Ta sama skala, inne pytanie: czy mierzy to samo w każdym pomiarze?
W badaniu podłużnym zwykle porównujesz średnie skali w kolejnych pomiarach albo modelujesz ich trajektorię. Taki wniosek zakłada, że kwestionariusz działa w każdym pomiarze tak samo. Widaman i in. (2010) pokazują, że przy kilku wskaźnikach w każdym pomiarze da się to sprawdzić. Jeśli ograniczenia inwariancji są spełnione, wyniki latentne z kolejnych pomiarów leżą na tej samej metryce, a wnioski o zmianie są mocniejsze.
Zmienia się kontekst życia badanych, a pozycja zaczyna reagować na coś innego niż konstrukt. Sam udział w badaniu też może zmieniać odpowiedzi. Warren i Halpern-Manners (2012) opisują ten efekt warunkowania panelowego i ostrzegają, że może on zniekształcić opis zmian między falami. Przykład z dwoma pomiarami zawiera hasło inwariancja pomiaru w CB-SEM, a porównania grup – wpis inwariancja pomiaru krok po kroku. Tu zajmujemy się tym, co swoiste dla danych podłużnych: trzema i więcej pomiarami, kowariancjami reszt, nieinwariancją tylko w jednym pomiarze, odpadaniem uczestników i funkcją measEq.syntax().
Przykład. 450 studentów (dane symulowane, set.seed(3441)) trzy razy wypełniło pięciopozycyjną skalę obniżonego nastroju (1–5): w listopadzie (T1), w marcu (T2) i w czerwcu, w trakcie sesji (T3). W populacji średnia czynnika rośnie o 0.30 SD w T2, a w T3 wynosi 0.15 SD powyżej T1. Pozycja n4 („Trudno mi skupić się na nauce”) ma w T3 wyraz wolny wyższy o 0.45 punktu. To skutek sesji, a nie gorszego nastroju. W T2 odpadło 13.1% osób, a w T3 18.9%, częściej ci z wyższym wynikiem w T1. Dane możesz pobrać jako plik CSV.
Który poziom inwariancji jest potrzebny do Twojego pytania?
Poziomy są te same co przy grupach; Meredith (1993) nazwał je inwariancją słabą, silną i ścisłą. To pytanie badawcze wyznacza, który poziom musisz osiągnąć.
| Pytanie w badaniu podłużnym | Co musi być równe w pomiarach | Poziom |
|---|---|---|
| Czy konstrukt ma w każdym pomiarze tę samą strukturę? | liczba czynników i układ ładunków | konfiguralna (konfiguracyjna) |
| Stabilność rangowa, korelacje i efekty krzyżowo-opóźnione między czynnikami | ładunki | metryczna |
| Czy średnia rośnie? Jak wygląda trajektoria i tempo zmiany? | ładunki i wyrazy wolne (progi przy pozycjach porządkowych) | skalarna, co najmniej częściowa |
| Zmiana sumy punktów u osoby, porównanie rzetelności w czasie | dodatkowo wariancje reszt | ścisła |
Model nie jest wielogrupowy. Te same osoby odpowiadają w każdym pomiarze, więc szacujesz jeden model z osobnym czynnikiem dla każdego pomiaru (CFA z trzema skorelowanymi czynnikami). Korelacje między czynnikami opisują stabilność konstruktu, a średnie czynników – jego zmianę.
Kowariancje reszt tej samej pozycji należą do modelu od początku
Każda pozycja ma swoją specyfikę, np. sformułowanie albo związek z czymś poza konstruktem. U tej samej osoby ta specyfika wraca w każdym pomiarze, więc reszty pozycji n1 z T1, T2 i T3 są skorelowane. Te kowariancje reszt wynikają ze schematu badania. Wpisz je do modelu bazowego, zanim zobaczysz wyniki. Przy pięciu pozycjach i trzech pomiarach jest ich 15.
W przykładzie model konfiguralny z tymi kowariancjami pasował dobrze: χ²(72) = 101.57, CFI = .988, RMSEA = .032, SRMR = .036. Standaryzowane kowariancje reszt miały medianę .31 (od .23 do .62). Bez nich dopasowanie było złe: χ²(87) = 459.14, CFI = .834, RMSEA = .109. Co gorsza, stała specyfika pozycji trafia wtedy do czynnika i zawyża jego korelacje w czasie. W tej próbie korelacja T1–T2 wzrosła z .62 do .69. Pojedyncza próba niewiele jednak mówi, dlatego powtórzyliśmy analizę na 500 symulowanych próbach (rysunek 1).
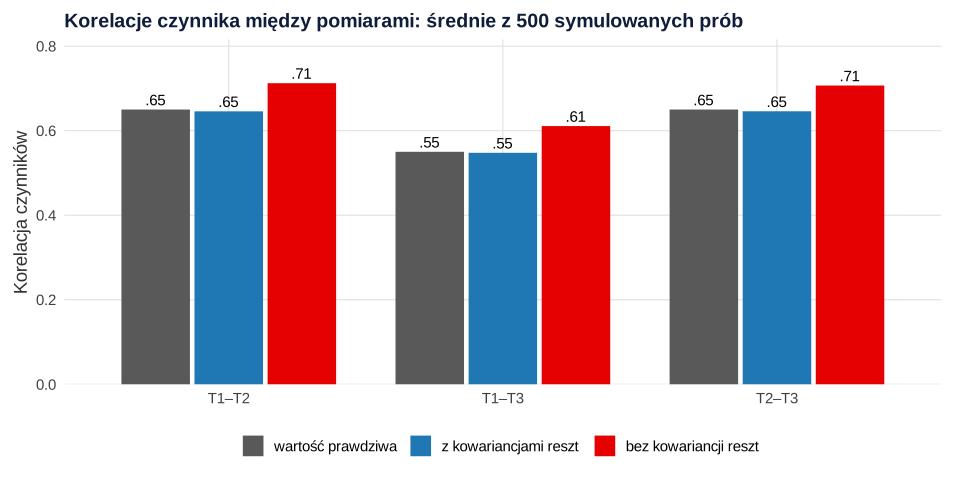
Model z kowariancjami reszt odtwarzał prawdziwe korelacje (średnio .646, .548 i .646). Model bez nich zawyżał każdą o około .06 (średnio .712, .611 i .707). Konstrukt wygląda wtedy na bardziej stabilny, niż jest, a błąd przenosi się na dalsze analizy, np. do modelu cross-lagged.
Składnia: measEq.syntax z longFacNames
Przy trzech pomiarach ręczna składnia ma kilkadziesiąt etykiet. Funkcja measEq.syntax() z pakietu semTools wygeneruje ją za Ciebie. Model zapisujesz w lavaan (Rosseel, 2012) jak zwykłą CFA z trzema czynnikami, a funkcji podajesz:
longFacNames– które czynniki to ten sam konstrukt w kolejnych pomiarach, np.list(nastroj = c("nastroj_t1", "nastroj_t2", "nastroj_t3"));longIndNames– które zmienne to ta sama pozycja w kolejnych pomiarach, np.n4 = c("n4_t1", "n4_t2", "n4_t3");long.equal– co zrównać w czasie:"loadings", potemc("loadings", "intercepts"), na końcu także"residuals";auto– kowariancje reszt tej samej pozycji; domyślnie"all", czyli wszystkie pary pomiarów (auto = 0je wyłącza, co zrobiliśmy tylko w celach porównawczych).
Model identyfikujemy przez ID.fac = "std.lv". Czynnik w T1 ma średnią 0 i wariancję 1. Gdy zrównasz ładunki, funkcja uwalnia wariancje czynnika w T2 i T3. Gdy zrównasz też wyrazy wolne, uwalnia średnie. Średnie czynnika w T2 i T3 wychodzą więc w odchyleniach standardowych czynnika z T1. Stąd Δdf = 8: zrównanie pięciu ładunków w trzech pomiarach to 10 ograniczeń, ale model uwalnia 2 wariancje. Jeśli wolisz wyniki w metryce pozycji, użyj kodowania efektów. Little i in. (2006) pokazują, że ta metoda daje takie samo dopasowanie jak metoda zmiennej wskaźnikowej, a parametry latentne wyraża w metryce wskaźników, także w modelach wielopomiarowych.
Szacujemy metodą MLR z missing = "fiml". Do modelu wchodzą więc wszystkie 450 osób, także te, które odpadły. Przy utracie uczestników zależnej od wyniku w T1, czyli przy brakach MAR (zob. MCAR, MAR i MNAR), analiza tylko kompletnych przypadków obciążyłaby średnie z T3.
Sekwencja modeli w trzech pomiarach
Przed analizą przyjęliśmy ΔCFI ≥ −.010 (Cheung i Rensvold, 2002) i ΔRMSEA ≤ .015 (Chen, 2007), a skalowany test różnicy chi-kwadrat podajemy informacyjnie. Każdy model porównujemy z ostatnim przyjętym. Putnick i Bornstein (2016) zauważają, że krok ścisły bywa testowany rzadziej niż pozostałe. Wykonaj go, jeśli zamierzasz porównywać sumy punktów.
Tabela 1
Testy podłużnej inwariancji pomiaru skali obniżonego nastroju w trzech pomiarach
| Model | χ² (df) | CFI | RMSEA | SRMR | Δχ² (Δdf); p | ΔCFI | ΔRMSEA | Spełniona |
|---|---|---|---|---|---|---|---|---|
| Konfiguralna | 101.57 (72) | .988 | .032 | .036 | — | — | — | — |
| Metryczna | 107.52 (80) | .989 | .029 | .038 | 5.26 (8); .729 | .001 | −.003 | tak |
| Skalarna | 204.76 (88) | .953 | .058 | .050 | 97.87 (8); < .001 | −.037 | .029 | nie |
| Skalarna częściowa | 118.29 (87) | .988 | .030 | .039 | 10.78 (7); .148 | −.001 | .000 | tak |
| Ścisła* | 124.03 (97) | .990 | .026 | .039 | 5.04 (10); .888 | .002 | −.004 | tak |
Uwaga. N = 450 w T1, odpadanie 13.1% w T2 i 18.9% w T3; dane symulowane. Jednogrupowy model CFA z czynnikiem w każdym pomiarze i kowariancjami reszt tej samej pozycji; estymator MLR z FIML: χ² – skalowany chi-kwadrat, CFI i RMSEA – wersje odporne. Skalarna częściowa: wyraz wolny pozycji n4 w T3 szacowany osobno (równość T1 = T2 zachowana). * – z zachowaniem tego uwolnienia. Każdy model porównano z ostatnim przyjętym; poziom uznawano za spełniony przy ΔCFI ≥ −.010 i ΔRMSEA ≤ .015 (Cheung i Rensvold, 2002; Chen, 2007).
Inwariancja metryczna została spełniona. Pełna inwariancja skalarna – nie: ΔCFI = −.037 i ΔRMSEA = .029 wyraźnie przekraczają progi.
Częściowa inwariancja: w którym pomiarze pozycja zmienia działanie?
W czasie każda równość parametru dotyczy kilku pomiarów. Etykieta nu.4 wspólna dla T1, T2 i T3 tworzy dwa ograniczenia: T1 = T2 i T1 = T3. Test punktowy (lavTestScore()) ocenia każde z nich osobno. Pokazuje więc nie tylko, która pozycja odstaje, lecz także w którym pomiarze (rysunek 2).
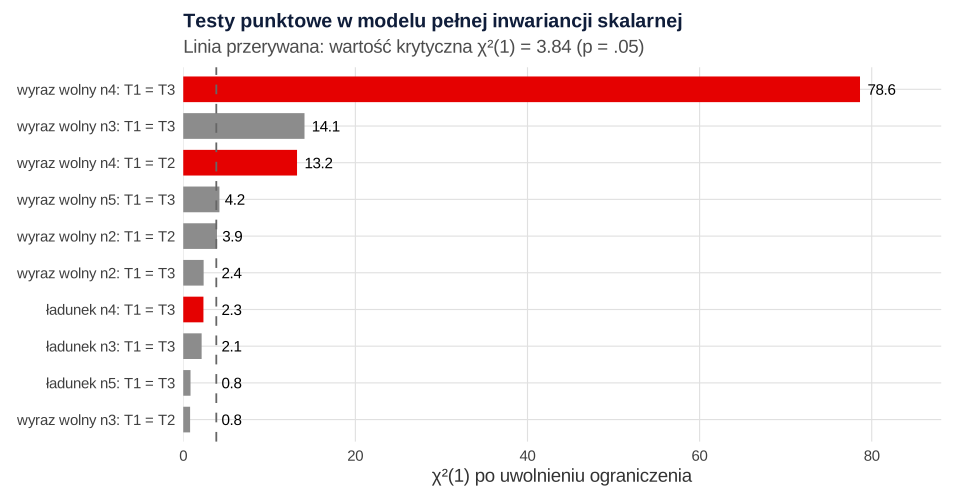
Zdecydowanie dominuje równość wyrazu wolnego n4 między T1 a T3, χ²(1) = 78.64, p < .001. Istotne wyszły też ograniczenia n3 T1 = T3 (14.09) i n4 T1 = T2 (13.22). To efekt uboczny: wymuszona równość przesuwa średnią czynnika w T3, więc inne pozycje i pomiary wyglądają na niedopasowane. Dlatego uwalniaj po jednym ograniczeniu i po każdej zmianie sprawdzaj model od nowa.
Uwolniliśmy tylko wyraz wolny n4 w T3. Równość T1 = T2 dla tej pozycji została w modelu. To wystarczyło: Δχ²(7) = 10.78, p = .148, ΔCFI = −.001 względem modelu metrycznego. Uwolnienie we wszystkich pomiarach odebrałoby n4 informację o zmianie między listopadem a marcem, choć wtedy działała tak samo. Wyraz wolny n4 wyniósł 2.52, 95% CI [2.44, 2.60] w T1 i T2 oraz 2.97, 95% CI [2.87, 3.06] w T3. Nieinwariancja ma tu sensowne wyjaśnienie: w trakcie sesji trudności z koncentracją rosną niezależnie od nastroju. Takie wyjaśnienie podaj w dyskusji jako hipotezę. Model ścisły z tym samym uwolnieniem także został przyjęty (ΔCFI = .002).
Co nieinwariantna pozycja robi z wnioskiem o zmianie
W modelu częściowej inwariancji skalarnej średnia czynnika wzrosła w T2 o 0.34 SD, 95% CI [0.23, 0.45], p < .001. W T3 była wyższa niż w T1 o 0.19 SD, 95% CI [0.07, 0.32], p = .003. Wartości prawdziwe to 0.30 i 0.15. Rysunek 3 porównuje to z dwoma podejściami, które ignorują zmianę pozycji n4.
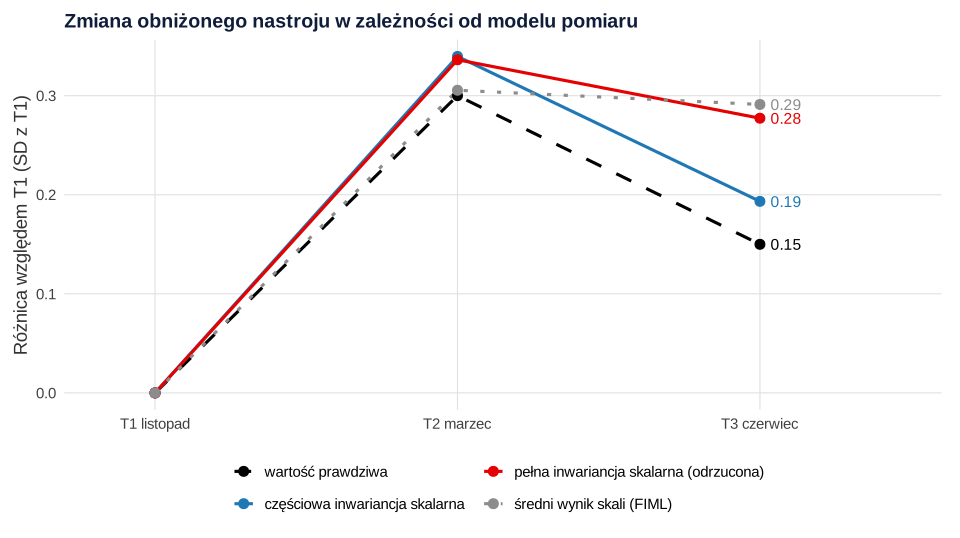
Do T2 wszystkie podejścia się zgadzają, bo n4 działała wtedy tak samo. W T3 model pełnej inwariancji skalarnej daje 0.28 SD, a średni wynik skali 0.29 SD. Oba niemal podwajają prawdziwy wzrost (0.15). Wzrost z częściowym powrotem zamienia się we wzrost i plateau: zmiana jednej pozycji zmienia opis kształtu trajektorii.
Pozycje porządkowe: progi zamiast wyrazów wolnych
Przy czterech i mniej kategoriach odpowiedzi pozycje traktuj jako porządkowe i szacuj modele estymatorem WLSMV (zob. kategorialna CFA w lavaan). Liu i in. (2017) rozszerzają testowanie inwariancji na podłużne dane porządkowe. Omawiają identyfikację modeli, rzadkie kategorie, braki danych i ocenę praktycznego znaczenia naruszeń. Wu i Estabrook (2016) pokazują, że ograniczenia identyfikujące model bazowy same działają jak ograniczenia inwariancji. Zalecają, by przy więcej niż dwóch kategoriach najpierw testować równość progów. W measEq.syntax() odpowiada to argumentom ordered, parameterization = "theta" i ID.cat = "Wu.Estabrook.2016" oraz sekwencji "thresholds" → "loadings" → "intercepts".
Na drugiej próbie (450 osób, odpowiedzi 1–4, pełne dane, to samo przesunięcie n4 w T3) model progów i model metryczny zostały przyjęte, Δχ²(10) = 7.30, p = .697 i Δχ²(8) = 9.22, p = .324. Model skalarny – nie: Δχ²(8) = 142.87, p < .001, CFI spadło z .998 do .971. Wyrazy wolne zmiennych ukrytych są w tej identyfikacji ustalone na 0, więc nieinwariancja ujawnia się w progach. Największe testy punktowe dotyczyły trzech progów n4 między T1 a T3, χ²(1) = 51.45, 28.00 i 23.55. Po uwolnieniu progów n4 w T3 model nie różnił się od metrycznego, Δχ²(5) = 2.83, p = .726. Średnia czynnika w T3 wyniosła 0.13 SD, a w modelu pełnej inwariancji skalarnej 0.28 SD.
Inwariancja a dalsze modele zmiany
Gdy konstrukt mierzy kilka pozycji, możesz zachować przyjęty model pomiarowy (z uwolnionym wyrazem wolnym n4 w T3) i nadbudować na nim krzywe wzrostu drugiego rzędu albo latentne modele zmiany (LCS). Jeśli analizujesz wyniki skali, np. wynik różnicowy, potrzebujesz co najmniej inwariancji skalarnej, a najlepiej ścisłej. Planowanie samego badania opisuje wpis badanie podłużne w doktoracie.
Jak opisać inwariancję podłużną w artykule
Podaj model bazowy z kowariancjami reszt, metodę estymacji i obsługę braków, kryteria przyjęte przed analizą i tabelę modeli (jak tabela 1). Przy każdym uwolnieniu podaj pozycję, pomiar, wielkość zmiany i jej możliwe wyjaśnienie. Średnie porównuj w modelu, który osiągnął (częściową) inwariancję skalarną.
Jeśli recenzent kwestionuje uwolnione parametry albo porównanie średnich w czasie, możemy wspólnie sprawdzić model i jego opis w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Przepisy 1 i 2 uruchamiaj po kolei w jednej sesji R. Przepisy 3 i 4 są samodzielne. Pierwszy tworzy plik nastroj-trzy-pomiary.csv (możesz go pobrać tutaj; puste komórki to braki). Potrzebne pakiety: lavaan, semTools i MASS.
1. Dane, model konfiguralny i kowariancje reszt
R
# Dane symulowane: 450 studentów, 5-pozycyjna skala obniżonego nastroju (1–5) w trzech pomiarach:
# T1 – listopad, T2 – marzec, T3 – czerwiec (w trakcie sesji). Prawdziwe średnie czynnika: 0, 0.30, 0.15.
# Pozycja n4 („Trudno mi skupić się na nauce”) ma w T3 wyraz wolny wyższy o 0.45 – to skutek sesji, nie nastroju.
suppressPackageStartupMessages({library(lavaan); library(semTools)})
set.seed(3441)
N <- 450
kor <- matrix(c(1, .65, .55, .65, 1, .65, .55, .65, 1), 3)              # korelacje czynnika w czasie
sd_eta <- sqrt(c(1, 1.1, 1.2))
eta <- MASS::mvrnorm(N, c(0, 0.30, 0.15), diag(sd_eta) %*% kor %*% diag(sd_eta))
lam <- c(0.80, 0.70, 0.75, 0.65, 0.70); nu <- c(2.6, 2.4, 2.8, 2.5, 2.2)
spec <- matrix(rnorm(N * 5, 0, sqrt(0.18)), N)                          # specyfika pozycji, ta sama w każdym pomiarze
dane <- data.frame(id = 1:N)
for (t in 1:3) for (j in 1:5) {
  x <- nu[j] + 0.45 * (j == 4 && t == 3) + lam[j] * eta[, t] + spec[, j] + rnorm(N, 0, sqrt(0.32))
  dane[[paste0("n", j, "_t", t)]] <- pmin(pmax(round(x), 1), 5)
}
# Odpadanie: 12% losowo w T2; w T3 częściej odpadają osoby z wyższym wynikiem w T1 (MAR)
wynik_t1 <- rowMeans(dane[, paste0("n", 1:5, "_t1")])
dane[runif(N) < 0.12, paste0("n", 1:5, "_t2")] <- NA
dane[runif(N) < plogis(-1.6 + 0.6 * (wynik_t1 - mean(wynik_t1))), paste0("n", 1:5, "_t3")] <- NA
write.csv(dane, "nastroj-trzy-pomiary.csv", row.names = FALSE, na = "")
round(c(braki_T2 = mean(is.na(dane$n1_t2)), braki_T3 = mean(is.na(dane$n1_t3))), 3)
srednie_poz <- sapply(1:3, function(t) colMeans(dane[, paste0("n", 1:5, "_t", t)], na.rm = TRUE))
dimnames(srednie_poz) <- list(paste0("n", 1:5), c("T1", "T2", "T3")); round(srednie_poz, 2)

# Model konfiguralny: czynnik w każdym pomiarze; measEq.syntax dopisuje kowariancje reszt tej samej pozycji
model <- 'nastroj_t1 =~ n1_t1 + n2_t1 + n3_t1 + n4_t1 + n5_t1
          nastroj_t2 =~ n1_t2 + n2_t2 + n3_t2 + n4_t2 + n5_t2
          nastroj_t3 =~ n1_t3 + n2_t3 + n3_t3 + n4_t3 + n5_t3'
czynniki <- list(nastroj = c("nastroj_t1", "nastroj_t2", "nastroj_t3"))
pozycje <- setNames(lapply(1:5, function(j) paste0("n", j, "_t", 1:3)), paste0("n", 1:5))
skladnia <- function(rowne = "", auto = "all")
  as.character(measEq.syntax(model, data = dane, ID.fac = "std.lv", longFacNames = czynniki,
                             longIndNames = pozycje, long.equal = rowne, auto = auto))
dopasuj <- function(s) cfa(s, data = dane, estimator = "MLR", missing = "fiml")
wsk <- c("chisq.scaled", "df.scaled", "cfi.robust", "rmsea.robust", "srmr")
konf <- dopasuj(skladnia())
konf_bez <- dopasuj(skladnia(auto = 0))                                  # bez kowariancji reszt w czasie
round(rbind(z_kowariancjami = fitMeasures(konf, wsk), bez_kowariancji = fitMeasures(konf_bez, wsk)), 3)
lavTestLRT(konf_bez, konf)[2, c("Chisq diff", "Df diff", "Pr(>Chisq)")]
kowar <- standardizedSolution(konf)
kowar <- kowar[kowar$op == "~~" & kowar$lhs != kowar$rhs & grepl("^n", kowar$lhs), ]
round(c(mediana = median(kowar$est.std), min = min(kowar$est.std), max = max(kowar$est.std)), 2)
korelacje <- function(f) { r <- lavInspect(f, "cor.lv"); c(T1_T2 = r[2, 1], T1_T3 = r[3, 1], T2_T3 = r[3, 2]) }
round(rbind(prawdziwe = c(.65, .55, .65), z_kowariancjami = korelacje(konf), bez_kowariancji = korelacje(konf_bez)), 3)
Wynik w R
braki_T2 braki_T3
   0.131    0.189
     T1   T2   T3
n1 2.58 2.82 2.76
n2 2.38 2.66 2.49
n3 2.84 3.06 2.84
n4 2.52 2.72 3.06
n5 2.26 2.44 2.33
                chisq.scaled df.scaled cfi.robust rmsea.robust  srmr
z_kowariancjami      101.567        72      0.988        0.032 0.036
bez_kowariancji      459.139        87      0.834        0.109 0.059
         Chisq diff Df diff Pr(>Chisq)
konf_bez     363.73      15  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
mediana     min     max
   0.31    0.23    0.62
                T1_T2 T1_T3 T2_T3
prawdziwe       0.650 0.550 0.650
z_kowariancjami 0.623 0.465 0.621
bez_kowariancji 0.691 0.540 0.681
2. Sekwencja modeli, testy punktowe i częściowa inwariancja
R
# Sekwencja modeli inwariancji podłużnej (wymaga obiektów z przepisu 1: dane, skladnia, dopasuj, wsk, konf)
suppressPackageStartupMessages(library(lavaan))
metr <- dopasuj(skladnia("loadings"))
skal <- dopasuj(skladnia(c("loadings", "intercepts")))
porownaj <- function(a, b) {                                             # skalowany test różnicy i zmiany wskaźników
  t <- lavTestLRT(a, b)
  c(d_chi2 = t[2, "Chisq diff"], d_df = t[2, "Df diff"], p = t[2, "Pr(>Chisq)"],
    d_CFI = unname(fitMeasures(b, "cfi.robust") - fitMeasures(a, "cfi.robust")),
    d_RMSEA = unname(fitMeasures(b, "rmsea.robust") - fitMeasures(a, "rmsea.robust")))
}
round(rbind(metryczna_vs_konf = porownaj(konf, metr), skalarna_vs_metr = porownaj(metr, skal)), 3)

# Testy punktowe: każda równość ma dwa ograniczenia (T1 = T2 i T1 = T3)
pt <- parTable(skal)
nazwa <- function(p) with(pt[pt$plabel == p, ], paste(lhs, op, rhs))
tp <- lavTestScore(skal)$uni
tp$ograniczenie <- paste(sapply(tp$lhs, nazwa), "=", sapply(tp$rhs, nazwa))
tp <- tp[order(-tp$X2), c("ograniczenie", "X2", "p.value")]; rownames(tp) <- NULL
write.csv(tp, "b344-testy-punktowe.csv", row.names = FALSE)
head(transform(tp, X2 = round(X2, 2), p.value = round(p.value, 3)), 5)

# Częściowa inwariancja skalarna: uwalniamy tylko wyraz wolny n4 w T3 (T1 = T2 zostaje)
s_czesc <- sub("n4_t3 ~ NA*1 + nu.4*1", "n4_t3 ~ NA*1 + nu.4_t3*1", skladnia(c("loadings", "intercepts")), fixed = TRUE)
czesc <- dopasuj(s_czesc)
s_scis <- sub("n4_t3 ~ NA*1 + nu.4*1", "n4_t3 ~ NA*1 + nu.4_t3*1",
              skladnia(c("loadings", "intercepts", "residuals")), fixed = TRUE)
scis <- dopasuj(s_scis)
round(rbind(czesciowa_vs_metr = porownaj(metr, czesc), scisla_vs_czesc = porownaj(czesc, scis)), 3)
round(t(sapply(list(konfiguralna = konf, metryczna = metr, skalarna = skal, czesciowa = czesc, scisla = scis),
               fitMeasures, wsk)), 3)
pe <- parameterEstimates(czesc)
round(pe[pe$op == "~1" & pe$lhs %in% c("n4_t1", "n4_t2", "n4_t3"), c("est", "ci.lower", "ci.upper")], 2)

# Średnie czynnika (w SD czynnika z T1) i średnie wyniku skali (FIML) w trzech modelach
srednie <- function(f) { p <- parameterEstimates(f); p <- p[p$op == "~1" & grepl("^nastroj", p$lhs), ]
  setNames(p$est, c("T1", "T2", "T3")) }
dane_sk <- data.frame(s1 = rowMeans(dane[, paste0("n", 1:5, "_t1")]), s2 = rowMeans(dane[, paste0("n", 1:5, "_t2")]),
                      s3 = rowMeans(dane[, paste0("n", 1:5, "_t3")]))
f_sk <- sem('s1 ~~ s2 + s3
             s2 ~~ s3', data = dane_sk, missing = "fiml", meanstructure = TRUE)
p_sk <- parameterEstimates(f_sk); m_sk <- p_sk$est[p_sk$op == "~1"]; sd1 <- sqrt(p_sk$est[p_sk$lhs == "s1" & p_sk$op == "~~" & p_sk$rhs == "s1"])
wyniki <- rbind(prawdziwe = c(0, 0.30, 0.15), czesciowa_skalarna = srednie(czesc), pelna_skalarna = srednie(skal),
                wynik_skali_FIML = (m_sk - m_sk[1]) / sd1)
write.csv(data.frame(model = rownames(wyniki), wyniki), "b344-srednie.csv", row.names = FALSE)
round(wyniki, 3)
sr <- pe[pe$op == "~1" & pe$lhs %in% c("nastroj_t2", "nastroj_t3"), c("est", "se", "pvalue", "ci.lower", "ci.upper")]
rownames(sr) <- c("T2", "T3"); round(sr, 3)
Wynik w R
                  d_chi2 d_df     p  d_CFI d_RMSEA
metryczna_vs_konf  5.263    8 0.729  0.001  -0.003
skalarna_vs_metr  97.865    8 0.000 -0.037   0.029
           ograniczenie    X2 p.value
1 n4_t1 ~1  = n4_t3 ~1  78.64   0.000
2 n3_t1 ~1  = n3_t3 ~1  14.09   0.000
3 n4_t1 ~1  = n4_t2 ~1  13.22   0.000
4 n5_t1 ~1  = n5_t3 ~1   4.20   0.040
5 n2_t1 ~1  = n2_t2 ~1   3.92   0.048
                  d_chi2 d_df     p  d_CFI d_RMSEA
czesciowa_vs_metr 10.781    7 0.148 -0.001   0.000
scisla_vs_czesc    5.041   10 0.888  0.002  -0.004
             chisq.scaled df.scaled cfi.robust rmsea.robust  srmr
konfiguralna      101.567        72      0.988        0.032 0.036
metryczna         107.516        80      0.989        0.029 0.038
skalarna          204.758        88      0.953        0.058 0.050
czesciowa         118.289        87      0.988        0.030 0.039
scisla            124.033        97      0.990        0.026 0.039
    est ci.lower ci.upper
19 2.52     2.44     2.60
24 2.52     2.44     2.60
29 2.97     2.87     3.06
                   T1    T2    T3
prawdziwe           0 0.300 0.150
czesciowa_skalarna  0 0.340 0.193
pelna_skalarna      0 0.336 0.277
wynik_skali_FIML    0 0.305 0.291
     est    se pvalue ci.lower ci.upper
T2 0.340 0.057  0.000    0.229     0.45
T3 0.193 0.065  0.003    0.067     0.32
3. Pozycje porządkowe: WLSMV i progi
R
# Wariant porządkowy: te same założenia, odpowiedzi 1–4, pełne dane (bez odpadania); WLSMV, parametryzacja theta
suppressPackageStartupMessages({library(lavaan); library(semTools)})
set.seed(3443)
N <- 450
kor <- matrix(c(1, .65, .55, .65, 1, .65, .55, .65, 1), 3); sd_eta <- sqrt(c(1, 1.1, 1.2))
eta <- MASS::mvrnorm(N, c(0, 0.30, 0.15), diag(sd_eta) %*% kor %*% diag(sd_eta))
lam <- c(0.80, 0.70, 0.75, 0.65, 0.70); progi <- c(-0.5, 0.5, 1.4)
spec <- matrix(rnorm(N * 5, 0, sqrt(0.18)), N)
dp <- data.frame(id = 1:N)
for (t in 1:3) for (j in 1:5) {
  y <- 0.45 * (j == 4 && t == 3) + lam[j] * eta[, t] + spec[, j] + rnorm(N, 0, sqrt(0.32))   # odpowiedź ukryta
  dp[[paste0("n", j, "_t", t)]] <- findInterval(y, progi) + 1
}
model <- 'nastroj_t1 =~ n1_t1 + n2_t1 + n3_t1 + n4_t1 + n5_t1
          nastroj_t2 =~ n1_t2 + n2_t2 + n3_t2 + n4_t2 + n5_t2
          nastroj_t3 =~ n1_t3 + n2_t3 + n3_t3 + n4_t3 + n5_t3'
czynniki <- list(nastroj = c("nastroj_t1", "nastroj_t2", "nastroj_t3"))
pozycje <- setNames(lapply(1:5, function(j) paste0("n", j, "_t", 1:3)), paste0("n", 1:5))
ord <- names(dp)[-1]
skl_p <- function(rowne) as.character(measEq.syntax(model, data = dp, ordered = ord, parameterization = "theta",
  ID.fac = "std.lv", ID.cat = "Wu.Estabrook.2016", longFacNames = czynniki, longIndNames = pozycje, long.equal = rowne))
dop_p <- function(s) cfa(s, data = dp, ordered = ord, estimator = "WLSMV", parameterization = "theta")
kroki <- list(konfiguralna = "", progow = "thresholds", metryczna = c("thresholds", "loadings"),
              skalarna = c("thresholds", "loadings", "intercepts"))
mp <- lapply(kroki, function(r) dop_p(skl_p(r)))
round(t(sapply(mp, fitMeasures, c("chisq.scaled", "df.scaled", "cfi.scaled", "rmsea.scaled"))), 3)
round(t(sapply(2:4, function(i) unlist(lavTestLRT(mp[[i - 1]], mp[[i]])[2, c("Chisq diff", "Df diff", "Pr(>Chisq)")]))), 3)
pt <- parTable(mp$skalarna); nazwa <- function(p) with(pt[pt$plabel == p, ], paste(lhs, op, rhs))
tp <- lavTestScore(mp$skalarna)$uni
tp$ograniczenie <- paste(sapply(tp$lhs, nazwa), "=", sapply(tp$rhs, nazwa))
tp <- tp[order(-tp$X2), c("ograniczenie", "X2", "p.value")]; rownames(tp) <- NULL
head(transform(tp, X2 = round(X2, 2), p.value = round(p.value, 3)), 4)
# Częściowa inwariancja: własne progi pozycji n4 w T3
s_cz <- skl_p(kroki$skalarna)
for (k in 1:3) s_cz <- sub(paste0("n4_t3 | NA*t", k, " + n4_t1.thr", k, "*t", k),
                           paste0("n4_t3 | NA*t", k, " + n4_t3.thr", k, "*t", k), s_cz, fixed = TRUE)
cz_p <- dop_p(s_cz)
round(c(fitMeasures(cz_p, c("chisq.scaled", "df.scaled", "cfi.scaled", "rmsea.scaled")),
        unlist(lavTestLRT(mp$metryczna, cz_p)[2, c("Chisq diff", "Df diff", "Pr(>Chisq)")])), 3)
sr_p <- function(f) { p <- parameterEstimates(f); round(p$est[p$op == "~1" & grepl("^nastroj", p$lhs)], 3) }
rbind(czesciowa = sr_p(cz_p), pelna_skalarna = sr_p(mp$skalarna))
Wynik w R
             chisq.scaled df.scaled cfi.scaled rmsea.scaled
konfiguralna       81.360        72      0.998        0.017
progow             89.886        82      0.998        0.015
metryczna          99.027        90      0.998        0.015
skalarna          234.218        98      0.971        0.056
     Chisq diff Df diff Pr(>Chisq)
[1,]      7.300      10      0.697
[2,]      9.223       8      0.324
[3,]    142.869       8      0.000
                               ograniczenie    X2 p.value
1                   n4_t1 | t1 = n4_t3 | t1 51.45   0.000
2                   n4_t1 | t2 = n4_t3 | t2 28.00   0.000
3                   n4_t1 | t3 = n4_t3 | t3 23.55   0.000
4 nastroj_t1 =~ n4_t1 = nastroj_t3 =~ n4_t3  9.07   0.003
chisq.scaled    df.scaled   cfi.scaled rmsea.scaled   Chisq diff      Df diff
     103.071       95.000        0.998        0.014        2.832        5.000
  Pr(>Chisq)
       0.726
               [,1]  [,2]  [,3]
czesciowa         0 0.253 0.130
pelna_skalarna    0 0.255 0.279
4. Symulacja: model z kowariancjami reszt i bez nich
R
# Symulacja: 500 prób po 450 osób z tego samego mechanizmu (pełne dane), model konfiguralny
# z kowariancjami reszt tej samej pozycji w czasie i bez nich; prawdziwe korelacje czynnika: .65, .55, .65
suppressPackageStartupMessages(library(lavaan))
set.seed(3444)
generuj <- function(N = 450) {
  kor <- matrix(c(1, .65, .55, .65, 1, .65, .55, .65, 1), 3); sd_eta <- sqrt(c(1, 1.1, 1.2))
  eta <- MASS::mvrnorm(N, c(0, 0.30, 0.15), diag(sd_eta) %*% kor %*% diag(sd_eta))
  lam <- c(0.80, 0.70, 0.75, 0.65, 0.70); nu <- c(2.6, 2.4, 2.8, 2.5, 2.2)
  spec <- matrix(rnorm(N * 5, 0, sqrt(0.18)), N); d <- data.frame(id = 1:N)
  for (t in 1:3) for (j in 1:5) {
    x <- nu[j] + 0.45 * (j == 4 && t == 3) + lam[j] * eta[, t] + spec[, j] + rnorm(N, 0, sqrt(0.32))
    d[[paste0("n", j, "_t", t)]] <- pmin(pmax(round(x), 1), 5)
  }
  d
}
m_bez <- paste0("f", 1:3, " =~ ", sapply(1:3, function(t) paste0("n", 1:5, "_t", t, collapse = " + ")), collapse = "\n")
m_z <- paste(m_bez, paste0("n", 1:5, "_t1 ~~ n", 1:5, "_t2 + n", 1:5, "_t3\nn", 1:5, "_t2 ~~ n", 1:5, "_t3", collapse = "\n"), sep = "\n")
kor_lv <- function(f) { r <- lavInspect(f, "cor.lv"); c(r[2, 1], r[3, 1], r[3, 2]) }
wyn <- t(replicate(500, { d <- generuj()
  c(kor_lv(cfa(m_z, data = d, std.lv = TRUE)), kor_lv(cfa(m_bez, data = d, std.lv = TRUE))) }))
tab <- data.frame(para = rep(c("T1-T2", "T1-T3", "T2-T3"), 2), model = rep(c("z_kowariancjami", "bez_kowariancji"), each = 3),
                  prawdziwa = rep(c(.65, .55, .65), 2), srednia = colMeans(wyn), blad_MC = apply(wyn, 2, sd) / sqrt(500))
write.csv(tab, "b344-symulacja.csv", row.names = FALSE)
transform(tab, srednia = round(srednia, 3), blad_MC = round(blad_MC, 4))
Wynik w R
   para           model prawdziwa srednia blad_MC
1 T1-T2 z_kowariancjami      0.65   0.646  0.0016
2 T1-T3 z_kowariancjami      0.55   0.548  0.0019
3 T2-T3 z_kowariancjami      0.65   0.646  0.0016
4 T1-T2 bez_kowariancji      0.65   0.712  0.0016
5 T1-T3 bez_kowariancji      0.55   0.611  0.0018
6 T2-T3 bez_kowariancji      0.65   0.707  0.0016
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lavaan, semTools i MASS; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semTools (wersja 0.5.8): Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., & Rosseel, Y. (2026). semTools: Useful tools for structural equation modeling (R package version 0.5-8) [Computer software]. https://CRAN.R-project.org/package=semTools
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Model wielogrupowy z pomiarami jako grupami. Pomija zależność odpowiedzi tych samych osób. Szacuj jeden model z czynnikiem dla każdego pomiaru.
- Kowariancje reszt dodawane dopiero po indeksach modyfikacji. Należą do modelu bazowego. Bez nich korelacje czynnika w czasie są zawyżone (rysunek 1).
- Uwolnienie pozycji we wszystkich pomiarach. Jeśli pozycja zmienia działanie tylko w jednym pomiarze, uwolnij parametr tylko tam. Pozostałe równości dalej wnoszą informację o zmianie.
- Odrzucenie osób, które odpadły. Analiza kompletnych przypadków obciąża średnie z późnych pomiarów, gdy odpadanie zależy od wcześniejszych wyników. Użyj FIML albo imputacji wielokrotnej.
- Trajektoria z sum punktów przy częściowej inwariancji. W przykładzie średni wynik skali niemal podwoił wzrost w T3 i zmienił kształt trajektorii (rysunek 3).
Najczęstsze pytania
Czy skalę z dobrą walidacją trzeba sprawdzać pod kątem inwariancji w czasie?
Tak, jeśli porównujesz średnie albo modelujesz zmianę. Walidacja przekrojowa nie mówi, czy pozycje działają tak samo w kolejnych pomiarach Twojego badania. Zmienia się kontekst życia badanych, a sam udział w badaniu może wpływać na odpowiedzi. W przykładzie jedna pozycja zmieniła działanie tylko w pomiarze przeprowadzonym w trakcie sesji.
Jak w measEq.syntax ustawić inwariancję podłużną?
Zapisz model jak CFA z osobnym czynnikiem dla każdego pomiaru. W longFacNames wskaż, które czynniki to ten sam konstrukt, a w longIndNames – które zmienne to ta sama pozycja w kolejnych pomiarach. Ograniczenia dodawaj argumentem long.equal, np. c("loadings", "intercepts"). Kowariancje reszt tej samej pozycji funkcja dopisze sama (auto = "all").
Co zrobić, gdy pozycja jest nieinwariantna tylko w jednym pomiarze?
Uwolnij jej parametr tylko w tym pomiarze, a równości w pozostałych pomiarach zostaw. Test punktowy ocenia osobno każdą parę pomiarów, więc pokazuje, gdzie leży problem. W przykładzie wystarczyło uwolnić wyraz wolny pozycji n4 w T3, Δχ²(7) = 10.78, p = .148 względem modelu metrycznego.
Jak uwzględnić odpadanie uczestników w teście inwariancji podłużnej?
Szacuj modele metodą FIML (w lavaan missing = "fiml", np. z estymatorem MLR), aby wykorzystać dane wszystkich osób, także tych, które odpadły. Gdy odpadanie zależy od wcześniejszych wyników, analiza samych kompletnych przypadków obciąża średnie z późniejszych pomiarów. Odsetek braków w każdym pomiarze podaj w uwadze pod tabelą modeli.
Czy przed modelem krzywych wzrostu trzeba sprawdzić inwariancję w czasie?
Tak, bo krzywa wzrostu opisuje zmianę średnich, a do porównania średnich potrzebna jest co najmniej częściowa inwariancja skalarna. Gdy konstrukt mierzy kilka pozycji, możesz zbudować krzywą wzrostu na czynnikach z przyjętego modelu pomiarowego. W przykładzie nieinwariantna pozycja zmieniła trajektorię ze wzrostu i częściowego powrotu we wzrost i plateau.
Powiązane hasła
Przeczytaj też
Inwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikKrzywe wzrostu (LGM) i modele zmiany
Krzywa wzrostu w lavaan na danych do pobrania: kształt zmiany, ujemna wariancja, kodowanie czasu, predyktor tempa, porównanie z lme4 i tabele APA.
Czytaj →PoradnikLatentne modele zmiany (LCS) w lavaan
Model podwójnej zmiany i sprzężenie dwóch procesów w lavaan: interpretacja β i γ, porównanie z LGM i odzysk parametrów w symulacji.
Czytaj →Porównujesz wyniki skali w kolejnych pomiarach i recenzent pyta o inwariancję?
Pomożemy zbudować model inwariancji podłużnej, podjąć decyzje o częściowej inwariancji i sprawdzić opis tak, żebyś mógł(a) samodzielnie uzasadnić porównania w czasie przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Chen, F. F. (2007). Sensitivity of goodness of fit indexes to lack of measurement invariance. Structural Equation Modeling: A Multidisciplinary Journal, 14(3), 464–504. https://doi.org/10.1080/10705510701301834
- Cheung, G. W., & Rensvold, R. B. (2002). Evaluating goodness-of-fit indexes for testing measurement invariance. Structural Equation Modeling: A Multidisciplinary Journal, 9(2), 233–255. https://doi.org/10.1207/s15328007sem0902_5
- Little, T. D., Slegers, D. W., & Card, N. A. (2006). A non-arbitrary method of identifying and scaling latent variables in SEM and MACS models. Structural Equation Modeling: A Multidisciplinary Journal, 13(1), 59–72. https://doi.org/10.1207/s15328007sem1301_3
- Liu, Y., Millsap, R. E., West, S. G., Tein, J.-Y., Tanaka, R., & Grimm, K. J. (2017). Testing measurement invariance in longitudinal data with ordered-categorical measures. Psychological Methods, 22(3), 486–506. https://doi.org/10.1037/met0000075 ● Otwarty dostęp
- Meredith, W. (1993). Measurement invariance, factor analysis and factorial invariance. Psychometrika, 58(4), 525–543. https://doi.org/10.1007/bf02294825
- Putnick, D. L., & Bornstein, M. H. (2016). Measurement invariance conventions and reporting: The state of the art and future directions for psychological research. Developmental Review, 41, 71–90. https://doi.org/10.1016/j.dr.2016.06.004 ● Otwarty dostęp: pełny tekst
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Warren, J. R., & Halpern-Manners, A. (2012). Panel conditioning in longitudinal social science surveys. Sociological Methods & Research, 41(4), 491–534. https://doi.org/10.1177/0049124112460374 ● Otwarty dostęp: pełny tekst
- Widaman, K. F., Ferrer, E., & Conger, R. D. (2010). Factorial invariance within longitudinal structural equation models: Measuring the same construct across time. Child Development Perspectives, 4(1), 10–18. https://doi.org/10.1111/j.1750-8606.2009.00110.x ● Otwarty dostęp: pełny tekst
- Wu, H., & Estabrook, R. (2016). Identification of confirmatory factor analysis models of different levels of invariance for ordered categorical outcomes. Psychometrika, 81(4), 1014–1045. https://doi.org/10.1007/s11336-016-9506-0 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{chen2007sensitivity, author={Chen, Fang Fang}, title={{Sensitivity of goodness of fit indexes to lack of measurement invariance}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={3}, pages={464--504}, doi={10.1080/10705510701301834}}@article{cheung2002evaluating, author={Cheung, Gordon W. and Rensvold, Roger B.}, title={{Evaluating goodness-of-fit indexes for testing measurement invariance}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2002}, volume={9}, number={2}, pages={233--255}, doi={10.1207/s15328007sem0902_5}}@article{little2006nonarbitrary, author={Little, Todd D. and Slegers, David W. and Card, Noel A.}, title={{A non-arbitrary method of identifying and scaling latent variables in SEM and MACS models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2006}, volume={13}, number={1}, pages={59--72}, doi={10.1207/s15328007sem1301_3}}@article{liu2017testing, author={Liu, Yu and Millsap, Roger E. and West, Stephen G. and Tein, Jenn-Yun and Tanaka, Rika and Grimm, Kevin J.}, title={{Testing measurement invariance in longitudinal data with ordered-categorical measures}}, journal={Psychological Methods}, year={2017}, volume={22}, number={3}, pages={486--506}, doi={10.1037/met0000075}}@article{meredith1993measurement, author={Meredith, William}, title={{Measurement invariance, factor analysis and factorial invariance}}, journal={Psychometrika}, year={1993}, volume={58}, number={4}, pages={525--543}, doi={10.1007/bf02294825}}@article{putnick2016measurement, author={Putnick, Diane L. and Bornstein, Marc H.}, title={{Measurement invariance conventions and reporting: The state of the art and future directions for psychological research}}, journal={Developmental Review}, year={2016}, volume={41}, pages={71--90}, doi={10.1016/j.dr.2016.06.004}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{warren2012panel, author={Warren, John Robert and Halpern-Manners, Andrew}, title={{Panel conditioning in longitudinal social science surveys}}, journal={Sociological Methods \& Research}, year={2012}, volume={41}, number={4}, pages={491--534}, doi={10.1177/0049124112460374}}@article{widaman2010factorial, author={Widaman, Keith F and Ferrer, Emilio and Conger, Rand D}, title={{Factorial invariance within longitudinal structural equation models: Measuring the same construct across time}}, journal={Child Development Perspectives}, year={2010}, volume={4}, number={1}, pages={10--18}, doi={10.1111/j.1750-8606.2009.00110.x}}@article{wu2016identification, author={Wu, Hao and Estabrook, Ryne}, title={{Identification of confirmatory factor analysis models of different levels of invariance for ordered categorical outcomes}}, journal={Psychometrika}, year={2016}, volume={81}, number={4}, pages={1014--1045}, doi={10.1007/s11336-016-9506-0}}