Kiedy krzywa wzrostu, a kiedy inny model zmiany
Masz trzy, cztery albo pięć pomiarów tych samych osób i chcesz wiedzieć, jak zmienia się wynik. Pytanie „czy średnia w kolejnych pomiarach się różni” to dopiero początek. W doktoracie i w artykule zwykle chodzi o więcej: jaki jest kształt zmiany, czy ludzie różnią się punktem startu i tempem, oraz co te różnice przewiduje. Na takie pytania odpowiada model krzywej wzrostu (ang. latent growth model, LGM). Curran i in. (2010) opisują tę rodzinę modeli jako narzędzie do badania międzyosobowych różnic w zmianie wewnątrzosobowej. Każda osoba ma własną trajektorię, a model opisuje jej średni przebieg i rozrzut.
Ten poradnik jest dla doktorantów i badaczy, którzy mają już dane z badania podłużnego i chcą je przeanalizować w pakiecie lavaan. Krok po kroku pokażemy, jak wybrać kształt zmiany, co zrobić z ujemną wariancją, jak kodowanie czasu zmienia interpretację parametrów, jak dodać predyktor i jak ten sam model zapisać jako model mieszany. O planowaniu liczby pomiarów i odstępów między nimi piszemy osobno w tekście badanie podłużne w doktoracie.
| Pytanie badawcze | Model | Gdzie szukać |
|---|---|---|
| Czy średnie w kilku pomiarach się różnią? | ANOVA z powtarzanymi pomiarami | ANOVA z powtarzanymi pomiarami krok po kroku |
| Jaki jest średni kształt zmiany i jak bardzo różnią się osoby? Co przewiduje start i tempo? | krzywa wzrostu (LGM) albo model mieszany z losowym nachyleniem | ten poradnik; ANOVA czy model mieszany |
| Czy zmiana jednej zmiennej poprzedza zmianę drugiej w obrębie osoby? | modele cross-lagged, zwłaszcza RI-CLPM | modele cross-lagged: CLPM i RI-CLPM |
| Czy istnieją podgrupy osób o odmiennych trajektoriach? | model mieszanin wzrostu (GMM) | sekcja rozszerzenia |
| O ile zmienił się wynik między dwoma pomiarami? | wynik różnicowy, ANCOVA | wynik różnicowy |
Ployhart i Vandenberg (2010) porównują te podejścia i pokazują, że wybór zależy od teorii zmiany, a nie od przyzwyczajenia. Krzywa wzrostu pyta o trajektorie. Modele cross-lagged pytają o następstwo zmian w dwóch procesach. To inne pytania, więc nie traktuj tych modeli jako zamienników. Do dwóch pomiarów LGM się nie nadaje. Model liniowy wymaga co najmniej trzech pomiarów, a kwadratowy – czterech. Lepiej mieć ich jeszcze więcej, bo wtedy model ma stopnie swobody i da się sprawdzić jego dopasowanie.
Badanie przykładowe: wypalenie doktorantów w pierwszym roku
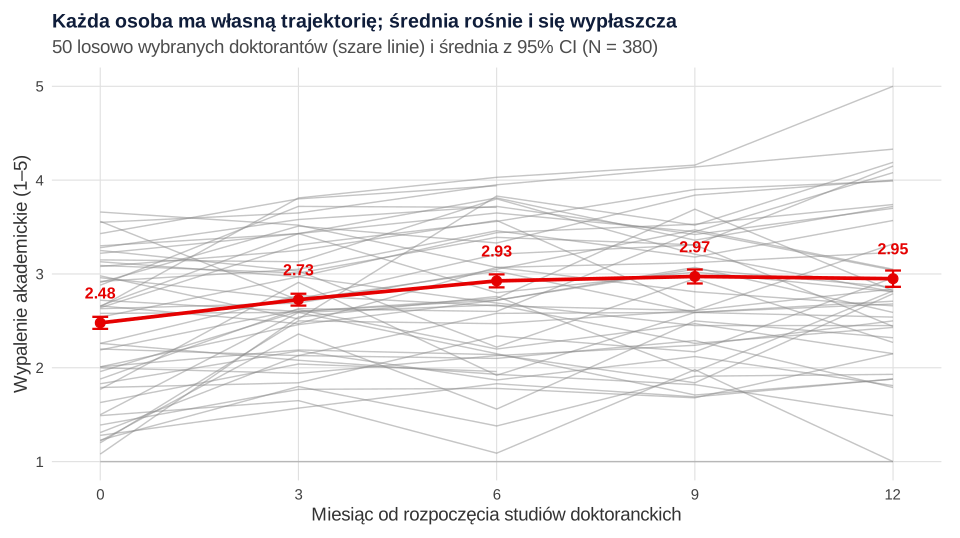
Przykład (dane symulowane): 380 doktorantów kilku szkół doktorskich wypełniało skalę wypalenia akademickiego pięć razy, co trzy miesiące, od początku do końca pierwszego roku studiów. Wynik skali to średnia pozycji od 1 do 5. W pierwszym pomiarze mierzono też wsparcie promotora, które zapisano jako wynik standaryzowany (M = 0, SD = 1). Pytania badawcze są trzy. Jak przebiega zmiana wypalenia w pierwszym roku? Czy doktoranci różnią się poziomem początkowym i tempem zmiany? Czy wsparcie promotora wiąże się z poziomem i tempem? Dane pobierzesz tutaj: krzywe-wzrostu-lgm-dane.csv (380 wierszy w formacie szerokim: id, wsparcie, w1–w5, braki jako puste komórki).
| Pomiar (miesiąc) | n | M | SD | r z pomiarem 1 |
|---|---|---|---|---|
| 1 (0) | 380 | 2.48 | 0.64 | – |
| 2 (3) | 373 | 2.73 | 0.62 | .78 |
| 3 (6) | 365 | 2.93 | 0.67 | .76 |
| 4 (9) | 350 | 2.97 | 0.71 | .67 |
| 5 (12) | 330 | 2.95 | 0.81 | .58 |
Już opis daje trzy wskazówki. Średnia rośnie, ale coraz wolniej, i między 9. a 12. miesiącem prawie stoi. Odchylenie standardowe rośnie z 0.64 do 0.81, więc osoby coraz bardziej się różnią. To typowy ślad zróżnicowanego tempa zmiany. Wreszcie korelacje z pierwszym pomiarem maleją wraz z odległością w czasie (od .78 do .58), co też pasuje do modelu z losowym nachyleniem.
Krok 1. Format danych, braki i odpadanie
LGM w lavaan potrzebuje danych w formacie szerokim: jeden wiersz to jedna osoba, a każdy pomiar ma własną kolumnę. Model mieszany z kroku 7 wymaga formatu długiego. Różnicę i sposób przekształcania opisuje hasło format długi i szeroki danych.
W badaniu podłużnym braki niemal zawsze rosną z czasem. W przykładzie ostatniego pomiaru nie ma 13.2% osób. Odpadanie nie było losowe: osoby, które zrezygnowały przed ostatnim pomiarem, miały na starcie wyższe wypalenie (M = 2.61) niż osoby, które zostały (M = 2.46). Gdybyś analizował tylko osoby z kompletem pomiarów, próba byłaby przesunięta w stronę mniej wypalonych, a średnia trajektoria – zaniżona. Dlatego szacujemy model pełną informacją największej wiarygodności (FIML, missing = "fiml"). Każda osoba wnosi do modelu wszystkie dostępne pomiary. W symulacjach Endersa i Bandalosa (2001) FIML dawał w modelach SEM przy brakach MCAR i MAR oszacowania nieobciążone i efektywniejsze niż usuwanie przypadków.
FIML nie usuwa jednak problemu, gdy rezygnacja zależy od wartości, których nie zmierzyłeś (np. od nieznanego wypalenia w kolejnym pomiarze). To mechanizm MNAR, a jego brak nie da się sprawdzić w samych danych. Opisz w pracy odsetek braków w każdym pomiarze, porównaj osoby, które odpadły, z pozostałymi i nazwij założenie, które przyjmujesz (zob. braki danych MCAR, MAR i MNAR). Gdy chcesz porównać FIML z imputacją, zajrzyj do poradnika braki danych i imputacja wielokrotna w R.
Krok 2. Jak zbudowany jest model krzywej wzrostu
LGM to konfirmacyjna analiza czynnikowa z ładunkami ustalonymi z góry. Każdy pomiar jest wskaźnikiem dwóch albo trzech zmiennych ukrytych: poziomu (i, intercept), tempa liniowego (s, slope) i – w modelu kwadratowym – przyspieszenia (q). W naszym kodowaniu czas t to liczba kwartałów od początku studiów (0, 1, 2, 3, 4):
Ładunki poziomu wynoszą 1 we wszystkich pomiarach. Ładunki tempa to wartości czasu (0, 1, 2, 3, 4), a ładunki przyspieszenia – ich kwadraty (0, 1, 4, 9, 16). Średnie zmiennych ukrytych opisują średnią trajektorię. Ich wariancje pokazują, jak bardzo osoby się różnią, a kowariancje – czy start wiąże się z tempem. Funkcja growth() z lavaan (Rosseel, 2012) różni się od cfa() tym, że wyrazy wolne zmiennych obserwowanych ustala na 0 i szacuje średnie zmiennych ukrytych. Domyślnie każdy pomiar ma też własną wariancję reszty. Ile parametrów model może mieć przy danej liczbie pomiarów, wyjaśnia hasło identyfikacja modelu SEM.
Wybieramy estymator MLR, czyli największą wiarygodność z odpornymi błędami standardowymi i przeskalowanym testem χ². Wynik skali to średnia kilku pozycji, więc ma wiele wartości i można go traktować jak zmienną ciągłą. Jeśli analizujesz pojedyncze pozycje z kilkoma kategoriami, zbuduj najpierw model pomiarowy (patrz rozszerzenia).
Krok 3. Kształt zmiany: porównanie modeli
Nie zakładaj z góry, że zmiana jest liniowa. Porównaj kilka modeli bezwarunkowych, czyli bez predyktorów: brak zmiany (tylko poziom), zmianę liniową, kwadratową i model z ładunkami swobodnymi (latent basis). W tym ostatnim ustalamy tylko ładunki pierwszego i ostatniego pomiaru (0 i 1), a pozostałe szacujemy z danych. Kształt średniej trajektorii wynika wtedy z danych, a nie z wybranej funkcji czasu.
Tabela 1
Dopasowanie bezwarunkowych modeli krzywej wzrostu wypalenia akademickiego
| Model | χ² | df | p | CFI | RMSEA [90% CI] | SRMR | BIC |
|---|---|---|---|---|---|---|---|
| Brak zmiany | 580.58 | 13 | < .001 | .673 | .349 [.325, .373] | .234 | 2627.8 |
| Liniowy | 126.68 | 10 | < .001 | .932 | .181 [.154, .209] | .057 | 2193.2 |
| Ładunki swobodne | 52.66 | 7 | < .001 | .975 | .131 [.100, .166] | .044 | 2134.8 |
| Kwadratowy, losowe i, s, qa | 3.82 | 6 | .702 | 1.000 | .000 [.000, .052] | .011 | 2096.2 |
| Kwadratowy, losowe i, s, stałe q | 7.87 | 9 | .548 | 1.000 | .000 [.000, .054] | .015 | 2082.4 |
Uwaga. N = 380. Estymator MLR, braki danych: FIML. χ² – przeskalowana statystyka testu; CFI i RMSEA w wersjach odpornych. a Rozwiązanie niedopuszczalne: ujemne wariancje tempa liniowego i przyspieszenia. Dane symulowane.
Model bez zmiany jest wyraźnie odrzucony. Model liniowy jest dużo lepszy, Δχ²(3) = 439.45, p < .001, ale wciąż źle dopasowany: RMSEA = .181, a CFI = .932. Dodanie przyspieszenia poprawia dopasowanie, Δχ²(4) = 124.90, p < .001 (przeskalowany test różnicy χ² Satorry–Bentlera). Najniższy BIC ma model kwadratowy ze stałym przyspieszeniem (o tym, dlaczego stałym, piszemy w kroku 4); porównywanie modeli kryteriami informacyjnymi omawia hasło AIC i BIC w SEM.
Ciekawy jest model z ładunkami swobodnymi. Oszacowane ładunki (0, .444, .748, .918, 1) dobrze opisują kształt średniej: do 3. miesiąca dokonało się 44.4% całej rocznej zmiany, do 6. – 74.8%, a do 9. – 91.8%. Mimo to model pasuje gorzej niż kwadratowy. Powód leży w różnicach między osobami. W modelu z ładunkami swobodnymi każda osoba ma ten sam kształt krzywej, tylko rozciągnięty w górę albo w dół. Różnice indywidualne muszą więc rosnąć w tym samym tempie co średnia, czyli szybko na początku i prawie wcale później. W naszych danych rozrzut rośnie równomiernie przez cały rok (SD od 0.64 do 0.81), a to lepiej oddaje losowe nachylenie liniowe ze wspólnym dla wszystkich przyspieszeniem.
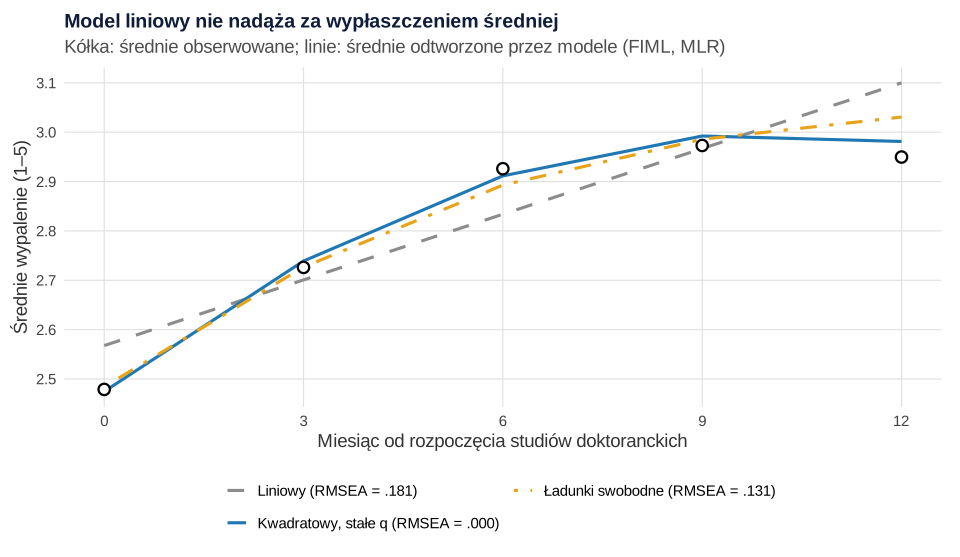
Rysunek 2 pokazuje, dlaczego warto patrzeć nie tylko na indeksy. Wu i in. (2009) zwracają uwagę, że w modelach wzrostu błąd specyfikacji może tkwić w czterech miejscach: w strukturze kowariancji wewnątrz osób i między osobami, w średnich oraz w średnich warunkowych (po dodaniu predyktorów). Klasyczne indeksy SEM skupiały się na strukturze kowariancji. Dlatego zestaw średnie obserwowane z odtworzonymi przez model i obejrzyj reszty. Wartości odcięcia RMSEA i CFI (Hu i Bentler, 1999) traktuj jako orientację, a nie jako regułę, zwłaszcza że w LGM mamy mało stopni swobody. Szerzej o tym w haśle SRMR i w przewodniku CB-SEM – założenia i interpretacja.
Krok 4. Ujemna wariancja i model ze stałym przyspieszeniem
Model kwadratowy z trzema losowymi czynnikami dopasował się świetnie, χ²(6) = 3.82, p = .702, ale lavaan zgłosił ostrzeżenie: some estimated lv variances are negative. Wariancja tempa liniowego wyniosła −0.012, a przyspieszenia −0.001. Ujemna wariancja nie ma sensu, więc rozwiązanie jest niedopuszczalne (zob. przypadek Heywooda). Nie interpretuj takiego modelu, nawet przy idealnych indeksach.
Częsta przyczyna to nadmiar losowych efektów. Pięć pomiarów to mało, by rzetelnie oszacować różnice między osobami w przyspieszeniu, a jeśli w populacji tych różnic prawie nie ma, oszacowanie wariancji spada poniżej zera. Najprostsze rozwiązanie to uznać przyspieszenie za wspólne dla wszystkich: wariancję q i jej kowariancje ustalamy na 0, a średnią q nadal szacujemy. Taki model jest dopuszczalny i dobrze dopasowany, χ²(9) = 7.87, p = .548, CFI = 1.000, RMSEA = .000, 90% CI [.000, .054], SRMR = .015. Nie jest istotnie gorszy od modelu pełnego, Δχ²(3) = 4.08, p = .253, a ma niższy BIC (2082.4 wobec 2096.2). Pamiętaj, że test różnicy jest tu tylko przybliżony, bo sprawdza wariancję na granicy możliwych wartości (wariancja nie może być mniejsza od zera). Dlatego decyzję opieraj też na dopuszczalności rozwiązania i kryteriach informacyjnych.
W pracy opisz tę decyzję wprost: pełny model był niedopuszczalny, więc ustalono wariancję przyspieszenia na zero. Recenzent zobaczy wtedy, że nie ukrywasz problemu, tylko świadomie uprościłeś model.
Krok 5. Interpretacja parametrów krzywej
W modelu ze stałym przyspieszeniem średni poziom początkowy wyniósł 2.475, 95% CI [2.412, 2.538]. Średnie tempo liniowe wyniosło 0.310 punktu na kwartał, 95% CI [0.277, 0.343], a przyspieszenie −0.046, 95% CI [−0.053, −0.038]. W modelu kwadratowym parametr s nie jest „średnią zmianą na kwartał”. To tempo zmiany w chwili t = 0, czyli na samym początku studiów. Ujemne przyspieszenie oznacza, że tempo spada o 2 × 0.046 = 0.092 punktu na każdy kwartał. Średnia trajektoria osiąga szczyt po −0.310 / (2 × −0.046) = 3.38 kwartału, czyli po około 10 miesiącach, a potem lekko opada. Model dobrze odtwarza średnie: przewidywane wartości (2.47, 2.74, 2.91, 2.99, 2.98) różnią się od obserwowanych najwyżej o 0.03.
Wariancje pokazują różnice indywidualne. Wariancja poziomu wyniosła 0.322 (SD = 0.57), a tempa 0.017 (SD = 0.13). Przy średnim tempie 0.31 i SD = 0.13 większość doktorantów ma na starcie wypalenie rosnące, ale u części osób rośnie ono dwa razy szybciej niż u innych. Kowariancja poziomu i tempa była bliska zeru, −0.006, 95% CI [−0.017, 0.004] (korelacja −.08). Według modelu wyższe wypalenie na starcie nie zapowiada więc szybszego ani wolniejszego wzrostu na początku roku. Ta interpretacja zależy jednak od kodowania czasu, o czym w kolejnym kroku.
Wariancje i kowariancje czynników wzrostu to efekty losowe, a średnie – efekty stałe. Ta sama terminologia pojawi się w modelu mieszanym w kroku 7.
Kodowanie czasu zmienia znaczenie parametrów
Poziom i to przewidywany wynik w chwili, w której czas wynosi 0. Jeśli bardziej interesuje Cię stan po roku niż na starcie, przesuń zero na ostatni pomiar: ładunki tempa to wtedy −4, −3, −2, −1, 0, a przyspieszenia 16, 9, 4, 1, 0. Dopasowanie modelu się nie zmienia (χ²(9) = 7.87), bo to ten sam model w innej parametryzacji. Zmieniają się za to parametry:
| Parametr | Zero na początku roku (0…4) | Zero na końcu roku (−4…0) |
|---|---|---|
| Średnia poziomu i | 2.475 (wynik w 0. miesiącu) | 2.981 (wynik w 12. miesiącu) |
| Średnie tempo s | 0.310 (tempo na starcie) | −0.057 (tempo na końcu roku) |
| Przyspieszenie q | −0.046 | −0.046 |
| Wariancja poziomu | 0.322 | 0.548 |
| Korelacja poziomu i tempa | −.08 | .65 |
Korelacja poziomu i tempa zmieniła się z −.08 na .65, choć dane i model są te same. Przy zerze na końcu roku znaczy ona coś innego: osoby z wyższym wypaleniem po roku to te, u których na końcu roku wypalenie nadal rosło. Biesanz i in. (2004) pokazują, że kodowanie czasu jednoznacznie wyznacza oszacowania i błędy standardowe parametrów niższego rzędu oraz moc testów dla ich predyktorów. Zalecają kodować czas tak, by parametry dało się łatwo zinterpretować, i pokazywać efekty na wykresie w całym przedziale czasu, z przedziałami ufności. Mehta i West (2000) opisują ten sam problem, gdy uczestnicy zaczynają badanie w różnym wieku: wybór metryki czasu przypomina wtedy centrowanie predyktorów w modelu wielopoziomowym.
Przy nierównych odstępach między pomiarami ładunki muszą odpowiadać rzeczywistemu czasowi (np. 0, 1, 3, 6, 12 miesięcy), a nie numerom pomiarów. Jeśli każdy uczestnik był badany w innym terminie, łatwiej będzie użyć modelu mieszanego z indywidualnym czasem albo tzw. zmiennych definicyjnych (definition variables) w SEM.
Krok 6. Model warunkowy: wsparcie promotora
Model z predyktorami czynników wzrostu nazywa się warunkowym. Wsparcie promotora (zmierzone na starcie) przewiduje poziom i tempo, ale nie przyspieszenie, które pozostaje wspólne dla wszystkich. Wsparcie jest standaryzowane, więc średnie i i s w tym modelu dotyczą osoby z przeciętnym wsparciem. Model pasował dobrze, χ²(12) = 8.75, p = .724, CFI = 1.000, TLI = 1.002, RMSEA = .000, 90% CI [.000, .040], SRMR = .014.
- Poziom początkowy: o 1 SD wyższe wsparcie wiązało się z niższym wypaleniem na starcie, b = −0.171, SE = 0.027, 95% CI [−0.225, −0.117], p < .001, β = −.30. Wsparcie wyjaśniło 9.1% wariancji poziomu.
- Tempo: wyższe wsparcie wiązało się z wolniejszym wzrostem wypalenia, b = −0.059 punktu na kwartał, SE = 0.008, 95% CI [−0.074, −0.043], p < .001, β = −.45. Wsparcie wyjaśniło 20.0% wariancji tempa.
- Po kontroli wsparcia korelacja reszt poziomu i tempa wyniosła −.25. Część różnic w starcie i tempie ma więc wspólne źródło poza wsparciem promotora.
Współczynniki dla tempa trudno sobie wyobrazić, dlatego przelicz je na przewidywane wyniki. W lavaan wystarczy nadać parametrom etykiety i zdefiniować nowe wielkości operatorem :=. Po roku przewidywane wypalenie przy wsparciu o 1 SD poniżej średniej wynosi 3.388, 95% CI [3.286, 3.489], a przy wsparciu o 1 SD powyżej średniej 2.574, 95% CI [2.481, 2.668]. Różnica to −0.813 punktu, 95% CI [−0.949, −0.677]. Na początku studiów różnica była ponad dwa razy mniejsza (2.646 wobec 2.304).
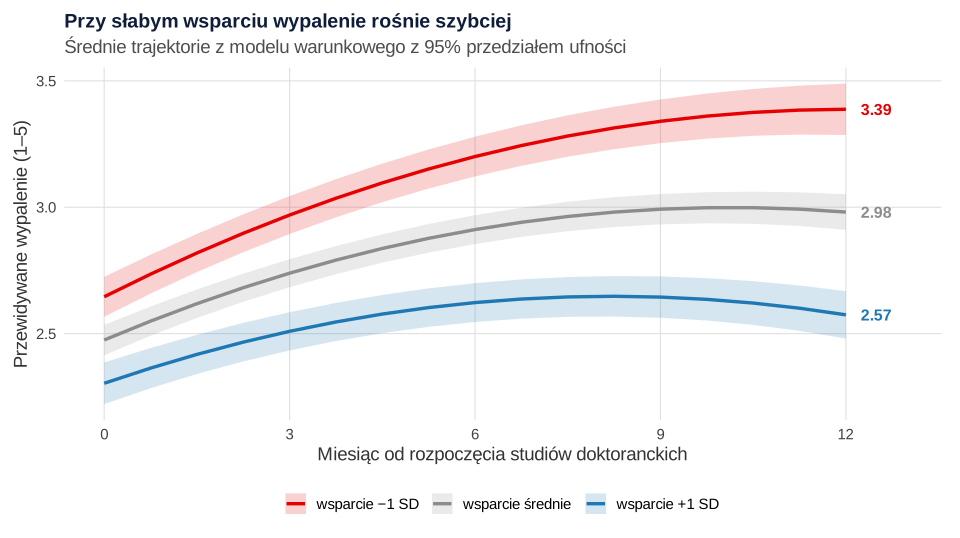
Uważaj z językiem przyczynowym. Wsparcie nie było manipulowane, a doktoranci z lepszym wsparciem mogą różnić się wieloma innymi cechami: dziedziną, finansowaniem, stażem naukowym. Napisz „wyższe wsparcie wiązało się z wolniejszym wzrostem wypalenia”, a nie „wsparcie hamuje wypalenie” (zob. korelacja a przyczynowość). Do modelu warunkowego możesz dodać kilka predyktorów naraz, także zmienne kontrolne, i zinterpretować je jak w regresji wielorakiej, tyle że zmienną zależną jest poziom albo tempo.
Krok 7. Ten sam model jako model mieszany
Krzywą wzrostu można zapisać także jako model mieszany (wielopoziomowy) z pomiarami zagnieżdżonymi w osobach. W formacie długim mamy 1798 obserwacji, a model w lme4 zawiera stały efekt czasu, czasu do kwadratu, wsparcia i interakcji wsparcia z czasem oraz losowy wyraz wolny i losowe nachylenie czasu. Oszacowania metodą ML są identyczne z LGM, w którym wariancje reszt we wszystkich pomiarach są równe: wyraz wolny 2.475, tempo 0.310, przyspieszenie −0.046, efekt wsparcia −0.171 i interakcja −0.059. Wariancja losowego wyrazu wolnego wyniosła 0.296, nachylenia 0.014, a reszty 0.074, i obie funkcje dały tę samą log-wiarygodność (−949.89).
Mehta i West (2000) wykazali tę równoważność formalnie: LGM szacowany z indywidualnych wektorów danych daje te same oszacowania co model wielopoziomowy. Różnica leży więc w wygodzie i domyślnych założeniach, a nie w wyniku:
| Sytuacja | Wygodniej w LGM (lavaan) | Wygodniej w modelu mieszanym (lme4, nlme) |
|---|---|---|
| Wariancje reszt w pomiarach | domyślnie różne, łatwo testować równość | domyślnie równe |
| Każda osoba badana w innym terminie | wymaga dodatkowych technik | czas jako zmienna w danych, bez kłopotu |
| Wiele pomiarów (np. 20+ dzienników) | dużo kolumn, trudna specyfikacja | naturalne |
| Konstrukt mierzony kilkoma pozycjami w każdym pomiarze | model pomiarowy i inwariancja w jednym modelu | zwykle tylko wynik skali |
| Czynniki wzrostu jako predyktory innych zmiennych | tak, np. tempo zmiany → wynik końcowy | trudne |
| Globalne dopasowanie (χ², CFI, RMSEA) | tak | tylko porównania modeli (LRT, AIC, BIC) |
W przykładzie test równości wariancji reszt w LGM nie wykazał różnic, Δχ²(4) = 1.29, p = .863 (wariancje od 0.069 do 0.084), więc oba zapisy są tu równie dobre. Pełną sekwencję modeli wielopoziomowych z centrowaniem i losowymi nachyleniami pokazujemy w poradniku model wielopoziomowy krok po kroku, a wybór między ANOVA a modelem mieszanym dla pomiarów powtarzanych – we wspomnianym wyżej tekście o ANOVA i modelu mieszanym.
Jak opisać krzywą wzrostu w artykule (APA)
W części „Metoda” podaj: liczbę i odstępy pomiarów, kodowanie czasu, porównywane modele, estymator, sposób postępowania z brakami i odsetek braków w każdym pomiarze, a także wszystkie ograniczenia nałożone na model (tu: stała wariancja przyspieszenia). W wynikach pokaż tabelę porównania modeli (jak tabela 1), parametry modelu końcowego i wykres trajektorii. Wzory tabel dopasowania znajdziesz w haśle tabela dopasowania modelu w APA.
Tabela 2
Parametry warunkowego modelu krzywej wzrostu wypalenia akademickiego z wsparciem promotora jako predyktorem
| Parametr | b | SE | 95% CI | β | |
|---|---|---|---|---|---|
| LL | UL | ||||
| Średnie czynników wzrostu | |||||
| Poziom początkowy (i) | 2.475 | 0.031 | 2.415 | 2.535 | – |
| Tempo liniowe (s) | 0.310 | 0.017 | 0.278 | 0.343 | – |
| Przyspieszenie (q) | −0.046 | 0.004 | −0.054 | −0.038 | – |
| Wsparcie promotora | |||||
| → poziom początkowy | −0.171 | 0.027 | −0.225 | −0.117 | −.30 |
| → tempo liniowe | −0.059 | 0.008 | −0.074 | −0.043 | −.45 |
Uwaga. N = 380. Czas kodowany w kwartałach od początku studiów (0–4); wariancja przyspieszenia ustalona na 0. Wsparcie standaryzowane (M = 0, SD = 1), więc średnie czynników dotyczą osoby z przeciętnym wsparciem. Estymator MLR, braki danych: FIML. R² = .09 dla poziomu i R² = .20 dla tempa. Dopasowanie: χ²(12) = 8.75, p = .724, CFI = 1.000, RMSEA = .000, 90% CI [.000, .040], SRMR = .014. LL i UL – dolna i górna granica przedziału ufności. Dane symulowane.
Wzór opisu wyników:
Rozszerzenia: co dalej z modelem zmiany
- Krzywa wzrostu dla zmiennej ukrytej. Gdy w każdym pomiarze masz kilka pozycji, możesz zbudować model drugiego rzędu: najpierw czynnik wypalenia w każdym pomiarze, potem krzywą wzrostu tych czynników. Warunkiem jest inwariancja pomiaru w czasie. Widaman i in. (2010) pokazują, że jeśli ograniczenia inwariancji są spełnione, wyniki zmiennej ukrytej w kolejnych pomiarach mają tę samą metrykę, a wnioski o zmianie są mocniejsze. Procedurę testowania inwariancji opisuje poradnik inwariancja pomiaru krok po kroku.
- Zmienne zmieniające się w czasie. Jeśli w każdym pomiarze mierzysz też np. obciążenie pracą, możesz dodać je jako predyktor pomiarów. Curran i Bauer (2011) podkreślają, że dane podłużne pozwalają rozdzielić efekt międzyosobowy (osoby bardziej obciążone są bardziej wypalone) od wewnątrzosobowego (w okresach większego obciążenia ta sama osoba jest bardziej wypalona), ale ta możliwość często pozostaje niewykorzystana.
- Dwa procesy naraz. W modelu równoległych procesów korelujesz czynniki wzrostu dwóch zmiennych, np. tempo wypalenia z tempem spadku satysfakcji. Jeśli pytasz o to, która zmiana poprzedza którą w obrębie osoby, sięgnij po RI-CLPM. Hamaker i in. (2015) wyjaśniają, dlaczego klasyczny CLPM myli różnice stałe między osobami z procesem wewnątrzosobowym; szczegóły znajdziesz we wpisie modele cross-lagged.
- Podgrupy trajektorii. Model mieszanin wzrostu (GMM) szuka klas osób o odmiennym przebiegu zmiany. Nylund i in. (2007) wskazują w symulacjach, że do wyboru liczby klas najlepiej sprawdzają się BIC i bootstrapowy test ilorazu wiarygodności. Bauer i Curran (2003) ostrzegają jednak, że przy nienormalnym rozkładzie pomiarów GMM może wskazać kilka klas, choć w populacji jest tylko jedna. Logikę klas ukrytych omawia poradnik analiza klas latentnych (LCA).
- Efekt sufitu i podłogi. Jeśli wiele osób osiąga maksimum skali, zwykły model wzrostu może źle oddać kształt zmiany. Wang i in. (2008) pokazali w symulacjach, że przy 10–40% obserwacji na górnej granicy zwykłe modele krzywej wzrostu prowadziły do błędnego wyboru modelu i obciążonych oszacowań, a model typu Tobit radził sobie dobrze (zob. efekt sufitu i efekt podłogi).
Najczęstsze błędy w analizie krzywych wzrostu
- Założenie liniowości bez sprawdzenia. Porównaj przynajmniej model liniowy, kwadratowy i z ładunkami swobodnymi, zestaw średnie odtworzone z obserwowanymi i obejrzyj wykres trajektorii.
- Interpretacja niedopuszczalnego rozwiązania. Ujemna wariancja oznacza, że model trzeba uprościć albo przemyśleć. Dobre indeksy dopasowania tego nie zmieniają.
- Nachylenie w modelu kwadratowym czytane jako średnia zmiana. Przy członie kwadratowym s to tempo w chwili t = 0. Średnią zmianę w całym okresie policz z przewidywanych wartości.
- Korelacja poziomu i tempa bez informacji o kodowaniu czasu. Zawsze podaj, gdzie jest zero. Ta sama korelacja może wynosić −.08 albo .65.
- Ładunki równe numerom pomiarów przy nierównych odstępach. Ładunki muszą odpowiadać rzeczywistemu czasowi.
- Analiza tylko osób z kompletem pomiarów. Przy odpadaniu zależnym od wcześniejszych wyników to prosta droga do obciążonej trajektorii. Użyj FIML i opisz braki.
- Za mało pomiarów na model. Trzy pomiary dają w modelu liniowym jeden stopień swobody, a model kwadratowy jest wtedy niezidentyfikowany.
- Język przyczynowy przy predyktorach czynników wzrostu. Predyktor mierzony na starcie wyjaśnia różnice w trajektoriach, ale nie dowodzi wpływu.
Jeśli przygotowujesz rozdział doktoratu albo artykuł z danymi podłużnymi i chcesz, by ktoś sprawdził specyfikację modelu, kodowanie czasu i opis wyników przed wysłaniem do recenzji, zajrzyj do oferty analiz dla badaczy.
Przykład w R
Kod odtwarza wszystkie liczby, tabele i rysunki z tego poradnika. Uruchom przepisy po kolei w katalogu roboczym: przepis 1 tworzy plik CSV, a kolejne go wczytują (możesz też od razu pobrać dane i zacząć od przepisu 2).
1. Dane: symulacja i przegląd pomiarów
R
# B85, przepis 1: dane do przykładu (dane symulowane) – wypalenie akademickie doktorantów w pierwszym roku
# 380 osób, 5 pomiarów co 3 miesiące (październik, styczeń, kwiecień, lipiec, październik),
# wynik skali = średnia pozycji 1–5; wsparcie promotora (wynik z, pomiar 1); odpadanie zależne od wcześniejszego wyniku (MAR)
set.seed(8521)
n <- 380
czas <- 0:4                                        # kwartały od początku studiów
wsparcie <- round(as.numeric(scale(rnorm(n))), 2)   # wynik z: M = 0, SD = 1
# poziom początkowy (i), tempo liniowe (s) i stałe przyspieszenie kwadratowe (q)
S <- matrix(c(0.55^2, -0.25 * 0.55 * 0.12,
              -0.25 * 0.55 * 0.12, 0.12^2), 2)
u <- MASS::mvrnorm(n, c(0, 0), S)
i <- 2.45 - 0.18 * wsparcie + u[, 1]
s <- 0.30 - 0.06 * wsparcie + u[, 2]
q <- -0.045
w <- sapply(czas, function(t) i + s * t + q * t^2 + rnorm(n, 0, 0.28))
w <- pmin(pmax(w, 1), 5)
colnames(w) <- paste0("w", 1:5)
# odpadanie: im wyższe wypalenie w poprzednim pomiarze, tym większa szansa rezygnacji (MAR)
aktywny <- rep(TRUE, n)
for (k in 2:5) {
  p_odp <- plogis(-3.6 + 0.55 * (w[, k - 1] - 2.7))
  aktywny <- aktywny & (runif(n) > p_odp)
  w[!aktywny, k] <- NA
}
dane <- data.frame(id = 1:n, wsparcie = wsparcie, round(w, 2))
write.csv(dane, "krzywe-wzrostu-lgm-dane.csv", row.names = FALSE, na = "")

# Przegląd: liczebność w każdym pomiarze, średnie, odchylenia, korelacje między pomiarami
dim(dane)
round(c(M_wsparcie = mean(dane$wsparcie), SD_wsparcie = sd(dane$wsparcie)), 2)
opis <- data.frame(n = colSums(!is.na(dane[, 3:7])),
                   M = colMeans(dane[, 3:7], na.rm = TRUE),
                   SD = apply(dane[, 3:7], 2, sd, na.rm = TRUE))
round(opis, 2)
round(100 * mean(is.na(dane$w5)), 1)                       # % osób bez ostatniego pomiaru
round(cor(dane[, 3:7], use = "pairwise.complete.obs"), 2)
# czy osoby, które odpadły przed ostatnim pomiarem, różniły się na starcie?
round(tapply(dane$w1, is.na(dane$w5), mean), 2)
Wynik w R
[1] 380   7
 M_wsparcie SD_wsparcie
          0           1
     n    M   SD
w1 380 2.48 0.64
w2 373 2.73 0.62
w3 365 2.93 0.67
w4 350 2.97 0.71
w5 330 2.95 0.81
[1] 13.2
     w1   w2   w3   w4   w5
w1 1.00 0.78 0.76 0.67 0.58
w2 0.78 1.00 0.82 0.78 0.73
w3 0.76 0.82 1.00 0.83 0.80
w4 0.67 0.78 0.83 1.00 0.85
w5 0.58 0.73 0.80 0.85 1.00
FALSE  TRUE
 2.46  2.61
2. Modele bezwarunkowe i kodowanie czasu
R
# B85, przepis 2: bezwarunkowe modele krzywej wzrostu – brak zmiany, liniowy, kwadratowy, ładunki swobodne
library(lavaan)
dane <- read.csv("krzywe-wzrostu-lgm-dane.csv")

m_brak <- ' i =~ 1*w1 + 1*w2 + 1*w3 + 1*w4 + 1*w5 '
m_lin  <- ' i =~ 1*w1 + 1*w2 + 1*w3 + 1*w4 + 1*w5
            s =~ 0*w1 + 1*w2 + 2*w3 + 3*w4 + 4*w5 '
m_kw   <- ' i =~ 1*w1 + 1*w2 + 1*w3 + 1*w4 + 1*w5
            s =~ 0*w1 + 1*w2 + 2*w3 + 3*w4 + 4*w5
            q =~ 0*w1 + 1*w2 + 4*w3 + 9*w4 + 16*w5 '
m_bazy <- ' i =~ 1*w1 + 1*w2 + 1*w3 + 1*w4 + 1*w5
            s =~ 0*w1 + w2 + w3 + w4 + 1*w5 '          # ładunki w2–w4 szacowane z danych (latent basis)

dopasuj <- function(m) growth(m, data = dane, missing = "fiml", estimator = "MLR")
modele <- list(brak = dopasuj(m_brak), liniowy = dopasuj(m_lin), kwadratowy = dopasuj(m_kw), bazy = dopasuj(m_bazy))
sapply(modele, function(f) c(zbiezny = lavInspect(f, "converged"), dopuszczalny = lavInspect(f, "post.check")))

indeksy <- c("npar", "chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "tli.robust",
             "rmsea.robust", "rmsea.ci.lower.robust", "rmsea.ci.upper.robust", "srmr", "aic", "bic")
round(t(sapply(modele, fitMeasures, indeksy)), 3)

# Testy różnicy (przeskalowane, Satorra–Bentler) dla modeli zagnieżdżonych
lavTestLRT(modele$liniowy, modele$brak)
lavTestLRT(modele$kwadratowy, modele$liniowy)

# Model kwadratowy: wariancja q bliska zeru -> model z losowym i, s i stałym q
pk2 <- parameterEstimates(modele$kwadratowy)
pk2 <- pk2[pk2$op == "~~" & pk2$lhs %in% c("i", "s", "q") & pk2$rhs %in% c("i", "s", "q"), c("lhs", "op", "rhs", "est", "se", "pvalue")]
pk2[, 4:6] <- round(pk2[, 4:6], 3); pk2
m_kw_q <- paste(m_kw, '
            q ~~ 0*q
            q ~~ 0*i
            q ~~ 0*s ')
kw_q <- dopasuj(m_kw_q)
round(fitMeasures(kw_q, indeksy), 3)
lavTestLRT(modele$kwadratowy, kw_q)

# Parametry modelu końcowego (losowe i oraz s, stałe q)
pe <- parameterEstimates(kw_q)
pe <- pe[(pe$op == "~1" & pe$lhs %in% c("i", "s", "q")) | (pe$op == "~~" & pe$lhs %in% c("i", "s") & pe$rhs %in% c("i", "s")),
         c("lhs", "op", "rhs", "est", "se", "pvalue", "ci.lower", "ci.upper")]
pe[, 4:8] <- round(pe[, 4:8], 3); pe
round(lavInspect(kw_q, "cor.lv")["i", "s"], 3)          # korelacja poziomu i tempa
# SD wariancji wzrostu i wierzchołek średniej trajektorii (kwartał, w którym średnia przestaje rosnąć)
w <- coef(kw_q)
round(c(SD_i = sqrt(w[["i~~i"]]), SD_s = sqrt(w[["s~~s"]]), wierzcholek = -w[["s~1"]] / (2 * w[["q~1"]])), 3)
# Średnie przewidywane przez model a średnie obserwowane (FIML: estymowane średnie zmiennych jawnych)
round(rbind(model = fitted(kw_q)$mean, dane = colMeans(dane[, 3:7], na.rm = TRUE)), 2)
# Ładunki swobodne (model bazowy) – kształt zmiany bez zakładania funkcji
lb <- parameterEstimates(modele$bazy)
round(lb[lb$lhs == "s" & lb$op == "=~", "est"], 3)

# Inne kodowanie czasu: poziom = wynik w ostatnim pomiarze (ładunki −4…0)
m_kon <- ' i =~ 1*w1 + 1*w2 + 1*w3 + 1*w4 + 1*w5
           s =~ -4*w1 + -3*w2 + -2*w3 + -1*w4 + 0*w5
           q =~ 16*w1 + 9*w2 + 4*w3 + 1*w4 + 0*w5
           q ~~ 0*q
           q ~~ 0*i
           q ~~ 0*s '
kon <- dopasuj(m_kon)
pk <- parameterEstimates(kon)
pk <- pk[(pk$op == "~1" & pk$lhs %in% c("i", "s", "q")) | (pk$op == "~~" & pk$lhs %in% c("i", "s") & pk$rhs %in% c("i", "s")),
         c("lhs", "op", "rhs", "est", "se")]
pk[, 4:5] <- round(pk[, 4:5], 3); pk
round(lavInspect(kon, "cor.lv")["i", "s"], 3)
round(fitMeasures(kon, c("chisq.scaled", "df.scaled", "cfi.robust")), 3)
Wynik w R
             brak liniowy kwadratowy bazy
zbiezny      TRUE    TRUE       TRUE TRUE
dopuszczalny TRUE    TRUE      FALSE TRUE
           npar chisq.scaled df.scaled pvalue.scaled cfi.robust tli.robust
brak          7      580.582        13         0.000      0.673      0.748
liniowy      10      126.675        10         0.000      0.932      0.932
kwadratowy   14        3.815         6         0.702      1.000      1.002
bazy         13       52.662         7         0.000      0.975      0.964
           rmsea.robust rmsea.ci.lower.robust rmsea.ci.upper.robust  srmr
brak              0.349                 0.325                 0.373 0.234
liniowy           0.181                 0.154                 0.209 0.057
kwadratowy        0.000                 0.000                 0.052 0.011
bazy              0.131                 0.100                 0.166 0.044
                aic      bic
brak       2600.243 2627.824
liniowy    2153.776 2193.178
kwadratowy 2041.035 2096.197
bazy       2083.613 2134.835

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

               Df    AIC    BIC  Chisq Chisq diff Df diff Pr(>Chisq)
modele$liniowy 10 2153.8 2193.2 124.53
modele$brak    13 2600.2 2627.8 577.00     439.45       3  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

                  Df    AIC    BIC    Chisq Chisq diff Df diff Pr(>Chisq)
modele$kwadratowy  6 2041.0 2096.2   3.7917
modele$liniowy    10 2153.8 2193.2 124.5331      124.9       4  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   lhs op rhs    est    se pvalue
21   i ~~   i  0.299 0.030  0.000
22   s ~~   s -0.012 0.016  0.445
23   q ~~   q -0.001 0.001  0.128
24   i ~~   s  0.018 0.017  0.307
25   i ~~   q -0.005 0.004  0.196
26   s ~~   q  0.006 0.003  0.073
                 npar          chisq.scaled             df.scaled
               11.000                 7.867                 9.000
        pvalue.scaled            cfi.robust            tli.robust
                0.548                 1.000                 1.001
         rmsea.robust rmsea.ci.lower.robust rmsea.ci.upper.robust
                0.000                 0.000                 0.054
                 srmr                   aic                   bic
                0.015              2039.016              2082.358

Scaled Chi-Squared Difference Test (method = “satorra.bentler.2001”)

lavaan->lavTestLRT():
   lavaan NOTE: The “Chisq” column contains standard test statistics, not the
   robust test that should be reported per model. A robust difference test is
   a function of two standard (not robust) statistics.

                  Df  AIC    BIC  Chisq Chisq diff Df diff Pr(>Chisq)
modele$kwadratowy  6 2041 2096.2 3.7917
kw_q               9 2039 2082.4 7.7729     4.0784       3     0.2531
   lhs op rhs    est    se pvalue ci.lower ci.upper
24   i ~~   i  0.322 0.026  0.000    0.272    0.372
25   s ~~   s  0.017 0.002  0.000    0.014    0.021
26   i ~~   s -0.006 0.005  0.239   -0.017    0.004
32   i ~1      2.475 0.032  0.000    2.412    2.538
33   s ~1      0.310 0.017  0.000    0.277    0.343
34   q ~1     -0.046 0.004  0.000   -0.053   -0.038
[1] -0.083
       SD_i        SD_s wierzcholek
      0.567       0.131       3.379
        w1   w2   w3   w4   w5
model 2.47 2.74 2.91 2.99 2.98
dane  2.48 2.73 2.93 2.97 2.95
[1] 0.000 0.444 0.748 0.918 1.000
   lhs op rhs    est    se
24   i ~~   i  0.548 0.044
25   s ~~   s  0.017 0.002
26   i ~~   s  0.063 0.008
32   i ~1      2.981 0.042
33   s ~1     -0.057 0.018
34   q ~1     -0.046 0.004
[1] 0.646
chisq.scaled    df.scaled   cfi.robust
       7.867        9.000        1.000

# Komunikaty i ostrzeżenia:
# OSTRZEŻENIE: lavaan->lav_object_post_check():
   some estimated lv variances are negative
# OSTRZEŻENIE: lavaan->lav_object_post_check():
   some estimated lv variances are negative
# OSTRZEŻENIE: diag(V) had non-positive or NA entries; the non-finite result may be dubious
# OSTRZEŻENIE: diag(V) had non-positive or NA entries; the non-finite result may be dubious
3. Model warunkowy z predyktorem
R
# B85, przepis 3: model warunkowy – wsparcie promotora jako predyktor poziomu i tempa wzrostu wypalenia
library(lavaan)
dane <- read.csv("krzywe-wzrostu-lgm-dane.csv")
m_war <- '
  i =~ 1*w1 + 1*w2 + 1*w3 + 1*w4 + 1*w5
  s =~ 0*w1 + 1*w2 + 2*w3 + 3*w4 + 4*w5
  q =~ 0*w1 + 1*w2 + 4*w3 + 9*w4 + 16*w5
  q ~~ 0*q
  q ~~ 0*i
  q ~~ 0*s
  i ~ gi*wsparcie
  s ~ gs*wsparcie
  i ~ ai*1
  s ~ as*1
  q ~ aq*1
  # przewidywana średnia w ostatnim pomiarze (kwartał 4) przy wsparciu −1 SD i +1 SD oraz różnica
  w5_nisk := (ai - gi) + 4*(as - gs) + 16*aq
  w5_wys  := (ai + gi) + 4*(as + gs) + 16*aq
  roznica_w5 := w5_wys - w5_nisk
'
war <- growth(m_war, data = dane, missing = "fiml", estimator = "MLR")
lavInspect(war, "converged"); lavInspect(war, "post.check")
round(fitMeasures(war, c("chisq.scaled", "df.scaled", "pvalue.scaled", "cfi.robust", "tli.robust",
                         "rmsea.robust", "rmsea.ci.lower.robust", "rmsea.ci.upper.robust", "srmr")), 3)
pe <- parameterEstimates(war, standardized = TRUE)
w <- pe[pe$op %in% c("~", "~1", ":=") & pe$lhs %in% c("i", "s", "q", "w5_nisk", "w5_wys", "roznica_w5"),
        c("lhs", "op", "rhs", "est", "se", "z", "pvalue", "ci.lower", "ci.upper")]
w[, 4:9] <- round(w[, 4:9], 3); w
round(pe[pe$op == "~", c("lhs", "rhs", "std.all")][, 3], 3)     # standaryzowane współczynniki dla i oraz s
round(lavInspect(war, "r2")[c("i", "s")], 3)
# reszty wariancji i, s oraz ich korelacja po kontroli wsparcia
psi <- lavInspect(war, "est")$psi[c("i", "s"), c("i", "s")]
round(psi, 3)
round(cov2cor(psi)[1, 2], 3)

# Średnia trajektoria przy wsparciu −1 SD, 0 i +1 SD (z przedziałem ufności) – dane do rysunku 3
siatka <- expand.grid(t = seq(0, 4, by = 0.25), x = c(-1, 0, 1))
V <- vcov(war)[c("ai", "as", "aq", "gi", "gs"), c("ai", "as", "aq", "gi", "gs")]
b <- coef(war)[c("ai", "as", "aq", "gi", "gs")]
G <- cbind(1, siatka$t, siatka$t^2, siatka$x, siatka$x * siatka$t)
siatka$fit <- as.vector(G %*% b)
siatka$se <- sqrt(rowSums((G %*% V) * G))
saveRDS(siatka, "kod/b85-trajektorie-wsparcie.rds")
round(siatka[siatka$t %in% c(0, 4), ], 3)
Wynik w R
[1] TRUE
[1] TRUE
         chisq.scaled             df.scaled         pvalue.scaled
                8.754                12.000                 0.724
           cfi.robust            tli.robust          rmsea.robust
                1.000                 1.002                 0.000
rmsea.ci.lower.robust rmsea.ci.upper.robust                  srmr
                0.000                 0.040                 0.014
          lhs op                     rhs    est    se       z pvalue ci.lower
19          i  ~                wsparcie -0.171 0.027  -6.242      0   -0.225
20          s  ~                wsparcie -0.059 0.008  -7.394      0   -0.074
21          i ~1                          2.475 0.031  80.411      0    2.415
22          s ~1                          0.310 0.017  18.573      0    0.278
23          q ~1                         -0.046 0.004 -11.901      0   -0.054
39    w5_nisk := (ai-gi)+4*(as-gs)+16*aq  3.388 0.052  65.246      0    3.286
40     w5_wys := (ai+gi)+4*(as+gs)+16*aq  2.574 0.048  53.775      0    2.481
41 roznica_w5 :=          w5_wys-w5_nisk -0.813 0.069 -11.705      0   -0.949
   ci.upper
19   -0.117
20   -0.043
21    2.535
22    0.343
23   -0.038
39    3.489
40    2.668
41   -0.677
[1] -0.301 -0.447
    i     s
0.091 0.200
       i      s
i  0.293 -0.016
s -0.016  0.014
[1] -0.254
   t  x   fit    se
1  0 -1 2.646 0.040
17 4 -1 3.388 0.052
18 0  0 2.475 0.031
34 4  0 2.981 0.036
35 0  1 2.304 0.042
51 4  1 2.574 0.048
4. Ta sama krzywa w modelu mieszanym
R
# B85, przepis 4: ta sama krzywa jako model mieszany (lme4) i porównanie z LGM
library(lavaan)
library(lme4)
dane <- read.csv("krzywe-wzrostu-lgm-dane.csv")
# format długi: jeden wiersz = jeden pomiar jednej osoby
dlugi <- reshape(dane, direction = "long", varying = paste0("w", 1:5), v.names = "wypalenie",
                 timevar = "kwartal", times = 0:4, idvar = "id")
dlugi <- dlugi[!is.na(dlugi$wypalenie), ]
nrow(dlugi)                                       # liczba obserwacji użytych w modelu
mm <- lmer(wypalenie ~ kwartal + I(kwartal^2) + wsparcie + wsparcie:kwartal + (1 + kwartal | id),
           data = dlugi, REML = FALSE)
round(summary(mm)$coefficients, 3)
print(VarCorr(mm), comp = c("Variance", "Std.Dev."), digits = 3)

# LGM z równymi wariancjami reszt we wszystkich pomiarach = założenie domyślne modelu mieszanego
m_rowne <- '
  i =~ 1*w1 + 1*w2 + 1*w3 + 1*w4 + 1*w5
  s =~ 0*w1 + 1*w2 + 2*w3 + 3*w4 + 4*w5
  q =~ 0*w1 + 1*w2 + 4*w3 + 9*w4 + 16*w5
  q ~~ 0*q
  q ~~ 0*i
  q ~~ 0*s
  i + s ~ wsparcie
  w1 ~~ e*w1
  w2 ~~ e*w2
  w3 ~~ e*w3
  w4 ~~ e*w4
  w5 ~~ e*w5
'
lgm_rowne <- growth(m_rowne, data = dane, missing = "fiml", estimator = "ML")
pe <- parameterEstimates(lgm_rowne)
round(setNames(pe$est[pe$op %in% c("~1", "~") & pe$lhs %in% c("i", "s", "q")],
               c("i~wsparcie", "s~wsparcie", "i", "s", "q")), 3)
round(c(var_i = coef(lgm_rowne)[["i~~i"]], var_s = coef(lgm_rowne)[["s~~s"]], reszta = coef(lgm_rowne)[["e"]]), 3)
round(c(logLik_lmer = as.numeric(logLik(mm)), logLik_lavaan = as.numeric(logLik(lgm_rowne))), 2)

# Czy wariancje reszt można uznać za równe? Porównanie z LGM o swobodnych wariancjach reszt (ML)
lgm_wolne <- growth(sub("  w1 ~~ e\\*w1\n  w2 ~~ e\\*w2\n  w3 ~~ e\\*w3\n  w4 ~~ e\\*w4\n  w5 ~~ e\\*w5\n", "", m_rowne),
                    data = dane, missing = "fiml", estimator = "ML")
round(coef(lgm_wolne)[paste0("w", 1:5, "~~w", 1:5)], 3)
anova(lgm_rowne, lgm_wolne)
Wynik w R
[1] 1798
                 Estimate Std. Error t value
(Intercept)         2.475      0.031  80.268
kwartal             0.310      0.017  18.135
I(kwartal^2)       -0.046      0.004 -11.819
wsparcie           -0.171      0.030  -5.697
kwartal:wsparcie   -0.059      0.008  -7.540
 Groups   Name        Variance Std.Dev. Corr
 id       (Intercept) 0.2957   0.544
          kwartal     0.0144   0.120    -0.27
 Residual             0.0738   0.272
i~wsparcie s~wsparcie          i          s          q
    -0.171     -0.059      2.475      0.310     -0.046
 var_i  var_s reszta
 0.296  0.014  0.074
  logLik_lmer logLik_lavaan
      -949.89       -949.89
w1~~w1 w2~~w2 w3~~w3 w4~~w4 w5~~w5
 0.080  0.069  0.074  0.071  0.084

Chi-Squared Difference Test

          Df    AIC    BIC  Chisq Chisq diff Df diff Pr(>Chisq)
lgm_wolne 12 1924.5 1975.7 8.5946
lgm_rowne 16 1917.8 1953.2 9.8830     1.2884       4     0.8633
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lavaan (modele krzywej wzrostu), lme4 (model mieszany) i MASS (symulacja danych); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y., Jorgensen, T. D., & De Wilde, L. (2026). lavaan: Latent variable analysis (R package version 0.7-2) [Computer software]. https://doi.org/10.32614/CRAN.package.lavaan
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Co zrobić, gdy w modelu krzywej wzrostu wariancja nachylenia jest ujemna?
Ujemna wariancja oznacza rozwiązanie niedopuszczalne, więc takiego modelu nie interpretuj, nawet przy dobrych indeksach. Najczęściej model ma za dużo efektów losowych w stosunku do liczby pomiarów. Ustal wariancję problematycznego czynnika (np. przyspieszenia) i jego kowariancje na zero, porównaj modele i opisz tę decyzję w pracy.
Czym różni się kwadratowa krzywa wzrostu od modelu z ładunkami swobodnymi?
Model kwadratowy zakłada konkretną funkcję czasu i dodaje czynnik przyspieszenia. W modelu z ładunkami swobodnymi (latent basis) ustalasz tylko ładunki pierwszego i ostatniego pomiaru, a kształt średniej trajektorii szacujesz z danych. Ten drugi model zakłada jednak, że wszystkie osoby mają ten sam kształt zmiany, różniący się tylko skalą, więc może gorzej odtwarzać różnice indywidualne.
Jak dodać predyktor do krzywej wzrostu w lavaan?
Po zdefiniowaniu czynników wzrostu dopisz regresje, np. i ~ wsparcie i s ~ wsparcie, i oszacuj model funkcją growth(). Współczynnik dla i mówi o różnicy w poziomie, a dla s – w tempie zmiany. Przewidywane wyniki dla wybranych wartości predyktora policzysz, nadając parametrom etykiety i definiując je operatorem :=.
Dlaczego korelacja poziomu początkowego i tempa zmienia się po przekodowaniu czasu?
Poziom oznacza wynik w chwili, w której czas wynosi zero. Gdy przesuniesz zero z pierwszego na ostatni pomiar, poziom staje się wynikiem końcowym, więc jego wariancja i związek z tempem są inne. W przykładzie korelacja zmieniła się z −.08 na .65 przy identycznym dopasowaniu modelu, dlatego w raporcie zawsze podaj kodowanie czasu.
Czy krzywą wzrostu można oszacować, gdy część uczestników odpadła z badania?
Tak. W lavaan użyj missing = "fiml", a każda osoba wniesie do modelu wszystkie dostępne pomiary. Oszacowania są nieobciążone, jeśli braki zależą od zmierzonych zmiennych (MAR). W pracy podaj odsetek braków w każdym pomiarze i porównaj osoby, które odpadły, z pozostałymi.
Powiązane hasła
Przeczytaj też
Modele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikBadanie podłużne w doktoracie
Liczba pomiarów i odstępy, moc w symulacji, rekrutacja z zapasem na odpadanie, kodowanie czasu oraz model mieszany i LGM w R z wzorem opisu.
Czytaj →Masz dane z kilku pomiarów i nie wiesz, jak opisać zmianę?
Pomożemy dobrać model zmiany, sprawdzić kształt trajektorii i dopuszczalność rozwiązania, wykonamy analizę w R i wyjaśnimy wyniki tak, żebyś mógł je opisać w artykule lub rozprawie i obronić przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bauer, D. J., & Curran, P. J. (2003). Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes. Psychological Methods, 8(3), 338–363. https://doi.org/10.1037/1082-989X.8.3.338
- Biesanz, J. C., Deeb-Sossa, N., Papadakis, A. A., Bollen, K. A., & Curran, P. J. (2004). The role of coding time in estimating and interpreting growth curve models. Psychological Methods, 9(1), 30–52. https://doi.org/10.1037/1082-989x.9.1.30
- Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62(1), 583–619. https://doi.org/10.1146/annurev.psych.093008.100356 ● Otwarty dostęp: pełny tekst
- Curran, P. J., Obeidat, K., & Losardo, D. (2010). Twelve frequently asked questions about growth curve modeling. Journal of Cognition and Development, 11(2), 121–136. https://doi.org/10.1080/15248371003699969 ● Otwarty dostęp: pełny tekst
- Enders, C. K., & Bandalos, D. L. (2001). The relative performance of full information maximum likelihood estimation for missing data in structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 8(3), 430–457. https://doi.org/10.1207/s15328007sem0803_5
- Hamaker, E. L., Kuiper, R. M., & Grasman, R. P. P. P. (2015). A critique of the cross-lagged panel model. Psychological Methods, 20(1), 102–116. https://doi.org/10.1037/a0038889 ● Otwarty dostęp: pełny tekst
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. https://doi.org/10.1080/10705519909540118
- Mehta, P. D., & West, S. G. (2000). Putting the individual back into individual growth curves. Psychological Methods, 5(1), 23–43. https://doi.org/10.1037/1082-989x.5.1.23
- Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling: A Multidisciplinary Journal, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
- Ployhart, R. E., & Vandenberg, R. J. (2010). Longitudinal research: The theory, design, and analysis of change. Journal of Management, 36(1), 94–120. https://doi.org/10.1177/0149206309352110
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2). https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Wang, L., Zhang, Z., McArdle, J. J., & Salthouse, T. A. (2008). Investigating ceiling effects in longitudinal data analysis. Multivariate Behavioral Research, 43(3), 476–496. https://doi.org/10.1080/00273170802285941 ● Otwarty dostęp: pełny tekst
- Widaman, K. F., Ferrer, E., & Conger, R. D. (2010). Factorial invariance within longitudinal structural equation models: Measuring the same construct across time. Child Development Perspectives, 4(1), 10–18. https://doi.org/10.1111/j.1750-8606.2009.00110.x ● Otwarty dostęp: pełny tekst
- Wu, W., West, S. G., & Taylor, A. B. (2009). Evaluating model fit for growth curve models: Integration of fit indices from SEM and MLM frameworks. Psychological Methods, 14(3), 183–201. https://doi.org/10.1037/a0015858
Cytowania BibTeX
@article{bauer2003distributional, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={338--363}, doi={10.1037/1082-989x.8.3.338}}@article{biesanz2004role, author={Biesanz, Jeremy C. and Deeb-Sossa, Natalia and Papadakis, Alison A. and Bollen, Kenneth A. and Curran, Patrick J.}, title={{The role of coding time in estimating and interpreting growth curve models}}, journal={Psychological Methods}, year={2004}, volume={9}, number={1}, pages={30--52}, doi={10.1037/1082-989x.9.1.30}}@article{curran2011disaggregation, author={Curran, Patrick J. and Bauer, Daniel J.}, title={{The disaggregation of within-person and between-person effects in longitudinal models of change}}, journal={Annual Review of Psychology}, year={2011}, volume={62}, number={1}, pages={583--619}, doi={10.1146/annurev.psych.093008.100356}}@article{curran2010twelve, author={Curran, Patrick J. and Obeidat, Khawla and Losardo, Diane}, title={{Twelve frequently asked questions about growth curve modeling}}, journal={Journal of Cognition and Development}, year={2010}, volume={11}, number={2}, pages={121--136}, doi={10.1080/15248371003699969}}@article{enders2001relative, author={Enders, Craig K. and Bandalos, Deborah L.}, title={{The relative performance of full information maximum likelihood estimation for missing data in structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2001}, volume={8}, number={3}, pages={430--457}, doi={10.1207/s15328007sem0803_5}}@article{hamaker2015critique, author={Hamaker, Ellen L. and Kuiper, Rebecca M. and Grasman, Raoul P. P. P.}, title={{A critique of the cross-lagged panel model}}, journal={Psychological Methods}, year={2015}, volume={20}, number={1}, pages={102--116}, doi={10.1037/a0038889}}@article{hu1999cutoff, author={Hu, Li-tze and Bentler, Peter M.}, title={{Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={1999}, volume={6}, number={1}, pages={1--55}, doi={10.1080/10705519909540118}}@article{mehta2000putting, author={Mehta, Paras D. and West, Stephen G.}, title={{Putting the individual back into individual growth curves}}, journal={Psychological Methods}, year={2000}, volume={5}, number={1}, pages={23--43}, doi={10.1037/1082-989x.5.1.23}}@article{nylund2007deciding, author={Nylund, Karen L. and Asparouhov, Tihomir and Muthén, Bengt O.}, title={{Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={4}, pages={535--569}, doi={10.1080/10705510701575396}}@article{ployhart2010longitudinal, author={Ployhart, Robert E. and Vandenberg, Robert J.}, title={{Longitudinal research: The theory, design, and analysis of change}}, journal={Journal of Management}, year={2010}, volume={36}, number={1}, pages={94--120}, doi={10.1177/0149206309352110}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, doi={10.18637/jss.v048.i02}}@article{wang2008investigating, author={Wang, Lijuan and Zhang, Zhiyong and McArdle, John J. and Salthouse, Timothy A.}, title={{Investigating ceiling effects in longitudinal data analysis}}, journal={Multivariate Behavioral Research}, year={2008}, volume={43}, number={3}, pages={476--496}, doi={10.1080/00273170802285941}}@article{widaman2010factorial, author={Widaman, Keith F and Ferrer, Emilio and Conger, Rand D}, title={{Factorial invariance within longitudinal structural equation models: Measuring the same construct across time}}, journal={Child Development Perspectives}, year={2010}, volume={4}, number={1}, pages={10--18}, doi={10.1111/j.1750-8606.2009.00110.x}}@article{wu2009evaluating, author={Wu, Wei and West, Stephen G. and Taylor, Aaron B.}, title={{Evaluating model fit for growth curve models: Integration of fit indices from SEM and MLM frameworks}}, journal={Psychological Methods}, year={2009}, volume={14}, number={3}, pages={183--201}, doi={10.1037/a0015858}}