Kiedy wybrać ANOVA z powtarzanymi pomiarami?
ANOVA z powtarzanymi pomiarami porównuje średnie z co najmniej trzech pomiarów tych samych osób. Pomiary mogą być kolejnymi momentami w czasie (przed terapią, po niej, w katamnezie) albo warunkami eksperymentu, przez które przechodzi każda osoba. Definicję, podział zmienności i wzory znajdziesz w haśle ANOVA z powtarzanymi pomiarami. Tutaj przeprowadzimy całą analizę na jednym badaniu: od ułożenia danych, przez założenia i poprawki, po porównania parami, wykres i gotowy opis do pracy.
Zanim zaczniesz, sprawdź, czy Twój plan to rzeczywiście schemat wewnątrzobiektowy. Pomaga w tym poniższe zestawienie.
| Twój plan | Analiza |
|---|---|
| Dwa pomiary tych samych osób | test t dla prób zależnych (ANOVA da ten sam wynik, bo F = t²) |
| Trzy pomiary lub więcej, jedna grupa, komplet danych | jednoczynnikowa ANOVA z powtarzanymi pomiarami – przykład główny w tym wpisie |
| Kilka pomiarów i dwie grupy lub więcej | ANOVA w schemacie mieszanym – rozszerzenie na końcu wpisu |
| Dwie grupy, pomiar przed i po interwencji | zwykle ANCOVA z pomiarem wyjściowym; zob. ANCOVA w badaniu przed i po |
| Braki pomiarów, różne odstępy czasu, czas jako zmienna ciągła | model mieszany; zob. ANOVA z powtarzanymi pomiarami czy model mieszany? |
| Bardzo mała próba, skala porządkowa, silna skośność | test Friedmana |
| Różne osoby w każdym warunku | zwykła ANOVA; zob. ANOVA krok po kroku |
Największa zaleta schematu z powtarzanymi pomiarami to moc. Stałe różnice między osobami (ktoś ma po prostu lepszą pamięć niż inni) zostają usunięte z błędu, więc ten sam efekt da się wykryć na mniejszej próbie. Greenwald (1976) zwraca jednak uwagę na cenę: każdy warunek działa w kontekście poprzednich. Dochodzi do ćwiczenia, zmęczenia i efektu przeniesienia. Dlatego w eksperymencie z kilkoma warunkami równoważy się ich kolejność, a w badaniu podłużnym trzeba pamiętać o efekcie uczenia się przy wielokrotnym wypełnianiu tego samego testu.
Badanie przykładowe: hałas w tle a pamięć robocza
Wyobraź sobie pracę licencjacką o tym, czy dźwięki w tle przeszkadzają w nauce. 32 osoby studiujące wykonały zadanie pamięci roboczej (od 0 do 40 poprawnych odpowiedzi) w czterech warunkach: w ciszy, przy szumie, przy muzyce instrumentalnej i przy muzyce ze słowami. Każdy warunek miał inną wersję zadania o tej samej trudności. Kolejność warunków zrównoważono kwadratem łacińskim: cztery kolejności, po osiem osób w każdej. Dodatkowo zapytano, czy osoba na co dzień uczy się w ciszy, czy przy muzyce (po 16 osób). Tę zmienną wykorzystamy dopiero w rozszerzeniu o schemat mieszany.
Dane są symulowane, ale realistyczne. Możesz je pobrać jako plik CSV (kolumny: id, nawyk, cisza, szum, instrumentalna, slowa) i powtórzyć analizę w R, SPSS albo JASP.
Hipotezy sformułowane przed zebraniem danych:
- H1: wyniki różnią się między czterema warunkami (test ogólny);
- H2: muzyka ze słowami obniża wynik bardziej niż pozostałe warunki (kontrast planowany).
Krok 1. Ułóż dane: format szeroki i długi
SPSS i JASP oczekują danych w formacie szerokim: jeden wiersz to jedna osoba, a każdy warunek to osobna kolumna. Tak wygląda pobrany plik. Większość funkcji w R, w tym pakiet afex, pracuje na formacie długim: jeden wiersz to jedna osoba w jednym warunku, więc 32 osoby dają 128 wierszy. Zamiana zajmuje jedną funkcję (reshape() w przepisie 1).
Sprawdź przy tym trzy rzeczy. Po pierwsze, każda osoba ma komplet pomiarów; ANOVA z powtarzanymi pomiarami usuwa osobę z jednym brakiem w całości. Po drugie, identyfikator osoby jest zmienną kategorialną, a nie liczbą. Po trzecie, poziomy czynnika są w sensownej kolejności, bo od tego zależą tabele, wykresy i kontrasty.
Krok 2. Policz statystyki opisowe
Zacznij od średnich i odchyleń standardowych w każdym warunku. Najwyższy wynik osoby uzyskały w ciszy, najniższy przy muzyce ze słowami. Szum i muzyka instrumentalna leżą pośrodku.
| Warunek | M | SD | 95% CI dla M | Min–maks |
|---|---|---|---|---|
| Cisza | 28.44 | 5.10 | [26.60, 30.28] | 17–40 |
| Szum | 27.69 | 4.66 | [26.01, 29.37] | 15–39 |
| Muzyka instrumentalna | 27.34 | 4.97 | [25.55, 29.14] | 18–37 |
| Muzyka ze słowami | 25.16 | 4.75 | [23.45, 26.87] | 19–38 |
Zwróć uwagę, że odchylenia standardowe (około 5 punktów) są dużo większe niż różnice między średnimi (najwyżej 3.28 punktu). W planie międzygrupowym tak małe różnice przy takim rozrzucie byłyby trudne do wykrycia. Tutaj wyniki w różnych warunkach silnie ze sobą korelują: od r = .58 (szum i słowa) do r = .76 (cisza i szum). Kto dobrze radzi sobie w ciszy, ten zwykle dobrze radzi sobie także przy muzyce. To właśnie te stałe różnice między osobami ANOVA z powtarzanymi pomiarami wyłącza z błędu.
Krok 3. Sprawdź założenia
ANOVA z powtarzanymi pomiarami ma cztery założenia. Dwa wynikają z planu badania, dwa sprawdzasz na danych.
- Niezależność osób. Pomiary tej samej osoby mogą (i powinny) być skorelowane, ale wyniki różnych osób nie mogą od siebie zależeć. W naszym badaniu każdy wykonywał zadanie sam.
- Ilościowa zmienna zależna. Liczba poprawnych odpowiedzi na 40 jest zmienną ilościową.
- Normalność reszt. Dotyczy reszt modelu (albo różnic między warunkami), a nie surowych wyników w każdej kolumnie.
- Sferyczność. Wariancje różnic między każdą parą warunków są w populacji równe.
Obserwacje odstające i normalność reszt
Żaden wynik nie odbiegał od średniej swojego warunku o więcej niż 3 odchylenia standardowe. Wykres Q-Q 128 reszt (rysunek 1B) układa się blisko prostej. Test Shapiro–Wilka dla reszt dał W = 0.99, p = .580, ale przy ocenie normalności ważniejszy jest wykres niż test (szerzej w poradniku jak sprawdzić normalność rozkładu). Jeśli w Twoich danych pojawi się wyraźnie obserwacja odstająca, najpierw sprawdź, czy to błąd wprowadzania danych, a dopiero potem decyduj, co z nią zrobić.
Sferyczność: wariancje różnic
Założenie sferyczności najłatwiej zrozumieć na liczbach. Dla każdej osoby policz różnicę wyników w dwóch warunkach, np. cisza − szum, i wariancję tej różnicy. Przy czterech warunkach masz sześć par. W naszych danych wariancje różnic wynoszą od 11.42 (cisza − szum) do 18.39 (szum − słowa), czyli największa jest 1.61 razy większa od najmniejszej (rysunek 1A). Różnice z udziałem muzyki ze słowami są bardziej zróżnicowane, bo osoby różnią się podatnością na rozpraszanie przez tekst.
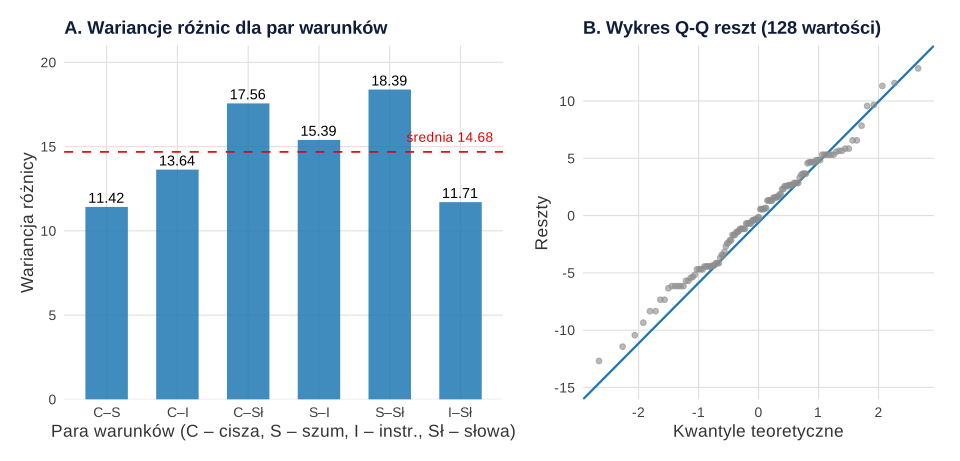
Klasyczny test tego założenia zaproponował Mauchly (1940). W przykładzie wyszło W = .86, p = .467, więc test nie wykrył naruszenia. Nie wyciągaj stąd wniosku, że sferyczność jest spełniona. Test Mauchly’ego ma małą moc w małych próbach, a w dużych reaguje na drobiazgi. Ważniejsza jest miara odstępstwa, czyli epsilon (ε): 1 oznacza pełną sferyczność, a im niższa wartość, tym silniejsze naruszenie. W przykładzie ε Greenhouse’a–Geissera wynosi .90, a ε Huynha–Feldta .99.
Co z tym zrobić? Blanca i in. (2023) w symulacji z 3, 4 i 6 pomiarami pokazali, że nieskorygowany test F staje się tym bardziej liberalny, im silniej naruszona jest sferyczność, a oba testy z poprawką kontrolują błąd I rodzaju. Autorzy zalecają domyślnie poprawkę Greenhouse’a–Geissera (Greenhouse i Geisser, 1959). Gdy obie poprawki prowadzą do różnych wniosków, przy ε̂ < .60 radzą trzymać się Greenhouse’a–Geissera, a przy ε̂ od .60 do .90 – poprawki Huynha–Feldta (Huynh i Feldt, 1976). Taka reguła może zastąpić wstępny test Mauchly’ego. Haverkamp i Beauducel (2017) również uzyskali dobre wyniki dla poprawki Huynha–Feldta, zwłaszcza przy małej próbie i wielu pomiarach. Najprostsza praktyczna rada brzmi: raportuj wynik z poprawką Greenhouse’a–Geissera zawsze, a nie tylko wtedy, gdy test Mauchly’ego jest istotny.
Krok 4. Przeprowadź ANOVA i odczytaj wynik
W R całą analizę wykonuje jedna funkcja aov_ez() z pakietu afex. Wystarczy wskazać identyfikator osoby, zmienną zależną i czynnik wewnątrzobiektowy. Funkcja nice() zwraca tabelę z poprawką Greenhouse’a–Geissera (to ustawienie domyślne) i wielkościami efektu. Dla porównania zestawiliśmy trzy wersje testu:
| Wersja testu | ε | df | F | p |
|---|---|---|---|---|
| Bez poprawki (zakłada sferyczność) | – | 3, 93 | 8.66 | < .001 |
| Greenhouse–Geisser (raportujesz) | .90 | 2.70, 83.62 | 8.66 | < .001 |
| Huynh–Feldt | .99 | 2.98, 92.35 | 8.66 | < .001 |
Poprawka nie zmienia wartości F. Mnoży oba stopnie swobody przez ε (3 × .90 = 2.70 i 93 × .90 = 83.62), dzięki czemu wartość p odczytuje się z bardziej „wymagającego” rozkładu. Tutaj naruszenie jest niewielkie, więc wszystkie trzy wersje dają ten sam wniosek: warunki różnią się, F(2.70, 83.62) = 8.66, p < .001. Przy ε rzędu .50 różnica między wersjami bywa decydująca.
Wielkość efektu: η² uogólnione czy cząstkowe?
afex podaje dwie miary. Cząstkowe eta kwadrat wynosi η²p = .218, a uogólnione η²G = .061. Skąd tak duża różnica? Cząstkowe η² liczy efekt względem samego błędu, z którego usunięto różnice między osobami. Uogólnione η² dolicza je z powrotem do mianownika. Olejnik i Algina (2003) pokazali, że cechy planu badania silnie wpływają na η²p, i zaproponowali η²G, które da się porównywać między planami wewnątrz- i międzyobiektowymi. Bakeman (2005) zaleca rutynowe raportowanie η²G w analizach z powtarzanymi pomiarami, a Lakens (2013) radzi podawać η²G obok η²p, gdy wynik ma być porównywany z innymi badaniami.
W praktyce podaj obie miary i nazwij je wprost. η²G = .061 znaczy, że warunek odpowiada za około 6% całej zmienności wyników. Jest jej sporo, bo osoby bardzo różnią się ogólnym poziomem pamięci roboczej. η²p = .218 opisuje, jak duży jest efekt na tle niespójności zmian u poszczególnych osób. Ta miara przyda się do analizy mocy kolejnego badania o tym samym planie. Konwencje dotyczące wielkości efektu omawiamy szerzej w poradniku wielkość efektu – interpretacja.
Krok 5. Porównaj warunki parami
Istotny test ogólny mówi tylko, że gdzieś jest różnica. Żeby wiedzieć gdzie, porównujesz warunki parami i kontrolujesz łączny błąd (zob. testy post hoc i korekta Bonferroniego). Przy czterech warunkach masz sześć par. Użyliśmy pakietu emmeans z poprawką Holma, która tak samo jak Bonferroni kontroluje błąd dla całej rodziny testów, a przy tym ma większą moc (więcej w poradniku poprawki na wielokrotne porównania).
Jedna ważna uwaga techniczna. Dla obiektów z afex emmeans domyślnie liczy każde porównanie z osobnym błędem, czyli tak jak test t dla prób zależnych na różnicy dwóch warunków. Dlatego każde porównanie ma 31 stopni swobody, a błędy standardowe różnią się między parami. Takie porównania nie zakładają sferyczności, co przy jej naruszeniu jest bezpieczniejsze niż wspólny błąd z całej ANOVA. Jako wielkość efektu podaliśmy dz, czyli średnią różnic podzieloną przez odchylenie standardowe różnic.
Tabela 1
Porównania parami liczby poprawnych odpowiedzi w czterech warunkach (N = 32)
| Porównanie | Mróżn | SE | t(31) | pHolm | 95% CIBonf | dz |
|---|---|---|---|---|---|---|
| Cisza – szum | 0.75 | 0.60 | 1.26 | .437 | [−0.93, 2.43] | 0.22 |
| Cisza – muzyka instrumentalna | 1.09 | 0.65 | 1.68 | .312 | [−0.75, 2.93] | 0.30 |
| Cisza – muzyka ze słowami | 3.28 | 0.74 | 4.43 | < .001 | [1.19, 5.37] | 0.78 |
| Szum – muzyka instrumentalna | 0.34 | 0.69 | 0.50 | .624 | [−1.61, 2.30] | 0.09 |
| Szum – muzyka ze słowami | 2.53 | 0.76 | 3.34 | .009 | [0.39, 4.67] | 0.59 |
| Muzyka instrumentalna – muzyka ze słowami | 2.19 | 0.60 | 3.62 | .005 | [0.48, 3.89] | 0.64 |
Uwaga. Mróżn – średnia różnica (pierwszy warunek minus drugi); pHolm – wartość p z poprawką Holma dla sześciu porównań; 95% CIBonf – przedział ufności z poprawką Bonferroniego; dz – średnia różnic podzielona przez odchylenie standardowe różnic. Dane symulowane.
Wzór jest wyraźny. Muzyka ze słowami daje niższy wynik niż każdy z trzech pozostałych warunków, o 2.19 do 3.28 punktu. Cisza, szum i muzyka instrumentalna nie różnią się istotnie między sobą. Nie oznacza to jednak, że są równoważne: przedział dla różnicy cisza − muzyka instrumentalna, od −0.75 do 2.93 punktu, obejmuje zarówno brak różnicy, jak i różnicę prawie trzypunktową. Żeby wykazać równoważność, potrzebny byłby test równoważności (TOST).
Krok 6. Sprawdź hipotezę kontrastem planowanym
Hipoteza H2 była kierunkowa i sformułowana przed badaniem: muzyka ze słowami szkodzi bardziej niż pozostałe warunki. Zamiast sześciu porównań post hoc możesz ją sprawdzić jednym kontrastem planowanym. Porównuje on średnią z warunku „słowa” ze średnią z trzech pozostałych warunków (wagi −1/3, −1/3, −1/3 i 1). Wynik: różnica −2.67 punktu, SE = 0.60, t(31) = −4.47, p < .001. Jeden test zamiast sześciu nie wymaga poprawki i odpowiada dokładnie na postawione pytanie. Kontrasty i analizę trendu (np. liniowego spadku w kolejnych pomiarach) omawiamy osobno w poradniku kontrasty planowane i analiza trendu.
Krok 7. Pokaż wyniki na wykresie z właściwymi przedziałami ufności
Zwykłe przedziały ufności wokół średnich w schemacie wewnątrzobiektowym wprowadzają w błąd. Cousineau (2005) wyjaśnia dlaczego: zawierają zmienność między osobami, którą ANOVA usuwa z błędu. W efekcie przedziały mocno na siebie zachodzą, choć różnice są wyraźnie istotne. Spójrz na rysunek 2B. Szary przedział dla ciszy (od 26.60 do 30.28) zachodzi na szary przedział dla muzyki ze słowami (od 23.45 do 26.87), a mimo to różnica ma p < .001.
Rozwiązaniem są przedziały wewnątrzosobowe. Cousineau (2005) zaproponował prostą normalizację: od wyniku każdej osoby odejmij jej średnią ze wszystkich warunków i dodaj średnią ogólną. Morey (2008) pokazał, że tak policzone przedziały są systematycznie za wąskie, i podał poprawkę. Przy k warunkach mnożysz szerokość przez √(k/(k − 1)). W przykładzie połowa szerokości zwykłego 95% CI wynosi od 1.68 do 1.84 punktu, a wewnątrzosobowego od 0.90 do 1.05.
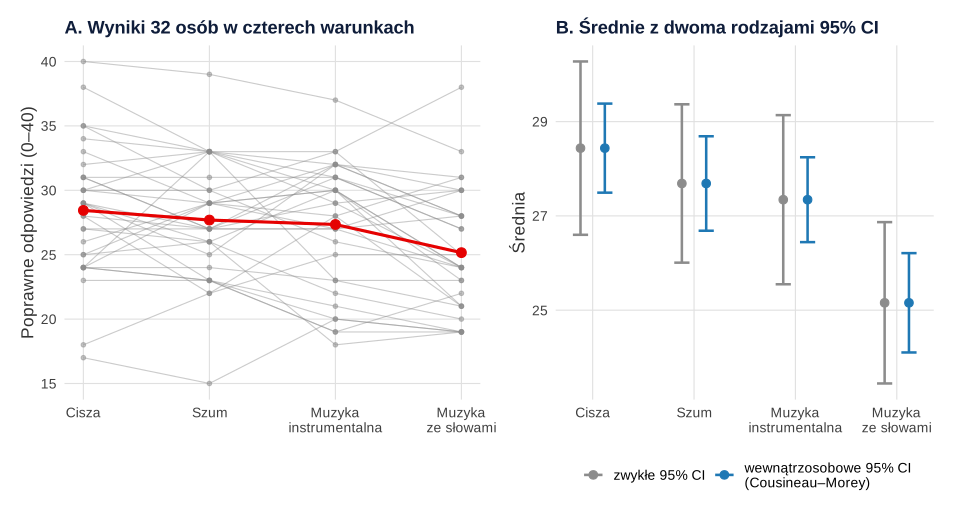
Panel A pokazuje coś, czego nie widać w samych średnich: linie poszczególnych osób przecinają się, a u części osób muzyka ze słowami wcale nie obniżyła wyniku. Pokazanie danych indywidualnych jest szczególnie cenne przy niewielkich próbach. W podpisie wykresu zawsze napisz, jakie przedziały pokazujesz. Przedział wewnątrzosobowy informuje o różnicach między warunkami, a nie o tym, gdzie leży średnia w populacji.
Krok 8. Opisz wynik w stylu APA
Opis wyniku ANOVA z powtarzanymi pomiarami powinien zawierać:
- nazwę analizy i czynnika z liczbą poziomów;
- informację o sferyczności: ε i zastosowaną poprawkę (test Mauchly’ego możesz dodać, ale nie uzależniaj od niego decyzji);
- F ze skorygowanymi stopniami swobody (dwa miejsca po kropce), dokładne p i wielkość efektu z nazwą miary;
- średnie i odchylenia standardowe (w tekście albo w tabeli);
- metodę porównań parami, poprawkę i najważniejsze różnice z przedziałami ufności.
Jeśli masz kilka zmiennych zależnych, zbierz wyniki testów ogólnych w tabeli według wzoru z hasła tabela ANOVA w APA.
Rozszerzenie: gdy dochodzi czynnik międzyobiektowy
W wielu pracach oprócz pomiarów powtarzanych są też grupy. W naszym badaniu połowa osób na co dzień uczy się w ciszy, a połowa przy muzyce. Pytanie brzmi: czy wpływ warunku zależy od nawyku? To schemat mieszany 2 × 4, z jednym czynnikiem międzyobiektowym (nawyk) i jednym wewnątrzobiektowym (warunek). W afex wystarczy dodać argument between = "nawyk".
| Efekt | df | F | p | η²G | η²p |
|---|---|---|---|---|---|
| Nawyk | 1, 30 | 0.02 | .888 | < .001 | < .001 |
| Warunek | 2.83, 85.03 | 9.31 | < .001 | .062 | .237 |
| Nawyk × warunek | 2.83, 85.03 | 3.34 | .025 | .023 | .100 |
Grupy nie różnią się ogólnym poziomem wyników, efekt warunku pozostaje wyraźny, a interakcja jest istotna. Interakcję zawsze rozpisz na efekty proste. U osób uczących się w ciszy warunki wyraźnie się różniły, F(3, 30) = 8.22, p < .001, a muzyka ze słowami obniżyła wynik względem ciszy o 4.50 punktu, t(30) = −4.42, p < .001. U osób uczących się przy muzyce różnice były słabsze i nieistotne, F(3, 30) = 2.24, p = .104. Spadek przy muzyce ze słowami wyniósł tu 2.06 punktu, t(30) = −2.03, p = .052.
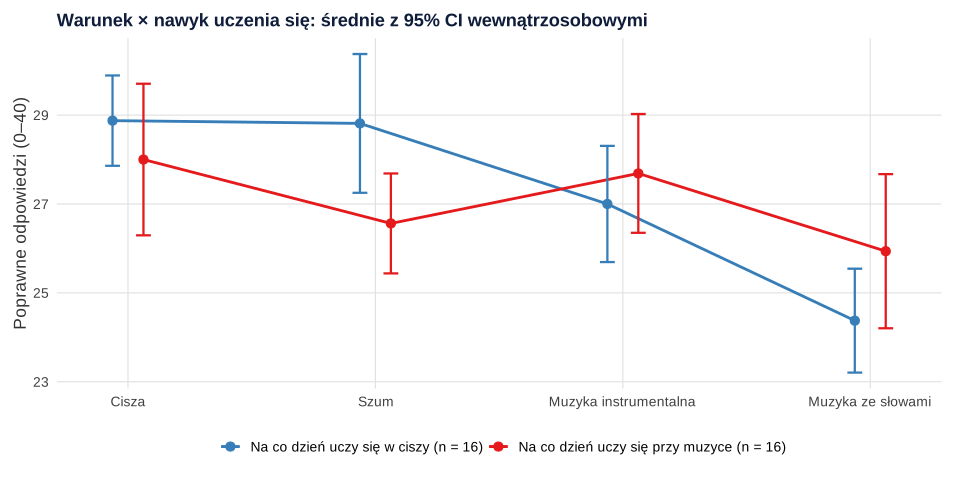
Tu przyda się ostrożność. Różnica spadków przy muzyce ze słowami (4.50 wobec 2.06 punktu, czyli 2.44 punktu) sama w sobie nie jest istotna, t(30) = 1.69, p = .101. Rysunek 3 pokazuje, że do istotnej interakcji przyczynia się także szum, który bardziej przeszkadzał osobom przyzwyczajonym do muzyki. Interakcja w teście ogólnym mówi tylko, że profile grup nie są równoległe. Jaki to dokładnie wzór, trzeba sprawdzić efektami prostymi i wykresem interakcji. Pamiętaj też, że nawyk nie był przydzielany losowo. Osoby uczące się przy muzyce mogą różnić się od pozostałych także innymi cechami, więc wynik to związek, a nie dowód, że przyzwyczajenie chroni przed rozpraszaniem.
Gdy w schemacie mieszanym masz braki pomiarów albo chcesz modelować czas jako zmienną ciągłą, przejdź do modelu mieszanego. Porównanie obu podejść na tych samych danych pokazujemy w poradniku o wyborze między ANOVA a modelem mieszanym, do którego odsyła tabela na początku wpisu. Badania z dwiema grupami i pomiarem przed i po omawiamy w poradniku o ANCOVA, także wymienionym w tej tabeli.
Gdy założenia zawodzą: test Friedmana
Przy kilkunastu osobach, skali porządkowej albo bardzo skośnych wynikach rozważ test Friedmana, czyli rangowy odpowiednik ANOVA z powtarzanymi pomiarami. Dla naszych danych wynik wynosi χ²(3) = 19.91, p < .001, czyli prowadzi do tego samego wniosku. Pamiętaj, że test Friedmana porównuje rangi w obrębie osób, a nie średnie. W opisie podaj więc mediany. Porównania parami po teście Friedmana i wielkość efektu pokazujemy w poradniku testy nieparametryczne krok po kroku. Samo nieistotne odstępstwo od normalności przy 30 osobach nie jest powodem do rezygnacji z ANOVA.
ANOVA z powtarzanymi pomiarami w SPSS
W SPSS analizę uruchomisz ścieżką Analyze > General Linear Model > Repeated Measures... (IBM Corp., b.d.). Dane muszą być w formacie szerokim: jedna kolumna na każdy warunek.
- W oknie definiowania czynników (Repeated Measures Define Factor(s)) wpisz nazwę czynnika wewnątrzobiektowego (np.
warunek) i liczbę poziomów (4), kliknij Add, a potem Define. - Przenieś cztery kolumny do listy zmiennych w kolejności poziomów. Zmienną
nawykw schemacie mieszanym przenieś do czynników międzyobiektowych. - Porównania parami i średnie brzegowe ustawisz w części EM Means, a dodatkowe statystyki w Options.
Test Mauchly’ego SPSS wyświetla automatycznie, a dokumentacja opisuje trzy oszacowania poprawki epsilon (IBM Corp., b.d.). Do pracy przepisz wiersz z poprawką Greenhouse’a–Geissera z tabeli testów efektów wewnątrzobiektowych. SPSS w tej procedurze nie podaje η²G. Możesz je policzyć z sum kwadratów albo w R. Jak odnaleźć poszczególne wartości w tabelach wydruku, wyjaśniamy w poradniku jak czytać wyniki z SPSS.
ANOVA z powtarzanymi pomiarami w R: afex i emmeans
Kod odtwarza wszystkie liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R, bo przepis 2 korzysta z danych z przepisu 1. Pakiet afex liczy ANOVA z testem Mauchly’ego i poprawkami ε, a emmeans – średnie brzegowe, porównania parami i kontrasty. Pierwszy przepis zapisuje też plik CSV do pobrania. Rysunki powstały w ggplot2 i patchwork według tych samych obliczeń (przedziały wewnątrzosobowe: normalizacja Cousineau z poprawką Moreya).
1. Jednoczynnikowa ANOVA z powtarzanymi pomiarami krok po kroku
R
# Przykład: hałas w tle a pamięć robocza (dane symulowane, set.seed(9204)).
# 32 osoby studiujące; każda wykonała zadanie pamięci roboczej (0–40 poprawnych odpowiedzi)
# w czterech warunkach: cisza, szum, muzyka instrumentalna, muzyka ze słowami.
# Kolejność warunków zrównoważono kwadratem łacińskim (4 kolejności po 8 osób).
suppressPackageStartupMessages({ library(afex); library(emmeans) })
set.seed(9204)
n <- 32
osoba <- rnorm(n, 0, 4.2)                            # stałe różnice między osobami
nawyk <- rep(c("w ciszy", "przy muzyce"), each = 16) # czy osoba na co dzień uczy się przy muzyce (do przepisu 2)
wrazliwosc <- rnorm(n, 0, 2.2)                       # różna podatność na rozproszenie (narusza sferyczność)
m <- c(cisza = 29, szum = 28, instrumentalna = 27.6, slowa = 24.6)
wynik <- sapply(1:4, function(j) {
  efekt_slow <- if (j == 4) ifelse(nawyk == "przy muzyce", 2.2, -2.2) else 0
  m[j] + osoba + c(0, 0.3, 0.6, 1.6)[j] * wrazliwosc + efekt_slow + rnorm(n, 0, 2.3)
})
wynik[] <- pmin(40, pmax(0, round(wynik)))
szerokie <- data.frame(id = 1:n, nawyk, wynik)
names(szerokie)[3:6] <- c("cisza", "szum", "instrumentalna", "slowa")
write.csv(szerokie, "../anova-powtarzane-pomiary-dane.csv", row.names = FALSE)   # plik do pobrania

# Format długi: jeden wiersz = jedna osoba w jednym warunku
dlugie <- reshape(szerokie, direction = "long", varying = c("cisza", "szum", "instrumentalna", "slowa"),
                  v.names = "wynik", timevar = "warunek", idvar = "id",
                  times = c("cisza", "szum", "instrumentalna", "slowa"))
dlugie$warunek <- factor(dlugie$warunek, levels = c("cisza", "szum", "instrumentalna", "slowa"))
dlugie$id <- factor(dlugie$id)
dlugie <- dlugie[order(dlugie$id, dlugie$warunek), ]
head(dlugie, 4)

# Krok 1. Statystyki opisowe w każdym warunku
opis <- function(x) { h <- qt(.975, length(x) - 1) * sd(x) / sqrt(length(x))
  round(c(M = mean(x), SD = sd(x), CI_dolna = mean(x) - h, CI_gorna = mean(x) + h, min = min(x), max = max(x)), 2) }
t(sapply(szerokie[3:6], opis))
round(cor(szerokie[3:6]), 2)                          # korelacje między warunkami

# Krok 2. Założenia
# 2a. Obserwacje odstające: wyniki standaryzowane w każdym warunku
z <- scale(szerokie[3:6]); sum(abs(z) > 3)
# 2b. Sferyczność: wariancje różnic dla wszystkich par warunków
pary <- combn(names(szerokie)[3:6], 2)
round(setNames(apply(pary, 2, function(p) var(szerokie[[p[1]]] - szerokie[[p[2]]])),
               apply(pary, 2, paste, collapse = "-")), 2)

# Krok 3. ANOVA z powtarzanymi pomiarami (afex): test Mauchly'ego, epsilon, poprawki
model <- aov_ez(id = "id", dv = "wynik", data = dlugie, within = "warunek")
summary(model)                                        # pełny wydruk: bez poprawki, Mauchly, GG i HF
nice(model, es = c("ges", "pes"), correction = "GG")  # tabela do raportu z poprawką Greenhouse'a-Geissera
nice(model, es = "ges", correction = "HF")            # dla porównania: Huynh-Feldt
nice(model, es = "ges", correction = "none")          # i bez poprawki
# 2c. Normalność reszt (reszty z modelu dla każdej osoby i warunku)
reszty <- residuals(model)
shapiro.test(unlist(reszty))

# Krok 4. Porównania parami: emmeans, poprawka Holma (osobny błąd dla każdej pary)
em <- emmeans(model, ~ warunek)
em
pw <- pairs(em, adjust = "holm")
pw
confint(pw, adjust = "bonferroni")                   # przedziały ufności z poprawką Bonferroniego
# d_z dla każdej pary = średnia różnic / SD różnic
round(setNames(apply(pary, 2, function(p) { d <- szerokie[[p[1]]] - szerokie[[p[2]]]; mean(d) / sd(d) }),
               apply(pary, 2, paste, collapse = "-")), 2)

# Krok 5. Kontrast planowany: muzyka ze słowami vs średnia trzech pozostałych warunków
contrast(em, list(slowa_vs_reszta = c(-1, -1, -1, 3) / 3))

# Alternatywa nieparametryczna: test Friedmana
friedman.test(as.matrix(szerokie[3:6]))
Wynik w R
                 id   nawyk        warunek wynik
1.cisza           1 w ciszy          cisza    32
1.szum            1 w ciszy           szum    33
1.instrumentalna  1 w ciszy instrumentalna    29
1.slowa           1 w ciszy          slowa    30
                   M   SD CI_dolna CI_gorna min max
cisza          28.44 5.10    26.60    30.28  17  40
szum           27.69 4.66    26.01    29.37  15  39
instrumentalna 27.34 4.97    25.55    29.14  18  37
slowa          25.16 4.75    23.45    26.87  19  38
               cisza szum instrumentalna slowa
cisza           1.00 0.76           0.73  0.64
szum            0.76 1.00           0.67  0.58
instrumentalna  0.73 0.67           1.00  0.75
slowa           0.64 0.58           0.75  1.00
[1] 0
          cisza-szum cisza-instrumentalna          cisza-slowa  szum-instrumentalna
               11.42                13.64                17.56                15.39
          szum-slowa instrumentalna-slowa
               18.39                11.71

Univariate Type III Repeated-Measures ANOVA Assuming Sphericity

            Sum Sq num Df Error SS den Df   F value    Pr(>F)
(Intercept)  94395      1  2261.37     31 1294.0131 < 2.2e-16 ***
warunek        191      3   682.81     93    8.6573  3.99e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


Mauchly Tests for Sphericity

        Test statistic p-value
warunek        0.85673 0.46737


Greenhouse-Geisser and Huynh-Feldt Corrections
 for Departure from Sphericity

         GG eps Pr(>F[GG])
warunek 0.89912  8.457e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

           HF eps   Pr(>F[HF])
warunek 0.9930191 4.202945e-05
Anova Table (Type 3 tests)

Response: wynik
   Effect          df  MSE        F  ges  pes p.value
1 warunek 2.70, 83.62 8.17 8.66 *** .061 .218   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
Anova Table (Type 3 tests)

Response: wynik
   Effect          df  MSE        F  ges p.value
1 warunek 2.98, 92.35 7.39 8.66 *** .061   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: HF
Anova Table (Type 3 tests)

Response: wynik
   Effect    df  MSE        F  ges p.value
1 warunek 3, 93 7.34 8.66 *** .061   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

	Shapiro-Wilk normality test

data:  unlist(reszty)
W = 0.99101, p-value = 0.5802

 warunek        emmean    SE df lower.CL upper.CL
 cisza            28.4 0.901 31     26.6     30.3
 szum             27.7 0.824 31     26.0     29.4
 instrumentalna   27.3 0.879 31     25.6     29.1
 slowa            25.2 0.839 31     23.4     26.9

Confidence level used: 0.95
 contrast               estimate    SE df t.ratio p.value
 cisza - szum              0.750 0.597 31   1.255  0.4374
 cisza - instrumentalna    1.094 0.653 31   1.676  0.3117
 cisza - slowa             3.281 0.741 31   4.429  0.0007
 szum - instrumentalna     0.344 0.694 31   0.496  0.6237
 szum - slowa              2.531 0.758 31   3.339  0.0088
 instrumentalna - slowa    2.188 0.605 31   3.617  0.0052

P value adjustment: holm method for 6 tests
 contrast               estimate    SE df lower.CL upper.CL
 cisza - szum              0.750 0.597 31   -0.934     2.43
 cisza - instrumentalna    1.094 0.653 31   -0.746     2.93
 cisza - slowa             3.281 0.741 31    1.193     5.37
 szum - instrumentalna     0.344 0.694 31   -1.611     2.30
 szum - slowa              2.531 0.758 31    0.395     4.67
 instrumentalna - slowa    2.188 0.605 31    0.483     3.89

Confidence level used: 0.95
Conf-level adjustment: bonferroni method for 6 estimates
          cisza-szum cisza-instrumentalna          cisza-slowa  szum-instrumentalna
                0.22                 0.30                 0.78                 0.09
          szum-slowa instrumentalna-slowa
                0.59                 0.64
 contrast        estimate    SE df t.ratio p.value
 slowa_vs_reszta    -2.67 0.597 31  -4.470 <0.0001


	Friedman rank sum test

data:  as.matrix(szerokie[3:6])
Friedman chi-squared = 19.906, df = 3, p-value = 0.0001775
2. Schemat mieszany: nawyk × warunek
R
# Rozszerzenie: schemat mieszany 2 (nawyk: uczę się w ciszy / przy muzyce) × 4 (warunek).
# Korzysta z obiektu dlugie z przepisu 1.
mieszany <- aov_ez(id = "id", dv = "wynik", data = dlugie, between = "nawyk", within = "warunek")
nice(mieszany, es = c("ges", "pes"), correction = "GG")
# średnie w komórkach
round(tapply(dlugie$wynik, list(dlugie$warunek, dlugie$nawyk), mean), 2)
# Efekty proste: różnice między warunkami osobno w każdej grupie (test F dla czynnika warunek)
joint_tests(mieszany, by = "nawyk")
# Muzyka ze słowami vs cisza w każdej grupie
em2 <- emmeans(mieszany, ~ warunek | nawyk)
contrast(em2, list(slowa_vs_cisza = c(-1, 0, 0, 1)))
# Interakcja jako różnica różnic: (słowa − cisza) w grupie „przy muzyce” minus w grupie „w ciszy”
contrast(emmeans(mieszany, ~ warunek * nawyk), list(roznica_roznic = c(-1, 0, 0, 1, 1, 0, 0, -1)))
Wynik w R
Converting to factor: nawyk
Contrasts set to contr.sum for the following variables: nawyk
Anova Table (Type 3 tests)

Response: wynik
         Effect          df   MSE        F   ges   pes p.value
1         nawyk       1, 30 75.33     0.02 <.001 <.001    .888
2       warunek 2.83, 85.03  7.23 9.31 ***  .062  .237   <.001
3 nawyk:warunek 2.83, 85.03  7.23   3.34 *  .023  .100    .025
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
               przy muzyce w ciszy
cisza                28.00   28.88
szum                 26.56   28.81
instrumentalna       27.69   27.00
slowa                25.94   24.38
nawyk = przy muzyce:
 model term df1 df2 F.ratio p.value
 warunek      3  30   2.243  0.1036

nawyk = w ciszy:
 model term df1 df2 F.ratio p.value
 warunek      3  30   8.221  0.0004

nawyk = przy muzyce:
 contrast       estimate   SE df t.ratio p.value
 slowa_vs_cisza    -2.06 1.02 30  -2.027  0.0516

nawyk = w ciszy:
 contrast       estimate   SE df t.ratio p.value
 slowa_vs_cisza    -4.50 1.02 30  -4.423  0.0001

 contrast       estimate   SE df t.ratio p.value
 roznica_roznic     2.44 1.44 30   1.694  0.1006
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje reshape(), shapiro.test() i friedman.test() z pakietów stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- afex (wersja 1.5-1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. (2025). afex: Analysis of factorial experiments (R package version 1.5-1) [Computer software]. https://doi.org/10.32614/CRAN.package.afex
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.emmeans
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Kilka testów t dla prób zależnych zamiast ANOVA bez żadnej poprawki. Sześć porównań na poziomie .05 to duże ryzyko fałszywego alarmu. Zacznij od testu ogólnego albo od kontrastów zaplanowanych przed badaniem.
- Analiza pomiarów powtarzanych jak grup niezależnych. Zwykła ANOVA wrzuca stałe różnice między osobami do błędu i traci moc, a przy okazji łamie założenie niezależności.
- Poprawka tylko wtedy, gdy test Mauchly’ego jest istotny. Test ma małą moc w małych próbach. Podawaj ε i wynik z poprawką Greenhouse’a–Geissera zawsze.
- Nieskorygowane stopnie swobody przy skorygowanym p albo odwrotnie. Zapis „F(3, 93) = 8.66” przy poprawce Greenhouse’a–Geissera jest niespójny; poprawne są stopnie swobody 2.70 i 83.62.
- Samo η²p bez nazwy miary porównywane z η² z badań międzygrupowych. Podaj η²G, a przy η²p napisz wprost, że to miara cząstkowa.
- Zwykłe przedziały ufności na wykresie i wniosek „przedziały się nakładają, więc brak różnicy”. W schemacie wewnątrzobiektowym użyj przedziałów wewnątrzosobowych i opisz je w podpisie.
- Brak zrównoważenia kolejności warunków. Gdy wszyscy wykonują warunki w tej samej kolejności, efekt warunku miesza się z ćwiczeniem i zmęczeniem.
- Usunięcie osób z brakami bez słowa. ANOVA z powtarzanymi pomiarami robi to automatycznie. Napisz, ile osób wypadło i dlaczego, a przy większych brakach rozważ model mieszany.
- Interpretacja interakcji bez efektów prostych. Istotna interakcja nie mówi, które warunki i w której grupie się różnią.
- Brak różnicy jako dowód równoważności, np. „szum nie wpływa na pamięć”. Wynik nieistotny przy szerokim przedziale ufności oznacza niepewność.
Jeśli nie wiesz, którą poprawkę wybrać albo jak rozpisać interakcję w schemacie mieszanym, możesz omówić analizę ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki w pracy musisz jednak rozumieć i umieć obronić samodzielnie.
Najczęstsze pytania
Czy poprawkę Greenhouse’a–Geissera stosować, gdy test Mauchly’ego jest nieistotny?
Tak, najlepiej zawsze. Test Mauchly’ego ma małą moc w małych próbach, więc nieistotny wynik nie dowodzi sferyczności. Blanca i in. (2023) zalecają poprawkę Greenhouse’a–Geissera jako wybór domyślny. Gdy ε jest bliskie 1, wynik z poprawką i bez niej prawie się nie różni, więc nic nie tracisz.
Dlaczego eta kwadrat cząstkowe jest dużo większe od uogólnionego w ANOVA z powtarzanymi pomiarami?
η²p liczy efekt względem błędu, z którego usunięto stałe różnice między osobami, a η²G dolicza je do mianownika. W przykładzie z tego wpisu η²p = .218, a η²G = .061. Do porównań z innymi badaniami podawaj η²G (Bakeman, 2005), a obie miary zawsze nazywaj wprost.
Jak zrobić porównania parami po ANOVA z powtarzanymi pomiarami w R?
Wygodnie zrobisz to w pakiecie emmeans: pairs(emmeans(model, ~ warunek), adjust = "holm"), gdzie model pochodzi z afex::aov_ez(). Dla obiektów z afex emmeans domyślnie liczy każde porównanie z osobnym błędem, jak test t dla prób zależnych, więc porównania nie zakładają sferyczności. Do wyników dodaj dz i przedziały ufności.
Jakie przedziały ufności pokazać na wykresie dla pomiarów powtarzanych?
Zwykłe przedziały zawierają różnice między osobami i zwykle mocno na siebie zachodzą, nawet przy istotnych różnicach. Lepsze są przedziały wewnątrzosobowe: normalizacja Cousineau (2005) z poprawką Moreya (2008). W podpisie napisz, jakie przedziały pokazujesz.
Co zrobić, gdy w ANOVA z powtarzanymi pomiarami brakuje części pomiarów?
Klasyczna ANOVA usunie każdą osobę z choćby jednym brakiem, co zmniejsza próbę i może zniekształcić wynik. Przy pojedynczych brakach opisz, ile osób wypadło i dlaczego. Przy większych brakach albo odpadaniu z badania wybierz model mieszany, który wykorzystuje wszystkie dostępne pomiary.
Powiązane hasła
Przeczytaj też
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikKontrasty planowane i analiza trendu
Od hipotez do wag kontrastów: trend liniowy i kwadratowy, kontrast interakcyjny, korekty, moc i tabela APA – na danych do pobrania, z kodem R.
Czytaj →Masz pomiary powtarzane i nie wiesz, którą poprawkę podać?
Sprawdzimy założenia, policzymy ANOVA z poprawką i porównaniami parami oraz wyjaśnimy wyniki tak, żebyś umiał(a) je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Blanca, M. J., Arnau, J., García-Castro, F. J., Alarcón, R., & Bono, R. (2023). Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best? Frontiers in Psychology, 14, Article 1192453. https://doi.org/10.3389/fpsyg.2023.1192453 ● Otwarty dostęp
- Cousineau, D. (2005). Confidence intervals in within-subject designs: A simpler solution to Loftus and Masson’s method. Tutorials in Quantitative Methods for Psychology, 1(1), 42–45. https://doi.org/10.20982/tqmp.01.1.p042 ● Otwarty dostęp
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Greenwald, A. G. (1976). Within-subjects designs: To use or not to use? Psychological Bulletin, 83(2), 314–320. https://doi.org/10.1037/0033-2909.83.2.314
- Haverkamp, N., & Beauducel, A. (2017). Violation of the sphericity assumption and its effect on Type-I error rates in repeated measures ANOVA and multi-level linear models (MLM). Frontiers in Psychology, 8, Article 1841. https://doi.org/10.3389/fpsyg.2017.01841 ● Otwarty dostęp
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- IBM Corp. (b.d.). GLM Repeated Measures. IBM SPSS Statistics 31.0.0 documentation. Pobrano 26 października 2026 z https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=statistics-glm-repeated-measures ● Otwarty dostęp
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Mauchly, J. W. (1940). Significance test for sphericity of a normal n-variate distribution. The Annals of Mathematical Statistics, 11(2), 204–209. https://doi.org/10.1214/aoms/1177731915 ● Otwarty dostęp
- Morey, R. D. (2008). Confidence intervals from normalized data: A correction to Cousineau (2005). Tutorials in Quantitative Methods for Psychology, 4(2), 61–64. https://doi.org/10.20982/tqmp.04.2.p061 ● Otwarty dostęp
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
Cytowania BibTeX
@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{blanca2023repeated, author={Blanca, María J. and Arnau, Jaume and García-Castro, F. Javier and Alarcón, Rafael and Bono, Roser}, title={{Repeated measures ANOVA and adjusted F-tests when sphericity is violated: Which procedure is best?}}, journal={Frontiers in Psychology}, year={2023}, volume={14}, eid={1192453}, doi={10.3389/fpsyg.2023.1192453}}@article{cousineau2005confidence, author={Cousineau, Denis}, title={{Confidence intervals in within-subject designs: A simpler solution to Loftus and Masson’s method}}, journal={Tutorials in Quantitative Methods for Psychology}, year={2005}, volume={1}, number={1}, pages={42--45}, doi={10.20982/tqmp.01.1.p042}}@article{greenhouse1959methods, author={Greenhouse, Samuel W. and Geisser, Seymour}, title={{On methods in the analysis of profile data}}, journal={Psychometrika}, year={1959}, volume={24}, number={2}, pages={95--112}, doi={10.1007/bf02289823}}@article{greenwald1976within, author={Greenwald, Anthony G.}, title={{Within-subjects designs: To use or not to use?}}, journal={Psychological Bulletin}, year={1976}, volume={83}, number={2}, pages={314--320}, doi={10.1037/0033-2909.83.2.314}}@article{haverkamp2017violation, author={Haverkamp, Nicolas and Beauducel, André}, title={{Violation of the sphericity assumption and its effect on Type-I error rates in repeated measures ANOVA and multi-level linear models (MLM)}}, journal={Frontiers in Psychology}, year={2017}, volume={8}, eid={1841}, doi={10.3389/fpsyg.2017.01841}}@article{huynh1976estimation, author={Huynh, Huynh and Feldt, Leonard S.}, title={{Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={1}, pages={69--82}, doi={10.3102/10769986001001069}}@misc{ibmndglmrepeated, author={{IBM Corp.}}, title={{GLM Repeated Measures}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, publisher={IBM}, url={https://www.ibm.com/docs/en/spss-statistics/31.0.0?topic=statistics-glm-repeated-measures}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{mauchly1940significance, author={Mauchly, John W.}, title={{Significance test for sphericity of a normal n-variate distribution}}, journal={The Annals of Mathematical Statistics}, year={1940}, volume={11}, number={2}, pages={204--209}, doi={10.1214/aoms/1177731915}}@article{morey2008confidence, author={Morey, Richard D.}, title={{Confidence intervals from normalized data: A correction to Cousineau (2005)}}, journal={Tutorials in Quantitative Methods for Psychology}, year={2008}, volume={4}, number={2}, pages={61--64}, doi={10.20982/tqmp.04.2.p061}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}