Po co kontrasty, skoro jest test F?
Test F w analizie wariancji odpowiada na pytanie, którego zwykle nikt nie zadał: czy jakiekolwiek średnie różnią się od siebie. Hipotezy w artykule i w doktoracie są zwykle bardziej konkretne. „Każda dawka działa lepiej niż placebo”. „Efekt rośnie z dawką, ale przy najwyższej słabnie”. „Krzywa wygląda inaczej u osób, które piją kawę codziennie”. Każde z tych zdań da się zapisać jako kontrast, czyli ważoną sumę średnich z wagami sumującymi się do zera, i sprawdzić jednym testem z jednym stopniem swobody.
Furr i Rosenthal (2003) nazywają analizę kontrastów sposobem na efektywne sprawdzanie teorii. Daje ona skupioną informację, której nie dają omnibusowe testy F, a mimo to rzadko pojawia się w literaturze. Schad i in. (2020) pokazują, że kontrasty zaplanowane przed poznaniem średnich pozwalają testować konkretne hipotezy lepiej niż ogólny test F. Działa to także w modelach mieszanych. Granziol i in. (2025) idą dalej. Poza badaniami eksploracyjnymi rutynowe porównania post hoc po istotnym efekcie mogą zwiększać odsetek błędów I rodzaju i obniżać moc. Lepiej więc zaplanować porównania przed badaniem.
Definicję, zasady doboru wag i krótki przykład z trzema grupami znajdziesz w haśle kontrast planowany. Podstawy ANOVA, założenia i testy post hoc omawia poradnik ANOVA krok po kroku. Ten wpis jest dla badaczy i doktorantów, którzy mają czynnik o kilku poziomach, zwłaszcza uporządkowanych (dawki, liczba sesji, poziomy trudności), i chcą przełożyć hipotezy na testy. Pokazujemy cały proces w R na jednym badaniu:
- dobór wag i sprawdzenie ortogonalności,
- test kontrastu z przedziałem ufności i wielkością efektu,
- analiza trendu wielomianowego i test braku dopasowania,
- kontrast interakcyjny, czyli porównanie kształtu krzywej w dwóch grupach,
- korekty, moc oraz gotowy opis i tabela APA.
Badanie przykładowe: dawka kofeiny a wynik testu uwagi
W przykładzie (dane symulowane) 240 dorosłych losowo przydzielono do jednej z czterech dawek kofeiny: 0 mg (placebo), 100, 200 i 300 mg. Po 45 minutach wykonywali komputerowy test uwagi, którego wynik ma skalę zbliżoną do wyników T (średnia około 50, odchylenie około 10). Połowa uczestników rzadko pije kawę, połowa pije ją codziennie. Losowanie przeprowadzono osobno w obu grupach, a w każdej z 8 komórek jest 30 osób. Taki układ to schemat eksperymentalny 2 × 4: dawka jest czynnikiem manipulowanym, a nawyk picia kawy czynnikiem mierzonym.
Przed zebraniem danych zapisano w prerejestracji trzy hipotezy dla osób rzadko pijących kawę i jedną dotyczącą różnicy między grupami:
- H1: średni wynik po kofeinie (średnia z trzech dawek) jest wyższy niż po placebo;
- H2: wynik rośnie wraz z dawką (trend liniowy);
- H3: wzrost słabnie przy wyższych dawkach, więc krzywa jest wklęsła (ujemny trend kwadratowy);
- H4: u osób pijących kawę codziennie krzywa jest mniej wygięta niż u osób pijących ją rzadko (różnica trendów kwadratowych).
Kolejność jest ważna. Wagi wynikają z hipotez, a hipotezy z teorii. Nie zaglądaliśmy do średnich, zanim je zapisaliśmy. Jak zapisać taki plan w protokole, pokazuje wpis plan analizy statystycznej i prerejestracja.
Plik do pobrania: kofeina-uwaga-kontrasty-dane.csv. Plik ma 240 wierszy i kolumny id, nawyk („rzadko” albo „codziennie”), dawka (0, 100, 200, 300) i uwaga (wynik testu). Wszystkie liczby w tekście, tabeli i na rysunkach pochodzą z kodu w sekcji Kontrasty i trend w R.
| Dawka | n | M | SD |
|---|---|---|---|
| 0 mg (placebo) | 30 | 46.03 | 8.72 |
| 100 mg | 30 | 52.77 | 9.15 |
| 200 mg | 30 | 56.40 | 7.76 |
| 300 mg | 30 | 52.20 | 10.66 |
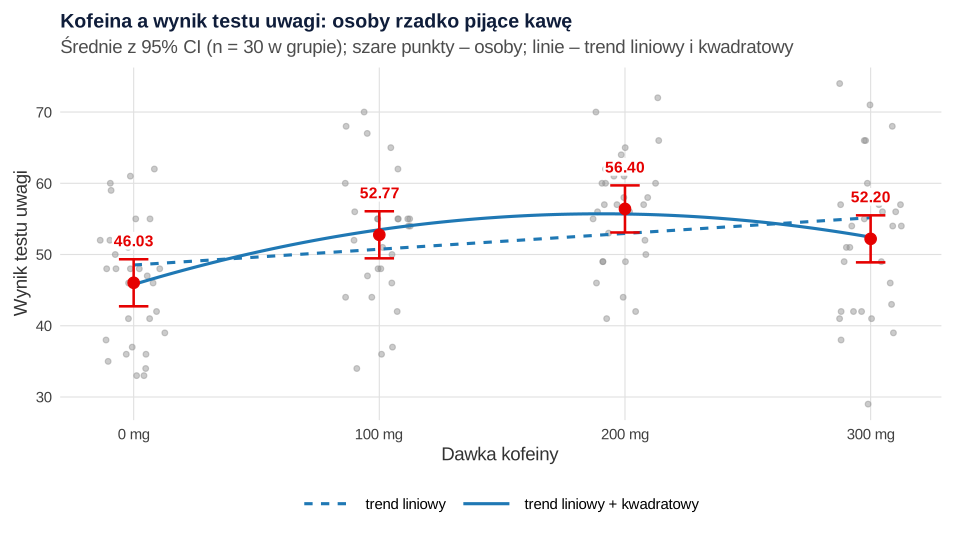
Dla porządku policzyliśmy też test omnibusowy: F(3, 116) = 6.66, p < .001, a w wersji Welcha F(3, 64.10) = 7.80, p < .001. Do sprawdzenia hipotez H1–H3 ten wynik nie jest potrzebny. Kontrast planowany nie wymaga wcześniejszego istotnego testu F i nie jest od niego „uzależniony”. Rysunek 1 pokazuje średnie, rozrzut wyników i dwie krzywe trendu, o których mowa niżej.
Krok 1. Zamień hipotezy na wagi
Kontrast to liczba L = Σ cjMj, gdzie Mj to średnie grup, a cj to wagi. Wagi muszą spełniać jeden warunek: sumują się do zera. Dzięki temu kontrast wynosi zero, gdy wszystkie średnie są równe, a hipoteza zerowa brzmi L = 0. Znak wagi mówi, po której stronie porównania stoi grupa. Wartość bezwzględna mówi, ile ta grupa waży w porównaniu.
| Hipoteza | 0 mg | 100 mg | 200 mg | 300 mg | Co mierzy estymata |
|---|---|---|---|---|---|
| H1: placebo a kofeina | −1 | 1/3 | 1/3 | 1/3 | różnicę średniej z trzech dawek i placebo w punktach testu |
| H2: trend liniowy | −3 | −1 | 1 | 3 | nachylenie (po przeskalowaniu na 100 mg) |
| H3: trend kwadratowy | 1 | −1 | −1 | 1 | wygięcie: skrajne dawki minus środkowe |
| (trend sześcienny) | −1 | 3 | −3 | 1 | resztę kształtu po trendzie liniowym i kwadratowym |
Przy H1 wybraliśmy wagi tak, aby suma wag dodatnich wynosiła 1, a ujemnych −1. Wtedy estymata kontrastu jest zwykłą różnicą dwóch średnich w jednostkach skali i nie trzeba jej przeliczać. Wagi (−3, 1, 1, 1) dałyby ten sam test t i to samo p, ale estymatę trzy razy większą. Wiens i Nilsson (2017) podkreślają, że wielkością efektu z analizy kontrastów jest po prostu różnica średnich, a jej przedział ufności mówi wprost o kierunku i znaczeniu efektu. Ta zaleta przepada, gdy wagi mają dowolną skalę.
Wagi trendów to wielomiany ortogonalne dla czterech równo oddalonych poziomów. W R daje je funkcja contr.poly() w wersji znormalizowanej. Powyżej podajemy je przeskalowane do liczb całkowitych, bo łatwiej je czytać. Dwa kontrasty są ortogonalne, gdy przy równych liczebnościach suma iloczynów ich wag wynosi zero, np. dla trendu liniowego i kwadratowego: (−3)(1) + (−1)(−1) + (1)(−1) + (3)(1) = 0. Przy nierównych liczebnościach warunek brzmi Σ c1jc2j/nj = 0. Ortogonalne kontrasty dzielą zmienność międzygrupową na niezależne części. Wrócimy do tego przy analizie trendu.
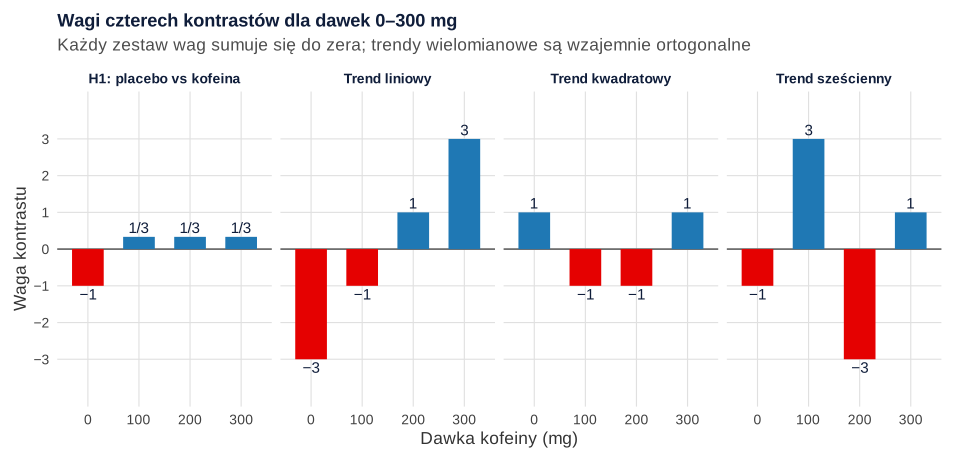
Czy H1 musi być ortogonalna do trendów? Nie musi. Suma iloczynów wag H1 i trendu liniowego wynosi 4, więc te kontrasty częściowo się pokrywają. Oba porównują niskie dawki z wysokimi. Nieortogonalne kontrasty planowane są dopuszczalne, jeśli każdy odpowiada na osobne pytanie z teorii. Trzeba tylko pamiętać, że ich wyniki nie są niezależne, a ich sumy kwadratów nie sumują się do sumy kwadratów efektu. Ile kontrastów można sprawdzić w jednym badaniu, omawia hasło o kontrastach planowanych. My mamy trzy, czyli tyle, ile stopni swobody ma czynnik.
Krok 2. Test kontrastu, przedział ufności i wielkość efektu
Błąd standardowy kontrastu w schemacie międzyobiektowym liczy się z wariancji wewnątrzgrupowej z całego modelu (MSE):
W R najprościej zrobić to pakietem emmeans. Najpierw dopasowujesz model liniowy, potem liczysz średnie brzegowe, a na końcu przekazujesz funkcji contrast() listę wag. Wynik dla osób rzadko pijących kawę:
- H1, placebo a kofeina: średnia z trzech dawek była wyższa niż po placebo o 7.76 punktu, 95% CI [3.94, 11.57], t(116) = 4.03, p < .001.
- H2, trend liniowy: L = 22.13, 95% CI [7.37, 36.90], t(116) = 2.97, p = .004.
- H3, trend kwadratowy: L = −10.93, 95% CI [−17.54, −4.33], t(116) = −3.28, p = .001.
Estymatę H1 można od razu wpisać do tekstu, bo jest różnicą średnich w punktach testu. Aby porównać ją z innymi badaniami, podziel ją przez odchylenie standardowe wewnątrzgrupowe, czyli pierwiastek z MSE (tu 9.13). Daje to standaryzowaną różnicę g = 0.85, 95% CI [0.43, 1.27]. Przedział policzyliśmy w przybliżeniu, dzieląc granice przedziału estymaty przez to samo odchylenie. Interpretację takich wartości omawia hasło d Cohena, a szerzej wpis wielkość efektu – interpretacja. Estymat H2 i H3 nie da się tak czytać. Zależą od skali wag, więc w kroku 3 zamieniamy je na jednostki o jasnym znaczeniu.
Uwaga na nierówne wariancje. Odchylenia w grupach wynoszą od 7.76 do 10.66, czyli ich stosunek jest umiarkowany, a liczebności są równe. Wtedy wspólne MSE nie stanowi problemu. Przy wyraźnie nierównych wariancjach i nierównych grupach licz błąd standardowy kontrastu z osobnych wariancji grup, ze stopniami swobody Welcha–Satterthwaite’a. To ta sama logika, którą Delacre i in. (2019) uzasadniają domyślny wybór testu F Welcha zamiast klasycznego. Więcej o tym założeniu piszemy w haśle homogeniczność wariancji.
Krok 3. Analiza trendu: liniowy, kwadratowy i sześcienny
Gdy poziomy czynnika są uporządkowane i równo oddalone, wielomiany ortogonalne rozkładają różnice między średnimi na składowe o prostej interpretacji. Przy czterech grupach są trzy składowe: liniowa (stały wzrost lub spadek), kwadratowa (jedno wygięcie, kształt U lub odwróconego U) i sześcienna (dwa wygięcia). Jest ich tyle, ile stopni swobody ma czynnik, a ich sumy kwadratów sumują się dokładnie do sumy kwadratów międzygrupowej. Suma kwadratów kontrastu to SSL = L² / Σ(cj²/nj).
| Składowa | L [95% CI] | t(116) | p | SS | Udział w SS międzygrupowej |
|---|---|---|---|---|---|
| Liniowa | 22.13 [7.37, 36.90] | 2.97 | .004 | 734.83 | 44.1% |
| Kwadratowa | −10.93 [−17.54, −4.33] | −3.28 | .001 | 896.53 | 53.9% |
| Sześcienna | −4.73 [−19.50, 10.03] | −0.63 | .527 | 33.61 | 2.0% |
| Razem (efekt dawki) | – | – | – | 1664.97 | 100% |
Wynik czytaj tak. Ponad połowa różnic między grupami to wygięcie krzywej, a 44.1% to ogólny wzrost. Trend sześcienny jest bliski zeru, więc dwa pierwsze trendy w pełni opisują kształt zależności. Aby opisać ją w zrozumiałych jednostkach, przelicz estymaty:
- Nachylenie liniowe: 2.21 punktu na każde 100 mg. To współczynnik regresji wyniku na dawkę liczbową. Przy równych liczebnościach daje ten sam test co kontrast liniowy.
- Wygięcie: estymata kwadratowa podzielona przez 2 to różnica średniej skrajnych dawek (0 i 300 mg) i średniej środkowych (100 i 200 mg). Wynosi −5.47 punktu, czyli średnie środkowych dawek leżą wyżej, niż przewidywałaby prosta.
- Wierzchołek paraboli: w modelu kwadratowym szczyt wypada przy około 190 mg (rysunek 1). To opis dopasowanej krzywej, a nie oszacowanie „optymalnej dawki”. Nie ma przedziału ufności i zależy od tego, że badaliśmy tylko cztery dawki.
Hipoteza H3 dotyczyła krzywej wklęsłej, a nie konkretnie odwróconego U. Istotny ujemny trend kwadratowy pasuje do obu kształtów: do plateau i do spadku przy najwyższej dawce. O tym, który kształt opisuje dane, mówią same średnie (52.20 przy 300 mg wobec 56.40 przy 200 mg) i ich przedziały ufności. Jeśli teoria przewiduje spadek, zaplanuj osobny kontrast, np. 200 a 300 mg, zanim zobaczysz dane.
Trend jako regresja i test braku dopasowania
Ten sam wynik dostaniesz, traktując dawkę jako zmienną liczbową w regresji krzywoliniowej. Model z samym członem liniowym porównujesz z modelem z członem kwadratowym, a ten z modelem, w którym każda dawka ma własną średnią (ANOVA). Dodanie członu kwadratowego wyraźnie poprawia dopasowanie, F(1, 116) = 10.75, p = .001. Kolejny krok to test braku dopasowania (lack of fit): czy cztery osobne średnie opisują dane lepiej niż parabola? Nie opisują, F(1, 116) = 0.40, p = .527. To dokładnie test trendu sześciennego (−0.63² ≈ 0.40), tylko inaczej nazwany.
Podejście regresyjne przydaje się w dwóch sytuacjach. Po pierwsze, gdy odstępy między poziomami są nierówne. Dla dawek 0, 50, 100 i 200 mg wagi z tabeli nie pasują. Funkcja contr.poly(4, scores = c(0, 50, 100, 200)) zwraca wtedy wagi liniowe −0.592, −0.254, 0.085 i 0.761 oraz kwadratowe 0.564, −0.322, −0.645 i 0.403. To nadal wielomiany ortogonalne, tylko dopasowane do prawdziwych odległości. Po drugie, gdy chcesz przewidywać wynik dla dawek pośrednich. Pamiętaj jednak, że z czterech punktów nie da się wiarygodnie oszacować krzywej spoza badanego zakresu. W pracy podaj, czy dawkę traktowałeś jako czynnik, czy jako zmienną liczbową, i jakie wartości przypisałeś poziomom.
Krok 4. Kontrast interakcyjny: czy krzywa ma ten sam kształt w obu grupach?
Hipoteza H4 dotyczy różnicy kształtu krzywej między osobami pijącymi kawę rzadko i codziennie, a więc interakcji dawki i nawyku. Dwuczynnikowa ANOVA 2 × 4 (sumy kwadratów typu II) daje wyraźny efekt dawki, F(3, 232) = 8.98, p < .001. Efekt nawyku jest nieistotny, F(1, 232) = 0.59, p = .443, podobnie jak omnibusowy test interakcji, F(3, 232) = 1.07, p = .364. Ten ostatni test ma 3 stopnie swobody i sprawdza każdą możliwą różnicę wzoru średnich. Nasza hipoteza była węższa.
Abelson i Prentice (1997) przekonują, że hipotezy o interakcji w ANOVA dwuczynnikowej warto testować kontrastami interakcyjnymi zaplanowanymi z góry. Opisują m.in. test różnicy krzywoliniowości dwóch profili. Kontrast interakcyjny tworzy się, mnożąc wagi dwóch czynników: tu wagi trendu kwadratowego (1, −1, −1, 1) i wagi grup (−1 dla „rzadko”, 1 dla „codziennie”). W emmeans robi to argument interaction = c(dawka_f = "poly", nawyk = "revpairwise"). Wyniki (rysunek 3):
- Trendy proste (osobno w każdej grupie, z MSE całego modelu). U osób rzadko pijących kawę trend kwadratowy wyniósł −10.93, 95% CI [−18.13, −3.74], t(232) = −2.99, p = .003. U osób pijących codziennie wyniósł −2.43, 95% CI [−9.63, 4.76], t(232) = −0.67, p = .506. Trend liniowy był istotny w obu grupach: 22.13, t(232) = 2.71, p = .007, oraz 29.43, t(232) = 3.61, p < .001.
- Kontrast interakcyjny H4, czyli różnica trendów kwadratowych (codziennie minus rzadko): 8.50, 95% CI [−1.67, 18.67], t(232) = 1.65, p = .101. Różnica trendów liniowych: 7.30, 95% CI [−15.45, 30.05], t(232) = 0.63, p = .528.
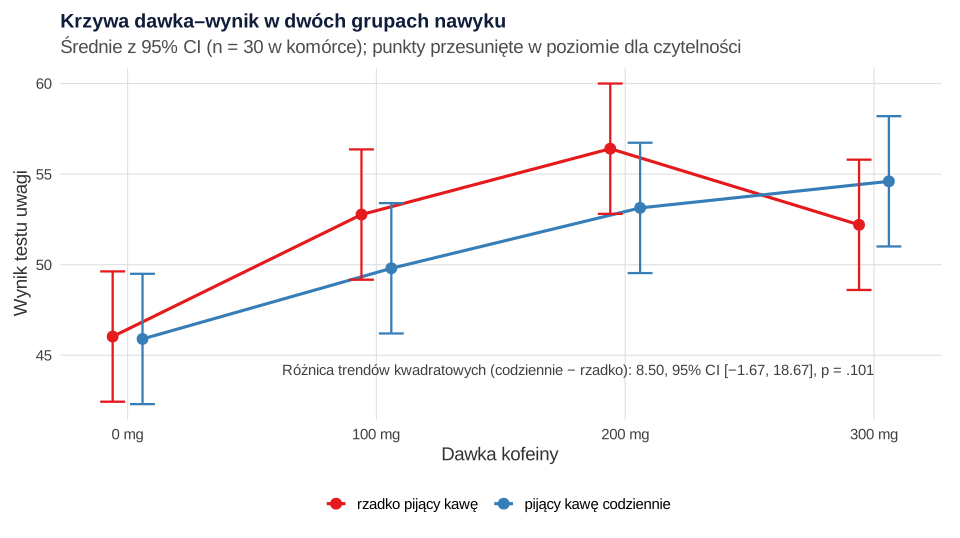
To typowa pułapka. Trend kwadratowy jest istotny w jednej grupie i nieistotny w drugiej, a rysunek sugeruje różne kształty. Kusi więc zdanie „efekt zależy od nawyku”. Gelman i Stern (2006) pokazują, że nawet duża różnica wartości p może odpowiadać małej, nieistotnej różnicy samych efektów, dlatego porównanie trzeba testować bezpośrednio. Tutaj test bezpośredni to kontrast interakcyjny. Jego przedział obejmuje zero, a także różnice dość duże. Hipotezy H4 nie potwierdzono, ale też jej nie obalono. Uczciwy wniosek brzmi: dane są zgodne zarówno z brakiem różnicy kształtu, jak i z różnicą umiarkowaną.
Ten wynik to także kwestia mocy. Sommet i in. (2023) w metabadaniu 159 badań oszacowali medianę mocy wykrycia interakcji typowej wielkości na zaledwie .18. Podają też zalecenia liczebności, które zależą od kształtu interakcji. Jeśli H4 jest dla Ciebie kluczowa, planuj liczebność pod kontrast interakcyjny, a nie pod efekt główny. Narzędzia znajdziesz we wpisie dobór liczebności próby. Efekty proste opisuje hasło efekt prosty, a układy z trzema czynnikami hasło interakcja trójczynnikowa. Rosnow i Rosenthal (1989) przypominają, że interakcja to reszta po usunięciu efektów głównych, a nie zestaw efektów prostych. Kontrast interakcyjny dokładnie tę resztę testuje.
Krok 5. Czy kontrasty planowane trzeba korygować?
To zależy od tego, jak wyniki przekładają się na wnioski, a nie od samej liczby testów. Rubin (2021) wyróżnia trzy sytuacje. Korekta jest potrzebna przy testowaniu alternatywy, gdy do odrzucenia łącznej hipotezy wystarczy jeden istotny wynik z kilku. Nie jest potrzebna przy testowaniu indywidualnym, gdy każdy test weryfikuje osobną hipotezę, ani przy testowaniu koniunkcji, gdy istotne muszą być wszystkie wyniki. Bender i Lange (2001) podkreślają, że w badaniach konfirmacyjnych korekta jest konieczna zawsze wtedy, gdy wyniki wielu testów łączysz w jeden wniosek.
H1–H3 to trzy osobne hipotezy, każda z własnym uzasadnieniem, więc w prerejestracji przyjęliśmy α = .05 dla każdej. Gdyby te trzy kontrasty tworzyły rodzinę, np. „kofeina wpływa na uwagę, jeśli którykolwiek kontrast jest istotny”, użylibyśmy metody Holma. Skorygowane wartości wyniosłyby p < .001 dla H1, p = .004 dla H2 i p = .003 dla H3, a wnioski by się nie zmieniły. Decyzję zapisz z góry i podaj w tekście. Porównanie metod korekty znajdziesz we wpisie poprawki na wielokrotne porównania i w haśle problem wielokrotnych porównań.
Inaczej jest z kontrastem wymyślonym po obejrzeniu średnich. Załóżmy, że ktoś zobaczył rysunek 1 i postanowił porównać placebo z dawką 200 mg, bo „najbardziej się różnią”. Bez korekty wynik wygląda tak: 10.37 punktu, 95% CI [5.70, 15.04], t(116) = 4.40, p < .001. Taki kontrast pochodzi jednak z przeszukania wszystkich możliwych porównań. Uczciwą ochronę daje wtedy procedura Scheffégo, opisana jako metoda oceny wszystkich kontrastów w ANOVA (Scheffé, 1953). Midway i in. (2020) zalecają ją właśnie dla dowolnych kombinacji liniowych średnich. Z korektą Scheffégo przedział rozszerza się do [3.68, 17.06], a p < .001. Tutaj efekt jest duży i wynik się utrzymuje, ale przy słabszych efektach różnica bywa rozstrzygająca. Szczegóły podaje hasło test Scheffégo.
Najgorsze rozwiązanie to przedstawić taki kontrast jako planowany. Kerr (1998) nazywa to HARKingiem, czyli przedstawianiem hipotezy post hoc tak, jakby była hipotezą a priori (zob. HARKing). W artykule oddziel więc wyraźnie analizy konfirmacyjne od eksploracyjnych, a te drugie opisz jako eksploracyjne, z odpowiednią korektą.
Dlaczego kontrast ma większą moc niż test F
Omnibusowy test F rozkłada efekt na wszystkie stopnie swobody czynnika. Kontrast kieruje go na jeden stopień, ten, który przewiduje hipoteza. Gdy hipoteza trafnie opisuje wzór średnich, zysk mocy jest spory. Pokazuje to symulacja na rysunku 4: cztery grupy, średnie rosnące liniowo, różnica skrajnych grup 0.36 SD, 4000 powtórzeń dla każdej liczebności.
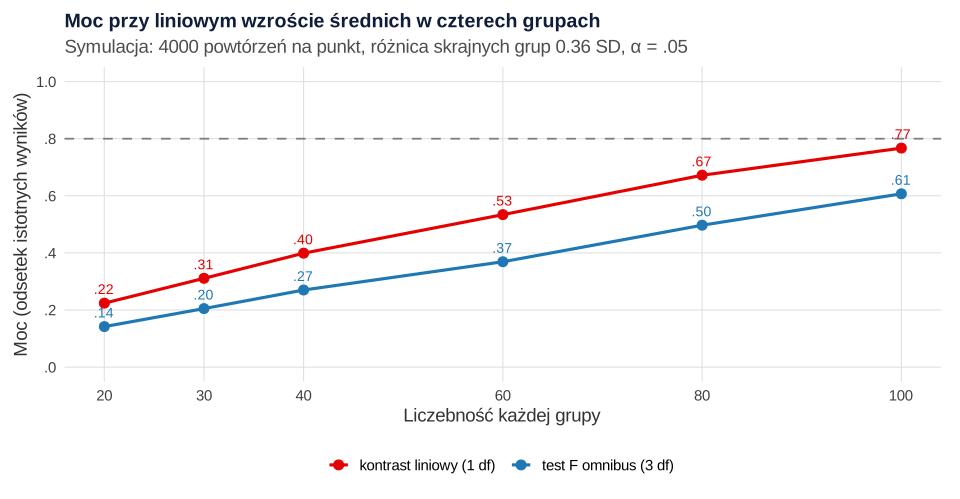
Przy 60 osobach w grupie kontrast liniowy wykrywa efekt w 53% symulowanych badań, a test F w 37%. Przy 100 osobach jest to 77% wobec 61%. Ta przewaga nie jest jednak darmowa. Gdyby prawdziwy wzór był kwadratowy, kontrast liniowy mógłby go w ogóle nie zauważyć. Moc kontrastu wynika z trafności teorii, która go wyznaczyła. Granziol i in. (2025) wskazują ten zysk jako główny powód, by porównania planować przed badaniem. Ogólne zasady opisuje hasło moc testu. Przy planowaniu liczebności pod kontrast wystarczy symulacja taka jak w przepisie 4: zmieniasz zakładane średnie i liczebności, a potem odczytujesz moc.
Kontrasty w pomiarach powtarzanych i odpowiedniki nieparametryczne
Gdy te same osoby badasz na kilku poziomach czynnika (np. cztery sesje albo cztery poziomy trudności), kontrast liczysz dla każdej osoby osobno. Mnożysz jej wyniki przez wagi i sumujesz, a potem sprawdzasz testem t dla jednej próby, czy średni wynik kontrastu różni się od zera. Takie podejście ma ważną zaletę. Kontrast ma jeden stopień swobody, więc nie dotyczy go założenie sferyczności, które w omnibusowej ANOVA z powtarzanymi pomiarami wymaga poprawek. Pełny przykład schematu wewnątrzobiektowego znajdziesz w poradniku ANOVA z powtarzanymi pomiarami krok po kroku, a wybór między ANOVA a modelem mieszanym we wpisie ANOVA z powtarzanymi pomiarami czy model mieszany. W modelu mieszanym kontrasty ustawiasz tak samo, przez macierz kontrastów czynnika. Schad i in. (2020) pokazują to szczegółowo, łącznie z kontrastami powtarzanymi i zagnieżdżonymi.
Jeśli wynik jest porządkowy albo ma silnie nienormalne rozkłady, kierunkowy trend w niezależnych grupach sprawdzisz testem Jonckheere’a–Terpstry. Test ten wykorzystuje porządek grup, ale nie rozdziela trendu na składowe liniową i kwadratową. Dla odsetków w uporządkowanych grupach (tabela 2 × k) odpowiednikiem kontrastu liniowego jest test trendu Cochrana–Armitage’a. Kiedy w ogóle sięgać po testy nieparametryczne, wyjaśnia wpis testy nieparametryczne krok po kroku.
Jak opisać kontrasty i analizę trendu w artykule (APA)
W części metod podaj: hipotezy i odpowiadające im wagi (najlepiej w tabeli albo w nocie), informację, że kontrasty zaplanowano przed analizą (z odwołaniem do prerejestracji), sposób liczenia błędu standardowego (wspólne MSE albo osobne wariancje) i decyzję o korekcie. W wynikach podaj dla każdego kontrastu estymatę z 95% CI w interpretowalnych jednostkach, t ze stopniami swobody i dokładne p. Dla trendu dodaj udział w zmienności międzygrupowej. Statystyki opisowe zbierz w tabeli jak w haśle tabela ANOVA w APA.
Tabela 1
Kontrasty planowane dla dawki kofeiny i wyniku testu uwagi
| Hipoteza (kontrast) | Estymata | SE | LL | UL | t | p |
|---|---|---|---|---|---|---|
| H1: placebo a kofeina | 7.76 | 1.93 | 3.94 | 11.57 | 4.03 | < .001 |
| H2: trend liniowy | 22.13 | 7.46 | 7.37 | 36.90 | 2.97 | .004 |
| H3: trend kwadratowy | −10.93 | 3.33 | −17.54 | −4.33 | −3.28 | .001 |
| H4: trend kwadratowy × nawyk | 8.50 | 5.16 | −1.67 | 18.67 | 1.65 | .101 |
Uwaga. Dane symulowane. H1–H3: osoby rzadko pijące kawę, n = 30 w każdej z czterech grup, df = 116. H4: obie grupy nawyku (N = 240), df = 232. Wagi H1: −1, 1/3, 1/3, 1/3 (estymata to różnica średnich w punktach testu); trend liniowy: −3, −1, 1, 3; trend kwadratowy: 1, −1, −1, 1; H4: wagi trendu kwadratowego pomnożone przez −1 (rzadko) i 1 (codziennie). Kontrasty zaplanowano przed zebraniem danych; bez korekty na wielokrotne testowanie. LL i UL to dolna i górna granica 95% przedziału ufności.
Jeśli recenzent pyta, dlaczego nie ma testów post hoc, odpowiedz, że hipotezy były kierunkowe i zaplanowane, a kontrasty sprawdzają je bezpośrednio. Wzory takich odpowiedzi zebraliśmy we wpisie odpowiedź recenzentom – wzory PL i EN. Gdy przygotowujesz artykuł albo rozdział doktoratu i chcesz, by ktoś sprawdził dobór wag, kod i opis, zajrzyj do oferty analiz statystycznych dla badaczy. Konsultujemy plan i wyjaśniamy wyniki tak, abyś mógł (mogła) samodzielnie ich bronić.
Kontrasty i trend w R
Kod odtwarza wszystkie liczby z tekstu, tabeli i rysunków. Pobierz plik kofeina-uwaga-kontrasty-dane.csv, zapisz go w katalogu roboczym R i uruchom przepisy. Każdy przepis wczytuje dane sam, więc możesz je uruchamiać osobno. Potrzebne pakiety: emmeans i car.
1. Statystyki opisowe, test omnibus i trzy kontrasty planowane
R
# 1. Kontrasty planowane w jednoczynnikowym schemacie: osoby rzadko pijące kawę (n = 120)
options(width = 110)
suppressPackageStartupMessages(library(emmeans))
dane <- read.csv("kofeina-uwaga-kontrasty-dane.csv")
rz <- subset(dane, nawyk == "rzadko")
rz$dawka_f <- factor(rz$dawka, levels = c(0, 100, 200, 300), labels = c("0 mg", "100 mg", "200 mg", "300 mg"))

# Statystyki opisowe w grupach
opis <- aggregate(uwaga ~ dawka_f, rz, function(x) c(n = length(x), M = mean(x), SD = sd(x)))
print(do.call(data.frame, opis), digits = 4)

# Test omnibus (dla porządku) – klasyczny F i F Welcha
m <- lm(uwaga ~ dawka_f, data = rz)
print(anova(m))
print(oneway.test(uwaga ~ dawka_f, data = rz))

# Kontrasty planowane: wagi ustalone przed analizą
sr <- emmeans(m, ~ dawka_f)
kontrasty <- list(
  "H1: placebo vs kofeina" = c(-1, 1/3, 1/3, 1/3),
  "H2: trend liniowy"      = c(-3, -1, 1, 3),
  "H3: trend kwadratowy"   = c(1, -1, -1, 1))
K <- do.call(rbind, kontrasty)
cat("Sumy wag:", rowSums(K), "\n")
cat("Iloczyny wag (ortogonalność, równe n):\n"); print(K %*% t(K))
wyn <- summary(contrast(sr, kontrasty), infer = TRUE)
print(wyn, digits = 4)

# Wielkość efektu kontrastu: estymata podzielona przez pierwiastek z MSE (odchylenie wewnątrzgrupowe)
sd_w <- sigma(m)
cat("SD wewnątrzgrupowe (pierwiastek MSE):", round(sd_w, 2), "\n")
cat("g kontrastu H1:", round(wyn$estimate[1] / sd_w, 2), "\n")
# Dla H1 z CI: przedział estymaty podzielony przez sd_w
cat("95% CI g dla H1 (przybliżone):", round(c(wyn$lower.CL[1], wyn$upper.CL[1]) / sd_w, 2), "\n")

# Gdy trzy kontrasty mają tworzyć jedną rodzinę: korekta Holma
print(summary(contrast(sr, kontrasty), adjust = "holm"), digits = 4)
Wynik w R
  dawka_f uwaga.n uwaga.M uwaga.SD
1    0 mg      30   46.03    8.720
2  100 mg      30   52.77    9.149
3  200 mg      30   56.40    7.762
4  300 mg      30   52.20   10.656
Analysis of Variance Table

Response: uwaga
           Df Sum Sq Mean Sq F value    Pr(>F)
dawka_f     3 1665.0  554.99   6.656 0.0003465 ***
Residuals 116 9672.3   83.38
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

	One-way analysis of means (not assuming equal variances)

data:  uwaga and dawka_f
F = 7.8012, num df = 3.000, denom df = 64.097, p-value = 0.0001618

Sumy wag: -1.110223e-16 0 0
Iloczyny wag (ortogonalność, równe n):
                       H1: placebo vs kofeina H2: trend liniowy H3: trend kwadratowy
H1: placebo vs kofeina               1.333333                 4            -1.333333
H2: trend liniowy                    4.000000                20             0.000000
H3: trend kwadratowy                -1.333333                 0             4.000000
 contrast               estimate    SE  df lower.CL upper.CL t.ratio p.value
 H1: placebo vs kofeina    7.756 1.925 116    3.943   11.568   4.029  0.0001
 H2: trend liniowy        22.133 7.456 116    7.366   36.900   2.969  0.0036
 H3: trend kwadratowy    -10.933 3.334 116  -17.537   -4.329  -3.279  0.0014

Confidence level used: 0.95
SD wewnątrzgrupowe (pierwiastek MSE): 9.13
g kontrastu H1: 0.85
95% CI g dla H1 (przybliżone): 0.43 1.27
 contrast               estimate    SE  df t.ratio p.value
 H1: placebo vs kofeina    7.756 1.925 116   4.029  0.0003
 H2: trend liniowy        22.133 7.456 116   2.969  0.0036
 H3: trend kwadratowy    -10.933 3.334 116  -3.279  0.0028

P value adjustment: holm method for 3 tests
2. Analiza trendu, test braku dopasowania, nierówne odstępy i kontrast post hoc
R
# 2. Analiza trendu: wielomiany ortogonalne, część zmienności międzygrupowej, brak dopasowania
options(width = 110)
suppressPackageStartupMessages(library(emmeans))
dane <- read.csv("kofeina-uwaga-kontrasty-dane.csv")
rz <- subset(dane, nawyk == "rzadko")
rz$dawka_f <- factor(rz$dawka)
m <- lm(uwaga ~ dawka_f, data = rz)
sr <- emmeans(m, ~ dawka_f)

# Wagi wielomianów ortogonalnych dla 4 równo odległych poziomów
print(round(sweep(contr.poly(4), 2, c(sqrt(20), 2, sqrt(20)), "*"), 3))   # przeskalowane do liczb całkowitych
pol <- summary(contrast(sr, "poly"), infer = TRUE)
print(pol, digits = 4)
# Interpretacja w punktach: kontrast kwadratowy / 2 = średnia skrajnych dawek minus średnia środkowych
cat("Średnia (0, 300 mg) minus średnia (100, 200 mg):", round(pol$estimate[2] / 2, 2), "\n")

# Suma kwadratów każdego trendu i udział w SS międzygrupowej
n_g <- 30
wagi <- list(liniowy = c(-3, -1, 1, 3), kwadratowy = c(1, -1, -1, 1), szescienny = c(-1, 3, -3, 1))
M <- summary(sr)$emmean
SS <- sapply(wagi, function(w) sum(w * M)^2 / sum(w^2 / n_g))
SS_miedzy <- anova(m)["dawka_f", "Sum Sq"]
print(round(rbind(SS = SS, udzial_proc = 100 * SS / SS_miedzy), 2))
cat("SS międzygrupowa:", round(SS_miedzy, 2), " suma SS trendów:", round(sum(SS), 2), "\n")

# To samo jako regresja wielomianowa na dawce (ortogonalne wielomiany) i test braku dopasowania
m_lin  <- lm(uwaga ~ dawka, data = rz)
m_kw   <- lm(uwaga ~ poly(dawka, 2), data = rz)
print(anova(m_lin, m_kw, m))                          # liniowy -> kwadratowy -> pełny (4 średnie)
b_lin <- coef(m_lin)["dawka"] * 100
cat("Nachylenie liniowe na 100 mg:", round(b_lin, 2), "\n")
# Wierzchołek paraboli z modelu kwadratowego w surowych jednostkach
m_kw_raw <- lm(uwaga ~ dawka + I(dawka^2), data = rz)
b <- coef(m_kw_raw); cat("Wierzchołek paraboli (mg):", round(-b[2] / (2 * b[3])), "\n")

# Nierówne odstępy: wagi dla dawek 0, 50, 100, 200 mg
cat("Wagi liniowe i kwadratowe dla dawek 0, 50, 100, 200 mg:\n")
print(round(contr.poly(4, scores = c(0, 50, 100, 200))[, 1:2], 3))

# Kontrast wybrany po obejrzeniu średnich (0 vs 200 mg): bez korekty i z korektą Scheffégo
poh <- list("0 vs 200 mg (po obejrzeniu)" = c(-1, 0, 1, 0))
print(summary(contrast(sr, poh), infer = TRUE, adjust = "none"), digits = 4)
print(summary(contrast(sr, poh), infer = TRUE, adjust = "scheffe", scheffe.rank = 3), digits = 4)
Wynik w R
     .L .Q .C
[1,] -3  1 -1
[2,] -1 -1  3
[3,]  1 -1 -3
[4,]  3  1  1
 contrast  estimate    SE  df lower.CL upper.CL t.ratio p.value
 linear      22.133 7.456 116    7.366   36.900   2.969  0.0036
 quadratic  -10.933 3.334 116  -17.537   -4.329  -3.279  0.0014
 cubic       -4.733 7.456 116  -19.500   10.034  -0.635  0.5268

Confidence level used: 0.95
Średnia (0, 300 mg) minus średnia (100, 200 mg): -5.47
            liniowy kwadratowy szescienny
SS           734.83     896.53      33.61
udzial_proc   44.13      53.85       2.02
SS międzygrupowa: 1664.97  suma SS trendów: 1664.97
Analysis of Variance Table

Model 1: uwaga ~ dawka
Model 2: uwaga ~ poly(dawka, 2)
Model 3: uwaga ~ dawka_f
  Res.Df     RSS Df Sum of Sq      F   Pr(>F)
1    118 10602.5
2    117  9705.9  1    896.53 10.752 0.001375 **
3    116  9672.3  1     33.61  0.403 0.526772
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Nachylenie liniowe na 100 mg: 2.21
Wierzchołek paraboli (mg): 190
Wagi liniowe i kwadratowe dla dawek 0, 50, 100, 200 mg:
         .L     .Q
[1,] -0.592  0.564
[2,] -0.254 -0.322
[3,]  0.085 -0.645
[4,]  0.761  0.403
 contrast                    estimate    SE  df lower.CL upper.CL t.ratio p.value
 0 vs 200 mg (po obejrzeniu)    10.37 2.358 116    5.697    15.04   4.397 <0.0001

Confidence level used: 0.95
 contrast                    estimate    SE  df lower.CL upper.CL t.ratio p.value
 0 vs 200 mg (po obejrzeniu)    10.37 2.358 116    3.678    17.06   4.397  0.0004

Confidence level used: 0.95
Conf-level adjustment: scheffe method with rank 3
P value adjustment: scheffe method with rank 3
3. Kontrast interakcyjny: trend × grupa nawyku
R
# 3. Kontrast interakcyjny: czy kształt krzywej dawka–wynik różni się między grupami nawyku?
options(width = 110)
suppressPackageStartupMessages(library(emmeans))
dane <- read.csv("kofeina-uwaga-kontrasty-dane.csv")
dane$dawka_f <- factor(dane$dawka)
dane$nawyk <- factor(dane$nawyk, levels = c("rzadko", "codziennie"))
m2 <- lm(uwaga ~ dawka_f * nawyk, data = dane)
print(car::Anova(m2, type = 2))
sr2 <- emmeans(m2, ~ dawka_f | nawyk)
print(summary(sr2), digits = 4)
# Trendy proste: trend liniowy i kwadratowy osobno w każdej grupie
tp <- summary(contrast(sr2, "poly", max.degree = 2), infer = TRUE)
print(tp, digits = 4)
# Kontrast interakcyjny: różnica trendów między grupami (codziennie − rzadko)
sr3 <- emmeans(m2, ~ dawka_f * nawyk)
ki <- summary(contrast(sr3, interaction = c(dawka_f = "poly", nawyk = "revpairwise"), max.degree = 2), infer = TRUE)
print(ki, digits = 4)
Wynik w R
Anova Table (Type II tests)

Response: uwaga
               Sum Sq  Df F value    Pr(>F)
dawka_f        2691.6   3  8.9751 1.197e-05 ***
nawyk            59.0   1  0.5902    0.4431
dawka_f:nawyk   319.7   3  1.0662    0.3642
Residuals     23192.5 232
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
nawyk = rzadko:
 dawka_f emmean    SE  df lower.CL upper.CL
 0        46.03 1.825 232    42.44    49.63
 100      52.77 1.825 232    49.17    56.36
 200      56.40 1.825 232    52.80    60.00
 300      52.20 1.825 232    48.60    55.80

nawyk = codziennie:
 dawka_f emmean    SE  df lower.CL upper.CL
 0        45.90 1.825 232    42.30    49.50
 100      49.80 1.825 232    46.20    53.40
 200      53.13 1.825 232    49.54    56.73
 300      54.60 1.825 232    51.00    58.20

Confidence level used: 0.95
nawyk = rzadko:
 contrast  estimate    SE  df lower.CL upper.CL t.ratio p.value
 linear      22.133 8.164 232    6.049    38.22   2.711  0.0072
 quadratic  -10.933 3.651 232  -18.126    -3.74  -2.995  0.0030

nawyk = codziennie:
 contrast  estimate    SE  df lower.CL upper.CL t.ratio p.value
 linear      29.433 8.164 232   13.349    45.52   3.605  0.0004
 quadratic   -2.433 3.651 232   -9.626     4.76  -0.667  0.5058

Confidence level used: 0.95
 dawka_f_poly nawyk_revpairwise   estimate     SE  df lower.CL upper.CL t.ratio p.value
 linear       codziennie - rzadko      7.3 11.545 232  -15.447    30.05   0.632  0.5278
 quadratic    codziennie - rzadko      8.5  5.163 232   -1.673    18.67   1.646  0.1011

Confidence level used: 0.95
4. Symulacja mocy: kontrast liniowy a test F
R
# 4. Symulacja mocy: test F omnibus a kontrast liniowy, gdy średnie rosną liniowo
options(width = 110)
set.seed(9304)
moc <- function(n, R = 4000, mu = c(0, 1, 2, 3) * 0.12) {    # różnica między skrajnymi = 0.36 SD
  k <- 4; c_lin <- c(-3, -1, 1, 3)
  wyn <- replicate(R, {
    y <- matrix(rnorm(k * n, mean = rep(mu, each = n)), nrow = n)
    M <- colMeans(y); s2 <- mean(apply(y, 2, var)); df_e <- k * (n - 1)
    F_omn <- (n * sum((M - mean(M))^2) / (k - 1)) / s2
    t_lin <- sum(c_lin * M) / sqrt(s2 * sum(c_lin^2) / n)
    c(omnibus = pf(F_omn, k - 1, df_e, lower.tail = FALSE) < .05,
      liniowy = 2 * pt(abs(t_lin), df_e, lower.tail = FALSE) < .05)
  })
  rowMeans(wyn)
}
n_siatka <- c(20, 30, 40, 60, 80, 100)
tab <- t(sapply(n_siatka, moc))
tab <- data.frame(n_na_grupe = n_siatka, round(tab, 3))
print(tab)
Wynik w R
  n_na_grupe omnibus liniowy
1         20   0.142   0.224
2         30   0.205   0.311
3         40   0.270   0.399
4         60   0.369   0.534
5         80   0.497   0.672
6        100   0.607   0.767
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- car (wersja 3.1-5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy przy kontrastach i analizie trendu
- Wagi dobrane po obejrzeniu średnich, a opisane jako planowane. Takie porównanie jest post hoc i wymaga procedury Scheffégo albo jawnego oznaczenia jako eksploracyjne.
- Wagi, które nie sumują się do zera. To już nie jest kontrast, tylko test, czy ważona suma średnich różni się od zera. Wynik zwykle nie ma sensu.
- Interpretowanie surowej estymaty trendu jak różnicy średnich. Wartość L = 22.13 zależy od skali wag. Przelicz ją na nachylenie albo na różnicę dawek skrajnych i środkowych.
- Wielomiany dla równych odstępów przy nierównych dawkach. Dla poziomów 0, 50, 100, 200 użyj
contr.poly(4, scores = …)albo regresji na dawce liczbowej. - Analiza trendu dla czynnika bez naturalnego porządku. „Trend liniowy” rodzajów terapii zależy od tego, w jakiej kolejności je wypiszesz, więc nic nie znaczy.
- Wniosek o interakcji z porównania istotności efektów prostych. Istotny trend w jednej grupie i nieistotny w drugiej to nie dowód różnicy. Testuj kontrast interakcyjny.
- Traktowanie wierzchołka paraboli jak „optymalnej dawki”. Bez przedziału ufności i przy czterech poziomach to tylko opis dopasowanej krzywej.
- Uruchamianie kontrastów dopiero po istotnym F. Kontrast planowany nie potrzebuje tej bramki, a wymóg istotnego F niepotrzebnie obniża moc.
- Brak decyzji o korekcie w planie. Napisz z góry, czy kontrasty to osobne hipotezy, czy rodzina, i jaką metodę korekty stosujesz.
Gdy oprócz średnich chcesz modelować kształt zmian w czasie u każdej osoby, sięgnij po krzywe wzrostu (LGM) albo model wielopoziomowy. Wtedy trend liniowy i kwadratowy stają się parametrami trajektorii, a nie kontrastami średnich grup.
Najczęstsze pytania
Czym różni się kontrast planowany od testu post hoc po ANOVA?
Kontrast planowany wynika z hipotezy zapisanej przed analizą i testuje jedno konkretne porównanie, zwykle bez korekty albo z łagodną korektą rodziny kilku kontrastów. Test post hoc przeszukuje wiele porównań po obejrzeniu wyników, więc musi kontrolować błąd I rodzaju dla całej rodziny, np. metodą Tukeya albo Scheffégo. Kontrast wybrany po obejrzeniu średnich jest w praktyce porównaniem post hoc.
Co oznacza istotny trend kwadratowy w ANOVA?
Oznacza, że średnie kolejnych poziomów czynnika nie układają się na prostej, tylko krzywa ma jedno wygięcie: kształt U, odwróconego U albo plateau. Kierunek wygięcia pokazuje znak estymaty, ale konkretny kształt odczytasz dopiero ze średnich i ich przedziałów ufności. W przykładzie z kofeiną ujemny trend kwadratowy oznaczał, że wynik rósł coraz wolniej, a przy 300 mg był niższy niż przy 200 mg.
Jak dobrać wagi trendu, gdy odstępy między poziomami są nierówne?
Wagi z tablic (−3, −1, 1, 3 itd.) zakładają równe odstępy. Przy poziomach takich jak 0, 50, 100 i 200 mg użyj w R funkcji contr.poly(4, scores = c(0, 50, 100, 200)) albo potraktuj dawkę jako zmienną liczbową w regresji z członem kwadratowym. W pracy podaj, jakie wartości przypisałeś poziomom.
Jak policzyć wielkość efektu dla kontrastu?
Najprostszą miarą jest sama estymata kontrastu, jeśli wagi dobrano tak, aby suma wag dodatnich wynosiła 1: wtedy jest to różnica średnich w jednostkach skali z 95% CI. Wersję standaryzowaną (g) uzyskasz, dzieląc ją przez pierwiastek z MSE. Dla trendu podaj nachylenie w jednostkach czynnika (np. na 100 mg) albo udział trendu w sumie kwadratów międzygrupowej.
Jak sprawdzić, czy trend różni się między dwiema grupami?
Policz kontrast interakcyjny: pomnóż wagi trendu przez wagi grup (np. −1 i 1) i przetestuj go w modelu z interakcją; w emmeans służy do tego argument interaction funkcji contrast(). Nie wnioskuj o różnicy z tego, że trend jest istotny w jednej grupie, a w drugiej nie – różnica istotności sama nie jest istotna.
Powiązane hasła
Przeczytaj też
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikPoprawki na wielokrotne porównania
Bonferroni, Holm, Hochberg, BH i BY na jednym przykładzie: co kontroluje każda poprawka, kiedy którą wybrać i jak opisać wynik w pracy.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Masz hipotezy kierunkowe, a recenzent pyta o post hoc?
Pomożemy dobrać wagi kontrastów, policzyć trend i kontrasty interakcyjne w R oraz opisać je tak, by plan analizy, wyniki i odpowiedź recenzentom były spójne.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Abelson, R. P., & Prentice, D. A. (1997). Contrast tests of interaction hypotheses. Psychological Methods, 2(4), 315–328. https://doi.org/10.1037/1082-989x.2.4.315
- Bender, R., & Lange, S. (2001). Adjusting for multiple testing—When and how? Journal of Clinical Epidemiology, 54(4), 343–349. https://doi.org/10.1016/S0895-4356(00)00314-0
- Delacre, M., Leys, C., Mora, Y. L., & Lakens, D. (2019). Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA. International Review of Social Psychology, 32(1), Article 13. https://doi.org/10.5334/irsp.198 ● Otwarty dostęp
- Furr, R. M., & Rosenthal, R. (2003). Evaluating theories efficiently: The nuts and bolts of contrast analysis. Understanding Statistics, 2(1), 33–67. https://doi.org/10.1207/s15328031us0201_03
- Gelman, A., & Stern, H. (2006). The difference between “significant” and “not significant” is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006x152649
- Granziol, U., Rabe, M., Gallucci, M., Spoto, A., & Vidotto, G. (2025). Not another post hoc paper: A new look at contrast analysis and planned comparisons. Advances in Methods and Practices in Psychological Science, 8(1), Article 25152459241293110. https://doi.org/10.1177/25152459241293110 ● Otwarty dostęp
- Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196–217. https://doi.org/10.1207/s15327957pspr0203_4
- Midway, S., Robertson, M., Flinn, S., & Kaller, M. (2020). Comparing multiple comparisons: Practical guidance for choosing the best multiple comparisons test. PeerJ, 8, Article e10387. https://doi.org/10.7717/peerj.10387 ● Otwarty dostęp
- Rosnow, R. L., & Rosenthal, R. (1989). Definition and interpretation of interaction effects. Psychological Bulletin, 105(1), 143–146. https://doi.org/10.1037/0033-2909.105.1.143
- Rubin, M. (2021). When to adjust alpha during multiple testing: A consideration of disjunction, conjunction, and individual testing. Synthese, 199(3–4), 10969–11000. https://doi.org/10.1007/s11229-021-03276-4 ● Otwarty dostęp: pełny tekst
- Schad, D. J., Vasishth, S., Hohenstein, S., & Kliegl, R. (2020). How to capitalize on a priori contrasts in linear (mixed) models: A tutorial. Journal of Memory and Language, 110, Article 104038. https://doi.org/10.1016/j.jml.2019.104038 ● Otwarty dostęp
- Scheffé, H. (1953). A method for judging all contrasts in the analysis of variance. Biometrika, 40(1–2), 87–110. https://doi.org/10.1093/biomet/40.1-2.87
- Sommet, N., Weissman, D. L., Cheutin, N., & Elliot, A. J. (2023). How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction. Advances in Methods and Practices in Psychological Science, 6(3), Article 25152459231178728. https://doi.org/10.1177/25152459231178728 ● Otwarty dostęp
- Wiens, S., & Nilsson, M. E. (2017). Performing contrast analysis in factorial designs: From NHST to confidence intervals and beyond. Educational and Psychological Measurement, 77(4), 690–715. https://doi.org/10.1177/0013164416668950 ● Otwarty dostęp
Cytowania BibTeX
@article{abelson1997contrast, author={Abelson, Robert P. and Prentice, Deborah A.}, title={{Contrast tests of interaction hypotheses}}, journal={Psychological Methods}, year={1997}, volume={2}, number={4}, pages={315--328}, doi={10.1037/1082-989x.2.4.315}}@article{bender2001adjusting, author={Bender, Ralf and Lange, Stefan}, title={{Adjusting for multiple testing—When and how?}}, journal={Journal of Clinical Epidemiology}, year={2001}, volume={54}, number={4}, pages={343--349}, doi={10.1016/s0895-4356(00)00314-0}}@article{delacre2019taking, author={Delacre, Marie and Leys, Christophe and Mora, Youri L. and Lakens, Daniël}, title={{Taking parametric assumptions seriously: Arguments for the use of Welch's F-test instead of the classical F-test in one-way ANOVA}}, journal={International Review of Social Psychology}, year={2019}, volume={32}, number={1}, eid={13}, doi={10.5334/irsp.198}}@article{furr2003evaluating, author={Furr, R. Michael and Rosenthal, Robert}, title={{Evaluating theories efficiently: The nuts and bolts of contrast analysis}}, journal={Understanding Statistics}, year={2003}, volume={2}, number={1}, pages={33--67}, doi={10.1207/s15328031us0201_03}}@article{gelman2006difference, author={Gelman, Andrew and Stern, Hal}, title={{The difference between “significant” and “not significant” is not itself statistically significant}}, journal={The American Statistician}, year={2006}, volume={60}, number={4}, pages={328--331}, doi={10.1198/000313006x152649}}@article{granziol2025not, author={Granziol, Umberto and Rabe, Maximilian and Gallucci, Marcello and Spoto, Andrea and Vidotto, Giulio}, title={{Not another post hoc paper: A new look at contrast analysis and planned comparisons}}, journal={Advances in Methods and Practices in Psychological Science}, year={2025}, volume={8}, number={1}, eid={25152459241293110}, doi={10.1177/25152459241293110}}@article{kerr1998harking, author={Kerr, Norbert L.}, title={{HARKing: Hypothesizing after the results are known}}, journal={Personality and Social Psychology Review}, year={1998}, volume={2}, number={3}, pages={196--217}, doi={10.1207/s15327957pspr0203_4}}@article{midway2020comparing, author={Midway, Stephen and Robertson, Matthew and Flinn, Shane and Kaller, Michael}, title={{Comparing multiple comparisons: Practical guidance for choosing the best multiple comparisons test}}, journal={PeerJ}, year={2020}, volume={8}, eid={e10387}, doi={10.7717/peerj.10387}}@article{rosnow1989definition, author={Rosnow, Ralph L. and Rosenthal, Robert}, title={{Definition and interpretation of interaction effects}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={1}, pages={143--146}, doi={10.1037/0033-2909.105.1.143}}@article{rubin2021when, author={Rubin, Mark}, title={{When to adjust alpha during multiple testing: A consideration of disjunction, conjunction, and individual testing}}, journal={Synthese}, year={2021}, volume={199}, number={3–4}, pages={10969--11000}, doi={10.1007/s11229-021-03276-4}}@article{schad2020capitalize, author={Schad, Daniel J. and Vasishth, Shravan and Hohenstein, Sven and Kliegl, Reinhold}, title={{How to capitalize on a priori contrasts in linear (mixed) models: A tutorial}}, journal={Journal of Memory and Language}, year={2020}, volume={110}, eid={104038}, doi={10.1016/j.jml.2019.104038}}@article{scheffe1953method, author={Scheff{\'e}, Henry}, title={{A method for judging all contrasts in the analysis of variance}}, journal={Biometrika}, year={1953}, volume={40}, number={1–2}, pages={87--110}, doi={10.1093/biomet/40.1-2.87}}@article{sommet2023how, author={Sommet, Nicolas and Weissman, David L. and Cheutin, Nicolas and Elliot, Andrew J.}, title={{How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction}}, journal={Advances in Methods and Practices in Psychological Science}, year={2023}, volume={6}, number={3}, eid={25152459231178728}, doi={10.1177/25152459231178728}}@article{wiens2017performing, author={Wiens, Stefan and Nilsson, Mats E.}, title={{Performing contrast analysis in factorial designs: From NHST to confidence intervals and beyond}}, journal={Educational and Psychological Measurement}, year={2017}, volume={77}, number={4}, pages={690--715}, doi={10.1177/0013164416668950}}