Co to jest ANOVA z powtarzanymi pomiarami?
ANOVA z powtarzanymi pomiarami (ang. repeated measures ANOVA, RM ANOVA) to analiza wariancji, w której te same osoby są mierzone kilka razy – w kolejnych momentach albo w kilku warunkach eksperymentu. Porównuje średnie z co najmniej trzech pomiarów czynnika wewnątrzobiektowego (np. czasu) i jest rozszerzeniem testu t dla prób zależnych na więcej niż dwa pomiary. W polskich podręcznikach spotkasz też nazwę „analiza wariancji dla prób zależnych”.
Typowe zastosowania w psychologii to badania podłużne (np. nasilenie objawów przed terapią, po niej i w katamnezie) oraz eksperymenty, w których każda osoba przechodzi przez wszystkie warunki (np. czas reakcji w trzech wersjach zadania). Największa zaleta schematu: stałe różnice między osobami zostają usunięte z błędu, więc test ma większą moc i ten sam efekt można wykryć na mniejszej próbie niż w ANOVA dla grup niezależnych. Park, Cho i Ki (2009) pokazują, że poprawne użycie tej analizy wymaga sprawdzenia jej założeń i właściwego doboru porównań wielokrotnych jako analizy następczej.
Jak działa: podział zmienności
Zmienność wszystkich wyników dzieli się tu na trzy części: różnice między osobami, różnice między pomiarami (efekt czynnika) i błąd, czyli niespójność zmian u różnych osób (interakcja osoba × pomiar):
Dla k pomiarów i n osób efekt ma k − 1 stopni swobody, a błąd (k − 1)(n − 1). W przykładzie poniżej (n = 30, k = 3) suma kwadratów wynosi 5545.96, z czego 3027.96 przypada na stałe różnice między osobami, 1147.29 na różnice między pomiarami i tylko 1370.71 na błąd. Stąd F(2, 58) = 573.64 / 23.63 = 24.27. Gdyby te same liczby potraktować jak trzy niezależne grupy, różnice między osobami trafiłyby do błędu i wynik spadłby do F(2, 87) = 11.35. Na tym polega przewaga schematu z powtarzanymi pomiarami.
Założenie sferyczności i poprawki ε
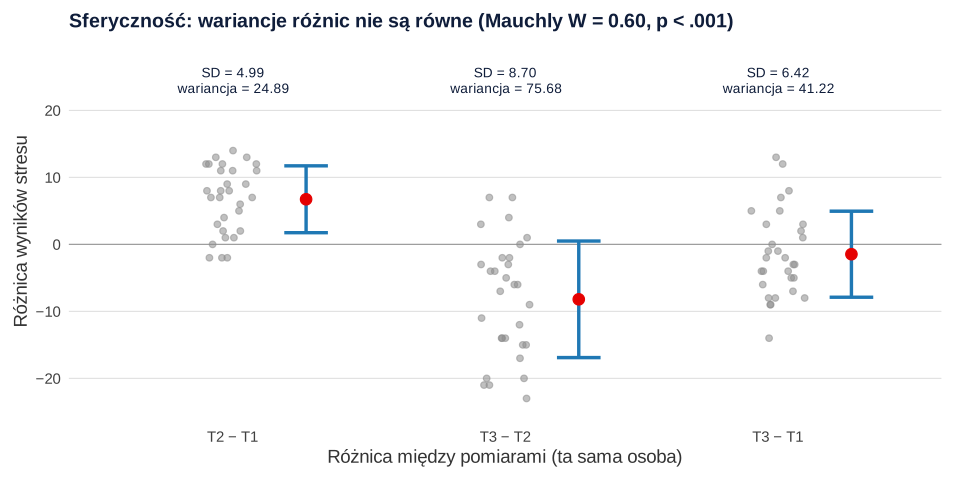
Kluczowym założeniem jest sferyczność: wariancje różnic między każdą parą pomiarów są równe. Jeśli zmiana T1→T2 jest u wszystkich podobna, a zmiana T2→T3 bardzo różna u różnych osób, założenie jest naruszone, a zwykły test F zbyt często daje wynik istotny. Przy dwóch pomiarach istnieje tylko jedna różnica, więc sferyczność jest spełniona automatycznie.
Sferyczność sprawdza się testem Mauchly’ego, ale ma on małą moc w małych próbach i bywa nadwrażliwy w dużych. Dlatego ważniejsza jest miara odstępstwa – epsilon (ε): 1 oznacza pełną sferyczność, a dolna granica wynosi 1/(k − 1). Poprawka polega na pomnożeniu obu liczb stopni swobody przez ε:
- Greenhouse–Geisser (GG) – oszacowanie ε zaproponowane w klasycznej pracy o danych profilowych; daje test konserwatywny (Greenhouse i Geisser, 1959);
- Huynh–Feldt (HF) – mniej obciążone oszacowanie ε, przydatne, gdy naruszenie jest niewielkie, bo wcześniejsze oszacowanie ε jest wtedy wyraźnie obciążone (Huynh i Feldt, 1976).
Praktyczna reguła: raportuj test z poprawką GG zawsze, gdy ε wyraźnie odbiega od 1; przy ε powyżej około .75 wielu autorów wybiera mniej konserwatywną poprawkę HF. Pozostałe założenia to normalność rozkładu reszt (różnic), brak skrajnych obserwacji odstających i komplet pomiarów u każdej osoby – osoba z jednym brakiem wypada z analizy w całości.
Przykład: stres przed sesją i po niej
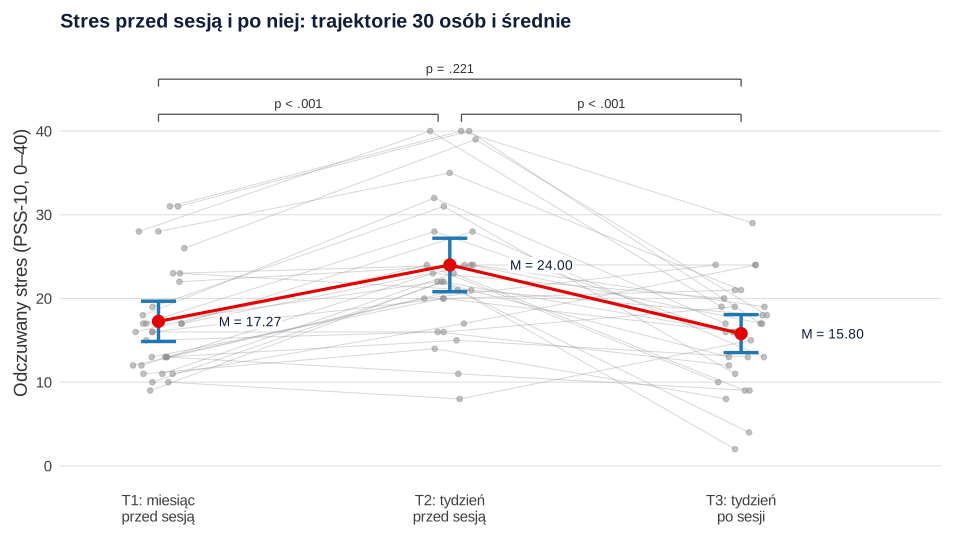
Trzydziestu studentów (dane symulowane) oceniło odczuwany stres skalą PSS-10 (0–40) trzy razy: miesiąc przed sesją egzaminacyjną (T1), tydzień przed sesją (T2) i tydzień po sesji (T3).
| Pomiar | M (SD) | 95% CI |
|---|---|---|
| T1: miesiąc przed sesją | 17.27 (6.45) | [14.86, 19.67] |
| T2: tydzień przed sesją | 24.00 (8.55) | [20.81, 27.19] |
| T3: tydzień po sesji | 15.80 (6.08) | [13.53, 18.07] |
Krok 1. Sferyczność. Wariancje różnic wyniosły 24.89 (T2 − T1), 75.68 (T3 − T2) i 41.22 (T3 − T1) – zmiana po sesji była u różnych osób znacznie bardziej zróżnicowana niż wzrost przed sesją (rysunek 2). Test Mauchly’ego potwierdził naruszenie, W = 0.60, p < .001; εGG = .71, εHF = .74.
Krok 2. Test główny. Bez poprawki wynik to F(2, 58) = 24.27. Po poprawce Greenhouse’a–Geissera stopnie swobody maleją do 2 × .7137 = 1.43 i 58 × .7137 = 41.39: F(1.43, 41.39) = 24.27, p < .001, η²G = .21. Poprawka HF prowadzi do tego samego wniosku, F(1.48, 42.93) = 24.27, p < .001. Wartość F się nie zmienia – zmienia się rozkład, z którym ją porównujemy, a więc p.
Krok 3. Porównania parami. Testy t dla prób zależnych z korektą Holma (zob. porównania wielokrotne i testy post hoc) wykazały wzrost stresu od T1 do T2 o 6.73 punktu, t(29) = 7.39, p < .001, 95% CI [4.87, 8.60], i spadek od T2 do T3 o 8.20 punktu, t(29) = 5.16, p < .001, 95% CI [4.95, 11.45]. Stres po sesji nie różnił się istotnie od poziomu sprzed miesiąca (różnica 1.47, t(29) = 1.25, p = .221). Każde porównanie korzysta tu z własnego błędu standardowego różnic, więc nie zależy od założenia sferyczności.
Wielkość efektu: η² uogólnione czy cząstkowe?
Cząstkowe η² w schemacie wewnątrzobiektowym bywa bardzo wysokie, bo z mianownika usuwa się różnice indywidualne – w przykładzie η²p = .46. Bakeman (2005) zaleca rutynowe raportowanie uogólnionego eta kwadrat (η²G), które – w odróżnieniu od η² i η²p – pozwala porównywać efekty między schematami wewnątrz- i międzyobiektowymi; wzory podali Olejnik i Algina (2003). Tu η²G = .21. Lakens (2013) pokazuje, jak liczyć i raportować wielkości efektu w obu typach schematów, tak by mogły posłużyć do analiz mocy i metaanaliz. Przy porównaniach dwóch pomiarów możesz dodać dz, czyli średnią różnicę podzieloną przez SD różnic: dla wzrostu T1→T2 wynosi 1.35. Więcej o miarach z rodziny η² znajdziesz w haśle eta kwadrat.
Alternatywy: test Friedmana, MANOVA i model mieszany
- Test Friedmana – nieparametryczny odpowiednik dla danych porządkowych lub silnie nienormalnych; w przykładzie χ²(2) = 23.45, p < .001.
- Podejście wielowymiarowe – MANOVA na różnicach między pomiarami nie wymaga sferyczności; tu ślad Pillaia V = .65, F(2, 28) = 26.39, p < .001. Przy małych próbach ma jednak mniejszą moc.
- Model wielopoziomowy (mieszany) – pomiary zagnieżdżone w osobach. Model z samym losowym wyrazem wolnym zakłada złożoną symetrię i daje tu ten sam test co ANOVA bez poprawki, F(2, 58) = 24.27. Jego przewaga ujawnia się przy brakach danych (nie usuwa osób z jednym brakiem), nierównych odstępach między pomiarami i gdy strukturę kowariancji modeluje się wprost.
Jeśli porównujesz zmiany w dwóch grupach (np. terapia i kontrola), potrzebujesz ANOVA w schemacie mieszanym z czynnikiem międzyobiektowym; przy dwóch pomiarach rozważ też ANCOVA z pre-testem jako kowariantem.
Jak opisać wynik w pracy (APA)
Podaj wynik testu Mauchly’ego, wartość ε i zastosowaną poprawkę, ułamkowe stopnie swobody, η²G oraz porównania parami z nazwą korekty. Przykładowy opis:
Ułamkowe stopnie swobody podawaj z dwoma miejscami po przecinku. Gotowe zdania dla innych analiz znajdziesz w poradniku jak opisać wyniki w stylu APA, a szerszy kontekst analizy wariancji – w poradniku ANOVA krok po kroku.
Przykład w R
Kod generuje dane z przykładu w formacie długim (jeden wiersz = jeden pomiar), wykonuje ANOVA z powtarzanymi pomiarami w pakiecie afex (test Mauchly’ego, poprawki GG i HF, η²G i η²p) i porównania parami w emmeans. Liczby w tekście i na rysunkach pochodzą z tego kodu.
ANOVA z powtarzanymi pomiarami w afex
R
library(MASS); library(afex); library(emmeans)
set.seed(37)
n <- 30
sd_t <- c(6, 8, 7)                                       # odchylenia standardowe w pomiarach
R <- matrix(c(1, .80, .35,  .80, 1, .45,  .35, .45, 1), 3)   # korelacje między pomiarami
x <- round(mvrnorm(n, mu = c(17, 23, 15.5), Sigma = diag(sd_t) %*% R %*% diag(sd_t)))
x <- pmin(pmax(x, 0), 40)                                # skala PSS-10: 0–40
dane <- data.frame(id = factor(rep(1:n, 3)),             # format długi: wiersz = pomiar
                   czas = factor(rep(c("T1", "T2", "T3"), each = n)),
                   stres = c(x))

fit <- aov_ez(id = "id", dv = "stres", data = dane, within = "czas")
summary(fit)                          # Mauchly, epsilon GG i HF, poprawione p
nice(fit, es = c("ges", "pes"))       # poprawka GG (domyślna), eta kwadrat uogólnione i cząstkowe

emm <- emmeans(fit, ~ czas)           # średnie z 95% CI
emm
pairs(emm, adjust = "holm")           # porównania parami z korektą Holma
Wynik w R
Univariate Type III Repeated-Measures ANOVA Assuming Sphericity

            Sum Sq num Df Error SS den Df F value    Pr(>F)
(Intercept)  32566      1   3028.0     29 311.899 < 2.2e-16 ***
czas          1147      2   1370.7     58  24.273 2.192e-08 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


Mauchly Tests for Sphericity

     Test statistic    p-value
czas        0.59875 0.00076109


Greenhouse-Geisser and Huynh-Feldt Corrections
 for Departure from Sphericity

      GG eps Pr(>F[GG])
czas 0.71365  1.381e-06 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

        HF eps   Pr(>F[HF])
czas 0.7402051 9.391976e-07
Anova Table (Type 3 tests)

Response: stres
  Effect          df   MSE         F  ges  pes p.value
1   czas 1.43, 41.39 33.12 24.27 *** .207 .456   <.001
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘+’ 0.1 ‘ ’ 1

Sphericity correction method: GG
 czas emmean   SE df lower.CL upper.CL
 T1     17.3 1.18 29     14.9     19.7
 T2     24.0 1.56 29     20.8     27.2
 T3     15.8 1.11 29     13.5     18.1

Confidence level used: 0.95
 contrast estimate    SE df t.ratio p.value
 T1 - T2     -6.73 0.911 29  -7.392 <0.0001
 T1 - T3      1.47 1.170 29   1.251  0.2209
 T2 - T3      8.20 1.590 29   5.163 <0.0001

P value adjustment: holm method for 3 tests
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (test Friedmana, podejście wielowymiarowe i model mieszany w lmerTest – w pełnym skrypcie strony); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- afex (wersja 1.5.1): Singmann, H., Bolker, B., Westfall, J., Aust, F., & Ben-Shachar, M. S. (2025). afex: Analysis of factorial experiments [R package]. https://doi.org/10.32614/CRAN.package.afex
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Pominięcie poprawki przy naruszonej sferyczności – nieskorygowany test F zbyt często daje wynik istotny; podawaj ε i poprawione stopnie swobody.
- Raportowanie F(2, 58) zamiast F(1.43, 41.39) – po poprawce stopnie swobody są ułamkowe i właśnie takie trzeba podać.
- Seria testów t bez korekty zamiast porównań z korektą na porównania wielokrotne.
- Usuwanie osób z brakami bez komentarza – klasyczna ANOVA wymaga kompletu pomiarów; przy wielu brakach lepszy jest model mieszany.
- Analiza danych w formacie szerokim jak grup niezależnych – ANOVA międzyobiektowa na tych samych liczbach ignoruje zależność pomiarów (w przykładzie F spadłby z 24.27 do 11.35, a wnioskowanie byłoby błędne).
- Raportowanie samego η²p bez zaznaczenia schematu – przy porównaniach z badaniami międzyobiektowymi podaj η²G (Bakeman, 2005).
Najczęstsze pytania
Kiedy stosować ANOVA z powtarzanymi pomiarami?
Gdy te same osoby mierzysz co najmniej trzy razy – w kolejnych momentach (np. przed terapią, po niej i w katamnezie) albo w kilku warunkach eksperymentu – i chcesz porównać średnie tych pomiarów. Przy dwóch pomiarach wystarczy test t dla prób zależnych.
Co to jest sferyczność?
Sferyczność oznacza, że wariancje różnic między każdą parą pomiarów są równe. Jej naruszenie sprawia, że zwykły test F zbyt często daje wynik istotny. Sprawdza się ją testem Mauchly’ego i miarą ε (1 = pełna sferyczność); przy dwóch pomiarach jest spełniona automatycznie.
Greenhouse–Geisser czy Huynh–Feldt?
Obie poprawki mnożą stopnie swobody przez oszacowanie ε. Greenhouse–Geisser jest bardziej konserwatywna i jest bezpiecznym wyborem domyślnym. Gdy ε przekracza około .75, wielu autorów stosuje mniej konserwatywną poprawkę Huynha–Feldta. Zawsze napisz, którą poprawkę zastosowano, i podaj ułamkowe stopnie swobody, np. F(1.43, 41.39).
Co zrobić, gdy test Mauchly’ego jest istotny?
Nie rezygnuj z analizy – zastosuj poprawkę Greenhouse’a–Geissera (lub Huynha–Feldta) i raportuj poprawione stopnie swobody oraz p. Alternatywnie użyj podejścia wielowymiarowego (MANOVA na różnicach), które nie wymaga sferyczności, albo modelu mieszanego z jawnie określoną strukturą kowariancji.
Jakie eta kwadrat podać w ANOVA z powtarzanymi pomiarami?
Zalecane jest uogólnione eta kwadrat (η²G), bo daje się porównywać z wynikami badań międzyobiektowych (Bakeman, 2005). Cząstkowe η²p jest w tym schemacie zwykle znacznie większe – w przykładzie na tej stronie .46 wobec .21 dla η²G.
Jak zrobić ANOVA z powtarzanymi pomiarami w SPSS?
Wybierz Analiza → Ogólny model liniowy → Powtarzane pomiary. Nazwij czynnik wewnątrzobiektowy (np. czas), podaj liczbę poziomów i przypisz kolumny z kolejnymi pomiarami. W wyniku znajdziesz test Mauchly’ego i tabelę z poprawkami Greenhouse’a–Geissera i Huynha–Feldta; porównania parami ustawisz w opcjach średnich brzegowych (EM Means).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
ANOVA krok po kroku
Jednoczynnikowa i dwuczynnikowa ANOVA na przykładach: założenia, test Welcha, post hoc, η² i ω², efekty proste, typy sum kwadratów i opis APA.
Czytaj →PoradnikJak opisać wyniki w stylu APA – gotowe zdania
18 gotowych zdań APA – od testu t po mediację i moderację – z liczbami z jednego badania i kodem R, który pozwala sprawdzić każdą wartość.
Czytaj →PoradnikStatystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707 ● Otwarty dostęp
- Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
- Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863 ● Otwarty dostęp
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Park, E., Cho, M., & Ki, C.-S. (2009). Correct use of repeated measures analysis of variance. The Korean Journal of Laboratory Medicine, 29(1), 1–9. https://doi.org/10.3343/kjlm.2009.29.1.1 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{bakeman2005recommended, author={Bakeman, Roger}, title={{Recommended effect size statistics for repeated measures designs}}, journal={Behavior Research Methods}, year={2005}, volume={37}, number={3}, pages={379--384}, doi={10.3758/bf03192707}}@article{greenhouse1959methods, author={Greenhouse, Samuel W. and Geisser, Seymour}, title={{On methods in the analysis of profile data}}, journal={Psychometrika}, year={1959}, volume={24}, number={2}, pages={95--112}, doi={10.1007/bf02289823}}@article{huynh1976estimation, author={Huynh, Huynh and Feldt, Leonard S.}, title={{Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs}}, journal={Journal of Educational Statistics}, year={1976}, volume={1}, number={1}, pages={69--82}, doi={10.3102/10769986001001069}}@article{lakens2013calculating, author={Lakens, Daniël}, title={{Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs}}, journal={Frontiers in Psychology}, year={2013}, volume={4}, eid={863}, doi={10.3389/fpsyg.2013.00863}}@article{olejnik2003generalized, author={Olejnik, Stephen and Algina, James}, title={{Generalized eta and omega squared statistics: Measures of effect size for some common research designs}}, journal={Psychological Methods}, year={2003}, volume={8}, number={4}, pages={434--447}, doi={10.1037/1082-989x.8.4.434}}@article{park2009correct, author={Park, Eunsik and Cho, Meehye and Ki, Chang-Seok}, title={{Correct use of repeated measures analysis of variance}}, journal={The Korean Journal of Laboratory Medicine}, year={2009}, volume={29}, number={1}, pages={1--9}, doi={10.3343/kjlm.2009.29.1.1}}