Co to jest test Quade'a?
Test Quade'a to nieparametryczny test dla układu bloków kompletnych: każdy blok (osoba albo dobrana grupa) przechodzi wszystkie k warunków. Jest alternatywą dla ANOVA z powtarzanymi pomiarami i dla testu Friedmana. Quade (1979) zauważył, że test Friedmana korzysta tylko z rang w obrębie bloków. Przy addytywnych efektach bloków informację między blokami można odzyskać, ważąc rangi według tego, jak wyraźnie blok porządkuje warunki. Dla dwóch warunków to różnica między testem znaków (rangi bez wag) a testem Wilcoxona (rangi ważone).
Jak działa
- W każdym bloku nadaj warunkom rangi Rij od 1 do k.
- Policz rozstęp wyników każdego bloku i nadaj blokom rangi rozstępu Qi (waga).
- Oblicz Sij = Qi[Rij − (k + 1)/2], A = ΣSij² i B = Σj(ΣiSij)²/b.
- Statystyka F = (b − 1)B/(A − B) ma w przybliżeniu rozkład F z k − 1 i (b − 1)(k − 1) stopniami swobody.
Quade czy Friedman?
Quade zyskuje, gdy bloki różnią się siłą efektu: osoby z dużym rozstępem niosą więcej informacji o kolejności warunków. Przy wielu warunkach test Friedmana bywa mocniejszy. Iman, Hora i Conover (1984) porównali oba testy z trzecim podejściem – testem F na rangach nadanych wszystkim obserwacjom – które w symulacjach było odporne i mocne przy małych próbach. Ten sam układ pojawia się w eksperymentach z randomizacją blokową.
Przykład
12 osób wykonało zadanie w czterech warunkach (dane symulowane), a u części osób warunki różniły się silniej. Test Quade'a: F(3, 33) = 3.19, p = .036; test Friedmana: χ²(3) = 6.30, p = .098. Po poprawce Holma różni się tylko para A–D (p = .048). W 1000 powtórzeń tego układu moc wyniosła 0.82 dla Quade'a i 0.61 dla Friedmana.
Na rysunku
Panel A pokazuje dane z przykładu: każdą osobę jako wiersz z jej czterema wynikami. Panel B to symulacja tego samego układu dla 6–24 osób, 1000 powtórzeń dla każdej liczby osób (ziarno 7262 ustalone raz). W scenariuszu „efekt różny” jedna trzecia osób ma siłę efektu 0, jedna trzecia 1 i jedna trzecia 2.5, jak w przykładzie. W scenariuszu „efekt jednakowy” każda osoba ma średnią z tych wartości (około 1.17), więc przeciętna różnica między warunkami jest ta sama. Wartości ustawiono ręcznie.
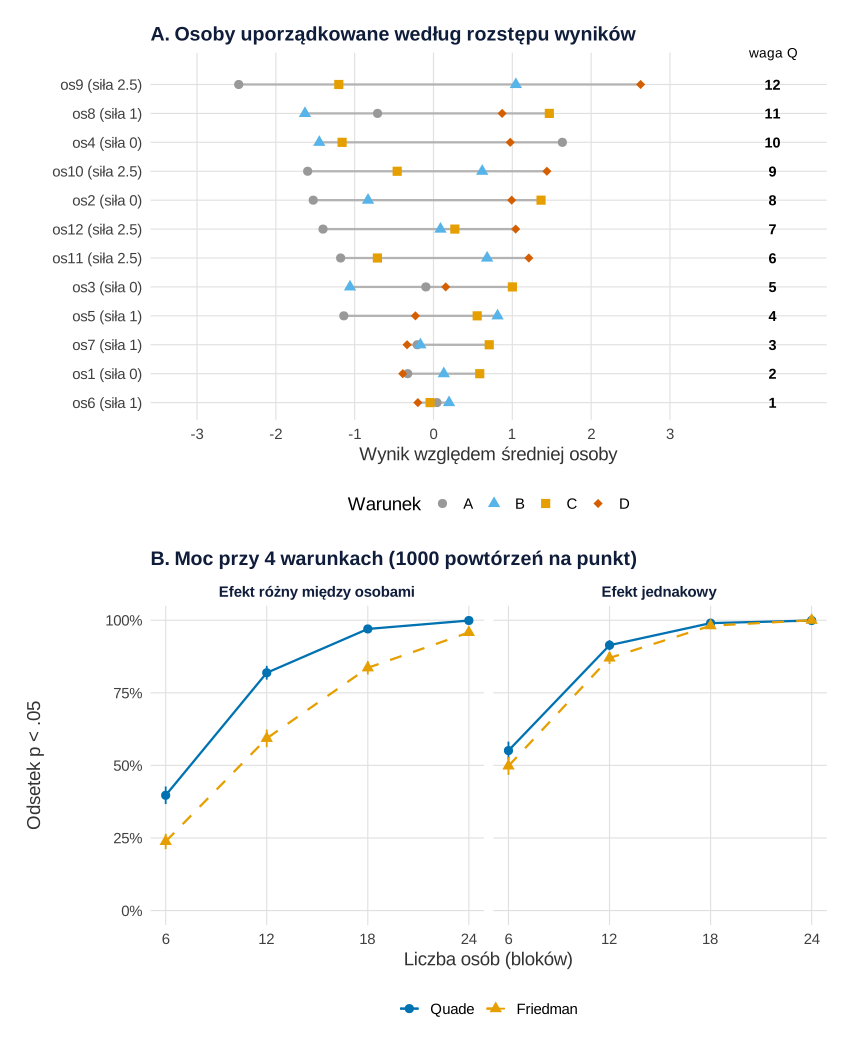
set.seed(7261) i set.seed(7262)).Co widać. Friedman liczy każdą osobę tak samo, Quade mnoży jej rangi przez wagę zależną od rozstępu. Osoba os6, której wyniki prawie się nie różnią, dostaje wagę 1, a os9 z najsilniejszym efektem – wagę 12. Gdy siła efektu różni się między osobami, to się opłaca: przy 12 osobach moc wynosi 81.9% dla Quade'a i 59.3% dla Friedmana, przy 6 osobach 39.7% i 23.8% (błąd Monte Carlo do 1.6 punktu procentowego). Gdy efekt jest u wszystkich jednakowy, przewaga prawie znika: 91.4% wobec 87.0% przy 12 osobach.
Na co uważać. Rozstęp mierzy efekt razem z szumem. Wagi 11 i 10 dostały w przykładzie osoby os8 i os4 o sile efektu 1 i 0 – ich wyniki rozrzucił sam przypadek. Przy małej liczbie osób i nierzetelnym pomiarze wagi bywają więc przypadkowe. Rysunek nie pokazuje też sytuacji, w której rozstępy są nieporównywalne, np. gdy osoby korzystają z różnych części skali; wtedy ważenie zniekształca wynik. Symulacja obejmuje tylko cztery warunki i rozkład normalny.
Podpis do pracy:
Kod rysunku odtwarza dane z przykładu i wykonuje symulację (16 tysięcy testów, kilkanaście sekund). Rysunek na stronie powstał z tego kodu po podmianie motywu na motyw serwisu (krój czcionki, siatka). Dane, geometrie i skale są identyczne.
Kod R rysunku 1
# Rysunek 1. Rozstęp bloków jako waga w teście Quade'a (A) i moc testu Quade'a vs Friedmana (B)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito i prosty motyw
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# A. Dane z przykładu w haśle (to samo ziarno i ten sam kod)
set.seed(7261)
b <- 12; k <- 4
skala <- rep(c(0, 1, 2.5), each = 4)                  # u części osób warunki działają silniej
efekt <- c(0, 0.5, 1, 1.5)                            # przesunięcie warunków B, C, D względem A
y <- t(sapply(1:b, function(i) 10 + rnorm(1, 0, 2) + skala[i] * efekt + rnorm(k)))
dimnames(y) <- list(paste0("os", 1:b), c("A", "B", "C", "D"))
rozstep <- apply(y, 1, function(w) diff(range(w)))
Q <- rank(rozstep)                                    # waga bloku w teście Quade'a
print(data.frame(skala, rozstep = round(rozstep, 2), Q))

yc <- y - rowMeans(y)                                  # wyniki względem średniej osoby
kolejn <- order(rozstep)                               # osoby od najmniejszego do największego rozstępu
dA <- data.frame(osoba = factor(rep(rownames(y), k), levels = rownames(y)[kolejn]),
                 warunek = rep(colnames(y), each = b), wynik = as.vector(yc))
dQ <- data.frame(osoba = factor(rownames(y), levels = rownames(y)[kolejn]), Q = Q,
                 lo = apply(yc, 1, min), hi = apply(yc, 1, max))
kol <- c(A = "#999999", B = "#56B4E9", C = "#E69F00", D = "#D55E00")
pA <- ggplot(dA, aes(wynik, osoba)) +
  geom_segment(data = dQ, aes(x = lo, xend = hi, yend = osoba), colour = "grey70", linewidth = 0.8) +
  geom_point(aes(colour = warunek, shape = warunek), size = 2.8) +
  geom_text(data = dQ, aes(x = 4.3, label = Q), size = 3.8, fontface = "bold") +
  annotate("text", x = 4.3, y = 13.1, label = "waga Q", size = 3.6) +
  scale_colour_manual(values = kol, name = "Warunek") + scale_shape_manual(values = c(16, 17, 15, 18), name = "Warunek") +
  scale_x_continuous(limits = c(-3.2, 4.6), breaks = -3:3) +
  scale_y_discrete(labels = setNames(paste0(rownames(y), " (siła ", skala, ")"), rownames(y))) +
  coord_cartesian(clip = "off") +
  labs(title = "A. Osoby uporządkowane według rozstępu wyników",
       x = "Wynik względem średniej osoby", y = NULL) +
  motyw

# B. Symulacja mocy: efekt jednakowy u wszystkich vs różny między osobami (ta sama średnia siła efektu)
moc <- function(b, scen, R = 1000) {
  sk <- if (scen == "różny") rep(c(0, 1, 2.5), each = b / 3) else rep(mean(c(0, 1, 2.5)), b)
  wyn <- replicate(R, {
    x <- t(sapply(1:b, function(i) 10 + rnorm(1, 0, 2) + sk[i] * efekt + rnorm(k)))
    c(Quade = quade.test(x)$p.value < .05, Friedman = friedman.test(x)$p.value < .05)
  })
  data.frame(osoby = b, scenariusz = scen, test = c("Quade", "Friedman"), moc = rowMeans(wyn))
}
set.seed(7262)                                          # ziarno ustalone raz
sym <- do.call(rbind, lapply(c("różny", "jednakowy"), function(s) do.call(rbind, lapply(c(6, 12, 18, 24), moc, scen = s))))
sym$bladMC <- sqrt(sym$moc * (1 - sym$moc) / 1000)
sym$scenariusz <- factor(sym$scenariusz, levels = c("różny", "jednakowy"),
                         labels = c("Efekt różny między osobami", "Efekt jednakowy"))
sym$test <- factor(sym$test, levels = c("Quade", "Friedman"))
print(transform(sym, moc = round(moc, 3), bladMC = round(bladMC, 3)), row.names = FALSE)

pB <- ggplot(sym, aes(osoby, moc, colour = test, shape = test, linetype = test)) +
  geom_errorbar(aes(ymin = moc - 1.96 * bladMC, ymax = moc + 1.96 * bladMC), width = 0, linetype = 1) +
  geom_line(linewidth = 0.8) + geom_point(size = 2.8) +
  facet_wrap(~ scenariusz) +
  scale_colour_manual(values = c(Quade = "#0072B2", Friedman = "#E69F00"), name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) + scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(6, 12, 18, 24)) +
  scale_y_continuous(limits = c(0, 1), labels = function(x) paste0(100 * x, "%")) +
  labs(title = "B. Moc przy 4 warunkach (1000 powtórzeń na punkt)", x = "Liczba osób (bloków)", y = "Odsetek p < .05") +
  motyw

p <- pA / pB + plot_layout(heights = c(1.15, 1))
p
Wynik w R
     skala rozstep  Q
os1    0.0    0.98  2
os2    0.0    2.89  8
os3    0.0    2.06  5
os4    0.0    3.08 10
os5    1.0    1.95  4
os6    1.0    0.40  1
os7    1.0    1.04  3
os8    1.0    3.10 11
os9    2.5    5.10 12
os10   2.5    3.03  9
os11   2.5    2.39  6
os12   2.5    2.44  7
 osoby                 scenariusz     test   moc bladMC
     6 Efekt różny między osobami    Quade 0.397  0.015
     6 Efekt różny między osobami Friedman 0.238  0.013
    12 Efekt różny między osobami    Quade 0.819  0.012
    12 Efekt różny między osobami Friedman 0.593  0.016
    18 Efekt różny między osobami    Quade 0.970  0.005
    18 Efekt różny między osobami Friedman 0.836  0.012
    24 Efekt różny między osobami    Quade 0.999  0.001
    24 Efekt różny między osobami Friedman 0.958  0.006
     6            Efekt jednakowy    Quade 0.551  0.016
     6            Efekt jednakowy Friedman 0.498  0.016
    12            Efekt jednakowy    Quade 0.914  0.009
    12            Efekt jednakowy Friedman 0.870  0.011
    18            Efekt jednakowy    Quade 0.990  0.003
    18            Efekt jednakowy Friedman 0.981  0.004
    24            Efekt jednakowy    Quade 0.999  0.001
    24            Efekt jednakowy Friedman 1.000  0.000
Jak opisać w pracy
Na co uważać
- Rozstępy muszą być porównywalne między blokami. Przy pojedynczej pozycji skali porządkowej bezpieczniejszy jest test Friedmana.
- Tylko bloki kompletne. Brak jednego pomiaru wyklucza blok.
- Wynik ogólny to nie porównania parami. Pary sprawdzaj osobnym testem z poprawką.
Inne testy rangowe zestawia hasło testy nieparametryczne.
Test Quade'a w R
Kod symuluje 12 bloków w czterech warunkach, wykonuje quade.test() i friedman.test(), odtwarza statystykę Quade'a ze wzoru, robi porównania parami z poprawką Holma i szacuje moc obu testów w 1000 powtórzeń. Liczby w tekście pochodzą z tego kodu.
Test Quade'a, porównania parami i moc
R
set.seed(7261)
library(PMCMRplus)
b <- 12; k <- 4                                       # 12 osób (bloki), 4 warunki (dane symulowane)
skala <- rep(c(0, 1, 2.5), each = 4)                  # u części osób warunki działają silniej
efekt <- c(0, 0.5, 1, 1.5)                            # przesunięcie warunków B, C, D względem A
y <- t(sapply(1:b, function(i) 10 + rnorm(1, 0, 2) + skala[i] * efekt + rnorm(k)))
dimnames(y) <- list(paste0("os", 1:b), c("A", "B", "C", "D"))
round(y[c(1, 5, 9), ], 2)
quade.test(y)                                          # wiersze = bloki, kolumny = warunki
friedman.test(y)
R <- t(apply(y, 1, rank))                              # rangi w obrębie osoby
Q <- rank(apply(y, 1, function(w) diff(range(w))))     # ranga rozstępu osoby (waga)
S <- Q * (R - (k + 1) / 2)
A <- sum(S^2); B <- sum(colSums(S)^2) / b
F <- (b - 1) * B / (A - B)
round(c(F = F, df1 = k - 1, df2 = (b - 1) * (k - 1), p = pf(F, k - 1, (b - 1) * (k - 1), lower.tail = FALSE)), 4)
quadeAllPairsTest(y, p.adjust.method = "holm")         # porównania parami
moc <- replicate(1000, {                               # moc obu testów w tym układzie
  x <- t(sapply(1:b, function(i) 10 + rnorm(1, 0, 2) + skala[i] * efekt + rnorm(k)))
  c(Quade = quade.test(x)$p.value < .05, Friedman = friedman.test(x)$p.value < .05)
})
rowMeans(moc)
Wynik w R
        A     B     C     D
os1 13.05 13.51 13.97 12.99
os5  9.63 11.58 11.32 10.54
os9 11.57 15.09 12.84 16.67

	Quade test

data:  y
Quade F = 3.1931, num df = 3, denom df = 33, p-value = 0.03618


	Friedman rank sum test

data:  y
Friedman chi-squared = 6.3, df = 3, p-value = 0.09789

      F     df1     df2       p
 3.1931  3.0000 33.0000  0.0362
  A     B     C
B 0.690 -     -
C 0.176 0.673 -
D 0.048 0.282 0.690
   Quade Friedman
   0.822    0.611
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje quade.test() i friedman.test() z pakietu stats oraz pakiet PMCMRplus). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()). Rysunek 1 wykonano w pakiecie ggplot2, panele złożono pakietem patchwork, a plik SVG zapisano pakietem svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- PMCMRplus (wersja 1.9.12): Pohlert, T. (2024). PMCMRplus: Calculate pairwise multiple comparisons of mean rank sums extended (R package version 1.9.12) [Computer software]. https://doi.org/10.32614/CRAN.package.PMCMRplus
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym test Quade'a różni się od testu Friedmana?
Oba nadają rangi warunkom w obrębie bloków. Test Friedmana traktuje wszystkie bloki jednakowo, a Quade'a waży je rangą rozstępu wyników, więc bloki z wyraźnym zróżnicowaniem warunków liczą się bardziej.
Kiedy wybrać test Quade'a zamiast testu Friedmana?
Gdy wyniki są liczbowe, rozstępy da się porównać między blokami, a warunków jest niewiele. Dla pojedynczej pozycji porządkowej lub wielu warunków zwykle lepszy jest test Friedmana.
Jak zrobić porównania parami po teście Quade'a?
W R użyj PMCMRplus::quadeAllPairsTest(y, p.adjust.method = "holm"), gdzie y to macierz z blokami w wierszach i warunkami w kolumnach. Raportuj p po poprawce.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Iman, R. L., Hora, S. C., & Conover, W. J. (1984). Comparison of asymptotically distribution-free procedures for the analysis of complete blocks. Journal of the American Statistical Association, 79(387), 674–685. https://doi.org/10.1080/01621459.1984.10478096
- Quade, D. (1979). Using weighted rankings in the analysis of complete blocks with additive block effects. Journal of the American Statistical Association, 74(367), 680–683. https://doi.org/10.1080/01621459.1979.10481670
Cytowania BibTeX
@article{friedman1937use, author={Friedman, Milton}, title={{The use of ranks to avoid the assumption of normality implicit in the analysis of variance}}, journal={Journal of the American Statistical Association}, year={1937}, volume={32}, number={200}, pages={675--701}, doi={10.1080/01621459.1937.10503522}}@article{iman1984comparison, author={Iman, Ronald L. and Hora, Stephen C. and Conover, W. J.}, title={{Comparison of asymptotically distribution-free procedures for the analysis of complete blocks}}, journal={Journal of the American Statistical Association}, year={1984}, volume={79}, number={387}, pages={674--685}, doi={10.1080/01621459.1984.10478096}}@article{quade1979using, author={Quade, Dana}, title={{Using weighted rankings in the analysis of complete blocks with additive block effects}}, journal={Journal of the American Statistical Association}, year={1979}, volume={74}, number={367}, pages={680--683}, doi={10.1080/01621459.1979.10481670}}