Kiedy doktorat potrzebuje badania podłużnego
Badanie podłużne to w doktoracie poważna decyzja. Wiąże harmonogram na kilka semestrów, wymaga utrzymania kontaktu z uczestnikami i zmienia sposób analizy danych. Warto ją podjąć, gdy pytanie dotyczy zmiany: jak zmienia się zmienna, czy ludzie różnią się tempem tej zmiany, co ją przewiduje i czy zmiany dwóch zmiennych są ze sobą powiązane w czasie.
Przewagę schematu podłużnego nad przekrojowym dobrze opisują Curran i Bauer (2011). Pomiary powtarzane dają większą moc, ustalają kolejność zdarzeń w czasie i przede wszystkim pozwalają oddzielić efekty wewnątrzosobowe od międzyosobowych. Badanie przekrojowe tego nie potrafi. Maxwell i Cole (2007) pokazali, że przekrojowe analizy mediacji procesów rozwijających się w czasie dają zwykle wyraźnie obciążone oszacowania, nawet w idealnych warunkach.
Collins (2006) ujmuje dobre badanie podłużne jako połączenie trzech elementów: teoretycznego modelu zmiany, planu czasowego, który pozwala ten proces zobaczyć, i modelu statystycznego, który jest operacjonalizacją teorii. W doktoracie najczęściej zawodzi środkowy element. Liczbę pomiarów i odstępy dobiera się do kalendarza grantu, a nie do tempa badanego procesu. Ten wpis prowadzi przez kolejne decyzje: pytanie o zmianę, liczbę i rozmieszczenie pomiarów, moc, odpadanie i wybór modelu. Na końcu znajdziesz pełny przykład w R.
Pytanie o zmianę wyznacza model i minimalną liczbę pomiarów
Zanim zaplanujesz pomiary, zapisz pytanie w kategoriach zmiany. Ployhart i Vandenberg (2010) proponują listy kontrolne zagadnień, które trzeba rozważyć przy teoretyzowaniu i planowaniu takich badań. Omawiają też kompromisy między ANOVA z powtarzanymi pomiarami, modelami ze współczynnikami losowymi i modelami krzywej latentnej. Tabela 1 łączy typowe pytania doktoratów z modelami.
| Pytanie | Model | Minimum pomiarów | Gdzie szczegóły |
|---|---|---|---|
| Czy grupa po interwencji różni się od kontrolnej (przed–po)? | ANCOVA z pomiarem wyjściowym | 2 | ANCOVA przed i po |
| Jak zmienia się średnia w kilku stałych punktach czasu? | ANOVA z powtarzanymi pomiarami albo model mieszany z czasem jako czynnikiem | 3 | ANOVA czy model mieszany |
| Jakie jest średnie tempo zmiany i czy ludzie różnią się tempem? | Model mieszany z losowym nachyleniem albo krzywa wzrostu (LGM) | 3 dla trajektorii liniowej, 4+ dla krzywoliniowej | krzywe wzrostu (LGM) |
| Czy wzrost X u danej osoby poprzedza wzrost Y u tej samej osoby? | RI-CLPM | 3 (więcej daje stabilniejsze oszacowania) | modele cross-lagged |
| Czy w tygodniach z gorszym snem stres jest wyższy niż zwykle u tej samej osoby? | Model wielopoziomowy z rozdzieleniem efektów wewnątrz- i międzyosobowych | kilka pomiarów na osobę, zwykle więcej niż 3 | model wielopoziomowy |
Dwa pomiary to wciąż badanie podłużne, ale bardzo ubogie. Nie da się na nich oddzielić prawdziwej zmiany od błędu pomiaru ani sprawdzić kształtu trajektorii. Trzy pomiary to minimum do linii prostej z różnicami indywidualnymi w nachyleniu. Jeśli teoria przewiduje przyspieszenie, spowolnienie albo powrót do poziomu wyjściowego, zaplanuj co najmniej cztery.
Jeśli pytasz o wpływy wzajemne dwóch zmiennych, nie poprzestawaj na klasycznym modelu krzyżowo-opóźnionym (CLPM). Gdy część stabilności konstruktów ma charakter stałej cechy, jego parametry nie opisują zależności wewnątrzosobowych i mogą prowadzić do błędnych wniosków o kierunku i znaku wpływów (Hamaker i in., 2015). Logikę, założenia i kod RI-CLPM omawiamy we wpisie CLPM i RI-CLPM. Tutaj zajmujemy się planem, który taki model w ogóle umożliwi.
Ile pomiarów? Rzetelność nachyleń zależy bardziej od czasu trwania
Gdy pytasz o różnice indywidualne w tempie zmiany, kluczowa jest rzetelność tempa wzrostu (growth rate reliability, GRR). To odsetek zmienności indywidualnych nachyleń, który odzwierciedla prawdziwe różnice między osobami, a nie błąd. Rast i Hofer (2014) pokazali w symulacjach opartych na rzeczywistych badaniach, że od GRR silnie i nieliniowo zależy liczebność potrzebna do wykrycia wariancji i kowariancji tempa zmian.
τ11 to wariancja nachyleń, σ2 – wariancja reszt, a SSTczas – suma kwadratów odchyleń momentów pomiaru od ich średniej. Ostatni składnik rośnie szybko, gdy wydłużasz badanie, i wolno, gdy dokładasz pomiary w tym samym okresie. Rysunek 1A pokazuje to dla skali stresu 1–5 przy odchyleniu standardowym nachyleń 0.03 punktu na miesiąc i odchyleniu standardowym reszt 0.35 punktu.
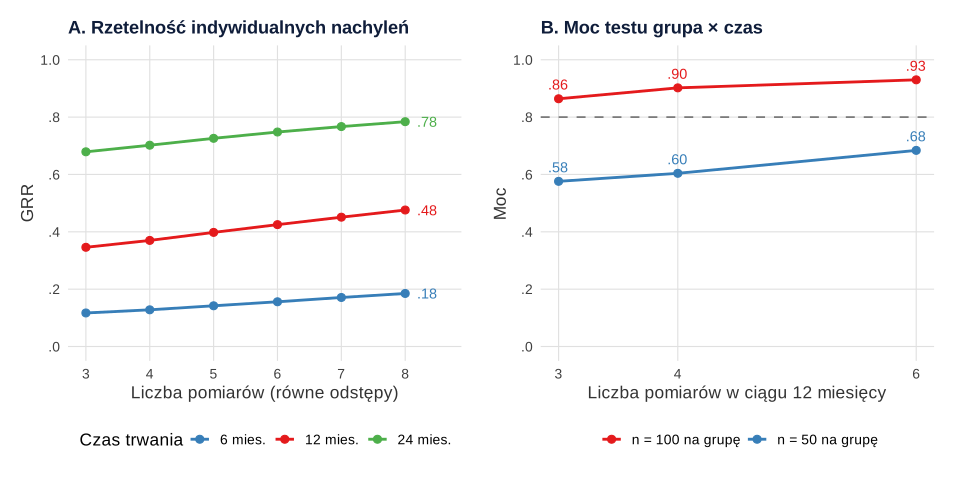
W ciągu 12 miesięcy GRR rośnie z .346 przy trzech pomiarach do .476 przy ośmiu. Wydłużenie obserwacji do 24 miesięcy przy tych samych trzech pomiarach daje .679, czyli więcej niż pięć dodatkowych pomiarów w ciągu roku. Przy sześciu miesiącach obserwacji nawet osiem pomiarów daje tylko .185. Jeśli doktorat pyta o różnice w tempie zmiany, najpierw walcz o czas trwania, a dopiero potem o liczbę pomiarów.
Ma znaczenie także rozmieszczenie pomiarów. Przy czterech pomiarach w ciągu roku GRR wynosi .370 przy równych odstępach (0, 4, 8, 12 miesięcy) i .405, gdy trzy pomiary skupisz na początku (0, 1, 2, 12). Spada do .352, gdy dwa środkowe przesuniesz do połowy roku (0, 5, 7, 12). Skupianie pomiarów na krańcach poprawia precyzję nachylenia liniowego, ale uniemożliwia sprawdzenie, czy zmiana jest liniowa. Timmons i Preacher (2015) pokazali, że przy trajektoriach nieliniowych najlepiej zagęścić pomiary tam, gdzie krzywizna jest największa. Dlatego rozmieszczenie wynika z teorii, a nie tylko z rachunku precyzji.
Odstępy między pomiarami: tempo procesu, kalendarz i powtarzanie testu
Odstęp jest częścią hipotezy, nawet jeśli nie pada w niej wprost. Współczynniki krzyżowo-opóźnione zależą od odstępu między pomiarami. Dormann i Griffin (2015) pokazali, że optymalny odstęp zależy od stabilności badanych zmiennych i bywa krótszy, niż zakłada wiele badań panelowych. Wynik „brak efektu krzyżowego po roku” nie oznacza więc braku efektu po miesiącu.
Przy planowaniu odstępów odpowiedz na cztery pytania:
- Jak szybko zachodzi proces? Adaptacja do studiów trwa tygodnie, zmiana postaw zawodowych – lata. Gdy nie wiesz, sięgnij po badania pilotażowe albo przegląd literatury o podobnych procesach.
- Jakie zdarzenia kalendarzowe wpływają na wynik? Sesja egzaminacyjna, wakacje i okres rozliczeń w pracy mogą wytworzyć „zmianę”, która jest tylko efektem terminu. Zapisz daty pomiarów w harmonogramie i uzasadnij każdy termin.
- Czy powtarzanie testu zmienia wynik? Przy testach wykonaniowych i pamięciowych pojawia się efekt uczenia się. Zbyt krótki odstęp go wzmacnia i udaje poprawę.
- Czy narzędzie mierzy to samo w każdym pomiarze? Wnioski o zmianie są mocniejsze, gdy inwariancja czynnikowa w czasie została sprawdzona i wyniki latentne leżą na tej samej metryce (Widaman i in., 2010). Procedurę opisujemy we wpisie inwariancja pomiaru krok po kroku.
Nie standaryzuj wyników osobno w każdym pomiarze. Standaryzacja z zeruje średnią w każdej fali, więc „znika” dokładnie ta zmiana, którą chcesz badać, a porównania grup stają się trudne (Moeller, 2015). Do porównań między falami używaj wyników surowych albo przekształceń, które zachowują metrykę skali, np. odsetka maksymalnego możliwego wyniku (POMP).
Moc: liczba osób zwykle waży więcej niż liczba pomiarów
Gdy hipoteza dotyczy różnicy średniego tempa zmiany między grupami (np. programem wsparcia a grupą kontrolną), moc zależy od liczebności, różnicy nachyleń, wariancji nachyleń i liczby pomiarów. Najprościej sprawdzić ją symulacją. Wygeneruj wiele badań o zakładanych parametrach, dopasuj do każdego model, który zamierzasz raportować, i policz odsetek istotnych wyników.
W symulacji z rysunku 1B prawdziwa różnica nachyleń wynosi −0.025 punktu na miesiąc, czyli −0.3 punktu w ciągu roku. Odchylenie standardowe poziomu wyjściowego to 0.50, a do końca roku zostaje średnio 75% osób. Przy 50 osobach w grupie moc rośnie z .576 (3 pomiary) przez .604 (4 pomiary) do .684 (6 pomiarów). Przy 100 osobach w grupie odpowiednie wartości to .864, .902 i .930. Podwojenie liczebności daje znacznie więcej niż podwojenie liczby pomiarów.
Dodatkowe pomiary mają jednak inne zalety. Pozwalają sprawdzić kształt trajektorii, poprawiają oszacowanie różnic indywidualnych i chronią przed utratą informacji, gdy ktoś opuści jeden termin. Symulację przygotuj dla własnych parametrów zaczerpniętych z pilotażu albo literatury i dołącz ją do planu analiz. Jak opisać ją we wniosku, pokazujemy we wpisie plan analiz do wniosku grantowego. Ogólne zasady analizy mocy a priori obowiązują i tutaj, ale prostego kalkulatora dla modelu mieszanego z odpadaniem nie znajdziesz – potrzebna jest symulacja.
Odpadanie: zaplanuj je, zanim się wydarzy
Utrata uczestników jest w badaniu podłużnym pewna. Niepewna jest tylko jej skala. Policz więc liczebność od końca. Jeśli w ostatnim, czwartym pomiarze potrzebujesz 150 osób, a między kolejnymi pomiarami spodziewasz się retencji 85%, zrekrutuj 245 osób (208 w drugim i 177 w trzecim pomiarze). Przy retencji 80% potrzebujesz 293 osób, przy 90% – 206. Formuły do własnych założeń znajdziesz w pliku planer badania podłużnego (xlsx), razem z arkuszem harmonogramu i dziennikiem odpadania.
Sama liczebność nie wystarczy. Liczy się mechanizm odpadania (zob. braki danych MCAR, MAR i MNAR). Jeśli z badania częściej odchodzą osoby z wysokim stresem, średnie obserwowane w ostatnich pomiarach będą zaniżone. Metody największej wiarygodności i imputacja wielokrotna dają poprawne wyniki przy założeniu MAR, czyli gdy odpadanie zależy od zmierzonych zmiennych. Graham (2009) podkreśla przy tym rolę zmiennych pomocniczych: zmniejszają obciążenie i zwiększają moc. Zaplanuj je od początku. Mogą to być np. deklarowana chęć udziału w kolejnych pomiarach, odległość od miejsca badania albo ocena obciążenia czasowego.
W protokole zaplanuj też działania, które zmniejszają odpadanie:
- kilka kanałów kontaktu (e-mail, telefon, osoba kontaktowa) zebranych za zgodą uczestnika;
- przypomnienia przed każdym pomiarem i krótkie podziękowanie po nim;
- kwestionariusze tak krótkie, jak pozwala pytanie badawcze;
- gratyfikacje rozłożone na kolejne pomiary, jeśli dopuszcza je komisja etyczna i budżet;
- dziennik odpadania z przyczyną (rezygnacja, brak kontaktu, wykluczenie), prowadzony na bieżąco.
Raportowanie utraty jest obowiązkiem, a nie dodatkiem. W badaniach z randomizacją większość publikacji nie podaje informacji wystarczających, by ocenić możliwy wpływ utraty na wyniki (Dumville i in., 2006). Podaj liczebność w każdym pomiarze, przyczyny odpadania i porównanie osób, które zostały, z tymi, które odpadły. Jak radzić sobie z brakami w analizie, opisujemy we wpisie braki danych i imputacja wielokrotna. Symulację porównującą ANOVA na kompletnych przypadkach z modelem mieszanym przy odpadaniu typu MAR znajdziesz we wpisie ANOVA z powtarzanymi pomiarami czy model mieszany.
Który model wybrać: mapa zamiast jednego przepisu
Model wynika z pytania z tabeli 1, ale kilka zasad dotyczy wszystkich badań podłużnych w doktoracie.
- Model mieszany zamiast ANOVA z powtarzanymi pomiarami, gdy masz braki, nierówne odstępy albo czas jako zmienną ciągłą. Modele mieszane wykorzystują wszystkie dostępne dane, uwzględniają korelację pomiarów tej samej osoby i elastyczniej modelują czas (Gueorguieva i Krystal, 2004). Szczegóły: efekty stałe i losowe, model wielopoziomowy.
- Model mieszany i krzywa wzrostu to często ten sam model. W szerokim zakresie warunków podłużne modele wzrostu w ujęciu wielopoziomowym i SEM są analitycznie identyczne (Curran, 2003). Wybór zależy od rozszerzeń, których potrzebujesz. SEM ułatwia zmienne latentne, inwariancję i ocenę dopasowania, model mieszany – nierówne terminy u różnych osób i wiele poziomów zagnieżdżenia. Hasło: krzywa wzrostu (LGM).
- Zmienne zmieniające się w czasie rozdzielaj na część wewnątrz- i międzyosobową przez centrowanie względem średniej osoby (Curran i Bauer, 2011). Bez tego współczynnik miesza dwa różne pytania.
- Wynik nieciągły (zliczenia, odpowiedź tak/nie) wymaga uogólnionego modelu mieszanego, a nie modelu liniowego na odsetkach.
Przykład: stres akademicki na pierwszym roku studiów
Doktorantka bada, jak zmienia się stres akademicki osób na pierwszym roku studiów. Pomiary przypadają w październiku (miesiąc 0), listopadzie (1), styczniu w trakcie sesji (3) i czerwcu (8). Wynik to średnia z ośmiu pozycji 1–5. Zrekrutowano 240 osób. Odpadanie zależy od stresu w poprzednim pomiarze, czyli odpowiada mechanizmowi MAR (dane symulowane). Kod znajdziesz w sekcji przykład w R.
Krok 1. Liczebność i odpadanie
W kolejnych pomiarach uczestniczyło 240, 222, 200 i 181 osób. Do czerwca zostało 75.4% próby, a retencja między pomiarami wynosiła od 90.1% do 92.5%. Osoby, które nie dotrwały do końca (n = 59), miały na starcie wyższy stres (M = 3.23) niż osoby, które zostały (M = 2.91), t(98.82) = 3.42, p < .001. To ważna informacja. Średnie obserwowane z późniejszych pomiarów pochodzą od coraz mniej zestresowanej części próby.
Krok 2. Model wzrostu: koduj czas w prawdziwych odstępach
Najczęstszy błąd w takim planie to kodowanie czasu numerem pomiaru (0, 1, 2, 3), choć odstępy wynoszą 1, 2 i 5 miesięcy. Porównaliśmy oba kodowania w modelu mieszanym z losowym wyrazem wolnym i losowym nachyleniem (estymacja ML). Model z czasem w miesiącach pasuje wyraźnie lepiej (AIC = 1163.3 wobec 1186.5). Kodowanie falami zawyża średnią w listopadzie i styczniu (3.07 i 3.20 wobec obserwowanych 2.99 i 3.12), bo zakłada, że między październikiem a listopadem upływa tyle samo czasu, co między styczniem a czerwcem.
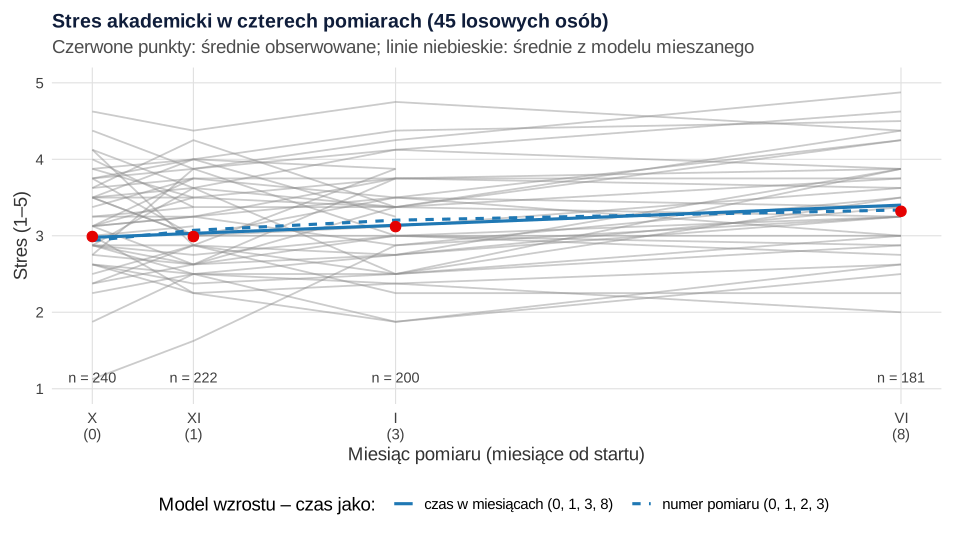
Stres rośnie średnio o 0.053 punktu na miesiąc, 95% CI [0.043, 0.062], czyli o 0.42 punktu między październikiem a czerwcem. Odchylenie standardowe indywidualnych nachyleń wynosi 0.034 punktu na miesiąc, więc część osób ma trajektorie płaskie albo malejące. W czerwcu model przewiduje średnią 3.40, a średnia obserwowana wynosi 3.32. Różnica wynika z odpadania osób bardziej zestresowanych. Model wykorzystuje ich wcześniejsze pomiary, a średnia z kompletnych odpowiedzi – nie.
Tabela 2
Liniowy model wzrostu stresu akademickiego na pierwszym roku studiów (czas w miesiącach)
| Parametr | b | SE | 95% CI | t | df | p |
|---|---|---|---|---|---|---|
| Efekty stałe | ||||||
| Wyraz wolny (październik) | 2.98 | 0.04 | [2.90, 3.05] | 78.41 | 239.81 | < .001 |
| Czas (miesiące) | 0.053 | 0.005 | [0.043, 0.062] | 11.26 | 192.64 | < .001 |
| Efekty losowe | ||||||
| Wariancja wyrazu wolnego | 0.287 | |||||
| Wariancja nachylenia | 0.0011 | |||||
| Korelacja wyrazu wolnego i nachylenia | −.03 | |||||
| Wariancja reszt | 0.112 | |||||
Uwaga. N = 240 osób, 843 pomiary (240, 222, 200 i 181 w kolejnych terminach). Estymacja ML; stopnie swobody metodą Satterthwaite’a; 95% CI z profilowej funkcji wiarygodności. Model z czasem kodowanym numerem pomiaru: AIC = 1186.5 wobec 1163.3. Dane symulowane.
Krok 3. Ten sam model jako krzywa wzrostu w SEM
Ten sam model można zapisać jako krzywą wzrostu w lavaan. Ładunki czynnika poziomu ustawiamy na 1, ładunki czynnika tempa na 0, 1, 3 i 8, a wariancje reszt ograniczamy do równości. Braki obsługuje FIML. Wyniki pokrywają się z modelem mieszanym: średni poziom 2.979, średnie tempo 0.053, wariancja reszt 0.112 i identyczna wartość logarytmu wiarygodności (−575.64). To ilustracja równoważności opisanej przez Currana (2003). Dopasowanie modelu jest dobre: χ²(8) = 7.26, p = .509, CFI = 1.000, RMSEA = .000, SRMR = .028. W wersji SEM łatwo dodać zmienne latentne w każdym pomiarze, uwolnić wariancje reszt albo sprawdzić kształt trajektorii z wolnymi ładunkami. Te rozszerzenia omawiamy we wpisie krzywe wzrostu (LGM) i modele zmiany.
Co opisać w rozprawie i artykule
Recenzent badania podłużnego chce zobaczyć plan czasowy tak wyraźnie jak model. W rozdziale metodologicznym albo w sekcji metod podaj:
- harmonogram z datami lub miesiącami od startu i uzasadnieniem każdego odstępu;
- liczebność w każdym pomiarze, przyczyny odpadania i porównanie osób, które zostały, z tymi, które odpadły;
- sposób kodowania czasu i punkt zerowy (co oznacza wyraz wolny);
- założenie o mechanizmie braków, metodę ich obsługi i zmienne pomocnicze;
- wyniki sprawdzenia inwariancji pomiaru w czasie, jeśli porównujesz średnie skal;
- symulację mocy z parametrami i ich źródłem;
- model z pełną specyfikacją efektów losowych oraz analizę wrażliwości, np. z innym kształtem trajektorii albo z założeniem MNAR.
Opis planu warto napisać jeszcze przed pierwszym pomiarem, np. do prerejestracji albo do projektu rozprawy. Wtedy każda późniejsza zmiana harmonogramu jest widoczna jako odstępstwo, a nie ginie w tekście. Poniższy wzór dotyczy przykładu z tego wpisu. Zastąp liczby własnymi i dopisz źródło parametrów symulacji.
Jeśli badanie podłużne jest częścią doktoratu z cyklu artykułów, ustal z góry, które pytania trafią do którego artykułu. Pilnuj też spójności kodowania i wykluczeń między nimi (zob. doktorat z cyklu artykułów). Gdy na tym samym zbiorze będą później pracować inni, przyda się dobra dokumentacja i znajomość zasad analizy wtórnej. Opisujemy je we wpisie reanaliza i wtórna analiza cudzych danych. Szerszy kontekst planowania badań w rozprawie znajdziesz we wpisie analiza statystyczna w doktoracie.
Jeśli chcesz, żeby ktoś niezależnie sprawdził plan pomiarów, przygotował symulację mocy dla Twoich parametrów albo dopasował modele do zebranych danych, zajrzyj do naszej oferty analiz statystycznych dla badaczy. Za wybór modelu, interpretację wyników i ich obronę odpowiadasz Ty jako autor(ka) – naszym zadaniem jest przygotować Cię do tego.
Przykład w R: plan, moc i model wzrostu
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Przepisy są niezależne, a każdy ustawia własne ziarno losowania. Symulacja mocy (przepis 2) dopasowuje 3000 modeli i trwa około dwóch minut. Modele mieszane liczy pakiet lme4, stopnie swobody Satterthwaite’a – pakiet lmerTest, a krzywą wzrostu – lavaan. Przepis 4 tworzy plik do pobrania.
1. Liczebność przy odpadaniu i rzetelność nachyleń (GRR)
R
# B82 – plan badania podłużnego: retencja, rzetelność nachyleń i moc (dane symulowane)
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript uruchom.R

# 1. Ile osób zrekrutować, żeby w ostatnim pomiarze zostało co najmniej 150?
#    Retencja = odsetek osób z pomiaru k, które biorą udział w pomiarze k + 1.
n_koniec <- 150
retencja <- c(.80, .85, .90)
fale <- 4
n_start <- ceiling(n_koniec / retencja^(fale - 1))
plan_n <- sapply(seq_along(retencja), function(i) round(n_start[i] * retencja[i]^(0:(fale - 1))))
dimnames(plan_n) <- list(paste0("T", 1:fale), paste0("retencja_", retencja))
plan_n
n_start

# 2. Rzetelność indywidualnych nachyleń (growth rate reliability, GRR)
#    GRR = tau11 / (tau11 + sigma2 / SST), SST = suma kwadratów odchyleń czasu pomiaru od jego średniej.
#    Skala stresu 1–5: SD nachyleń = 0.03 pkt na miesiąc, SD reszt = 0.35 pkt.
tau11 <- 0.03^2; sigma2 <- 0.35^2
grr <- function(czasy) { sst <- sum((czasy - mean(czasy))^2); tau11 / (tau11 + sigma2 / sst) }
siatka <- expand.grid(liczba_fal = 3:8, czas_trwania = c(6, 12, 24))
siatka$GRR <- mapply(function(k, d) grr(seq(0, d, length.out = k)), siatka$liczba_fal, siatka$czas_trwania)
siatka$GRR <- round(siatka$GRR, 3)
reshape(siatka, idvar = "liczba_fal", timevar = "czas_trwania", direction = "wide")

# Ten sam rok i cztery pomiary, ale inny rozkład w czasie
round(c(rowno_0_4_8_12 = grr(c(0, 4, 8, 12)), skupione_0_1_2_12 = grr(c(0, 1, 2, 12)),
        srodek_0_5_7_12 = grr(c(0, 5, 7, 12)), trzy_0_6_12 = grr(c(0, 6, 12))), 3)
Wynik w R
   retencja_0.8 retencja_0.85 retencja_0.9
T1          293           245          206
T2          234           208          185
T3          188           177          167
T4          150           150          150
[1] 293 245 206
  liczba_fal GRR.6 GRR.12 GRR.24
1          3 0.117  0.346  0.679
2          4 0.128  0.370  0.702
3          5 0.142  0.398  0.726
4          6 0.156  0.425  0.748
5          7 0.171  0.451  0.767
6          8 0.185  0.476  0.784
   rowno_0_4_8_12 skupione_0_1_2_12   srodek_0_5_7_12       trzy_0_6_12
            0.370             0.405             0.352             0.346
2. Symulacja mocy: grupa × czas przy 3, 4 i 6 pomiarach
R
# B82 – moc testu różnicy nachyleń (grupa × czas) w modelu mieszanym: 3, 4 albo 6 pomiarów w ciągu roku
# Dane symulowane, set.seed(8202); 500 powtórzeń w każdym wariancie; prawdziwa różnica nachyleń −0.025 pkt/mies.
suppressPackageStartupMessages(library(lmerTest))
sym_badanie <- function(n_grupa, czasy, roznica = -0.025, retencja_koniec = .75) {
  n <- 2 * n_grupa
  grupa <- rep(0:1, each = n_grupa)                       # 0 = kontrolna, 1 = program wsparcia
  u0 <- rnorm(n, 0, 0.50); u1 <- rnorm(n, 0, 0.03)        # różnice indywidualne: poziom i tempo zmiany
  d <- expand.grid(id = 1:n, fala = seq_along(czasy))
  d$mies <- czasy[d$fala]; d$grupa <- grupa[d$id]
  d$stres <- 3.0 + u0[d$id] + (0.020 + roznica * d$grupa + u1[d$id]) * d$mies + rnorm(nrow(d), 0, 0.35)
  # odpadanie monotoniczne (MCAR): do końca roku zostaje średnio 75% osób niezależnie od liczby pomiarów
  retencja <- retencja_koniec^(1 / (length(czasy) - 1))
  ostatnia <- sapply(1:n, function(i) { k <- 1; while (k < length(czasy) && runif(1) < retencja) k <- k + 1; k })
  d[d$fala <= ostatnia[d$id], ]
}
jedno <- function(n_grupa, czasy) {
  d <- sym_badanie(n_grupa, czasy)
  m <- suppressMessages(suppressWarnings(lmer(stres ~ mies * grupa + (mies | id), data = d,
                                              control = lmerControl(calc.derivs = FALSE))))
  c(p = summary(m)$coefficients["mies:grupa", "Pr(>|t|)"], osobliwy = isSingular(m), n_obs = nrow(d))
}
warianty <- expand.grid(n_grupa = c(50, 100), fale = c(3, 4, 6))
set.seed(8202)
R <- 500
wyniki <- t(sapply(seq_len(nrow(warianty)), function(i) {
  czasy <- seq(0, 12, length.out = warianty$fale[i])
  w <- replicate(R, jedno(warianty$n_grupa[i], czasy))
  c(moc = mean(w["p", ] < .05), osobliwe = mean(w["osobliwy", ]), srednio_obserwacji = mean(w["n_obs", ]))
}))
moc_tab <- cbind(warianty, round(wyniki, 3))
moc_tab
Wynik w R
  n_grupa fale   moc osobliwe srednio_obserwacji
1      50    3 0.576    0.030            261.148
2     100    3 0.864    0.010            522.660
3      50    4 0.604    0.030            349.146
4     100    4 0.902    0.000            697.518
5      50    6 0.684    0.006            522.234
6     100    6 0.930    0.002           1042.974
3. Model wzrostu: czas w miesiącach, numer pomiaru i LGM
R
# B82 – przykład z doktoratu: stres akademicki na pierwszym roku, 4 pomiary w nierównych odstępach
# październik (miesiąc 0), listopad (1), styczeń (3, sesja), czerwiec (8); skala 1–5 (średnia z 8 pozycji).
# 240 osób, odpadanie zależne od wcześniej zmierzonego stresu (MAR). Dane symulowane, set.seed(8203).
suppressPackageStartupMessages({ library(lmerTest); library(lavaan) })
set.seed(8203)
n <- 240; czasy <- c(0, 1, 3, 8)
u0 <- rnorm(n, 0, 0.55); u1 <- rnorm(n, 0, 0.040)
szer <- sapply(czasy, function(t) 2.90 + u0 + (0.060 + u1) * t + rnorm(n, 0, 0.33))
szer[] <- pmin(5, pmax(1, round(szer * 8) / 8))          # średnia z 8 pozycji 1–5
colnames(szer) <- paste0("T", 1:4)
# odpadanie: im wyższy stres w poprzednim pomiarze, tym większa szansa rezygnacji
for (k in 2:4) {
  p_odpad <- plogis(-2.3 + 0.90 * (szer[, k - 1] - 3))
  odpada <- !is.na(szer[, k - 1]) & runif(n) < p_odpad
  szer[odpada | is.na(szer[, k - 1]), k:4] <- NA
}
szer <- data.frame(id = 1:n, szer)
dl <- reshape(szer, direction = "long", varying = paste0("T", 1:4), v.names = "stres",
              timevar = "fala", times = 1:4, idvar = "id")
dl <- dl[!is.na(dl$stres), ]
dl$mies <- czasy[dl$fala]; dl$fala0 <- dl$fala - 1
c(osoby = length(unique(dl$id)), pomiary = nrow(dl))

# 1. Liczebność i średnie w kolejnych pomiarach
opis <- aggregate(stres ~ fala, dl, function(x) c(n = length(x), M = mean(x), SD = sd(x)))
opis <- data.frame(fala = opis$fala, round(opis$stres, 2)); opis
round(c(proc_od_startu = 100 * opis$n / n, retencja_miedzy_pomiarami = 100 * opis$n[-1] / opis$n[-4]), 1)
# 2. Czy osoby, które zostały do końca, różniły się na starcie?
szer$do_konca <- !is.na(szer$T4)
table(szer$do_konca)
t.test(T1 ~ do_konca, data = szer)
round(tapply(szer$T1, szer$do_konca, mean), 2)

# 3. Model wzrostu: czas w miesiącach (prawdziwe odstępy) a czas jako numer fali (0, 1, 2, 3)
m_mies <- lmer(stres ~ mies + (mies | id), data = dl, REML = FALSE)
m_fala <- lmer(stres ~ fala0 + (fala0 | id), data = dl, REML = FALSE)
summary(m_mies)$coefficients
summary(m_fala)$coefficients
round(c(AIC_miesiace = AIC(m_mies), AIC_fale = AIC(m_fala)), 1)
# średnie przewidywane w kolejnych pomiarach w obu kodowaniach a średnie obserwowane
b1 <- fixef(m_mies); b2 <- fixef(m_fala)
round(rbind(obserwowane = opis$M, miesiace = b1[1] + b1[2] * czasy, fale = b2[1] + b2[2] * 0:3), 2)
round(c(zmiana_8_mies = unname(8 * b1[2]), zmiana_3_fale = unname(3 * b2[2])), 2)
confint(m_mies, parm = "beta_", method = "profile")
VarCorr(m_mies)

# 4. Ten sam model jako krzywa wzrostu (LGM) w lavaan: ładunki nachylenia = miesiące, FIML
lgm <- '
  poziom =~ 1*T1 + 1*T2 + 1*T3 + 1*T4
  tempo  =~ 0*T1 + 1*T2 + 3*T3 + 8*T4
  T1 ~~ e*T1; T2 ~~ e*T2; T3 ~~ e*T3; T4 ~~ e*T4     # równe wariancje reszt jak w modelu mieszanym
'
f_lgm <- growth(lgm, data = szer, missing = "fiml")
pe <- parameterEstimates(f_lgm)
pe <- pe[(pe$lhs %in% c("poziom", "tempo") & pe$op %in% c("~1", "~~")) | (pe$lhs == "T1" & pe$op == "~~"),
         c("lhs", "op", "rhs", "est", "se", "ci.lower", "ci.upper")]
pe <- as.data.frame(pe); pe[, 4:7] <- round(pe[, 4:7], 4); pe
round(fitMeasures(f_lgm, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
round(c(logLik_lmer = as.numeric(logLik(m_mies)), logLik_lavaan = as.numeric(logLik(f_lgm))), 2)
Wynik w R
  osoby pomiary
    240     843
  fala   n    M   SD
1    1 240 2.99 0.64
2    2 222 2.99 0.63
3    3 200 3.12 0.63
4    4 181 3.32 0.68
           proc_od_startu1            proc_od_startu2            proc_od_startu3
                     100.0                       92.5                       83.3
           proc_od_startu4 retencja_miedzy_pomiarami1 retencja_miedzy_pomiarami2
                      75.4                       92.5                       90.1
retencja_miedzy_pomiarami3
                      90.5

FALSE  TRUE
   59   181

	Welch Two Sample t-test

data:  T1 by do_konca
t = 3.4217, df = 98.818, p-value = 0.0009063
alternative hypothesis: true difference in means between group FALSE and group TRUE is not equal to 0
95 percent confidence interval:
 0.1353118 0.5088731
sample estimates:
mean in group FALSE  mean in group TRUE
           3.230932            2.908840

FALSE  TRUE
 3.23  2.91
              Estimate  Std. Error       df  t value      Pr(>|t|)
(Intercept) 2.97898530 0.037994665 239.8076 78.40536 6.355825e-173
mies        0.05273359 0.004681657 192.6415 11.26387  6.171630e-23
             Estimate Std. Error       df  t value      Pr(>|t|)
(Intercept) 2.9373534 0.03961571 239.6298 74.14618 2.994273e-167
fala0       0.1332871 0.01212838 207.5764 10.98968  1.932994e-22
AIC_miesiace     AIC_fale
      1163.3       1186.5
            [,1] [,2] [,3] [,4]
obserwowane 2.99 2.99 3.12 3.32
miesiace    2.98 3.03 3.14 3.40
fale        2.94 3.07 3.20 3.34
zmiana_8_mies zmiana_3_fale
         0.42          0.40
Computing profile confidence intervals ...
                 2.5 %     97.5 %
(Intercept) 2.90426429 3.05381840
mies        0.04341269 0.06201239
 Groups   Name        Std.Dev. Corr
 id       (Intercept) 0.535571
          mies        0.033633 -0.032
 Residual             0.334725
      lhs op    rhs     est     se ci.lower ci.upper
9      T1 ~~     T1  0.1120 0.0077   0.0969   0.1272
13 poziom ~~ poziom  0.2869 0.0319   0.2244   0.3493
14  tempo ~~  tempo  0.0011 0.0005   0.0002   0.0021
15 poziom ~~  tempo -0.0006 0.0029  -0.0064   0.0052
20 poziom ~1         2.9790 0.0380   2.9045   3.0535
21  tempo ~1         0.0527 0.0047   0.0435   0.0620
 chisq     df pvalue    cfi  rmsea   srmr
 7.260  8.000  0.509  1.000  0.000  0.028
  logLik_lmer logLik_lavaan
      -575.64       -575.64
4. Plik do pobrania: planer badania podłużnego
R
# B82 – plik do pobrania: planer badania podłużnego (xlsx z formułami)
suppressPackageStartupMessages(library(openxlsx))
wb <- createWorkbook(creator = "Metodolog.pl", title = "Planer badania podłużnego")
addWorksheet(wb, "retencja")
writeData(wb, "retencja", data.frame(Parametr = c("Liczba osób potrzebna w ostatnim pomiarze", "Przewidywana retencja między pomiarami (0–1)", "Liczba pomiarów"),
                                     Wartosc = c(150, 0.85, 4)), startRow = 1)
writeData(wb, "retencja", "Liczba osób do zrekrutowania", startCol = 1, startRow = 6)
writeFormula(wb, "retencja", "=ROUNDUP(B2/B3^(B4-1),0)", startCol = 2, startRow = 6)
writeData(wb, "retencja", data.frame(Pomiar = paste0("T", 1:8)), startRow = 8)
for (k in 1:8) writeFormula(wb, "retencja", sprintf('=IF(%d<=$B$4,ROUND($B$6*$B$3^(%d-1),0),"")', k, k), startCol = 2, startRow = 8 + k)
writeData(wb, "retencja", "Przewidywana liczba osób", startCol = 2, startRow = 8)
setColWidths(wb, "retencja", 1:2, c(48, 26))
addWorksheet(wb, "harmonogram")
writeData(wb, "harmonogram", data.frame(
  Pomiar = paste0("T", 1:4), Miesiac_od_startu = c(0, 1, 3, 8), Termin = c("październik", "listopad", "styczeń (sesja)", "czerwiec"),
  Uzasadnienie_odstepu = c("pomiar wyjściowy przed pierwszymi zaliczeniami", "adaptacja do studiów", "szczyt obciążenia w sesji", "koniec roku akademickiego"),
  Narzedzia = "", Przypomnienia = "", Planowana_N = ""))
setColWidths(wb, "harmonogram", 1:7, c(10, 18, 18, 46, 24, 18, 14))
addWorksheet(wb, "dziennik_odpadania")
writeData(wb, "dziennik_odpadania", data.frame(Pomiar = paste0("T", 1:4), Zaproszeni = "", Uczestniczyli = "", Rezygnacja_jawna = "",
                                               Brak_kontaktu = "", Wykluczeni_i_powod = "", Uwagi = ""))
setColWidths(wb, "dziennik_odpadania", 1:7, c(10, 12, 14, 18, 16, 28, 30))
saveWorkbook(wb, "../planer-badania-podluznego.xlsx", overwrite = TRUE)
# kontrola: odczyt pliku i metadane autora
library(readxl)
excel_sheets("../planer-badania-podluznego.xlsx")
read_excel("../planer-badania-podluznego.xlsx", sheet = "harmonogram")[, 1:3]
tmp <- tempfile(); unzip("../planer-badania-podluznego.xlsx", "docProps/core.xml", exdir = tmp)
regmatches(x <- readLines(file.path(tmp, "docProps/core.xml"), warn = FALSE), gregexpr("<dc:creator>[^<]*</dc:creator>|<cp:lastModifiedBy>[^<]*</cp:lastModifiedBy>", x))[[1]]
Wynik w R
[1] "retencja"           "harmonogram"        "dziennik_odpadania"
# A tibble: 4 × 3
  Pomiar Miesiac_od_startu Termin
  <chr>              <dbl> <chr>
1 T1                     0 październik
2 T2                     1 listopad
3 T3                     3 styczeń (sesja)
4 T4                     8 czerwiec
[1] "<dc:creator>Metodolog.pl</dc:creator>"
[2] "<cp:lastModifiedBy>Metodolog.pl</cp:lastModifiedBy>"
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Modele mieszane dopasowano w pakiecie lme4 (testy efektów stałych w lmerTest), krzywą wzrostu – w pakiecie lavaan, a plik xlsx zapisano w pakiecie openxlsx i sprawdzono w readxl. Rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0-1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2-1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- readxl (wersja 1.4.5): Wickham, H., & Bryan, J. (2025). readxl: Read Excel files [R package]. https://doi.org/10.32614/CRAN.package.readxl
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy w badaniach podłużnych w doktoracie
- Odstępy dopasowane do kalendarza grantu, nie do procesu. Pomiar co pół roku nie uchwyci zmiany, która trwa tygodnie, a pomiar tuż po sesji udaje trwały wzrost stresu.
- Czas kodowany numerem pomiaru przy nierównych odstępach. W przykładzie takie kodowanie dało gorsze dopasowanie i zawyżone średnie w środkowych pomiarach. Koduj czas w jednostkach, które mają znaczenie (tygodnie, miesiące).
- Liczebność policzona na pierwszy pomiar. Moc dotyczy danych, które zostaną. Licz rekrutację od końca i zaplanuj retencję.
- Analiza tylko kompletnych przypadków. Gdy odpadają osoby o wyższych wynikach, średnie z kompletnych danych są obciążone. Użyj modelu mieszanego albo FIML z założeniem MAR i opisz wrażliwość na MNAR.
- Brak porównania osób, które odpadły. Bez niego czytelnik nie oceni, czy wyniki dotyczą całej próby.
- Standaryzacja osobno w każdym pomiarze. Usuwa zmianę średniej, którą chcesz badać.
- Klasyczny CLPM jako dowód kierunku wpływu. Bez oddzielenia stałych różnic między osobami współczynniki krzyżowe mogą wprowadzać w błąd. Rozważ RI-CLPM i uzasadnij odstęp.
- Brak sprawdzenia inwariancji w czasie. Jeśli narzędzie zaczyna mierzyć coś innego, „zmiana” może być zmianą znaczenia pozycji, a nie poziomu cechy.
- Wnioski przyczynowe z samego następstwa czasowego. Pomiar wcześniejszy nie jest przyczyną późniejszego tylko dlatego, że go poprzedza. Zmienne zakłócające zmieniające się w czasie nadal mogą wyjaśniać związek.
Najczęstsze pytania
Ile pomiarów potrzeba w badaniu podłużnym w doktoracie?
Dwa pomiary pozwalają porównać stan przed i po, ale nie pokażą kształtu zmiany. Do trajektorii liniowej z różnicami indywidualnymi potrzebujesz co najmniej trzech pomiarów, a do zmiany krzywoliniowej – czterech lub więcej. RI-CLPM wymaga co najmniej trzech fal.
Jak dobrać odstępy między pomiarami w badaniu podłużnym?
Dopasuj je do tempa badanego procesu, a nie do kalendarza grantu. Uwzględnij zdarzenia, które mogą wywołać pozorną zmianę (np. sesję), i efekt uczenia się przy powtarzanych testach. Każdy termin uzasadnij w harmonogramie, bo współczynniki krzyżowo-opóźnione zależą od długości odstępu.
Ile osób zrekrutować do badania podłużnego, jeśli część odpadnie?
Licz od końca: liczebność potrzebną w ostatnim pomiarze podziel przez retencję podniesioną do potęgi równej liczbie odstępów. Przy 150 osobach w czwartym pomiarze i retencji 85% między pomiarami potrzebujesz 245 osób na starcie. Dodatkowo zaplanuj działania ograniczające odpadanie i dziennik jego przyczyn.
Jak kodować czas w modelu wzrostu przy nierównych odstępach?
W jednostkach czasu, np. w miesiącach od pierwszego pomiaru (0, 1, 3, 8), a nie numerem pomiaru (0, 1, 2, 3). Kodowanie numerem zakłada równe odstępy i zniekształca kształt trajektorii. Punkt zerowy wybierz tak, żeby wyraz wolny miał sens, np. pomiar wyjściowy.
Czy model mieszany i krzywa wzrostu LGM dają te same wyniki?
W typowym liniowym modelu wzrostu tak: przy równych wariancjach reszt oba ujęcia są równoważne i dają te same oszacowania oraz tę samą wartość wiarygodności. Model mieszany łatwiej radzi sobie z różnymi terminami u różnych osób, a SEM – ze zmiennymi latentnymi, inwariancją i oceną dopasowania.
Powiązane hasła
Przeczytaj też
Modele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikKrzywe wzrostu (LGM) i modele zmiany
Krzywa wzrostu w lavaan na danych do pobrania: kształt zmiany, ujemna wariancja, kodowanie czasu, predyktor tempa, porównanie z lme4 i tabele APA.
Czytaj →Planujesz badanie podłużne w doktoracie?
Pomożemy dobrać liczbę i odstępy pomiarów, policzyć moc w symulacji dla Twoich parametrów, przeanalizować dane z odpadaniem i wyjaśnić wyniki tak, żebyś umiał(a) je obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Collins, L. M. (2006). Analysis of longitudinal data: The integration of theoretical model, temporal design, and statistical model. Annual Review of Psychology, 57(1), 505–528. https://doi.org/10.1146/annurev.psych.57.102904.190146
- Curran, P. J. (2003). Have multilevel models been structural equation models all along? Multivariate Behavioral Research, 38(4), 529–569. https://doi.org/10.1207/s15327906mbr3804_5
- Curran, P. J., & Bauer, D. J. (2011). The disaggregation of within-person and between-person effects in longitudinal models of change. Annual Review of Psychology, 62(1), 583–619. https://doi.org/10.1146/annurev.psych.093008.100356 ● Otwarty dostęp: pełny tekst
- Dormann, C., & Griffin, M. A. (2015). Optimal time lags in panel studies. Psychological Methods, 20(4), 489–505. https://doi.org/10.1037/met0000041
- Dumville, J. C., Torgerson, D. J., & Hewitt, C. E. (2006). Reporting attrition in randomised controlled trials. BMJ, 332(7547), 969–971. https://doi.org/10.1136/bmj.332.7547.969 ● Otwarty dostęp: pełny tekst
- Graham, J. W. (2009). Missing data analysis: Making it work in the real world. Annual Review of Psychology, 60(1), 549–576. https://doi.org/10.1146/annurev.psych.58.110405.085530
- Gueorguieva, R., & Krystal, J. H. (2004). Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry. Archives of General Psychiatry, 61(3), 310–317. https://doi.org/10.1001/archpsyc.61.3.310
- Hamaker, E. L., Kuiper, R. M., & Grasman, R. P. P. P. (2015). A critique of the cross-lagged panel model. Psychological Methods, 20(1), 102–116. https://doi.org/10.1037/a0038889 ● Otwarty dostęp: pełny tekst
- Maxwell, S. E., & Cole, D. A. (2007). Bias in cross-sectional analyses of longitudinal mediation. Psychological Methods, 12(1), 23–44. https://doi.org/10.1037/1082-989x.12.1.23
- Moeller, J. (2015). A word on standardization in longitudinal studies: Don’t. Frontiers in Psychology, 6, Article 1389. https://doi.org/10.3389/fpsyg.2015.01389 ● Otwarty dostęp
- Ployhart, R. E., & Vandenberg, R. J. (2010). Longitudinal research: The theory, design, and analysis of change. Journal of Management, 36(1), 94–120. https://doi.org/10.1177/0149206309352110
- Rast, P., & Hofer, S. M. (2014). Longitudinal design considerations to optimize power to detect variances and covariances among rates of change: Simulation results based on actual longitudinal studies. Psychological Methods, 19(1), 133–154. https://doi.org/10.1037/a0034524 ● Otwarty dostęp: pełny tekst
- Timmons, A. C., & Preacher, K. J. (2015). The importance of temporal design: How do measurement intervals affect the accuracy and efficiency of parameter estimates in longitudinal research? Multivariate Behavioral Research, 50(1), 41–55. https://doi.org/10.1080/00273171.2014.961056
- Widaman, K. F., Ferrer, E., & Conger, R. D. (2010). Factorial invariance within longitudinal structural equation models: Measuring the same construct across time. Child Development Perspectives, 4(1), 10–18. https://doi.org/10.1111/j.1750-8606.2009.00110.x ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{collins2006analysis, author={Collins, Linda M.}, title={{Analysis of longitudinal data: The integration of theoretical model, temporal design, and statistical model}}, journal={Annual Review of Psychology}, year={2006}, volume={57}, number={1}, pages={505--528}, doi={10.1146/annurev.psych.57.102904.190146}}@article{curran2003have, author={Curran, Patrick J.}, title={{Have multilevel models been structural equation models all along?}}, journal={Multivariate Behavioral Research}, year={2003}, volume={38}, number={4}, pages={529--569}, doi={10.1207/s15327906mbr3804_5}}@article{curran2011disaggregation, author={Curran, Patrick J. and Bauer, Daniel J.}, title={{The disaggregation of within-person and between-person effects in longitudinal models of change}}, journal={Annual Review of Psychology}, year={2011}, volume={62}, number={1}, pages={583--619}, doi={10.1146/annurev.psych.093008.100356}}@article{dormann2015optimal, author={Dormann, Christian and Griffin, Mark A.}, title={{Optimal time lags in panel studies}}, journal={Psychological Methods}, year={2015}, volume={20}, number={4}, pages={489--505}, doi={10.1037/met0000041}}@article{dumville2006reporting, author={Dumville, Jo C. and Torgerson, David J. and Hewitt, Catherine E.}, title={{Reporting attrition in randomised controlled trials}}, journal={BMJ}, year={2006}, volume={332}, number={7547}, pages={969--971}, doi={10.1136/bmj.332.7547.969}}@article{graham2009missing, author={Graham, John W.}, title={{Missing data analysis: Making it work in the real world}}, journal={Annual Review of Psychology}, year={2009}, volume={60}, number={1}, pages={549--576}, doi={10.1146/annurev.psych.58.110405.085530}}@article{gueorguieva2004move, author={Gueorguieva, Ralitza and Krystal, John H.}, title={{Move over ANOVA: Progress in analyzing repeated-measures data and its reflection in papers published in the Archives of General Psychiatry}}, journal={Archives of General Psychiatry}, year={2004}, volume={61}, number={3}, pages={310--317}, doi={10.1001/archpsyc.61.3.310}}@article{hamaker2015critique, author={Hamaker, Ellen L. and Kuiper, Rebecca M. and Grasman, Raoul P. P. P.}, title={{A critique of the cross-lagged panel model}}, journal={Psychological Methods}, year={2015}, volume={20}, number={1}, pages={102--116}, doi={10.1037/a0038889}}@article{maxwell2007bias, author={Maxwell, Scott E. and Cole, David A.}, title={{Bias in cross-sectional analyses of longitudinal mediation}}, journal={Psychological Methods}, year={2007}, volume={12}, number={1}, pages={23--44}, doi={10.1037/1082-989x.12.1.23}}@article{moeller2015word, author={Moeller, Julia}, title={{A word on standardization in longitudinal studies: Don’t}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={1389}, doi={10.3389/fpsyg.2015.01389}}@article{ployhart2010longitudinal, author={Ployhart, Robert E. and Vandenberg, Robert J.}, title={{Longitudinal research: The theory, design, and analysis of change}}, journal={Journal of Management}, year={2010}, volume={36}, number={1}, pages={94--120}, doi={10.1177/0149206309352110}}@article{rast2014longitudinal, author={Rast, Philippe and Hofer, Scott M.}, title={{Longitudinal design considerations to optimize power to detect variances and covariances among rates of change: Simulation results based on actual longitudinal studies}}, journal={Psychological Methods}, year={2014}, volume={19}, number={1}, pages={133--154}, doi={10.1037/a0034524}}@article{timmons2015importance, author={Timmons, Adela C. and Preacher, Kristopher J.}, title={{The importance of temporal design: How do measurement intervals affect the accuracy and efficiency of parameter estimates in longitudinal research?}}, journal={Multivariate Behavioral Research}, year={2015}, volume={50}, number={1}, pages={41--55}, doi={10.1080/00273171.2014.961056}}@article{widaman2010factorial, author={Widaman, Keith F and Ferrer, Emilio and Conger, Rand D}, title={{Factorial invariance within longitudinal structural equation models: Measuring the same construct across time}}, journal={Child Development Perspectives}, year={2010}, volume={4}, number={1}, pages={10--18}, doi={10.1111/j.1750-8606.2009.00110.x}}