Co to jest GLMM?
Uogólniony liniowy model mieszany (ang. generalized linear mixed model, GLMM) łączy dwie rzeczy: rozkład wyniku inny niż normalny, jak w regresji logistycznej czy regresji Poissona, oraz zależność obserwacji, jak w modelu wielopoziomowym. Używasz go, gdy wynik jest binarny albo jest zliczeniem, a dane mają skupienia: uczniów w klasach, pacjentów w oddziałach, wiele prób u tej samej osoby.
Jak to działa
Model ma efekty stałe i losowe, ale liczy je na skali funkcji łączącej: logitu dla wyniku 0/1, logarytmu dla zliczeń. Losowy wyraz wolny pozwala każdej klasie mieć własny poziom bazowy.
pij to prawdopodobieństwo zdarzenia u osoby i w skupieniu j, a τ² to wariancja między skupieniami. W R taki model dopasujesz funkcją glmer() z pakietu lme4 (Bates i in., 2015). Sommet i Morselli (2017) proponują dla wielopoziomowej regresji logistycznej trzy kroki: model pusty z ICC, test, czy nachylenie różni się między skupieniami, i model końcowy z ilorazami szans.
Przykład
Zbadano 400 uczniów z 20 klas: czy zaliczyli test (56% zaliczeń) i ile godzin się uczyli (dane symulowane). Każda dodatkowa godzina nauki zwiększała szanse zaliczenia, OR = 1.36, 95% CI [1.25, 1.48], z = 7.26, p < .001. Wariancja losowego wyrazu wolnego wyniosła τ² = 0.29, co na skali logitów daje ICC = .08.
Na rysunku
Panel A pokazuje model z przykładu: szare krzywe to przewidywania dla 20 klas (efekt stały + efekt losowy klasy), niebieska – dla klasy przeciętnej (u = 0), a przerywana – średnie prawdopodobieństwo zaliczenia po wszystkich klasach. Panel B to wariant fikcyjny: te same efekty stałe, ale τ² = 4 (wartość wybrana ręcznie, by różnica była wyraźna).
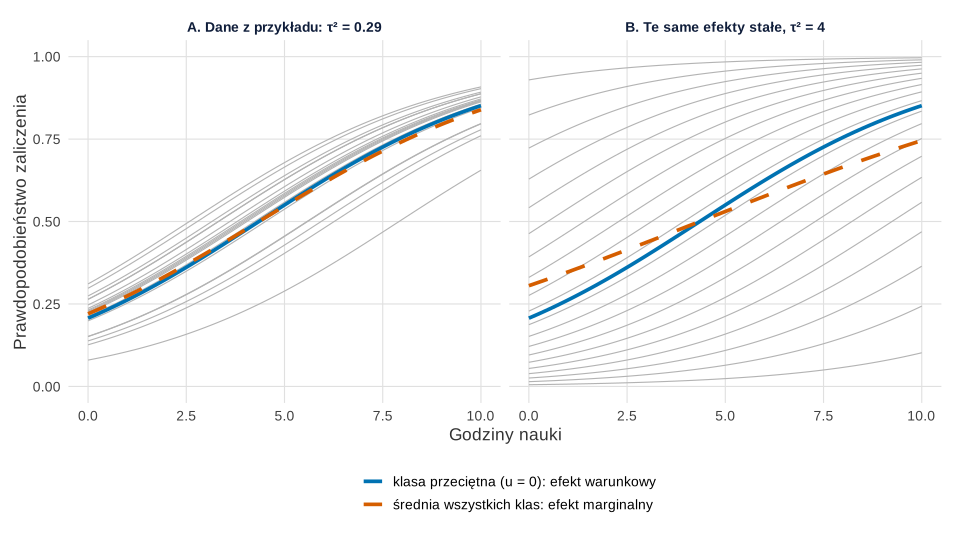
Co widać. Przy τ² = 0.29 obie krzywe prawie się pokrywają: OR warunkowy wynosi 1.36, a nachylenie krzywej średniej odpowiada OR = 1.34. Przy τ² = 4 krzywa klasy przeciętnej jest ta sama (od 0.21 przy 0 godzin do 0.85 przy 10), ale średnia po klasach jest płaska: od 0.31 do 0.75, czyli OR ≈ 1.21. Uśrednienie krzywych S o różnym położeniu nie daje krzywej S o tym samym nachyleniu – stąd różnica między efektem warunkowym GLMM a efektem populacyjnym, który szacuje np. GEE.
Na co uważać. Szare krzywe w panelu A to przewidywania ze ściągniętymi do średniej efektami losowymi, a nie krzywe dopasowane osobno do każdej klasy. W panelu B klasy nie pochodzą z danych – to 20 równo rozłożonych kwantyli rozkładu N(0, 4). Krzywa marginalna nie jest „lepsza” ani „gorsza” od warunkowej: odpowiadają na inne pytania (uczeń w danej klasie vs przeciętny uczeń w populacji). W modelu liniowym z tożsamościową funkcją łączącą ta różnica nie występuje. Krzywą S, skalę logitu i interpretację OR krok po kroku pokazuje wpis Regresja logistyczna w obrazkach.
Podpis do pracy:
Kod R rysunku 1
# Rysunek 1. Krzywe klas, krzywa warunkowa (klasa przeciętna) i krzywa marginalna (średnia populacyjna)
suppressPackageStartupMessages(library(lme4))
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("klasa przeciętna (u = 0): efekt warunkowy" = "#0072B2",
         "średnia wszystkich klas: efekt marginalny" = "#D55E00")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", legend.direction = "vertical",
        strip.text = element_text(face = "bold", hjust = 0),
        plot.background = element_rect(fill = "white", colour = NA))

# Te same dane co w przykładzie: 400 uczniów w 20 klasach
set.seed(187)
k <- 20; m <- 20
klasa   <- factor(rep(1:k, each = m))
u       <- rnorm(k, 0, 1.0)
godziny <- round(runif(k * m, 0, 10), 1)
zdal    <- rbinom(k * m, 1, plogis(-1.2 + 0.25 * godziny + u[klasa]))
m1 <- glmer(zdal ~ godziny + (1 | klasa), family = binomial)
b  <- fixef(m1); tau <- sqrt(as.numeric(VarCorr(m1)$klasa))

x <- seq(0, 10, 0.1)
z <- qnorm(ppoints(2000))                                  # siatka wartości N(0, 1) do uśredniania po klasach
krzywe <- function(tau, u_klas, panel) {
  kl  <- expand.grid(x = x, klasa = seq_along(u_klas))
  kl$p <- plogis(b[1] + b[2] * kl$x + u_klas[kl$klasa])
  sr  <- rbind(data.frame(x = x, p = plogis(b[1] + b[2] * x), co = names(kol)[1]),
               data.frame(x = x, p = sapply(x, function(g) mean(plogis(b[1] + b[2] * g + tau * z))),
                          co = names(kol)[2]))
  list(klasy = cbind(kl, panel = panel), srednie = cbind(sr, panel = panel))
}
A <- krzywe(tau, ranef(m1)$klasa[, 1], sprintf("A. Dane z przykładu: τ² = %.2f", tau^2))
tau_B <- 2                                                 # wariant fikcyjny: duże różnice między klasami (τ² = 4)
B <- krzywe(tau_B, tau_B * qnorm(ppoints(20)), "B. Te same efekty stałe, τ² = 4")

# Nachylenie krzywej marginalnej w skali logitu i prawdopodobieństwa przy 0, 5 i 10 godzinach
nachyl <- function(s) coef(lm(qlogis(p) ~ x, data = s[s$co == names(kol)[2], ]))[2]
round(c(b_warunkowe = unname(b[2]), b_marg_A = unname(nachyl(A$srednie)), b_marg_B = unname(nachyl(B$srednie))), 3)
round(exp(c(OR_warunkowy = unname(b[2]), OR_marg_A = unname(nachyl(A$srednie)), OR_marg_B = unname(nachyl(B$srednie)))), 2)
p_przy <- function(s) { w <- s[s$x %in% c(0, 5, 10), ]
  round(cbind(godziny = c(0, 5, 10), warunkowa = w$p[w$co == names(kol)[1]], marginalna = w$p[w$co == names(kol)[2]]), 2) }
p_przy(A$srednie); p_przy(B$srednie)

srednie <- rbind(A$srednie, B$srednie); srednie$co <- factor(srednie$co, names(kol))
p1 <- ggplot(srednie, aes(x, p)) +
  geom_line(data = rbind(A$klasy, B$klasy), aes(group = klasa), colour = "grey70", linewidth = 0.4) +
  geom_line(aes(colour = co, linetype = co), linewidth = 1.3) +
  facet_wrap(~ panel, ncol = 2) +
  scale_colour_manual(NULL, values = kol) +
  scale_linetype_manual(NULL, values = c("solid", "dashed")) +
  scale_y_continuous(limits = c(0, 1), breaks = seq(0, 1, 0.25)) +
  labs(x = "Godziny nauki", y = "Prawdopodobieństwo zaliczenia") + motyw
p1
Wynik w R
b_warunkowe    b_marg_A    b_marg_B
      0.309       0.291       0.189
OR_warunkowy    OR_marg_A    OR_marg_B
        1.36         1.34         1.21
     godziny warunkowa marginalna
[1,]       0      0.21       0.22
[2,]       5      0.55       0.55
[3,]      10      0.85       0.84
     godziny warunkowa marginalna
[1,]       0      0.21       0.31
[2,]       5      0.55       0.53
[3,]      10      0.85       0.75
Rysunek na stronie powstał z tego kodu z motywem serwisu (dane, geometrie i skale identyczne). Ziarno 187 i dane pochodzą z przykładu i nie były zmieniane; ręcznie wybrano tylko τ² = 4 w panelu B. Nachylenie krzywej średniej to nachylenie prostej dopasowanej do jej logitu.
Jak opisać w pracy
Na co uważać
- OR z GLMM jest warunkowy. Opisuje porównanie uczniów z tej samej klasy, a nie średni efekt w populacji. Przy dużym τ² oba ujęcia się rozjeżdżają.
- Nie transformuj wyniku na siłę. Lo i Andrews (2015) pokazują, że logarytmowanie czasów reakcji przed modelem mieszanym może zmienić wnioski, i proponują GLMM bez transformacji.
- Przy małej liczbie skupień oszacowanie τ² jest niestabilne. Podaj liczbę skupień i ostrzeżenia o zbieżności, jeśli wystąpiły.
Model z wynikiem ciągłym krok po kroku pokazujemy w poradniku model wielopoziomowy w R.
GLMM w R
Kod dopasowuje regresję logistyczną z losowym wyrazem wolnym dla klasy do danych z przykładu.
Wielopoziomowa regresja logistyczna w lme4
R
library(lme4)
m1  <- glmer(zdal ~ godziny + (1 | klasa), data = dane, family = binomial)
b   <- fixef(m1)["godziny"]
ci  <- confint(m1, parm = "godziny", method = "Wald")
round(c(b = b, OR = exp(b), OR_lo = exp(ci[1]), OR_hi = exp(ci[2])), 3)
tau2 <- as.numeric(VarCorr(m1)$klasa)
round(c(tau2 = tau2, ICC = tau2 / (tau2 + pi^2 / 3)), 3)
Wynik w R
 b.godziny OR.godziny      OR_lo      OR_hi
     0.309      1.362      1.253      1.480
 tau2   ICC
0.293 0.082
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem lme4 (rysunek 1 – także pakiet ggplot2).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym GLMM różni się od zwykłego modelu mieszanego (LMM)?
LMM zakłada wynik ciągły z resztami o rozkładzie normalnym. GLMM dopuszcza wynik binarny, zliczenia lub proporcje i łączy predyktory z wynikiem przez funkcję łączącą, np. logit.
Jak policzyć ICC w wielopoziomowej regresji logistycznej?
Na skali logitów wariancję poziomu osób przyjmuje się jako π²/3 ≈ 3.29. ICC = τ² / (τ² + 3.29), gdzie τ² to wariancja losowego wyrazu wolnego.
Co zrobić, gdy glmer zgłasza problem ze zbieżnością?
Wycentruj lub przeskaluj predyktory, uprość strukturę efektów losowych albo zmień optymalizator. Opisz w pracy, co zmieniono i czy wnioski pozostały takie same.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Model mieszany (MIXED) w SPSS krok po kroku
Linear Mixed Models od pliku w formacie długim po opis APA: Subjects i Repeated, losowy wyraz wolny, ICC, struktury AR(1), CS i UN, średnie brzegowe i składnia MIXED – na przykładzie dwóch grup i trzech pomiarów z brakami.
Czytaj →PoradnikStatystyka w pracy z rolnictwa, zootechniki i weterynarii
Poletka w blokach, krzywa plonu, kojec jako jednostka, ważenia w modelu mieszanym, dokumentacja stada i ankiety: analizy, zdania APA i kod R.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikWielopoziomowa regresja logistyczna (GLMM)
glmer krok po kroku: ICC z π²/3 i MOR, ilorazy szans warunkowe a uśrednione, kwadratura, zbieżność, prawdopodobieństwa i wzór opisu APA.
Czytaj →PoradnikModel mieszany się nie zbiega – singular fit
Skalowanie, gradient względny, allFit, rePCA, model bez korelacji i upraszczanie efektów losowych – procedura na jednym przykładzie w R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Lo, S., & Andrews, S. (2015). To transform or not to transform: Using generalized linear mixed models to analyse reaction time data. Frontiers in Psychology, 6, Article 1171. https://doi.org/10.3389/fpsyg.2015.01171 ● Otwarty dostęp
- Sommet, N., & Morselli, D. (2017). Keep calm and learn multilevel logistic modeling: A simplified three-step procedure using Stata, R, Mplus, and SPSS. International Review of Social Psychology, 30(1), 203–218. https://doi.org/10.5334/irsp.90 ● Otwarty dostęp
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{lo2015transform, author={Lo, Steson and Andrews, Sally}, title={{To transform or not to transform: Using generalized linear mixed models to analyse reaction time data}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={1171}, doi={10.3389/fpsyg.2015.01171}}@article{sommet2017keep, author={Sommet, Nicolas and Morselli, Davide}, title={{Keep calm and learn multilevel logistic modeling: A simplified three-step procedure using Stata, R, Mplus, and SPSS}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={203--218}, doi={10.5334/irsp.90}}