y + 1. Zacznij od modelu Poissona z offsetem dla czasu obserwacji i policz współczynnik rozproszenia. Przy nadmiernym rozproszeniu przejdź do regresji ujemnej dwumianowej. Po model z nadmiarem zer (ZINB) albo hurdle sięgnij dopiero wtedy, gdy NB wyraźnie nie docenia liczby zer i potrafisz wyjaśnić, skąd biorą się zera strukturalne.Zliczenia to nie wyniki skali: po co osobny model
Liczba napadów paniki, epizodów objadania się, dni nieobecności, wizyt w poradni czy błędów w zadaniu to zliczenia. Są nieujemnymi liczbami całkowitymi, mają zwykle prawostronnie skośny rozkład z wieloma zerami, a ich wariancja rośnie razem ze średnią. Gardner, Mulvey i Shaw (1995) opisują problemy, jakie daje analizowanie takich danych zwykłą regresją liniową, a Coxe, West i Aiken (2009) pokazują, że przy niskich średnich model liniowy może dawać obciążone wyniki. Właściwą rodziną są modele dla zliczeń: regresja Poissona, regresja ujemna dwumianowa i modele z nadmiarem zer.
Hasła słownika objaśniają każdy z tych modeli osobno, w tym iloraz częstości (IRR), parametr θ i dwie części modelu zero-inflated. Ten wpis prowadzi przez pełną analizę na jednym zbiorze danych: od opisu rozkładu przez model Poissona z offsetem, diagnozę rozproszenia, modele NB, ZIP, ZINB i hurdle, aż po wybór modelu, interpretację obu części, przewidywane średnie, tabelę APA i opis do artykułu. Doktoranci i badacze, którzy mają dane z dzienniczków, rejestrów albo obserwacji, znajdą tu sekwencję kroków do planu analiz i odpowiedzi na typowe pytania recenzentów. W przykładzie używamy R bez pakietów pscl i glmmTMB, które nie były zainstalowane w środowisku obliczeniowym. Modele z nadmiarem zer liczymy więc funkcją optim(), a odpowiednie wywołania tych pakietów podajemy obok.
Mapa modeli dla zliczeń
Modele różnią się dwiema rzeczami: tym, jak wariancja zależy od średniej, i tym, skąd biorą się zera. Tabela pomoże dobrać kandydatów, zanim zobaczysz dane. Modele najlepiej wpisać do planu analizy razem z kryteriami wyboru.
| Model | Wariancja | Skąd zera | Kiedy rozważyć | R |
|---|---|---|---|---|
| Poisson | Var(Y) = μ | Z tego samego rozkładu co inne wartości | Rzadkie zdarzenia, brak nadmiernego rozproszenia po uwzględnieniu predyktorów | glm(family = poisson) |
| Quasi-Poisson | φ · μ | Jak w modelu Poissona | Te same współczynniki co w modelu Poissona, ale z poprawionymi SE | glm(family = quasipoisson) |
| Ujemny dwumianowy (NB) | μ + μ²/θ | Z jednego rozkładu, ale z większą liczbą zer niż w modelu Poissona | Nadmierne rozproszenie, czyli najczęstsza sytuacja w psychologii | MASS::glm.nb() |
| ZIP | Większa niż μ (mieszanina) | Zera strukturalne + zera z rozkładu Poissona | Część osób nie może mieć zdarzenia, a pozostali nie mają nadmiernego rozproszenia | pscl::zeroinfl(dist = "poisson") |
| ZINB | Mieszanina z NB | Zera strukturalne + zera z rozkładu NB | Zera strukturalne i rozproszenie wśród osób „zagrożonych” | pscl::zeroinfl(dist = "negbin"), glmmTMB(ziformula = ~ …) |
| Hurdle NB | Dwie części | Wszystkie zera z części binarnej, dodatnie wartości z uciętego NB | Najpierw decyzja „czy w ogóle”, potem „ile razy” | pscl::hurdle(dist = "negbin") |
Quasi-Poisson i NB mają tyle samo parametrów i często dają podobne wyniki. Ver Hoef i Boveng (2007) wyjaśniają, kiedy się rozchodzą. W quasi-Poisson wariancja jest liniową funkcją średniej, a w NB kwadratową, więc oba modele inaczej ważą małe i duże zliczenia. Mullahy (1986) zaproponował zmodyfikowane modele dla zliczeń, które elastyczniej opisują dane nadmiernie lub niedostatecznie rozproszone względem modelu Poissona, a Lambert (1992) – regresję ZIP z osobnym procesem generującym zera. Zeileis, Kleiber i Jackman (2008) opisują ich implementację w pakiecie pscl.
Badanie przykładowe: epizody objadania się w dzienniczku
W przykładzie 480 dorosłych losowo przydzielono do programu internetowego albo na listę oczekujących (po 240 osób; dane symulowane). Przez 28 dni uczestnicy prowadzili dzienniczek epizodów objadania się. Nie wszyscy wypełnili go do końca: średnio 23.86 dnia, a pełne 28 dni wypełniło 51 osób. Predyktorami są grupa (0 = lista oczekujących, 1 = program) i stres w pomiarze wyjściowym, wystandaryzowany jako wynik z. Część osób w ogóle nie miewa epizodów objadania się, więc dane zawierają zera strukturalne. Prawdopodobieństwo takiego zera maleje ze stresem. Dane pobierzesz tutaj: regresja-dla-zliczen-dane.csv (kolumny id, grupa, stres, dni, epizody).
Krok 0. Opis rozkładu i czas obserwacji
Średnia liczba epizodów wyniosła 1.95, a wariancja 8.28, czyli była ponad czterokrotnie większa. Bez żadnego epizodu było 247 osób (51.46%), 95 osób miało 1–2 epizody, 68 osób 3–5, 65 osób 6–10, a 5 osób 11–20. Maksimum wyniosło 16. Średnie w grupach wyniosły 2.06 na liście oczekujących i 1.85 w programie przy niemal identycznej liczbie wypełnionych dni (23.90 i 23.82). Wariancja większa od średniej to dopiero sygnał. O nadmiernym rozproszeniu rozstrzygają reszty modelu z predyktorami.
Różny czas obserwacji wymaga offsetu. Osoba, która prowadziła dzienniczek 10 dni, miała mniej okazji do epizodu niż osoba obserwowana 28 dni. Dodanie offset(log(dni)) sprawia, że model opisuje częstość epizodów na dzień, a współczynnik przy offsecie jest ustalony na 1. Pominięcie offsetu przy różnym czasie obserwacji miesza dwa zjawiska: częstość zdarzeń i długość okna obserwacji.
Krok 1. Model Poissona z offsetem i współczynnik rozproszenia
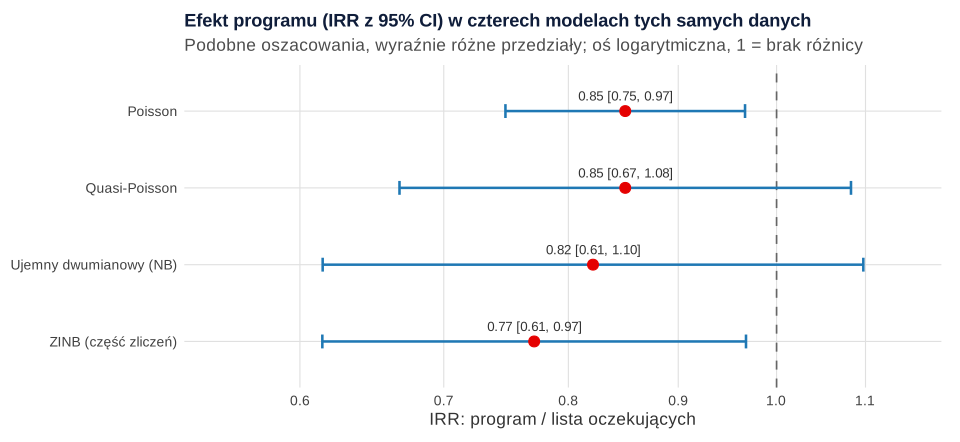
W modelu Poissona program wiązał się z mniejszą częstością epizodów, IRR = 0.85, 95% CI [0.75, 0.97], p = .013, a wzrost stresu o 1 SD – z większą, IRR = 1.69, 95% CI [1.59, 1.81]. Stała wyniosła −2.584, czyli exp(−2.584) ≈ 0.075 epizodu dziennie na liście oczekujących przy przeciętnym stresie. Wynik wygląda przekonująco, ale współczynnik rozproszenia, czyli suma kwadratów reszt Pearsona podzielona przez stopnie swobody, wyniósł 3.55. Wariancja reszt jest ponad trzy razy większa, niż zakłada model. Błędy standardowe są więc za małe, a wartości p zbyt optymistyczne. Gardner i in. (1995) zwracają uwagę, że przy nadmiernie rozproszonych danych model Poissona wprowadza w błąd.
Krok 2. Quasi-Poisson i regresja ujemna dwumianowa
Najprostsza poprawka to quasi-Poisson. Współczynniki zostają te same, a błędy standardowe mnoży się przez pierwiastek ze współczynnika rozproszenia. SE dla grupy wzrósł z 0.066 do 0.123, a przedział dla IRR objął 1: 0.85, 95% CI [0.67, 1.08], p = .189. Quasi-Poisson nie ma jednak funkcji wiarygodności, więc nie policzysz dla niego AIC ani nie porównasz go z innymi modelami.
Regresja ujemna dwumianowa szacuje rozproszenie jako parametr θ. W przykładzie θ = 0.517 (SE = 0.057), czyli α = 1/θ = 1.934. To bardzo duże rozproszenie. Test ilorazu wiarygodności NB wobec Poissona dał χ² = 569.37, p < .001. Ponieważ model Poissona odpowiada granicznej wartości α = 0, wartość p dzieli się przez 2, choć przy takim wyniku nie ma to znaczenia. Współczynnik rozproszenia w modelu NB spadł do 0.90, a AIC z 2248.6 do 1681.2. Efekt programu w NB wyniósł IRR = 0.82, 95% CI [0.61, 1.10], p = .183, a stresu IRR = 1.85, 95% CI [1.59, 2.15].
Uwaga na rozwiązanie, którego nie polecamy: transformację logarytmiczną log(epizody + 1) i zwykłą regresję liniową. W przykładzie dała dla grupy b = −0.042, SE = 0.070, p = .546. Wynik jest trudny do interpretacji, bo dotyczy logarytmu liczby powiększonej o 1. O’Hara i Kotze (2010) w symulacjach na danych z rozkładu ujemnego dwumianowego pokazali, że transformacje logarytmiczna i pierwiastkowa działały słabo poza sytuacją małego rozproszenia i dużych średnich. Modele quasi-Poissona i NB na surowych zliczeniach były konsekwentnie mało obciążone.
Krok 3. Ile zer przewiduje model? ZIP, ZINB i hurdle
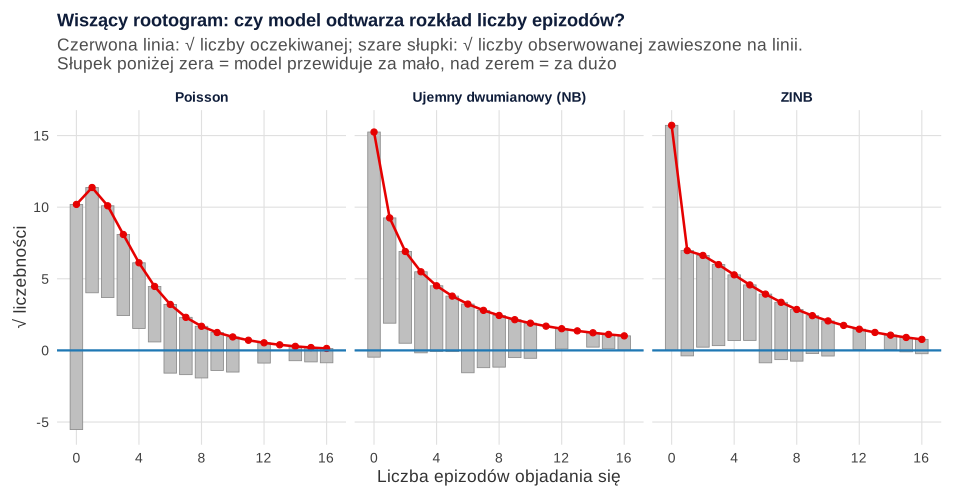
Przy 51.46% zer nasuwa się model z nadmiarem zer. Zanim po niego sięgniesz, sprawdź, ile zer przewiduje każdy model. Suma prawdopodobieństw P(Y = 0) po wszystkich osobach daje oczekiwaną liczbę zer. Model Poissona przewidział 103.9 zer przy 247 obserwowanych, a NB 232.4. NB jest więc blisko, ale nadal niedoszacowuje zer o około 15 osób. ZIP i ZINB przewidziały po 246.9 zer, a model hurdle z definicji odtwarza je dokładnie (247.0).
Modele ZIP, ZINB i hurdle NB oszacowaliśmy metodą największej wiarygodności, minimalizując funkcją optim() ujemny logarytm wiarygodności. Błędy standardowe pochodzą z odwrotności macierzy Hessego. Część zliczeń zawiera grupę, stres i offset, a część zerowa – stres. Taki podział warto uzasadnić teorią przed analizą: program ma zmniejszać częstość epizodów u osób, które je miewają, a nie zmieniać tego, kto ich nie miewa w ogóle. W codziennej pracy ten sam model ZINB dopasujesz jednym wywołaniem: pscl::zeroinfl(epizody ~ grupa + stres + offset(log(dni)) | stres, dist = "negbin") albo glmmTMB::glmmTMB(epizody ~ grupa + stres + offset(log(dni)), ziformula = ~ stres, family = nbinom2). Wyniki powinny być zgodne z naszymi do zaokrągleń.
| Model | log L | k | AIC | BIC | Przewidywane zera (obserwowane: 247) |
|---|---|---|---|---|---|
| Poisson | −1121.3 | 3 | 2248.6 | 2261.1 | 103.9 |
| Ujemny dwumianowy (NB) | −836.6 | 4 | 1681.2 | 1697.9 | 232.4 |
| ZIP | −857.3 | 5 | 1724.6 | 1745.5 | 246.9 |
| ZINB | −810.7 | 6 | 1633.3 | 1658.4 | 246.9 |
| Hurdle NB | −811.7 | 6 | 1635.5 | 1660.5 | 247.0 |
Wynik jest pouczający. ZIP odtwarza zera, ale jest gorszy od zwykłego NB (AIC 1724.6 wobec 1681.2), bo nie radzi sobie z rozproszeniem wśród osób mających epizody. Najlepsze są ZINB (AIC = 1633.3, BIC = 1658.4) i hurdle NB (1635.5 i 1660.5). Różnica między nimi jest mała, więc wybór powinien wynikać z teorii. ZINB zakłada, że część zer pochodzi od osób „zagrożonych”, które w danym okresie przypadkiem nie miały epizodu. Hurdle zakłada jedną bramkę: każde zero oznacza osobę, która nie przekroczyła progu. W przykładzie część osób nie ma problemu z objadaniem się, a część po prostu miała spokojny miesiąc, dlatego wybieramy ZINB.
Dopasowanie całego rozkładu najlepiej pokazuje rootogram. Kleiber i Zeileis (2016) rozszerzyli go na modele regresji i wskazują, że jest szczególnie użyteczny w diagnozie nadmiernego rozproszenia i nadmiaru zer. Ich pakiet countreg nie był dostępny, dlatego rootogram na rysunku 1 policzyliśmy ręcznie.
Do porównania ZINB z NB często używa się testu Vuonga. Vuong (1989) zaproponował go do wyboru między modelami niezagnieżdżonymi. Wilson (2015) pokazuje jednak, że stosowanie go jako testu nadmiaru zer jest błędne, bo modele z nadmiarem zer i ich odpowiedniki bez tej części nie są niezagnieżdżone w sensie wymaganym przez test. Dlatego opieraj wybór na przewidywanej liczbie zer, rootogramie, AIC i BIC oraz teorii, a test Vuonga, jeśli recenzent go oczekuje, opisz z tym zastrzeżeniem.
Krok 4. Interpretacja dwóch części modelu ZINB
Część zliczeń opisuje osoby „zagrożone” epizodami. Program wiązał się w niej z częstością epizodów mniejszą o 23%, IRR = 0.77, 95% CI [0.61, 0.97], p = .025. Wzrost stresu o 1 SD wiązał się z częstością większą o 27%, IRR = 1.27, 95% CI [1.11, 1.45], p < .001. Parametr rozproszenia wyniósł θ = 2.063, 95% CI [1.28, 3.33]. Po wydzieleniu zer strukturalnych rozproszenie jest więc znacznie mniejsze niż w modelu NB (0.517).
Część zerowa to regresja logistyczna prawdopodobieństwa, że osoba jest zerem strukturalnym. Przy przeciętnym stresie to prawdopodobieństwo wyniosło .427. Wzrost stresu o 1 SD zmniejszał szansę bycia zerem strukturalnym, OR = 0.40, 95% CI [0.29, 0.55], p < .001. Znak w części zerowej działa odwrotnie, niż podpowiada intuicja: OR mniejszy od 1 oznacza mniej zer strukturalnych, czyli więcej osób zagrożonych epizodami. Stres działa więc w obu częściach w tym samym kierunku, co pokazuje rysunek 2. Przy stresie −2 SD prawdopodobieństwo zera strukturalnego wynosi .825, a przy +2 SD tylko .106.
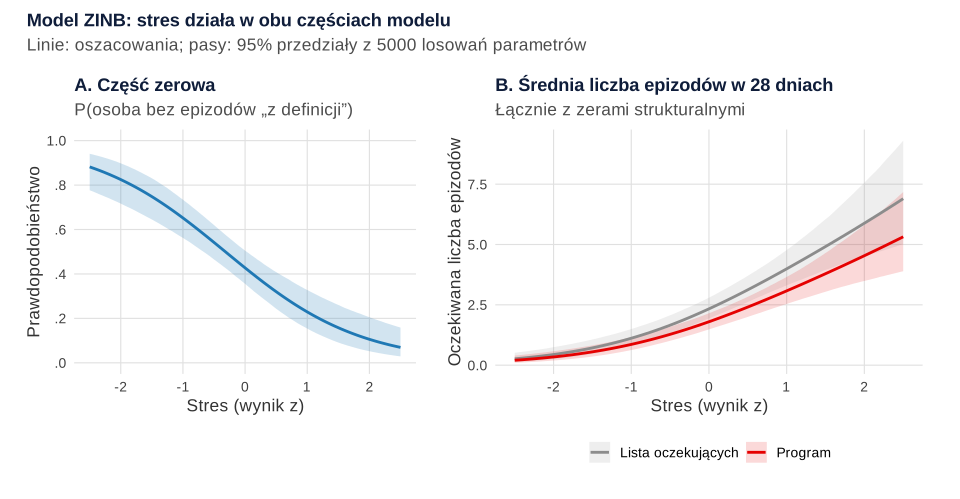
IRR z części zliczeń dotyczy tylko osób zagrożonych. Czytelników zwykle interesuje jednak średnia w całej populacji, z zerami strukturalnymi włącznie. Policz ją z obu części: (1 − π) · 28 · exp(b0 + b1·grupa + b2·stres). Przy przeciętnym stresie model przewiduje 2.33 epizodu w 28 dniach na liście oczekujących, 95% CI [1.94, 2.80], i 1.80 w programie, 95% CI [1.48, 2.15]. Różnica wynosi −0.53 epizodu, 95% CI [−1.05, −0.08]. Przedziały policzyliśmy, losując 5000 zestawów parametrów z wielowymiarowego rozkładu normalnego o macierzy kowariancji z Hessego. Ta sama metoda posłuży do każdej innej wartości stresu.
Rysunek 3 pokazuje, dlaczego wybór modelu ma znaczenie dla wniosku. Model Poissona dał „istotny” efekt programu tylko dzięki za małym błędom standardowym. Quasi-Poisson i NB poszerzyły przedział tak, że objął 1. ZINB, który oddziela zera strukturalne od zmienności wśród osób zagrożonych, przywrócił efekt z sensownym przedziałem. Nie chodzi o to, by szukać modelu z istotnym wynikiem. Taki wybór byłby p-hackingiem. Sekwencję modeli i kryteria wyboru zapisz przed analizą, a pozostałe modele podaj jako analizę wrażliwości.
Sekwencja decyzji do planu analiz
Kroki z przykładu da się zapisać jako krótką procedurę. Wpisz ją do planu analiz albo prerejestracji przed zebraniem danych. Kryteria wyboru modelu nie będą wtedy zależały od tego, który wynik okazał się istotny.
- Zdefiniuj zliczenie i okno obserwacji. Co dokładnie liczysz, w jakim okresie i czy czas obserwacji jest u wszystkich taki sam. Jeśli nie jest, zaplanuj offset.
- Sprawdź niezależność obserwacji. Kilka pomiarów od tej samej osoby, osoby w klasach albo zespołach wymagają modelu mieszanego, a nie zwykłego GLM.
- Dopasuj model Poissona i policz współczynnik rozproszenia. Wartość wyraźnie większa od 1 oznacza nadmierne rozproszenie. Wartość wyraźnie mniejsza od 1, czyli niedostateczne rozproszenie, jest rzadsza i wymaga innych modeli niż NB.
- Przy nadmiernym rozproszeniu dopasuj NB. Podaj θ (albo α = 1/θ) i test ilorazu wiarygodności na granicy przestrzeni parametrów.
- Porównaj liczbę zer obserwowaną z przewidywaną przez NB. Jeśli różnica jest wyraźna i masz teorię zer strukturalnych, dopasuj ZINB. Jeśli każde zero oznacza decyzję „nie”, wybierz model hurdle.
- Oceń dopasowanie całego rozkładu. Użyj rootogramu i kryteriów informacyjnych. Nie opieraj się na samym teście Vuonga.
- Interpretuj obie części i policz przewidywane średnie. IRR i OR podaj z 95% CI, a średnie w grupach z przedziałami.
- Zaplanuj analizę wrażliwości. Pokaż wynik w modelu NB i w modelu z nadmiarem zer, a różnice opisz wprost.
Dwie sytuacje wymagają innych modeli niż opisane wyżej. Pierwsza to zliczenia bez zer z definicji, np. liczba dni hospitalizacji osób, które trafiły do szpitala. Coxe i in. (2009) omawiają modele dla takich zer uciętych obok modeli z nadmiarem zer. Druga to zliczenia z górnym limitem, np. liczba poprawnych odpowiedzi na 20 pytań. Takie dane opisuje lepiej model dwumianowy dla proporcji z liczbą prób jako mianownikiem, a nie model Poissona.
Krok 5. Tabela APA i opis wyników
W artykule pokaż obie części modelu w jednej tabeli. W części zliczeń podaj IRR, a w części zerowej OR, oba z 95% CI. W tekście lub w nocie dodaj liczbę zer, porównanie modeli i informację o offsecie. Ogólny układ tabel regresji opisują hasła tabela regresji liniowej w APA i tabela regresji logistycznej w APA.
Tabela 1
Model ujemny dwumianowy z nadmiarem zer dla liczby epizodów objadania się (N = 480)
| Predyktor | b | SE | IRR / OR | 95% CI | p |
|---|---|---|---|---|---|
| Część zliczeń (IRR) | |||||
| Stała | −1.93 | 0.10 | 0.15 | [0.12, 0.18] | < .001 |
| Program (vs lista oczekujących) | −0.26 | 0.12 | 0.77 | [0.61, 0.97] | .025 |
| Stres (wynik z) | 0.24 | 0.07 | 1.27 | [1.11, 1.45] | < .001 |
| Część zerowa: zero strukturalne (OR) | |||||
| Stała | −0.29 | 0.16 | 0.75 | [0.55, 1.02] | .069 |
| Stres (wynik z) | −0.92 | 0.16 | 0.40 | [0.29, 0.55] | < .001 |
Uwaga. Offset: log(liczba wypełnionych dni dzienniczka); stała części zliczeń to częstość epizodów na dzień. θ = 2.06, 95% CI [1.28, 3.33]. Zera: 247 (51.46%); model przewidywał 246.9. AIC = 1633.3 (NB: 1681.2; hurdle NB: 1635.5). IRR = iloraz częstości; OR = iloraz szans bycia zerem strukturalnym. 95% CI z przedziałów Walda. Dane symulowane.
Ostatnie zdanie opisu nie jest ozdobą. Jeśli wynik zależy od wyboru modelu, recenzent i tak o to zapyta, więc lepiej to pokazać od razu. Jak odpowiadać na takie pytania, opisują wpisy o zarzutach recenzentów i wzorach odpowiedzi recenzentom. Gdy te same osoby mają kilka pomiarów, np. dzienniczek przed programem i po nim, potrzebujesz modelu mieszanego dla zliczeń (GLMM). Atkins i in. (2013) pokazują modele zero-inflated i hurdle w wersjach mieszanych dla danych podłużnych. Logikę efektów losowych opisuje wpis model wielopoziomowy krok po kroku.
Regresja dla zliczeń w R
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Przepis 0 tworzy plik regresja-dla-zliczen-dane.csv. Możesz go pominąć i pobrać gotowy plik do katalogu nadrzędnego względem katalogu roboczego, bo skrypty czytają ../regresja-dla-zliczen-dane.csv. Przepis 2 korzysta z obiektów z przepisu 1, więc uruchom je w jednej sesji. Potrzebny jest tylko pakiet MASS, który jest dołączony do R. Modele ZIP, ZINB i hurdle liczymy funkcją optim(), bo pakiety pscl i glmmTMB nie były zainstalowane. Jeśli je masz, porównaj wynik z pscl::zeroinfl().
0. Symulacja danych
R
# Regresja dla zliczeń – przepis 0: symulacja danych (plik regresja-dla-zliczen-dane.csv)
# Dane symulowane: 480 dorosłych z badania programu internetowego (grupa: 0 = lista oczekujących,
# 1 = program) przez 28 dni prowadziło dzienniczek epizodów objadania się. Część osób wypełniła
# dzienniczek krócej (dni = liczba wypełnionych dni). stres = stres w pomiarze wyjściowym (wynik z).
# Część osób nie ma epizodów objadania się w ogóle (zera strukturalne; im wyższy stres, tym rzadziej).
set.seed(88)
n <- 480
grupa <- rep(0:1, each = n / 2)
stres <- round(rnorm(n), 2)
dni <- pmin(28, pmax(7, round(28 - rexp(n, 1 / 4))))
p_zero <- plogis(-0.5 - 0.7 * stres)                       # P(zero strukturalne)
zero <- rbinom(n, 1, p_zero)
mu <- dni * exp(-2.0 + 0.30 * stres - 0.45 * grupa)        # oczekiwana liczba epizodów w okresie dni
epizody <- ifelse(zero == 1, 0, rnbinom(n, mu = mu, size = 1.8))
dane <- data.frame(id = 1:n, grupa, stres, dni, epizody)
write.csv(dane, "../regresja-dla-zliczen-dane.csv", row.names = FALSE)

round(c(N = n, M = mean(epizody), wariancja = var(epizody), zera = sum(epizody == 0),
        proc_zer = 100 * mean(epizody == 0), max = max(epizody), M_dni = mean(dni), pelne_28 = sum(dni == 28)), 2)
aggregate(cbind(epizody, dni) ~ grupa, data = dane, FUN = function(x) round(mean(x), 2))
table(cut(epizody, c(-1, 0, 2, 5, 10, 20, Inf), labels = c("0", "1-2", "3-5", "6-10", "11-20", ">20")))
Wynik w R
        N         M wariancja      zera  proc_zer       max     M_dni  pelne_28
   480.00      1.95      8.28    247.00     51.46     16.00     23.86     51.00
  grupa epizody   dni
1     0    2.06 23.90
2     1    1.85 23.82

    0   1-2   3-5  6-10 11-20   >20
  247    95    68    65     5     0
1. Poisson, quasi-Poisson i regresja ujemna dwumianowa
R
# Regresja dla zliczeń – przepis 1: Poisson, rozproszenie, quasi-Poisson i regresja ujemna dwumianowa
library(MASS)
dane <- read.csv("../regresja-dla-zliczen-dane.csv")
m_p  <- glm(epizody ~ grupa + stres + offset(log(dni)), family = poisson, data = dane)
round(summary(m_p)$coefficients, 3)
round(c(epizody_na_dzien = unname(exp(coef(m_p)[1]))), 3)   # stała jako częstość na dzień
round(c(rozproszenie = sum(residuals(m_p, type = "pearson")^2) / df.residual(m_p)), 2)

m_qp <- glm(epizody ~ grupa + stres + offset(log(dni)), family = quasipoisson, data = dane)
round(cbind(b = coef(m_qp), SE_Poisson = sqrt(diag(vcov(m_p))), SE_quasi = sqrt(diag(vcov(m_qp)))), 3)

m_nb <- glm.nb(epizody ~ grupa + stres + offset(log(dni)), data = dane)
round(summary(m_nb)$coefficients, 3)
round(c(theta = m_nb$theta, SE_theta = m_nb$SE.theta, alfa = 1 / m_nb$theta), 3)
lr <- 2 * (as.numeric(logLik(m_nb)) - as.numeric(logLik(m_p)))
round(c(LR = lr, p = pchisq(lr, 1, lower.tail = FALSE) / 2), 4)    # test na granicy przestrzeni parametrów
round(c(rozproszenie_NB = sum(residuals(m_nb, type = "pearson")^2) / df.residual(m_nb)), 2)

# IRR z 95% CI (Wald) dla grupy i stresu w trzech modelach; p z czterema miejscami
irr <- function(m) { b <- coef(m)[2:3]; se <- sqrt(diag(vcov(m)))[2:3]
  cbind(IRR = exp(b), CI_d = exp(b - 1.96 * se), CI_g = exp(b + 1.96 * se), p = 2 * pnorm(-abs(b / se))) }
wyn <- rbind(irr(m_p), irr(m_qp), irr(m_nb))
rownames(wyn) <- paste(rep(c("Poisson", "quasi", "NB"), each = 2), rownames(wyn))
round(wyn, 4)

# Zła droga dla porównania: regresja liniowa na log(epizody + 1)
m_log <- lm(log(epizody + 1) ~ grupa + stres, data = dane)
round(summary(m_log)$coefficients[2:3, ], 3)
Wynik w R
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   -2.584      0.048 -53.671    0.000
grupa         -0.162      0.066  -2.476    0.013
stres          0.527      0.033  15.835    0.000
epizody_na_dzien
           0.075
rozproszenie
        3.55
                 b SE_Poisson SE_quasi
(Intercept) -2.584      0.048    0.091
grupa       -0.162      0.066    0.123
stres        0.527      0.033    0.063
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   -2.596      0.104 -25.016    0.000
grupa         -0.197      0.148  -1.331    0.183
stres          0.614      0.077   8.006    0.000
   theta SE_theta     alfa
   0.517    0.057    1.934
      LR        p
569.3665   0.0000
rozproszenie_NB
            0.9
                 IRR   CI_d   CI_g      p
Poisson grupa 0.8503 0.7478 0.9668 0.0133
Poisson stres 1.6934 1.5865 1.8075 0.0000
quasi grupa   0.8503 0.6676 1.0830 0.1889
quasi stres   1.6934 1.4977 1.9148 0.0000
NB grupa      0.8214 0.6148 1.0974 0.1832
NB stres      1.8471 1.5894 2.1465 0.0000
      Estimate Std. Error t value Pr(>|t|)
grupa   -0.042      0.070  -0.604    0.546
stres    0.317      0.035   8.988    0.000
2. ZIP, ZINB i hurdle NB przez optim()
R
# Regresja dla zliczeń – przepis 2: ZIP, ZINB i hurdle NB liczone przez optim()
# (pakiety pscl i glmmTMB nie są zainstalowane w środowisku, w którym liczono przykład).
# Wymaga obiektów z przepisu 1 (dane, m_p, m_nb).
y <- dane$epizody; X <- cbind(1, dane$grupa, dane$stres); Z <- cbind(1, dane$stres); off <- log(dane$dni)
nll_zi <- function(th, nb) {                                       # th: b (3), g (2) [, log theta]
  mu <- exp(off + X %*% th[1:3]); pi0 <- plogis(Z %*% th[4:5])
  f  <- if (nb) dnbinom(y, mu = mu, size = exp(th[6])) else dpois(y, mu)
  f0 <- if (nb) dnbinom(0, mu = mu, size = exp(th[6])) else dpois(0, mu)
  -sum(log(ifelse(y == 0, pi0 + (1 - pi0) * f0, (1 - pi0) * f)))
}
nll_hnb <- function(th) {                                          # hurdle: P(y > 0) z logitu, NB ucięty w zerze
  mu <- exp(off + X %*% th[1:3]); p1 <- plogis(Z %*% th[4:5]); k <- exp(th[6])
  f0 <- dnbinom(0, mu = mu, size = k)
  -sum(ifelse(y == 0, log(1 - p1), log(p1) + dnbinom(y, mu = mu, size = k, log = TRUE) - log(1 - f0)))
}
st <- c(coef(m_p), 0, 0)
zip  <- optim(st, nll_zi, nb = FALSE, method = "BFGS", hessian = TRUE, control = list(maxit = 500))
zinb <- optim(c(st, 0), nll_zi, nb = TRUE, method = "BFGS", hessian = TRUE, control = list(maxit = 500))
hnb  <- optim(c(coef(m_nb), 0, 0, 0), nll_hnb, method = "BFGS", hessian = TRUE, control = list(maxit = 500))
round(c(zip = zip$convergence, zinb = zinb$convergence, hnb = hnb$convergence), 0)   # 0 = zbieżność

# Przewidywana liczba zer i kryteria informacyjne
mu_p <- fitted(m_p); mu_nb <- fitted(m_nb)
pr0 <- function(th, nb) { mu <- exp(off + X %*% th[1:3]); pi0 <- plogis(Z %*% th[4:5])
  pi0 + (1 - pi0) * (if (nb) dnbinom(0, mu = mu, size = exp(th[6])) else dpois(0, mu)) }
zera <- c(obserwowane = sum(y == 0), Poisson = sum(dpois(0, mu_p)), NB = sum(dnbinom(0, mu = mu_nb, size = m_nb$theta)),
          ZIP = sum(pr0(zip$par, FALSE)), ZINB = sum(pr0(zinb$par, TRUE)), hurdle_NB = sum(y == 0))
round(zera, 1)
ic <- function(nll, k) c(logLik = -nll, k = k, AIC = 2 * nll + 2 * k, BIC = 2 * nll + log(length(y)) * k)
round(rbind(Poisson = ic(-as.numeric(logLik(m_p)), 3), NB = ic(-as.numeric(logLik(m_nb)), 4),
            ZIP = ic(zip$value, 5), ZINB = ic(zinb$value, 6), hurdle_NB = ic(hnb$value, 6)), 1)

# Współczynniki ZINB: IRR (część zliczeń) i OR (część zerowa) z 95% CI (Wald, z macierzy Hessego)
se <- sqrt(diag(solve(zinb$hessian)))
tab <- data.frame(param = c("(stała)", "grupa", "stres", "zero: (stała)", "zero: stres", "log(theta)"),
                  b = zinb$par, SE = se, z = zinb$par / se, p = 2 * pnorm(-abs(zinb$par / se)))
tab$exp_b <- exp(tab$b); tab$CI_d <- exp(tab$b - 1.96 * se); tab$CI_g <- exp(tab$b + 1.96 * se)
tab[, -1] <- round(tab[, -1], 4); tab
round(c(theta = exp(zinb$par[6]), pi_przy_sredim_stresie = plogis(zinb$par[4])), 3)

# Część zliczeń w hurdle NB (dla porównania)
se_h <- sqrt(diag(solve(hnb$hessian)))
round(cbind(b = hnb$par, SE = se_h, exp_b = exp(hnb$par))[1:5, ], 3)

# Przewidywana liczba epizodów w 28 dniach (ZINB) przy stresie = 0 i różnica grup
pred <- function(th, g, s) (1 - plogis(th[4] + th[5] * s)) * 28 * exp(th[1] + th[2] * g + th[3] * s)
set.seed(881)
los <- MASS::mvrnorm(5000, zinb$par, solve(zinb$hessian))
sym <- apply(los, 1, function(th) c(kontrola = pred(th, 0, 0), program = pred(th, 1, 0)))
sym <- rbind(sym, roznica = sym["program", ] - sym["kontrola", ])
round(cbind(oszacowanie = c(pred(zinb$par, 0, 0), pred(zinb$par, 1, 0), pred(zinb$par, 1, 0) - pred(zinb$par, 0, 0)),
            CI_d = apply(sym, 1, quantile, .025), CI_g = apply(sym, 1, quantile, .975)), 2)
Wynik w R
 zip zinb  hnb
   0    0    0
obserwowane     Poisson          NB         ZIP        ZINB   hurdle_NB
      247.0       103.9       232.4       246.9       246.9       247.0
           logLik k    AIC    BIC
Poisson   -1121.3 3 2248.6 2261.1
NB         -836.6 4 1681.2 1697.9
ZIP        -857.3 5 1724.6 1745.5
ZINB       -810.7 6 1633.3 1658.4
hurdle_NB  -811.7 6 1635.5 1660.5
          param       b     SE        z      p  exp_b   CI_d   CI_g
1       (stała) -1.9267 0.0967 -19.9236 0.0000 0.1456 0.1205 0.1760
2         grupa -0.2598 0.1158  -2.2429 0.0249 0.7712 0.6146 0.9678
3         stres  0.2391 0.0688   3.4734 0.0005 1.2701 1.1098 1.4536
4 zero: (stała) -0.2924 0.1605  -1.8215 0.0685 0.7465 0.5450 1.0225
5   zero: stres -0.9208 0.1601  -5.7499 0.0000 0.3982 0.2909 0.5450
6    log(theta)  0.7241 0.2448   2.9573 0.0031 2.0628 1.2766 3.3333
                 theta pi_przy_sredim_stresie
                 2.063                  0.427
                 b    SE exp_b
(Intercept) -1.915 0.095 0.147
grupa       -0.276 0.120 0.759
stres        0.242 0.068 1.274
            -0.107 0.098 0.898
             0.840 0.112 2.317
 oszacowanie  CI_d  CI_g
        2.33  1.94  2.80
        1.80  1.48  2.15
       -0.53 -1.05 -0.08
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag New York. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://CRAN.R-project.org/package=patchwork
Najczęstsze błędy w regresji dla zliczeń
- Regresja liniowa albo test t na zliczeniach z wieloma zerami. Przewidywane wartości mogą być ujemne, a wariancja rośnie ze średnią. Logarytmowanie
y + 1nie rozwiązuje problemu, co pokazał przykład z p = .546. - Brak offsetu przy różnym czasie obserwacji. Gdy ludzie byli obserwowani przez różną liczbę dni, tygodni albo sesji, model bez
offset(log(czas))myli częstość zdarzeń z długością obserwacji. - Ocena rozproszenia na surowych danych. Wariancja większa od średniej to sygnał, ale decyduje współczynnik rozproszenia z reszt modelu z predyktorami. W przykładzie wyniósł 3.55 w modelu Poissona i 0.90 w NB.
- Model z nadmiarem zer „bo jest dużo zer”. Najpierw porównaj liczbę zer obserwowanych z przewidywaną przez NB. Czasem NB w zupełności wystarcza. ZIP bywa gorszy od NB, jak w przykładzie (AIC 1724.6 wobec 1681.2).
- Brak teorii zer strukturalnych. W modelu ZINB musisz umieć powiedzieć, kim są osoby „zawsze zerowe”. Jeśli nie potrafisz, rozważ model hurdle albo pozostań przy NB.
- Odwrócona interpretacja części zerowej. Dodatni współczynnik w części zerowej zwiększa szansę bycia zerem strukturalnym, a więc oznacza mniej zdarzeń. W modelu hurdle (pscl) jest odwrotnie, bo część binarna opisuje szansę przekroczenia zera. Zawsze podaj, co modeluje każda część.
- Test Vuonga jako dowód nadmiaru zer. Wilson (2015) wyjaśnia, dlaczego to niewłaściwe użycie testu.
- Raportowanie tylko IRR z części zliczeń. IRR z części zliczeń dotyczy osób zagrożonych. Jeśli pytanie dotyczy całej populacji, podaj przewidywane średnie z obu części z przedziałami ufności.
- Wybór modelu po wyniku istotności. W przykładzie trzy z czterech modeli dają inny wniosek o programie. Sekwencję i kryteria wyboru zapisz w planie analiz, a modele alternatywne pokaż jako analizę wrażliwości.
Jeśli masz dane z dzienniczka, rejestru albo obserwacji i nie wiesz, który model dla zliczeń obronić przed recenzentem, możemy przeliczyć sekwencję modeli na twoich danych i wyjaśnić wyniki w ramach oferty dla badaczy. Opis i decyzje w artykule pozostaną twoje, ale będziesz wiedzieć, skąd wynika każda liczba.
Najczęstsze pytania
Kiedy w regresji Poissona potrzebny jest offset?
Gdy osoby były obserwowane przez różny czas albo miały różną liczbę okazji do zdarzenia, np. wypełniły dzienniczek przez 10 albo 28 dni. Dodaj wtedy offset(log(dni)): model opisuje częstość zdarzeń na jednostkę czasu, a IRR porównuje częstości, a nie surowe liczby. Bez offsetu efekt predyktora miesza się z długością obserwacji.
Jak sprawdzić, czy w danych jest nadmiar zer?
Dopasuj model ujemny dwumianowy i zsumuj przewidywane prawdopodobieństwa zera dla wszystkich osób. Porównaj tę liczbę z obserwowaną liczbą zer i obejrzyj rootogram. W przykładzie NB przewidział 232.4 zer przy 247 obserwowanych, a ZINB 246.9. Sam wysoki odsetek zer nie wystarcza, bo NB często dobrze je odtwarza.
ZINB czy model hurdle – który wybrać?
Wybór wynika z teorii zer. ZINB zakłada dwa rodzaje zer: strukturalne (osoba nie może mieć zdarzenia) i przypadkowe (mogła, ale nie miała). Model hurdle zakłada jedną bramkę: każde zero oznacza, że osoba nie przekroczyła progu, a część zliczeń opisuje tylko wartości dodatnie. Gdy AIC obu modeli jest podobne, jak w przykładzie (1633.3 i 1635.5), rozstrzyga uzasadnienie merytoryczne.
Czy test Vuonga rozstrzyga o modelu z nadmiarem zer?
Nie powinien. Vuong (1989) zaproponował test dla modeli niezagnieżdżonych, a Wilson (2015) pokazuje, że używanie go do porównania modelu z nadmiarem zer z jego odpowiednikiem bez tej części jest błędne. Lepiej oprzeć decyzję na przewidywanej liczbie zer, rootogramie, AIC i BIC oraz teorii zer strukturalnych.
Jak opisać w APA wynik modelu ZINB?
Podaj, dlaczego wybrano ZINB (rozproszenie, liczba zer obserwowanych i przewidywanych, AIC), a potem obie części osobno: w części zliczeń IRR z 95% CI i p, w części zerowej OR dla szansy bycia zerem strukturalnym. Dodaj przewidywane średnie w grupach, bo IRR z części zliczeń dotyczy tylko osób zagrożonych zdarzeniem. W nocie tabeli wymień offset i θ.
Powiązane hasła
Przeczytaj też
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →PoradnikPlan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →Masz zliczenia z wieloma zerami i nie wiesz, który model wybrać?
Przeliczymy model Poissona, NB, ZINB i hurdle na twoich danych, porównamy je i wyjaśnimy wyniki tak, żebyś mógł je opisać w artykule lub doktoracie i obronić przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Atkins, D. C., Baldwin, S. A., Zheng, C., Gallop, R. J., & Neighbors, C. (2013). A tutorial on count regression and zero-altered count models for longitudinal substance use data. Psychology of Addictive Behaviors, 27(1), 166–177. https://doi.org/10.1037/a0029508 ● Otwarty dostęp: pełny tekst
- Coxe, S., West, S. G., & Aiken, L. S. (2009). The analysis of count data: A gentle introduction to Poisson regression and its alternatives. Journal of Personality Assessment, 91(2), 121–136. https://doi.org/10.1080/00223890802634175
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Kleiber, C., & Zeileis, A. (2016). Visualizing count data regressions using rootograms. The American Statistician, 70(3), 296–303. https://doi.org/10.1080/00031305.2016.1173590 ● Otwarty dostęp: pełny tekst
- Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1–14. https://doi.org/10.2307/1269547
- Mullahy, J. (1986). Specification and testing of some modified count data models. Journal of Econometrics, 33(3), 341–365. https://doi.org/10.1016/0304-4076(86)90002-3 ● Otwarty dostęp
- O’Hara, R. B., & Kotze, D. J. (2010). Do not log-transform count data. Methods in Ecology and Evolution, 1(2), 118–122. https://doi.org/10.1111/j.2041-210x.2010.00021.x
- Ver Hoef, J. M., & Boveng, P. L. (2007). Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data? Ecology, 88(11), 2766–2772. https://doi.org/10.1890/07-0043.1
- Vuong, Q. H. (1989). Likelihood ratio tests for model selection and non-nested hypotheses. Econometrica, 57(2), 307–333. https://doi.org/10.2307/1912557
- Wilson, P. (2015). The misuse of the Vuong test for non-nested models to test for zero-inflation. Economics Letters, 127, 51–53. https://doi.org/10.1016/j.econlet.2014.12.029 ● Otwarty dostęp: pełny tekst
- Zeileis, A., Kleiber, C., & Jackman, S. (2008). Regression models for count data in R. Journal of Statistical Software, 27(8), 1–25. https://doi.org/10.18637/jss.v027.i08 ● Otwarty dostęp
Cytowania BibTeX
@article{atkins2013tutorial, author={Atkins, David C. and Baldwin, Scott A. and Zheng, Cheng and Gallop, Robert J. and Neighbors, Clayton}, title={{A tutorial on count regression and zero-altered count models for longitudinal substance use data}}, journal={Psychology of Addictive Behaviors}, year={2013}, volume={27}, number={1}, pages={166--177}, doi={10.1037/a0029508}}@article{coxe2009analysis, author={Coxe, Stefany and West, Stephen G. and Aiken, Leona S.}, title={{The analysis of count data: A gentle introduction to Poisson regression and its alternatives}}, journal={Journal of Personality Assessment}, year={2009}, volume={91}, number={2}, pages={121--136}, doi={10.1080/00223890802634175}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{kleiber2016visualizing, author={Kleiber, Christian and Zeileis, Achim}, title={{Visualizing count data regressions using rootograms}}, journal={The American Statistician}, year={2016}, volume={70}, number={3}, pages={296--303}, doi={10.1080/00031305.2016.1173590}}@article{lambert1992zero, author={Lambert, Diane}, title={{Zero-inflated Poisson regression, with an application to defects in manufacturing}}, journal={Technometrics}, year={1992}, volume={34}, number={1}, pages={1--14}, doi={10.2307/1269547}}@article{mullahy1986specification, author={Mullahy, John}, title={{Specification and testing of some modified count data models}}, journal={Journal of Econometrics}, year={1986}, volume={33}, number={3}, pages={341--365}, doi={10.1016/0304-4076(86)90002-3}}@article{ohara2010do, author={O'Hara, Robert B. and Kotze, D. Johan}, title={{Do not log-transform count data}}, journal={Methods in Ecology and Evolution}, year={2010}, volume={1}, number={2}, pages={118--122}, doi={10.1111/j.2041-210x.2010.00021.x}}@article{verhoef2007quasi, author={Ver Hoef, Jay M. and Boveng, Peter L.}, title={{Quasi-Poisson vs. negative binomial regression: How should we model overdispersed count data?}}, journal={Ecology}, year={2007}, volume={88}, number={11}, pages={2766--2772}, doi={10.1890/07-0043.1}}@article{vuong1989likelihood, author={Vuong, Quang H.}, title={{Likelihood ratio tests for model selection and non-nested hypotheses}}, journal={Econometrica}, year={1989}, volume={57}, number={2}, pages={307--333}, doi={10.2307/1912557}}@article{wilson2015misuse, author={Wilson, Paul}, title={{The misuse of the Vuong test for non-nested models to test for zero-inflation}}, journal={Economics Letters}, year={2015}, volume={127}, pages={51--53}, doi={10.1016/j.econlet.2014.12.029}}@article{zeileis2008regression, author={Zeileis, Achim and Kleiber, Christian and Jackman, Simon}, title={{Regression models for count data in R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={8}, pages={1--25}, doi={10.18637/jss.v027.i08}}