Co to jest model z nadmiarem zer?
Model z nadmiarem zer (ang. zero-inflated model) to model dla zliczeń, w którym zera mają dwa źródła. Część osób w ogóle nie może mieć zdarzenia (zera strukturalne), a reszta mogła je mieć, ale w danym okresie go nie miała. Lambert (1992) opisała regresję ZIP: z prawdopodobieństwem π obserwuje się wyłącznie zero, a z prawdopodobieństwem 1 − π – wartość z rozkładu Poissona. Oba parametry mogą zależeć od predyktorów. Wersja ZINB zamiast Poissona używa rozkładu ujemnego dwumianowego.
Model
f to rozkład Poissona lub ujemny dwumianowy. Model ma dwie części: logistyczną dla π (kto należy do grupy „zawsze zero”) i część zliczeń z logarytmiczną funkcją wiążącą (IRR). Model hurdle działa inaczej: jedna część opisuje wszystkie zera, a druga tylko wartości dodatnie. Oba podejścia, też wielopoziomowo, omawiają Atkins i in. (2013).
Przykład
400 studentów podało liczbę drinków wypitych w weekend; część nie pije alkoholu (dane symulowane). Zer jest 188. Regresja Poissona przewiduje ich 58.7, model NB – 171.5, ZIP – 186.5, a ZINB – 186.2. AIC wynosi odpowiednio 2162.7, 1564.1, 1584.5 i 1514.6. ZIP odtwarza zera, ale nie rozproszenie wśród pijących; najlepszy jest ZINB. Szacowany odsetek zer strukturalnych to π = .40, 95% CI [.34, .46], a w części zliczeń IRR dla impulsywności = 1.58, 95% CI [1.42, 1.77].
Na rysunku
Liczba przewidywanych zer to tylko jeden słupek rozkładu. Rysunek porównuje z danymi z przykładu wszystkie liczebności naraz: ile osób wypiło 0, 1, 2… drinki, a ile przewiduje każdy z czterech modeli. To tzw. wiszący rootogram: słupek obserwowanej liczby osób zwisa z krzywej przewidywanej, a obie wielkości są pod pierwiastkiem, żeby rzadkie duże wartości nie zniknęły. Rozkład Poissona i ujemny dwumianowy na tych samych osiach pokazuje też wpis Regresja Poissona – wizualizacja.
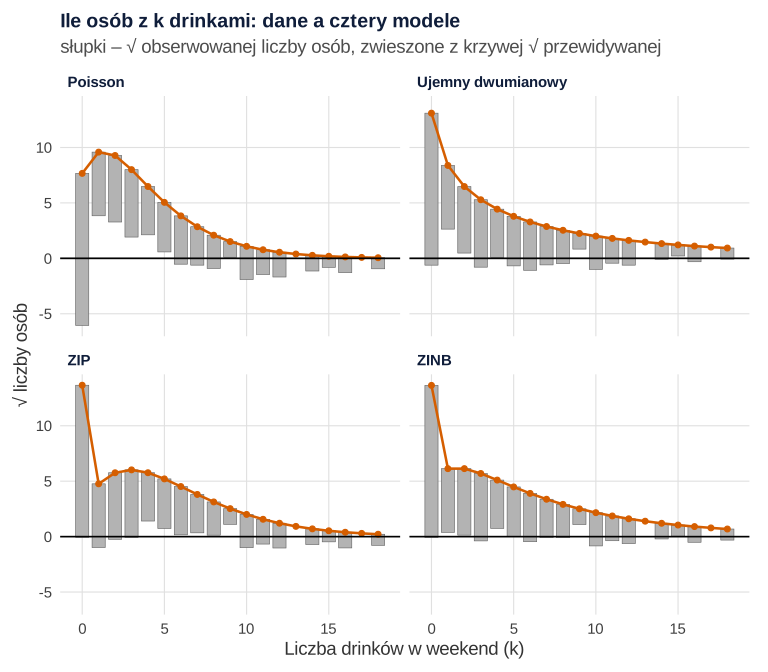
set.seed(186)).Co widać. Gdy model pasuje, dół każdego słupka wypada na osi zero. Słupek poniżej osi oznacza, że model przewiduje za mało osób, a kończący się nad osią – za dużo. Model Poissona przewiduje 58.7 zer wobec 188 i za dużo wyników 1–4 (np. 91.8 osoby z jednym drinkiem wobec 33). ZIP trafia w zera (186.5), ale ma za mało osób z jednym drinkiem (22.7) i za dużo z czterema (33.2 wobec 19), bo Poisson jest zbyt wąski dla pijących. ZINB odtwarza zera i kształt reszty rozkładu najlepiej z czterech modeli: 37.6 osoby z jednym drinkiem wobec 33.
Na co uważać. Ujemny dwumianowy bez części zerowej też wygląda nieźle (171.5 zer) – rootogram nie rozstrzyga, czy zera są strukturalne. Pokazuje dopasowanie rozkładu brzegowego, a nie to, czy dobrze opisano zależność od predyktorów. Skala pierwiastkowa zmniejsza różnice przy dużych liczebnościach, więc czytaj ją jako wykres kształtu, a liczby bierz z tabeli.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tej sekcji. Jest samowystarczalny: definiuje prosty motyw, a dane powstają od własnego set.seed(186), tego samego co w przykładzie (ziarna nie zmieniano). Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Wiszący rootogram: obserwowana i przewidywana liczba osób z k drinkami w czterech modelach
library(ggplot2)
suppressPackageStartupMessages(library(MASS))

motyw <- theme_minimal(base_size = 14) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom",
        plot.title = element_text(face = "bold"))

# Te same dane i modele co w przykładzie (ZIP i ZINB liczone przez optim)
set.seed(186)
n <- 400
impuls <- rnorm(n)
abstynent <- rbinom(n, 1, 0.35)
drinki <- ifelse(abstynent == 1, 0, rnbinom(n, mu = exp(1.3 + 0.4 * impuls), size = 3))
X <- cbind(1, impuls)
nll_zi <- function(th, nb) {
  mu <- exp(X %*% th[1:2]); pi0 <- plogis(th[3])
  f <- if (nb) dnbinom(drinki, mu = mu, size = exp(th[4])) else dpois(drinki, mu)
  f0 <- if (nb) dnbinom(0, mu = mu, size = exp(th[4])) else dpois(0, mu)
  -sum(log(ifelse(drinki == 0, pi0 + (1 - pi0) * f0, (1 - pi0) * f)))
}
zip  <- optim(c(1, 0, 0), nll_zi, nb = FALSE, method = "BFGS")
zinb <- optim(c(1, 0, 0, 0), nll_zi, nb = TRUE, method = "BFGS")
m_p <- glm(drinki ~ impuls, family = poisson); m_nb <- glm.nb(drinki ~ impuls)

# Przewidywana liczba osób z wynikiem k = suma po osobach P(Y = k | impulsywność)
k <- 0:max(drinki)
ocz <- function(mu, pi0 = 0, size = NULL) sapply(k, function(kk)
  sum((kk == 0) * pi0 + (1 - pi0) * (if (is.null(size)) dpois(kk, mu) else dnbinom(kk, mu = mu, size = size))))
oczekiwane <- list(
  "Poisson"            = ocz(fitted(m_p)),
  "Ujemny dwumianowy"  = ocz(fitted(m_nb), size = m_nb$theta),
  "ZIP"                = ocz(exp(X %*% zip$par[1:2]), plogis(zip$par[3])),
  "ZINB"               = ocz(exp(X %*% zinb$par[1:2]), plogis(zinb$par[3]), exp(zinb$par[4])))
obserwowane <- tabulate(drinki + 1, nbins = length(k))
rg <- do.call(rbind, lapply(names(oczekiwane), function(m)
  data.frame(model = m, k, obs = obserwowane, ocz = oczekiwane[[m]])))
rg$model <- factor(rg$model, names(oczekiwane))

# Obserwowane i przewidywane liczebności dla k = 0–6
round(cbind(k = 0:6, obserwowane = obserwowane[1:7], sapply(oczekiwane, `[`, 1:7)), 1)

# Wiszący rootogram: słupek √obserwowane zwisa z krzywej √przewidywane;
# dół słupka poniżej 0 = model przewiduje za mało, powyżej 0 = za dużo
p1 <- ggplot(rg, aes(x = k)) +
  geom_rect(aes(xmin = k - 0.4, xmax = k + 0.4, ymin = sqrt(ocz) - sqrt(obs), ymax = sqrt(ocz)),
            fill = "grey70", colour = "grey35", linewidth = 0.2) +
  geom_line(aes(y = sqrt(ocz)), colour = "#D55E00", linewidth = 0.9) +
  geom_point(aes(y = sqrt(ocz)), colour = "#D55E00", size = 1.6) +
  geom_hline(yintercept = 0, linewidth = 0.6) +
  facet_wrap(~ model, ncol = 2) +
  labs(title = "Ile osób z k drinkami: dane a cztery modele",
       subtitle = "słupki – √ obserwowanej liczby osób, zwieszone z krzywej √ przewidywanej",
       x = "Liczba drinków w weekend (k)", y = "√ liczby osób") + motyw
p1   # zapis: ggsave("model-z-nadmiarem-zer-rootogram.svg", p1, width = 8, height = 7)
Wynik w R
     k obserwowane Poisson Ujemny dwumianowy   ZIP  ZINB
[1,] 0         188    58.7             171.5 186.5 186.2
[2,] 1          33    91.8              70.2  22.7  37.6
[3,] 2          36    86.1              41.9  33.2  37.6
[4,] 3          37    64.0              27.9  36.3  32.4
[5,] 4          19    42.0              19.7  33.2  26.0
[6,] 5          20    25.5              14.4  27.1  20.1
[7,] 6          19    14.7              10.8  20.4  15.2
Jak opisać w pracy
Na co uważać
- Dużo zer to jeszcze nie nadmiar. Porównaj liczbę zer z przewidywaną przez Poissona i NB. W przykładzie NB był już blisko.
- Uzasadnij zera strukturalne. Jeśli nie wiadomo, kto „nie może” mieć zdarzenia, rozważ model hurdle.
- Czytaj dwie części osobno. Dodatni współczynnik w części zerowej zwiększa szansę bycia zerem strukturalnym, czyli oznacza mniej zdarzeń.
W R oba modele dopasujesz funkcją zeroinfl() z pakietu pscl (Zeileis i in., 2008), dane powtarzane – w GLMM. Porównanie modeli opisuje wpis Regresja dla zliczeń.
Model z nadmiarem zer w R
Kod liczy wiarygodność modeli ZIP i ZINB ręcznie (optim()), dopasowuje modele Poissona i NB i porównuje przewidywaną liczbę zer oraz AIC. W codziennej pracy wygodniej użyć funkcji zeroinfl() z pakietu pscl.
Ile zer przewiduje każdy model?
R
# Model z nadmiarem zer (ZIP, ZINB) liczony przez optim (dane symulowane)
library(MASS)
set.seed(186)
n <- 400
impuls <- rnorm(n)                                 # impulsywność (wynik z)
abstynent <- rbinom(n, 1, 0.35)                    # zera strukturalne: osoby niepijące
drinki <- ifelse(abstynent == 1, 0, rnbinom(n, mu = exp(1.3 + 0.4 * impuls), size = 3))
round(c(zera_obs = sum(drinki == 0), M = mean(drinki), wariancja = var(drinki)), 2)
X <- cbind(1, impuls)
nll_zi <- function(th, nb) {                       # th: b0, b1, logit(pi) [, log(theta)]
  mu <- exp(X %*% th[1:2]); pi0 <- plogis(th[3])
  f <- if (nb) dnbinom(drinki, mu = mu, size = exp(th[4])) else dpois(drinki, mu)
  f0 <- if (nb) dnbinom(0, mu = mu, size = exp(th[4])) else dpois(0, mu)
  -sum(log(ifelse(drinki == 0, pi0 + (1 - pi0) * f0, (1 - pi0) * f)))
}
zip  <- optim(c(1, 0, 0), nll_zi, nb = FALSE, method = "BFGS", hessian = TRUE)
zinb <- optim(c(1, 0, 0, 0), nll_zi, nb = TRUE, method = "BFGS", hessian = TRUE)
m_p <- glm(drinki ~ impuls, family = poisson); m_nb <- glm.nb(drinki ~ impuls)
zera_ocz <- function(mu, pi0 = 0, size = NULL)
  sum(pi0 + (1 - pi0) * (if (is.null(size)) dpois(0, mu) else dnbinom(0, mu = mu, size = size)))
mu_zip <- exp(X %*% zip$par[1:2]); mu_zinb <- exp(X %*% zinb$par[1:2])
round(c(Poisson = zera_ocz(fitted(m_p)), NB = zera_ocz(fitted(m_nb), size = m_nb$theta),
        ZIP = zera_ocz(mu_zip, plogis(zip$par[3])),
        ZINB = zera_ocz(mu_zinb, plogis(zinb$par[3]), exp(zinb$par[4]))), 1)
round(c(AIC_Poisson = AIC(m_p), AIC_NB = AIC(m_nb),
        AIC_ZIP = 2 * zip$value + 2 * 3, AIC_ZINB = 2 * zinb$value + 2 * 4), 1)
se <- sqrt(diag(solve(zinb$hessian)))
round(c(pi = plogis(zinb$par[3]), pi_dolna = plogis(zinb$par[3] - 1.96 * se[3]),
        pi_gorna = plogis(zinb$par[3] + 1.96 * se[3])), 2)          # odsetek zer strukturalnych
round(exp(c(IRR = zinb$par[2], dolna = zinb$par[2] - 1.96 * se[2],
            gorna = zinb$par[2] + 1.96 * se[2])), 2)                # IRR w części zliczeń
c(zip$convergence, zinb$convergence)
Wynik w R
 zera_obs         M wariancja
   188.00      2.44     11.56
Poisson      NB     ZIP    ZINB
   58.7   171.5   186.5   186.2
AIC_Poisson      AIC_NB     AIC_ZIP    AIC_ZINB
     2162.7      1564.1      1584.5      1514.6
      pi pi_dolna pi_gorna
    0.40     0.34     0.46
  IRR dolna gorna
 1.58  1.42  1.77
[1] 0 0
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats, pakiet MASS). Rysunek 1 wykonano w pakiecie ggplot2 i zapisano pakietem svglite. W pracy podaj wersję R, której faktycznie użyto (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym model z nadmiarem zer różni się od modelu hurdle?
W modelu z nadmiarem zer zera pochodzą z dwóch procesów: strukturalnego i przypadkowego. W modelu hurdle wszystkie zera opisuje jedna część, a druga modeluje tylko wartości dodatnie.
Kiedy wybrać ZINB zamiast ZIP?
Gdy wśród osób, które mogą mieć zdarzenie, wariancja zliczeń przekracza średnią. Porównaj modele przez AIC; w przykładzie ZIP odtworzył liczbę zer, ale ZINB miał wyraźnie niższe AIC.
Jak interpretować część zerową modelu zero-inflated?
To regresja logistyczna dla przynależności do grupy „zawsze zero”. Dodatni współczynnik zwiększa szansę, że osoba jest zerem strukturalnym, czyli oznacza mniej zdarzeń, odwrotnie niż w części zliczeń.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka w pracy ze stomatologii
PUWZ z nadmiarem zer, materiały in vitro, kilka zębów u pacjenta, kalibracja badaczy, lęk stomatologiczny i higiena przed i po: modele, zdania APA i kod R.
Czytaj →PoradnikStatystyka w pracy z biologii i ochrony środowiska
Stanowiska, liczebność w pułapkach bez pseudoreplikacji, różnorodność gatunkowa, sezonowość w monitoringu i skala NEP: modele, efekty i kod R.
Czytaj →PoradnikRegresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Atkins, D. C., Baldwin, S. A., Zheng, C., Gallop, R. J., & Neighbors, C. (2013). A tutorial on count regression and zero-altered count models for longitudinal substance use data. Psychology of Addictive Behaviors, 27(1), 166–177. https://doi.org/10.1037/a0029508 ● Otwarty dostęp: pełny tekst
- Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1–14. https://doi.org/10.2307/1269547
- Zeileis, A., Kleiber, C., & Jackman, S. (2008). Regression models for count data in R. Journal of Statistical Software, 27(8), 1–25. https://doi.org/10.18637/jss.v027.i08 ● Otwarty dostęp
Cytowania BibTeX
@article{atkins2013tutorial, author={Atkins, David C. and Baldwin, Scott A. and Zheng, Cheng and Gallop, Robert J. and Neighbors, Clayton}, title={{A tutorial on count regression and zero-altered count models for longitudinal substance use data}}, journal={Psychology of Addictive Behaviors}, year={2013}, volume={27}, number={1}, pages={166--177}, doi={10.1037/a0029508}}@article{lambert1992zero, author={Lambert, Diane}, title={{Zero-inflated Poisson regression, with an application to defects in manufacturing}}, journal={Technometrics}, year={1992}, volume={34}, number={1}, pages={1--14}, doi={10.2307/1269547}}@article{zeileis2008regression, author={Zeileis, Achim and Kleiber, Christian and Jackman, Simon}, title={{Regression models for count data in R}}, journal={Journal of Statistical Software}, year={2008}, volume={27}, number={8}, pages={1--25}, doi={10.18637/jss.v027.i08}}