Plan analiz we wniosku to argument za wykonalnością
Recenzent wniosku grantowego nie sprawdza, czy umiesz policzyć model mieszany. Sprawdza, czy projekt da odpowiedź na postawione pytanie, zanim skończą się pieniądze i czas. Część o analizie statystycznej jest w tym miejscu najmocniejszym dowodem: pokazuje, że liczba osób, pomiarów i miesięcy nie została wzięta z sufitu, że wiesz, co zrobisz z brakami danych, i że wynik negatywny też będzie coś znaczył.
Ten poradnik jest dla doktorantów i doktorantek, którzy piszą pierwszy wniosek (np. do konkursu dla osób bez stopnia doktora), oraz dla badaczy, którym poprzedni wniosek wrócił z uwagą „niejasna metodyka”. Pokazujemy na jednym przykładzie, jak zbudować plan analiz w siedmiu blokach: hipotezy, liczebność, analiza główna, analizy dodatkowe, braki danych, analizy wrażliwości i ryzyka. Wszystkie liczby pochodzą z kodu R na końcu strony (dane symulowane).
Czym ten tekst nie jest. Pełny plan analizy statystycznej (SAP) i jego rejestrację opisujemy w poradniku plan analizy statystycznej i prerejestracja. Tam są reguły wykluczeń, kodowanie zmiennych i tabela odstępstw. Planowanie całej części empirycznej doktoratu, harmonogram i plan zarządzania danymi omawiamy w tekście analiza statystyczna w doktoracie. Wniosek grantowy wymaga czegoś innego: krótkiego, przekonującego streszczenia decyzji, które w SAP rozpiszesz później, z naciskiem na wykonalność i koszt.
Co mówią zasady konkursu – i czego nie zgadywać
Wymagania co do objętości, języka i układu wniosku różnią się między grantodawcami, konkursami, a nawet edycjami tego samego konkursu. Dlatego zanim zaczniesz pisać, przeczytaj aktualne ogłoszenie, warunki konkursu i wzór formularza. Poniżej podajemy tylko to, co odczytaliśmy z oficjalnej strony jednego konkursu, jako przykład tego, czego szukać.
W ogłoszeniu konkursu PRELUDIUM 25 Narodowego Centrum Nauki z 16 marca 2026 r. (Narodowe Centrum Nauki, 2026; odczyt 25 października 2026 r.):
- wniosek zawiera m.in. plan badań (dodatkowo w języku polskim), skrócony opis projektu do 5 stron A4 i szczegółowy opis projektu do 15 stron A4, z bibliografią poza limitem stron;
- opisy projektu muszą uwzględniać m.in. ogólną koncepcję i plan badań oraz metodykę badań;
- przy ocenie uwzględnia się w szczególności m.in. ocenę możliwości realizacji planowanych badań i zasadność planowanych kosztów w stosunku do przedmiotu i zakresu badań;
- osobnymi częściami wniosku są informacje o kwestiach etycznych i plan zarządzania danymi.
Z tego wynikają dwie praktyczne wskazówki. Po pierwsze, plan analiz nie ma osobnej rubryki: mieści się w metodyce, więc musi być zwięzły. W skróconym opisie wystarczą 2–4 zdania (schemat, liczebność z uzasadnieniem, model główny), a w opisie szczegółowym – pełne siedem bloków z tego poradnika. Po drugie, liczebność łączy się bezpośrednio z kosztorysem. Jeśli uzasadnisz 40 klas, recenzent zobaczy, skąd biorą się wynagrodzenia osób prowadzących zajęcia, koszty dojazdów i nagrody dla szkół. Jeśli liczba jest „okrągła”, kosztorys też wygląda na przypadkowy.
Plan zarządzania danymi ma w NCN własne wytyczne, m.in. o dokumentacji, przechowywaniu i udostępnianiu danych (Narodowe Centrum Nauki, 2020). W metodyce wystarczy do niego odesłać i nie powtarzać go. Jak przygotować dane i kod do udostępnienia, pokazujemy w poradniku o pakiecie replikacyjnym.
Projekt przykładowy: program w szkołach z losowaniem klas
Przykład ma typową dla grantu trudność: interwencję realizuje się w grupach, więc losuje się całe klasy, a nie uczniów. To zmienia wszystko – od liczebności po model analizy.
| Element | Decyzja w projekcie przykładowym |
|---|---|
| Pytanie | Czy 8-tygodniowy program grupowy obniża lęk egzaminacyjny uczniów szkół średnich? |
| Schemat | Badanie z losowym przydziałem klas (randomizacja klastrów): program albo grupa kontrolna z odroczonym udziałem |
| Wynik pierwszorzędowy | Lęk egzaminacyjny po programie, skala 10–40, oczekiwane SD ≈ 6 punktów |
| Kowarianta | Ten sam pomiar przed programem; oczekiwana korelacja z pomiarem końcowym r = .60 |
| Struktura danych | Średnio 22 uczniów w klasie; oczekiwany ICC = .10 (scenariusz główny), .05 i .15 (scenariusze poboczne) |
| Odpadanie | 15% uczniów bez pomiaru końcowego |
| Najmniejszy interesujący efekt | d = 0.30, czyli 1.8 punktu skali |
Każdy wiersz tej tabeli to założenie, które recenzent może zakwestionować. Dlatego we wniosku przy każdym podaj źródło: wcześniejsze badania, dane pilotażowe, dane szkolne albo rozsądny zakres wartości, jeśli źródła nie ma. Szczególnie ważne są ICC i korelacja pre–post, bo od nich zależy liczba klas bardziej niż od samej wielkości efektu.
Blok 1. Hipotezy, które da się przełożyć na analizę
Standardy JARS-Quant zalecają, by hipotezy, analizy i wnioski dzielić na pierwszorzędowe, drugorzędowe i eksploracyjne (Appelbaum i in., 2018). We wniosku ten podział robi dwie rzeczy: pokazuje, na czym opiera się liczebność, i z góry chroni przed zarzutem wielokrotnego testowania. Jedna hipoteza badawcza główna z jednym wynikiem i jednym momentem pomiaru to rozwiązanie najbezpieczniejsze.
| Hipoteza | Wynik | Model | Kryterium |
|---|---|---|---|
| H1 (główna): w klasach z programem lęk po 8 tygodniach będzie niższy niż w klasach kontrolnych | Lęk egzaminacyjny (10–40) | Model mieszany ANCOVA z losowym wyrazem wolnym klasy | Test dwustronny, α = .05; skorygowana różnica średnich i d z 95% CI |
| H2a–H2c (drugorzędowe): wyższa samoskuteczność, mniejsza prokrastynacja, lepszy dobrostan | Trzy skale | Jak H1 | Korekta Holma w rodzinie trzech testów |
| Eksploracja: czy efekt zależy od lęku na starcie? | Lęk egzaminacyjny | H1 + interakcja grupa × pomiar wyjściowy | Bez wniosków konfirmacyjnych |
Zwróć uwagę na ostatni wiersz. Pytanie o moderację jest ciekawe, ale nie opieraj na nim liczebności. W metabadaniu 159 badań mediana mocy wykrycia interakcji typowej wielkości wynosiła .18 (Sommet i in., 2023). Uczciwe zdanie „analiza ma charakter eksploracyjny, bo moc dla interakcji będzie niska” robi lepsze wrażenie niż obietnica, której nie da się spełnić. Więcej o formułowaniu hipotez piszemy w tekście pytania badawcze i hipotezy.
Blok 2. Liczebność: SESOI, parametry i symulacja
Lakens (2022) opisuje sześć sposobów uzasadnienia liczebności próby, od badania niemal całej populacji, przez ograniczenia zasobów, po analizę mocy a priori i planowanie dokładności. We wniosku grantowym najczęściej łączysz dwa z nich: analizę mocy dla najmniejszego interesującego efektu (SESOI) i uczciwy opis tego, na ile klas stać projekt. Ogólne zasady doboru liczebności opisujemy w poradniku dobór liczebności próby, a proste przypadki policzysz w kalkulatorze liczebności próby.
Skąd wziąć SESOI, a skąd nie
SESOI to efekt, który uzasadnia wdrożenie programu: przy mniejszym koszt zajęć byłby niewart wyniku. Nie bierz go z małego pilotażu. Albers i Lakens (2018) pokazują, że oszacowania efektu z danych pilotażowych prowadzą do analiz mocy obciążonych w stronę zbyt małych prób, a pilotaże, które „wyszły dobrze”, częściej przechodzą do badania głównego. Pilotaż przydaje się do czegoś innego: do oszacowania odsetka odpadnięć, korelacji pre–post i wykonalności rekrutacji (zob. badanie pilotażowe).
Najpierw wzór: efekt schematu
Gdy losujesz klasy, uczniowie z jednej klasy są do siebie podobni, a efektywna liczebność spada. Mówi o tym efekt schematu (design effect):
gdzie m to liczba uczniów w klasie z pomiarem końcowym. W przykładzie m = 22 × 0.85 = 18.7, więc przy ICC = .10 DE = 2.77. Bez klastrów ANCOVA z pomiarem wyjściowym wymagałaby 113 uczniów na grupę z pomiarem końcowym (moc .80, α = .05). Pomnożone przez DE i podzielone przez 18.7 daje to 17 klas na grupę. Przy ICC = .05 wychodzi 12 klas, a przy ICC = .15 – 23. Ten jeden parametr prawie podwaja koszt projektu, więc uzasadnij go źródłem.
Wzór zakłada równe klasy. Gdy liczebności klas są bardzo różne, moc spada, więc we wniosku podaj, jak duże różnice przewidujesz, albo uwzględnij je w symulacji.
Potem symulacja modelu, który naprawdę zastosujesz
Wzór jest przybliżeniem. Dla schematów złożonych lepsza jest symulacja: generujesz wiele zbiorów danych zgodnych z założeniami, w każdym liczysz zaplanowany model i sprawdzasz, jak często wynik jest istotny (Arnold i in., 2011). W przykładzie symulowaliśmy model mieszany z testem na poziomie klas (stopnie swobody = liczba klas − 2), po 500 powtórzeń dla każdej kombinacji liczby klas i ICC.
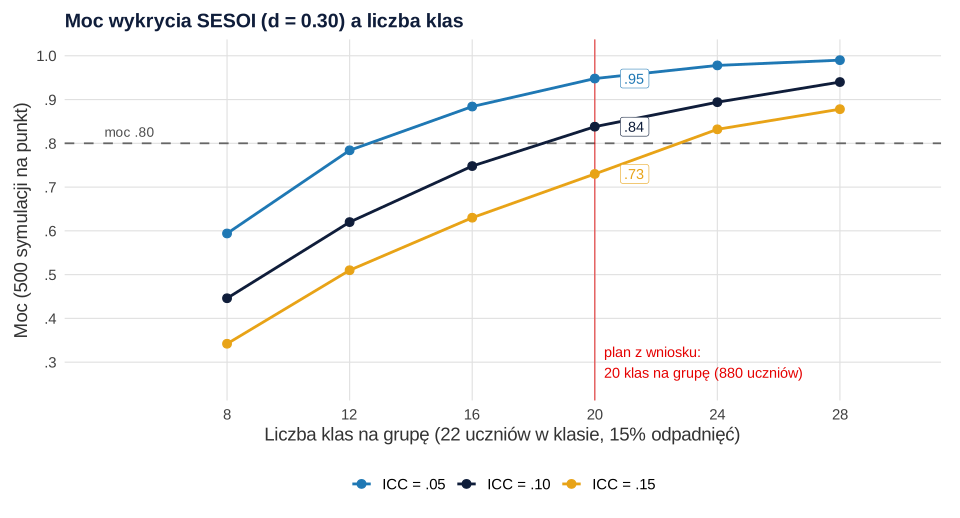
Symulacja daje dwie informacje, których sam wzór nie daje. Po pierwsze, wzór był optymistyczny: obiecywał moc .80 przy 17 klasach na grupę, a symulacja dla 16 klas na grupę daje .75. Po drugie, widać, co się stanie, jeśli ICC okaże się wyższy. Dlatego plan zakłada 20 klas na grupę (40 klas, 880 uczniów): moc .84 w scenariuszu głównym, .95 przy ICC = .05 i .73 przy ICC = .15. Ten ostatni wynik warto napisać wprost – to dobry materiał do bloku o ryzykach.
Blok 3. Analiza główna i analizy drugorzędowe
Opis analizy głównej we wniosku ma być na tyle dokładny, by inny statystyk mógł ją powtórzyć: model, zmienne, estymacja, test i miara efektu. W przykładzie jest to model wielopoziomowy z losowym wyrazem wolnym klasy, grupą jako predyktorem poziomu klasy i pomiarem wyjściowym jako kowariantą. Szczegóły takich modeli i ich raportowanie opisujemy w poradnikach model wielopoziomowy krok po kroku i ANCOVA w badaniu przed i po.
Dlaczego to takie ważne? W symulacji przy braku efektu (1000 powtórzeń, 40 klas, ICC = .10) model mieszany dawał wynik istotny w 5.4% badań, czyli zgodnie z założonym α = .05. Zwykła regresja, która traktuje uczniów jak niezależne obserwacje, dawała fałszywy alarm w 24.8% badań. Recenzent, który zobaczy we wniosku z randomizacją klas „test t dla prób niezależnych”, wie, że projekt nie ma właściwego planu. Różnicę między efektami stałymi i losowymi warto wyjaśnić jednym zdaniem, bez wykładu.
Dla hipotez drugorzędowych podaj rodzinę testów i metodę korekty. Bender i Lange (2001) przypominają, że korekty są potrzebne wtedy, gdy wyniki wielu testów łączysz w jeden wniosek, i że trzeba podać, który wskaźnik błędu kontrolujesz. W przykładzie trzy skale drugorzędowe tworzą jedną rodzinę z korektą Holma; H1 nie wymaga korekty, bo jest jedna. Zasady wyboru korekty znajdziesz w tekście poprawki na wielokrotne porównania i w haśle problem wielokrotnych porównań.
W badaniach interwencyjnych zdecyduj też, kogo analizujesz. Analiza główna według zasady ITT obejmuje wszystkie wylosowane klasy, niezależnie od tego, ile zajęć się odbyło. Analiza per protocol (np. uczniowie z co najmniej 6 z 8 sesji) może być analizą wrażliwości, ale nie główną.
Blok 4. Braki danych: zapobieganie, założenie, metoda
Braki pomiaru końcowego są w badaniach szkolnych pewne, więc ich pominięcie we wniosku to błąd. Opis ma trzy części. Najpierw zapobieganie: pomiar w czasie lekcji, termin uzupełniający, kontakt z wychowawcą. Potem założenie o mechanizmie (MCAR, MAR, MNAR) i zmienne pomocnicze, które zbierzesz, by założenie MAR było bardziej wiarygodne. Na końcu metoda: model mieszany na wszystkich dostępnych obserwacjach albo imputacja wielokrotna.
Przewodnik Jakobsena i in. (2017) pokazuje, kiedy w badaniu randomizowanym wystarczy analiza dostępnych danych, a kiedy potrzebna jest imputacja wielokrotna, i podkreśla, że ryzyko obciążenia zależy od mechanizmu braków. Nie pisz progów w rodzaju „przy brakach powyżej 5% zastosujemy imputację”. Madley-Dowd i in. (2019) pokazują w symulacjach, że sam odsetek braków jest złym przewodnikiem przy wyborze metody. Lepiej napisać, od czego zależy decyzja. Praktykę imputacji w R pokazujemy w poradniku braki danych i imputacja wielokrotna w R.
Na symulowanym zbiorze o liczebności z wniosku (próba generalna planu) pomiaru końcowego zabrakło u 128 z 880 uczniów (14.5%): 13.0% w klasach kontrolnych i 16.1% w klasach z programem. Osoby bez pomiaru końcowego miały na starcie wyższy lęk (M = 27.50) niż osoby z pomiarem (M = 24.74). To typowy obraz braków MAR względem pomiaru wyjściowego – i powód, by pomiar wyjściowy był w modelu.
Analiza główna na tym zbiorze dała skorygowaną różnicę −1.83 punktu, 95% CI [−2.99, −0.67], t(38) = −3.18, p = .003, co odpowiada d = −0.31. ICC reszt wyniósł .11, blisko założonego .10. Te liczby nie trafiają do wniosku, bo wniosek powstaje przed zebraniem danych. Próba generalna sprawdza tylko, czy plan da się wykonać od początku do końca i czy kod działa.
Blok 5. Analizy wrażliwości: co, jeśli założenia są błędne?
Analiza wrażliwości sprawdza, czy wnioski z analizy głównej przetrwają zmianę kluczowych założeń i decyzji: innej metody, innej definicji wyniku, odstępstw od protokołu, braków danych czy obserwacji odstających (Thabane i in., 2013). We wniosku wystarczą dwie lub trzy, każda z jednym zdaniem uzasadnienia. Wybierz te, które odpowiadają na najbardziej prawdopodobny zarzut recenzenta.
W badaniu interwencyjnym takim zarzutem jest prawie zawsze: „A jeśli uczniowie, którzy odpadli z programu, mieli gorsze wyniki?”. Założenia MAR nie da się sprawdzić na danych, więc planuje się analizę z przesunięciem δ. Brakujące wyniki imputuje się tak, jakby osoby, które odpadły, miały wynik o δ gorszy, niż przewiduje model, i szuka się wartości δ, przy której wniosek się zmienia (Cro i in., 2020). Taką wartość nazywa się punktem krytycznym (tipping point).
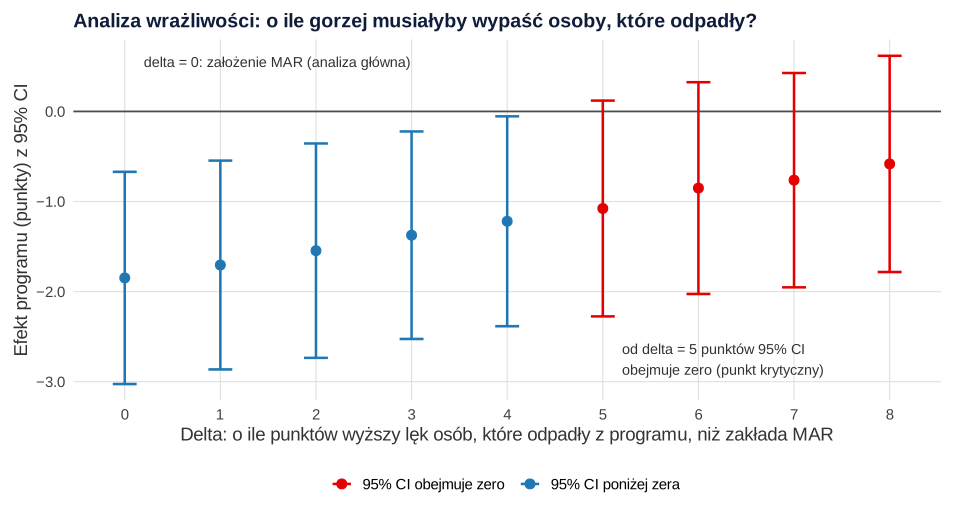
Przy δ = 0 imputacja odtwarza analizę główną: −1.85 punktu, 95% CI [−3.03, −0.67]. Przy δ = 4 efekt maleje do −1.22 [−2.39, −0.06], p = .041. Od δ = 5 punktów przedział obejmuje zero (−1.08 [−2.28, 0.12], p = .076). Pięć punktów to 0.83 SD wyniku – osoby, które odpadły z programu, musiałyby wypaść znacznie gorzej, niż przewiduje model. We wniosku nie podajesz tych liczb, tylko zapowiadasz procedurę i zakres δ. W raporcie końcowym ten jeden wykres odpowiada na najczęstszy zarzut wobec badań interwencyjnych.
Blok 6. Analizy eksploracyjne i odtwarzalność
Analizy eksploracyjne wymień z nazwy i oznacz jako eksploracyjne. Recenzent nie oczekuje, że niczego więcej nie sprawdzisz. Oczekuje, że nie przedstawisz potem eksploracji jako potwierdzenia hipotezy, czyli że unikniesz HARKingu. Analizy w podgrupach (płeć, typ szkoły) planuj jako testy interakcji, nie jako osobne testy w każdej podgrupie (zob. analiza podgrup).
W tym bloku zapowiedz też prerejestrację planu przed rekrutacją i udostępnienie kodu. Gamble i in. (2017) uzgodnili w procedurze delfickiej minimalny zestaw 55 elementów planu analizy statystycznej badania klinicznego. Wniosek nie musi ich zawierać, ale zdanie „przed rozpoczęciem rekrutacji przygotujemy i zarejestrujemy szczegółowy plan analizy statystycznej” pokazuje, że wiesz, co nastąpi po przyznaniu grantu.
Blok 7. Ryzyka i plan B
Kryterium „możliwości realizacji” w praktyce oznacza pytanie: co zrobisz, gdy coś pójdzie nie tak? Tabela ryzyk w metodyce zajmuje mniej miejsca niż akapity, a recenzent szybko ją przeczyta.
| Ryzyko | Skutek dla analizy | Działanie |
|---|---|---|
| Mniej szkół niż planowano | Spadek mocy: 16 klas na grupę to moc .75 przy ICC = .10 | Rezerwowa lista szkół, rekrutacja od pierwszego miesiąca, losowanie dopiero po zebraniu zgód |
| ICC wyższy niż założony | Moc .73 przy ICC = .15 | Losowanie warstwowe według szkoły, kowarianta wyjściowa, raport ICC z przedziałem ufności |
| Odpadanie powyżej 15% | Mniejsza moc i ryzyko obciążenia (MNAR) | Pomiar w czasie lekcji, termin uzupełniający, analiza δ z bloku 5 |
| Program realizowany niezgodnie z protokołem | Rozmycie efektu | Szkolenie prowadzących, listy obecności, ocena adherencji, analiza per protocol |
| Efekt mniejszy niż SESOI | Wynik nieistotny trudny do interpretacji | Raport efektu z 95% CI; test równoważności względem SESOI jako analiza dodatkowa |
Ostatni wiersz bywa pomijany, a recenzenci lubią go widzieć. Test równoważności pozwala odrzucić efekt co najmniej tak duży jak SESOI i stwierdzić brak efektu o praktycznym znaczeniu (Lakens i in., 2018). Projekt z takim planem daje użyteczny wynik niezależnie od kierunku, a o to chodzi w ocenie znaczenia badań.
Wzór tekstu do metodyki wniosku
Poniżej wersja do szczegółowego opisu projektu. Zastąp liczby i źródła własnymi. Jeśli wniosek piszesz po angielsku, zachowaj tę samą kolejność zdań. Cały szablon z przykładem, tabelą hipotez i tabelą ryzyk możesz pobrać jako plik Word (plan-analiz-wniosek-grantowy-wzor.docx).
Jeśli chcesz, żeby ktoś z zewnątrz sprawdził założenia mocy, policzył symulację dla Twojego schematu albo przeczytał metodykę oczami recenzenta, zajrzyj do oferty dla badaczy. Sam wniosek i jego treść pozostają Twoje – konsultacja dotyczy obliczeń i spójności planu.
Plan analiz w R: symulacja mocy i analiza wrażliwości
Kod odtwarza wszystkie liczby z tekstu, tabel i rysunków. Przepis 1 liczy liczebność wzorem i symulacją (ok. 2 minut), przepis 2 to próba generalna planu na jednym symulowanym zbiorze: opis braków, analiza główna i analiza z przesunięciem δ. Model mieszany liczy pakiet lme4. Symulację łatwo przerobić na własny schemat: zmień funkcję symuluj_dane() i parametry na początku przepisu 1.
1. Liczebność: efekt schematu i symulacja mocy (rysunek 1)
R
# B75 – przepis 1: liczebność do wniosku grantowego w badaniu z randomizacją klas
# Wpis: /blog/plan-analiz-do-wniosku-grantowego/ (sekcja „Liczebność” i rysunek 1)
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b75-1-moc-klasy.R
# Projekt przykładowy (dane symulowane): program redukcji lęku egzaminacyjnego w szkołach średnich.
# Losujemy klasy (nie uczniów) do programu albo do grupy kontrolnej z odroczonym udziałem.
# Wynik pierwszorzędowy: lęk egzaminacyjny po programie (skala 10–40, SD ok. 6), kowarianta: pomiar wyjściowy.
suppressPackageStartupMessages(library(lme4))

# Założenia planu (każde trzeba uzasadnić we wniosku)
sesoi_d <- 0.30        # najmniejszy efekt wart wdrożenia, w jednostkach SD
sd_pkt  <- 6           # SD wyniku w punktach skali
r_pp    <- 0.60        # korelacja pomiaru wyjściowego z końcowym
m       <- 22          # uczniów w klasie
odpad   <- 0.15        # odsetek uczniów bez pomiaru końcowego
icc     <- 0.10        # ICC wyniku (scenariusz główny)
c(SESOI_punkty = sesoi_d * sd_pkt)

# 1. Przybliżenie wzorem: ANCOVA na poziomie ucznia × efekt schematu (design effect)
sd_res <- sqrt(1 - r_pp^2)                                   # SD reszt po uwzględnieniu pomiaru wyjściowego
n_ind  <- power.t.test(delta = sesoi_d, sd = sd_res, power = .80)$n   # uczniów na grupę bez klastrów
m_ef   <- m * (1 - odpad)                                    # uczniów z pomiarem końcowym w klasie
de     <- function(icc) 1 + (m_ef - 1) * icc
klasy_wzor <- sapply(c(icc05 = .05, icc10 = .10, icc15 = .15), function(i) ceiling(n_ind * de(i) / m_ef))
round(c(n_bez_klastrow = n_ind, m_efektywne = m_ef, DE_icc10 = de(.10)), 2)
klasy_wzor                                                   # klas na grupę według wzoru

# 2. Symulacja: model mieszany, który naprawdę planujemy we wniosku
#    wynik_po ~ grupa + wynik_przed + (1 | klasa); test efektu grupy z df = K − 2 (ostrożnie, poziom klas)
symuluj_dane <- function(K, icc, d, m = 22, odpad = .15, r = .60) {
  klasa <- rep(seq_len(K), each = m)
  grupa <- rep(rep(0:1, length.out = K), each = m)           # połowa klas w programie
  a <- rnorm(K, 0, sqrt(icc))[klasa]                         # różnice między klasami na starcie
  przed <- a + rnorm(K * m, 0, sqrt(1 - icc))
  u <- rnorm(K, 0, sqrt(icc * (1 - r^2)))[klasa]
  po <- r * przed + u + rnorm(K * m, 0, sqrt((1 - icc) * (1 - r^2))) - d * grupa  # program obniża lęk
  dane <- data.frame(klasa = factor(klasa), grupa, przed = 25 + sd_pkt * przed, po = 25 + sd_pkt * po)
  dane$po[runif(K * m) < odpad] <- NA                        # odpadanie (tu: losowe)
  dane
}
p_grupy <- function(dane, K) {
  fit <- suppressMessages(lmer(po ~ grupa + przed + (1 | klasa), data = dane,
                               control = lmerControl(calc.derivs = FALSE)))
  t <- coef(summary(fit))["grupa", "t value"]
  2 * pt(-abs(t), df = K - 2)
}
moc <- function(K, icc, d = sesoi_d, R = 500) mean(replicate(R, p_grupy(symuluj_dane(K, icc, d), K)) < .05)

set.seed(7501)
siatka <- expand.grid(K = c(16, 24, 32, 40, 48, 56), icc = c(.05, .10, .15))
siatka$moc <- mapply(moc, siatka$K, siatka$icc)
siatka$K_na_grupe <- siatka$K / 2
print(siatka, row.names = FALSE)

# 3. Fałszywe alarmy przy braku efektu (czy test trzyma α = .05?) i błąd analizy na poziomie ucznia
set.seed(7502)
p_zle <- function(dane) {                                    # błąd: lm bez klas, jakby uczniowie byli niezależni
  fit <- lm(po ~ grupa + przed, data = dane)
  coef(summary(fit))["grupa", "Pr(>|t|)"]
}
H0 <- replicate(1000, { d0 <- symuluj_dane(40, .10, 0); c(model_mieszany = p_grupy(d0, 40), lm_bez_klas = p_zle(d0)) })
round(rowMeans(H0 < .05), 3)

saveRDS(siatka, "b75-1-moc.rds")
Wynik w R
SESOI_punkty
         1.8
n_bez_klastrow    m_efektywne       DE_icc10
        112.60          18.70           2.77
icc05 icc10 icc15
   12    17    23
  K  icc   moc K_na_grupe
 16 0.05 0.594          8
 24 0.05 0.784         12
 32 0.05 0.884         16
 40 0.05 0.948         20
 48 0.05 0.978         24
 56 0.05 0.990         28
 16 0.10 0.446          8
 24 0.10 0.620         12
 32 0.10 0.748         16
 40 0.10 0.838         20
 48 0.10 0.894         24
 56 0.10 0.940         28
 16 0.15 0.342          8
 24 0.15 0.510         12
 32 0.15 0.630         16
 40 0.15 0.730         20
 48 0.15 0.832         24
 56 0.15 0.878         28
model_mieszany    lm_bez_klas
         0.054          0.248
2. Próba generalna: braki danych i analiza z przesunięciem δ (rysunek 2)
R
# B75 – przepis 2: analiza główna i zaplanowana analiza wrażliwości na braki danych (delta, punkt krytyczny)
# Wpis: /blog/plan-analiz-do-wniosku-grantowego/ (sekcja „Braki danych i wrażliwość” i rysunek 2)
# Uruchomienie z folderu kod/: LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b75-2-wrazliwosc-braki.R
# Próba generalna planu: jeden symulowany zbiór o liczebności z wniosku (40 klas po 22 uczniów, ICC = .10).
# Odpadanie zależy od lęku na starcie (MAR względem pomiaru wyjściowego) i jest częstsze w grupie programu.
suppressPackageStartupMessages(library(lme4))
set.seed(7503)
K <- 40; m <- 22; icc <- .10; r <- .60; sd_pkt <- 6
klasa <- rep(seq_len(K), each = m)
grupa <- rep(rep(0:1, length.out = K), each = m)
a <- rnorm(K, 0, sqrt(icc))[klasa]
z_przed <- a + rnorm(K * m, 0, sqrt(1 - icc))
u <- rnorm(K, 0, sqrt(icc * (1 - r^2)))[klasa]
z_po <- r * z_przed + u + rnorm(K * m, 0, sqrt((1 - icc) * (1 - r^2))) - 0.35 * grupa
dane <- data.frame(klasa = factor(klasa), grupa, przed = round(25 + sd_pkt * z_przed),
                   po = round(25 + sd_pkt * z_po))
dane[c("przed", "po")] <- lapply(dane[c("przed", "po")], function(x) pmin(40, pmax(10, x)))
p_brak <- plogis(-2.0 + 0.4 * z_przed + 0.3 * grupa)          # wyższy lęk na starcie -> częściej brak pomiaru
dane$po[runif(K * m) < p_brak] <- NA

# Opis braków: ile i u kogo
c(N = nrow(dane), braki = sum(is.na(dane$po)), odsetek = round(100 * mean(is.na(dane$po)), 1))
round(100 * tapply(is.na(dane$po), dane$grupa, mean), 1)       # % braków: 0 = kontrola, 1 = program
round(tapply(dane$przed, is.na(dane$po), mean), 2)             # lęk na starcie: FALSE = jest pomiar, TRUE = brak

# Analiza główna (zgodnie z planem): model mieszany ANCOVA na dostępnych danych (FIML/REML zakłada MAR)
fit <- lmer(po ~ grupa + przed + (1 | klasa), data = dane)
b <- unname(fixef(fit)["grupa"]); se <- sqrt(vcov(fit)["grupa", "grupa"])
round(c(b = b, SE = se, CI_dolna = b - qt(.975, K - 2) * se, CI_gorna = b + qt(.975, K - 2) * se,
        t = b / se, p = 2 * pt(-abs(b / se), K - 2)), 3)
vc <- as.data.frame(VarCorr(fit))
round(c(ICC_reszt = vc$vcov[1] / sum(vc$vcov), d = b / sd(dane$po, na.rm = TRUE)), 3)

# Analiza wrażliwości: imputacja wielokrotna z przesunięciem delta w grupie programu
# (osoby, które odpadły z programu, mają lęk o delta punktów wyższy, niż przewiduje model MAR)
imputuj <- function(dane, delta, M = 30) {
  obs <- dane[!is.na(dane$po), ]
  mi <- lmer(po ~ grupa + przed + (1 | klasa), data = obs)
  braki <- is.na(dane$po)
  X <- model.matrix(~ grupa + przed, dane[braki, ])
  re <- ranef(mi)$klasa[as.character(dane$klasa[braki]), 1]
  wyn <- t(replicate(M, {
    beta <- MASS::mvrnorm(1, fixef(mi), as.matrix(vcov(mi)))   # niepewność parametrów modelu imputacji
    d <- dane
    d$po[braki] <- X %*% beta + re + rnorm(sum(braki), 0, sigma(mi)) + delta * d$grupa[braki]
    f <- lmer(po ~ grupa + przed + (1 | klasa), data = d)
    c(unname(fixef(f)["grupa"]), vcov(f)["grupa", "grupa"])
  }))
  q <- mean(wyn[, 1]); W <- mean(wyn[, 2]); B <- var(wyn[, 1]); Tv <- W + (1 + 1 / M) * B   # reguły Rubina
  c(delta = delta, b = q, SE = sqrt(Tv), CI_dolna = q - qt(.975, K - 2) * sqrt(Tv),
    CI_gorna = q + qt(.975, K - 2) * sqrt(Tv), p = 2 * pt(-abs(q / sqrt(Tv)), K - 2))
}
set.seed(7504)
wrazliwosc <- as.data.frame(t(sapply(seq(0, 8, by = 1), function(dl) imputuj(dane, dl))))
print(round(wrazliwosc, 3), row.names = FALSE)
punkt_krytyczny <- wrazliwosc$delta[which(wrazliwosc$CI_gorna >= 0)[1]]
c(punkt_krytyczny_delta = punkt_krytyczny, w_SD = round(punkt_krytyczny / sd_pkt, 2))

saveRDS(list(dane = dane, wrazliwosc = wrazliwosc, b = b, se = se), "b75-2-wrazliwosc.rds")
Wynik w R
      N   braki odsetek
  880.0   128.0    14.5
   0    1
13.0 16.1
FALSE  TRUE
24.74 27.50
       b       SE CI_dolna CI_gorna        t        p
  -1.830    0.575   -2.994   -0.667   -3.184    0.003
ICC_reszt         d
    0.110    -0.314
 delta      b    SE CI_dolna CI_gorna     p
     0 -1.848 0.582   -3.026   -0.671 0.003
     1 -1.705 0.573   -2.864   -0.546 0.005
     2 -1.546 0.588   -2.736   -0.356 0.012
     3 -1.374 0.569   -2.526   -0.223 0.021
     4 -1.220 0.575   -2.385   -0.055 0.041
     5 -1.078 0.592   -2.275    0.120 0.076
     6 -0.851 0.581   -2.026    0.324 0.151
     7 -0.763 0.588   -1.952    0.426 0.202
     8 -0.583 0.593   -1.783    0.617 0.332
punkt_krytyczny_delta                  w_SD
                 5.00                  0.83
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje power.t.test() i pt() z pakietu stats); rysunki przygotowano w ggplot2, a plik Word w pakietach officer i flextable. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- officer (wersja 0.7.4): Gohel, D., Moog, S., & Heckmann, M. (2026). officer: Manipulation of Microsoft Word and PowerPoint documents (R package version 0.7.4) [Computer software]. https://doi.org/10.32614/CRAN.package.officer
- flextable (wersja 0.9.11): Gohel, D., & Skintzos, P. (2026). flextable: Functions for tabular reporting (R package version 0.9.11) [Computer software]. https://doi.org/10.32614/CRAN.package.flextable
Najczęstsze błędy w planie analiz do wniosku
- Liczebność bez parametrów. „Moc .80 wymaga 200 osób” bez wielkości efektu, ICC, korelacji i odsetka odpadnięć nie da się sprawdzić, więc recenzent nie może ocenić wykonalności.
- Efekt z małego pilotażu. Oszacowanie z kilkunastu osób jest bardzo niepewne i prowadzi zwykle do zbyt małej próby (Albers i Lakens, 2018).
- Ignorowanie klastrów. Losujesz klasy, a liczysz uczniów jak niezależne obserwacje. W naszej symulacji odsetek fałszywych alarmów wzrósł z 5.4% do 24.8%.
- Lista testów zamiast modelu. „Zastosujemy test t, ANOVA, korelację Pearsona i regresję” nie mówi, którą hipotezę sprawdza który test.
- Brak hierarchii hipotez. Pięć równorzędnych hipotez głównych to pięć analiz mocy albo korekta, której nikt nie zaplanował.
- Braki danych jednym zdaniem. „Braki zostaną usunięte” w badaniu z 15% odpadnięć to sygnał, że autor nie zna konsekwencji.
- Obietnica analiz, na które nie ma mocy. Interakcje, mediacje i podgrupy opisane jako konfirmacyjne przy liczebności liczonej dla efektu głównego.
- Liczebność oderwana od kosztorysu. 40 klas w metodyce i budżet na 20 szkół z jedną klasą to sprzeczność, którą recenzent zauważy.
- Wymogi konkursu „z pamięci”. Limity stron i układ wniosku zmieniają się między edycjami. Sprawdź je w aktualnej dokumentacji.
Lista kontrolna przed złożeniem wniosku
- Każda hipoteza ma przypisany wynik, model i kryterium wnioskowania.
- Jedna hipoteza (lub mała rodzina) jest główna i to ona wyznacza liczebność.
- SESOI ma uzasadnienie merytoryczne, a nie „średni efekt według Cohena”.
- Parametry analizy mocy (SD, korelacje, ICC, odpadanie) mają źródła.
- Moc podano także dla scenariusza pesymistycznego.
- Model główny uwzględnia schemat badania (klastry, pomiary powtarzane).
- Opisano korekty dla hipotez drugorzędowych.
- Braki danych: zapobieganie, założenie i metoda.
- Zaplanowano 2–3 analizy wrażliwości odpowiadające na najbardziej prawdopodobne zarzuty.
- Analizy eksploracyjne są nazwane i oznaczone.
- Liczebność zgadza się z harmonogramem i kosztorysem.
- Limity stron, język i wymagane części wniosku sprawdzono w aktualnej dokumentacji konkursu.
Badania z wieloma pomiarami w czasie mają własne decyzje projektowe (liczba fal, odstępy, odpadanie); omawiamy je w tekście badanie podłużne w doktoracie.
Najczęstsze pytania
Ile miejsca poświęcić analizie statystycznej we wniosku grantowym?
Tyle, ile trzeba, by inny statystyk mógł powtórzyć analizę główną i ocenić liczebność. W krótkim opisie zwykle wystarczą 2–4 zdania (schemat, liczebność z uzasadnieniem, model główny), w opisie szczegółowym – hipotezy z modelami, analiza mocy, braki danych, analizy wrażliwości i ryzyka. Limity stron sprawdź w aktualnej dokumentacji konkursu, bo różnią się między konkursami i edycjami.
Jak uzasadnić liczebność próby we wniosku grantowym?
Podaj najmniejszy efekt, który ma praktyczne znaczenie (SESOI), wszystkie parametry obliczeń ze źródłami (SD, korelacje, ICC, odsetek odpadnięć), metodę (wzór albo symulacja zaplanowanego modelu) i moc dla scenariusza pesymistycznego. Nie opieraj efektu na małym pilotażu, bo takie oszacowania prowadzą zwykle do zbyt małych prób (Albers i Lakens, 2018).
Czy we wniosku grantowym trzeba planować analizę wrażliwości?
Warto, zwłaszcza w badaniach interwencyjnych. Wystarczą dwie lub trzy analizy odpowiadające na najbardziej prawdopodobne zarzuty, np. imputacja z przesunięciem δ dla osób, które odpadły, model bez kowariant i analiza per protocol. Recenzent widzi wtedy, że wniosek z projektu nie zależy od jednego, niesprawdzalnego założenia.
Jak policzyć moc, gdy losuje się klasy albo szkoły, a nie osoby?
Najprościej pomnożyć liczebność dla losowania osób przez efekt schematu DE = 1 + (m − 1) × ICC. Dokładniej – zasymulować dane i policzyć na nich model mieszany, który zastosujesz. W przykładzie na tej stronie wzór obiecywał moc .80 przy 17 klasach na grupę, a symulacja dla 16 klas dała .75, dlatego plan zakłada 20 klas na grupę.
Czym różni się plan analiz we wniosku od planu analizy statystycznej (SAP)?
Plan we wniosku jest krótki i ma przekonać o wykonalności: hipotezy, liczebność, model główny, braki, wrażliwość i ryzyka. SAP powstaje przed zebraniem danych i rozpisuje wszystko szczegółowo, od kodowania zmiennych po reguły wykluczeń. Wzór SAP i prerejestrację opisujemy w poradniku plan analizy statystycznej i prerejestracja.
Powiązane hasła
Przeczytaj też
Plan analizy statystycznej i prerejestracja
12 elementów planu analizy, moc i SESOI w R, OSF czy AsPredicted, registered reports, tabela odstępstw i wzór planu w Wordzie do pobrania.
Czytaj →PoradnikAnaliza statystyczna w doktoracie
Seria badań z uzasadnioną liczebnością, harmonogram zgodny z IPB i oceną śródokresową, cykl publikacji bez salami slicing, dane, etyka i autorstwo.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →Piszesz wniosek i nie masz pewności, czy liczebność się obroni?
Sprawdzimy założenia analizy mocy, policzymy symulację dla Twojego schematu i przeczytamy plan analiz oczami recenzenta, a Ty zachowasz pełną kontrolę nad treścią wniosku.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Albers, C., & Lakens, D. (2018). When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias. Journal of Experimental Social Psychology, 74, 187–195. https://doi.org/10.1016/j.jesp.2017.09.004 ● Otwarty dostęp
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Arnold, B. F., Hogan, D. R., Colford, J. M., & Hubbard, A. E. (2011). Simulation methods to estimate design power: An overview for applied research. BMC Medical Research Methodology, 11(1), Article 94. https://doi.org/10.1186/1471-2288-11-94 ● Otwarty dostęp
- Bender, R., & Lange, S. (2001). Adjusting for multiple testing—When and how? Journal of Clinical Epidemiology, 54(4), 343–349. https://doi.org/10.1016/S0895-4356(00)00314-0
- Cro, S., Morris, T. P., Kenward, M. G., & Carpenter, J. R. (2020). Sensitivity analysis for clinical trials with missing continuous outcome data using controlled multiple imputation: A practical guide. Statistics in Medicine, 39(21), 2815–2842. https://doi.org/10.1002/sim.8569 ● Otwarty dostęp
- Gamble, C., Krishan, A., Stocken, D., Lewis, S., Juszczak, E., Doré, C., Williamson, P. R., Altman, D. G., Montgomery, A., Lim, P., Berlin, J., Senn, S., Day, S., Barbachano, Y., & Loder, E. (2017). Guidelines for the content of statistical analysis plans in clinical trials. JAMA, 318(23), 2337–2343. https://doi.org/10.1001/jama.2017.18556 ● Otwarty dostęp
- Jakobsen, J. C., Gluud, C., Wetterslev, J., & Winkel, P. (2017). When and how should multiple imputation be used for handling missing data in randomised clinical trials – A practical guide with flowcharts. BMC Medical Research Methodology, 17(1), Article 162. https://doi.org/10.1186/s12874-017-0442-1 ● Otwarty dostęp
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), Article 33267. https://doi.org/10.1525/collabra.33267 ● Otwarty dostęp
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963 ● Otwarty dostęp
- Madley-Dowd, P., Hughes, R., Tilling, K., & Heron, J. (2019). The proportion of missing data should not be used to guide decisions on multiple imputation. Journal of Clinical Epidemiology, 110, 63–73. https://doi.org/10.1016/j.jclinepi.2019.02.016 ● Otwarty dostęp
- Narodowe Centrum Nauki. (2020). Wytyczne dla wnioskodawców do uzupełnienia planu zarządzania danymi w projekcie badawczym. https://www.ncn.gov.pl/sites/default/files/pliki/regulaminy/wytyczne_zarzadzanie_danymi_06_2020.pdf ● Otwarty dostęp
- Narodowe Centrum Nauki. (2026, 16 marca). PRELUDIUM 25 [ogłoszenie konkursu]. https://www.ncn.gov.pl/ogloszenia/konkursy/preludium25 ● Otwarty dostęp
- Sommet, N., Weissman, D. L., Cheutin, N., & Elliot, A. J. (2023). How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction. Advances in Methods and Practices in Psychological Science, 6(3), Article 25152459231178728. https://doi.org/10.1177/25152459231178728 ● Otwarty dostęp
- Thabane, L., Mbuagbaw, L., Zhang, S., Samaan, Z., Marcucci, M., Ye, C., Thabane, M., Giangregorio, L., Dennis, B., Kosa, D., Borg Debono, V., Dillenburg, R., Fruci, V., Bawor, M., Lee, J., Wells, G., & Goldsmith, C. H. (2013). A tutorial on sensitivity analyses in clinical trials: The what, why, when and how. BMC Medical Research Methodology, 13(1), Article 92. https://doi.org/10.1186/1471-2288-13-92 ● Otwarty dostęp
Cytowania BibTeX
@article{albers2018power, author={Albers, Casper and Lakens, Daniël}, title={{When power analyses based on pilot data are biased: Inaccurate effect size estimators and follow-up bias}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={74}, pages={187--195}, doi={10.1016/j.jesp.2017.09.004}}@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{arnold2011simulation, author={Arnold, Benjamin F. and Hogan, Daniel R. and Colford, John M. and Hubbard, Alan E.}, title={{Simulation methods to estimate design power: An overview for applied research}}, journal={BMC Medical Research Methodology}, year={2011}, volume={11}, number={1}, eid={94}, doi={10.1186/1471-2288-11-94}}@article{bender2001adjusting, author={Bender, Ralf and Lange, Stefan}, title={{Adjusting for multiple testing—When and how?}}, journal={Journal of Clinical Epidemiology}, year={2001}, volume={54}, number={4}, pages={343--349}, doi={10.1016/s0895-4356(00)00314-0}}@article{cro2020sensitivity, author={Cro, Suzie and Morris, Tim P. and Kenward, Michael G. and Carpenter, James R.}, title={{Sensitivity analysis for clinical trials with missing continuous outcome data using controlled multiple imputation: A practical guide}}, journal={Statistics in Medicine}, year={2020}, volume={39}, number={21}, pages={2815--2842}, doi={10.1002/sim.8569}}@article{gamble2017guidelines, author={Gamble, Carrol and Krishan, Ashma and Stocken, Deborah and Lewis, Steff and Juszczak, Edmund and Doré, Caroline and Williamson, Paula R. and Altman, Douglas G. and Montgomery, Alan and Lim, Pilar and Berlin, Jesse and Senn, Stephen and Day, Simon and Barbachano, Yolanda and Loder, Elizabeth}, title={{Guidelines for the content of statistical analysis plans in clinical trials}}, journal={JAMA}, year={2017}, volume={318}, number={23}, pages={2337--2343}, doi={10.1001/jama.2017.18556}}@article{jakobsen2017when, author={Jakobsen, Janus Christian and Gluud, Christian and Wetterslev, Jørn and Winkel, Per}, title={{When and how should multiple imputation be used for handling missing data in randomised clinical trials – A practical guide with flowcharts}}, journal={BMC Medical Research Methodology}, year={2017}, volume={17}, number={1}, eid={162}, doi={10.1186/s12874-017-0442-1}}@article{lakens2022sample, author={Lakens, Daniël}, title={{Sample size justification}}, journal={Collabra: Psychology}, year={2022}, volume={8}, number={1}, eid={33267}, doi={10.1525/collabra.33267}}@article{lakens2018equivalence, author={Lakens, Daniël and Scheel, Anne M. and Isager, Peder M.}, title={{Equivalence testing for psychological research: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2018}, volume={1}, number={2}, pages={259--269}, doi={10.1177/2515245918770963}}@article{madleydowd2019proportion, author={Madley-Dowd, Paul and Hughes, Rachael and Tilling, Kate and Heron, Jon}, title={{The proportion of missing data should not be used to guide decisions on multiple imputation}}, journal={Journal of Clinical Epidemiology}, year={2019}, volume={110}, pages={63--73}, doi={10.1016/j.jclinepi.2019.02.016}}@techreport{ncn2020plandanych, author={{Narodowe Centrum Nauki}}, title={{Wytyczne dla wnioskodawców do uzupełnienia planu zarządzania danymi w projekcie badawczym}}, year={2020}, institution={Narodowe Centrum Nauki}, url={https://www.ncn.gov.pl/sites/default/files/pliki/regulaminy/wytyczne_zarzadzanie_danymi_06_2020.pdf}}@misc{ncn2026preludium25, author={{Narodowe Centrum Nauki}}, title={{PRELUDIUM 25 [ogłoszenie konkursu]}}, year={2026}, url={https://www.ncn.gov.pl/ogloszenia/konkursy/preludium25}}@article{sommet2023how, author={Sommet, Nicolas and Weissman, David L. and Cheutin, Nicolas and Elliot, Andrew J.}, title={{How many participants do I need to test an interaction? Conducting an appropriate power analysis and achieving sufficient power to detect an interaction}}, journal={Advances in Methods and Practices in Psychological Science}, year={2023}, volume={6}, number={3}, eid={25152459231178728}, doi={10.1177/25152459231178728}}@article{thabane2013tutorial, author={Thabane, Lehana and Mbuagbaw, Lawrence and Zhang, Shiyuan and Samaan, Zainab and Marcucci, Maura and Ye, Chenglin and Thabane, Marroon and Giangregorio, Lora and Dennis, Brittany and Kosa, Daisy and Borg Debono, Victoria and Dillenburg, Rejane and Fruci, Vincent and Bawor, Monica and Lee, Juneyoung and Wells, George and Goldsmith, Charles H.}, title={{A tutorial on sensitivity analyses in clinical trials: The what, why, when and how}}, journal={BMC Medical Research Methodology}, year={2013}, volume={13}, number={1}, eid={92}, doi={10.1186/1471-2288-13-92}}