Zmiana jako zmienna latentna
Masz kilka pomiarów tych samych osób i pytasz nie tylko o to, jak szybko rośnie wynik, ale też od czego zależy tempo zmiany. Czy dzieci z bogatszym słownictwem przyrastają wolniej, bo zbliżają się do pułapu? Czy wysoki poziom jednej umiejętności przyspiesza zmianę drugiej? Krzywa wzrostu opisuje kształt trajektorii funkcją czasu. Latentny model zmiany (ang. latent change score model, LCS) zaczyna od drugiej strony: od samej zmiany między kolejnymi pomiarami.
Prosty wynik różnicowy xt − xt−1 zawiera błąd pomiaru z obu pomiarów. W LCS każdy pomiar ma zmienną latentną – wynik prawdziwy ηt – a zmiana Δηt = ηt − ηt−1 jest osobną zmienną latentną, wolną od tego błędu. McArdle (2009) pokazuje, że w ten sposób modele SEM dla danych podłużnych mogą bezpośrednio pytać o różnice i zmiany, a nie tylko o poziomy. Skoro zmiana jest zmienną, można ją przewidywać: poprzednim poziomem, stałą cechą osoby albo poziomem innej zmiennej.
Wpis zakłada, że znasz krzywe wzrostu (LGM) w lavaan i podstawy składni lavaan. O planowaniu liczby pomiarów i odstępów piszemy we wpisie badanie podłużne w doktoracie. Tu pokazujemy, jak zbudować LCS jedno- i dwuwymiarowy, jak czytać jego parametry i kiedy wybrać go zamiast LGM.
Zmiana stała i zmiana proporcjonalna
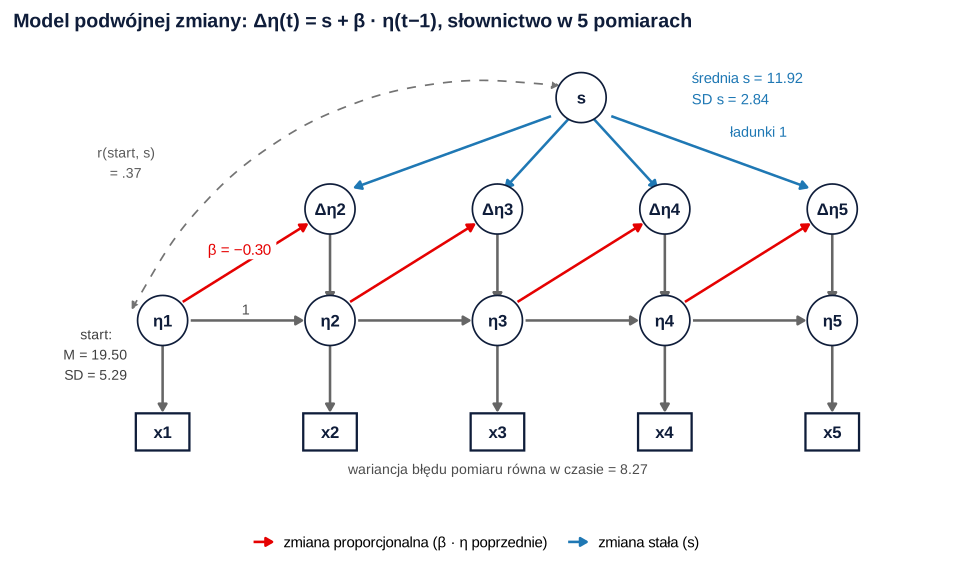
Podstawowy model tej rodziny to model podwójnej zmiany (dual change score). Zmiana w każdym kroku ma dwie składowe:
- zmiana stała s – czynnik latentny o średniej i wariancji, ten sam u danej osoby w każdym kroku; odpowiada „tempu” z liniowej krzywej wzrostu;
- zmiana proporcjonalna β · ηt−1 – część zmiany zależna od poprzedniego poziomu, z jednym współczynnikiem β dla całej próby.
Znak β decyduje o kształcie trajektorii. Przy β < 0 osoby z wyższym poziomem przyrastają mniej, więc wzrost zwalnia i średnia zbliża się do asymptoty −μs/β. Przy β > 0 zmiana przyspiesza. Przy β = 0 zostaje sama zmiana stała, czyli liniowa krzywa wzrostu. Rysunek 1 pokazuje cały model dla pięciu pomiarów.
Przykład: słownictwo i rozumienie tekstu
400 dzieci badano co roku od klasy 1 do 5 testem słownictwa (x) i testem rozumienia czytanego tekstu (y). Dane są symulowane (set.seed(3461)) z modelu o znanych parametrach. Dzięki temu na końcu sprawdzimy, czy model je odzyskuje. Dane możesz pobrać jako plik CSV (400 wierszy, 10 kolumn).
Już średnie sugerują różne procesy. Przyrosty słownictwa maleją: 6.00, 4.45, 3.07 i 1.79 punktu. Przyrosty rozumienia tekstu są prawie stałe: od 4.19 do 3.65. Pytanie badawcze brzmi: czy słownictwo zwalnia, bo dzieci zbliżają się do pułapu, i czy poziom słownictwa wiąże się z późniejszą zmianą rozumienia tekstu?
Krok 1. Jednowymiarowy LCS w lavaan
Model zapisujemy w pakiecie lavaan (Rosseel, 2012) funkcją lavaan(), a nie sem(). lavaan() nie dodaje żadnych parametrów domyślnie, więc wszystko, co szacujesz, widać w składni. Ghisletta i McArdle (2012) pokazują ten sam typ modeli w lavaan i OpenMx, a Kievit i in. (2018) udostępniają gotowe skrypty. Składnię dla dowolnej liczby pomiarów generuje funkcja z przepisu 2. Najważniejsze elementy są cztery:
lx1 =~ 1*x1– wynik prawdziwy w każdym pomiarze, z ładunkiem 1;lx2 ~ 1*lx1idx2 =~ 1*lx2– η2 = η1 + Δη2, przy wariancji i średniej η2 ustalonych na 0;dx2 ~ b_x*lx1– zmiana proporcjonalna; ta sama etykietab_xw każdym kroku narzuca równość β w czasie;sx =~ 1*dx2 + 1*dx3 + …– czynnik zmiany stałej z ładunkami 1, z szacowaną średnią, wariancją i kowariancją ze startem.
Wariancje błędu pomiaru są równe w czasie (etykieta e_x). Wariancja zmian latentnych jest ustalona na 0, więc cała zmienność zmiany pochodzi z s i z poziomu. Przy pięciu pomiarach mamy 20 momentów (5 średnich i 15 wariancji i kowariancji), a model ma 7 parametrów. Zostaje 13 stopni swobody (zob. identyfikacja modelu SEM).
Dopasowujemy cztery modele zagnieżdżone: bez zmiany, tylko ze zmianą stałą, tylko z proporcjonalną i podwójnej zmiany. Dla porównania dochodzą dwie krzywe wzrostu.
| Model | Parametry | χ² (df) | CFI | RMSEA | BIC |
|---|---|---|---|---|---|
| Brak zmiany | 3 | 2486.42 (17) | .000 | .603 | 14160.40 |
| Tylko zmiana stała | 6 | 325.81 (14) | .822 | .236 | 12017.76 |
| Tylko zmiana proporcjonalna | 4 | 651.77 (16) | .638 | .315 | 12331.74 |
| Podwójna zmiana | 7 | 20.61 (13) | .996 | .038 | 11718.56 |
| LGM liniowa | 6 | 325.81 (14) | .822 | .236 | 12017.76 |
| LGM kwadratowa | 10 | 13.30 (10) | .998 | .029 | 11729.22 |
Model podwójnej zmiany pasuje dobrze, χ²(13) = 20.61, p = .081, RMSEA = .038. Test różnicy chi-kwadrat względem modelu tylko ze zmianą stałą daje Δχ²(1) = 305.20, p < .001. Zmiana proporcjonalna jest więc potrzebna.
Krok 2. Interpretacja parametrów
W modelu podwójnej zmiany β = −0.299, 95% CI [−0.326, −0.271]. Każdy punkt poziomu w poprzedniej klasie wiąże się z przyrostem mniejszym o około 0.3 punktu. Średnia zmiany stałej wyniosła 11.92, 95% CI [11.12, 12.72], a jej SD 2.84. Średni start to 19.50 (SD = 5.29). Przewidywane średnie zmiany latentne maleją z klasy na klasę: 6.10, 4.28, 3.00 i 2.10. Średnia trajektoria dąży do asymptoty −11.92 / (−0.299) = 39.92 punktu.
Nie czytaj s jak nachylenia z krzywej liniowej. W modelu podwójnej zmiany s to składowa zmiany, która działa razem z β. Średnia 11.92 nie jest przeciętnym rocznym przyrostem, bo ten wynosił od 6.10 do 2.10. Podobnie korelacja startu z s (r = .37) nie oznacza, że dzieci z wyższym startem szybciej rosną. Przy β < 0 ich całkowita zmiana jest mniejsza, bo wyższy poziom „zjada” część przyrostu. Pytania o całkowitą zmianę odczytuj z przewidywanych trajektorii.
Model odzyskał parametry symulacji: β = −0.30, średnia zmiany stałej 12, start 20, SD zmiany stałej 3, korelacja .30. Wariancja błędu pomiaru wyniosła 8.27, 95% CI [7.61, 8.93], przy prawdziwej wartości 9. To ta część wariancji, którą zwykły wynik różnicowy liczyłby jako zmianę (zob. standardowy błąd pomiaru).
LCS a krzywa wzrostu (LGM)
Model tylko ze zmianą stałą to dokładnie liniowa krzywa wzrostu. Oba modele mają ten sam χ²(14) = 325.81 i tę samą log-wiarygodność, −5990.907. Różnicę robi dopiero β.
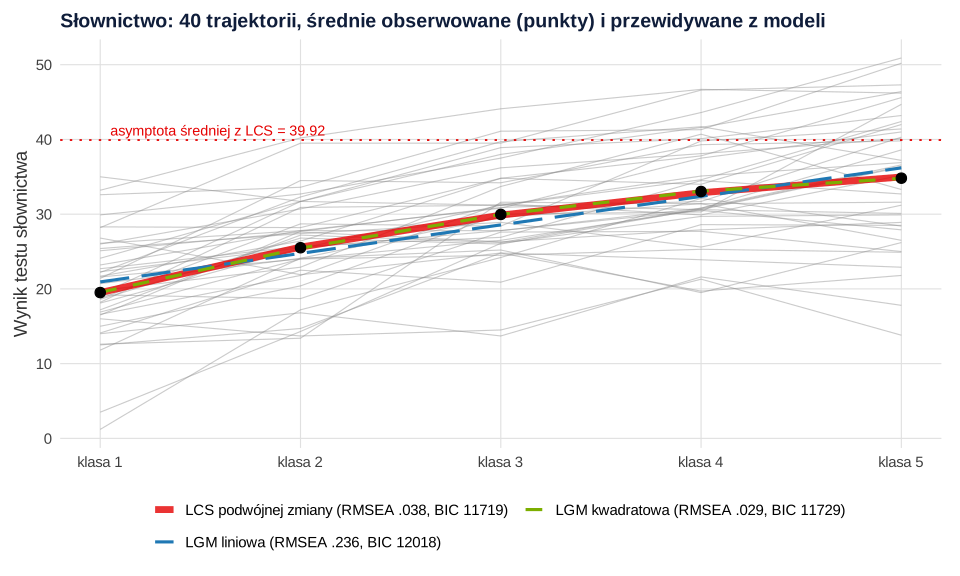
Kwadratowa krzywa wzrostu opisuje średnie tak samo dobrze jak model podwójnej zmiany (rysunek 2). Pasuje nawet nieco lepiej: RMSEA = .029 wobec .038. Ma jednak 10 parametrów zamiast 7, więc BIC wskazuje LCS (11718.56 wobec 11729.22), a AIC prawie nie rozróżnia modeli (11690.62 wobec 11689.31). Dopasowanie nie rozstrzyga, który model jest właściwy. Rozstrzyga teoria. Parabola po klasie 5 zacznie opadać. Model podwójnej zmiany mówi, że wzrost wyhamowuje przy pułapie i zależy od osiągniętego poziomu.
LGM wybierz, gdy pytasz o kształt trajektorii w czasie, potrzebujesz nierównych terminów u różnych osób albo modelu wielopoziomowego (zob. modele wzrostu w lme4). LCS wybierz, gdy hipoteza dotyczy mechanizmu zmiany: zależności od poprzedniego poziomu albo od innej zmiennej.
Krok 3. Dwuwymiarowy LCS ze sprzężeniem
W modelu dwuwymiarowym każda zmienna ma własny model podwójnej zmiany, a zmiana jednej zależy też od poprzedniego poziomu drugiej. To sprzężenie (coupling):
Analogicznie γxy łączy poziom czytania ze zmianą słownictwa. Grimm i in. (2012) rozszerzyli tę rodzinę modeli o wpływ wcześniejszych zmian na kolejne zmiany. Pozwala to pytać, czy niedawny przyrost, a nie poziom, zapowiada dalszą zmianę. Kievit i in. (2018) piszą, że LCS ujmuje kluczowe pytania rozwojowe jako parametry modelu, np. skorelowaną zmianę dwóch procesów.
Model ze sprzężeniami w obie strony pasuje bardzo dobrze, χ²(45) = 46.03, p = .429, CFI = 1.000, RMSEA = .008. Sprzężenie słownictwo → zmiana czytania wyniosło γyx = 0.090, 95% CI [0.011, 0.170]. Model bez niego pasował gorzej, Δχ²(1) = 4.21, p = .040. Sprzężenie w drugą stronę było ujemne i nieistotne, γxy = −0.076, 95% CI [−0.156, 0.004], Δχ²(1) = 3.44, p = .064. Korelacja zmian stałych obu umiejętności wyniosła .43.
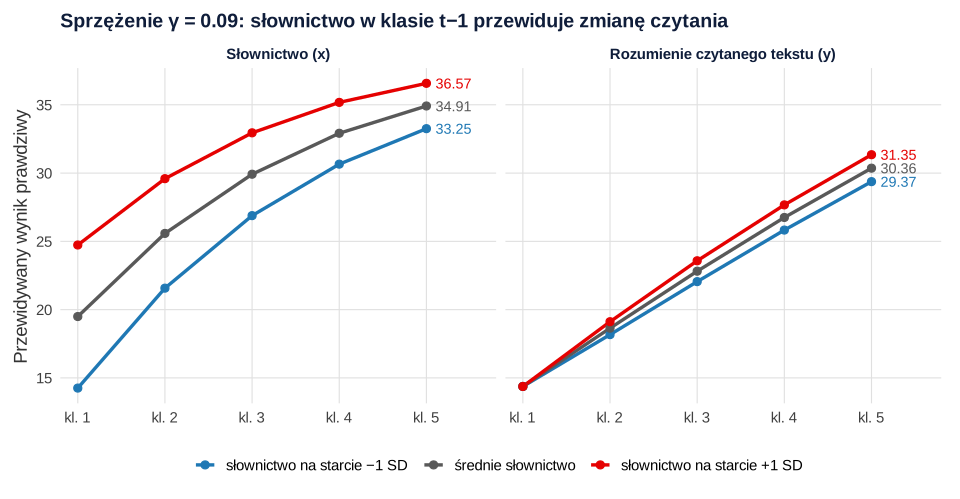
Pojedynczy współczynnik γ trudno sobie wyobrazić, dlatego licz trajektorie przewidywane. Wstaw oszacowania do równań zmiany i przelicz je krok po kroku dla wybranych wartości startowych. Na rysunku 3 dzieci zaczynają z tym samym poziomem czytania, 14.38. Różnica 2 SD w słownictwie daje w klasie 5 różnicę około 2 punktów w czytaniu (29.37 wobec 31.35). Rozbieżność narasta z każdym rokiem, bo sprzężenie działa w każdym kroku.
Sprzężenie to związek poprzedniego poziomu z późniejszą zmianą w modelu. Samo nie dowodzi wpływu przyczynowego. Usami i in. (2019) porządkują modele z relacjami krzyżowymi, w tym LCS, CLPM i RI-CLPM, i pokazują, że interpretacja parametrów krzyżowych zależy od tego, jakie czynniki wspólne opisują zmianę. Wybór modelu może zmienić wniosek. W LCS czynniki s oddzielają stałe różnice w tempie od sprzężenia. Pełni to podobną rolę jak losowe stałe w RI-CLPM, które Hamaker i in. (2015) proponują zamiast klasycznego CLPM. Jeśli pytasz o wewnątrzosobowe wahania wokół trajektorii, przeczytaj wpis o modelach cross-lagged.
Krok 4. Czy model odzyskuje parametry?
W naszej próbie γyx = 0.090, choć dane wygenerowano z wartością 0.15. W modelu dwuwymiarowym β słownictwa wyniosło −0.235, a nie −0.299 jak w jednowymiarowym. Czy estymator jest obciążony, czy to zmienność z próby? Odpowie symulacja: 200 nowych zbiorów z tymi samymi parametrami dla N = 150 i N = 400 (zob. liczebność próby do SEM – symulacja Monte Carlo).
| Parametr (prawdziwy) | N | Średnia | SD oszacowań | Pokrycie 95% CI | Odsetek CI bez 0 |
|---|---|---|---|---|---|
| βx (−0.30) | 150 | −0.300 | 0.059 | .955 | .990 |
| βx (−0.30) | 400 | −0.301 | 0.035 | .945 | 1.000 |
| γyx (0.15) | 150 | 0.148 | 0.060 | .965 | .685 |
| γyx (0.15) | 400 | 0.148 | 0.036 | .940 | .960 |
| γxy (0) | 150 | 0.000 | 0.067 | .960 | .040 |
| γxy (0) | 400 | −0.002 | 0.038 | .955 | .045 |
Wszystkie zbiory się zbiegły. Średnie oszacowań praktycznie równają się wartościom prawdziwym, a pokrycie przedziałów mieści się w granicach błędu Monte Carlo (±0.015 wokół .95). Nasza próba wylosowała γyx około 1.7 SD poniżej prawdy, co zdarza się przy takim rozrzucie. Przy N = 150 przedział wykluczał zero tylko w 68.5% zbiorów, przy N = 400 – w 96.0%. Sprzężenia wymagają dużych prób. Taką symulację z parametrami z literatury zrób przed badaniem, jako analizę mocy.
Założenia i pułapki
- Równe odstępy. Model jest dyskretny: β i γ opisują zmianę na jeden odstęp. Jeśli odstępy są nierówne, nie wstawiaj kolejnych pomiarów jak równoodległych. Model trzeba zmodyfikować, np. dodając pomiary „fantomowe” bez danych.
- Równości w czasie. Zwykle narzucamy jedno β i jedną wariancję błędu. Clark i in. (2018) pokazali w symulacji, że błędnie narzucona równość parametrów obciąża m.in. średnią zmiany stałej i β, a wskaźniki dopasowania i tak wyglądają dobrze. Sprawdzaj modele z uwolnionym β, ale licz się z mniej stabilnymi oszacowaniami.
- Ten sam konstrukt w czasie. Gdy w każdym pomiarze masz kilka pozycji, zbuduj LCS na czynnikach i najpierw sprawdź inwariancję podłużną.
- Braki danych. Dodaj
missing = "fiml"do wywołanialavaan(). FIML zakłada braki MAR (zob. MCAR, MAR i MNAR). - Liczba pomiarów. Kievit i in. (2018) pokazują LCS nawet na dwóch pomiarach, ale wtedy nie oddzielisz zmiany stałej od proporcjonalnej. Przy trzech pomiarach model podwójnej zmiany ma tylko 2 stopnie swobody.
Jak opisać latentny model zmiany w artykule
W metodach podaj specyfikację: które parametry szacujesz, które są równe w czasie, estymator i sposób obsługi braków. Pokaż porównanie modeli zagnieżdżonych i schemat. W wynikach podaj β i γ z 95% CI, średnią i wariancję zmiany stałej oraz trajektorie przewidywane, a nie tylko pojedyncze współczynniki. Jeśli recenzent pyta o identyfikację albo o wybór między LCS a LGM, możemy przejrzeć model w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy plik latentne-modele-zmiany-dane.csv (możesz go pobrać tutaj). Potrzebne pakiety: lavaan i MASS.
1. Dane: dwa procesy w pięciu pomiarach
R
# Dane symulowane: 400 dzieci, 5 corocznych pomiarów (klasy 1–5) dwóch umiejętności:
# słownictwo (x1–x5) i rozumienie czytanego tekstu (y1–y5). Wyniki prawdziwe zmieniają się według
# dwuwymiarowego modelu podwójnej zmiany (dual change score) ze sprzężeniem; obserwacje = wynik prawdziwy + błąd.
# Prawdziwe parametry: słownictwo – średnia zmiany stałej 12, β = −0.30; czytanie – średnia zmiany stałej 4,
# β = −0.20; sprzężenie słownictwo → zmiana czytania γ = 0.15, czytanie → zmiana słownictwa γ = 0; SD błędu 3.
symuluj_lcs <- function(n, T = 5, beta_x = -0.30, beta_y = -0.20, g_yx = 0.15, g_xy = 0, sd_e = 3) {
  m <- c(20, 12, 15, 4)                                   # średnie: start x, zmiana stała x, start y, zmiana stała y
  sd <- c(5, 3, 5, 2)
  R <- matrix(c(1, .30, .50, .20,
               .30, 1, .20, .30,
               .50, .20, 1, .30,
               .20, .30, .30, 1), 4)
  f <- MASS::mvrnorm(n, m, diag(sd) %*% R %*% diag(sd))
  x <- y <- matrix(NA, n, T)
  x[, 1] <- f[, 1]; y[, 1] <- f[, 3]
  for (t in 2:T) {                                         # Δx_t = s_x + β_x·x_{t−1} + γ_xy·y_{t−1}
    x[, t] <- x[, t - 1] + f[, 2] + beta_x * x[, t - 1] + g_xy * y[, t - 1]
    y[, t] <- y[, t - 1] + f[, 4] + beta_y * y[, t - 1] + g_yx * x[, t - 1]
  }
  d <- data.frame(round(x + rnorm(n * T, 0, sd_e), 1), round(y + rnorm(n * T, 0, sd_e), 1))
  names(d) <- c(paste0("x", 1:T), paste0("y", 1:T))
  d
}
set.seed(3461)
dane <- symuluj_lcs(400)
write.csv(dane, "latentne-modele-zmiany-dane.csv", row.names = FALSE)
head(dane, 3)
# Średnie i SD w kolejnych pomiarach
round(rbind(M_x = colMeans(dane[1:5]), SD_x = apply(dane[1:5], 2, sd),
            M_y = colMeans(dane[6:10]), SD_y = apply(dane[6:10], 2, sd)), 2)
# Średnie przyrosty obserwowane między pomiarami: słownictwo zwalnia, czytanie nie
round(rbind(dx = diff(colMeans(dane[1:5])), dy = diff(colMeans(dane[6:10]))), 2)
Wynik w R
    x1   x2   x3   x4   x5   y1   y2   y3   y4   y5
1 24.1 31.7 38.9 40.1 43.2 29.9 30.6 39.6 38.1 42.3
2 16.6 16.9 26.9 26.0 23.7 22.8 19.6 22.4 24.3 28.4
3 25.7 28.3 27.2 25.7 30.3 22.6 21.9 30.3 30.0 27.0
        x1    x2    x3    x4    x5
M_x  19.51 25.51 29.96 33.03 34.82
SD_x  6.00  6.30  6.63  7.53  8.55
M_y  14.39 18.58 22.90 26.71 30.36
SD_y  6.31  6.39  6.69  7.41  8.63
     x2   x3   x4   x5
dx 6.00 4.45 3.07 1.79
dy 4.19 4.31 3.82 3.65
2. Jednowymiarowy LCS i porównanie z LGM
R
# Jednowymiarowy latentny model zmiany (LCS) dla słownictwa w lavaan (wymaga obiektu dane z przepisu 1)
suppressPackageStartupMessages(library(lavaan))

# Składnia LCS dla T pomiarów zmiennej v: wynik prawdziwy l1–lT, zmiany latentne d2–dT.
# beta: "b" = zmiana proporcjonalna szacowana (równa w czasie), "0" = brak; stala = czy jest czynnik zmiany stałej s.
lcs_skladnia <- function(v, T = 5, beta = "b", stala = TRUE) {
  l <- paste0("l", v, 1:T); d <- paste0("d", v, 2:T); o <- paste0(v, 1:T)
  c(paste0(l, " =~ 1*", o),                                    # wynik prawdziwy w każdym pomiarze
    paste0(l[-1], " ~ 1*", l[-T]),                             # l_t = l_{t−1} + d_t
    paste0(d, " =~ 1*", l[-1]),                                # zmiana latentna d_t
    paste0(d, " ~ ", if (beta == "0") "0" else paste0(beta, "_", v), "*", l[-T]),   # zmiana proporcjonalna: β · l_{t−1}
    if (stala) c(paste0("s", v, " =~ ", paste0("1*", d, collapse = " + ")),   # zmiana stała
                 paste0("s", v, " ~ 1"), paste0("s", v, " ~~ s", v), paste0("l", v, "1 ~~ s", v)),
    paste0(l[1], " ~ 1"), paste0(l[1], " ~~ ", l[1]),           # start: średnia i wariancja
    paste0(o, " ~~ e_", v, "*", o),                              # równe wariancje błędu pomiaru
    paste0(c(o, l[-1], d), " ~ 0*1"), paste0(c(l[-1], d), " ~~ 0*", c(l[-1], d)))
}
dopasuj <- function(skl) lavaan(paste(skl, collapse = "\n"), data = dane)
cat(lcs_skladnia("x"), sep = "\n")                              # pełna składnia modelu podwójnej zmiany

m_brak  <- dopasuj(lcs_skladnia("x", beta = "0", stala = FALSE))  # brak zmiany
m_stala <- dopasuj(lcs_skladnia("x", beta = "0"))                 # tylko zmiana stała
m_prop  <- dopasuj(lcs_skladnia("x", stala = FALSE))              # tylko zmiana proporcjonalna
m_dual  <- dopasuj(lcs_skladnia("x"))                             # podwójna zmiana (dual change score)

# Krzywe wzrostu dla porównania: liniowa i kwadratowa (równe wariancje błędu jak w LCS)
lgm_lin <- growth("i =~ 1*x1 + 1*x2 + 1*x3 + 1*x4 + 1*x5
                   s =~ 0*x1 + 1*x2 + 2*x3 + 3*x4 + 4*x5
                   x1 ~~ e*x1; x2 ~~ e*x2; x3 ~~ e*x3; x4 ~~ e*x4; x5 ~~ e*x5", data = dane)
lgm_kw  <- growth("i =~ 1*x1 + 1*x2 + 1*x3 + 1*x4 + 1*x5
                   s =~ 0*x1 + 1*x2 + 2*x3 + 3*x4 + 4*x5
                   q =~ 0*x1 + 1*x2 + 4*x3 + 9*x4 + 16*x5
                   x1 ~~ e*x1; x2 ~~ e*x2; x3 ~~ e*x3; x4 ~~ e*x4; x5 ~~ e*x5", data = dane)
modele <- list(brak_zmiany = m_brak, zmiana_stala = m_stala, proporcjonalna = m_prop,
               podwojna = m_dual, LGM_liniowa = lgm_lin, LGM_kwadratowa = lgm_kw)
round(t(sapply(modele, fitMeasures, c("npar", "chisq", "df", "pvalue", "cfi", "rmsea", "srmr", "aic", "bic"))), 3)

# LCS ze zmianą stałą to liniowa krzywa wzrostu: ten sam logLik
round(c(LCS_stala = logLik(m_stala), LGM_liniowa = logLik(lgm_lin)), 3)
# Czy zmiana proporcjonalna jest potrzebna? Test ilorazu wiarygodności
lavTestLRT(m_stala, m_dual)

# Parametry modelu podwójnej zmiany (prawdziwe: start 20, zmiana stała 12, β −0.30, SD startu 5, SD zmiany 3, r .30, wariancja błędu 9)
pe <- parameterEstimates(m_dual)
pe <- pe[(pe$op == "~1" & pe$lhs %in% c("lx1", "sx")) | pe$label %in% c("b_x", "e_x") |
         (pe$op == "~~" & pe$lhs %in% c("lx1", "sx") & pe$rhs %in% c("lx1", "sx")), ]
pe <- pe[pe$label == "" | !duplicated(pe$label), ]          # parametry równe w czasie: jeden wiersz
print(data.frame(parametr = ifelse(pe$label != "", pe$label, paste(pe$lhs, pe$op, pe$rhs)), est = round(pe$est, 3), se = round(pe$se, 3),
                 dolny = round(pe$ci.lower, 3), gorny = round(pe$ci.upper, 3)), row.names = FALSE)
round(c(r_start_zmiana = lavInspect(m_dual, "cor.lv")["lx1", "sx"]), 3)

# Średnie przewidywane w pomiarach (model) a obserwowane; asymptota średniej trajektorii = −μ_s / β
srednie <- rbind(obserwowane = colMeans(dane[1:5]), podwojna = fitted(m_dual)$mean,
                 LGM_liniowa = fitted(lgm_lin)$mean, LGM_kwadratowa = fitted(lgm_kw)$mean)
round(srednie, 2)
b <- coef(m_dual)
round(c(asymptota = -unname(b["sx~1"] / b["b_x"])), 2)
# Przewidywane średnie zmiany latentne Δ2–Δ5: μ_s + β · E(l_{t−1})
round(unname(b["sx~1"]) + unname(b["b_x"]) * fitted(m_dual)$mean[1:4], 2)
Wynik w R
lx1 =~ 1*x1
lx2 =~ 1*x2
lx3 =~ 1*x3
lx4 =~ 1*x4
lx5 =~ 1*x5
lx2 ~ 1*lx1
lx3 ~ 1*lx2
lx4 ~ 1*lx3
lx5 ~ 1*lx4
dx2 =~ 1*lx2
dx3 =~ 1*lx3
dx4 =~ 1*lx4
dx5 =~ 1*lx5
dx2 ~ b_x*lx1
dx3 ~ b_x*lx2
dx4 ~ b_x*lx3
dx5 ~ b_x*lx4
sx =~ 1*dx2 + 1*dx3 + 1*dx4 + 1*dx5
sx ~ 1
sx ~~ sx
lx1 ~~ sx
lx1 ~ 1
lx1 ~~ lx1
x1 ~~ e_x*x1
x2 ~~ e_x*x2
x3 ~~ e_x*x3
x4 ~~ e_x*x4
x5 ~~ e_x*x5
x1 ~ 0*1
x2 ~ 0*1
x3 ~ 0*1
x4 ~ 0*1
x5 ~ 0*1
lx2 ~ 0*1
lx3 ~ 0*1
lx4 ~ 0*1
lx5 ~ 0*1
dx2 ~ 0*1
dx3 ~ 0*1
dx4 ~ 0*1
dx5 ~ 0*1
lx2 ~~ 0*lx2
lx3 ~~ 0*lx3
lx4 ~~ 0*lx4
lx5 ~~ 0*lx5
dx2 ~~ 0*dx2
dx3 ~~ 0*dx3
dx4 ~~ 0*dx4
dx5 ~~ 0*dx5
               npar    chisq df pvalue   cfi rmsea  srmr      aic      bic
brak_zmiany       3 2486.422 17  0.000 0.000 0.603 0.611 14148.43 14160.40
zmiana_stala      6  325.808 14  0.000 0.822 0.236 0.096 11993.82 12017.76
proporcjonalna    4  651.768 16  0.000 0.638 0.315 0.148 12315.77 12331.74
podwojna          7   20.610 13  0.081 0.996 0.038 0.032 11690.62 11718.56
LGM_liniowa       6  325.808 14  0.000 0.822 0.236 0.096 11993.82 12017.76
LGM_kwadratowa   10   13.299 10  0.207 0.998 0.029 0.030 11689.31 11729.22
  LCS_stala LGM_liniowa
  -5990.907   -5990.907

Chi-Squared Difference Test

        Df   AIC   BIC  Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
m_dual  13 11691 11719  20.61
m_stala 14 11994 12018 325.81      305.2 0.87206       1  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   parametr    est    se  dolny  gorny
        b_x -0.299 0.014 -0.326 -0.271
     sx ~1  11.919 0.408 11.120 12.718
   sx ~~ sx  8.062 0.731  6.629  9.494
  lx1 ~~ sx  5.487 0.937  3.649  7.324
    lx1 ~1  19.503 0.298 18.918 20.088
 lx1 ~~ lx1 27.985 2.425 23.233 32.738
        e_x  8.270 0.338  7.609  8.932
r_start_zmiana
         0.365
                  x1    x2    x3    x4    x5
obserwowane    19.51 25.51 29.96 33.03 34.82
podwojna       19.50 25.60 29.87 32.87 34.98
LGM_liniowa    20.94 24.75 28.56 32.38 36.19
LGM_kwadratowa 19.53 25.45 29.97 33.08 34.79
asymptota
    39.92
  x1   x2   x3   x4
6.10 4.28 3.00 2.10
3. Dwuwymiarowy LCS ze sprzężeniem i trajektorie przewidywane
R
# Dwuwymiarowy model podwójnej zmiany ze sprzężeniem (wymaga obiektu dane i funkcji lcs_skladnia z przepisów 1–2)
suppressPackageStartupMessages(library(lavaan))
# sprzężenie: g_yx = wpływ słownictwa l_x(t−1) na zmianę czytania Δy_t; g_xy = wpływ czytania na zmianę słownictwa
lcs_dwa <- function(g_yx = "g_yx", g_xy = "g_xy", T = 5) {
  c(lcs_skladnia("x", T), lcs_skladnia("y", T),
    paste0("dy", 2:T, " ~ ", g_yx, "*lx", 1:(T - 1)),
    paste0("dx", 2:T, " ~ ", g_xy, "*ly", 1:(T - 1)),
    "lx1 ~~ ly1; lx1 ~~ sy; sx ~~ ly1; sx ~~ sy")             # korelacje czynników obu procesów
}
dopasuj2 <- function(skl, d = dane) lavaan(paste(skl, collapse = "\n"), data = d)
m_sprz   <- dopasuj2(lcs_dwa())                  # oba sprzężenia szacowane
m_bez_yx <- dopasuj2(lcs_dwa(g_yx = "0"))        # bez wpływu słownictwa na zmianę czytania
m_bez_xy <- dopasuj2(lcs_dwa(g_xy = "0"))        # bez wpływu czytania na zmianę słownictwa
round(fitMeasures(m_sprz, c("npar", "chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
lavTestLRT(m_bez_yx, m_sprz)
lavTestLRT(m_bez_xy, m_sprz)

# Odzysk parametrów: oszacowanie, 95% CI i wartość prawdziwa
pe <- parameterEstimates(m_sprz)
pe <- pe[pe$label %in% c("b_x", "b_y", "g_yx", "g_xy", "e_x", "e_y") | (pe$op == "~1" & pe$lhs %in% c("sx", "sy")), ]
pe <- pe[pe$label == "" | !duplicated(pe$label), ]
pe$nazwa <- ifelse(pe$label != "", pe$label, paste(pe$lhs, pe$op))
prawdziwe <- c(b_x = -0.30, b_y = -0.20, g_yx = 0.15, g_xy = 0, e_x = 9, e_y = 9, "sx ~1" = 12, "sy ~1" = 4)
print(data.frame(parametr = pe$nazwa, est = round(pe$est, 3), se = round(pe$se, 3), dolny = round(pe$ci.lower, 3),
                 gorny = round(pe$ci.upper, 3), prawdziwy = prawdziwe[pe$nazwa]), row.names = FALSE)
round(lavInspect(m_sprz, "cor.lv")[c("lx1", "sx", "ly1", "sy"), c("lx1", "sx", "ly1", "sy")], 2)

# Trajektorie przewidywane: czytanie u dziecka ze słownictwem na starcie o 1 SD niższym / wyższym od średniej,
# przy pozostałych czynnikach (zmiana stała słownictwa, start i zmiana stała czytania) na średnich
trajektoria <- function(lx1, b = coef(m_sprz), T = 5) {
  x <- lx1; y <- unname(b["ly1~1"]); sx <- unname(b["sx~1"]); sy <- unname(b["sy~1"])
  for (t in 2:T) {
    x[t] <- x[t - 1] + sx + b[["b_x"]] * x[t - 1] + b[["g_xy"]] * y[t - 1]
    y[t] <- y[t - 1] + sy + b[["b_y"]] * y[t - 1] + b[["g_yx"]] * x[t - 1]
  }
  rbind(x = x, y = y)
}
b <- coef(m_sprz); sd_lx1 <- sqrt(lavInspect(m_sprz, "cov.lv")["lx1", "lx1"])
traj <- rbind(nisko = trajektoria(b[["lx1~1"]] - sd_lx1), srednio = trajektoria(b[["lx1~1"]]),
              wysoko = trajektoria(b[["lx1~1"]] + sd_lx1))
dimnames(traj) <- list(paste(rep(c("nisko", "srednio", "wysoko"), each = 2), c("x", "y")), paste0("klasa_", 1:5))
round(traj, 2)
write.csv(data.frame(grupa = rownames(traj), traj), "trajektorie-przewidywane.csv", row.names = FALSE)
Wynik w R
  npar  chisq     df pvalue    cfi  rmsea   srmr
20.000 46.031 45.000  0.429  1.000  0.008  0.025

Chi-Squared Difference Test

         Df   AIC   BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
m_sprz   45 23298 23378 46.031
m_bez_yx 46 23300 23376 50.237     4.2057 0.089522       1    0.04029 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Chi-Squared Difference Test

         Df   AIC   BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
m_sprz   45 23298 23378 46.031
m_bez_xy 46 23299 23375 49.471     3.4404 0.078109       1    0.06362 .
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 parametr    est    se  dolny  gorny prawdziwy
      b_x -0.235 0.038 -0.309 -0.161     -0.30
    sx ~1 11.755 0.425 10.922 12.588     12.00
      e_x  8.237 0.337  7.577  8.896      9.00
      b_y -0.151 0.044 -0.238 -0.065     -0.20
    sy ~1  4.680 0.445  3.807  5.552      4.00
      e_y  8.923 0.365  8.209  9.638      9.00
     g_yx  0.090 0.041  0.011  0.170      0.15
     g_xy -0.076 0.041 -0.156  0.004      0.00
     lx1   sx  ly1   sy
lx1 1.00 0.38 0.55 0.16
sx  0.38 1.00 0.30 0.43
ly1 0.55 0.30 1.00 0.11
sy  0.16 0.43 0.11 1.00
          klasa_1 klasa_2 klasa_3 klasa_4 klasa_5
nisko x     14.26   21.57   26.88   30.65   33.25
nisko y     14.38   18.17   22.05   25.83   29.37
srednio x   19.49   25.58   29.92   32.92   34.91
srednio y   14.38   18.64   22.82   26.75   30.36
wysoko x    24.73   29.59   32.95   35.18   36.57
wysoko y    14.38   19.12   23.58   27.67   31.35
4. Symulacja: odzysk parametrów sprzężenia
R
# Odzysk parametrów sprzężenia w symulacji: 200 zbiorów dla N = 150 i N = 400
# (wymaga funkcji symuluj_lcs, lcs_skladnia, lcs_dwa i dopasuj2 z przepisów 1–3; trwa kilka minut)
suppressPackageStartupMessages(library(lavaan))
set.seed(3464)
jeden <- function(n) {
  zbior <- symuluj_lcs(n)                                    # nowy zbiór z tymi samymi prawdziwymi parametrami
  fit <- tryCatch(dopasuj2(lcs_dwa(), zbior), warning = function(w) NULL, error = function(e) NULL)
  if (is.null(fit) || !lavInspect(fit, "converged")) return(rep(NA, 9))
  pe <- parameterEstimates(fit); pe <- pe[!duplicated(pe$label) & pe$label %in% c("b_x", "g_yx", "g_xy"), ]
  pe <- pe[match(c("b_x", "g_yx", "g_xy"), pe$label), ]
  c(pe$est, pe$ci.lower, pe$ci.upper)
}
prawdziwe <- c(b_x = -0.30, g_yx = 0.15, g_xy = 0)
wyniki <- do.call(rbind, lapply(c(150, 400), function(n) {
  w <- t(replicate(200, jeden(n)))
  data.frame(N = n, powt = 1:200, parametr = rep(names(prawdziwe), each = 200),
             est = c(w[, 1:3]), dolny = c(w[, 4:6]), gorny = c(w[, 7:9]))
}))
write.csv(wyniki, "odzysk-symulacja.csv", row.names = FALSE)
ok <- !is.na(wyniki$est)
round(tapply(ok, list(wyniki$parametr, wyniki$N), mean), 3)   # odsetek zbiorów z poprawnym dopasowaniem
w <- wyniki[ok, ]; w$prawdziwy <- prawdziwe[w$parametr]
podsum <- do.call(rbind, lapply(split(w, list(w$parametr, w$N)), function(d) data.frame(
  parametr = d$parametr[1], N = d$N[1], dopasowane = nrow(d), srednia = mean(d$est),
  obciazenie = mean(d$est) - d$prawdziwy[1], SD = sd(d$est),
  pokrycie_95 = mean(d$dolny <= d$prawdziwy[1] & d$gorny >= d$prawdziwy[1]),
  odrzucenie_zera = mean(d$dolny > 0 | d$gorny < 0))))
print(transform(podsum, srednia = round(srednia, 3), obciazenie = round(obciazenie, 3), SD = round(SD, 3),
                pokrycie_95 = round(pokrycie_95, 3), odrzucenie_zera = round(odrzucenie_zera, 3)), row.names = FALSE)
round(c(blad_MC_pokrycia_95 = sqrt(.95 * .05 / 200)), 3)
Wynik w R
     150 400
b_x    1   1
g_xy   1   1
g_yx   1   1
 parametr   N dopasowane srednia obciazenie    SD pokrycie_95 odrzucenie_zera
      b_x 150        200  -0.300      0.000 0.059       0.955           0.990
     g_xy 150        200   0.000      0.000 0.067       0.960           0.040
     g_yx 150        200   0.148     -0.002 0.060       0.965           0.685
      b_x 400        200  -0.301     -0.001 0.035       0.945           1.000
     g_xy 400        200  -0.002     -0.002 0.038       0.955           0.045
     g_yx 400        200   0.148     -0.002 0.036       0.940           0.960
blad_MC_pokrycia_95
              0.015
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lavaan i MASS; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Interpretacja s jak nachylenia LGM. Przy β ≠ 0 całkowita zmiana zależy od poziomu; opisuj trajektorie przewidywane.
- Wybór LCS albo LGM według dopasowania. Kwadratowa krzywa i podwójna zmiana mogą pasować równie dobrze, a mówią co innego o mechanizmie.
- Sprzężenie opisane jak efekt przyczynowy. To związek poziomu z późniejszą zmianą w danych obserwacyjnych.
- Niesprawdzone równości w czasie. Dobre dopasowanie nie chroni przed obciążeniem β (Clark i in., 2018).
- Nierówne odstępy traktowane jak równe. β i γ odnoszą się do jednego odstępu, więc ich znaczenie zmienia się z długością odstępu.
- Sprzężenia na małej próbie. Przy N = 150 przedział dla γ = 0.15 obejmował zero w prawie co trzecim zbiorze.
Najczęstsze pytania
Czym różni się latentny model zmiany od krzywej wzrostu?
Krzywa wzrostu opisuje trajektorię funkcją czasu (poziom, nachylenie, przyspieszenie). Latentny model zmiany modeluje zmianę między kolejnymi pomiarami i pozwala ją przewidywać poprzednim poziomem albo poziomem innej zmiennej. LCS z samą zmianą stałą to dokładnie liniowa krzywa wzrostu; różnicę robi współczynnik zmiany proporcjonalnej β.
Co oznacza ujemny współczynnik β w modelu podwójnej zmiany?
Że osoby z wyższym poprzednim poziomem mają mniejszy kolejny przyrost, więc wzrost zwalnia, a średnia trajektoria zbliża się do asymptoty −μs/β. W przykładzie β = −0.30, a średnie słownictwo dążyło do 39.92 punktu. Dodatnie β oznacza zmianę przyspieszającą.
Jak interpretować sprzężenie (coupling) w dwuwymiarowym modelu LCS?
Sprzężenie γyx mówi, o ile zmienia się oczekiwana zmiana y w kolejnym kroku przy poziomie x wyższym o jednostkę. Najlepiej pokazać je trajektoriami przewidywanymi dla różnych wartości startowych. To związek w danych obserwacyjnych, a nie dowód wpływu przyczynowego.
Ile pomiarów potrzeba do latentnego modelu zmiany?
Prostą wersję LCS da się oszacować nawet na dwóch pomiarach, ale nie oddzielisz wtedy zmiany stałej od proporcjonalnej. Model podwójnej zmiany przy trzech pomiarach ma tylko 2 stopnie swobody, więc praktycznie potrzebujesz czterech–pięciu pomiarów w równych odstępach i, przy sprzężeniach, kilkuset osób.
Dlaczego latentny model zmiany zapisuje się w lavaan funkcją lavaan(), a nie sem()?
Funkcja sem() dodaje część parametrów automatycznie, np. wariancje zmiennych latentnych i kowariancje między egzogenicznymi zmiennymi latentnymi, więc każdy niechciany parametr trzeba wtedy jawnie ustalić. lavaan() niczego nie dodaje: wszystkie ustalenia LCS – ładunki 1, zerowe średnie i wariancje zmian latentnych – widać w składni i łatwo sprawdzić, że model ma dokładnie zamierzone parametry.
Powiązane hasła
Przeczytaj też
Krzywe wzrostu (LGM) i modele zmiany
Krzywa wzrostu w lavaan na danych do pobrania: kształt zmiany, ujemna wariancja, kodowanie czasu, predyktor tempa, porównanie z lme4 i tabele APA.
Czytaj →PoradnikModele cross-lagged: logika, założenia i interpretacja CLPM oraz RI-CLPM
Jak odróżnić stabilne różnice między osobami od zmiany wewnątrzosobowej, dobrać model panelowy i nie pomylić predykcji czasowej z przyczynowością.
Czytaj →PoradnikModele wzrostu w lme4
Losowy wyraz wolny i nachylenie czasu, kodowanie czasu, nieregularne terminy, predyktor × czas, braki MAR, porównanie z LGM i wzór opisu APA.
Czytaj →Planujesz latentny model zmiany w badaniu podłużnym?
Pomożemy dobrać model zmiany do hipotezy, sprawdzić specyfikację w lavaan, odzysk parametrów i opis wyników tak, żebyś mógł(a) samodzielnie bronić analizy przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Clark, D. A., Nuttall, A. K., & Bowles, R. P. (2018). Misspecification in latent change score models: Consequences for parameter estimation, model evaluation, and predicting change. Multivariate Behavioral Research, 53(2), 172–189. https://doi.org/10.1080/00273171.2017.1409612
- Ghisletta, P., & McArdle, J. J. (2012). Latent curve models and latent change score models estimated in R. Structural Equation Modeling: A Multidisciplinary Journal, 19(4), 651–682. https://doi.org/10.1080/10705511.2012.713275 ● Otwarty dostęp: pełny tekst
- Grimm, K. J., An, Y., McArdle, J. J., Zonderman, A. B., & Resnick, S. M. (2012). Recent changes leading to subsequent changes: Extensions of multivariate latent difference score models. Structural Equation Modeling: A Multidisciplinary Journal, 19(2), 268–292. https://doi.org/10.1080/10705511.2012.659627 ● Otwarty dostęp: pełny tekst
- Hamaker, E. L., Kuiper, R. M., & Grasman, R. P. P. P. (2015). A critique of the cross-lagged panel model. Psychological Methods, 20(1), 102–116. https://doi.org/10.1037/a0038889 ● Otwarty dostęp: pełny tekst
- Kievit, R. A., Brandmaier, A. M., Ziegler, G., van Harmelen, A.-L., de Mooij, S. M. M., Moutoussis, M., Goodyer, I. M., Bullmore, E., Jones, P. B., Fonagy, P., Lindenberger, U., & Dolan, R. J. (2018). Developmental cognitive neuroscience using latent change score models: A tutorial and applications. Developmental Cognitive Neuroscience, 33, 99–117. https://doi.org/10.1016/j.dcn.2017.11.007 ● Otwarty dostęp
- McArdle, J. J. (2009). Latent variable modeling of differences and changes with longitudinal data. Annual Review of Psychology, 60(1), 577–605. https://doi.org/10.1146/annurev.psych.60.110707.163612
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Usami, S., Murayama, K., & Hamaker, E. L. (2019). A unified framework of longitudinal models to examine reciprocal relations. Psychological Methods, 24(5), 637–657. https://doi.org/10.1037/met0000210 ● Otwarty dostęp
Cytowania BibTeX
@article{clark2018misspecification, author={Clark, D. Angus and Nuttall, Amy K. and Bowles, Ryan P.}, title={{Misspecification in latent change score models: Consequences for parameter estimation, model evaluation, and predicting change}}, journal={Multivariate Behavioral Research}, year={2018}, volume={53}, number={2}, pages={172--189}, doi={10.1080/00273171.2017.1409612}}@article{ghisletta2012latent, author={Ghisletta, Paolo and McArdle, John J.}, title={{Latent curve models and latent change score models estimated in R}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2012}, volume={19}, number={4}, pages={651--682}, doi={10.1080/10705511.2012.713275}}@article{grimm2012recent, author={Grimm, Kevin J. and An, Yang and McArdle, John J. and Zonderman, Alan B. and Resnick, Susan M.}, title={{Recent changes leading to subsequent changes: Extensions of multivariate latent difference score models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2012}, volume={19}, number={2}, pages={268--292}, doi={10.1080/10705511.2012.659627}}@article{hamaker2015critique, author={Hamaker, Ellen L. and Kuiper, Rebecca M. and Grasman, Raoul P. P. P.}, title={{A critique of the cross-lagged panel model}}, journal={Psychological Methods}, year={2015}, volume={20}, number={1}, pages={102--116}, doi={10.1037/a0038889}}@article{kievit2018developmental, author={Kievit, Rogier A. and Brandmaier, Andreas M. and Ziegler, Gabriel and van Harmelen, Anne-Laura and de Mooij, Susanne M. M. and Moutoussis, Michael and Goodyer, Ian M. and Bullmore, Ed and Jones, Peter B. and Fonagy, Peter and Lindenberger, Ulman and Dolan, Raymond J.}, title={{Developmental cognitive neuroscience using latent change score models: A tutorial and applications}}, journal={Developmental Cognitive Neuroscience}, year={2018}, volume={33}, pages={99--117}, doi={10.1016/j.dcn.2017.11.007}}@article{mcardle2009latent, author={McArdle, John J.}, title={{Latent variable modeling of differences and changes with longitudinal data}}, journal={Annual Review of Psychology}, year={2009}, volume={60}, number={1}, pages={577--605}, doi={10.1146/annurev.psych.60.110707.163612}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{usami2019unified, author={Usami, Satoshi and Murayama, Kou and Hamaker, Ellen L.}, title={{A unified framework of longitudinal models to examine reciprocal relations}}, journal={Psychological Methods}, year={2019}, volume={24}, number={5}, pages={637--657}, doi={10.1037/met0000210}}