Kiedy wystarczy analiza ścieżek
Analiza ścieżek (ang. path analysis) to model równań strukturalnych, w którym wszystkie zmienne są obserwowalne: wyniki skal, liczby godzin, wskaźniki kliniczne. Nie ma tu owali ani ładunków czynnikowych. Jest za to kilka równań regresji szacowanych razem, a zmienna zależna w jednym równaniu może być predyktorem w drugim. Streiner (2005) opisuje ją jako rozszerzenie regresji wielorakiej na modele z kilkoma zmiennymi zależnymi i łańcuchami wpływów. Podkreśla też, że analiza ścieżek nie dowodzi przyczynowości. Sprawdza tylko, czy dane są zgodne z modelem, i pozwala porównywać modele konkurencyjne.
Po analizę ścieżek sięgasz, gdy masz gotowy model badawczy ze schematem hipotez, a zmienne mierzysz sumami lub średnimi z pozycji. Jeśli chcesz modelować błąd pomiaru, potrzebujesz pełnego SEM z częścią pomiarową. Taki przykład krok po kroku pokazuje wpis CB-SEM w R (lavaan), a kolejność wszystkich decyzji – przewodnik po modelowaniu SEM. Gdy pytasz o jeden albo kilka mediatorów jednego predyktora, wystarczą wpisy analiza mediacji krok po kroku i mediacja równoległa i szeregowa. Tutaj zajmujemy się tym, czego tam nie ma: modelem z kilkoma predyktorami i zmiennymi pośredniczącymi, który ma stopnie swobody, więc można sprawdzić jego dopasowanie i porównać go z modelem zagnieżdżonym i alternatywnym. Definicję i symbole znajdziesz w haśle analiza ścieżek oraz wykres ścieżkowy.
Przykład: obciążenie, wsparcie i zamiar odejścia z zawodu
Ankietę wypełniło 380 pielęgniarek i pielęgniarzy (dane symulowane, set.seed(2361), plik CSV). Mierzono obciążenie pracą (1–5), wsparcie przełożonego (1–5), wypalenie (1–7), zaangażowanie w pracę (0–6) i zamiar odejścia z zawodu (1–5). Hipotezy zapisano przed analizą:
- obciążenie nasila wypalenie, a wsparcie je osłabia;
- wsparcie zwiększa zaangażowanie;
- wypalenie zwiększa, a zaangażowanie zmniejsza zamiar odejścia;
- obciążenie i wsparcie działają na zamiar odejścia wyłącznie przez wypalenie i zaangażowanie (model M1).
W planie analizy zapisano też model alternatywny M2 z dwoma efektami bezpośrednimi na zamiar odejścia. Uzasadnienie: obciążenie może skłaniać do odejścia także bez wypalenia, np. przez brak czasu dla rodziny.
| Zmienna | M (SD) | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| 1. Obciążenie pracą | 3.20 (0.64) | – | |||
| 2. Wsparcie przełożonego | 3.33 (0.81) | −.31 | – | ||
| 3. Wypalenie | 3.64 (0.99) | .50 | −.39 | – | |
| 4. Zaangażowanie | 3.74 (1.03) | −.21 | .46 | −.44 | – |
| 5. Zamiar odejścia | 2.49 (0.88) | .38 | −.30 | .57 | −.42 |
Identyfikacja i stopnie swobody
Zanim uruchomisz sem(), policz bilans informacji. Pięć zmiennych daje 5 × 6 / 2 = 15 wariancji i kowariancji. Model M1 szacuje 12 parametrów:
- 5 ścieżek (a1, a2, a3, b1, b2);
- 3 wariancje reszt zmiennych endogenicznych;
- 1 kowariancję reszt wypalenia i zaangażowania;
- 2 wariancje i 1 kowariancję zmiennych egzogenicznych.
Zostają 3 stopnie swobody. Każdy z nich to strzałka, której nie narysowałeś: obciążenie → zaangażowanie, obciążenie → zamiar odejścia i wsparcie → zamiar odejścia. Dopiero te ograniczenia pozwalają testować model. Gdyby narysować wszystkie strzałki, model byłby nasycony (df = 0). Odtworzyłby dane idealnie, a χ² wyniósłby 0 niezależnie od trafności teorii. Tak jest w zwykłej regresji i w prostym modelu mediacji.
Model rekurencyjny, czyli bez pętli zwrotnych i bez kowariancji reszt, jest zawsze zidentyfikowany. Kowariancja reszt dwóch zmiennych, których nie łączy strzałka, jak w naszym modelu, też nie stwarza kłopotu. Trudniej jest przy pętlach zwrotnych (A → B → A) i przy korelacji reszt zmiennej i jej predyktora. Wtedy reguła liczenia parametrów nie wystarcza i trzeba sprawdzić warunki identyfikacji. Bollen i Davis (2009) przypominają, że ostrzeżenia programu dotyczą tylko identyfikacji lokalnej przy danych oszacowaniach, i podają reguły do sprawdzania modelu przed estymacją. Więcej o tym w haśle identyfikacja modelu SEM.
Krok 1. Model hipotetyczny i jego dopasowanie
W pakiecie lavaan (Rosseel, 2012) model M1 to cztery linie: trzy regresje z etykietami ścieżek i kowariancja reszt wyp ~~ zaa. Wypalenie i zaangażowanie mają wspólne przyczyny spoza modelu, więc zakładanie, że ich reszty nie są związane, byłoby dodatkowym, trudnym do obrony ograniczeniem. Wynik:
- χ²(3) = 9.26, p = .026 – model nie odtwarza danych dokładnie;
- CFI = .986, TLI = .957, SRMR = .036;
- RMSEA = .074, 90% CI [.023, .131].
Przy trzech stopniach swobody RMSEA jest mało przydatny. Kenny i in. (2015) pokazali, że przy małym df RMSEA zbyt często wskazuje złe dopasowanie nawet modelu poprawnego. Zalecają zamiast tego oszacować parametry, których model nie zawierał. Najpierw jednak zajrzyj do dopasowania lokalnego. Reszty korelacyjne są małe z jednym wyjątkiem: model zaniża korelację obciążenia z zamiarem odejścia o .115. To dokładnie miejsce, w którym M1 zakłada brak efektu bezpośredniego.
Uważaj na indeksy modyfikacji. Największy (MI = 9.40) proponuje regresję wsparcia na wypaleniu, czyli strzałkę ze zmiennej endogenicznej do egzogenicznej. Teoretycznie to nonsens. Ścieżka obciążenie → zamiar odejścia ma MI = 6.80. MacCallum i in. (1992) pokazali, że modyfikacje wybrane na podstawie danych słabo się replikują, i zalecają porównywanie modeli alternatywnych określonych z góry. Tak postępujemy w następnym kroku.
Krok 2. Model zagnieżdżony: test różnicy χ²
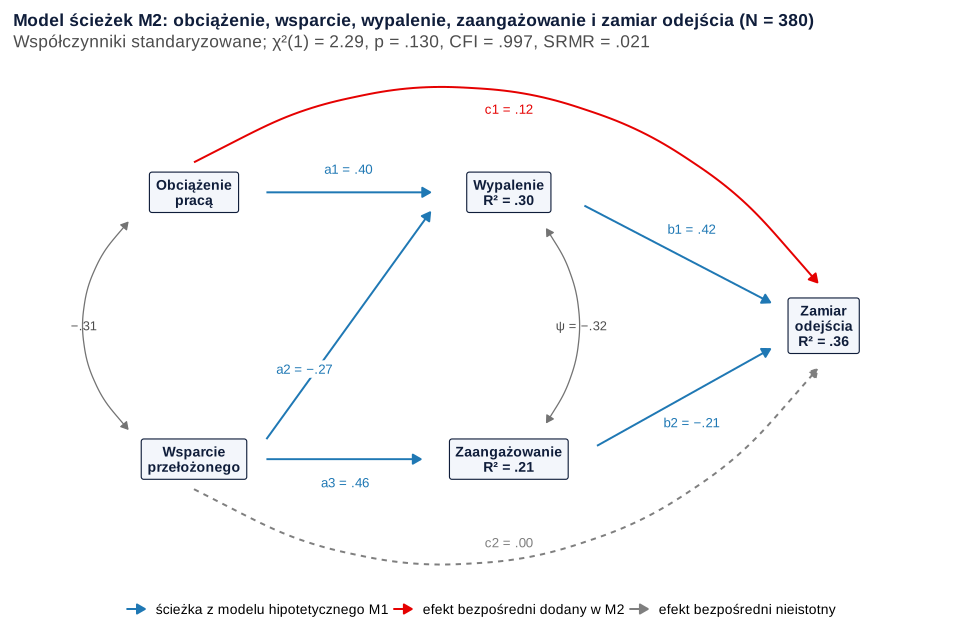
Model M2 dodaje dwie ścieżki: obciążenie → zamiar odejścia (c1) i wsparcie → zamiar odejścia (c2). M1 powstaje z M2 przez ustalenie c1 = c2 = 0, więc M1 jest zagnieżdżony w M2. Takie modele porównuje test różnicy chi-kwadrat (lavTestLRT()).
| Model | χ² (df) | p | CFI | SRMR | AIC | BIC |
|---|---|---|---|---|---|---|
| M1: pełna mediacja (hipoteza) | 9.26 (3) | .026 | .986 | .036 | 2728.13 | 2763.59 |
| M2: z efektami bezpośrednimi | 2.29 (1) | .130 | .997 | .021 | 2725.15 | 2768.50 |
| M3: alternatywny, niezagnieżdżony | 63.06 (3) | < .001 | .864 | .071 | 2781.93 | 2817.39 |
Różnica wynosi Δχ²(2) = 6.97, p = .031. Ograniczenia M1 istotnie pogarszają dopasowanie, więc dalej interpretujemy M2. Zauważ jednak, że AIC i BIC wskazują różne modele: AIC jest niższy dla M2, a BIC – dla M1, bo silniej karze za dwa dodatkowe parametry. Rozbieżność kryteriów oznacza, że przewaga M2 jest niewielka. Zapisz to w raporcie, zamiast wybierać kryterium pasujące do tezy. Przy estymatorze MLR, np. przy skośnych zmiennych, użyj przeskalowanego testu różnicy (zob. MLR).
Krok 3. Efekty bezpośrednie, pośrednie i całkowite
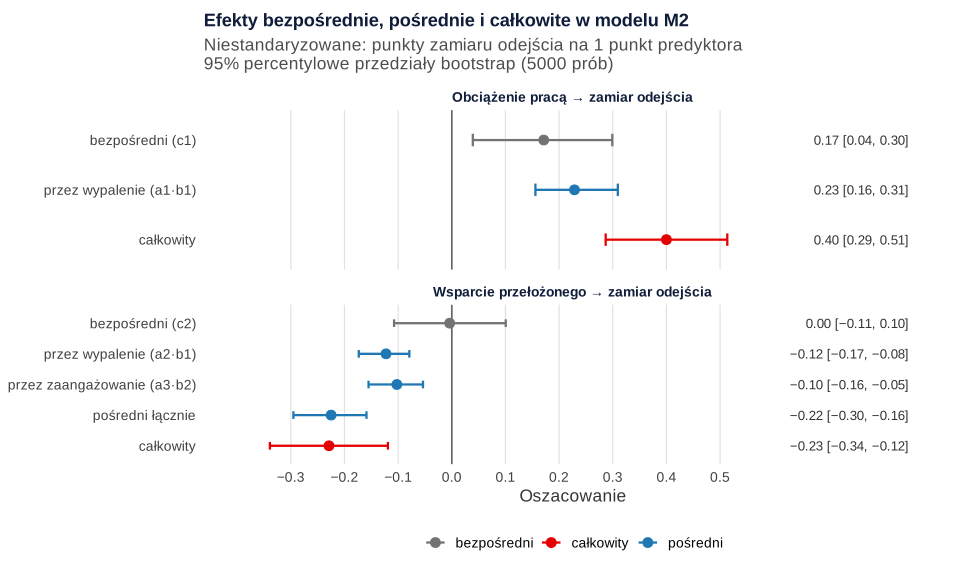
W modelu ścieżek efekt pośredni to iloczyn ścieżek wzdłuż drogi, a efekt całkowity – suma efektu bezpośredniego i wszystkich dróg pośrednich. W lavaan definiujesz je operatorem :=. Rozkład iloczynu zwykle nie jest normalny, dlatego przedziały ufności liczysz bootstrapem. W symulacjach MacKinnona i in. (2004) metody oparte na ponownym próbkowaniu dawały dokładniejsze przedziały niż przybliżenie normalne. Mechanikę bootstrapu w SEM opisuje hasło bootstrap w SEM. Użyliśmy 5000 prób i przedziałów percentylowych. Udało się 4997 prób. Zawsze sprawdzaj tę liczbę.
| Efekt na zamiar odejścia | B [95% CI] | β |
|---|---|---|
| Obciążenie: bezpośredni (c1) | 0.17 [0.04, 0.30] | .12 |
| Obciążenie: pośredni przez wypalenie (a1·b1) | 0.23 [0.16, 0.31] | .17 |
| Obciążenie: całkowity | 0.40 [0.29, 0.51] | .29 |
| Wsparcie: bezpośredni (c2) | 0.00 [−0.11, 0.10] | .00 |
| Wsparcie: pośredni przez wypalenie (a2·b1) | −0.12 [−0.17, −0.08] | −.11 |
| Wsparcie: pośredni przez zaangażowanie (a3·b2) | −0.10 [−0.16, −0.05] | −.09 |
| Wsparcie: pośredni łącznie | −0.22 [−0.30, −0.16] | −.21 |
| Wsparcie: całkowity | −0.23 [−0.34, −0.12] | −.21 |
Obciążenie wyższe o 1 punkt wiąże się z zamiarem odejścia wyższym średnio o 0.40 punktu. Około 57% tego związku (0.23 z 0.40) przechodzi przez wypalenie, a reszta to efekt bezpośredni. Związek wsparcia z zamiarem odejścia jest w całości pośredni: ścieżka c2 jest bliska zeru, a obie drogi, przez wypalenie i przez zaangażowanie, mają przedziały wykluczające zero. Kontrast obu dróg wyniósł −0.02, 95% CI [−0.09, 0.05], więc nie można twierdzić, że któraś przenosi więcej. Model wyjaśnia 30% wariancji wypalenia, 21% zaangażowania i 36% zamiaru odejścia. Definicje znajdziesz w hasłach efekt pośredni i efekt całkowity.
Krok 4. Model alternatywny i modele równoważne
Konkurencyjna teoria może zakładać łańcuch: wypalenie obniża zaangażowanie, a dopiero spadek zaangażowania prowadzi do zamiaru odejścia (model M3). M3 nie jest zagnieżdżony w M2 – każdy z nich ma ścieżki, których drugi nie ma – więc test różnicy χ² nie ma zastosowania. Zostają kryteria informacyjne i test Vuonga. Merkle i in. (2016) przenieśli ten test do SEM i udostępnili go w pakiecie nonnest2. M3 dopasował się źle (tabela wyżej). AIC M2 był niższy o 56.77, a 95% przedział różnicy AIC wyniósł [−88.12, −25.42]. Test Vuonga potwierdził, że modele są rozróżnialne (ω² = 0.168, p < .001) i że M2 pasuje lepiej (z = 3.80, p < .001).
Inaczej jest z modelami równoważnymi. Jeśli w M2 zastąpisz kowariancję reszt strzałką zaangażowanie → wypalenie, dostaniesz identyczne χ²(1) = 2.29 i to samo AIC. Dane nie odróżnią tych modeli, choć opowiadają inną historię. MacCallum i in. (1993), przeglądając 53 publikacje, stwierdzili, że modele równoważne występują rutynowo i często w dużej liczbie. Dopasowanie nie rozstrzyga więc kierunku strzałek. Rohrer i in. (2022) wyjaśniają, że ani odwracanie strzałek, ani porównywanie indeksów dopasowania nie wskaże modelu prawdziwego. Kierunek uzasadnij teorią, kolejnością pomiaru albo schematem badania (zob. grafy przyczynowe DAG).
Jak opisać analizę ścieżek
McDonald i Ho (2002) zalecają, by raport uzasadniał model i jego alternatywy, omawiał identyfikację i podawał pełny zestaw parametrów z błędami standardowymi oraz macierz korelacji. Czytelnik może wtedy sam ocenić model. W praktyce pokaż:
- macierz korelacji z M i SD (tak jak w tabeli wyżej);
- rysunek modelu z oznaczeniem ścieżek hipotetycznych i dodanych;
- dopasowanie wszystkich modeli z planu, także odrzuconych;
- efekty pośrednie i całkowite z przedziałami bootstrap i liczbą udanych prób;
- wzmiankę o modelach równoważnych.
Jeśli planujesz dopiero badanie, liczebność dla wybranej ścieżki oszacujesz symulacją opisaną we wpisie liczebność próby do SEM.
Jeśli recenzent pyta o identyfikację, modele alternatywne albo efekty pośrednie w Twoim modelu, możemy wspólnie przejrzeć analizę w ramach wsparcia statystycznego dla badaczy.
Przykład w R
Jeden przepis tworzy dane, zapisuje plik analiza-sciezek-dane.csv (możesz go pobrać tutaj) i liczy wszystkie wyniki z tekstu. Potrzebne pakiety: lavaan, nonnest2 i MASS (do symulacji). Bootstrap z 5000 prób trwa około minuty.
Analiza ścieżek: identyfikacja, dopasowanie, modele zagnieżdżone i alternatywne, efekty z bootstrapem
R
# B236 – analiza ścieżek na zmiennych obserwowalnych w lavaan (dane symulowane, set.seed(2361)).
# 380 pielęgniarek i pielęgniarzy: obciążenie pracą (obc, 1–5), wsparcie przełożonego (wsp, 1–5),
# wypalenie (wyp, 1–7), zaangażowanie w pracę (zaa, 0–6), zamiar odejścia z zawodu (zam, 1–5) – średnie z pozycji skal.
suppressPackageStartupMessages({ library(lavaan); library(nonnest2) })
set.seed(2361)
n <- 380
ogr <- function(x, lo, hi) round(pmin(pmax(x, lo), hi), 2)
z <- MASS::mvrnorm(n, c(0, 0), matrix(c(1, -.30, -.30, 1), 2))
obc <- z[, 1]; wsp <- z[, 2]
wyp <- 0.45 * obc - 0.30 * wsp + rnorm(n, 0, 0.78)
zaa <- 0.40 * wsp - 0.25 * wyp + rnorm(n, 0, 0.85)
zam <- 0.40 * wyp - 0.30 * zaa + 0.15 * obc + rnorm(n, 0, 0.80)
dane <- data.frame(obc = ogr(3.2 + 0.70 * obc, 1, 5), wsp = ogr(3.4 + 0.80 * wsp, 1, 5),
                   wyp = ogr(3.6 + 1.10 * wyp, 1, 7), zaa = ogr(3.8 + 1.00 * zaa, 0, 6),
                   zam = ogr(2.5 + 0.90 * zam, 1, 5))
write.csv(dane, "analiza-sciezek-dane.csv", row.names = FALSE)

# Krok 1. Statystyki opisowe i korelacje
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x))), 2)
round(cor(dane), 2)

# Krok 2. Model hipotetyczny (M1): pełna mediacja przez wypalenie i zaangażowanie
m1 <- '
  wyp ~ a1 * obc + a2 * wsp
  zaa ~ a3 * wsp
  zam ~ b1 * wyp + b2 * zaa
  wyp ~~ zaa
'
fit1 <- sem(m1, data = dane)
c(momenty = 5 * 6 / 2, parametry = fitMeasures(fit1, "npar") + 3, df = fitMeasures(fit1, "df"))   # +3: wariancje i kowariancja obc, wsp (fixed.x)
miary <- c("chisq", "df", "pvalue", "cfi", "tli", "rmsea", "rmsea.ci.lower", "rmsea.ci.upper", "srmr", "aic", "bic")
round(fitMeasures(fit1, miary), 3)
# Dopasowanie lokalne: reszty korelacyjne i indeksy modyfikacji
round(lavResiduals(fit1, type = "cor")$cov, 3)
mi <- modindices(fit1, sort. = TRUE)
mi[1:4, c("lhs", "op", "rhs", "mi", "sepc.all")]

# Krok 3. Model zagnieżdżony M2: dodane efekty bezpośrednie obc → zam i wsp → zam (częściowa mediacja)
m2 <- '
  wyp ~ a1 * obc + a2 * wsp
  zaa ~ a3 * wsp
  zam ~ b1 * wyp + b2 * zaa + c1 * obc + c2 * wsp
  wyp ~~ zaa
'
fit2 <- sem(m2, data = dane)
round(fitMeasures(fit2, miary), 3)
lavTestLRT(fit1, fit2)

# Krok 4. Efekty bezpośrednie, pośrednie i całkowite w M2 z bootstrapem (5000 prób, przedziały percentylowe)
m2_efekty <- paste(m2, '
  ind_obc := a1 * b1
  calk_obc := c1 + ind_obc
  ind_wsp_wyp := a2 * b1
  ind_wsp_zaa := a3 * b2
  ind_wsp := ind_wsp_wyp + ind_wsp_zaa
  calk_wsp := c2 + ind_wsp
  kontrast_wsp := ind_wsp_wyp - ind_wsp_zaa
')
fit2b <- sem(m2_efekty, data = dane, fixed.x = FALSE, se = "bootstrap", bootstrap = 5000, iseed = 2361)
sum(complete.cases(lavInspect(fit2b, "boot")))      # liczba udanych prób bootstrap
pe <- parameterEstimates(fit2b, boot.ci.type = "perc")
wiersze <- c("a1", "a2", "a3", "b1", "b2", "c1", "c2", "ind_obc", "calk_obc", "ind_wsp_wyp", "ind_wsp_zaa",
             "ind_wsp", "calk_wsp", "kontrast_wsp")
ef <- pe[match(wiersze, pe$label), c("label", "est", "ci.lower", "ci.upper", "pvalue")]
ef$std <- standardizedSolution(fit2b)$est.std[match(wiersze, pe$label)]
ef[, -1] <- round(ef[, -1], 3); print(ef, row.names = FALSE)
round(inspect(fit2b, "r2"), 3)

# Krok 5. Model alternatywny niezagnieżdżony M3: zaangażowanie jako ogniwo między wypaleniem a zamiarem odejścia
m3 <- '
  wyp ~ obc + wsp
  zaa ~ wsp + wyp
  zam ~ zaa + obc
'
fit3 <- sem(m3, data = dane)
round(fitMeasures(fit3, miary), 3)
round(c(AIC_M2 = AIC(fit2), AIC_M3 = AIC(fit3), BIC_M2 = BIC(fit2), BIC_M3 = BIC(fit3)), 2)
v <- vuongtest(fit2, fit3)      # test Vuonga (nonnest2): czy modele są rozróżnialne i który pasuje lepiej
round(c(omega2 = v$omega, p_omega = v$p_omega, z = v$LRTstat, p_M2_lepszy = v$p_LRT$A), 4)
icci(fit2, fit3)

# Krok 6. Model równoważny: ścieżka zaa → wyp zamiast kowariancji reszt daje identyczne dopasowanie
m2_rown <- sub("wyp ~~ zaa", "wyp ~ zaa", m2, fixed = TRUE)
fit2r <- sem(m2_rown, data = dane)
round(rbind(M2 = fitMeasures(fit2, c("chisq", "df", "aic")), M2_rownowazny = fitMeasures(fit2r, c("chisq", "df", "aic"))), 3)
Wynik w R
    obc  wsp  wyp  zaa  zam
M  3.20 3.33 3.64 3.74 2.49
SD 0.64 0.81 0.99 1.03 0.88
      obc   wsp   wyp   zaa   zam
obc  1.00 -0.31  0.50 -0.21  0.38
wsp -0.31  1.00 -0.39  0.46 -0.30
wyp  0.50 -0.39  1.00 -0.44  0.57
zaa -0.21  0.46 -0.44  1.00 -0.42
zam  0.38 -0.30  0.57 -0.42  1.00
       momenty parametry.npar          df.df
            15             12              3
         chisq             df         pvalue            cfi            tli
         9.261          3.000          0.026          0.986          0.957
         rmsea rmsea.ci.lower rmsea.ci.upper           srmr            aic
         0.074          0.023          0.131          0.036       2728.126
           bic
      2763.587
       wyp    zaa    zam    obc    wsp
wyp  0.000
zaa -0.023  0.000
zam  0.006 -0.011  0.000
obc  0.016 -0.065  0.115  0.000
wsp  0.003  0.000 -0.016  0.000  0.000
   lhs op rhs    mi sepc.all
26 wsp  ~ wyp 9.404    3.679
24 obc  ~ zam 7.021    0.150
20 zam  ~ obc 6.800    0.123
16 wyp  ~ zam 6.225   -0.258
         chisq             df         pvalue            cfi            tli
         2.289          1.000          0.130          0.997          0.974
         rmsea rmsea.ci.lower rmsea.ci.upper           srmr            aic
         0.058          0.000          0.162          0.021       2725.154
           bic
      2768.496

Chi-Squared Difference Test

     Df    AIC    BIC  Chisq Chisq diff    RMSEA Df diff Pr(>Chisq)
fit2  1 2725.2 2768.5 2.2891
fit1  3 2728.1 2763.6 9.2607     6.9715 0.080879       2    0.03063 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Warning: lavaan->lav_model_nvcov_bootstrap():
   3 bootstrap runs failed or did not converge.
[1] 4997
        label    est ci.lower ci.upper pvalue    std
           a1  0.618    0.495    0.738  0.000  0.400
           a2 -0.331   -0.440   -0.227  0.000 -0.271
           a3  0.581    0.471    0.687  0.000  0.458
           b1  0.370    0.275    0.467  0.000  0.416
           b2 -0.176   -0.258   -0.094  0.000 -0.206
           c1  0.171    0.039    0.299  0.010  0.125
           c2 -0.004   -0.108    0.101  0.940 -0.004
      ind_obc  0.229    0.156    0.309  0.000  0.167
     calk_obc  0.400    0.287    0.513  0.000  0.292
  ind_wsp_wyp -0.123   -0.173   -0.079  0.000 -0.113
  ind_wsp_zaa -0.102   -0.155   -0.054  0.000 -0.094
      ind_wsp -0.225   -0.295   -0.159  0.000 -0.207
     calk_wsp -0.229   -0.339   -0.119  0.000 -0.211
 kontrast_wsp -0.020   -0.092    0.051  0.582 -0.019
  wyp   zaa   zam
0.302 0.210 0.362
         chisq             df         pvalue            cfi            tli
        63.060          3.000          0.000          0.864          0.592
         rmsea rmsea.ci.lower rmsea.ci.upper           srmr            aic
         0.230          0.182          0.280          0.071       2781.926
           bic
      2817.387
 AIC_M2  AIC_M3  BIC_M2  BIC_M3
2725.15 2781.93 2768.50 2817.39
Warning in imhof(n * omega.hat.2, lamstar^2) :
  Note that Qq + abserr is positive.
     omega2     p_omega           z p_M2_lepszy
     0.1683      0.0000      3.7993      0.0001

Model 1
 Class: lavaan
 Call: lavaan::lavaan(model = m2, data = dane, model.type = "sem", cmd = "sem", ...
 AIC: 2725.154
 BIC: 2768.496

Model 2
 Class: lavaan
 Call: lavaan::lavaan(model = m3, data = dane, model.type = "sem", cmd = "sem", ...
 AIC: 2781.926
 BIC: 2817.387

95% Confidence Interval of AIC difference (AICdiff = AIC1 - AIC2)
  -88.121 < AICdiff < -25.421

95% Confidence Interval of BIC difference (BICdiff = BIC1 - BIC2)
  -80.241 < BICdiff < -17.541
              chisq df      aic
M2            2.289  1 2725.154
M2_rownowazny 2.289  1 2725.154
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiety lavaan 0.7.2 i nonnest2 0.5.8); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- nonnest2 (wersja 0.5.8): Merkle, E. C., You, D., & Preacher, K. J. (2016). Testing nonnested structural equation models. Psychological Methods, 21(2), 151–163. https://doi.org/10.1037/met0000038
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Model nasycony przedstawiony jako „idealnie dopasowany”. Przy df = 0 indeksy dopasowania niczego nie testują.
- Brak kowariancji reszt zmiennych pośredniczących bez uzasadnienia. To dodatkowe ograniczenie, które psuje dopasowanie i zniekształca ścieżki (zob. kowariancja reszt w SEM).
- Dopisywanie ścieżek według indeksów modyfikacji, także tych bez sensu teoretycznego. Modele alternatywne zapisz w planie analizy.
- Test różnicy χ² dla modeli niezagnieżdżonych. Do nich służą kryteria informacyjne i test Vuonga.
- Wniosek o kierunku z dopasowania. Model równoważny pasuje tak samo, więc strzałki uzasadnia teoria i schemat badania.
- Same ścieżki bez efektów pośrednich i całkowitych, albo efekty pośrednie z testem opartym na rozkładzie normalnym zamiast bootstrapu.
Najczęstsze pytania
Czym analiza ścieżek różni się od regresji wielorakiej?
Regresja ma jedną zmienną zależną. Analiza ścieżek szacuje razem kilka równań, w których zmienna zależna jednego równania jest predyktorem w innym, i wylicza z nich efekty pośrednie i całkowite. Gdy model pomija część strzałek, ma stopnie swobody i można sprawdzić, czy odtwarza korelacje w danych (Streiner, 2005).
Dlaczego model ścieżkowy ma zero stopni swobody i czy to błąd?
Zero stopni swobody oznacza model nasycony: szacujesz tyle parametrów, ile jest wariancji i kowariancji. To nie błąd, ale taki model zawsze idealnie odtwarza dane, więc χ², CFI czy RMSEA niczego nie testują. Raportujesz wtedy tylko ścieżki i efekty. Żeby sprawdzić teorię, model musi zakładać brak części strzałek.
Czy przy kilku stopniach swobody raportować RMSEA?
Ostrożnie. Kenny i in. (2015) pokazali, że przy małym df RMSEA często wskazuje złe dopasowanie nawet poprawnego modelu, zwłaszcza w małych próbach. Podaj χ², CFI i SRMR, przejrzyj reszty korelacyjne i oszacuj zaplanowane wcześniej pominięte ścieżki, zamiast opierać decyzję na progu RMSEA.
Jak porównać dwa modele ścieżkowe, które nie są zagnieżdżone?
Test różnicy χ² wymaga, by jeden model powstawał z drugiego przez ograniczenie parametrów. Dla modeli niezagnieżdżonych porównaj AIC i BIC, a różnicę sprawdź testem Vuonga, który Merkle i in. (2016) przenieśli do SEM (pakiet nonnest2). Jeśli dwa modele mają identyczne χ², są równoważne i dane ich nie rozróżnią.
Jak policzyć efekt całkowity w analizie ścieżek?
Efekt całkowity to suma efektu bezpośredniego i wszystkich dróg pośrednich, a każda droga to iloczyn ścieżek. W lavaan nadaj ścieżkom etykiety i zdefiniuj efekty operatorem :=, a przedziały ufności policz bootstrapem. W przykładzie efekt całkowity obciążenia wyniósł 0.40, z czego 0.23 przypadało na drogę przez wypalenie.
Powiązane hasła
Przeczytaj też
CB-SEM w R (lavaan)
Kompletny przykład w lavaan 0.7 na danych do pobrania: CFA z MLR i FIML, dopasowanie, omega i AVE, efekt pośredni z bootstrapem i tabela APA.
Czytaj →PoradnikMediacja równoległa i szeregowa
Trzy mediatory i łańcuch dwóch mediatorów w lavaan: efekty pośrednie szczegółowe, kontrasty, bootstrap i wzór opisu w pracy.
Czytaj →PoradnikModel badawczy – schemat hipotez
Prostokąty i strzałki, mediator na ścieżce, moderator strzałką na strzałkę, zmienne kontrolne i hipotezy H1–Hn – z trzema wzorami rysunków i wskazówką, jaką analizą sprawdzić model.
Czytaj →Budujesz model ścieżkowy do artykułu albo odpowiadasz recenzentowi?
Pomożemy sprawdzić identyfikację, zaplanować modele alternatywne, policzyć efekty pośrednie z bootstrapem i opisać wyniki tak, żebyś mógł(a) je samodzielnie obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bollen, K. A., & Davis, W. R. (2009). Two rules of identification for structural equation models. Structural Equation Modeling: A Multidisciplinary Journal, 16(3), 523–536. https://doi.org/10.1080/10705510903008261
- Kenny, D. A., Kaniskan, B., & McCoach, D. B. (2015). The performance of RMSEA in models with small degrees of freedom. Sociological Methods & Research, 44(3), 486–507. https://doi.org/10.1177/0049124114543236
- MacCallum, R. C., Roznowski, M., & Necowitz, L. B. (1992). Model modifications in covariance structure analysis: The problem of capitalization on chance. Psychological Bulletin, 111(3), 490–504. https://doi.org/10.1037/0033-2909.111.3.490
- MacCallum, R. C., Wegener, D. T., Uchino, B. N., & Fabrigar, L. R. (1993). The problem of equivalent models in applications of covariance structure analysis. Psychological Bulletin, 114(1), 185–199. https://doi.org/10.1037/0033-2909.114.1.185
- MacKinnon, D. P., Lockwood, C. M., & Williams, J. (2004). Confidence limits for the indirect effect: Distribution of the product and resampling methods. Multivariate Behavioral Research, 39(1), 99–128. https://doi.org/10.1207/s15327906mbr3901_4 ● Otwarty dostęp
- McDonald, R. P., & Ho, M.-H. R. (2002). Principles and practice in reporting structural equation analyses. Psychological Methods, 7(1), 64–82. https://doi.org/10.1037/1082-989x.7.1.64
- Merkle, E. C., You, D., & Preacher, K. J. (2016). Testing nonnested structural equation models. Psychological Methods, 21(2), 151–163. https://doi.org/10.1037/met0000038 ● Otwarty dostęp
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Streiner, D. L. (2005). Finding our way: An introduction to path analysis. The Canadian Journal of Psychiatry, 50(2), 115–122. https://doi.org/10.1177/070674370505000207 ● Otwarty dostęp
Cytowania BibTeX
@article{bollen2009two, author={Bollen, Kenneth A. and Davis, Walter R.}, title={{Two rules of identification for structural equation models}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2009}, volume={16}, number={3}, pages={523--536}, doi={10.1080/10705510903008261}}@article{kenny2015performance, author={Kenny, David A. and Kaniskan, Burcu and McCoach, D. Betsy}, title={{The performance of RMSEA in models with small degrees of freedom}}, journal={Sociological Methods \& Research}, year={2015}, volume={44}, number={3}, pages={486--507}, doi={10.1177/0049124114543236}}@article{maccallum1992model, author={MacCallum, Robert C. and Roznowski, Mary and Necowitz, Lawrence B.}, title={{Model modifications in covariance structure analysis: The problem of capitalization on chance}}, journal={Psychological Bulletin}, year={1992}, volume={111}, number={3}, pages={490--504}, doi={10.1037/0033-2909.111.3.490}}@article{maccallum1993problem, author={MacCallum, Robert C. and Wegener, Duane T. and Uchino, Bert N. and Fabrigar, Leandre R.}, title={{The problem of equivalent models in applications of covariance structure analysis}}, journal={Psychological Bulletin}, year={1993}, volume={114}, number={1}, pages={185--199}, doi={10.1037/0033-2909.114.1.185}}@article{mackinnon2004confidence, author={MacKinnon, David P. and Lockwood, Chondra M. and Williams, Jason}, title={{Confidence limits for the indirect effect: Distribution of the product and resampling methods}}, journal={Multivariate Behavioral Research}, year={2004}, volume={39}, number={1}, pages={99--128}, doi={10.1207/s15327906mbr3901_4}}@article{mcdonald2002principles, author={McDonald, Roderick P. and Ho, Moon-Ho Ringo}, title={{Principles and practice in reporting structural equation analyses}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={64--82}, doi={10.1037/1082-989x.7.1.64}}@article{merkle2016testing, author={Merkle, Edgar C. and You, Dongjun and Preacher, Kristopher J.}, title={{Testing nonnested structural equation models}}, journal={Psychological Methods}, year={2016}, volume={21}, number={2}, pages={151--163}, doi={10.1037/met0000038}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{streiner2005finding, author={Streiner, David L.}, title={{Finding our way: An introduction to path analysis}}, journal={The Canadian Journal of Psychiatry}, year={2005}, volume={50}, number={2}, pages={115--122}, doi={10.1177/070674370505000207}}