Co to jest analiza ścieżek?
Analiza ścieżek (ang. path analysis) to układ równań regresji dla zmiennych obserwowalnych, szacowany jako jeden model. Zmienna może być w nim jednocześnie skutkiem jednej zmiennej i przyczyną kolejnej, więc model opisuje łańcuchy wpływu, np. wsparcie → motywacja → zaangażowanie. Metodę współczynników ścieżek opisał Wright (1934). Dziś to szczególny przypadek SEM bez zmiennych latentnych, a model zapisuje się zwykle jako wykres ścieżkowy.
Ścieżki, efekty i dopasowanie
Każda strzałka to współczynnik regresji. Iloczyn ścieżek wzdłuż łańcucha daje efekt pośredni, a jego suma z efektem bezpośrednim – efekt całkowity; to ta sama logika co w analizie mediacji, tylko w większym układzie. Gdy z modelu usunięto część możliwych ścieżek, ma on dodatnie stopnie swobody i można ocenić jego dopasowanie (χ², CFI, RMSEA, SRMR) – warunki opisuje hasło identyfikacja modelu SEM. Streiner (2005) podkreśla, że dobre dopasowanie mówi tylko, że dane są zgodne z modelem, a nie że model jest przyczynowo prawdziwy.
Przykład
W symulowanych danych (n = 300) wsparcie i autonomia wpływały na motywację, a ta na zaangażowanie, bez ścieżek bezpośrednich. Model w pakiecie lavaan (Rosseel, 2012) dopasował się dobrze: χ²(2) = 0.98, p = .612, CFI = 1.000, RMSEA = 0.000, SRMR = .015. Ścieżki standaryzowane: wsparcie → motywacja β = .39, autonomia → motywacja β = .23, motywacja → zaangażowanie β = .52. Efekt pośredni wsparcia wyniósł 0.27, 95% CI bootstrap [0.19, 0.35]. Dodanie ścieżki bezpośredniej nie poprawiło modelu: Δχ²(1) = 0.27, p = .606.
Na rysunku
Ten sam model z przykładu pokazano dwa razy: jako diagram z oszacowaniami i jako wykres współczynników z przedziałami z 2000 prób bootstrapowych. Diagram mówi, co jest w modelu, a wykres – jak dokładnie oszacowano każdy efekt.
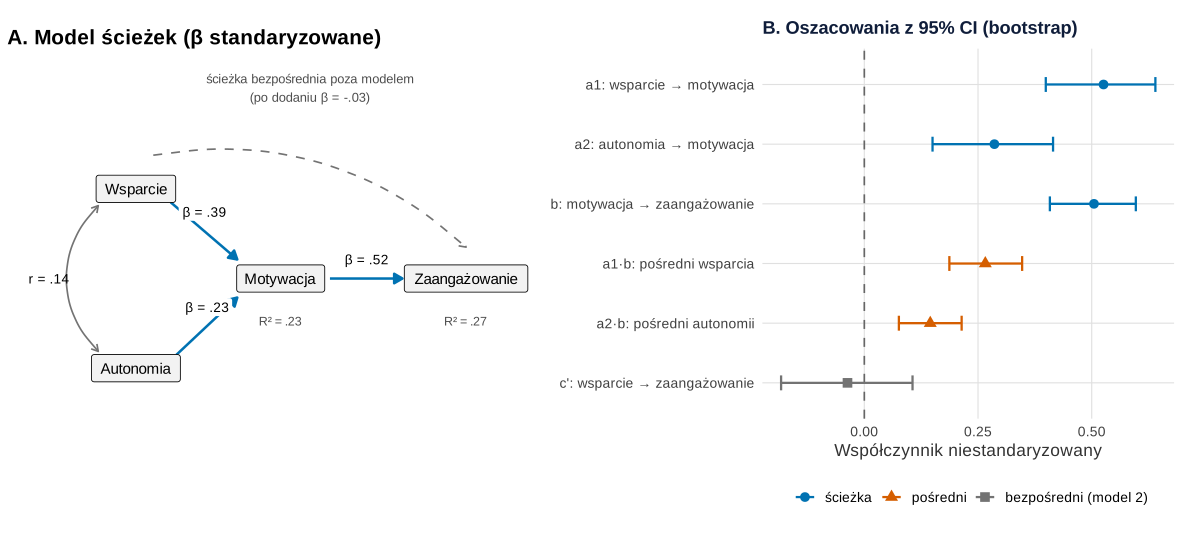
set.seed(3731), 2000 prób bootstrapowych).Co widać. Każda strzałka na diagramie (A) to jedno równanie regresji z β standaryzowanym: wsparcie → motywacja .39, autonomia → motywacja .23, motywacja → zaangażowanie .52. Predyktory wyjaśniają 23% zmienności motywacji i 27% zaangażowania. Łuk z dwoma grotami to korelacja wsparcia z autonomią (r = .14), a nie wpływ. Przerywana strzałka to ścieżka bezpośrednia, której w modelu nie ma; po jej dodaniu β = −.03. Na wykresie (B) oba efekty pośrednie mają przedziały nad zerem: 0.27 [0.19, 0.35] dla wsparcia i 0.15 [0.08, 0.21] dla autonomii. Przedział ścieżki bezpośredniej, −0.04 [−0.18, 0.11], obejmuje zero.
Na co uważać. Diagram wygląda jak schemat przyczyn, ale kierunek strzałek pochodzi z założeń. Model z inaczej ustawionymi strzałkami może pasować do danych tak samo dobrze. β standaryzowane zależą od wariancji zmiennych w próbie, więc do porównań między grupami lepsze są współczynniki niestandaryzowane z panelu B. Przedział c′ obejmujący zero nie dowodzi, że efektu bezpośredniego nie ma; jest zgodny także z małym efektem w obu kierunkach. Zasady rysowania diagramu opisuje hasło wykres ścieżkowy, a efekty pośrednie na wykresach rozrzutu i w bootstrapie pokazuje wpis Mediacja w obrazkach.
Podpis do pracy:
Kod poniżej odtwarza rysunek i liczby z tego akapitu (obliczenia trwają około 40 s). Współczynniki w danych ustawiono ręcznie, tak jak w przykładzie; ziarno 3731 ustalono raz i nie zmieniano. Kod definiuje sam paletę Okabe–Ito i motyw. Rysunek na stronie powstał z tych samych obiektów pA i pB, a panel B dostał motyw serwisu – dane, geometrie i skale są identyczne, różni się tylko krój czcionki i siatka.
Kod R rysunku 1
# Rysunek 1. Model ścieżek z oszacowaniami (A) i efekty z 95% przedziałami bootstrapowymi (B)
suppressPackageStartupMessages(library(lavaan))
library(ggplot2)
library(patchwork)
okabe <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", szary = "grey45")
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))

set.seed(3731)                                          # te same dane co w przykładzie hasła
n <- 300
wsparcie   <- rnorm(n)
autonomia  <- 0.3 * wsparcie + rnorm(n)
motywacja  <- 0.40 * wsparcie + 0.35 * autonomia + rnorm(n)
zaangaz    <- 0.50 * motywacja + rnorm(n)
dane <- data.frame(wsparcie, autonomia, motywacja, zaangaz)
model <- '
  motywacja ~ a1 * wsparcie + a2 * autonomia
  zaangaz   ~ b * motywacja
  ind_wsparcie  := a1 * b
  ind_autonomia := a2 * b
'
fit <- sem(model, data = dane, se = "bootstrap", bootstrap = 2000)
pe  <- parameterEstimates(fit, boot.ci.type = "perc", standardized = TRUE)
# model ze ścieżką bezpośrednią (do porównania): c' też z bootstrapem
fit2 <- sem(paste(model, "zaangaz ~ c * wsparcie"), data = dane, se = "bootstrap", bootstrap = 2000)
pe2  <- parameterEstimates(fit2, boot.ci.type = "perc", standardized = TRUE)
c_bezp <- pe2[pe2$label == "c", ]
r2 <- inspect(fit, "r2")
efekty <- rbind(pe[pe$label %in% c("a1", "a2", "b", "ind_wsparcie", "ind_autonomia"),
                   c("label", "est", "ci.lower", "ci.upper", "std.all")],
                c_bezp[, c("label", "est", "ci.lower", "ci.upper", "std.all")])
efekty[, -1] <- round(efekty[, -1], 3)
efekty
round(c(r_wsp_aut = cor(wsparcie, autonomia), r2), 3)

fmt <- function(x) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = 2))
beta <- setNames(pe$std.all, pe$label)
wezly <- data.frame(x = c(0, 0, 2.5, 5.7), y = c(1.6, 0, 0.8, 0.8),
                    et = c("Wsparcie", "Autonomia", "Motywacja", "Zaangażowanie"))
sciezki <- data.frame(x = c(0.6, 0.7, 3.35), y = c(1.48, 0.12, 0.8), xend = c(1.75, 1.75, 4.6),
                      yend = c(0.97, 0.63, 0.8), et = paste0("β = ", fmt(beta[c("a1", "a2", "b")])))
pA <- ggplot() +
  geom_curve(aes(x = -0.65, y = 1.45, xend = -0.65, yend = 0.15), curvature = 0.45,
             arrow = arrow(length = unit(2, "mm"), ends = "both"), colour = okabe[["szary"]]) +
  annotate("text", x = -1.5, y = 0.8, label = paste0("r = ", fmt(cor(wsparcie, autonomia))), size = 3.6) +
  geom_curve(aes(x = 0.3, y = 1.9, xend = 5.7, yend = 1.08), curvature = -0.25, linetype = "dashed",
             arrow = arrow(length = unit(2, "mm")), colour = okabe[["szary"]]) +
  annotate("text", x = 3, y = 2.5, size = 3.4, colour = "grey30",
           label = paste0("ścieżka bezpośrednia poza modelem\n(po dodaniu β = ", fmt(c_bezp$std.all), ")")) +
  geom_segment(data = sciezki, aes(x, y, xend = xend, yend = yend), linewidth = 0.9,
               colour = okabe[["niebieski"]], arrow = arrow(length = unit(2.5, "mm"), type = "closed")) +
  geom_label(data = sciezki, aes((x + xend) / 2, (y + yend) / 2 + 0.17, label = et), size = 3.6,
             linewidth = 0, fill = "white") +
  geom_label(data = wezly, aes(x, y, label = et), size = 4, label.padding = unit(0.45, "lines"),
             fill = "grey95") +
  annotate("text", x = c(2.5, 5.7), y = 0.42, size = 3.3, colour = "grey30",
           label = paste0("R² = ", fmt(r2[c("motywacja", "zaangaz")]))) +
  coord_cartesian(xlim = c(-1.8, 6.6), ylim = c(-0.3, 2.7)) +
  labs(title = "A. Model ścieżek (β standaryzowane)") +
  theme_void(base_size = 13) + theme(plot.title = element_text(face = "bold"))

efekty$rodzaj <- factor(ifelse(grepl("ind", efekty$label), "pośredni", ifelse(efekty$label == "c", "bezpośredni (model 2)", "ścieżka")),
                        levels = c("ścieżka", "pośredni", "bezpośredni (model 2)"))
efekty$nazwa <- factor(c("a1: wsparcie → motywacja", "a2: autonomia → motywacja", "b: motywacja → zaangażowanie",
                         "a1·b: pośredni wsparcia", "a2·b: pośredni autonomii", "c': wsparcie → zaangażowanie"),
                       levels = rev(c("a1: wsparcie → motywacja", "a2: autonomia → motywacja", "b: motywacja → zaangażowanie",
                                      "a1·b: pośredni wsparcia", "a2·b: pośredni autonomii", "c': wsparcie → zaangażowanie")))
pB <- ggplot(efekty, aes(est, nazwa, colour = rodzaj, shape = rodzaj)) +
  geom_vline(xintercept = 0, linetype = "dashed", colour = "grey40") +
  geom_errorbar(aes(xmin = ci.lower, xmax = ci.upper), width = 0.25, orientation = "y", linewidth = 0.8) +
  geom_point(size = 3) +
  scale_colour_manual(values = unname(okabe[c("niebieski", "cynober", "szary")]), name = NULL) +
  scale_shape_manual(values = c(16, 17, 15), name = NULL) +
  guides(colour = guide_legend(nrow = 1), shape = guide_legend(nrow = 1)) +
  labs(title = "B. Oszacowania z 95% CI (bootstrap)", x = "Współczynnik niestandaryzowany", y = NULL) +
  motyw
p1 <- pA + pB + plot_layout(widths = c(1.3, 1))
p1   # zapis: ggsave("analiza-sciezek-model-i-efekty.svg", p1, width = 12.5, height = 5.6)
Wynik w R
           label    est ci.lower ci.upper std.all
1             a1  0.526    0.399    0.640   0.391
2             a2  0.286    0.150    0.415   0.228
3              b  0.505    0.408    0.597   0.521
9   ind_wsparcie  0.266    0.187    0.347   0.204
10 ind_autonomia  0.145    0.076    0.214   0.119
4              c -0.037   -0.183    0.106  -0.028
r_wsp_aut motywacja   zaangaz
    0.139     0.230     0.271
Jak opisać w pracy
Na co uważać
- Strzałka to założenie. Kierunek wpływu pochodzi z teorii i schematu badania, nie z danych przekrojowych.
- Błąd pomiaru. Sumy skal traktowane jak bezbłędne zaniżają ścieżki; przy kilku wskaźnikach lepszy jest pełny SEM.
- Modele równoważne. Inny układ strzałek może dać identyczne dopasowanie.
Cały model krok po kroku pokazuje wpis Analiza ścieżek w lavaan, a rysowanie hipotez – Model badawczy. Modele z czynnikami opisuje CB-SEM w R.
Analiza ścieżek w R
Kod symuluje dane, dopasowuje model ścieżek w lavaan z bootstrapowymi przedziałami dla efektów pośrednich i porównuje go z modelem ze ścieżką bezpośrednią.
Wsparcie i autonomia → motywacja → zaangażowanie
R
suppressPackageStartupMessages(library(lavaan))
set.seed(3731)
n <- 300
wsparcie   <- rnorm(n)                                  # X1: wsparcie społeczne
autonomia  <- 0.3 * wsparcie + rnorm(n)                 # X2: autonomia w pracy
motywacja  <- 0.40 * wsparcie + 0.35 * autonomia + rnorm(n)   # M: motywacja
zaangaz    <- 0.50 * motywacja + rnorm(n)               # Y: zaangażowanie
dane <- data.frame(wsparcie, autonomia, motywacja, zaangaz)

model <- '
  motywacja ~ a1 * wsparcie + a2 * autonomia
  zaangaz   ~ b * motywacja
  ind_wsparcie  := a1 * b
  ind_autonomia := a2 * b
'
fit <- sem(model, data = dane, se = "bootstrap", bootstrap = 2000)
fitMeasures(fit, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr"))
pe <- parameterEstimates(fit, boot.ci.type = "perc", standardized = TRUE)
pe[pe$op %in% c("~", ":="), c("lhs", "op", "rhs", "est", "se", "ci.lower", "ci.upper", "std.all")]

# model alternatywny z bezpośrednią ścieżką wsparcie -> zaangażowanie
fit0 <- sem(model, data = dane)
fit2 <- sem(paste(model, "zaangaz ~ wsparcie"), data = dane)
anova(fit2, fit0)
Wynik w R
 chisq     df pvalue    cfi  rmsea   srmr
 0.981  2.000  0.612  1.000  0.000  0.015
             lhs op       rhs   est    se ci.lower ci.upper std.all
1      motywacja  ~  wsparcie 0.526 0.062    0.399    0.640   0.391
2      motywacja  ~ autonomia 0.286 0.068    0.150    0.415   0.228
3        zaangaz  ~ motywacja 0.505 0.047    0.408    0.597   0.521
9   ind_wsparcie :=      a1*b 0.266 0.041    0.187    0.347   0.204
10 ind_autonomia :=      a2*b 0.145 0.035    0.076    0.214   0.119

Chi-Squared Difference Test

     Df    AIC    BIC  Chisq Chisq diff RMSEA Df diff Pr(>Chisq)
fit2  1 1765.5 1787.8 0.7151
fit0  2 1763.8 1782.3 0.9813    0.26623     0       1     0.6059
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet lavaan). Rysunek 1 wykonano w pakietach ggplot2 i patchwork i zapisano pakietem svglite. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze pytania
Czym analiza ścieżek różni się od kilku osobnych regresji?
W prostym modelu rekursywnym współczynniki zwykle są takie same jak w osobnych regresjach. Różnica polega na tym, że model szacowany naraz daje błędy standardowe i przedziały dla efektów pośrednich i całkowitych oraz test dopasowania, który mówi, czy pominięte ścieżki są zgodne z danymi.
Kiedy model ścieżek ma zero stopni swobody?
Gdy zawiera wszystkie możliwe ścieżki i kowariancje, np. pełną mediację z trzema zmiennymi i ścieżką bezpośrednią. Taki model odtwarza dane idealnie, więc χ², CFI i RMSEA nic nie mówią; dopasowanie da się ocenić dopiero po usunięciu części ścieżek.
Czy analiza ścieżek dowodzi przyczynowości?
Nie. Pokazuje, czy dane są zgodne z założonym układem strzałek (Streiner, 2005). O przyczynowości decyduje schemat badania: kolejność pomiarów, manipulacja eksperymentalna i kontrola zmiennych zakłócających.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza ścieżek w lavaan krok po kroku
Model na zmiennych obserwowalnych: identyfikacja i df, dopasowanie, efekty pośrednie i całkowite z bootstrapem, modele zagnieżdżone i alternatywne.
Czytaj →PoradnikModel badawczy – schemat hipotez
Prostokąty i strzałki, mediator na ścieżce, moderator strzałką na strzałkę, zmienne kontrolne i hipotezy H1–Hn – z trzema wzorami rysunków i wskazówką, jaką analizą sprawdzić model.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Streiner, D. L. (2005). Finding our way: An introduction to path analysis. The Canadian Journal of Psychiatry, 50(2), 115–122. https://doi.org/10.1177/070674370505000207 ● Otwarty dostęp
- Wright, S. (1934). The method of path coefficients. The Annals of Mathematical Statistics, 5(3), 161–215. https://doi.org/10.1214/aoms/1177732676 ● Otwarty dostęp
Cytowania BibTeX
@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{streiner2005finding, author={Streiner, David L.}, title={{Finding our way: An introduction to path analysis}}, journal={The Canadian Journal of Psychiatry}, year={2005}, volume={50}, number={2}, pages={115--122}, doi={10.1177/070674370505000207}}@article{wright1934method, author={Wright, Sewall}, title={{The method of path coefficients}}, journal={The Annals of Mathematical Statistics}, year={1934}, volume={5}, number={3}, pages={161--215}, doi={10.1214/aoms/1177732676}}