Co to jest wykres ścieżkowy?
Wykres ścieżkowy (diagram ścieżkowy, ang. path diagram) to graficzny zapis modelu równań strukturalnych, analizy ścieżek albo CFA. Każdy element rysunku odpowiada jednemu elementowi modelu: zmiennej, parametrowi albo założeniu. Strzałka oznacza oszacowany parametr. Brak strzałki to założenie, że dany związek wynosi zero. Dobrze narysowany wykres jest więc pełnym opisem modelu, z którego da się odtworzyć składnię w programie. Gdy wszystkie zmienne na wykresie są jawne, opisuje on analizę ścieżek, czyli układ kilku równań regresji wielorakiej szacowanych razem. Gdy pojawiają się owale, jest to pełny model SEM z częścią pomiarową.
Metoda pochodzi od genetyka Sewalla Wrighta. Wright (1934) przedstawił ją jako sposób powiązania korelacji między zmiennymi z zakładanymi między nimi zależnościami, opisanymi strzałkami. W psychologii wykres ścieżkowy jest standardową częścią raportu z SEM. McDonald i Ho (2002) podkreślają, że raport powinien szczegółowo uzasadniać przyjęty model i modele alternatywne, a rysunek pozwala to zrobić najprościej.
Symbole na wykresie ścieżkowym
| Symbol | Znaczenie | Składnia lavaan |
|---|---|---|
| Prostokąt | zmienna jawna (obserwowana): pozycja kwestionariusza, wynik testu, wiek, liczba godzin | nazwa kolumny w danych |
| Owal (elipsa) | zmienna ukryta (latentna), np. stres, inteligencja | nazwa po lewej stronie =~ |
| Strzałka od owalu do prostokąta | ładunek czynnikowy – cecha ukryta wpływa na odpowiedź (model refleksyjny) | STR =~ s1 + s2 + s3 |
| Strzałka jednokierunkowa między zmiennymi | ścieżka (współczynnik regresji) od przyczyny do skutku | STR ~ WSP + praca |
| Łuk ze strzałkami na obu końcach | kowariancja lub korelacja bez założonego kierunku | WSP ~~ praca |
| Małe koło lub strzałka „znikąd” | błąd pomiaru wskaźnika (ε) albo zakłócenie zmiennej zależnej (ζ) – to, czego model nie wyjaśnia | dodawane automatycznie; s1 ~~ s1 |
| Trójkąt | stała – pojawia się, gdy model zawiera średnie lub wyrazy wolne | s1 ~ 1 |
Rosseel (2012) zaprojektował składnię lavaan tak, aby odpowiadała właśnie tym elementom. Model zapisujesz więc tak, jak rysujesz: =~ to strzałki pomiarowe, ~ – strukturalne, a ~~ – dwukierunkowe. Część wykresu z owalami i ich wskaźnikami to model pomiarowy. Strzałki między owalami (i jawnymi predyktorami) to model strukturalny.
Przykład: wsparcie, godziny pracy i stres
Trzystu pracujących studentów (dane symulowane) wypełniło skale wsparcia społecznego (3 pozycje, 1–7) i stresu (3 pozycje, 1–5) oraz podało tygodniową liczbę godzin pracy zarobkowej. Model zakłada, że wsparcie i godziny pracy wpływają na stres, a między sobą tylko korelują. Rysunek 1 pokazuje rozwiązanie standaryzowane z lavaan. Model pasował bardzo dobrze: χ²(12) = 6.96, p = .860, CFI = 1.000, RMSEA = .000, SRMR = .015.
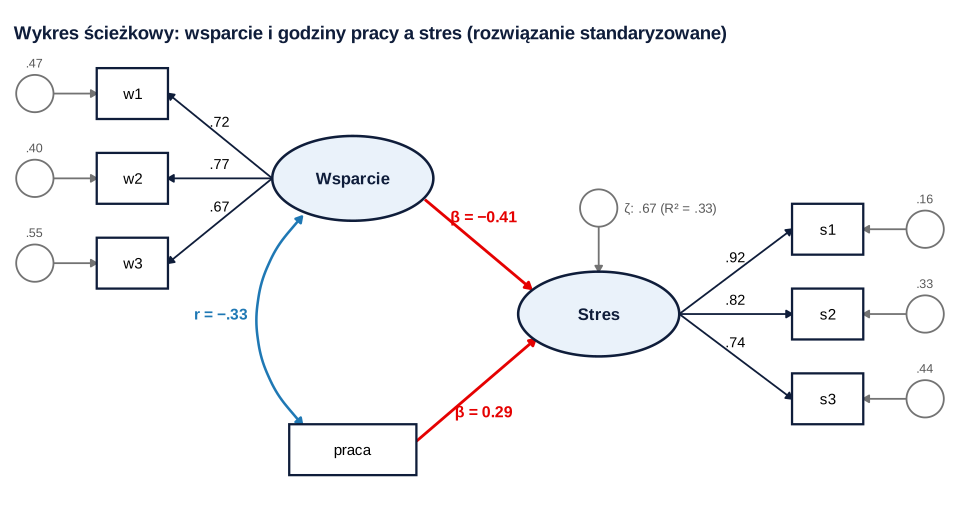
Wyższe wsparcie wiązało się z niższym stresem (β = −0.41), a więcej godzin pracy – z wyższym (β = 0.29). Oba predyktory wyjaśniały 33% wariancji stresu, bo zakłócenie ζ ma standaryzowaną wariancję .67. Kolor i grubość strzałek strukturalnych pomagają czytelnikowi od razu odróżnić hipotezy od części pomiarowej.
Reguła śledzenia ścieżek: jak wykres „produkuje” korelacje
Wykres ścieżkowy to także narzędzie rachunkowe. Według reguł Wrighta korelacja dwóch zmiennych odtworzona przez model (standaryzowany) równa się sumie iloczynów współczynników wzdłuż wszystkich dopuszczalnych dróg między nimi. Droga jest dopuszczalna, gdy:
- przechodzi przez każdą zmienną najwyżej raz,
- zawiera najwyżej jedną strzałkę dwukierunkową,
- nie idzie najpierw „z prądem”, a potem „pod prąd” strzałek (nie przechodzi przez wspólny skutek).
Dla pozycji w1 (wsparcie) i s1 (stres) są dwie takie drogi:
- w1 ← Wsparcie → Stres → s1: 0.724 × (−0.407) × 0.916 = −0.270;
- w1 ← Wsparcie ↔ praca → Stres → s1: 0.724 × (−0.332) × 0.290 × 0.916 = −0.064.
Suma −0.334 to dokładnie korelacja w1–s1 odtworzona przez lavaan. W próbie ta korelacja wynosiła −.372. Różnica to reszta, z której liczy się wskaźniki dopasowania, np. SRMR. Ta sama logika tłumaczy, jak w modelu mediacji powstaje efekt pośredni (iloczyn ścieżek) i efekt całkowity (suma dróg).
Wykres ułatwia też liczenie stopni swobody. Siedem zmiennych jawnych daje 7 × 8 / 2 = 28 wariancji i kowariancji. Model szacuje 16 parametrów: 4 swobodne ładunki (po jednym na czynnik ustalono na 1), 2 ścieżki, 1 kowariancję, 6 wariancji błędów, wariancję czynnika Wsparcie, wariancję godzin pracy i wariancję zakłócenia. Zostaje df = 12. Gdy parametrów jest więcej niż informacji w danych, model nie jest identyfikowalny (zob. identyfikacja modelu SEM).
Jak narysować czytelny wykres – lista kontrolna
- Narysuj model przed analizą, na podstawie hipotez. Wykres rysowany dopiero z wyników łatwo „dopasować” do danych.
- Ustaw kierunek czytania: zmienne egzogeniczne (przyczyny) po lewej, zależne po prawej, mediatory pośrodku. Strzałki strukturalne powinny biec w jedną stronę.
- Wskaźniki umieść na zewnątrz modelu: po lewej przy czynnikach egzogenicznych, po prawej przy zależnych. Przy wielu czynnikach możesz pokazać tylko model strukturalny i odesłać do tabeli ładunków.
- Zaznacz wszystkie parametry swobodne, także kowariancje predyktorów i reszt. Ustalone parametry (np. ładunek = 1) oznacz w nocie.
- Wyróżnij hipotezy kolorem albo grubością linii, a ścieżki nieistotne – linią przerywaną.
- Sprawdź zgodność ze składnią: każda strzałka ma swój wiersz w modelu, a każdy wiersz – strzałkę.
Jak umieścić wykres ścieżkowy w pracy (APA)
Wykres to w APA rysunek: numer pogrubiony, tytuł kursywą w nowym wierszu, pod spodem nota. W nocie wyjaśnij symbole, napisz, czy współczynniki są standaryzowane, jak oznaczono istotność i co pominięto (np. błędy pomiaru) – tak jak w poniższym wzorze. Na wykresie umieść tylko te liczby, których czytelnik potrzebuje. Pełną tabelę parametrów daj osobno.
Model z wykresu w R (lavaan)
Kod tworzy dane z przykładu, zapisuje model ze wzoru na wykresie i wypisuje parametry standaryzowane, czyli liczby z rysunku 1. Sprawdza też regułę śledzenia ścieżek dla pary w1–s1 i liczy stopnie swobody. Na końcu rysuje szybki szkic wykresu w pakiecie semPlot. Do pracy lepiej przygotować rysunek starannie, bo automatyczne układy bywają nieczytelne.
Od wykresu do składni i z powrotem
R
suppressPackageStartupMessages(library(lavaan))   # SEM

# Dane symulowane: 300 studentów pracujących zarobkowo. Wsparcie społeczne (WSP, pozycje w1–w3, 1–7),
# liczba godzin pracy tygodniowo (praca – zmienna jawna) i stres (STR, pozycje s1–s3, 1–5).
set.seed(143)
populacja <- '
  WSP =~ 0.80*w1 + 0.75*w2 + 0.70*w3
  STR =~ 0.85*s1 + 0.75*s2 + 0.70*s3
  STR ~ -0.40*WSP + 0.30*praca
  WSP ~~ -0.25*praca
'
z <- simulateData(populacja, sample.nobs = 300, standardized = TRUE)
dane <- data.frame(
  w1 = round(5 + 1.2 * z$w1), w2 = round(5 + 1.2 * z$w2), w3 = round(5 + 1.3 * z$w3),
  s1 = round(3 + 0.9 * z$s1), s2 = round(3 + 0.9 * z$s2), s3 = round(3 + 1.0 * z$s3),
  praca = round(16 + 7 * z$praca))
dane[, 1:3] <- lapply(dane[, 1:3], function(x) pmin(pmax(x, 1), 7))
dane[, 4:6] <- lapply(dane[, 4:6], function(x) pmin(pmax(x, 1), 5))
dane$praca <- pmax(dane$praca, 2)

model <- '
  WSP =~ w1 + w2 + w3          # model pomiarowy: owale -> prostokąty
  STR =~ s1 + s2 + s3
  STR ~ WSP + praca            # model strukturalny: strzałki jednokierunkowe
  WSP ~~ praca                 # kowariancja: strzałka dwukierunkowa
'
fit <- sem(model, data = dane)

# 1. Dopasowanie i rozwiązanie standaryzowane (liczby na wykresie)
round(fitMeasures(fit, c("chisq", "df", "pvalue", "cfi", "rmsea", "srmr")), 3)
std <- standardizedSolution(fit)
std$est.std <- round(std$est.std, 3)
std[std$op %in% c("=~", "~", "~~"), c("lhs", "op", "rhs", "est.std", "pvalue")]

# 2. Reguła śledzenia ścieżek (Wright): korelacja w1–s1 odtworzona przez model
e <- setNames(std$est.std, paste(std$lhs, std$op, std$rhs))
droga1 <- e["WSP =~ w1"] * e["STR ~ WSP"] * e["STR =~ s1"]                      # w1 <- WSP -> STR -> s1
droga2 <- e["WSP =~ w1"] * e["WSP ~~ praca"] * e["STR ~ praca"] * e["STR =~ s1"] # w1 <- WSP <-> praca -> STR -> s1
implik <- lavInspect(fit, "cor.ov")["w1", "s1"]
round(c(droga_1 = unname(droga1), droga_2 = unname(droga2), suma = unname(droga1 + droga2),
        lavaan_odtworzona = implik, w_probie = cor(dane$w1, dane$s1)), 3)

# 3. Liczba „kropek” danych i parametrów (stopnie swobody)
p <- 7
c(momenty = p * (p + 1) / 2, parametry = lavInspect(fit, "npar"), df = fitMeasures(fit, "df"))

# 4. Szybki szkic wykresu ścieżkowego z pakietu semPlot (do sprawdzenia modelu, nie do pracy)
suppressPackageStartupMessages(library(semPlot))
png(tempfile(fileext = ".png"), width = 900, height = 600)
semPaths(fit, what = "std", layout = "tree2", rotation = 2, edge.label.cex = 1.1, residuals = TRUE)
invisible(dev.off())
Wynik w R
 chisq     df pvalue    cfi  rmsea   srmr
 6.962 12.000  0.860  1.000  0.000  0.015
     lhs op   rhs est.std pvalue
1    WSP =~    w1   0.724      0
2    WSP =~    w2   0.773      0
3    WSP =~    w3   0.669      0
4    STR =~    s1   0.916      0
5    STR =~    s2   0.817      0
6    STR =~    s3   0.745      0
7    STR  ~   WSP  -0.407      0
8    STR  ~ praca   0.290      0
9    WSP ~~ praca  -0.332      0
10    w1 ~~    w1   0.475      0
11    w2 ~~    w2   0.403      0
12    w3 ~~    w3   0.553      0
13    s1 ~~    s1   0.161      0
14    s2 ~~    s2   0.332      0
15    s3 ~~    s3   0.444      0
16 praca ~~ praca   1.000     NA
17   WSP ~~   WSP   1.000     NA
18   STR ~~   STR   0.672      0
          droga_1           droga_2              suma lavaan_odtworzona
           -0.270            -0.064            -0.334            -0.334
         w_probie
           -0.372
  momenty parametry     df.df
       28        16        12
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek 1 przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- semPlot (wersja 1.1.8): Epskamp, S. (2026). semPlot: Path diagrams and visual analysis of various SEM packages' output [R package]. https://doi.org/10.32614/CRAN.package.semPlot
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Czytanie strzałek jako dowodu przyczynowości. Strzałka to założenie badacza, a nie wynik analizy. Rohrer i in. (2022) pokazują, że odwrócenie strzałek czy porównanie dopasowania modeli nie rozstrzyga, który kierunek jest prawdziwy. W badaniu przekrojowym pisz o związkach.
- Wykres niezgodny z oszacowanym modelem, np. bez kowariancji, którą program dodał automatycznie, albo z kowariancją reszt dorysowaną „dla porządku”. Brak strzałki to także hipoteza.
- Mieszanie współczynników standaryzowanych i niestandaryzowanych na jednym rysunku bez informacji w nocie.
- Kierunek strzałek pomiarowych niezgodny z teorią. W modelu refleksyjnym strzałki biegną od owalu do wskaźników, a w formatywnym – odwrotnie (zob. modele refleksyjne i formatywne).
- Przeładowanie rysunku wariancjami, progami i wszystkimi wartościami p. Ważne liczby zostaw na wykresie, pozostałe przenieś do tabeli.
Jak rysować i opisywać pełny model od hipotez po raport, pokazuje poradnik modelowanie równań strukturalnych (SEM). Ten sam model w lavaan krok po kroku znajdziesz w CB-SEM w R.
Najczęstsze pytania
Co oznacza owal, a co prostokąt na wykresie ścieżkowym?
Prostokąt oznacza zmienną jawną – coś, co zmierzyłeś bezpośrednio, np. odpowiedź na pozycję albo liczbę godzin pracy. Owal oznacza zmienną ukrytą – cechę, której nie obserwujesz wprost i którą model szacuje na podstawie kilku wskaźników.
Czym różni się strzałka jednokierunkowa od dwukierunkowej w SEM?
Strzałka jednokierunkowa to zakładana zależność kierunkowa: ładunek (od czynnika do wskaźnika) albo ścieżka regresyjna (od predyktora do zmiennej zależnej). Łuk ze strzałkami na obu końcach to kowariancja lub korelacja – związek bez założonego kierunku, np. między dwoma predyktorami.
W jakim programie narysować wykres ścieżkowy do pracy?
Szkic wygenerujesz automatycznie z wyników (w R np. pakietem semPlot, w AMOS – w oknie modelu), ale do pracy lepiej przygotować rysunek ręcznie w edytorze grafiki lub w R, z czytelnym układem i tylko potrzebnymi liczbami. Ważne, by rysunek dokładnie odpowiadał oszacowanemu modelowi.
Czy strzałki na wykresie ścieżkowym oznaczają związek przyczynowy?
Nie same z siebie. Strzałka wyraża założenie badacza o kierunku zależności; dobre dopasowanie modelu nie dowodzi, że ten kierunek jest prawdziwy, bo modele z odwróconymi strzałkami często pasują równie dobrze. Wnioski przyczynowe wymagają odpowiedniego planu badania.
Jak podpisać wykres ścieżkowy w pracy według APA?
Jako rysunek: numer pogrubiony, tytuł kursywą w nowym wierszu, a pod rysunkiem nota z objaśnieniem symboli, informacją, czy współczynniki są standaryzowane, oznaczeniem istotności i tym, co pominięto (np. błędy pomiaru). Wskaźniki dopasowania możesz dodać w nocie albo w tekście.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Modelowanie równań strukturalnych (SEM): od teorii do raportu
SEM bez skrótów myślowych: model pomiarowy i strukturalny, CB-SEM a PLS-SEM, dopasowanie, założenia oraz raportowanie wyników.
Czytaj →PoradnikCB-SEM w R: kompletny przykład w pakiecie lavaan
Odtwarzalny przykład CB-SEM w R i lavaan: model pomiarowy, ścieżki, MLR, FIML, wskaźniki dopasowania, reszty i interpretacja APA 7.
Czytaj →PoradnikAnaliza mediacji krok po kroku
Hipoteza, ścieżki a, b, c′, efekt pośredni z bootstrapem, PROCESS w SPSS, lavaan w R, dwa mediatory, moc i gotowy opis APA – na jednym przykładzie.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- McDonald, R. P., & Ho, M.-H. R. (2002). Principles and practice in reporting structural equation analyses. Psychological Methods, 7(1), 64–82. https://doi.org/10.1037/1082-989x.7.1.64
- Rohrer, J. M., Hünermund, P., Arslan, R. C., & Elson, M. (2022). That’s a lot to process! Pitfalls of popular path models. Advances in Methods and Practices in Psychological Science, 5(2), Article 25152459221095827. https://doi.org/10.1177/25152459221095827 ● Otwarty dostęp
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02 ● Otwarty dostęp
- Wright, S. (1934). The method of path coefficients. The Annals of Mathematical Statistics, 5(3), 161–215. https://doi.org/10.1214/aoms/1177732676 ● Otwarty dostęp
Cytowania BibTeX
@article{mcdonald2002principles, author={McDonald, Roderick P. and Ho, Moon-Ho Ringo}, title={{Principles and practice in reporting structural equation analyses}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={64--82}, doi={10.1037/1082-989x.7.1.64}}@article{rohrer2022process, author={Rohrer, Julia M. and Hünermund, Paul and Arslan, Ruben C. and Elson, Malte}, title={{That’s a lot to process! Pitfalls of popular path models}}, journal={Advances in Methods and Practices in Psychological Science}, year={2022}, volume={5}, number={2}, eid={25152459221095827}, doi={10.1177/25152459221095827}}@article{rosseel2012lavaan, author={Rosseel, Yves}, title={{lavaan: An R package for structural equation modeling}}, journal={Journal of Statistical Software}, year={2012}, volume={48}, number={2}, pages={1--36}, doi={10.18637/jss.v048.i02}}@article{wright1934method, author={Wright, Sewall}, title={{The method of path coefficients}}, journal={The Annals of Mathematical Statistics}, year={1934}, volume={5}, number={3}, pages={161--215}, doi={10.1214/aoms/1177732676}}