Co to jest zmienna jawna?
Zmienna jawna (obserwowana, mierzalna; ang. manifest variable, observed variable) to zmienna, której wartości masz bezpośrednio w zbiorze danych – jako kolumnę. Może to być odpowiedź na pozycję kwestionariusza, wynik testu, czas reakcji, wiek, liczba godzin snu albo przynależność do grupy. W modelach SEM zmienną jawną przeciwstawia się zmiennej ukrytej, której nie mierzy się wprost i którą model szacuje na podstawie kilku zmiennych jawnych. Na wykresie ścieżkowym zmienne jawne rysuje się jako prostokąty.
„Jawna” nie znaczy „bezbłędna”. Odpowiedź na pozycję „Czuję się częścią mojej grupy” zawiera i poczucie przynależności, i błąd pomiaru: nastrój, interpretację słów, pośpiech. Bollen (2002) pokazuje, że różne definicje zmiennej ukrytej różnią się właśnie tym, jak opisują jej związek ze zmiennymi obserwowanymi. Edwards i Bagozzi (2000) zwracają uwagę, że relację konstruktu i miary trzeba określić z góry: zwykle konstrukt jest przyczyną odpowiedzi, ale bywa odwrotnie.
Zmienne jawne w innych analizach
Pojęcie zmiennej jawnej przydaje się także poza SEM, bo pozwala nazwać założenie, które w wielu analizach przyjmujemy po cichu:
- w regresji, ANOVA i teście t wszystkie zmienne są jawne i zakłada się, że predyktory zmierzono bez błędu,
- w analizie czynnikowej (EFA, CFA) zmienne jawne są wskaźnikami, a czynniki – zmiennymi ukrytymi,
- w IRT zmiennymi jawnymi są odpowiedzi na zadania (często 0/1), a zdolność jest cechą ukrytą,
- w analizie profili i klas ukrytych zmienne jawne służą do wyodrębnienia nieobserwowanych grup osób (zob. analiza profili latentnych).
Role zmiennych jawnych w modelu
| Rola | Przykład | Co warto wiedzieć |
|---|---|---|
| Wskaźnik refleksyjny | pozycja skali stresu | przejaw zmiennej ukrytej; ocenia się go przez ładunek |
| Wskaźnik formatywny | ocena wyposażenia sal jako składnik „warunków studiowania” | współtworzy konstrukt (zob. formatywna zmienna latentna) |
| Jawny predyktor lub wynik | liczba godzin pracy, średnia ocen | wchodzi do modelu strukturalnego bez części pomiarowej |
| Zmienna kontrolna | wiek, płeć | usuwa wpływ czynnika ubocznego (zob. zmienna kontrolna) |
| Wynik sumaryczny skali | suma 10 pozycji | też zmienna jawna, ale zawiera błąd pomiaru całej skali |
Ostatni wiersz ma duże znaczenie praktyczne. Gdy w regresji albo analizie ścieżek używasz sum skal, każda z nich jest zmienną jawną z błędem pomiaru. Związki między takimi zmiennymi są przez to osłabione, a w modelach z kilkoma predyktorami mogą być zniekształcone w obie strony. Modelowanie pozycji jako wskaźników zmiennej ukrytej oddziela ten błąd od cechy.
Zmienne jawne jako „dane” modelu
Model SEM nie analizuje surowych odpowiedzi, tylko wariancje i kowariancje zmiennych jawnych (czasem także ich średnie). Przy p zmiennych jawnych jest ich p(p + 1)/2. Liczba parametrów nie może przekroczyć tej liczby. Różnica to stopnie swobody modelu. Dla 6 pozycji mamy 21 wariancji i kowariancji, a model jednoczynnikowy szacuje 12 parametrów (5 ładunków, 6 wariancji błędów, wariancję czynnika), więc df = 9. Wynika z tego praktyczna zasada: czynnik z dwoma wskaźnikami nie jest identyfikowalny bez dodatkowych ograniczeń. Trzy wskaźniki to minimum, a cztery dają już możliwość sprawdzenia dopasowania (zob. identyfikacja modelu SEM).
Przykład: przegląd zmiennych jawnych przed CFA
Trzystu dwudziestu studentów (dane symulowane) odpowiedziało na 6 pozycji skali poczucia przynależności do grupy (1–5). Zanim dopasujesz model, obejrzyj każdą zmienną jawną (rysunek 1).
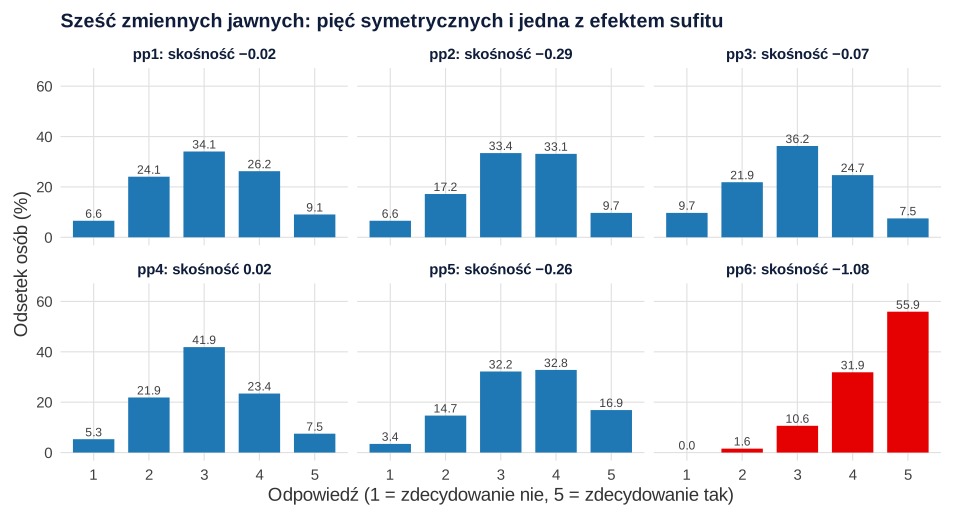
Pięć pozycji ma rozkłady zbliżone do symetrycznych (skośność od −0.29 do 0.02, kurtoza od −0.66 do −0.34). Pozycja pp6 („Lubię niektóre osoby z mojego roku”) jest dla badanych za łatwa: 55.9% wybrało 5, nikt nie wybrał 1, skośność wynosi −1.08. Test Mardii wskazał istotną wielowymiarową skośność (b1,p = 2.23, p < .001), ale nie kurtozę (b2,p = 46.36, p = .134). Cain i in. (2017) stwierdzili, że większość rozkładów w opublikowanych badaniach psychologicznych odbiega od normalności. Zalecają rutynowe raportowanie skośności i kurtozy. Jackson i in. (2009) pokazali z kolei, że w raportach CFA ocena normalności często jest pomijana.
Jak te cechy zmiennych jawnych wpływają na wynik? Porównaliśmy trzy estymatory jednoczynnikowej CFA:
| Estymator | Jak traktuje zmienne jawne | χ²(9) | p | Ładunek pp6 |
|---|---|---|---|---|
| ML | ciągłe, rozkład normalny | 8.98 | .439 | .443 |
| MLR | ciągłe, poprawka na nienormalność | 8.52 | .483 | .443 |
| WLSMV | porządkowe (progi, korelacje polichoryczne) | 8.72 | .464 | .515 |
Model pasował we wszystkich wersjach (CFI = 1.000, RMSEA = .000). Współczynnik skalujący MLR wyniósł 1.054, więc nienormalność była tu umiarkowana. Różnica pojawia się w ładunkach. Przy WLSMV ładunek pp6 wynosi .515, a przy ML – .443, bo efekt sufitu obniża zwykłą korelację tej pozycji z pozostałymi. Pozostałe ładunki też są przy WLSMV wyższe (np. .794 zamiast .759 dla pp1). Przy 5 kategoriach i prawie symetrycznych rozkładach oba podejścia są do obrony. Rhemtulla i in. (2012) wskazują, że przy 5 i więcej kategoriach odporny ML zwykle sprawdza się dobrze, a metody kategorialne mają przewagę przy mniejszej liczbie kategorii. Ważne, aby decyzję oprzeć na przeglądzie zmiennych jawnych i opisać ją w pracy.
Jak opisać zmienne jawne w pracy (APA)
W części „Analiza danych” podaj, jakie zmienne jawne weszły do modelu, ich poziom pomiaru, liczbę kategorii, statystyki opisowe (M, SD, skośność, kurtoza), test wielowymiarowej normalności i wynikający z tego wybór estymatora. Tabelę statystyk opisowych pozycji dołącz do wyników albo do aneksu.
Przegląd zmiennych jawnych w R
Kod tworzy dane z przykładu, opisuje każdą zmienną jawną (średnia, SD, skośność, kurtoza, liczba użytych kategorii) i wykonuje test Mardii. Liczy też liczbę wariancji i kowariancji, parametrów i stopni swobody oraz porównuje dopasowanie i ładunki przy ML, MLR i WLSMV. Liczby w tekście i na rysunku 1 pochodzą z tego kodu.
Statystyki opisowe, normalność i wybór estymatora
R
suppressPackageStartupMessages({library(lavaan); library(psych)})   # CFA; opis rozkładów i test Mardii

# Dane symulowane: 320 studentów, 6 pozycji skali poczucia przynależności do grupy (1–5).
# Pozycja pp6 („Lubię niektóre osoby z mojego roku”) jest bardzo łatwa – większość odpowiada 4 lub 5.
set.seed(144)
populacja <- 'przynaleznosc =~ 0.75*pp1 + 0.70*pp2 + 0.70*pp3 + 0.65*pp4 + 0.60*pp5 + 0.55*pp6'
z <- simulateData(populacja, sample.nobs = 320, standardized = TRUE)
srodek <- c(3.0, 3.2, 2.9, 3.1, 3.3, 4.6)
dane <- as.data.frame(mapply(function(x, m) pmin(pmax(round(m + 1.0 * x), 1), 5), z, srodek))

# 1. Opis zmiennych jawnych: średnia, SD, skośność, kurtoza (nadwyżkowa), liczba użytych kategorii
opis <- describe(dane)[, c("mean", "sd", "skew", "kurtosis")]
opis$kategorie <- sapply(dane, function(x) length(unique(x)))
round(opis, 2)
round(prop.table(table(dane$pp6)), 3)            # rozkład odpowiedzi na pp6

# 2. Wielowymiarowa normalność: test Mardii
m <- mardia(dane, plot = FALSE)
round(c(skosnosc_b1p = m$b1p, p_skosnosc = m$p.skew, kurtoza_b2p = m$b2p, p_kurtoza = m$p.kurt), 4)

# 3. Ile informacji dają zmienne jawne: p(p + 1)/2 wariancji i kowariancji a parametry modelu
p <- ncol(dane)
fit_ml  <- cfa('przynaleznosc =~ pp1 + pp2 + pp3 + pp4 + pp5 + pp6', data = dane)
c(momenty = p * (p + 1) / 2, parametry = lavInspect(fit_ml, "npar"), df = unname(fitMeasures(fit_ml, "df")))

# 4. Ten sam model: ML, MLR (odporny) i WLSMV (pozycje jako porządkowe)
fit_mlr <- cfa('przynaleznosc =~ pp1 + pp2 + pp3 + pp4 + pp5 + pp6', data = dane, estimator = "MLR")
fit_cat <- cfa('przynaleznosc =~ pp1 + pp2 + pp3 + pp4 + pp5 + pp6', data = dane, ordered = names(dane))
round(rbind(ML    = fitMeasures(fit_ml,  c("chisq", "df", "pvalue", "cfi", "rmsea")),
            MLR   = fitMeasures(fit_mlr, c("chisq.scaled", "df", "pvalue.scaled", "cfi.robust", "rmsea.robust")),
            WLSMV = fitMeasures(fit_cat, c("chisq.scaled", "df", "pvalue.scaled", "cfi.scaled", "rmsea.scaled"))), 3)
round(fitMeasures(fit_mlr, "chisq.scaling.factor"), 3)
lad <- function(f) standardizedSolution(f)[1:6, "est.std"]
round(cbind(ML = lad(fit_ml), WLSMV = lad(fit_cat)), 3)
Wynik w R
    mean   sd  skew kurtosis kategorie
pp1 3.07 1.06 -0.02    -0.66         5
pp2 3.22 1.05 -0.29    -0.49         5
pp3 2.98 1.08 -0.07    -0.60         5
pp4 3.06 0.98  0.02    -0.34         5
pp5 3.45 1.04 -0.26    -0.55         5
pp6 4.42 0.74 -1.08     0.43         4

    2     3     4     5
0.016 0.106 0.319 0.559
skosnosc_b1p   p_skosnosc  kurtoza_b2p    p_kurtoza
      2.2334       0.0000      46.3600       0.1344
  momenty parametry        df
       21        12         9
      chisq df pvalue cfi rmsea
ML    8.979  9  0.439   1     0
MLR   8.519  9  0.483   1     0
WLSMV 8.715  9  0.464   1     0
chisq.scaling.factor
               1.054
        ML WLSMV
[1,] 0.759 0.794
[2,] 0.672 0.704
[3,] 0.670 0.695
[4,] 0.597 0.630
[5,] 0.576 0.605
[6,] 0.443 0.515
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lavaan (wersja 0.7.2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Dopasowanie modelu bez obejrzenia zmiennych jawnych. Efekt sufitu, pusta kategoria albo wartość spoza skali (np. 9 jako kod braku) zmieniają korelacje i ładunki.
- Traktowanie sumy skali jak bezbłędnej miary. Wynik sumaryczny to też zmienna jawna z błędem pomiaru. W analizie ścieżek osłabia on oszacowane związki.
- Za mało zmiennych jawnych na czynnik. Przy dwóch wskaźnikach model nie jest identyfikowalny, a przy trzech jest dokładnie identyfikowalny i nie da się ocenić jego dopasowania.
- Mylenie nazwy pozycji z nazwą konstruktu – np. nazywanie jednej pozycji „samooceną” i analizowanie jej jak skali.
- Automatyczne usuwanie pozycji z efektem sufitu. Pozycja pp6 z przykładu nadal mierzy przynależność (ładunek .515 przy WLSMV). O jej losie decydują treść i ładunek, a nie sam kształt rozkładu.
- Pomijanie poziomu pomiaru przy wyborze estymatora. Pozycje dychotomiczne i 3–4-stopniowe lepiej traktować jako porządkowe.
Pełną procedurę od przeglądu danych do oceny modelu opisuje CB-SEM krok po kroku, a sprawdzanie normalności pojedynczych zmiennych – jak sprawdzić normalność rozkładu.
Najczęstsze pytania
Czym różni się zmienna jawna od zmiennej ukrytej?
Zmienną jawną mierzysz bezpośrednio i masz ją w danych, np. odpowiedź na pozycję „Czuję się częścią grupy”. Zmiennej ukrytej, np. poczucia przynależności, nie mierzysz wprost – model szacuje ją na podstawie tego, co wspólne dla kilku zmiennych jawnych, oddzielając cechę od błędu pomiaru.
Czy wynik sumaryczny skali to zmienna jawna?
Tak. Suma lub średnia pozycji to zmienna obserwowana, tyle że złożona z kilku odpowiedzi; zawiera błąd pomiaru całej skali. Dlatego związki między wynikami sumarycznymi są zwykle słabsze niż związki między odpowiadającymi im zmiennymi ukrytymi.
Ile zmiennych jawnych potrzeba na jedną zmienną ukrytą?
Co najmniej trzy, aby czynnik był identyfikowalny bez dodatkowych ograniczeń; cztery lub więcej pozwalają ocenić dopasowanie modelu pomiarowego. Przy dwóch wskaźnikach potrzebne są ograniczenia, np. równe ładunki, albo korelacje z innymi czynnikami.
Jak sprawdzić zmienne jawne przed analizą SEM?
Policz dla każdej M, SD, skośność, kurtozę i liczbę użytych kategorii, obejrzyj rozkłady odpowiedzi, sprawdź wartości spoza skali i braki danych, a całość oceń testem wielowymiarowej normalności (np. Mardii). Na tej podstawie wybierz estymator: ML, MLR albo WLSMV.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
CB-SEM krok po kroku: założenia, dopasowanie i interpretacja
Praktyczny przewodnik po covariance-based SEM: identyfikacja, estymator, brakujące dane, ocena dopasowania, reszty, parametry i raport APA 7.
Czytaj →PoradnikJak sprawdzić normalność rozkładu
Co ma być normalne, wykres Q-Q reszt, skośność i kurtoza, granice testu Shapiro-Wilka i sześć strategii na brak normalności – z kodem R, SPSS i opisem APA.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Bollen, K. A. (2002). Latent variables in psychology and the social sciences. Annual Review of Psychology, 53(1), 605–634. https://doi.org/10.1146/annurev.psych.53.100901.135239
- Cain, M. K., Zhang, Z., & Yuan, K.-H. (2017). Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation. Behavior Research Methods, 49(5), 1716–1735. https://doi.org/10.3758/s13428-016-0814-1 ● Otwarty dostęp
- Edwards, J. R., & Bagozzi, R. P. (2000). On the nature and direction of relationships between constructs and measures. Psychological Methods, 5(2), 155–174. https://doi.org/10.1037/1082-989x.5.2.155
- Jackson, D. L., Gillaspy, J. A., & Purc-Stephenson, R. (2009). Reporting practices in confirmatory factor analysis: An overview and some recommendations. Psychological Methods, 14(1), 6–23. https://doi.org/10.1037/a0014694
- Rhemtulla, M., Brosseau-Liard, P. É., & Savalei, V. (2012). When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions. Psychological Methods, 17(3), 354–373. https://doi.org/10.1037/a0029315
Cytowania BibTeX
@article{bollen2002latent, author={Bollen, Kenneth A.}, title={{Latent variables in psychology and the social sciences}}, journal={Annual Review of Psychology}, year={2002}, volume={53}, number={1}, pages={605--634}, doi={10.1146/annurev.psych.53.100901.135239}}@article{cain2017univariate, author={Cain, Meghan K. and Zhang, Zhiyong and Yuan, Ke-Hai}, title={{Univariate and multivariate skewness and kurtosis for measuring nonnormality: Prevalence, influence and estimation}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={5}, pages={1716--1735}, doi={10.3758/s13428-016-0814-1}}@article{edwards2000nature, author={Edwards, Jeffrey R. and Bagozzi, Richard P.}, title={{On the nature and direction of relationships between constructs and measures}}, journal={Psychological Methods}, year={2000}, volume={5}, number={2}, pages={155--174}, doi={10.1037/1082-989x.5.2.155}}@article{jackson2009reporting, author={Jackson, Dennis L. and Gillaspy, J. Arthur and Purc-Stephenson, Rebecca}, title={{Reporting practices in confirmatory factor analysis: An overview and some recommendations}}, journal={Psychological Methods}, year={2009}, volume={14}, number={1}, pages={6--23}, doi={10.1037/a0014694}}@article{rhemtulla2012when, author={Rhemtulla, Mijke and Brosseau-Liard, Patricia É. and Savalei, Victoria}, title={{When can categorical variables be treated as continuous? A comparison of robust continuous and categorical SEM estimation methods under suboptimal conditions}}, journal={Psychological Methods}, year={2012}, volume={17}, number={3}, pages={354--373}, doi={10.1037/a0029315}}