Model wzrostu jako model wielopoziomowy
Gdy te same osoby mierzysz kilka razy, pomiary są zagnieżdżone w osobach. Model wzrostu w ujęciu wielopoziomowym traktuje czas jako predyktor poziomu 1, a osobę jako jednostkę poziomu 2. Każda osoba ma własny punkt startowy (losowy wyraz wolny) i własne tempo zmiany (losowe nachylenie czasu). Efekty stałe opisują przeciętną trajektorię, a wariancje efektów losowych – to, jak bardzo ludzie różnią się startem i tempem (Curran i in., 2010).
Ten sam model można zapisać jako krzywą wzrostu (LGM) w SEM. Tę drogę, z porównaniem kształtów zmiany i modelem warunkowym w lavaan, pokazuje poradnik krzywe wzrostu (LGM). Wybór między ANOVA z powtarzanymi pomiarami a modelem mieszanym omawia wpis ANOVA czy model mieszany. Tutaj skupiamy się na sytuacjach, w których podejście wielopoziomowe w lme4 (Bates i in., 2015) jest najwygodniejsze: pomiary w różnych terminach, różna liczba pomiarów na osobę i odpadanie z badania.
Przykład: objawy lęku w terapii poznawczo-behawioralnej
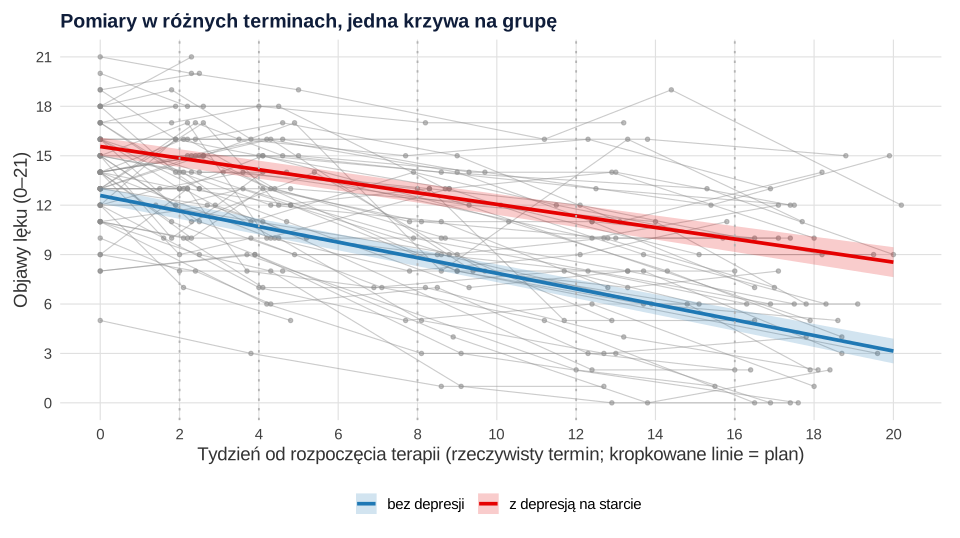
Dwustu czterdziestu pacjentów poradni zdrowia psychicznego rozpoczęło 16-tygodniową terapię poznawczo-behawioralną zaburzeń lękowych. Objawy lęku mierzono skalą 0–21 (wyższy wynik oznacza silniejsze objawy) na wizytach planowanych w tygodniach 0, 2, 4, 8, 12 i 16. Rzeczywiste terminy przesuwały się, a część osób przerwała udział. Na starcie u 105 osób rozpoznano współwystępującą depresję. Pytamy, czy osoby z depresją zaczynają z wyższego poziomu i czy ich objawy spadają wolniej. Dane są symulowane, a liczby pochodzą z kodu R na końcu strony. Zbiór możesz pobrać jako plik CSV (1134 wiersze: id, depresja, wizyta, tydzien_plan, tydzien, wynik).
Krok 1. Format długi i kodowanie czasu
lme4 potrzebuje danych w formacie długim: jeden wiersz to jeden pomiar, a osobę identyfikuje kolumna id. Czas jest zwykłą zmienną w danych, więc każdy wiersz może mieć inną wartość. W przykładzie jest 1134 pomiarów od 240 osób, a liczba pomiarów na osobę waha się od 1 do 6. Osoby z jednym pomiarem też wchodzą do modelu i pomagają oszacować poziom początkowy.
| Wizyta (plan, tydzień) | n | Braki | Rzeczywisty tydzień: mediana (min–maks) | M lęku |
|---|---|---|---|---|
| 0 | 240 | 0.0% | 0.0 | 13.82 |
| 2 | 203 | 15.4% | 2.2 (1.4–3.3) | 13.06 |
| 4 | 185 | 22.9% | 4.3 (3.1–5.5) | 11.78 |
| 8 | 173 | 27.9% | 8.7 (6.9–11.2) | 9.45 |
| 12 | 170 | 29.2% | 13.1 (10.6–15.4) | 7.87 |
| 16 | 163 | 32.1% | 17.6 (14.6–20.8) | 5.69 |
Czas kodujemy w tygodniach od pierwszej wizyty: 0 = pomiar wyjściowy. Wtedy wyraz wolny to przewidywany wynik na starcie, a efekt czasu to zmiana na tydzień. Biesanz i in. (2004) pokazują, że wybór punktu zerowego jednoznacznie wyznacza oszacowania i błędy standardowe parametrów niższego rzędu, a także moc testów dla ich predyktorów. Zero ustaw tam, gdzie wynik ma sens merytoryczny. Pełne kodowanie czasu, także dla modelu kwadratowego, omawia poradnik o LGM.
Krok 2. Losowy wyraz wolny i losowe nachylenie
Model bezwarunkowy zawiera tylko czas:
Przeciętny pacjent zaczynał od 13.89 pkt, a objawy spadały o 0.420 pkt na tydzień, SE = 0.014, t(181.2) = −30.86, p < .001. Wariancja wyrazu wolnego wyniosła 8.96 (SD = 2.99), a nachylenia 0.021 (SD = 0.146 pkt na tydzień). Przy średnim tempie −0.42 oznacza to, że u większości pacjentów objawy spadały w tempie od około −0.13 do −0.71 pkt na tydzień (±2 SD). Korelacja startu i tempa wyniosła .24: osoby z wyższym wynikiem na starcie poprawiały się nieco wolniej. Wariancja reszt to 2.65.
Czy losowe nachylenie jest potrzebne? Porównaj model z samym losowym wyrazem wolnym i model z losowym nachyleniem. Oba mają te same efekty stałe, więc możesz je porównać na wiarygodności REML (zob. REML a ML). Losowe nachylenie wyraźnie poprawiło dopasowanie, χ²(2) = 115.31, p < .001, AIC 5191.6 wobec 5302.9. Pominięcie zróżnicowanego tempa zaniżałoby błąd standardowy efektu czasu. Ten test ilorazu wiarygodności jest zachowawczy, bo wariancja nie może być ujemna.
Krok 3. Predyktor stały w czasie × czas
Depresja na starcie nie zmienia się w trakcie badania, więc jest predyktorem poziomu 2. Jej efekt główny mówi o różnicy na starcie, a interakcja z czasem – o różnicy w tempie zmiany. Taka interakcja to interakcja międzypoziomowa: cecha osoby moderuje nachylenie poziomu 1.
| Efekt | b | SE | 95% CI | t (df) | p |
|---|---|---|---|---|---|
| Wyraz wolny (start, bez depresji) | 12.585 | 0.245 | [12.104, 13.066] | 51.28 (237.1) | < .001 |
| Tydzień (tempo, bez depresji) | −0.472 | 0.017 | [−0.504, −0.440] | −28.58 (179.5) | < .001 |
| Depresja (różnica na starcie) | 2.973 | 0.372 | [2.244, 3.701] | 8.00 (238.8) | < .001 |
| Tydzień × depresja (różnica tempa) | 0.121 | 0.026 | [0.069, 0.173] | 4.59 (182.1) | < .001 |
Osoby z depresją zaczynały o 2.97 pkt wyżej, a ich objawy spadały wolniej: o 0.351 pkt na tydzień wobec 0.472 pkt bez depresji. Przez 16 tygodni daje to spadek o 5.62 wobec 7.55 pkt. Depresja wyjaśniła 16.6% wariancji nachylenia, ale pacjenci nadal istotnie różnili się tempem (wariancja 0.018). Spadek wariancji efektów losowych to tylko jedna z miar; inne opisuje hasło R² w modelach wielopoziomowych.
Stopnie swobody pochodzą z przybliżenia Satterthwaite’a w pakiecie lmerTest. Przybliżenie Kenwarda–Rogera dało niemal identyczne wartości, np. dla interakcji t(183.2) = 4.58 (Kuznetsova i in., 2017). Luke (2017) pokazał w symulacjach, że błąd I rodzaju najlepiej kontrolują modele REML z jednym z tych przybliżeń. Różnice między nimi omawia hasło stopnie swobody Kenwarda–Rogera i Satterthwaite’a.
Gdy pytanie dotyczy różnicy na końcu terapii, przesuń zero czasu na tydzień 16. Model jest ten sam (log-wiarygodność −2550.97 w obu wersjach), ale efekt depresji oznacza teraz różnicę po 16 tygodniach: 4.91 pkt, 95% CI [3.89, 5.93], t(206.1) = 9.41, p < .001.
Krok 4. Niezrównoważone i nieregularne terminy pomiarów
W praktyce wizyta „po 8 tygodniach” odbywa się między 6.9 a 11.2 tygodniem, a odstępy zwykle się wydłużają. Model wielopoziomowy przyjmuje rzeczywisty czas każdego pomiaru bez dodatkowej pracy. W LGM trzeba by zastosować tzw. zmienne definicyjne. Mehta i West (2000) pokazali, że gdy SEM korzysta z indywidualnych danych, a nie ze średnich i kowariancji, daje te same oszacowania co model wielopoziomowy. Uproszczenie do czasu z planu ma swoją cenę:
- z rzeczywistym czasem tempo bez depresji wyniosło −0.472 pkt na tydzień;
- z czasem z planu wyniosło −0.519 pkt na tydzień, czyli było przeszacowane o około 10%;
- różnica tempa w grupie z depresją zmieniła się z 0.121 na 0.135.
Przyczyna jest prosta: przypisujesz zmianę krótszemu odcinkowi czasu, niż naprawdę upłynął. Zapisuj więc datę każdego pomiaru, a nie tylko numer wizyty. Gdy jednak zależy Ci na modelu pomiarowym z kilkoma pozycjami w każdym pomiarze, wygodniejszy bywa SEM.
Struktura reszt w skrócie
Model z losowym wyrazem wolnym i nachyleniem zakłada niezależne reszty o stałej wariancji. Gdy pomiary są gęste (np. dzienniki), reszty bliskich pomiarów mogą być skorelowane (zob. autokorelacja reszt). lme4 nie modeluje struktury reszt, ale umożliwia to pakiet nlme. Przy nieregularnych terminach pasuje autokorelacja w czasie ciągłym (corCAR1). W przykładzie nie poprawiła dopasowania, χ²(1) = 0.47, p = .494, AIC 5105.4 wobec 5103.9, a efekty stałe się nie zmieniły. Sprawdź tę strukturę zwłaszcza przy wielu pomiarach na osobę.
Model wielopoziomowy a LGM: kiedy są równoważne
Oba ujęcia dają identyczne oszacowania, gdy wszyscy są mierzeni w tych samych terminach, kształt zmiany jest taki sam, w LGM wariancje reszt są ograniczone do równości, a oba modele szacuje się metodą największej wiarygodności. Tak było w przykładzie z poradnika o LGM. McNeish i Matta (2018) przestrzegają jednak, że równoważność matematyczna nie oznacza równoważności praktycznej. Jeśli dane nie są idealne, bo próba jest mała, są braki, a terminy i liczba pomiarów się różnią, domyślne ustawienia programów mogą dać różne wyniki, a jedno z ujęć jest zwykle wygodniejsze.
| Sytuacja | Wygodniej |
|---|---|
| Każdy pomiar w innym terminie, różna liczba pomiarów | model wielopoziomowy (lme4) |
| Mała liczba osób, potrzebny REML i poprawka stopni swobody | model wielopoziomowy |
| Dodatkowe poziomy (pomiary w osobach w poradniach) | model wielopoziomowy |
| Konstrukt latentny w każdym pomiarze, inwariancja w czasie | LGM (lavaan) |
| Tempo zmiany jako predyktor innej zmiennej, globalne dopasowanie | LGM |
Braki danych przy założeniu MAR
Model mieszany szacowany metodą największej wiarygodności korzysta ze wszystkich dostępnych pomiarów. Daje nieobciążone oszacowania, jeśli braki są typu MAR, czyli zależą od zmierzonych zmiennych, w tym od wcześniejszych wyników (zob. braki danych MCAR, MAR i MNAR). Schafer i Graham (2002) rekomendują w takiej sytuacji właśnie metody największej wiarygodności albo imputację wielokrotną zamiast usuwania przypadków. W symulacji rezygnacja zależała od ostatniego zmierzonego wyniku. Osoby bez kompletu pomiarów miały na starcie średnio 14.44 pkt, a osoby z kompletem 13.28 pkt.
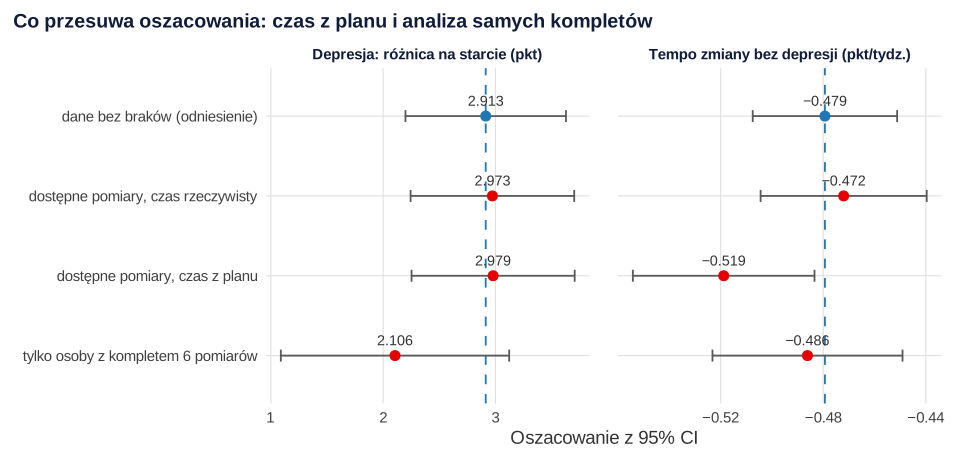
Wynik porównania: model ze wszystkimi pomiarami dał różnicę na starcie 2.973 pkt, bardzo blisko wartości z pełnych danych (2.913). Analiza tylko 128 osób z kompletem sześciu pomiarów zaniżyła ją do 2.106 pkt, bo z badania częściej odpadały osoby z silniejszymi objawami. MAR jest założeniem, którego nie da się sprawdzić w danych. Jeśli rezygnacja może zależeć od niezmierzonego pogorszenia (MNAR), dodaj analizę wrażliwości. Imputację wielokrotną i zmienne pomocnicze opisuje wpis braki danych i imputacja wielokrotna w R.
Jak opisać model wzrostu (APA)
W części „Metoda” podaj liczbę osób i pomiarów, zakres liczby pomiarów na osobę, sposób kodowania czasu (jednostka i punkt zerowy), strukturę efektów losowych i test jej wyboru, metodę estymacji (REML lub ML), przybliżenie stopni swobody, odsetek braków w każdej wizycie i założenie o mechanizmie braków. W wynikach pokaż tabelę efektów stałych, wariancje efektów losowych i wykres trajektorii. Planowanie takich badań opisuje wpis badanie podłużne w doktoracie, a ogólny schemat podłużny – hasło w słowniku.
Jeśli Twoje dane mają nieregularne terminy, kilka poziomów albo duże odpadanie i chcesz sprawdzić model przed wysłaniem artykułu, możemy przejrzeć go razem w ramach wsparcia statystycznego dla badaczy. Gdy wynik jest binarny, zajrzyj do wpisu wielopoziomowa regresja logistyczna, a ogólną sekwencję modeli wielopoziomowych znajdziesz w poradniku model wielopoziomowy krok po kroku.
Przykład w R
Dwa przepisy uruchamiane po kolei w jednej sesji. Pierwszy tworzy dane, zapisuje plik modele-wzrostu-dane.csv (możesz go pobrać tutaj) i dopasowuje modele wzrostu. Drugi zmienia kodowanie czasu, porównuje czas rzeczywisty z planowanym, analizę wszystkich pomiarów z analizą kompletnych przypadków i sprawdza strukturę reszt. Potrzebne pakiety: lme4, lmerTest (z pbkrtest dla Kenwarda–Rogera) i nlme.
1. Dane w formacie długim, model bezwarunkowy i model z depresją
R
# Dane symulowane: objawy lęku (skala 0–21, wyższy wynik = silniejsze objawy) u 240 pacjentów terapii poznawczo-behawioralnej.
# Wizyty planowane w tygodniach 0, 2, 4, 8, 12 i 16, ale rzeczywiste terminy się przesuwają; część wizyt jest pominięta,
# a rezygnacja zależy od ostatniego zmierzonego wyniku (mechanizm MAR). Predyktor stały w czasie: depresja na starcie (0/1).
suppressPackageStartupMessages({library(lme4); library(lmerTest)})
set.seed(17604)
n <- 240
plan <- c(0, 2, 4, 8, 12, 16)
osoby <- data.frame(id = sprintf("p%03d", 1:n), depresja = rbinom(n, 1, .40))
u0 <- rnorm(n, 0, 2.6); u1 <- 0.014 * u0 + rnorm(n, 0, 0.12)   # losowy poziom i tempo (słaba dodatnia korelacja)
dl <- do.call(rbind, lapply(1:n, function(i) {
  opozn <- c(0, cumsum(diff(plan) * exp(rnorm(5, 0.08, 0.15))))                  # odstępy zwykle nieco dłuższe niż w planie
  data.frame(id = osoby$id[i], depresja = osoby$depresja[i], wizyta = 1:6, tydzien_plan = plan, tydzien = round(opozn, 1),
             wynik = 13 + 2.0 * osoby$depresja[i] + u0[i] + (-0.50 + 0.18 * osoby$depresja[i] + u1[i]) * opozn + rnorm(6, 0, 1.6))
}))
dl$wynik <- pmin(pmax(round(dl$wynik), 0), 21)
# Braki: rezygnacja po wizycie zależna od ostatniego wyniku (MAR) i pojedyncze pominięte wizyty (MCAR)
dl$obecny <- TRUE
for (i in osoby$id) {
  w <- which(dl$id == i)
  for (k in 2:6) {
    if (!dl$obecny[w[k - 1]]) { dl$obecny[w[k:6]] <- FALSE; break }
    if (runif(1) < plogis(-5.4 + 0.22 * dl$wynik[w[k - 1]])) { dl$obecny[w[k:6]] <- FALSE; break }
  }
  pomin <- w[-1][runif(5) < .06]
  dl$obecny[pomin] <- FALSE
}
pelne <- dl                                  # dane bez braków – tylko do porównania z prawdą symulacji
dane <- subset(dl, obecny, select = c(id, depresja, wizyta, tydzien_plan, tydzien, wynik))
write.csv(dane, "modele-wzrostu-dane.csv", row.names = FALSE)

# Opis: format długi, liczba pomiarów na osobę, terminy wizyt
head(dane, 7)
c(osoby = n, pomiary = nrow(dane), z_depresja = sum(osoby$depresja))
table(pomiarow_na_osobe = table(factor(dane$id, levels = osoby$id)))
do.call(rbind, tapply(dane$tydzien, dane$tydzien_plan, function(x) round(c(n = length(x), min = min(x), mediana = median(x), max = max(x)), 1)))
round(tapply(dane$wynik, dane$tydzien_plan, mean), 2)
round(100 * (1 - table(dane$tydzien_plan) / n), 1)                         # odsetek braków w każdej wizycie

ctrl <- lmerControl(optimizer = "bobyqa")      # optymalizator bobyqa dla wszystkich modeli
# Model 1: bezwarunkowy model wzrostu – losowy wyraz wolny i losowe nachylenie czasu (REML)
m1 <- lmer(wynik ~ tydzien + (1 + tydzien | id), data = dane, control = ctrl)
summary(m1)$coefficients
print(VarCorr(m1), comp = c("Variance", "Std.Dev."))
# Czy potrzebne losowe nachylenie? (te same efekty stałe, więc porównanie na REML)
m1a <- lmer(wynik ~ tydzien + (1 | id), data = dane, control = ctrl)
anova(m1a, m1, refit = FALSE)

# Model 2: depresja na starcie × czas (predyktor stały w czasie), REML; df Satterthwaite'a i Kenwarda–Rogera
m2 <- lmer(wynik ~ tydzien * depresja + (1 + tydzien | id), data = dane, control = ctrl)
round(summary(m2)$coefficients, 3)
round(summary(m2, ddf = "Kenward-Roger")$coefficients, 3)
round(confint(m2, parm = "beta_", method = "Wald"), 3)
print(VarCorr(m2), comp = "Variance")
# Tempo zmiany w obu grupach i przewidywana zmiana przez 16 tygodni
tempo <- c(bez_depresji = fixef(m2)[["tydzien"]], z_depresja = fixef(m2)[["tydzien"]] + fixef(m2)[["tydzien:depresja"]])
round(rbind(tempo_na_tydzien = tempo, zmiana_16_tyg = 16 * tempo), 3)
# Ile wariancji nachylenia wyjaśnia depresja?
round(100 * (1 - VarCorr(m2)$id["tydzien", "tydzien"] / VarCorr(m1)$id["tydzien", "tydzien"]), 1)
Wynik w R
    id depresja wizyta tydzien_plan tydzien wynik
1 p001        1      1            0     0.0    16
2 p001        1      2            2     2.7    17
3 p001        1      3            4     4.9    13
4 p001        1      4            8     9.2    15
5 p001        1      5           12    14.0    12
6 p001        1      6           16    18.5    12
7 p002        0      1            0     0.0     7
     osoby    pomiary z_depresja
       240       1134        105
pomiarow_na_osobe
  1   2   3   4   5   6
 24  19  15  11  43 128
     n  min mediana  max
0  240  0.0     0.0  0.0
2  203  1.4     2.2  3.3
4  185  3.1     4.3  5.5
8  173  6.9     8.7 11.2
12 170 10.6    13.1 15.4
16 163 14.6    17.6 20.8
    0     2     4     8    12    16
13.82 13.06 11.78  9.45  7.87  5.69

   0    2    4    8   12   16
 0.0 15.4 22.9 27.9 29.2 32.1
              Estimate Std. Error       df   t value      Pr(>|t|)
(Intercept) 13.8888688 0.20730361 238.0380  66.99772 1.769132e-156
tydzien     -0.4198166 0.01360382 181.1926 -30.86020  4.655550e-74
 Groups   Name        Variance Std.Dev. Corr
 id       (Intercept) 8.958667 2.99310
          tydzien     0.021192 0.14557  0.236
 Residual             2.651124 1.62823
Data: dane
Models:
m1a: wynik ~ tydzien + (1 | id)
m1: wynik ~ tydzien + (1 + tydzien | id)
    npar    AIC    BIC  logLik -2*log(L)  Chisq Df Pr(>Chisq)
m1a    4 5302.9 5323.1 -2647.5    5294.9
m1     6 5191.6 5221.8 -2589.8    5179.6 115.31  2  < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
                 Estimate Std. Error      df t value Pr(>|t|)
(Intercept)        12.585      0.245 237.149  51.279        0
tydzien            -0.472      0.017 179.510 -28.581        0
depresja            2.973      0.372 238.780   7.998        0
tydzien:depresja    0.121      0.026 182.123   4.592        0
                 Estimate Std. Error      df t value Pr(>|t|)
(Intercept)        12.585      0.245 236.117  51.276        0
tydzien            -0.472      0.017 180.428 -28.548        0
depresja            2.973      0.372 237.743   7.997        0
tydzien:depresja    0.121      0.026 183.193   4.584        0
                  2.5 % 97.5 %
(Intercept)      12.104 13.066
tydzien          -0.504 -0.440
depresja          2.244  3.701
tydzien:depresja  0.069  0.173
 Groups   Name        Variance Corr
 id       (Intercept) 6.804987
          tydzien     0.017668 0.071
 Residual             2.648969
                 bez_depresji z_depresja
tempo_na_tydzien       -0.472     -0.351
zmiana_16_tyg          -7.553     -5.615
[1] 16.6
2. Kodowanie czasu, terminy, braki danych i struktura reszt
R
# Kodowanie czasu: zero na końcu terapii (tydzień 16) – ten sam model, inne znaczenie wyrazu wolnego i efektu depresji
dane$tydzien16 <- dane$tydzien - 16
m2_koniec <- lmer(wynik ~ tydzien16 * depresja + (1 + tydzien16 | id), data = dane, control = ctrl)
round(summary(m2_koniec)$coefficients, 3)
round(confint(m2_koniec, parm = "depresja", method = "Wald"), 3)
round(c(logLik_start = as.numeric(logLik(m2)), logLik_koniec = as.numeric(logLik(m2_koniec))), 2)

# Planowane czy rzeczywiste terminy wizyt? Ten sam model z czasem nominalnym
m2_plan <- lmer(wynik ~ tydzien_plan * depresja + (1 + tydzien_plan | id), data = dane, control = ctrl)
round(rbind(czas_rzeczywisty = fixef(m2), czas_planowany = fixef(m2_plan)), 3)

# Braki danych (MAR): wszystkie dostępne pomiary a tylko osoby z kompletem 6 pomiarów; punkt odniesienia – dane bez braków
komplet <- names(which(table(dane$id) == 6))
m2_kompl <- lmer(wynik ~ tydzien * depresja + (1 + tydzien | id), data = subset(dane, id %in% komplet), control = ctrl)
m2_pelne <- lmer(wynik ~ tydzien * depresja + (1 + tydzien | id), data = pelne, control = ctrl)
round(rbind(dane_bez_brakow = fixef(m2_pelne), wszystkie_dostepne = fixef(m2), tylko_komplet = fixef(m2_kompl)), 3)
c(osoby_z_kompletem = length(komplet))
# Rezygnacja a wynik na starcie
round(tapply(subset(dane, wizyta == 1)$wynik, subset(dane, wizyta == 1)$id %in% komplet, mean), 2)

# Struktura reszt (krótko): niezależne reszty a autokorelacja w czasie ciągłym (nlme, ML do porównania AIC)
suppressPackageStartupMessages(library(nlme))
r_niez <- lme(wynik ~ tydzien * depresja, random = ~ 1 + tydzien | id, data = dane, method = "ML")
r_car1 <- update(r_niez, correlation = corCAR1(form = ~ tydzien | id))
anova(r_niez, r_car1)
round(fixef(r_car1), 3)
Wynik w R
                   Estimate Std. Error      df t value Pr(>|t|)
(Intercept)           5.033      0.334 196.609  15.046        0
tydzien16            -0.472      0.017 179.510 -28.581        0
depresja              4.911      0.522 206.131   9.408        0
tydzien16:depresja    0.121      0.026 182.123   4.592        0
         2.5 % 97.5 %
depresja 3.888  5.934
 logLik_start logLik_koniec
     -2550.97      -2550.97
                 (Intercept) tydzien depresja tydzien:depresja
czas_rzeczywisty      12.585  -0.472    2.973            0.121
czas_planowany        12.593  -0.519    2.979            0.135
                   (Intercept) tydzien depresja tydzien:depresja
dane_bez_brakow         12.620  -0.479    2.913            0.132
wszystkie_dostepne      12.585  -0.472    2.973            0.121
tylko_komplet           12.569  -0.486    2.106            0.141
osoby_z_kompletem
              128
FALSE  TRUE
14.44 13.28
       Model df      AIC      BIC    logLik   Test   L.Ratio p-value
r_niez     1  8 5103.898 5144.166 -2543.949
r_car1     2  9 5105.431 5150.732 -2543.715 1 vs 2 0.4677406   0.494
     (Intercept)          tydzien         depresja tydzien:depresja
          12.581           -0.472            2.978            0.120
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietami lme4, lmerTest, pbkrtest i nlme; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- lme4 (wersja 2.0.1): Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- lmerTest (wersja 3.2.1): Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- pbkrtest (wersja 0.5.5): Halekoh, U., & Højsgaard, S. (2014). A Kenward-Roger approximation and parametric bootstrap methods for tests in linear mixed models – The R package pbkrtest. Journal of Statistical Software, 59(9), 1–32. https://doi.org/10.18637/jss.v059.i09
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Numer wizyty zamiast rzeczywistego czasu. Przy przesuwających się terminach zniekształca tempo zmiany.
- Usuwanie osób bez kompletu pomiarów. Przy odpadaniu typu MAR obciąża wyniki i marnuje dane, które model mieszany wykorzystuje bez imputacji.
- Interpretacja efektu predyktora bez sprawdzenia punktu zerowego czasu. Przy interakcji z czasem efekt główny opisuje różnicę w chwili 0.
- Sam losowy wyraz wolny przy zróżnicowanym tempie. Zaniża błąd standardowy efektu czasu i jego interakcji.
- Porównywanie modeli o różnych efektach stałych na wiarygodności REML. Do takich porównań dopasuj modele metodą ML.
Najczęstsze pytania
Czy w modelu wzrostu w lme4 każdy uczestnik musi mieć tyle samo pomiarów?
Nie. W formacie długim każdy pomiar to osobny wiersz, więc osoby z jednym, trzema czy sześcioma pomiarami wnoszą do modelu wszystko, co mają. Wyniki są nieobciążone, jeśli braki są typu MAR. W przykładzie 240 pacjentów miało od 1 do 6 pomiarów.
Czy w modelu wzrostu użyć planowanego czy rzeczywistego terminu pomiaru?
Rzeczywistego, jeśli go znasz. Przypisanie wszystkim terminu z planu zakłada, że zmiana zaszła w krótszym lub dłuższym czasie, niż upłynął naprawdę. W przykładzie czas z planu przeszacował tempo spadku objawów o około 10% (−0.519 zamiast −0.472 pkt na tydzień).
Jak zinterpretować interakcję predyktora z czasem w modelu wzrostu?
Interakcja mówi, o ile różni się tempo zmiany między grupami lub na jednostkę predyktora. Efekt główny predyktora opisuje wtedy różnicę w chwili, w której czas wynosi 0. Jeśli chcesz różnicy na końcu badania, przesuń zero czasu na ostatni pomiar.
Kiedy model wzrostu w lme4 i krzywa wzrostu LGM dają te same wyniki?
Gdy wszyscy są mierzeni w tych samych terminach, oba modele mają ten sam kształt zmiany i efekty losowe, w LGM wariancje reszt są równe, a oba szacujesz metodą największej wiarygodności. Przy nieregularnych terminach, małej próbie i brakach domyślne ustawienia programów mogą prowadzić do różnych wyników (McNeish i Matta, 2018).
Powiązane hasła
Przeczytaj też
Krzywe wzrostu (LGM) i modele zmiany
Krzywa wzrostu w lavaan na danych do pobrania: kształt zmiany, ujemna wariancja, kodowanie czasu, predyktor tempa, porównanie z lme4 i tabele APA.
Czytaj →PoradnikANOVA z powtarzanymi pomiarami czy model mieszany?
Ten sam przykład 2 × 4 w afex i lmerTest, symulacja odpadania MAR, struktura efektów losowych, stopnie swobody, R² i gotowy opis do artykułu.
Czytaj →PoradnikModel wielopoziomowy krok po kroku w R
Pięć modeli na danych o pracownikach w zespołach: ICC, centrowanie CWC i CGM, losowe nachylenia, interakcja międzypoziomowa, REML a ML i wzór raportu.
Czytaj →Masz dane z kilku pomiarów w różnych terminach i nie wiesz, jak opisać zmianę?
Pomożemy zbudować i sprawdzić model wzrostu, dobrać kodowanie czasu i strukturę efektów losowych oraz wyjaśnić wyniki tak, żebyś mógł(a) samodzielnie je opisać i obronić.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01 ● Otwarty dostęp
- Biesanz, J. C., Deeb-Sossa, N., Papadakis, A. A., Bollen, K. A., & Curran, P. J. (2004). The role of coding time in estimating and interpreting growth curve models. Psychological Methods, 9(1), 30–52. https://doi.org/10.1037/1082-989x.9.1.30
- Curran, P. J., Obeidat, K., & Losardo, D. (2010). Twelve frequently asked questions about growth curve modeling. Journal of Cognition and Development, 11(2), 121–136. https://doi.org/10.1080/15248371003699969 ● Otwarty dostęp: pełny tekst
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13 ● Otwarty dostęp
- Luke, S. G. (2017). Evaluating significance in linear mixed-effects models in R. Behavior Research Methods, 49(4), 1494–1502. https://doi.org/10.3758/s13428-016-0809-y ● Otwarty dostęp
- McNeish, D., & Matta, T. (2018). Differentiating between mixed-effects and latent-curve approaches to growth modeling. Behavior Research Methods, 50(4), 1398–1414. https://doi.org/10.3758/s13428-017-0976-5 ● Otwarty dostęp
- Mehta, P. D., & West, S. G. (2000). Putting the individual back into individual growth curves. Psychological Methods, 5(1), 23–43. https://doi.org/10.1037/1082-989x.5.1.23
- Schafer, J. L., & Graham, J. W. (2002). Missing data: Our view of the state of the art. Psychological Methods, 7(2), 147–177. https://doi.org/10.1037/1082-989X.7.2.147
Cytowania BibTeX
@article{bates2015fitting, author={Bates, Douglas and Mächler, Martin and Bolker, Ben and Walker, Steve}, title={{Fitting linear mixed-effects models using lme4}}, journal={Journal of Statistical Software}, year={2015}, volume={67}, number={1}, pages={1--48}, doi={10.18637/jss.v067.i01}}@article{biesanz2004role, author={Biesanz, Jeremy C. and Deeb-Sossa, Natalia and Papadakis, Alison A. and Bollen, Kenneth A. and Curran, Patrick J.}, title={{The role of coding time in estimating and interpreting growth curve models}}, journal={Psychological Methods}, year={2004}, volume={9}, number={1}, pages={30--52}, doi={10.1037/1082-989x.9.1.30}}@article{curran2010twelve, author={Curran, Patrick J. and Obeidat, Khawla and Losardo, Diane}, title={{Twelve frequently asked questions about growth curve modeling}}, journal={Journal of Cognition and Development}, year={2010}, volume={11}, number={2}, pages={121--136}, doi={10.1080/15248371003699969}}@article{kuznetsova2017lmertest, author={Kuznetsova, Alexandra and Brockhoff, Per B. and Christensen, Rune H. B.}, title={{lmerTest package: Tests in linear mixed effects models}}, journal={Journal of Statistical Software}, year={2017}, volume={82}, number={13}, pages={1--26}, doi={10.18637/jss.v082.i13}}@article{luke2017evaluating, author={Luke, Steven G.}, title={{Evaluating significance in linear mixed-effects models in R}}, journal={Behavior Research Methods}, year={2017}, volume={49}, number={4}, pages={1494--1502}, doi={10.3758/s13428-016-0809-y}}@article{mcneish2018differentiating, author={McNeish, Daniel and Matta, Tyler}, title={{Differentiating between mixed-effects and latent-curve approaches to growth modeling}}, journal={Behavior Research Methods}, year={2018}, volume={50}, number={4}, pages={1398--1414}, doi={10.3758/s13428-017-0976-5}}@article{mehta2000putting, author={Mehta, Paras D. and West, Stephen G.}, title={{Putting the individual back into individual growth curves}}, journal={Psychological Methods}, year={2000}, volume={5}, number={1}, pages={23--43}, doi={10.1037/1082-989x.5.1.23}}@article{schafer2002missing, author={Schafer, Joseph L. and Graham, John W.}, title={{Missing data: Our view of the state of the art}}, journal={Psychological Methods}, year={2002}, volume={7}, number={2}, pages={147--177}, doi={10.1037/1082-989x.7.2.147}}