Ankieta mieszana: dwie przyczyny jednej różnicy
Ankietę mieszaną (mixed-mode) projektuje się zwykle z dwóch powodów: żeby obniżyć koszt i żeby dotrzeć do osób, które w jednym trybie nie odpowiedzą. Typowy schemat sekwencyjny wygląda tak: najpierw zaproszenie do ankiety internetowej, a osoby, które jej nie wypełniły, dostają wywiad telefoniczny albo kwestionariusz papierowy. De Leeuw (2005) omawia typowe formy takich schematów oraz ich zalety i wady. Dla analizy najważniejszy problem polega na tym, że odpowiedzi z różnych trybów mogą się różnić z powodu samego trybu.
Definicję i najprostszą korektę wiekiem znajdziesz w haśle efekt trybu badania, a przegląd trybów CAWI, CATI, CAPI i PAPI – we wpisie rodzaje badań ankietowych. Ten wpis jest dla badacza, który ma już dane z dwóch trybów albo dopiero planuje badanie. Pokazuje, kiedy korekta kowariantami wystarcza, jakie projekty rozdzielają oba zjawiska i co z tego problemu wyłapie test inwariancji pomiaru.
Różnica średnich między trybami ma dwa składniki. Vannieuwenhuyze i in. (2010) nazywają je efektem selekcji i efektem pomiaru. Selekcja to różnica w tym, kto odpowiada w danym trybie: przez telefon odpowiadają częściej osoby starsze i mniej aktywne w internecie. Efekt pomiaru to różnica w tym, jak ta sama osoba odpowiada w różnych trybach. W ankiecie mieszanej każdy respondent odpowiada tylko w jednym trybie, więc oba składniki są ze sobą splątane. Vannieuwenhuyze i Loosveldt (2013) zauważają, że splątanie może być całkowite: z samych danych mieszanych nie da się ich rozdzielić bez dodatkowych założeń albo dodatkowych danych.
Przykład: różnica bliska zera, która niczego nie dowodzi
W symulacji 3000 osób wypełnia czteropozycyjną skalę dobrostanu (odpowiedzi 1–5, wynik to średnia). Przez internet odpowiedziało 1760 osób, a przez telefon 1240. Osoby wybierające telefon były starsze (średnio 58.4 wobec 43.4 roku) i rzadziej miały wyższe wykształcenie (42.5% wobec 62.3%). O wyborze trybu decyduje też cecha, której badacz nie mierzy: codzienna sprawność i aktywność, która podnosi dobrostan. Przez telefon odpowiedzi przesuwają się ku odpowiedziom pożądanym. Przesunięcie jest większe u starszych osób i największe w pozycji „Jestem zadowolony(-a) ze swojego życia”.
Ponieważ dane tworzymy sami, każda osoba ma dwa wyniki potencjalne: jak odpowiedziałaby w internecie i jak przez telefon (zob. model potencjalnych wyników). Pozwala to rozłożyć surową różnicę dokładnie na dwa składniki (Rysunek 1).
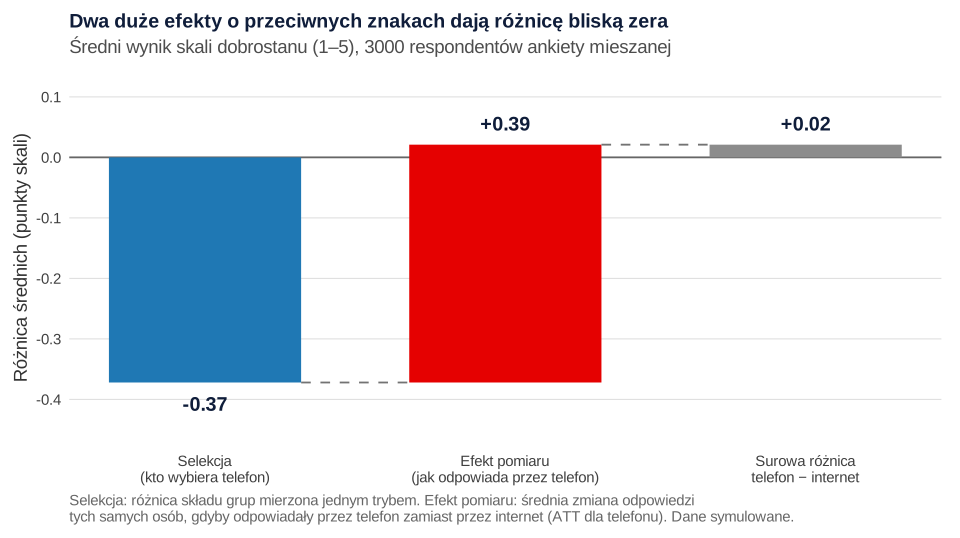
Średni wynik wyniósł 3.268 przez telefon i 3.247 przez internet, więc surowa różnica to zaledwie 0.021 punktu. Kusi wniosek „tryb nie ma znaczenia, łączymy dane”. Tymczasem osoby z grupy telefonicznej mają dobrostan niższy o 0.372 punktu (selekcja), a telefon podnosi ich odpowiedzi o 0.393 punktu (efekt pomiaru). Dwa duże efekty o przeciwnych znakach prawie się znoszą. Jeśli w kolejnej edycji badania udział telefonu się zmieni, zmieni się też średnia ogólna, choć dobrostan populacji pozostanie taki sam.
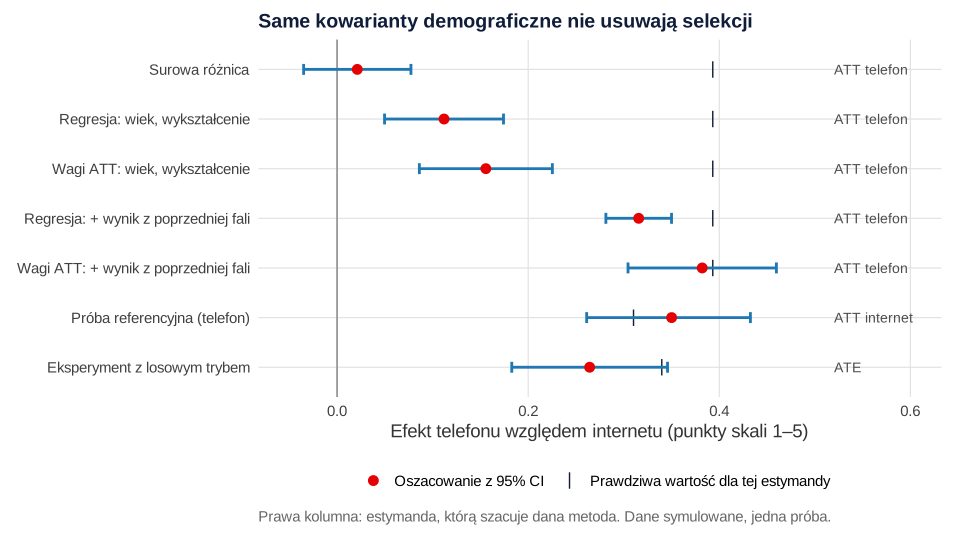
Warto też ustalić, o który efekt trybu pytasz. W przykładzie telefon podnosi wynik o 0.393 punktu u osób, które go wybrały (ATT dla telefonu), o 0.310 u osób, które wybrały internet, i o 0.344 w całej próbie (ATE). Różnice biorą się stąd, że efekt jest większy u starszych. Każda z metod opisanych niżej szacuje inną z tych wielkości.
Jak tryb zmienia odpowiedzi
Efekt pomiaru ma kilka typowych źródeł. Warto je znać, bo podpowiadają, które pytania będą najbardziej wrażliwe na tryb.
- Obecność ankietera. Przy ankieterze silniej działa aprobata społeczna. Kreuter i in. (2008) porównali odpowiedzi absolwentów z dokumentacją uczelni. Ankieta internetowa dawała więcej ujawnień drażliwych informacji i trafniejsze odpowiedzi niż wywiad telefoniczny. Do tego dochodzi zmienność między ankieterami (efekt ankietera).
- Skale ocen. Klausch i in. (2013) w dużym eksperymencie pokazali, że tryby z ankieterem i tryby samodzielne mierzą pytania postaw na systematycznie różnych skalach. Między papierem a internetem oraz między wywiadem osobistym a telefonicznym takich różnic nie było. Tryby samodzielne miały przy tym wyższą rzetelność wskaźników. Część różnic to style odpowiedzi skrajnych i środkowych.
- Kanał wzrokowy a słuchowy. Listę odpowiedzi czytaną z ekranu respondent przegląda od góry, a usłyszaną przez telefon zapamiętuje od końca. Stąd przewaga pierwszych opcji w trybach wzrokowych i ostatnich w słuchowych (efekt kolejności odpowiedzi). Krosnick (1991) wiąże takie zjawiska z satysfakcjonowaniem, czyli wybieraniem pierwszej odpowiedzi, która wydaje się wystarczająca, gdy pytanie wymaga dużego wysiłku.
- Pytania drażliwe. Gdy anonimowość trybu samodzielnego nie wystarcza, zostają metody pośrednie: eksperyment listowy i technika randomizowanych odpowiedzi.
Projekt: kwestionariusz ujednolicony czy dopasowany do trybu
Najtańsza ochrona przed efektem pomiaru zaczyna się przed zbieraniem danych. Dillman i in. (2014) poświęcają podręcznik projektowaniu ankiet internetowych, telefonicznych, pocztowych i mieszanych (zob. metoda Dillmana). W praktyce wybierasz między dwiema strategiami:
| Strategia | Na czym polega | Kiedy wybrać |
|---|---|---|
| Ujednolicona (unimode) | To samo brzmienie, te same kategorie odpowiedzi i ta sama kolejność we wszystkich trybach; bez elementów, których nie da się przenieść (np. siatek pytań tylko na ekranie, ukrytej opcji „nie wiem” tylko u ankietera) | Gdy łączysz odpowiedzi z różnych trybów w jednej analizie albo porównujesz grupy, które odpowiadały w różnych trybach |
| Dopasowana do trybu (mode-specific) | Każdy tryb w najlepszej dla siebie wersji, nawet jeśli wersje się różnią | Gdy w każdym trybie liczy się przede wszystkim trafność odpowiedzi, a różnice wersji są sprawdzone, np. w eksperymencie |
Wynik Klauscha i in. (2013) daje też prostą regułę doboru trybów do pytań o postawy: łącz tryby tego samego typu (papier z internetem albo wywiad osobisty z telefonicznym), a tryby z ankieterem i samodzielne łącz tylko ostrożnie. Przy wyborze programu sprawdź, czy wersja internetowa da się odwzorować na papierze i przez telefon (zob. narzędzia do ankiet online). W danych zawsze zapisuj tryb jako zmienną.
Korekta kowariantami i wagami
Najczęstsza analiza to regresja wyniku na zmienną trybu z kowariantami, które tłumaczą wybór trybu. Jej odmiana to wagi IPW, które upodabniają grupę internetową do telefonicznej (estymanda ATT). Ten sam mechanizm i jego granice omawiamy we wpisie o błędzie selekcji w praktyce. Vannieuwenhuyze i in. (2014) przypominają, że kowarianty korygujące selekcję muszą spełniać silne założenia, które zwykle się pomija. W praktyce chodzi o dwa warunki. Po pierwsze, kowarianty muszą w pełni tłumaczyć związek wyboru trybu z wynikiem. Po drugie, sam tryb nie może na nie wpływać. Wiek i wykształcenie spełniają drugi warunek, ale rzadko pierwszy.
| Metoda (cel: ATT dla telefonu = 0.393) | Oszacowanie [95% CI] |
|---|---|
| Surowa różnica | 0.021 [−0.035, 0.077] |
| Regresja z wiekiem i wykształceniem | 0.112 [0.050, 0.174] |
| Wagi ATT z wieku i wykształcenia | 0.156 [0.086, 0.225] |
| Regresja z wynikiem z poprzedniej fali | 0.316 [0.281, 0.350] |
| Wagi ATT z wynikiem z poprzedniej fali | 0.382 [0.304, 0.460] |
Demografia usunęła tylko część selekcji: wagi dały 0.156 przy prawdziwej wartości 0.393. Reszta selekcji biegnie przez cechę niezmierzoną. Dużo lepszym kowariantem jest wynik tej samej skali z poprzedniej fali, zebranej w jednym trybie dla wszystkich. Taka zmienna mierzy właśnie to, co różni grupy, a tryb bieżącej fali nie mógł na nią wpłynąć. Hox i in. (2015) kontrolowali w panelu mieszanym wyniki skal z poprzedniej, jednotrybowej fali. Zwykle poprawiało to równoważność pomiaru między trybami, choć nie dla wszystkich skal. Wagi z tym kowariantem dały 0.382, ale efektywna liczebność grupy internetowej spadła z 1760 do 737 osób.
W 500 powtórzeniach symulacji demografia zostawiła obciążenie −0.219 (wagi) i −0.248 (regresja). Z wynikiem poprzedniej fali obciążenie spadło do −0.034 i −0.065, ale nie do zera, bo poprzedni pomiar jest obarczony błędem. Regresja wypada tu gorzej od wag także dlatego, że przy efekcie zależnym od wieku nie szacuje czystego ATT.
Próba referencyjna i eksperyment z losowym trybem
Gdy kowariantów brakuje, problem rozwiązuje projekt badania. Vannieuwenhuyze i in. (2010) proponują porównać ankietę mieszaną z porównywalną próbą jednotrybową z tej samej populacji. Jeśli w próbie referencyjnej wszyscy odpowiadają przez telefon, jej średnia szacuje średnią telefoniczną całej populacji. Odejmując wkład osób, które w ankiecie mieszanej wybrały telefon, dostajemy średnią, jaką przez telefon uzyskaliby internauci. Kluczowe założenie: obie próby mają taki sam skład respondentów. Vannieuwenhuyze i Loosveldt (2013) porównali na tych samych danych trzy metody rozdzielania selekcji i pomiaru, w tym dwie z próbą jednotrybową, i uzyskali duże różnice wyników. Metodę opartą na zmiennych „niewrażliwych na tryb” uznali za wymagającą zwykle nierealistycznych założeń. Założenie o porównywalności prób trzeba więc uzasadnić, a nie przyjąć.
W przykładzie próba referencyjna liczy 1500 osób. Efekt telefonu u internautów oszacowano na 0.350, 95% CI [0.261, 0.433] (bootstrap percentylowy, 2000 powtórzeń), przy prawdziwej wartości 0.310. Selekcja mierzona na skali telefonicznej wyniosła −0.329.
Złotym standardem jest eksperyment z losowym przydziałem trybu. Losowanie usuwa selekcję, a różnica średnich szacuje efekt trybu w populacji (ATE). Jäckle i in. (2010) omawiają metody oceny efektów trybu i to, które efekty są w nich identyfikowane, na przykładzie eksperymentów Europejskiego Sondażu Społecznego. W przykładzie 1500 osób losowo podzielono na dwie grupy. Wynik: 0.264, 95% CI [0.183, 0.346], przy prawdziwym ATE 0.340. Przedział obejmuje prawdę, a w powtórzeniach symulacji średnie obciążenie wyniosło −0.001. Pamiętaj tylko, że eksperyment z odmowami w jednym z ramion znów wprowadza selekcję. Wtedy różnice w odsetku odpowiedzi trzeba analizować jak w każdym badaniu z błędem braku odpowiedzi.
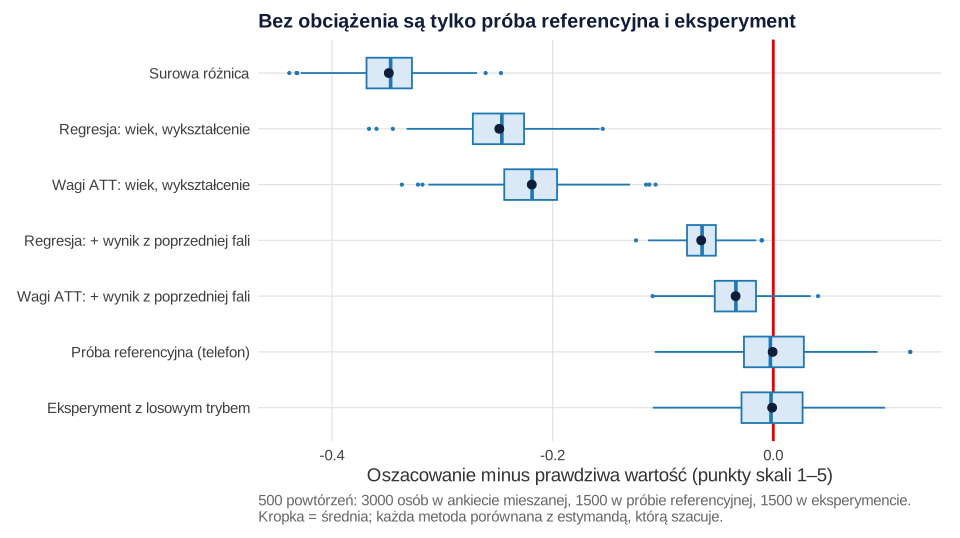
Rysunek 3 pokazuje też koszt. SD oszacowań wyniosło 0.040 dla próby referencyjnej i 0.041 dla eksperymentu, wobec 0.027 dla wag z poprzednią falą. Projekty bez obciążenia wymagają dodatkowej próby i dają szersze przedziały.
Inwariancja pomiaru między trybami: co wykryje, a czego nie
Przy skalach wielopozycyjnych naturalnym krokiem jest wielogrupowa CFA z trybem jako grupą. Procedurę krok po kroku opisuje wpis inwariancja pomiaru krok po kroku, a wersję dla odpowiedzi porządkowych – kategorialna CFA w lavaan. W przykładzie model metryczny nie pogorszył dopasowania, Δχ²(3) = 0.94, p = .817. Model skalarny je pogorszył: Δχ²(3) = 158.63, p < .001, CFI = .962, RMSEA = .101. Test uwolnienia ograniczeń wskazał przede wszystkim wyraz wolny pozycji 4 (χ² = 148.33; dla pozycji 2: 49.43). Po jego uwolnieniu dopasowanie było bardzo dobre, χ²(9) = 9.71, CFI = 1.000, RMSEA = .007.
Test inwariancji wykrył więc pozycję, w której efekt telefonu był wyjątkowo duży. Nie wykrył natomiast części efektu wspólnej dla wszystkich pozycji. Po uwolnieniu pozycji 4 średnia latentna grupy telefonicznej wyniosła −0.068 SD, 95% CI [−0.124, −0.011]. Ten sam model dopasowany do odpowiedzi, jakie wszyscy daliby w internecie, daje −0.366 SD. Wspólne przesunięcie wszystkich pozycji model przypisał więc różnicy dobrostanu między grupami, czyli selekcji. To zgodne z wnioskiem Klauscha i in. (2013), że tryb działa głównie przez błąd systematyczny, który dotyka wielu pozycji jednakowo. Częściowa inwariancja skalarna nie dowodzi więc braku efektu trybu. Hox i in. (2015) dlatego przed testem równoważności korygowali selekcję metodami propensity score.
Jak opisać efekt trybu w artykule
Opisz schemat (kolejność trybów, kto dostał który), liczebności i porównanie składu grup. Podaj, jakim projektem lub jakimi kowariantami rozdzielono selekcję i pomiar, jaka jest estymanda i jakie założenie za tym stoi. Jeśli korygujesz wagami, podaj efektywną liczebność.
Jeśli łączysz dane z kilku trybów i recenzent pyta o ich porównywalność, możemy wspólnie dobrać projekt, przygotować korektę i test inwariancji w ramach analiz statystycznych dla badaczy.
Przykład w R
Przepisy uruchamiasz po kolei w jednej sesji R (drugi i trzeci korzystają z funkcji i obiektów z pierwszego). Pierwszy zapisuje dane, które widzi badacz, do pliku ankieta-mieszana.csv (możesz go pobrać tutaj). Całość liczy się kilkanaście sekund. Potrzebne pakiety: WeightIt, sandwich, lmtest, boot i lavaan.
1. Selekcja i efekt pomiaru w ankiecie mieszanej
R
# Krok 1. Ankieta mieszana (internet albo telefon): surowa różnica = selekcja + efekt pomiaru (dane symulowane)
# Każda osoba ma dwa wyniki potencjalne: jak odpowiedziałaby w internecie i jak przez telefon.
suppressPackageStartupMessages({library(WeightIt); library(sandwich); library(lmtest)})

generuj <- function(n) {
  wiek <- round(runif(n, 18, 80))
  wyzsze <- rbinom(n, 1, plogis(0.3 - 0.03 * (wiek - 45)))
  u <- rnorm(n)                                    # cecha niezmierzona: sprawność i aktywność na co dzień
  eta <- 0.3 * wyzsze - 0.01 * (wiek - 45) + 0.4 * u + rnorm(n, 0, sqrt(0.7))   # prawdziwy dobrostan
  lam <- c(0.8, 0.9, 0.7, 0.8)
  e <- sapply(lam, function(l) rnorm(n, 0, 0.6))   # ten sam błąd losowy w obu trybach
  # Efekt pomiaru przez telefon (ankieter): przesunięcie ku odpowiedziom pożądanym, większe u starszych
  # i największe w pozycji 4 („Jestem zadowolony(-a) ze swojego życia”)
  delta <- outer(1 + 0.015 * (wiek - 45), c(0.25, 0.25, 0.25, 0.60))
  odp <- function(x) pmin(pmax(round(x), 1), 5)   # skala 1–5
  web <- odp(3 + outer(eta, lam) + e)
  tel <- odp(3 + outer(eta, lam) + e + delta)
  tryb <- ifelse(runif(n) < plogis(0.5 - 0.06 * (wiek - 45) + 0.6 * wyzsze + 0.8 * u), "web", "tel")
  poprz <- eta + rnorm(n, 0, 0.4)                  # wynik skali z poprzedniej fali (jeden tryb dla wszystkich)
  data.frame(wiek, wyzsze, u, eta, poprz, tryb, y_web = rowMeans(web), y_tel = rowMeans(tel),
             web = web, tel = tel)
}

set.seed(3541)
d <- generuj(3000)
d$telefon <- as.integer(d$tryb == "tel")
d$y <- ifelse(d$telefon == 1, d$y_tel, d$y_web)    # tylko ten wynik widzi badacz
write.csv(transform(d[, c("wiek", "wyzsze", "poprz", "tryb", "y")], poprz = round(poprz, 3), y = round(y, 2)),
          "ankieta-mieszana.csv", row.names = FALSE)

cat("Liczebność trybów:\n"); print(table(d$tryb))
sapply(split(d[, c("wiek", "wyzsze", "y")], d$tryb), function(x) round(colMeans(x), 3))

# Prawda (znana tylko w symulacji): rozkład surowej różnicy tel − web
T <- d$telefon == 1
prawda <- c(surowa = mean(d$y_tel[T]) - mean(d$y_web[!T]),
            selekcja = mean(d$y_web[T]) - mean(d$y_web[!T]),          # różnica składu, mierzona jednym trybem
            pomiar_ATT_tel = mean(d$y_tel[T] - d$y_web[T]),          # efekt trybu u odpowiadających przez telefon
            pomiar_ATE = mean(d$y_tel - d$y_web),                    # efekt trybu w całej próbie
            pomiar_ATT_web = mean(d$y_tel[!T] - d$y_web[!T]))        # efekt trybu u odpowiadających przez internet
round(prawda, 3)

# Szacowanie efektu pomiaru (ATT dla telefonu) z danych, które ma badacz
efekt <- function(m) { ct <- coeftest(m, vcov. = vcovHC(m, type = "HC0"))["telefon", 1:2]
  c(b = ct[[1]], dolna = ct[[1]] - 1.96 * ct[[2]], gorna = ct[[1]] + 1.96 * ct[[2]]) }
w_obs <- weightit(telefon ~ wiek + wyzsze, data = d, method = "glm", estimand = "ATT")
w_pop <- weightit(telefon ~ wiek + wyzsze + poprz, data = d, method = "glm", estimand = "ATT")
tab <- rbind(
  surowa             = efekt(lm(y ~ telefon, data = d)),
  regresja_wiek_wykszt = efekt(lm(y ~ telefon + wiek + wyzsze, data = d)),
  wagi_ATT_wiek_wykszt = efekt(lm(y ~ telefon, data = d, weights = w_obs$weights)),
  regresja_z_poprz_fala = efekt(lm(y ~ telefon + wiek + wyzsze + poprz, data = d)),
  wagi_ATT_z_poprz_fala = efekt(lm(y ~ telefon, data = d, weights = w_pop$weights)))
print(round(tab, 3))
cat("Efektywna liczebność grupy web po ważeniu (z poprzednią falą):",
    round(sum(w_pop$weights[!T])^2 / sum(w_pop$weights[!T]^2)), "z", sum(!T), "\n")
Wynik w R
Liczebność trybów:

 tel  web
1240 1760
          tel    web
wiek   58.422 43.449
wyzsze  0.425  0.623
y       3.268  3.247
        surowa       selekcja pomiar_ATT_tel     pomiar_ATE pomiar_ATT_web
         0.021         -0.372          0.393          0.344          0.310
                          b  dolna gorna
surowa                0.021 -0.035 0.077
regresja_wiek_wykszt  0.112  0.050 0.174
wagi_ATT_wiek_wykszt  0.156  0.086 0.225
regresja_z_poprz_fala 0.316  0.281 0.350
wagi_ATT_z_poprz_fala 0.382  0.304 0.460
Efektywna liczebność grupy web po ważeniu (z poprzednią falą): 737 z 1760
2. Próba referencyjna, eksperyment i Monte Carlo
R
# Krok 2. Dwa projekty, które rozdzielają selekcję i pomiar, oraz powtórzenia Monte Carlo
# (wymaga funkcji generuj() i obiektów z kroku 1)
suppressPackageStartupMessages(library(boot))

# A. Próba referencyjna jednotrybowa (Vannieuwenhuyze i in., 2010): druga próba z tej samej populacji, wszyscy przez telefon.
#    E[Y_tel | web] = (E_ref[Y_tel] − p_tel · E[Y_tel | tel]) / p_web
set.seed(3542)
ref <- generuj(1500)
metoda_ref <- function(y_mm, tel_mm, y_ref) {
  p_tel <- mean(tel_mm)
  m_tel_tel <- mean(y_mm[tel_mm == 1]); m_web_web <- mean(y_mm[tel_mm == 0])
  m_tel_web <- (mean(y_ref) - p_tel * m_tel_tel) / (1 - p_tel)   # jak odpowiedzieliby przez telefon internauci
  c(pomiar_ATT_web = m_tel_web - m_web_web, selekcja_w_tel = m_tel_tel - m_tel_web)
}
est_ref <- metoda_ref(d$y, d$telefon, ref$y_tel)
dane_boot <- rbind(data.frame(y = d$y, tel = d$telefon, proba = 1), data.frame(y = ref$y_tel, tel = 1, proba = 2))
b_ref <- boot(dane_boot, function(x, i) { x <- x[i, ]; metoda_ref(x$y[x$proba == 1], x$tel[x$proba == 1], x$y[x$proba == 2]) },
              R = 2000, strata = dane_boot$proba)
ci_ref <- boot.ci(b_ref, type = "perc", index = 1)$percent[4:5]
round(c(oszacowanie = est_ref[["pomiar_ATT_web"]], dolna = ci_ref[1], gorna = ci_ref[2],
        prawda_ATT_web = prawda[["pomiar_ATT_web"]], selekcja_w_tel = est_ref[["selekcja_w_tel"]]), 3)

# B. Eksperyment z losowym przydziałem trybu: 1500 osób, połowa losowo do internetu, połowa do telefonu
set.seed(3543)
eks <- generuj(1500)
eks$telefon <- sample(rep(0:1, length.out = nrow(eks)))
eks$y <- ifelse(eks$telefon == 1, eks$y_tel, eks$y_web)
m_eks <- lm(y ~ telefon, data = eks)
round(c(efekt(m_eks), prawda_ATE = mean(eks$y_tel - eks$y_web)), 3)
# Zestawienie oszacowań z jednej próby (do rysunku 2)
osz <- data.frame(metoda = c(rownames(tab), "proba_referencyjna", "eksperyment"),
                  rbind(tab, c(est_ref[["pomiar_ATT_web"]], ci_ref), efekt(m_eks)),
                  cel = c(rep(prawda[["pomiar_ATT_tel"]], 5), prawda[["pomiar_ATT_web"]], mean(eks$y_tel - eks$y_web)))
write.csv(osz, "oszacowania-jedna-proba.csv", row.names = FALSE)

# C. Monte Carlo: 500 powtórzeń całego badania (3000 w ankiecie mieszanej, 1500 w próbie referencyjnej, 1500 w eksperymencie)
jedno_badanie <- function() {
  d <- generuj(3000); d$telefon <- as.integer(d$tryb == "tel"); d$y <- ifelse(d$telefon == 1, d$y_tel, d$y_web)
  T <- d$telefon == 1
  w1 <- weightit(telefon ~ wiek + wyzsze, data = d, method = "glm", estimand = "ATT")$weights
  w2 <- weightit(telefon ~ wiek + wyzsze + poprz, data = d, method = "glm", estimand = "ATT")$weights
  b <- function(f, w = rep(1, nrow(d))) { d$w <- w; coef(lm(f, data = d, weights = w))[["telefon"]] }
  r <- generuj(1500)
  e <- generuj(1500); e$telefon <- sample(rep(0:1, length.out = 1500)); e$y <- ifelse(e$telefon == 1, e$y_tel, e$y_web)
  c(surowa = b(y ~ telefon), regresja_wiek_wykszt = b(y ~ telefon + wiek + wyzsze), wagi_wiek_wykszt = b(y ~ telefon, w1),
    regresja_z_poprz = b(y ~ telefon + wiek + wyzsze + poprz), wagi_z_poprz = b(y ~ telefon, w2),
    proba_ref = metoda_ref(d$y, d$telefon, r$y_tel)[["pomiar_ATT_web"]],
    eksperyment = coef(lm(y ~ telefon, data = e))[["telefon"]],
    cel_ATT_tel = mean(d$y_tel[T] - d$y_web[T]), cel_ATT_web = mean(d$y_tel[!T] - d$y_web[!T]),
    cel_ATE = mean(e$y_tel - e$y_web), selekcja = mean(d$y_web[T]) - mean(d$y_web[!T]))
}
set.seed(3544)
mc <- t(replicate(500, jedno_badanie()))
write.csv(round(mc, 4), "mc-tryb.csv", row.names = FALSE)
cel <- c(rep("cel_ATT_tel", 5), "cel_ATT_web", "cel_ATE")
metody <- colnames(mc)[1:7]
wyn <- t(sapply(seq_along(metody), function(j) {
  x <- mc[, metody[j]]; blad <- x - mc[, cel[j]]
  c(srednia = mean(x), sredni_cel = mean(mc[, cel[j]]), obciazenie = mean(blad), SD = sd(x), blad_MC = sd(blad) / sqrt(nrow(mc)))
}))
rownames(wyn) <- paste(metody, "→", sub("cel_", "", cel))
print(round(wyn, 3))
round(c(srednia_selekcja = mean(mc[, "selekcja"]), SD_selekcja = sd(mc[, "selekcja"])), 3)
Wynik w R
   oszacowanie          dolna          gorna prawda_ATT_web selekcja_w_tel
         0.350          0.261          0.433          0.310         -0.329
         b      dolna      gorna prawda_ATE
     0.264      0.183      0.346      0.340
                               srednia sredni_cel obciazenie    SD blad_MC
surowa → ATT_tel                 0.044      0.392     -0.348 0.031   0.001
regresja_wiek_wykszt → ATT_tel   0.144      0.392     -0.248 0.035   0.002
wagi_wiek_wykszt → ATT_tel       0.173      0.392     -0.219 0.038   0.002
regresja_z_poprz → ATT_tel       0.327      0.392     -0.065 0.019   0.001
wagi_z_poprz → ATT_tel           0.358      0.392     -0.034 0.027   0.001
proba_ref → ATT_web              0.309      0.310     -0.001 0.040   0.002
eksperyment → ATE                0.342      0.343     -0.001 0.041   0.002
srednia_selekcja      SD_selekcja
          -0.348            0.032
3. Inwariancja pomiaru między trybami
R
# Krok 3. Inwariancja pomiaru między trybami: co wykryje, a czego nie (wymaga obiektu d z kroku 1)
suppressPackageStartupMessages(library(lavaan))
for (j in 1:4) d[[paste0("x", j)]] <- ifelse(d$telefon == 1, d[[paste0("tel.", j)]], d[[paste0("web.", j)]])
d$grupa <- factor(d$tryb, levels = c("web", "tel"))      # grupa odniesienia (pierwsza): internet
sapply(split(d[, paste0("x", 1:4)], d$grupa), function(x) round(colMeans(x), 3))

model <- "dobrostan =~ x1 + x2 + x3 + x4"
fit_konf <- cfa(model, data = d, group = "grupa", group.label = c("web", "tel"))
fit_metr <- cfa(model, data = d, group = "grupa", group.label = c("web", "tel"), group.equal = "loadings")
fit_skal <- cfa(model, data = d, group = "grupa", group.label = c("web", "tel"), group.equal = c("loadings", "intercepts"))
miary <- function(f) fitMeasures(f, c("chisq", "df", "cfi", "rmsea", "srmr"))
round(rbind(konfiguralny = miary(fit_konf), metryczny = miary(fit_metr), skalarny = miary(fit_skal)), 3)
lavTestLRT(fit_konf, fit_metr, fit_skal)

# Która pozycja łamie inwariancję skalarną? Test uwolnienia ograniczeń (score test)
lt <- lavTestScore(fit_skal)$uni
pt <- parTable(fit_skal)
lt$parametr <- pt$lhs[match(lt$lhs, pt$plabel)]
lt$op <- pt$op[match(lt$lhs, pt$plabel)]
print(subset(lt, op == "~1", select = c(parametr, X2, p.value)), row.names = FALSE, digits = 3)

# Częściowa inwariancja skalarna: uwalniamy wyraz wolny pozycji 4
fit_czes <- cfa(model, data = d, group = "grupa", group.label = c("web", "tel"), group.equal = c("loadings", "intercepts"),
                group.partial = "x4~1")
round(miary(fit_czes), 3)
pe <- parameterEstimates(fit_czes)
round(unlist(subset(pe, lhs == "dobrostan" & op == "~1" & group == 2)[, c("est", "ci.lower", "ci.upper")]), 3)
# Kontrola: ten sam model na odpowiedziach, jakie wszyscy daliby w internecie (sama selekcja, bez efektu pomiaru)
for (j in 1:4) d[[paste0("x", j)]] <- d[[paste0("web.", j)]]
fit_web <- cfa(model, data = d, group = "grupa", group.label = c("web", "tel"), group.equal = c("loadings", "intercepts"))
round(c(roznica_latentna_bez_efektu_pomiaru = subset(parameterEstimates(fit_web), lhs == "dobrostan" & op == "~1" & group == 2)$est), 3)
Wynik w R
     web   tel
x1 3.207 3.159
x2 3.286 3.167
x3 3.225 3.201
x4 3.269 3.546
               chisq df   cfi rmsea  srmr
konfiguralny   2.892  4 1.000 0.000 0.004
metryczny      3.827  7 1.000 0.000 0.007
skalarny     162.456 10 0.962 0.101 0.042

Chi-Squared Difference Test

         Df   AIC   BIC    Chisq Chisq diff   RMSEA Df diff Pr(>Chisq)
fit_konf  4 28954 29098   2.8921
fit_metr  7 28949 29075   3.8274      0.935 0.00000       3     0.8169
fit_skal 10 29102 29210 162.4561    158.629 0.18597       3     <2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
 parametr     X2 p.value
       x1   8.44   0.004
       x2  49.43   0.000
       x3   2.62   0.105
       x4 148.33   0.000
chisq    df   cfi rmsea  srmr
9.705 9.000 1.000 0.007 0.010
     est ci.lower ci.upper
  -0.068   -0.124   -0.011
roznica_latentna_bez_efektu_pomiaru
                             -0.366
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–3 w R 4.5.3 (modele lm() i glm() z pakietu stats) z pakietami WeightIt, sandwich, lmtest, boot i lavaan; rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- WeightIt (wersja 2.1.0): Greifer, N. (2026). WeightIt: Weighting for covariate balance in observational studies (R package version 2.1.0) [Computer software]. https://doi.org/10.32614/CRAN.package.WeightIt
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- boot (wersja 1.3-32): Canty, A., & Ripley, B. (2025). boot: Bootstrap functions (R package version 1.3-32) [Computer software]. https://doi.org/10.32614/CRAN.package.boot
- lavaan (wersja 0.7-2): Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. https://doi.org/10.18637/jss.v048.i02
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- „Średnie w trybach są podobne, więc łączymy dane”. Podobne średnie mogą ukrywać selekcję i efekt pomiaru o przeciwnych znakach.
- Surowa różnica nazwana efektem trybu. To suma selekcji i pomiaru, a nie efekt trybu.
- Korekta tylko demografią. Działa wtedy, gdy demografia w pełni tłumaczy wybór trybu. Szukaj kowariantów bliskich badanej cesze i niezależnych od trybu, np. wyników z wcześniejszej fali.
- Brak estymandy. Efekt trybu u osób wybierających telefon, u internautów i w całej populacji to trzy różne liczby.
- Częściowa inwariancja jako dowód braku efektu trybu. Wspólne przesunięcie wszystkich pozycji przejdzie przez test i trafi do średniej latentnej.
- Ważenie do struktury populacji jako lekarstwo na tryb. Ważenie sondażowe poprawia skład próby, ale nie zmienia tego, jak tryb wpłynął na odpowiedzi.
Najczęstsze pytania
Czy można łączyć dane z ankiety internetowej i telefonicznej?
Można, jeśli kwestionariusz jest ujednolicony, tryb jest zapisany jako zmienna i sprawdzono, czy efekt pomiaru nie zmienia wniosków. Podobne średnie w obu trybach tego nie dowodzą: w przykładzie selekcja (−0.37) i efekt pomiaru (+0.39) prawie się zniosły, a surowa różnica wyniosła 0.02 punktu.
Czym różni się efekt selekcji od efektu pomiaru w ankiecie mieszanej?
Selekcja to różnica w tym, kto odpowiada w danym trybie, np. starsze osoby częściej wybierają telefon. Efekt pomiaru to różnica w odpowiedzi tej samej osoby w różnych trybach, np. przesunięcie ku odpowiedziom pożądanym przy ankieterze. Surowa różnica średnich między trybami jest sumą obu.
Czy korekta wiekiem i wykształceniem usuwa efekt selekcji między trybami?
Tylko wtedy, gdy te zmienne w pełni tłumaczą wybór trybu. W symulacji, w której o wyborze decydowała też cecha niezmierzona, wagi z demografii dały 0.16 przy prawdziwym efekcie 0.39. Dużo lepszym kowariantem był wynik tej samej skali z wcześniejszej fali zebranej jednym trybem.
Jak zaplanować badanie, które rozdzieli selekcję i efekt trybu?
Są dwa projekty. Eksperyment z losowym przydziałem trybu usuwa selekcję i szacuje efekt trybu w populacji. Próba referencyjna, w której wszyscy odpowiadają w jednym trybie, pozwala oszacować, jak w tym trybie odpowiedzieliby respondenci drugiego trybu. Oba wymagają dodatkowej próby i dają szersze przedziały.
Czy test inwariancji pomiaru wykrywa efekt trybu?
Tylko częściowo. Wykrywa efekt, który różni się między pozycjami. Przesunięcie wspólne dla wszystkich pozycji przechodzi przez test i trafia do średniej latentnej. W przykładzie po uwolnieniu jednej pozycji grupa telefoniczna miała średnią −0.07 SD zamiast −0.37 SD, jaką dałby ten sam model bez efektu pomiaru.
Powiązane hasła
Przeczytaj też
Rodzaje badań ankietowych
Czas, dobór, kanał i cel badania ankietowego oraz ich konsekwencje dla wniosków – z symulacją autoselekcji w R i wzorem opisu schematu.
Czytaj →PoradnikInwariancja pomiaru krok po kroku
Wielogrupowa CFA w lavaan: model konfiguracyjny, metryczny, skalarny i ścisły, kryteria ΔCFI i ΔRMSEA, testy punktowe, częściowa inwariancja i opis APA.
Czytaj →PoradnikBłąd selekcji i zmienna zderzeniowa w praktyce
Ochotnicy online, rezygnacje i biobanki: symulacje w R, korekta wagami IPW i sytuacje, w których żadna korekta nie wystarczy.
Czytaj →Łączysz dane z kilku trybów i recenzent pyta o porównywalność?
Pomożemy dobrać projekt, który rozdzieli selekcję i efekt pomiaru, przygotować korektę wagami i test inwariancji oraz opis, który samodzielnie obronisz przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- de Leeuw, E. D. (2005). To mix or not to mix data collection modes in surveys. Journal of Official Statistics, 21, 233–255. https://dspace.library.uu.nl/handle/1874/202577
- Dillman, D. A., Smyth, J. D., & Christian, L. M. (2014). Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.). Wiley. https://doi.org/10.1002/9781394260645
- Hox, J. J., De Leeuw, E. D., & Zijlmans, E. A. O. (2015). Measurement equivalence in mixed mode surveys. Frontiers in Psychology, 6, Article 87. https://doi.org/10.3389/fpsyg.2015.00087 ● Otwarty dostęp
- Jäckle, A., Roberts, C., & Lynn, P. (2010). Assessing the effect of data collection mode on measurement. International Statistical Review, 78(1), 3–20. https://doi.org/10.1111/j.1751-5823.2010.00102.x
- Klausch, T., Hox, J. J., & Schouten, B. (2013). Measurement effects of survey mode on the equivalence of attitudinal rating scale questions. Sociological Methods & Research, 42(3), 227–263. https://doi.org/10.1177/0049124113500480
- Kreuter, F., Presser, S., & Tourangeau, R. (2008). Social desirability bias in CATI, IVR, and web surveys: The effects of mode and question sensitivity. Public Opinion Quarterly, 72(5), 847–865. https://doi.org/10.1093/poq/nfn063 ● Otwarty dostęp
- Krosnick, J. A. (1991). Response strategies for coping with the cognitive demands of attitude measures in surveys. Applied Cognitive Psychology, 5(3), 213–236. https://doi.org/10.1002/acp.2350050305
- Vannieuwenhuyze, J. T. A., & Loosveldt, G. (2013). Evaluating relative mode effects in mixed-mode surveys: Three methods to disentangle selection and measurement effects. Sociological Methods & Research, 42(1), 82–104. https://doi.org/10.1177/0049124112464868
- Vannieuwenhuyze, J. T. A., Loosveldt, G., & Molenberghs, G. (2014). Evaluating mode effects in mixed-mode survey data using covariate adjustment models. Journal of Official Statistics, 30(1), 1–21. https://doi.org/10.2478/jos-2014-0001 ● Otwarty dostęp
- Vannieuwenhuyze, J., Loosveldt, G., & Molenberghs, G. (2010). A method for evaluating mode effects in mixed-mode surveys. Public Opinion Quarterly, 74(5), 1027–1045. https://doi.org/10.1093/poq/nfq059 ● Otwarty dostęp
Cytowania BibTeX
@article{deleeuw2005mix, author={de Leeuw, Edith D.}, title={{To mix or not to mix data collection modes in surveys}}, journal={Journal of Official Statistics}, year={2005}, volume={21}, pages={233--255}, url={https://dspace.library.uu.nl/handle/1874/202577}}@book{dillman2014internet, author={Dillman, Don A. and Smyth, Jolene D. and Christian, Leah Melani}, title={{Internet, phone, mail, and mixed-mode surveys: The tailored design method (4th ed.)}}, year={2014}, publisher={Wiley}, doi={10.1002/9781394260645}}@article{hox2015measurement, author={Hox, Joop J. and De Leeuw, Edith D. and Zijlmans, Eva A. O.}, title={{Measurement equivalence in mixed mode surveys}}, journal={Frontiers in Psychology}, year={2015}, volume={6}, eid={87}, doi={10.3389/fpsyg.2015.00087}}@article{jackle2010assessing, author={Jäckle, Annette and Roberts, Caroline and Lynn, Peter}, title={{Assessing the effect of data collection mode on measurement}}, journal={International Statistical Review}, year={2010}, volume={78}, number={1}, pages={3--20}, doi={10.1111/j.1751-5823.2010.00102.x}}@article{klausch2013measurement, author={Klausch, Thomas and Hox, Joop J. and Schouten, Barry}, title={{Measurement effects of survey mode on the equivalence of attitudinal rating scale questions}}, journal={Sociological Methods \& Research}, year={2013}, volume={42}, number={3}, pages={227--263}, doi={10.1177/0049124113500480}}@article{kreuter2008social, author={Kreuter, F. and Presser, S. and Tourangeau, R.}, title={{Social desirability bias in CATI, IVR, and web surveys: The effects of mode and question sensitivity}}, journal={Public Opinion Quarterly}, year={2008}, volume={72}, number={5}, pages={847--865}, doi={10.1093/poq/nfn063}}@article{krosnick1991response, author={Krosnick, Jon A.}, title={{Response strategies for coping with the cognitive demands of attitude measures in surveys}}, journal={Applied Cognitive Psychology}, year={1991}, volume={5}, number={3}, pages={213--236}, doi={10.1002/acp.2350050305}}@article{vannieuwenhuyze2013evaluating, author={Vannieuwenhuyze, Jorre T. A. and Loosveldt, Geert}, title={{Evaluating relative mode effects in mixed-mode surveys: Three methods to disentangle selection and measurement effects}}, journal={Sociological Methods \& Research}, year={2013}, volume={42}, number={1}, pages={82--104}, doi={10.1177/0049124112464868}}@article{vannieuwenhuyze2014evaluating, author={Vannieuwenhuyze, Jorre T. A. and Loosveldt, Geert and Molenberghs, Geert}, title={{Evaluating mode effects in mixed-mode survey data using covariate adjustment models}}, journal={Journal of Official Statistics}, year={2014}, volume={30}, number={1}, pages={1--21}, doi={10.2478/jos-2014-0001}}@article{vannieuwenhuyze2010method, author={Vannieuwenhuyze, J. and Loosveldt, G. and Molenberghs, G.}, title={{A method for evaluating mode effects in mixed-mode surveys}}, journal={Public Opinion Quarterly}, year={2010}, volume={74}, number={5}, pages={1027--1045}, doi={10.1093/poq/nfq059}}