Kiedy pytanie wprost zaniża odpowiedzi
Pytasz o zażywanie substancji, nieuczciwość akademicką, przemoc, uprzedzenia albo łamanie przepisów. Część osób z cechą odpowie „nie”, nawet w anonimowej ankiecie online. Tourangeau i Yan (2007) pokazują, że takie błędne odpowiedzi są częste i zależą od sytuacji: od tego, czy respondent ma coś do ukrycia, i od warunków badania. Mechanizm opisuje hasło aprobata społeczna, a podstawowe zabiegi (anonimowość, neutralne sformułowania, kolejność pytań) – wpis o najczęstszych błędach w ankietach.
Gdy to nie wystarcza, zostają metody pośrednie: eksperyment listowy i technika randomizowanych odpowiedzi (RRT). Obie ukrywają odpowiedź pojedynczej osoby i pozwalają odtworzyć tylko odsetek w grupie. Hasła słownika wyjaśniają ich zasadę na prostych przykładach. Ten wpis jest dla badacza, który musi wybrać technikę, zaprojektować ją, policzyć regresję z kowariantami i uzasadnić liczebność próby.
Zacznij od pytania, czy obciążenie w ogóle będzie duże. Blair i in. (2020) zebrali eksperymenty listowe porównane z pytaniami bezpośrednimi. Obciążenie było zwykle mniejsze niż 10 punktów procentowych, a w niektórych dziedzinach bliskie zera. Metoda pośrednia zawsze kosztuje precyzję. Opłaca się więc tylko wtedy, gdy spodziewane obciążenie jest większe niż koszt w wariancji. Policzymy to niżej.
Przykład: pięć wersji jednego pytania
Pięć tysięcy studentów (dane symulowane, set.seed(3434)) losowo podzielono na pięć grup po 1000 osób. Pytanie dotyczyło tego, czy w ostatnim roku przyjęli lek na receptę bez recepty, żeby lepiej się uczyć. W symulacji znamy prawdę: odsetek wynosi 17.6% i jest wyższy na kierunkach medycznych oraz u osób z wyższym stresem. Pytani wprost zaprzeczają częściej na kierunkach medycznych (55% osób z cechą) niż na innych (35%).
- Pytanie bezpośrednie (tak/nie).
- Eksperyment listowy: grupa kontrolna dostaje cztery stwierdzenia neutralne, eksperymentalna te same i stwierdzenie drażliwe (dwie grupy po 1000 osób).
- Model Warnera: z prawdopodobieństwem p = .70 osoba odpowiada na stwierdzenie „Przyjąłem(-am)…”, a z prawdopodobieństwem .30 na jego zaprzeczenie.
- Odpowiedź wymuszona: osoba losuje liczbę 1–20; przy 1–3 odpowiada „tak”, przy 4–5 „nie”, a przy 6–20 zgodnie z prawdą.
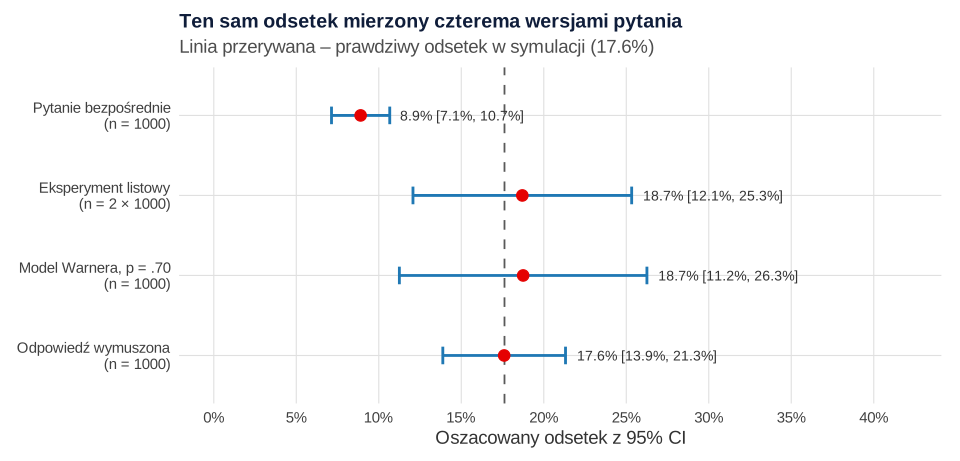
Pytanie wprost dało 8.9%, 95% CI [7.1, 10.7]. Przedział jest wąski, ale leży daleko od prawdy. Eksperyment listowy dał 18.7%, 95% CI [12.1, 25.3], model Warnera 18.7%, 95% CI [11.2, 26.3], a odpowiedź wymuszona 17.6%, 95% CI [13.9, 21.3]. Metody pośrednie trafiły w prawdziwą wartość, ale ich przedziały są od dwóch do ponad czterech razy szersze. Podobny wzór dało badanie walidacyjne Rosenfelda i in. (2016). Porównali oni oszacowania głosowania w referendum z oficjalnym wynikiem. Pytanie bezpośrednie istotnie zaniżało drażliwe głosy, a metody pośrednie były znacznie bliżej prawdy.
Eksperyment listowy: projekt list
Oszacowanie to różnica średnich liczby wskazań między grupami, a jego błąd standardowy rośnie z wariancją liczby wskazań stwierdzeń neutralnych. Dlatego projekt listy decyduje o precyzji. Glynn (2013) podaje zasady projektowania, które zmniejszają obciążenie i wariancję, oraz wzory na liczebność próby. W praktyce pilnuj trzech rzeczy:
- Unikaj efektu sufitu i podłogi. Kto w grupie eksperymentalnej wskaże wszystkie stwierdzenia, ujawnia „tak”. Kto nie wskaże żadnego, ujawnia „nie”. Nie dawaj stwierdzeń, które prawie wszyscy potwierdzają albo odrzucają.
- Połącz stwierdzenia ujemnie skorelowane. W przykładzie „Pracuję zarobkowo” i „Mam ponad 20 godzin zajęć w tygodniu” rzadko są prawdziwe naraz. Wariancja liczby wskazań w grupie kontrolnej wyniosła 0.468, a przy niezależnych stwierdzeniach o tych samych częstościach wyniosłaby 0.870.
- Dopisz stwierdzenie drażliwe tak, by nie odstawało formą ani długością. Kolejność stwierdzeń losuj.
W przykładzie nikt w grupie eksperymentalnej nie wskazał pięciu stwierdzeń, a zero wskazało 2.7% osób. Te osoby ujawniły odpowiedź „nie”, co przy pytaniu o zachowanie niepożądane zwykle nie szkodzi. Odsetki odpowiedzi 0–5 w obu grupach podaj w suplemencie.
Test błędu projektu
Estymator różnicy średnich opiera się na dwóch założeniach (Blair i Imai, 2012). Po pierwsze, dodanie stwierdzenia drażliwego nie zmienia odpowiedzi na stwierdzenia neutralne (brak błędu projektu, ang. design effect). Po drugie, respondenci nie kłamią w liczbie wskazań. Przy pierwszym założeniu odsetki „typów” respondentów (liczba wskazań neutralnych × odpowiedź drażliwa) wynikają z rozkładów odpowiedzi w obu grupach. Żaden z nich nie może być ujemny. Test Blaira i Imaia (2012), w pakiecie list funkcja ict.test(), sprawdza, czy któryś odsetek jest istotnie poniżej zera. Wartości p koryguje poprawką Bonferroniego.
W przykładzie wszystkie szacowane odsetki były nieujemne, a skorygowane p wyniosło 1, więc nie ma śladu błędu projektu. Pamiętaj jednak, że wynik nieistotny nie dowodzi braku problemu, zwłaszcza przy kilkuset osobach.
Regresja z kowariantami
Zwykle chcesz wiedzieć nie tylko, ile osób ma cechę, ale też kto. Imai (2011) zaproponował dwa estymatory regresji wielozmiennej dla eksperymentu listowego: nieliniową metodę najmniejszych kwadratów (NLS) i metodę największej wiarygodności (ML). Oba szacują model logitowy dla stwierdzenia drażliwego, tak jak regresja logistyczna, i osobny model dla stwierdzeń neutralnych. Imai (2011) zauważa, że ML bywa znacznie efektywniejszy. W funkcji ictreg() ML zakłada jednak dwumianowy rozkład liczby wskazań stwierdzeń neutralnych. Nasze stwierdzenia celowo skorelowaliśmy ujemnie, więc to założenie nie pasuje. ML dał niewiarygodne współczynniki: wyraz wolny −16.543 i efekt kierunku 15.023. Takie wartości to sygnał złej specyfikacji, a nie odkrycie. NLS nie zakłada rozkładu stwierdzeń neutralnych i dał sensowny model. Efekt kierunku medycznego wyniósł b = 1.239, SE = 0.465, a efekt stresu b = 0.492, SE = 0.243.
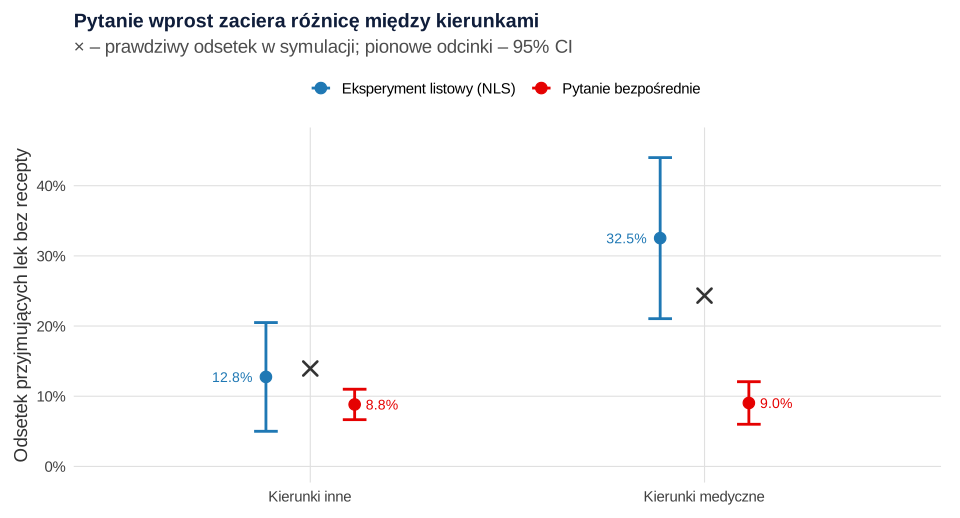
Z modelu policzyliśmy przewidywany odsetek w każdej podgrupie, uśredniony po rozkładzie stresu w próbie. Na kierunkach innych wyniósł 12.8%, 95% CI [5.0, 20.5], a na medycznych 32.5%, 95% CI [21.1, 44.0]. Pytanie wprost dało 8.8% i 9.0%, czyli prawie zerową różnicę. To częsty i groźny skutek pytania wprost. Gdy skłonność do zaprzeczania różni się między grupami, obciążone są nie tylko odsetki, ale też porównania i współczynniki regresji. Różnicę między listą a pytaniem bezpośrednim (3.9 i 23.5 punktu procentowego) możesz traktować jako oszacowanie obciążenia w podgrupie.
Randomizowane odpowiedzi: Warner i odpowiedź wymuszona
Warner (1965) zaproponował, by respondent losował, na które z dwóch przeciwnych stwierdzeń odpowiada. Podał też nieobciążony estymator odsetka. Jeśli λ to odsetek odpowiedzi „tak”, a p – prawdopodobieństwo stwierdzenia drażliwego, to λ = pπ + (1 − p)(1 − π), skąd:
W odpowiedzi wymuszonej wynik losowania z prawdopodobieństwem ptak narzuca „tak”, a z pprawda każe odpowiedzieć szczerze:
W przykładzie „tak” w modelu Warnera odpowiedziało 37.5% osób, a w odpowiedzi wymuszonej 28.2%. Ze wzorów wychodzą oszacowania z rysunku 1. Mianownik pokazuje cenę prywatności. W modelu Warnera dzielisz przez 2p − 1, więc im bliżej p = .5, tym większy błąd. Przy n = 1000 i odsetku 17.6% SE wynosi 0.078 dla p = .60, 0.038 dla .70, 0.024 dla .80 i 0.017 dla .90. Większe p daje jednak respondentom mniejszą ochronę i może obniżyć ich zaufanie. Blair i in. (2015) przeglądają standardowe schematy RRT, proponują dla nich regresję wielozmienną i analizę mocy oraz schematy oparte na słabszych założeniach.
Regresja dla odpowiedzi wymuszonej. Prawdopodobieństwo odpowiedzi „tak” to ptak + pprawda × logit−1(xβ). Taki model dopasujesz metodą największej wiarygodności przez optim(), a błędy standardowe policzysz z hesjanu. Efekt stresu wyniósł b = 0.496, SE = 0.137, p < .001, a iloraz szans dla kierunku medycznego OR = 1.41, 95% CI [0.83, 2.39]. Zwykła regresja logistyczna odpowiedzi „tak” zaniża współczynniki. Dla stresu dała 0.257, bo losowo wymuszone odpowiedzi rozmywają związek. W RRT nie analizuj więc odpowiedzi „tak” jak zwykłej zmiennej zależnej.
RRT zakłada, że respondent wykonuje instrukcję. Lensvelt-Mulders i in. (2005) w metaanalizie stwierdzili, że RRT daje trafniejsze dane niż pytania konwencjonalne, tym bardziej, im bardziej drażliwy temat. Wyniki różniły się jednak między badaniami w sposób niewyjaśniony. Instrukcję losowania sprawdź więc w pilotażu, a w ankiecie online wyjaśnij, dlaczego badacz nie zna wyniku losowania.
Koszt precyzji: kiedy metoda pośrednia się opłaca
Porównaj metody wariancją „na osobę”, czyli N × SE². Przy szczerym pytaniu bezpośrednim wynosi ona π(1 − π) = 0.145. W przykładzie odpowiedź wymuszona wymagała 2.5 raza większej próby dla tej samej precyzji, model Warnera 10.1 raza, a eksperyment listowy 15.8 raza. Lista zużywa dwie grupy, a jej wariancja zależy od stwierdzeń neutralnych. Dlatego przegrywa tu z RRT, mimo dobrze dobranych stwierdzeń.
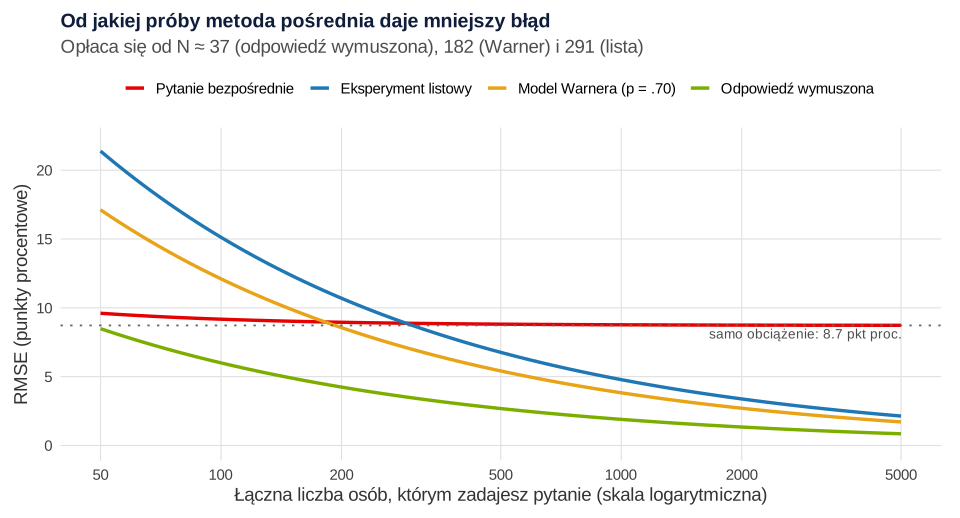
Pytanie bezpośrednie nie jest jednak szczere, więc trzeba porównać łączny błąd, czyli RMSE: pierwiastek z sumy kwadratu obciążenia i wariancji. Obciążenie pytania wprost nie maleje z liczbą osób, a wariancja metody pośredniej maleje. Od pewnego N metoda pośrednia wygrywa. To ten sam kompromis między obciążeniem a wariancją, o którym piszą Blair i in. (2020).
| Obciążenie pytania wprost | Odpowiedź wymuszona | Model Warnera (p = .70) | Eksperyment listowy |
|---|---|---|---|
| −8.7 pkt proc. (przykład) | 37 | 182 | 291 |
| −3 pkt proc. | 262 | 1489 | 2403 |
| −1 pkt proc. | 2214 | 13263 | 21482 |
Przy dużym obciążeniu każda metoda pośrednia opłaca się już przy kilkuset osobach. Przy obciążeniu 3 punktów eksperyment listowy wymaga około 2400 osób, żeby tylko wyrównać błąd pytania wprost. Jeśli chcesz porównywać podgrupy, potrzebujesz jeszcze więcej. Przed badaniem przyjmij realistyczne obciążenie z literatury swojej dziedziny i policz te progi dla swoich wariancji. Gotowy kod jest w przepisie 4. Liczebność wpisz do planu analizy.
Wybór praktyczny jest prosty. Odpowiedź wymuszona daje najwięcej precyzji, ale wymaga zrozumiałej instrukcji losowania i zaufania do niej. Eksperyment listowy jest prostszy dla respondenta i nie wymaga losowania po jego stronie, ale potrzebuje dużych prób i starannego projektu listy. Losowy przydział wersji to zwykła randomizacja, jak w eksperymencie conjoint i winietowym.
Jak opisać badanie w artykule
Podaj treść wszystkich stwierdzeń lub instrukcji losowania, prawdopodobieństwa, liczebności grup, estymator i sposób liczenia błędu. Dla listy dodaj rozkład liczby wskazań i wynik testu błędu projektu. Dla RRT podaj, jak sprawdzono zrozumienie instrukcji. Jeśli w badaniu było też pytanie bezpośrednie, pokaż oba oszacowania obok siebie.
Jeśli recenzent pyta o założenia eksperymentu listowego albo o regresję dla RRT, możemy sprawdzić analizę w ramach wsparcia statystycznego dla badaczy. Wpis o statystyce w pracy z kryminologii pokazuje prostszy przykład z modelem Warnera do pracy dyplomowej.
Przykład w R
Cztery przepisy uruchamiane po kolei w jednej sesji R. Pierwszy tworzy plik pytania-drazliwe-dane.csv (możesz go pobrać). Kolumna prawdziwej odpowiedzi nie trafia do pliku, tak jak w realnym badaniu. Potrzebny jest pakiet list. Estymatory RRT i regresja dla odpowiedzi wymuszonej są napisane ręcznie w bazowym R.
1. Dane i cztery oszacowania odsetka
R
# Dane symulowane: odsetek studentów, którzy w ostatnim roku przyjęli lek na receptę bez recepty,
# żeby lepiej się uczyć. 5000 osób losowo przydzielonych do pięciu wersji pytania (po 1000 osób).
# W symulacji znamy prawdziwą odpowiedź każdej osoby, czego w realnym badaniu nie ma.
set.seed(3434)
n <- 5000
d <- data.frame(id = 1:n,
                kierunek = factor(sample(c("inny", "medyczny"), n, replace = TRUE, prob = c(0.65, 0.35)),
                                  levels = c("inny", "medyczny")),
                stres = round(rnorm(n), 2))                       # stres akademicki (z)
d$prawda <- rbinom(n, 1, plogis(-1.9 + 0.8 * (d$kierunek == "medyczny") + 0.5 * d$stres))
d$wersja <- sample(rep(c("bezposrednie", "lista_kontrolna", "lista_eksperymentalna", "warner", "wymuszona"),
                       each = n / 5))

# 1. Pytanie bezpośrednie: część osób z cechą zaprzecza (na kierunkach medycznych częściej)
zaprzecza <- rbinom(n, 1, ifelse(d$kierunek == "medyczny", 0.55, 0.35))
d$bezp <- ifelse(d$wersja == "bezposrednie", d$prawda * (1 - zaprzecza), NA)

# 2. Eksperyment listowy: 4 stwierdzenia neutralne; 1. i 2. są ujemnie skorelowane
s1 <- rbinom(n, 1, 0.5)                                           # „Pracuję zarobkowo w czasie studiów”
s2 <- ifelse(runif(n) < 0.8, 1 - s1, rbinom(n, 1, 0.5))           # „Mam w tygodniu więcej niż 20 godzin zajęć”
s3 <- rbinom(n, 1, 0.30)                                          # „Ćwiczę co najmniej 3 razy w tygodniu”
s4 <- rbinom(n, 1, 0.20)                                          # „W ostatnim miesiącu byłem(-am) w teatrze”
kontrolne <- s1 + s2 + s3 + s4
d$lista <- ifelse(d$wersja == "lista_kontrolna", kontrolne,
                  ifelse(d$wersja == "lista_eksperymentalna", kontrolne + d$prawda, NA))
d$eksp <- as.integer(d$wersja == "lista_eksperymentalna")

# 3. Model Warnera: z prawdopodobieństwem p = .70 osoba odpowiada na stwierdzenie „Przyjąłem(-am)…”,
#    z prawdopodobieństwem .30 na jego zaprzeczenie „Nie przyjąłem(-am)…”
pw <- 0.70
d$warner <- ifelse(d$wersja == "warner", ifelse(runif(n) < pw, d$prawda, 1 - d$prawda), NA)

# 4. Odpowiedź wymuszona: losowanie liczby 1–20; 1–3 → „tak”, 4–5 → „nie”, 6–20 → odpowiedź prawdziwa
los <- sample(1:20, n, replace = TRUE)
p_tak <- 3 / 20; p_prawda <- 15 / 20
d$wymuszona <- ifelse(d$wersja == "wymuszona", ifelse(los <= 3, 1, ifelse(los <= 5, 0, d$prawda)), NA)
write.csv(d[, c("id", "kierunek", "stres", "wersja", "bezp", "lista", "eksp", "warner", "wymuszona")],
          "pytania-drazliwe-dane.csv", row.names = FALSE)

# Oszacowania odsetka i błędy standardowe (wzory)
wiersz <- function(est, se) c(est = est, se = se, dolna = est - 1.96 * se, gorna = est + 1.96 * se)
b <- na.omit(d$bezp); lt <- d$lista[d$wersja == "lista_eksperymentalna"]; lk <- d$lista[d$wersja == "lista_kontrolna"]
lw <- mean(d$warner, na.rm = TRUE); lf <- mean(d$wymuszona, na.rm = TRUE); m <- n / 5
wyniki <- rbind(
  bezposrednie = wiersz(mean(b), sqrt(mean(b) * (1 - mean(b)) / m)),
  lista        = wiersz(mean(lt) - mean(lk), sqrt(var(lt) / m + var(lk) / m)),
  warner       = wiersz((lw - (1 - pw)) / (2 * pw - 1), sqrt(lw * (1 - lw) / m) / (2 * pw - 1)),
  wymuszona    = wiersz((lf - p_tak) / p_prawda, sqrt(lf * (1 - lf) / m) / p_prawda))
round(wyniki, 3)
round(c(prawdziwy_odsetek = mean(d$prawda), odsetek_tak_warner = lw, odsetek_tak_wymuszona = lf), 3)

# Lista: rozkład liczby wskazań (0 i 5 w grupie eksperymentalnej ujawniają odpowiedź)
round(prop.table(table(grupa = d$wersja[!is.na(d$lista)], liczba = d$lista[!is.na(d$lista)]), 1), 3)
# Wariancja liczby wskazań w grupie kontrolnej a wariancja przy niezależnych stwierdzeniach
round(c(wariancja_kontrolnej = var(lk),
        gdyby_niezalezne = sum(c(0.5, 0.5, 0.3, 0.2) * (1 - c(0.5, 0.5, 0.3, 0.2)))), 3)
Wynik w R
               est    se dolna gorna
bezposrednie 0.089 0.009 0.071 0.107
lista        0.187 0.034 0.121 0.253
warner       0.187 0.038 0.112 0.263
wymuszona    0.176 0.019 0.139 0.213
    prawdziwy_odsetek    odsetek_tak_warner odsetek_tak_wymuszona
                0.176                 0.375                 0.282
                       liczba
grupa                       0     1     2     3     4
  lista_eksperymentalna 0.027 0.444 0.378 0.126 0.025
  lista_kontrolna       0.030 0.525 0.372 0.070 0.003
wariancja_kontrolnej     gdyby_niezalezne
               0.468                0.870
2. Eksperyment listowy: test błędu projektu i regresja
R
# Eksperyment listowy: test błędu projektu i regresja z kowariantami (wymaga obiektu d z przepisu 1)
suppressPackageStartupMessages(library(list))
dl <- subset(d, !is.na(lista))

# Test błędu projektu (Blair i Imai, 2012): czy dodanie stwierdzenia drażliwego zmieniło odpowiedzi
# na stwierdzenia neutralne? Ujemny szacowany odsetek któregoś typu respondentów to sygnał naruszenia.
test <- ict.test(dl$lista, dl$eksp, J = 4, gms = TRUE)
test

# Regresja (Imai, 2011): logit dla stwierdzenia drażliwego. Estymator ML zakłada dwumianowy rozkład
# liczby wskazań stwierdzeń neutralnych – przy stwierdzeniach ujemnie skorelowanych to założenie nie pasuje.
m_ml <- ictreg(lista ~ kierunek + stres, data = dl, treat = "eksp", J = 4, method = "ml")
round(coef(m_ml)[1:3], 3)                     # niewiarygodne wartości: sygnał złej specyfikacji
# Nieliniowa metoda najmniejszych kwadratów (NLS) nie zakłada rozkładu stwierdzeń neutralnych
m_lista <- ictreg(lista ~ kierunek + stres, data = dl, treat = "eksp", J = 4, method = "nls")
summary(m_lista)

# Odsetek w podgrupach kierunku: lista (predykcja NLS uśredniona po próbie) i pytanie bezpośrednie (odsetek „tak”)
db <- subset(d, !is.na(bezp))
podgrupy <- t(sapply(levels(d$kierunek), function(k) {
  nd <- transform(dl, kierunek = factor(k, levels = levels(d$kierunek)))
  pl <- unlist(predict(m_lista, newdata = nd, avg = TRUE, interval = "confidence")$fit)
  x <- db$bezp[db$kierunek == k]; pb <- mean(x); sb <- sqrt(pb * (1 - pb) / length(x))
  c(lista = pl, bezp = pb, bezp.lwr = pb - 1.96 * sb, bezp.upr = pb + 1.96 * sb, roznica = pl[[1]] - pb)
}))
round(podgrupy, 3)
# Dla kontroli: prawdziwy odsetek w podgrupach (znany tylko w symulacji)
round(tapply(d$prawda, d$kierunek, mean), 3)
Wynik w R
Test for List Experiment Design Effects

Estimated population proportions
                         est.   s.e.
pi(Y_i(0) = 0, Z_i = 1) 0.003 0.0074
pi(Y_i(0) = 1, Z_i = 1) 0.084 0.0223
pi(Y_i(0) = 2, Z_i = 1) 0.078 0.0140
pi(Y_i(0) = 3, Z_i = 1) 0.022 0.0052
pi(Y_i(0) = 4, Z_i = 1) 0.000 0.0000
pi(Y_i(0) = 0, Z_i = 0) 0.027 0.0051
pi(Y_i(0) = 1, Z_i = 0) 0.441 0.0167
pi(Y_i(0) = 2, Z_i = 0) 0.294 0.0194
pi(Y_i(0) = 3, Z_i = 0) 0.048 0.0096
pi(Y_i(0) = 4, Z_i = 0) 0.003 0.0017

 Y_i(0) is the (latent) count of 'yes' responses to the control items. Z_i is the (latent) binary response to the sensitive item.

Bonferroni-corrected p-value
If this value is below alpha, you reject the null hypothesis of no design effect. If it is above alpha, you fail to reject the null.

Sensitive Item 1
               1

     sensitive.(Intercept) sensitive.kierunekmedyczny
                   -16.543                     15.023
           sensitive.stres
                     0.407

Item Count Technique Regression

Call: ictreg(formula = lista ~ kierunek + stres, data = dl, treat = "eksp",
    J = 4, method = "nls")

Sensitive item
                     Est.    S.E.
(Intercept)      -2.00758 0.38382
kierunekmedyczny  1.23922 0.46459
stres             0.49176 0.24260

Control items
                     Est.    S.E.
(Intercept)      -0.50044 0.02837
kierunekmedyczny -0.05935 0.04887
stres             0.03109 0.02425

Residual standard error: 0.812699 with 997 degrees of freedom

Number of control items J set to 4. Treatment groups were indicated by '' and '' and the control group by ''.

         lista.fit lista.lwr lista.upr  bezp bezp.lwr bezp.upr roznica
inny         0.128     0.050     0.205 0.088    0.067    0.110   0.039
medyczny     0.325     0.211     0.440 0.090    0.060    0.121   0.235
    inny medyczny
   0.139    0.243
3. Regresja dla odpowiedzi wymuszonej i koszt precyzji
R
# Technika randomizowanych odpowiedzi: regresja logistyczna dla odpowiedzi wymuszonej
# i koszt precyzji obu technik (wymaga obiektów z przepisów 1–2)
dw <- subset(d, !is.na(wymuszona))
X <- model.matrix(~ kierunek + stres, data = dw)
# P(„tak” | x) = p_tak + p_prawda × logit⁻¹(xβ); log-wiarygodność rozkładu Bernoulliego
nll <- function(beta) {
  lam <- p_tak + p_prawda * plogis(drop(X %*% beta))
  -sum(dw$wymuszona * log(lam) + (1 - dw$wymuszona) * log(1 - lam))
}
fit <- optim(c(-1.5, 0, 0), nll, method = "BFGS", hessian = TRUE)
se <- sqrt(diag(solve(fit$hessian)))
tab <- cbind(b = fit$par, se = se, z = fit$par / se, p = 2 * pnorm(-abs(fit$par / se)))
rownames(tab) <- colnames(X)
round(tab, 3)
round(exp(fit$par[2] + c(OR = 0, dolna = -1.96, gorna = 1.96) * se[2]), 2)   # OR dla kierunku medycznego
# Te same predyktory w zwykłej regresji logistycznej odpowiedzi „tak” (błędnie, bez uwzględnienia losowania)
round(coef(summary(glm(wymuszona ~ kierunek + stres, family = binomial, data = dw)))[, 1:2], 3)

# Koszt precyzji: wariancja „na osobę” (N × SE²) względem szczerego pytania bezpośredniego.
# Lista zużywa 2000 osób (dwie wersje po 1000), pozostałe techniki po 1000.
pi_hat <- wyniki["wymuszona", "est"]; m <- 1000
v_szczere <- pi_hat * (1 - pi_hat)
v_lista <- 2 * (var(lt) + var(lk))
v_warner <- lw * (1 - lw) / (2 * pw - 1)^2
v_wymuszona <- lf * (1 - lf) / p_prawda^2
v <- c(szczere_bezposrednie = v_szczere, lista = v_lista, warner = v_warner, wymuszona = v_wymuszona)
round(cbind(wariancja_na_osobe = v, ile_razy_wieksza_proba = v / v_szczere,
            se_przy_N_1000 = sqrt(v / 1000)), 3)
# Model Warnera: błąd standardowy przy n = 1000 i odsetku 17.6% dla różnych p
p_siatka <- c(0.60, 0.70, 0.80, 0.90)
lam_p <- p_siatka * pi_hat + (1 - p_siatka) * (1 - pi_hat)
round(rbind(p = p_siatka, se_warner = sqrt(lam_p * (1 - lam_p) / m) / (2 * p_siatka - 1)), 3)
Wynik w R
                      b    se      z     p
(Intercept)      -1.742 0.189 -9.231 0.000
kierunekmedyczny  0.344 0.268  1.283 0.199
stres             0.496 0.137  3.612 0.000
   OR dolna gorna
 1.41  0.83  2.39
                 Estimate Std. Error
(Intercept)        -1.010      0.090
kierunekmedyczny    0.188      0.146
stres               0.257      0.069
                     wariancja_na_osobe ile_razy_wieksza_proba se_przy_N_1000
szczere_bezposrednie              0.145                  1.000          0.012
lista                             2.287                 15.768          0.048
warner                            1.465                 10.101          0.038
wymuszona                         0.360                  2.482          0.019
           [,1]  [,2]  [,3]  [,4]
p         0.600 0.700 0.800 0.900
se_warner 0.078 0.038 0.024 0.017
4. Od jakiej próby metoda pośrednia się opłaca
R
# Kiedy metoda pośrednia się opłaca: obciążenie a wariancja (wymaga obiektów z przepisów 1–3).
# Wariancje „na osobę” z przepisu 3; N = łączna liczba osób, którym zadajemy pytanie.
pi0 <- mean(d$prawda)                                   # prawdziwy odsetek (w realnym badaniu nieznany)
progi <- function(obc) {
  pd <- pi0 + obc; v_bezp <- pd * (1 - pd)
  # N, od którego RMSE metody pośredniej jest mniejszy niż RMSE obciążonego pytania bezpośredniego
  (c(lista = v_lista, warner = v_warner, wymuszona = v_wymuszona) - v_bezp) / obc^2
}
obc_sym <- wyniki["bezposrednie", "est"] - pi0
round(c(obciazenie_bezposredniego = obc_sym), 3)
rbind(`obciążenie z symulacji` = ceiling(progi(obc_sym)), `obciążenie −0.03` = ceiling(progi(-0.03)),
      `obciążenie −0.01` = ceiling(progi(-0.01)))
# RMSE przy N = 300 i N = 2000 (punkty procentowe)
rmse <- function(N, obc = obc_sym) { pd <- pi0 + obc
  100 * c(bezposrednie = sqrt(obc^2 + pd * (1 - pd) / N), lista = sqrt(v_lista / N),
          warner = sqrt(v_warner / N), wymuszona = sqrt(v_wymuszona / N)) }
round(rbind(`N = 300` = rmse(300), `N = 2000` = rmse(2000)), 1)
Wynik w R
obciazenie_bezposredniego
                   -0.087
                       lista warner wymuszona
obciążenie z symulacji   291    182        37
obciążenie −0.03        2403   1489       262
obciążenie −0.01       21482  13263      2214
         bezposrednie lista warner wymuszona
N = 300           8.9   8.7    7.0       3.5
N = 2000          8.7   3.4    2.7       1.3
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia przepisów 1–4 w R 4.5.3 (funkcje pakietów base i stats oraz pakiet list); rysunki przygotowano w pakietach ggplot2 i svglite.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- list (wersja 9.2.6): Blair, G., & Imai, K. (2024). list: Statistical methods for the item count technique and list experiment (R package version 9.2.6) [Computer software]. https://CRAN.R-project.org/package=list
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Metoda pośrednia przy małej próbie. Przy kilkuset osobach i małym obciążeniu lista daje większy łączny błąd niż pytanie wprost. Policz progi przed badaniem.
- Lista ze stwierdzeniami „zawsze tak” lub „zawsze nie”. Efekt sufitu i podłogi ujawnia odpowiedzi i skłania do ich zniekształcania.
- Brak testu błędu projektu. Raportuj rozkład wskazań i wynik testu Blaira i Imaia (2012), nawet gdy jest nieistotny.
- Ślepe zaufanie do estymatora ML. Współczynniki rzędu ±15 w modelu logitowym oznaczają złą specyfikację. Porównaj ML z NLS.
- Zwykła regresja logistyczna na odpowiedziach z RRT. Losowo wymuszone odpowiedzi zaniżają współczynniki. Modeluj prawdopodobieństwo „tak” razem z mechanizmem losowania.
- Porównania podgrup z pytania wprost. Gdy skłonność do zaprzeczania różni się między grupami, różnica może zniknąć albo się odwrócić.
- Wartość p w modelu Warnera bliska .5. Błąd standardowy rośnie wtedy bez ograniczeń.
Najczęstsze pytania
Eksperyment listowy czy technika randomizowanych odpowiedzi – co wybrać?
Odpowiedź wymuszona daje zwykle najmniejszy błąd standardowy, ale wymaga zrozumiałej instrukcji losowania i zaufania respondentów. Eksperyment listowy jest prostszy dla badanego, lecz potrzebuje dwóch grup i dużej próby. W przykładzie dla tej samej precyzji co szczere pytanie wprost odpowiedź wymuszona wymagała 2.5 raza większej próby, a lista 15.8 raza.
Jak sprawdzić błąd projektu w eksperymencie listowym?
Użyj testu Blaira i Imaia (2012), w R funkcji ict.test() z pakietu list. Test szacuje odsetki typów respondentów i sprawdza, czy któryś jest istotnie ujemny, co oznaczałoby, że stwierdzenie drażliwe zmieniło odpowiedzi na stwierdzenia neutralne. Raportuj wynik razem z rozkładem liczby wskazań w obu grupach.
Jak zrobić regresję dla danych z eksperymentu listowego?
Funkcja ictreg() z pakietu list szacuje model logitowy dla stwierdzenia drażliwego metodą NLS albo ML (Imai, 2011). ML jest efektywniejszy, ale zakłada dwumianowy rozkład stwierdzeń neutralnych. Gdy daje współczynniki rzędu ±15, przejdź na NLS i porównaj wyniki.
Od jakiej liczebności próby opłaca się metoda pośrednia?
Zależy od obciążenia pytania wprost. Porównaj RMSE: obciążenie nie maleje z próbą, a wariancja metody pośredniej tak. W przykładzie przy obciążeniu 8.7 punktu eksperyment listowy wygrywał od około 291 osób łącznie, a przy obciążeniu 3 punktów dopiero od około 2400.
Dlaczego w modelu Warnera prawdopodobieństwo nie może wynosić .5?
Estymator Warnera dzieli przez 2p − 1, więc przy p = .5 odpowiedzi nie niosą żadnej informacji o odsetku. Im bliżej .5, tym większy błąd standardowy: w przykładzie przy n = 1000 wynosił 0.078 dla p = .60 i 0.024 dla p = .80. Wyższe p daje jednak mniejszą ochronę prywatności.
Powiązane hasła
Przeczytaj też
Eksperyment conjoint i winietowy
Atrybuty i zadania, AMCE z błędami klastrowanymi, średnie brzegowe w podgrupach i winiety w modelu mieszanym – na danych w R.
Czytaj →PoradnikNajczęstsze błędy w ankietach
Pytania dwa w jednym, złe kafeterie, wielkie macierze i brak „nie dotyczy” – przykłady źle/dobrze z audytów ankiet i lista kontrolna przed startem.
Czytaj →PoradnikStatystyka w pracy z kryminologii
Winieta o karze, lęk przed przestępczością, zliczenia wiktymizacji, odsetki zgłoszeń i pytania drażliwe: modele, wielkość efektu, zdania APA i kod R.
Czytaj →Planujesz badanie z pytaniami drażliwymi albo recenzent pyta o eksperyment listowy?
Pomożemy dobrać technikę i liczebność próby, zaprojektować listę lub schemat losowania oraz policzyć i opisać regresję tak, żebyś mógł(a) samodzielnie uzasadnić wyniki przed recenzentami.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Blair, G., & Imai, K. (2012). Statistical analysis of list experiments. Political Analysis, 20(1), 47–77. https://doi.org/10.1093/pan/mpr048 ● Otwarty dostęp
- Blair, G., Coppock, A., & Moor, M. (2020). When to worry about sensitivity bias: A social reference theory and evidence from 30 years of list experiments. American Political Science Review, 114(4), 1297–1315. https://doi.org/10.1017/s0003055420000374 ● Otwarty dostęp
- Blair, G., Imai, K., & Zhou, Y.-Y. (2015). Design and analysis of the randomized response technique. Journal of the American Statistical Association, 110(511), 1304–1319. https://doi.org/10.1080/01621459.2015.1050028
- Glynn, A. N. (2013). What can we learn with statistical truth serum? Design and analysis of the list experiment. Public Opinion Quarterly, 77(S1), 159–172. https://doi.org/10.1093/poq/nfs070 ● Otwarty dostęp
- Imai, K. (2011). Multivariate regression analysis for the item count technique. Journal of the American Statistical Association, 106(494), 407–416. https://doi.org/10.1198/jasa.2011.ap10415
- Lensvelt-Mulders, G. J. L. M., Hox, J. J., van der Heijden, P. G. M., & Maas, C. J. M. (2005). Meta-analysis of randomized response research: Thirty-five years of validation. Sociological Methods & Research, 33(3), 319–348. https://doi.org/10.1177/0049124104268664 ● Otwarty dostęp: pełny tekst
- Rosenfeld, B., Imai, K., & Shapiro, J. N. (2016). An empirical validation study of popular survey methodologies for sensitive questions. American Journal of Political Science, 60(3), 783–802. https://doi.org/10.1111/ajps.12205
- Tourangeau, R., & Yan, T. (2007). Sensitive questions in surveys. Psychological Bulletin, 133(5), 859–883. https://doi.org/10.1037/0033-2909.133.5.859
- Warner, S. L. (1965). Randomized response: A survey technique for eliminating evasive answer bias. Journal of the American Statistical Association, 60(309), 63–69. https://doi.org/10.1080/01621459.1965.10480775
Cytowania BibTeX
@article{blair2012statistical, author={Blair, Graeme and Imai, Kosuke}, title={{Statistical analysis of list experiments}}, journal={Political Analysis}, year={2012}, volume={20}, number={1}, pages={47--77}, doi={10.1093/pan/mpr048}}@article{blair2020when, author={Blair, Graeme and Coppock, Alexander and Moor, Margaret}, title={{When to worry about sensitivity bias: A social reference theory and evidence from 30 years of list experiments}}, journal={American Political Science Review}, year={2020}, volume={114}, number={4}, pages={1297--1315}, doi={10.1017/s0003055420000374}}@article{blair2015design, author={Blair, Graeme and Imai, Kosuke and Zhou, Yang-Yang}, title={{Design and analysis of the randomized response technique}}, journal={Journal of the American Statistical Association}, year={2015}, volume={110}, number={511}, pages={1304--1319}, doi={10.1080/01621459.2015.1050028}}@article{glynn2013what, author={Glynn, Adam N.}, title={{What can we learn with statistical truth serum? Design and analysis of the list experiment}}, journal={Public Opinion Quarterly}, year={2013}, volume={77}, number={S1}, pages={159--172}, doi={10.1093/poq/nfs070}}@article{imai2011multivariate, author={Imai, Kosuke}, title={{Multivariate regression analysis for the item count technique}}, journal={Journal of the American Statistical Association}, year={2011}, volume={106}, number={494}, pages={407--416}, doi={10.1198/jasa.2011.ap10415}}@article{lensveltmulders2005meta, author={Lensvelt-Mulders, Gerty J. L. M. and Hox, Joop J. and van der Heijden, Peter G. M. and Maas, Cora J. M.}, title={{Meta-analysis of randomized response research: Thirty-five years of validation}}, journal={Sociological Methods \& Research}, year={2005}, volume={33}, number={3}, pages={319--348}, doi={10.1177/0049124104268664}}@article{rosenfeld2016empirical, author={Rosenfeld, Bryn and Imai, Kosuke and Shapiro, Jacob N.}, title={{An empirical validation study of popular survey methodologies for sensitive questions}}, journal={American Journal of Political Science}, year={2016}, volume={60}, number={3}, pages={783--802}, doi={10.1111/ajps.12205}}@article{tourangeau2007sensitive, author={Tourangeau, Roger and Yan, Ting}, title={{Sensitive questions in surveys}}, journal={Psychological Bulletin}, year={2007}, volume={133}, number={5}, pages={859--883}, doi={10.1037/0033-2909.133.5.859}}@article{warner1965randomized, author={Warner, Stanley L.}, title={{Randomized response: A survey technique for eliminating evasive answer bias}}, journal={Journal of the American Statistical Association}, year={1965}, volume={60}, number={309}, pages={63--69}, doi={10.1080/01621459.1965.10480775}}