Pięć typowych projektów w pracy z kryminologii
Prace dyplomowe z kryminologii rzadko opierają się na jednym typie danych. Ten sam student może zbadać ankietą postawy wobec kary, policzyć, ile razy respondenci padli ofiarą oszustwa w internecie, i porównać odsetki osób, które zgłosiły zdarzenie na policję. Każdy z tych celów wymaga innego modelu: odpowiedź porządkowa – regresji porządkowej, wynik skali – regresji liniowej, liczba zdarzeń – modelu dla zliczeń, odsetek – przedziału ufności dla proporcji. Do tego dochodzi cecha szczególna kierunku: pytasz o sprawy drażliwe, więc część odpowiedzi może być zaniżona, a dane wymagają starannej ochrony. Tabela porządkuje pięć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Dane | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Postawy wobec kary (winieta) | Czy uprzednia karalność sprawcy zmienia rekomendowaną reakcję? | odpowiedź porządkowa w 5 kategoriach, losowo przydzielone wersje opisu | regresja porządkowa (proporcjonalne szanse) | iloraz szans (OR) z 95% CI |
| 2. Lęk przed przestępczością | Co wiąże się z lękiem mieszkańców? | wynik skali 1–5 i kilka predyktorów | regresja wieloraka | b i β z 95% CI, R² |
| 3. Wiktymizacja w internecie | Od czego zależy liczba incydentów w ciągu roku? | zliczenia 0, 1, 2…, dużo zer | regresja Poissona → ujemna dwumianowa | iloraz częstości (IRR) z 95% CI |
| 4. Zgłaszanie zdarzeń na policję | Czy odsetek zgłoszeń zależy od rodzaju zdarzenia? | tak/nie w grupach | odsetki z CI Wilsona, chi-kwadrat, różnica proporcji | V Craméra, różnica w punktach procentowych z CI |
| 5. Pytanie drażliwe | Ile osób naprawdę jeździ bez biletu? | odpowiedź wprost i technika randomizowanej odpowiedzi | estymator Warnera z przedziałem ufności | różnica oszacowań, utrata precyzji |
Wszystkie dane w przykładach są symulowane, a liczby nie opisują żadnej rzeczywistej populacji. Pełny kod znajdziesz w sekcji Przykład w R. Jeśli w Twojej pracy przeważa sondaż opinii z ważeniem, zajrzyj też do poradnika statystyka w pracy z socjologii, a jeśli badasz instytucje i służby – do wpisu statystyka w pracy z bezpieczeństwa narodowego. Nie wiesz, który test pasuje do Twojej hipotezy? Pomoże kreator doboru testu, a cały proces od pytania do rozdziału wyników opisuje przewodnik po statystyce w pracy dyplomowej.
Zanim zaczniesz: drażliwe pytania i ochrona respondentów
Pytania o przestępstwa są pytaniami drażliwymi. Tourangeau i Yan (2007) w przeglądzie badań nad pytaniami drażliwymi pokazują, że błędne odpowiedzi są częste i zależą od sytuacji: od tego, czy respondent ma coś do ukrycia, i od warunków badania. Respondenci „redagują” odpowiedzi, aby uniknąć zakłopotania albo konsekwencji. W kryminologii dotyczy to zarówno pytań o własne zachowania, jak i o bycie ofiarą, bo część osób wstydzi się przyznać do oszustwa czy nękania. Dlatego wybór trybu badania (ankieta internetowa bez ankietera zamiast wywiadu), sposób sformułowania pytań i zapewnienie anonimowości są tu częścią metodologii, a nie formalnością. Szerzej zjawisko opisuje hasło aprobata społeczna.
Nie pytaj o więcej, niż potrzebujesz. Dane o naruszeniach prawa i o byciu ofiarą wymagają szczególnej ostrożności. Zanim zbierzesz dane, ustal z promotorem, czy badanie wymaga opinii komisji etycznej, i przygotuj informację dla uczestników zgodną z zasadami opisanymi w haśle świadoma zgoda i RODO w badaniach. Unikaj pytań o konkretne, możliwe do zidentyfikowania czyny i osoby. Nie zbieraj adresów e-mail w tym samym pliku co odpowiedzi. Nie dobieraj też przykładów ani zmiennych tak, aby utrwalały stereotypy o grupach społecznych: w tym poradniku sprawca w winiecie nie ma narodowości, wyglądu ani miejsca zamieszkania.
Nie podawaj danych o przestępczości bez źródła. Jeśli we wstępie pracy przywołujesz liczby przestępstw lub odsetki ofiar, cytuj konkretną publikację lub oficjalną statystykę z datą odczytu i zaznacz, czy chodzi o przestępstwa zarejestrowane, czy o deklaracje respondentów. To dwa różne zjawiska, bo nie każde zdarzenie trafia do policji, a projekt 4 pokazuje, jak tę lukę badać.
Projekt 1. Postawy wobec kary: eksperyment winietowy
Pytanie „Czy kary w Polsce są zbyt łagodne?” mierzy ogólną punitywność, ale niewiele mówi o tym, co wpływa na ocenę konkretnej sprawy. Lepszym narzędziem jest eksperyment winietowy: respondent czyta krótki opis zdarzenia, w którym badacz systematycznie zmienia wybrane cechy, i wskazuje właściwą reakcję. Atzmüller i Steiner (2010) zwracają uwagę, że sposób doboru winiet (losowy albo według planu eksperymentalnego) ma poważne konsekwencje dla analizy i interpretacji efektów, w tym interakcji. W pracy dyplomowej najprostszy jest plan czynnikowy 2 × 2, w którym każda osoba dostaje jedną losowo przydzieloną wersję.
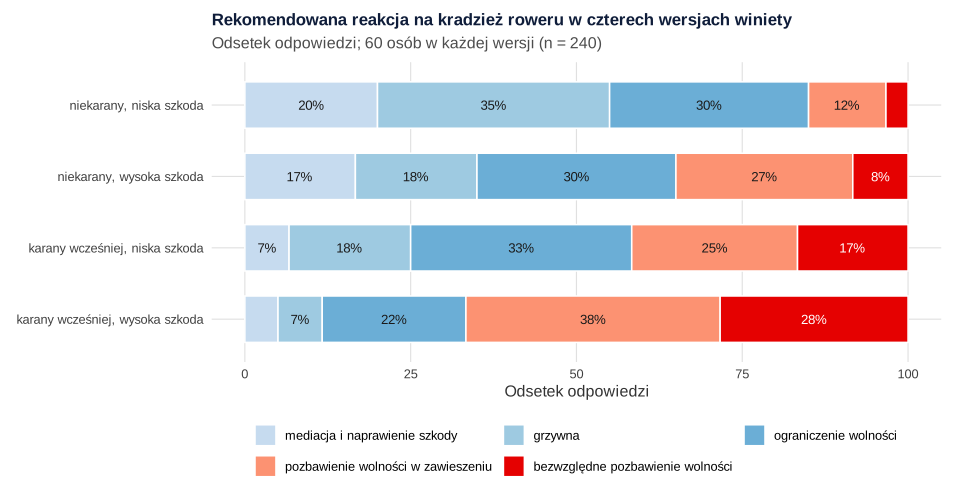
Przykład: 240 osób przeczytało opis kradzieży roweru. Losowo zmieniano dwie cechy: uprzednią karalność sprawcy (nie/tak) i wartość szkody (niska/wysoka), po 60 osób na wersję. Odpowiedź miała pięć uporządkowanych kategorii: mediacja i naprawienie szkody, grzywna, ograniczenie wolności, pozbawienie wolności w zawieszeniu, bezwzględne pozbawienie wolności. Odsetek wskazań kary pozbawienia wolności (dwie najsurowsze kategorie) wynosił 15.0% przy sprawcy niekaranym i niskiej szkodzie, 35.0% przy niekaranym i wysokiej szkodzie, 41.7% przy karanym i niskiej szkodzie oraz 66.7% przy karanym i wysokiej szkodzie.
Dlaczego regresja porządkowa, a nie średnia
Kategorie odpowiedzi są uporządkowane, ale odległości między nimi nie są równe: „krok” od grzywny do ograniczenia wolności nie jest tym samym co krok od kary w zawieszeniu do bezwzględnego więzienia. Dlatego zamiast porównywać średnie z kodów 1–5 użyj regresji porządkowej. Model proporcjonalnych szans podaje jeden iloraz szans dla każdej cechy winiety: o ile rosną szanse wskazania reakcji surowszej zamiast łagodniejszej, niezależnie od tego, w którym miejscu skali postawimy granicę.
Najpierw sprawdź interakcję, bo plan 2 × 2 do tego służy. Model z interakcją nie był lepszy od modelu addytywnego, χ²(1) = 0.08, p = .783, więc efekt karalności był podobny przy niskiej i wysokiej szkodzie. W modelu addytywnym uprzednia karalność zwiększała szanse wskazania surowszej reakcji 3.81 raza, 95% CI [2.37, 6.19], z = 5.48, p < .001, a wysoka szkoda 2.31 raza, 95% CI [1.45, 3.70], z = 3.52, p < .001. Test efektów nominalnych nie wskazał naruszenia założenia proporcjonalnych szans (p = .935 dla karalności i p = .241 dla szkody). Pełną procedurę, w tym odczyt progów i prawdopodobieństw przewidywanych, opisujemy w poradniku regresja porządkowa krok po kroku.
Pamiętaj o ograniczeniu, które warto wpisać do dyskusji: winieta mierzy deklarowaną ocenę hipotetycznej sprawy. Nie wiesz, jak ta sama osoba oceniłaby prawdziwą sprawę w sądzie. Uzupełnij badanie o pytanie sprawdzające (czy respondent zapamiętał wartość szkody) i analizuj tylko kompletne odpowiedzi albo wykonaj analizę z wykluczeniem osób, które nie zdały kontroli.
Projekt 2. Lęk przed przestępczością w sondażu mieszkańców
Lęk przed przestępczością to jeden z najczęstszych tematów prac z kryminologii i jednocześnie jeden z najtrudniejszych do zmierzenia. Ferraro i LaGrange (1987) w przeglądzie piętnastu lat badań pokazali, że miary lęku i miary szacowanego ryzyka korelują tylko umiarkowanie, a mimo to wiele badań mierzyło ryzyko i wyciągało wnioski o lęku. Pytanie „Jak bezpiecznie czujesz się, chodząc sam po zmroku?” nie mówi, czego respondent się boi, i miesza emocję z oceną sytuacji. Lepiej zapytać osobno o obawę przed konkretnymi zdarzeniami (np. kradzieżą, napadem, włamaniem) i osobno o subiektywne prawdopodobieństwo, że się wydarzą.
Przykład: 400 mieszkańców odpowiedziało na cztery pytania o obawę przed konkretnymi zdarzeniami (1 – wcale się nie obawiam, 5 – bardzo się obawiam). Wynik skali to średnia pozycji, M = 2.79, SD = 0.77, a jej spójność wewnętrzna była dobra (α = .80). Lęk korelował z szacowanym ryzykiem na poziomie r = .35, czyli umiarkowanie. Tak niska zbieżność to argument, by w pracy nie traktować tych miar zamiennie.
Regresja wieloraka i co z niej raportować
Predyktory lęku wybierz z teorii, a nie z listy wszystkich pytań metryczkowych. Tu są to płeć, wiek, doświadczenie wiktymizacji w ciągu ostatnich trzech lat i postrzegany nieład w okolicy (np. zaśmiecenie, zniszczone przystanki, zakłócanie spokoju), mierzony skalą 1–5. Model regresji wielorakiej wyjaśniał 10.7% wariancji lęku, R² = .107, skorygowane R² = .098, F(4, 395) = 11.86, p < .001.
| Predyktor | b [95% CI] | t(395) | p | β |
|---|---|---|---|---|
| Płeć (mężczyzna vs kobieta) | −0.31 [−0.45, −0.16] | −4.17 | < .001 | −0.40a |
| Wiek (lata) | 0.001 [−0.003, 0.005] | 0.37 | .711 | .02 |
| Wiktymizacja w ostatnich 3 latach (tak vs nie) | 0.20 [0.02, 0.37] | 2.17 | .030 | 0.25a |
| Postrzegany nieład (1–5) | 0.25 [0.16, 0.34] | 5.31 | < .001 | .25 |
a Dla zmiennych 0/1 podano różnicę w odchyleniach standardowych lęku, a nie klasyczne β, które dla zmiennej dychotomicznej trudno zinterpretować.
Mężczyźni deklarowali niższy lęk niż kobiety o 0.31 punktu, a osoby, które były ofiarą przestępstwa, wyższy o 0.20 punktu. Wzrost postrzeganego nieładu o 1 punkt wiązał się z lękiem wyższym o 0.25 punktu. Wiek nie wiązał się z lękiem po uwzględnieniu pozostałych zmiennych. To badanie przekrojowe, więc pisz o związkach, a nie o przyczynach: lęk może skłaniać ludzi do zauważania nieładu, a nie tylko odwrotnie. Krok po kroku – z diagnostyką reszt i współliniowością – regresję opisujemy w poradniku regresja wieloraka krok po kroku.
Projekt 3. Ile razy? Wiktymizacja w internecie jako dane zliczeniowe
Pytania typu „Ile razy w ciągu ostatnich 12 miesięcy…” dają zliczenia: liczby całkowite od zera w górę. W kryminologii to bardzo częsty typ danych – liczba zdarzeń wiktymizacji, liczba deklarowanych wykroczeń, liczba interwencji. Zliczenia mają zwykle wiele zer i długi prawy ogon, więc ani test t, ani zwykła regresja liniowa nie są dla nich właściwe. Gardner i in. (1995) opisują problemy wynikające z analizowania liczebności zwykłą regresją liniową i pokazują, że regresja Poissona myli, gdy dane są nadmiernie rozproszone.
Przykład pochodzi z teorii rutynowych aktywności. Cohen i Felson (1979) wyjaśniali przestępstwa nie cechami sprawców, lecz okolicznościami: do zdarzenia dochodzi, gdy w tym samym czasie i miejscu spotykają się zmotywowany sprawca, odpowiedni cel i brak skutecznego opiekuna. W internecie „opiekunem” mogą być zabezpieczenia konta, a „ekspozycją” – czas spędzany w sieci i zakupy online. Zbadano 320 studentów. Zmienna zależna to liczba incydentów w ciągu 12 miesięcy (np. przejęcie konta, oszustwo przy zakupie, nękanie w wiadomościach). Predyktory: liczba godzin w internecie dziennie, robienie zakupów online (tak/nie) i liczba stosowanych zabezpieczeń (0–5).
Krok 1. Opis rozkładu
Średnia liczba incydentów wynosiła 0.53, wariancja 1.08, mediana 0, a 69.1% osób (221 z 320) nie zgłosiło żadnego incydentu. Najwyższa wartość to 6. Wariancja dwa razy większa od średniej to pierwszy sygnał, że rozkład Poissona, w którym obie te wartości są równe, nie będzie pasował. W pracy podaj taki opis przed modelem: średnią, wariancję, odsetek zer i tabelę liczebności, a nie samą średnią z odchyleniem standardowym.
Krok 2. Regresja Poissona i nadmierne rozproszenie
Regresja Poissona to punkt wyjścia. Po dopasowaniu modelu policz współczynnik rozproszenia: sumę kwadratów reszt Pearsona podzieloną przez liczbę stopni swobody. Wyszło 1.60, czyli wyraźnie więcej niż 1. Przy nadmiernym rozproszeniu model Poissona daje zbyt małe błędy standardowe, a więc zbyt wąskie przedziały ufności i zbyt małe wartości p.
Krok 3. Regresja ujemna dwumianowa
Regresja ujemna dwumianowa ma dodatkowy parametr, który pozwala, by wariancja była większa od średniej. Test ilorazu wiarygodności zdecydowanie wskazał na ten model, χ²(1) = 41.35, p < .001 (wartość p podzielono przez 2, bo parametr rozproszenia leży na granicy dopuszczalnych wartości). AIC spadło z 639.3 do 599.9, a parametr θ wyniósł 0.82 (SE = 0.22). Berk i MacDonald (2008) przestrzegają jednak przed traktowaniem modelu ujemnego dwumianowego jako automatycznego „rozwiązania” nadmiernego rozproszenia: pokazują, że jest on właściwy tylko przy określonych założeniach, a rozproszenie może wynikać np. z pominiętych predyktorów lub zależności między obserwacjami. Dlatego wybór modelu uzasadnij danymi i teorią, a nie samym testem.
Krok 4. Ile zer przewiduje model?
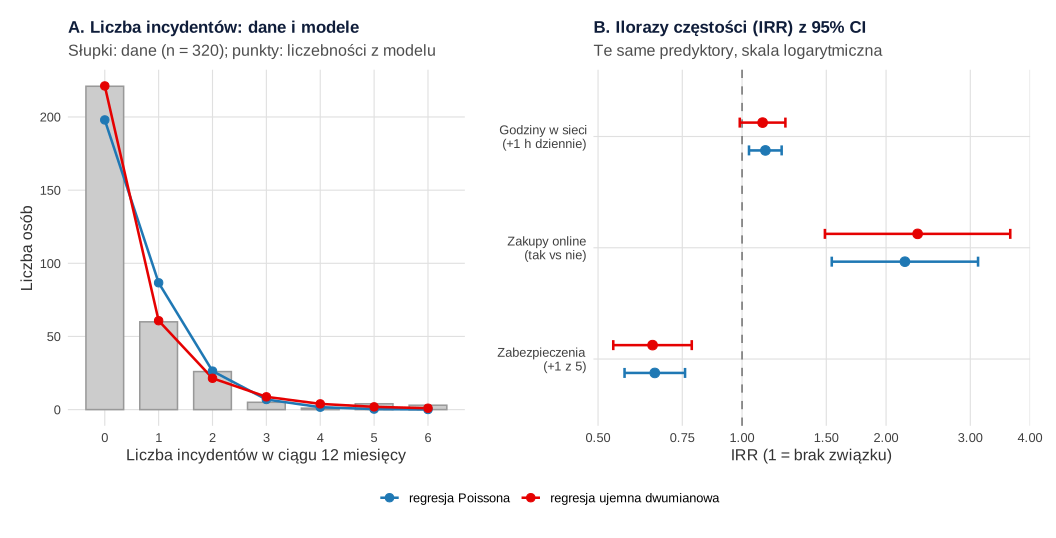
Rysunek 2A pokazuje najprostszą diagnostykę: porównanie obserwowanych liczebności z oczekiwanymi. Model Poissona przewidywał 198.0 osób bez incydentu (obserwowano 221) i 86.7 osób z jednym incydentem (obserwowano 60). Model ujemny dwumianowy przewidywał odpowiednio 221.2 i 60.8, czyli niemal dokładnie tyle, ile było w danych. Gdyby nawet model ujemny dwumianowy wyraźnie zaniżał liczbę zer, rozważ model z nadmiarem zer. Gdyby respondenci byli obserwowani przez różny czas (np. część od 6, a część od 12 miesięcy), dodaj do modelu offset z logarytmem czasu obserwacji. Oba warianty, z kodem i interpretacją, opisujemy w poradniku regresja dla zliczeń krok po kroku.
Krok 5. Interpretacja: ilorazy częstości
Współczynniki modelu dla zliczeń są w skali logarytmu, więc w pracy podaj ich wykładnik – iloraz częstości (IRR, ang. incidence rate ratio). IRR = 2.33 dla zakupów online oznacza, że osoby robiące zakupy w sieci miały średnio 2.33 raza więcej incydentów niż osoby, które ich nie robią, przy tych samych wartościach pozostałych zmiennych. IRR = 0.65 dla zabezpieczeń oznacza, że każde kolejne zabezpieczenie wiązało się z liczbą incydentów mniejszą o około 35%. Przewidywane wartości dobrze to obrazują: student spędzający w sieci 6 godzin dziennie, robiący zakupy online i stosujący 2 zabezpieczenia miał według modelu średnio 0.80 incydentu rocznie, a ten sam student z 5 zabezpieczeniami – 0.22.
Najważniejsza lekcja z rysunku 2B dotyczy godzin w internecie. W modelu Poissona ich związek z liczbą incydentów był istotny, IRR = 1.12, 95% CI [1.03, 1.21], p = .005. W modelu ujemnym dwumianowym oszacowanie było podobne, ale przedział szerszy i obejmował 1, IRR = 1.10, 95% CI [0.99, 1.23], p = .078. Wniosek z błędnego modelu zmienia się więc z „im więcej godzin w sieci, tym więcej incydentów” na „związek nie jest pewny”. Zwykła regresja liniowa na tych samych danych również dała dla godzin p = .047, czyli wniosek zbyt optymistyczny. Opis wyników możesz potem sprawdzić w generatorze opisu wyników APA.
| Predyktor | IRR [95% CI] – ujemna dwumianowa | z | p | IRR [95% CI] – Poisson |
|---|---|---|---|---|
| Godziny w internecie dziennie | 1.10 [0.99, 1.23] | 1.76 | .078 | 1.12 [1.03, 1.21] |
| Zakupy online (tak vs nie) | 2.33 [1.49, 3.64] | 3.71 | < .001 | 2.19 [1.54, 3.11] |
| Liczba zabezpieczeń (0–5) | 0.65 [0.54, 0.79] | −4.46 | < .001 | 0.66 [0.57, 0.76] |
Projekt 4. Odsetki w grupach: kto zgłasza zdarzenie na policję
Badania wiktymizacyjne pytają nie tylko o to, czy ktoś był ofiarą, ale też czy zgłosił zdarzenie. Odsetek zgłoszeń w różnych grupach zdarzeń to prosty, a bardzo kryminologiczny wynik: pokazuje, które zdarzenia rzadziej trafiają do oficjalnych statystyk. Przykład: 360 studentów, którzy w ostatnim roku doświadczyli jednego z trzech zdarzeń, odpowiedziało, czy je zgłosili.
| Rodzaj zdarzenia | Zgłoszono / n | % zgłoszeń [95% CI] | Reszta standaryzowana skorygowana |
|---|---|---|---|
| Kradzież | 74 / 150 | 49.3 [41.4, 57.3] | 5.55 |
| Oszustwo w internecie | 38 / 120 | 31.7 [24.0, 40.4] | −0.40 |
| Nękanie w internecie | 7 / 90 | 7.8 [3.8, 15.2] | −5.89 |
Przy każdym odsetku podaj przedział ufności dla proporcji. Przy małych grupach i odsetkach bliskich 0% lub 100% wybierz przedział Wilsona zamiast prostego wzoru Walda, który może dawać nawet ujemne granice. Odsetek zgłoszeń różnił się między rodzajami zdarzeń, χ²(2) = 44.05, p < .001, V Craméra = .35. Najmniejsza liczebność oczekiwana wynosiła 29.8, więc warunek testu był spełniony. Reszty standaryzowane skorygowane pokazują, że wynik „robią” dwie skrajne grupy: kradzieże zgłaszano częściej, a nękanie rzadziej, niż wynikałoby z niezależności. Odczytywanie reszt i tabel większych niż 2 × 2 opisujemy w poradniku test chi-kwadrat krok po kroku.
Gdy hipoteza dotyczy dwóch konkretnych grup, podaj różnicę odsetków w punktach procentowych z przedziałem ufności, a nie tylko wynik testu. Newcombe (1998) porównał jedenaście metod i pokazał, że proste przedziały mają słabe pokrycie, a metoda łącząca przedziały Wilsona dla obu proporcji działa dobrze. Kradzieże zgłaszano częściej niż oszustwa w internecie o 17.7 punktu procentowego, 95% CI [5.9, 28.7]. Szczegóły opisujemy w poradniku jak porównać odsetki w dwóch grupach, a pojedynczą tabelę 2 × 2 możesz policzyć w kalkulatorze tabeli 2 × 2. Pamiętaj, że próba to studenci, którzy sami zgodzili się wziąć udział w badaniu, więc odsetki opisują badaną grupę, a nie wszystkie ofiary takich zdarzeń.
Projekt 5. Pytanie drażliwe: technika randomizowanej odpowiedzi
Gdy pytasz o własne naruszenia przepisów, nawet w anonimowej ankiecie część osób zaprzeczy. Warner (1965) zaproponował technikę randomizowanej odpowiedzi (ang. randomized response technique, RRT). Respondent w ukryciu losuje (np. kostką albo datą urodzenia bliskiej osoby), na które z dwóch stwierdzeń odpowiada: „Zdarzyło mi się w ostatnim roku jechać komunikacją bez ważnego biletu” albo jego zaprzeczenie. Badacz zna tylko prawdopodobieństwo wylosowania pierwszego stwierdzenia (tu P = .75), ale nie wie, na które pytanie odpowiedziała konkretna osoba. Odpowiedź „tak” niczego więc o niej nie zdradza, a odsetek w grupie można oszacować ze wzoru Warnera.
Przykład: w symulacji prawdziwy odsetek osób jeżdżących bez biletu wynosił 30%, ale przy pytaniu wprost 40% z nich zaprzeczało. W grupie pytanej wprost (n = 300) oszacowanie wyniosło 16.7%, 95% CI [12.4, 20.9]. W grupie z techniką Warnera (n = 300) „tak” odpowiedziało 39.0% osób, co po przeliczeniu daje 28.0%, 95% CI [17.0, 39.0]. RRT jest więc bliższe prawdzie, ale ma swoją cenę: błąd standardowy był 2.62 raza większy niż przy pytaniu wprost, a uzyskanie takiej samej precyzji wymagałoby około 6.9 raza większej próby. Różnica między metodami nie osiągnęła istotności, z = 1.88, p = .060, mimo że w symulacji wiemy, że pytanie wprost zaniża wynik.
Lensvelt-Mulders i in. (2005) w metaanalizie badań walidacyjnych i porównawczych wykazali, że techniki randomizowanej odpowiedzi dają trafniejsze dane niż zwykłe pytania, tym bardziej, im bardziej drażliwy temat. Zauważyli jednak, że wyniki różnią się między badaniami w sposób niewyjaśniony, więc technika nie jest w pełni pod kontrolą badacza. W praktyce dla pracy dyplomowej oznacza to trzy rzeczy: instrukcję trzeba przetestować w pilotażu (respondent musi zrozumieć, że jest chroniony), próbę zaplanować większą niż przy zwykłym pytaniu, a wynik raportować z przedziałem ufności i podanym P.
Anonimizacja: kto jest jedyny w swojej komórce
Usunięcie imienia i nazwiska nie czyni danych anonimowymi. Jeśli w bazie jest jedna 26-letnia kobieta z czwartego roku pochodząca z małego miasta, każdy, kto ją zna, rozpozna jej odpowiedzi o wiktymizacji. Sweeney (2002) zaproponowała model k-anonimowości: zbiór jest k-anonimowy, jeśli informacji o żadnej osobie nie da się odróżnić od informacji o co najmniej k − 1 innych osobach. Cechy, które razem mogą zidentyfikować osobę (wiek, płeć, rok studiów, miejscowość), nazywa się quasi-identyfikatorami.
W symulowanej bazie 320 respondentów 29.4% osób było jedynych w swojej kombinacji czterech cech (wiek w latach, płeć, rok studiów, wielkość miejscowości pochodzenia). Po zastąpieniu wieku trzema przedziałami odsetek ten spadł do 5.0%, a po usunięciu miejscowości – do 1.2%. Odsetek osób w grupach mniejszych niż 5 spadł z 94.4% do 4.4%. Ten prosty rachunek warto wykonać przed udostępnieniem danych promotorowi, recenzentowi albo w repozytorium. Pojęcia i techniki porządkuje hasło anonimizacja i pseudonimizacja danych. W tabelach do pracy nie pokazuj też krzyżowań, w których pojedyncza komórka odpowiada jednej, rozpoznawalnej osobie.
Jak opisać analizę statystyczną w pracy z kryminologii
Rozdział o metodach powinien pozwolić innej osobie powtórzyć badanie. W kryminologii opisz dodatkowo tryb zbierania danych i sposób zapewnienia anonimowości, bo od nich zależy wiarygodność odpowiedzi na pytania drażliwe. Poniżej wzór akapitu dla projektów 1, 3 i 4.
Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Przykład w R: zliczenia i pozostałe projekty
Kod odtwarza wszystkie liczby z tego wpisu. Najważniejszy jest przepis 1 z pełną analizą zliczeń: od opisu rozkładu, przez model Poissona i ujemny dwumianowy, po liczebności przewidywane i ilorazy częstości. Przepis 2 zawiera pozostałe projekty, a przepis 3 – rysunki. Każdy przepis tworzy własne dane symulowane. Modele ujemne dwumianowe liczy pakiet MASS, a regresję porządkową – pakiet ordinal.
1. Projekt 3: liczba incydentów – Poisson, nadmierne rozproszenie, regresja ujemna dwumianowa i IRR
R
# Projekt 3: liczba incydentów wiktymizacji w internecie w ostatnich 12 miesiącach (dane symulowane).
# 320 studentów; zmienne: godziny w internecie dziennie, zakupy online (tak/nie),
# liczba stosowanych zabezpieczeń (0–5: m.in. weryfikacja dwuetapowa, menedżer haseł, aktualizacje).
suppressPackageStartupMessages(library(MASS))
set.seed(22501)
n <- 320
godziny <- round(pmin(12, pmax(1, rgamma(n, shape = 5, rate = 1.2))), 1)
zakupy <- factor(rbinom(n, 1, .62), levels = 0:1, labels = c("nie", "tak"))
zabezp <- pmin(5, rbinom(n, 5, .45))
mu <- exp(-1.05 + 0.13 * godziny + 0.45 * (zakupy == "tak") - 0.22 * zabezp)
incydenty <- rnbinom(n, mu = mu, size = 0.9)
p3 <- data.frame(id = 1:n, godziny, zakupy, zabezp, incydenty)

# Krok 1. Opis rozkładu: średnia, wariancja, odsetek zer, maksimum
round(c(M = mean(p3$incydenty), Wariancja = var(p3$incydenty), Me = median(p3$incydenty),
        Zera_proc = 100 * mean(p3$incydenty == 0), Max = max(p3$incydenty)), 2)
table(p3$incydenty)

# Krok 2. Regresja Poissona i współczynnik rozproszenia (Pearson χ² / df)
m_pois <- glm(incydenty ~ godziny + zakupy + zabezp, family = poisson, data = p3)
disp <- sum(residuals(m_pois, type = "pearson")^2) / df.residual(m_pois)
round(disp, 2)

# Krok 3. Regresja ujemna dwumianowa i test ilorazu wiarygodności (Poisson to NB z θ → ∞;
# wartość p dzielimy przez 2, bo parametr leży na granicy przestrzeni parametrów)
m_nb <- glm.nb(incydenty ~ godziny + zakupy + zabezp, data = p3)
lr <- as.numeric(2 * (logLik(m_nb) - logLik(m_pois)))
signif(c(LR = lr, p = pchisq(lr, df = 1, lower.tail = FALSE) / 2, theta = m_nb$theta, SE_theta = m_nb$SE.theta,
        AIC_Poisson = AIC(m_pois), AIC_NB = AIC(m_nb)), 4)

# Krok 4. Ilorazy częstości (IRR) z 95% CI (Wald) w obu modelach
irr <- function(m) { b <- coef(m)[-1]; se <- sqrt(diag(vcov(m)))[-1]
  data.frame(IRR = round(exp(b), 3), CI_d = round(exp(b - 1.96 * se), 3), CI_g = round(exp(b + 1.96 * se), 3),
             z = round(b / se, 2), p = signif(2 * pnorm(-abs(b / se)), 3)) }
cat("Poisson:\n"); print(irr(m_pois))
cat("Ujemna dwumianowa:\n"); print(irr(m_nb))

# Krok 5. Ile zer przewiduje każdy model? (obserwowane vs oczekiwane liczebności 0, 1, 2, ...)
k <- 0:8
obs <- sapply(k, function(i) sum(p3$incydenty == i))
exp_pois <- sapply(k, function(i) sum(dpois(i, fitted(m_pois))))
exp_nb <- sapply(k, function(i) sum(dnbinom(i, mu = fitted(m_nb), size = m_nb$theta)))
round(data.frame(k, obserwowane = obs, Poisson = exp_pois, NB = exp_nb), 1)

# Krok 6. Częsty błąd: regresja liniowa na zliczeniach (porównaj znaki i wnioski, nie wartości)
summary(lm(incydenty ~ godziny + zakupy + zabezp, data = p3))$coefficients |> round(4)

# Krok 7. Przewidywana liczba incydentów (NB) dla typowych profili
nowe <- data.frame(godziny = c(3, 6, 6), zakupy = factor(c("nie", "tak", "tak"), levels = c("nie", "tak")), zabezp = c(2, 2, 5))
cbind(nowe, przewidywana = round(predict(m_nb, nowe, type = "response"), 2))
Wynik w R
        M Wariancja        Me Zera_proc       Max
     0.53      1.08      0.00     69.06      6.00

  0   1   2   3   4   5   6
221  60  26   5   1   4   3
[1] 1.6
         LR           p       theta    SE_theta AIC_Poisson      AIC_NB
  4.135e+01   6.349e-11   8.217e-01   2.191e-01   6.393e+02   5.999e+02
Poisson:
            IRR  CI_d  CI_g     z        p
godziny   1.119 1.034 1.210  2.80 5.13e-03
zakupytak 2.190 1.540 3.114  4.36 1.29e-05
zabezp    0.657 0.568 0.760 -5.66 1.50e-08
Ujemna dwumianowa:
            IRR  CI_d  CI_g     z        p
godziny   1.104 0.989 1.232  1.76 7.77e-02
zakupytak 2.328 1.490 3.636  3.71 2.04e-04
zabezp    0.650 0.538 0.785 -4.46 8.23e-06
  k obserwowane Poisson    NB
1 0         221   198.0 221.2
2 1          60    86.7  60.8
3 2          26    26.3  21.4
4 3           5     6.9   8.7
5 4           1     1.6   3.9
6 5           4     0.4   1.9
7 6           3     0.1   1.0
8 7           0     0.0   0.5
9 8           0     0.0   0.3
            Estimate Std. Error t value Pr(>|t|)
(Intercept)   0.5047     0.1918  2.6310   0.0089
godziny       0.0622     0.0312  1.9939   0.0470
zakupytak     0.3736     0.1135  3.2903   0.0011
zabezp       -0.2081     0.0495 -4.2007   0.0000
  godziny zakupy zabezp przewidywana
1       3    nie      2         0.26
2       6    tak      2         0.80
3       6    tak      5         0.22
2. Projekty 1, 2, 4 i 5 oraz ryzyko identyfikacji
R
# Projekty 1, 2, 4 i 5 oraz kontrola ryzyka identyfikacji (dane symulowane).
suppressPackageStartupMessages({ library(ordinal); library(psych); library(DescTools) })

## Projekt 1. Eksperyment winietowy: postawy wobec kary --------------------------------------
# 240 osób losowo przydzielonych do 4 wersji opisu kradzieży roweru (2 × 2):
# uprzednia karalność sprawcy (nie/tak) × wartość szkody (niska/wysoka).
# Odpowiedź: rekomendowana reakcja w 5 kategoriach uporządkowanych od najłagodniejszej.
set.seed(22562)
n1 <- 240
p1 <- data.frame(karalnosc = factor(rep(c("nie", "tak"), each = n1 / 2)),
                 szkoda = factor(rep(rep(c("niska", "wysoka"), each = n1 / 4), 2), levels = c("niska", "wysoka")))
eta <- 1.10 * (p1$karalnosc == "tak") + 0.55 * (p1$szkoda == "wysoka") + 0.15 * (p1$karalnosc == "tak") * (p1$szkoda == "wysoka")
progi <- c(-1.3, -0.1, 1.2, 2.6)
lat <- eta + rlogis(n1)
kat <- c("mediacja i naprawienie szkody", "grzywna", "ograniczenie wolności", "pozbawienie wolności w zawieszeniu", "bezwzględne pozbawienie wolności")
p1$reakcja <- factor(kat[findInterval(lat, progi) + 1], levels = kat, ordered = TRUE)
p1$reakcja_num <- as.integer(p1$reakcja)
# Rozkład odpowiedzi (%) w czterech wersjach winiety
round(100 * prop.table(table(interaction(p1$karalnosc, p1$szkoda, sep = "/"), p1$reakcja), 1), 1)
aggregate(reakcja_num ~ karalnosc + szkoda, p1, function(x) c(Me = median(x), M = mean(x)))
# Regresja porządkowa (proporcjonalne szanse): model z interakcją i bez niej
m1i <- clm(reakcja ~ karalnosc * szkoda, data = p1)
m1 <- clm(reakcja ~ karalnosc + szkoda, data = p1)
anova(m1, m1i)                                   # test interakcji (LR)
b1 <- coef(m1)[c("karalnosctak", "szkodawysoka")]; ci1 <- confint(m1)
round(cbind(OR = exp(b1), exp(ci1[c("karalnosctak", "szkodawysoka"), ])), 2)
summary(m1)$coefficients[c("karalnosctak", "szkodawysoka"), ] |> signif(4)
nominal_test(m1)                                 # założenie proporcjonalnych szans
# Odsetek wskazań kary pozbawienia wolności (kategorie 4–5) w czterech wersjach
round(100 * tapply(p1$reakcja_num >= 4, list(p1$karalnosc, p1$szkoda), mean), 1)

## Projekt 2. Lęk przed przestępczością w sondażu mieszkańców ---------------------------------
# 400 osób; lęk: średnia 4 pozycji (1–5) o obawie przed konkretnymi zdarzeniami;
# predyktory: płeć, wiek, wiktymizacja w ostatnich 3 latach, postrzegany nieład w okolicy (1–5);
# osobno szacowane ryzyko (1–5) – inny konstrukt niż lęk.
set.seed(22503)
n2 <- 400
plec <- factor(sample(c("kobieta", "mężczyzna"), n2, TRUE, prob = c(.54, .46)))
wiek <- round(runif(n2, 18, 80))
wiktym <- factor(rbinom(n2, 1, .22), levels = 0:1, labels = c("nie", "tak"))
nielad <- round(pmin(5, pmax(1, rnorm(n2, 2.6, 0.8))), 1)
lek_lat <- 0.45 * (plec == "kobieta") + 0.004 * (wiek - 45) + 0.35 * (wiktym == "tak") + 0.40 * (nielad - 2.6) + rnorm(n2, 0, 0.85)
pozycje <- sapply(c(.75, .80, .70, .78), function(l) pmin(5, pmax(1, round(2.6 + l * lek_lat + rnorm(n2, 0, .65)))))
colnames(pozycje) <- paste0("lek", 1:4)
p2 <- data.frame(plec, wiek, wiktym, nielad, pozycje)
p2$lek <- rowMeans(pozycje)
p2$ryzyko <- pmin(5, pmax(1, round(2.7 + 0.45 * scale(lek_lat)[, 1] + 0.25 * (nielad - 2.6) + rnorm(n2, 0, .9))))
round(psych::alpha(pozycje)$total$raw_alpha, 2)
round(c(M = mean(p2$lek), SD = sd(p2$lek), r_lek_ryzyko = cor(p2$lek, p2$ryzyko)), 2)
m2 <- lm(lek ~ plec + wiek + wiktym + nielad, data = p2)
s2 <- summary(m2)
p2s <- p2; p2s[c("lek", "wiek", "nielad")] <- lapply(p2s[c("lek", "wiek", "nielad")], function(x) scale(x)[, 1])
beta <- coef(lm(lek ~ plec + wiek + wiktym + nielad, data = p2s))       # β dla zmiennych ciągłych; dla 0/1 – różnica w SD lęku
cbind(round(cbind(b = coef(m2), confint(m2), t = s2$coefficients[, 3]), 3), p = signif(s2$coefficients[, 4], 3), beta = round(beta, 2))
round(c(R2 = s2$r.squared, R2_adj = s2$adj.r.squared, F = unname(s2$fstatistic[1])), 3); s2$fstatistic[2:3]
signif(pf(s2$fstatistic[1], s2$fstatistic[2], s2$fstatistic[3], lower.tail = FALSE), 3)

## Projekt 4. Odsetek zgłoszeń na policję według rodzaju zdarzenia -----------------------------
# Studenci, którzy doświadczyli zdarzenia w ostatnim roku; zgłoszenie (tak/nie).
set.seed(22504)
typ <- factor(rep(c("kradzież", "oszustwo w internecie", "nękanie w internecie"), c(150, 120, 90)),
              levels = c("kradzież", "oszustwo w internecie", "nękanie w internecie"))
zgl <- rbinom(length(typ), 1, c(.48, .25, .12)[as.integer(typ)])
tab4 <- table(typ, zgloszenie = factor(zgl, 0:1, c("nie", "tak"))); tab4
t(sapply(levels(typ), function(g) { x <- sum(zgl[typ == g]); n <- sum(typ == g)
  ci <- prop.test(x, n, correct = FALSE)$conf.int; round(c(x = x, n = n, proc = 100 * x / n, CI_d = 100 * ci[1], CI_g = 100 * ci[2]), 1) }))
ch4 <- chisq.test(tab4); ch4; round(min(ch4$expected), 1)
round(CramerV(tab4), 2); round(ch4$stdres[, "tak"], 2)
# Różnica: kradzież − oszustwo w internecie (punkty procentowe), 95% CI Newcombe'a (hybrid score)
x1 <- sum(zgl[typ == "kradzież"]); x2 <- sum(zgl[typ == "oszustwo w internecie"])
round(100 * BinomDiffCI(x1, 150, x2, 120, method = "score"), 1)

## Projekt 5. Pytanie drażliwe: pytanie wprost a technika randomizowanej odpowiedzi (Warner) ---
# Zachowanie: przejazd komunikacją bez ważnego biletu w ostatnim roku; prawdziwy odsetek w symulacji 30%.
# Pytanie wprost: część osób zaprzecza (zaniżanie). Warner: z prawdopodobieństwem P = .75 respondent
# odpowiada na stwierdzenie „Zdarzyło mi się…”, a z 1 − P na jego zaprzeczenie; ankieter nie wie, które wylosował.
set.seed(22505)
n5 <- 300; P <- .75; pi_true <- .30
cecha_a <- rbinom(n5, 1, pi_true)
wprost <- ifelse(cecha_a == 1, rbinom(n5, 1, .60), 0)           # 40% osób z cechą zaprzecza
cecha_b <- rbinom(n5, 1, pi_true)
los <- rbinom(n5, 1, P)
rrt <- ifelse(los == 1, cecha_b, 1 - cecha_b)                    # odpowiedź „tak” na wylosowane stwierdzenie
p_w <- mean(wprost); se_w <- sqrt(p_w * (1 - p_w) / n5)
lam <- mean(rrt); pi_hat <- (lam - (1 - P)) / (2 * P - 1); se_r <- sqrt(lam * (1 - lam) / (n5 * (2 * P - 1)^2))
round(100 * rbind(wprost = c(est = p_w, CI_d = p_w - 1.96 * se_w, CI_g = p_w + 1.96 * se_w, SE = se_w),
                  Warner = c(est = pi_hat, CI_d = pi_hat - 1.96 * se_r, CI_g = pi_hat + 1.96 * se_r, SE = se_r)), 1)
round(c(odsetek_tak_RRT = 100 * lam, wzrost_SE = se_r / se_w, mnoznik_n = (se_r / se_w)^2, z_roznicy = (pi_hat - p_w) / sqrt(se_r^2 + se_w^2),
        p = 2 * pnorm(-abs((pi_hat - p_w) / sqrt(se_r^2 + se_w^2)))), 3)

## Ryzyko identyfikacji: ile osób jest jedynych w swojej kombinacji cech? -----------------------
# 320 respondentów; quasi-identyfikatory: wiek w latach, płeć, rok studiów, miejscowość pochodzenia (4 kategorie).
set.seed(22506)
q <- data.frame(wiek = pmin(35, 19 + rpois(320, 3)), plec = sample(c("K", "M"), 320, TRUE),
                rok = sample(1:5, 320, TRUE), miejsce = sample(c("wieś", "do 50 tys.", "50–200 tys.", "> 200 tys."), 320, TRUE))
unikat <- function(d) { k <- ave(rep(1, nrow(d)), do.call(paste, d), FUN = length); c(k1_proc = 100 * mean(k == 1), k_lt5_proc = 100 * mean(k < 5)) }
q2 <- q; q2$wiek <- cut(q$wiek, c(18, 21, 24, Inf), labels = c("19–21", "22–24", "25+"))
q3 <- q2[c("wiek", "plec", "rok")]
round(rbind(surowe = unikat(q), wiek_w_przedzialach = unikat(q2), bez_miejscowosci = unikat(q3)), 1)
Wynik w R
             mediacja i naprawienie szkody grzywna ograniczenie wolności pozbawienie wolności w zawieszeniu
  nie/niska                           20.0    35.0                  30.0                               11.7
  tak/niska                            6.7    18.3                  33.3                               25.0
  nie/wysoka                          16.7    18.3                  30.0                               26.7
  tak/wysoka                           5.0     6.7                  21.7                               38.3

             bezwzględne pozbawienie wolności
  nie/niska                               3.3
  tak/niska                              16.7
  nie/wysoka                              8.3
  tak/wysoka                             28.3
  karalnosc szkoda reakcja_num.Me reakcja_num.M
1       nie  niska       2.000000      2.433333
2       tak  niska       3.000000      3.266667
3       nie wysoka       3.000000      2.916667
4       tak wysoka       4.000000      3.783333
Likelihood ratio tests of cumulative link models:

    formula:                     link: threshold:
m1  reakcja ~ karalnosc + szkoda logit flexible
m1i reakcja ~ karalnosc * szkoda logit flexible

    no.par    AIC  logLik LR.stat df Pr(>Chisq)
m1       6 716.84 -352.42
m1i      7 718.76 -352.38  0.0757  1     0.7832
               OR 2.5 % 97.5 %
karalnosctak 3.81  2.37   6.19
szkodawysoka 2.31  1.45   3.70
             Estimate Std. Error z value Pr(>|z|)
karalnosctak   1.3380     0.2442   5.478 4.29e-08
szkodawysoka   0.8381     0.2378   3.524 4.25e-04
Tests of nominal effects

formula: reakcja ~ karalnosc + szkoda
          Df  logLik    AIC LRT Pr(>Chi)
<none>       -352.42 716.84
karalnosc
szkoda
    niska wysoka
nie  15.0   35.0
tak  41.7   66.7
[1] 0.8
           M           SD r_lek_ryzyko
        2.79         0.77         0.35
                   b  2.5 % 97.5 %      t        p  beta
(Intercept)    2.223  1.895  2.550 13.344 8.63e-34  0.14
plecmężczyzna -0.305 -0.449 -0.161 -4.165 3.82e-05 -0.40
wiek           0.001 -0.003  0.005  0.371 7.11e-01  0.02
wiktymtak      0.195  0.019  0.372  2.172 3.04e-02  0.25
nielad         0.250  0.157  0.343  5.308 1.85e-07  0.25
    R2 R2_adj      F
 0.107  0.098 11.859
numdf dendf
    4   395
   value
4.15e-09
                       zgloszenie
typ                     nie tak
  kradzież               76  74
  oszustwo w internecie  82  38
  nękanie w internecie   83   7
                       x   n proc CI_d CI_g
kradzież              74 150 49.3 41.4 57.3
oszustwo w internecie 38 120 31.7 24.0 40.4
nękanie w internecie   7  90  7.8  3.8 15.2

	Pearson's Chi-squared test

data:  tab4
X-squared = 44.053, df = 2, p-value = 2.717e-10

[1] 29.8
[1] 0.35
             kradzież oszustwo w internecie  nękanie w internecie
                 5.55                 -0.40                 -5.89
      est lwr.ci upr.ci
[1,] 17.7    5.9   28.7
        est CI_d CI_g  SE
wprost 16.7 12.4 20.9 2.2
Warner 28.0 17.0 39.0 5.6
odsetek_tak_RRT       wzrost_SE       mnoznik_n       z_roznicy               p
         39.000           2.618           6.852           1.880           0.060
                    k1_proc k_lt5_proc
surowe                 29.4       94.4
wiek_w_przedzialach     5.0       47.5
bez_miejscowosci        1.2        4.4
3. Rysunki
R
# Rysunki do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b225-rysunki.R > b225-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(patchwork); library(svglite) })
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 13) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA),
          plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100), round(file.info(plik)$size / 1024)))
}
pdf(NULL)
invisible(capture.output({ for (f in c("b225-1-wiktymizacja-zliczenia.R", "b225-2-pozostale-projekty.R")) source(f) }))

# Rysunek 1: zliczenia – obserwowane i oczekiwane liczebności (A) oraz IRR w dwóch modelach (B)
kk <- 0:6
d1 <- data.frame(k = kk, obserwowane = sapply(kk, function(i) sum(p3$incydenty == i)),
                 Poisson = sapply(kk, function(i) sum(dpois(i, fitted(m_pois)))),
                 NB = sapply(kk, function(i) sum(dnbinom(i, mu = fitted(m_nb), size = m_nb$theta))))
print(round(d1, 1), row.names = FALSE)
dl <- rbind(data.frame(k = d1$k, model = "regresja Poissona", ocz = d1$Poisson),
            data.frame(k = d1$k, model = "regresja ujemna dwumianowa", ocz = d1$NB))
rA <- ggplot(d1, aes(k, obserwowane)) + geom_col(fill = "grey80", colour = "grey60", width = .7) +
  geom_line(data = dl, aes(k, ocz, colour = model), linewidth = .9) + geom_point(data = dl, aes(k, ocz, colour = model), size = 2.6) +
  scale_colour_manual(values = c("regresja Poissona" = KOLORY[["drugi"]], "regresja ujemna dwumianowa" = KOLORY[["akcent"]]), name = NULL) +
  scale_x_continuous(breaks = kk) +
  labs(title = "A. Liczba incydentów: dane i modele", subtitle = "Słupki: dane (n = 320); punkty: liczebności z modelu",
       x = "Liczba incydentów w ciągu 12 miesięcy", y = "Liczba osób") + theme_metodolog(12)
ir <- rbind(cbind(model = "regresja Poissona", irr(m_pois), zm = rownames(irr(m_pois))),
            cbind(model = "regresja ujemna dwumianowa", irr(m_nb), zm = rownames(irr(m_nb))))
ir$zm <- factor(ir$zm, levels = c("zabezp", "zakupytak", "godziny"),
                labels = c("Zabezpieczenia\n(+1 z 5)", "Zakupy online\n(tak vs nie)", "Godziny w sieci\n(+1 h dziennie)"))
print(ir[, c("model", "zm", "IRR", "CI_d", "CI_g", "p")], row.names = FALSE)
pos <- position_dodge(width = .5)
rB <- ggplot(ir, aes(IRR, zm, colour = model)) + geom_vline(xintercept = 1, colour = "grey45", linetype = 2) +
  geom_errorbar(aes(xmin = CI_d, xmax = CI_g), width = .18, orientation = "y", linewidth = .9, position = pos) + geom_point(size = 3, position = pos) +
  scale_x_log10(breaks = c(.5, .75, 1, 1.5, 2, 3, 4)) +
  scale_colour_manual(values = c("regresja Poissona" = KOLORY[["drugi"]], "regresja ujemna dwumianowa" = KOLORY[["akcent"]]), name = NULL, guide = "none") +
  labs(title = "B. Ilorazy częstości (IRR) z 95% CI", subtitle = "Te same predyktory, skala logarytmiczna",
       x = "IRR (1 = brak związku)", y = NULL) + theme_metodolog(12)
zapisz_svg(rA + rB + plot_layout(widths = c(1, 1.1), guides = "collect") & theme(legend.position = "bottom"), "../statystyka-kryminologia-zliczenia-poisson-nb.svg", szer = 11, wys = 5.6)

# Rysunek 2: eksperyment winietowy – rozkład rekomendowanej reakcji w czterech wersjach opisu
d2 <- as.data.frame(prop.table(table(wersja = interaction(p1$karalnosc, p1$szkoda, sep = "/"), reakcja = p1$reakcja), 1))
d2$wersja <- factor(d2$wersja, levels = c("nie/niska", "nie/wysoka", "tak/niska", "tak/wysoka"),
                    labels = c("niekarany, niska szkoda", "niekarany, wysoka szkoda", "karany wcześniej, niska szkoda", "karany wcześniej, wysoka szkoda"))
d2$proc <- 100 * d2$Freq
print(reshape(d2[, c("wersja", "reakcja", "proc")], idvar = "wersja", timevar = "reakcja", direction = "wide"), digits = 3, row.names = FALSE)
pal <- c("#c6dbef", "#9ecae1", "#6baed6", "#fc9272", "#e50101")
r2 <- ggplot(d2, aes(proc, wersja, fill = reakcja)) + geom_col(width = .65, colour = "white", position = position_stack(reverse = TRUE)) +
  geom_text(aes(label = ifelse(proc >= 6, sprintf("%.0f%%", proc), "")), position = position_stack(vjust = .5, reverse = TRUE), size = 3.5, colour = ifelse(d2$reakcja == "bezwzględne pozbawienie wolności", "white", "grey10")) +
  scale_fill_manual(values = pal, name = NULL) + scale_y_discrete(limits = rev) +
  labs(title = "Rekomendowana reakcja na kradzież roweru w czterech wersjach winiety",
       subtitle = "Odsetek odpowiedzi; 60 osób w każdej wersji (n = 240)", x = "Odsetek odpowiedzi", y = NULL) +
  theme_metodolog(12) + guides(fill = guide_legend(nrow = 2, byrow = TRUE))
zapisz_svg(r2, "../statystyka-kryminologia-winieta-kara.svg", szer = 10, wys = 5.2)
Wynik w R
 k obserwowane Poisson    NB
 0         221   198.0 221.2
 1          60    86.7  60.8
 2          26    26.3  21.4
 3           5     6.9   8.7
 4           1     1.6   3.9
 5           4     0.4   1.9
 6           3     0.1   1.0
                      model                               zm   IRR  CI_d  CI_g        p
          regresja Poissona Godziny w sieci\n(+1 h dziennie) 1.119 1.034 1.210 5.13e-03
          regresja Poissona      Zakupy online\n(tak vs nie) 2.190 1.540 3.114 1.29e-05
          regresja Poissona         Zabezpieczenia\n(+1 z 5) 0.657 0.568 0.760 1.50e-08
 regresja ujemna dwumianowa Godziny w sieci\n(+1 h dziennie) 1.104 0.989 1.232 7.77e-02
 regresja ujemna dwumianowa      Zakupy online\n(tak vs nie) 2.328 1.490 3.636 2.04e-04
 regresja ujemna dwumianowa         Zabezpieczenia\n(+1 z 5) 0.650 0.538 0.785 8.23e-06
Zapisano ../statystyka-kryminologia-zliczenia-poisson-nb.svg: w HTML width="1100" height="560" (17 KB)
                          wersja proc.mediacja i naprawienie szkody proc.grzywna proc.ograniczenie wolności
         niekarany, niska szkoda                              20.00        35.00                       30.0
  karany wcześniej, niska szkoda                               6.67        18.33                       33.3
        niekarany, wysoka szkoda                              16.67        18.33                       30.0
 karany wcześniej, wysoka szkoda                               5.00         6.67                       21.7
 proc.pozbawienie wolności w zawieszeniu proc.bezwzględne pozbawienie wolności
                                    11.7                                  3.33
                                    25.0                                 16.67
                                    26.7                                  8.33
                                    38.3                                 28.33
Zapisano ../statystyka-kryminologia-winieta-kara.svg: w HTML width="1000" height="520" (13 KB)
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje glm(), lm(), chisq.test() i prop.test() z pakietu stats); rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ordinal (wersja 2026.7-26): Christensen, R. H. B. (2026). ordinal: Regression models for ordinal data (R package version 2026.7-26) [Computer software]. https://CRAN.R-project.org/package=ordinal
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z kryminologii
- Zliczenia analizowane testem t albo regresją liniową. Przy wielu zerach i długim ogonie wnioski bywają zbyt optymistyczne – w przykładzie liniowa regresja dała dla godzin w sieci p = .047, a model ujemny dwumianowy p = .078.
- Regresja Poissona bez sprawdzenia nadmiernego rozproszenia i bez porównania przewidywanej liczby zer z obserwowaną.
- Model ujemny dwumianowy traktowany jako automatyczne lekarstwo, bez zastanowienia, czy rozproszenie nie wynika z pominiętych zmiennych lub różnego czasu obserwacji (wtedy offset).
- Surowe współczynniki logarytmiczne zamiast IRR albo IRR opisany jako różnica w liczbie zdarzeń, a nie krotność.
- Średnia z kodów 1–5 dla rekomendowanej kary zamiast regresji porządkowej, bez sprawdzenia interakcji w planie czynnikowym.
- Szacowane ryzyko nazwane „lękiem przed przestępczością” albo jedno ogólne pytanie o bezpieczeństwo po zmroku jako jedyna miara lęku.
- Wnioski przyczynowe z badania przekrojowego, np. „nieład powoduje lęk”.
- Odsetki bez przedziałów ufności i uogólnianie wyników ankiety rozesłanej wśród znajomych na „wszystkie ofiary”.
- Dane o przestępczości we wstępie bez źródła albo bez rozróżnienia przestępstw zarejestrowanych i deklarowanych.
- Baza „zanonimizowana” przez usunięcie nazwisk, w której prawie co trzecia osoba jest jedyna w swojej kombinacji wieku, płci, roku i miejscowości.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej z kryminologii?
Zależy to od typu zmiennej zależnej. Odpowiedź porządkową (np. rekomendowaną karę) analizuj regresją porządkową, wynik skali (np. lęku przed przestępczością) regresją wieloraką, liczbę zdarzeń regresją ujemną dwumianową albo Poissona, a odsetki w grupach testem chi-kwadrat z przedziałami ufności Wilsona. Przy każdej analizie podaj wielkość efektu: OR, IRR, b z 95% CI albo V Craméra.
Czy liczbę przestępstw albo zdarzeń wiktymizacji można analizować testem t?
Zwykle nie. Zliczenia mają wiele zer i długi prawy ogon, a ich wariancja rośnie ze średnią. Test t i regresja liniowa mogą wtedy dawać zbyt małe wartości p. Użyj regresji Poissona, sprawdź nadmierne rozproszenie i w razie potrzeby przejdź do regresji ujemnej dwumianowej. Wyniki podaj jako ilorazy częstości (IRR) z 95% CI.
Jak zmierzyć lęk przed przestępczością w ankiecie?
Zapytaj osobno o obawę przed konkretnymi zdarzeniami (np. kradzieżą, napadem, włamaniem) i osobno o szacowane ryzyko, że się wydarzą. Ogólne pytanie o poczucie bezpieczeństwa po zmroku miesza emocję z oceną sytuacji, a lęk i szacowane ryzyko korelują tylko umiarkowanie, więc nie traktuj ich zamiennie. Sprawdź rzetelność skali i opisz jej pozycje w rozdziale metodologicznym.
Jak pytać o drażliwe zachowania, żeby respondenci nie kłamali?
Zapewnij pełną anonimowość, wybierz ankietę bez ankietera i formułuj pytania bez oceniania. Przy bardzo drażliwych zachowaniach możesz użyć techniki randomizowanej odpowiedzi, w której respondent losuje, na które stwierdzenie odpowiada. Daje ona trafniejsze oszacowania, ale ma większy błąd standardowy, więc wymaga większej próby i dobrze przetestowanej instrukcji.
Czy usunięcie imion i nazwisk wystarczy, aby dane z badania były anonimowe?
Nie. Osobę można rozpoznać po kombinacji cech, takich jak wiek, płeć, rok studiów i miejscowość. Przed udostępnieniem danych sprawdź, ile osób jest jedynych w swojej kombinacji cech, zastąp dokładny wiek przedziałami i usuń zbędne zmienne. W tabelach nie pokazuj komórek, które odpowiadają pojedynczym, rozpoznawalnym osobom.
Powiązane hasła
Przeczytaj też
Regresja dla zliczeń krok po kroku
Poisson z offsetem, rozproszenie, ujemna dwumianowa, ZIP, ZINB i hurdle na jednym przykładzie: rootogram, IRR, przewidywane średnie, tabela APA i kod R.
Czytaj →PoradnikRegresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →PoradnikStatystyka w pracy dyplomowej – przewodnik
Osiem etapów od hipotez do obrony: na każdy etap poradniki, hasła i kalkulatory oraz tabela typowych problemów z odpowiedzią, co przeczytać.
Czytaj →Piszesz pracę z kryminologii i nie wiesz, jak policzyć wyniki?
Pomożemy dobrać analizy do Twoich danych – winiety, skali lęku, zliczeń albo odsetków – policzyć je z wielkością efektu i wyjaśnić tak, abyś umiał samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Atzmüller, C., & Steiner, P. M. (2010). Experimental vignette studies in survey research. Methodology, 6(3), 128–138. https://doi.org/10.1027/1614-2241/a000014
- Berk, R., & MacDonald, J. M. (2008). Overdispersion and Poisson regression. Journal of Quantitative Criminology, 24(3), 269–284. https://doi.org/10.1007/s10940-008-9048-4
- Cohen, L. E., & Felson, M. (1979). Social change and crime rate trends: A routine activity approach. American Sociological Review, 44(4), 588–608. https://doi.org/10.2307/2094589
- Ferraro, K. F., & LaGrange, R. L. (1987). The measurement of fear of crime. Sociological Inquiry, 57(1), 70–97. https://doi.org/10.1111/j.1475-682x.1987.tb01181.x
- Gardner, W., Mulvey, E. P., & Shaw, E. C. (1995). Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models. Psychological Bulletin, 118(3), 392–404. https://doi.org/10.1037/0033-2909.118.3.392
- Lensvelt-Mulders, G. J. L. M., Hox, J. J., van der Heijden, P. G. M., & Maas, C. J. M. (2005). Meta-analysis of randomized response research: Thirty-five years of validation. Sociological Methods & Research, 33(3), 319–348. https://doi.org/10.1177/0049124104268664 ● Otwarty dostęp: pełny tekst
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
- Sweeney, L. (2002). k-Anonymity: A model for protecting privacy. International Journal of Uncertainty, Fuzziness and Knowledge-Based Systems, 10(05), 557–570. https://doi.org/10.1142/s0218488502001648 ● Otwarty dostęp: pełny tekst
- Tourangeau, R., & Yan, T. (2007). Sensitive questions in surveys. Psychological Bulletin, 133(5), 859–883. https://doi.org/10.1037/0033-2909.133.5.859
- Warner, S. L. (1965). Randomized response: A survey technique for eliminating evasive answer bias. Journal of the American Statistical Association, 60(309), 63–69. https://doi.org/10.1080/01621459.1965.10480775
Cytowania BibTeX
@article{atzmuller2010experimental, author={Atzmüller, Christiane and Steiner, Peter M.}, title={{Experimental vignette studies in survey research}}, journal={Methodology}, year={2010}, volume={6}, number={3}, pages={128--138}, doi={10.1027/1614-2241/a000014}}@article{berk2008overdispersion, author={Berk, Richard and MacDonald, John M.}, title={{Overdispersion and Poisson regression}}, journal={Journal of Quantitative Criminology}, year={2008}, volume={24}, number={3}, pages={269--284}, doi={10.1007/s10940-008-9048-4}}@article{cohen1979social, author={Cohen, Lawrence E. and Felson, Marcus}, title={{Social change and crime rate trends: A routine activity approach}}, journal={American Sociological Review}, year={1979}, volume={44}, number={4}, pages={588--608}, doi={10.2307/2094589}}@article{ferraro1987measurement, author={Ferraro, Kenneth F. and LaGrange, Randy L.}, title={{The measurement of fear of crime}}, journal={Sociological Inquiry}, year={1987}, volume={57}, number={1}, pages={70--97}, doi={10.1111/j.1475-682x.1987.tb01181.x}}@article{gardner1995regression, author={Gardner, William and Mulvey, Edward P. and Shaw, Esther C.}, title={{Regression analyses of counts and rates: Poisson, overdispersed Poisson, and negative binomial models}}, journal={Psychological Bulletin}, year={1995}, volume={118}, number={3}, pages={392--404}, doi={10.1037/0033-2909.118.3.392}}@article{lensveltmulders2005meta, author={Lensvelt-Mulders, Gerty J. L. M. and Hox, Joop J. and van der Heijden, Peter G. M. and Maas, Cora J. M.}, title={{Meta-analysis of randomized response research: Thirty-five years of validation}}, journal={Sociological Methods \& Research}, year={2005}, volume={33}, number={3}, pages={319--348}, doi={10.1177/0049124104268664}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}@article{sweeney2002k, author={Sweeney, Latanya}, title={{k-Anonymity: A model for protecting privacy}}, journal={International Journal of Uncertainty, Fuzziness and Knowledge-Based Systems}, year={2002}, volume={10}, number={05}, pages={557--570}, doi={10.1142/s0218488502001648}}@article{tourangeau2007sensitive, author={Tourangeau, Roger and Yan, Ting}, title={{Sensitive questions in surveys}}, journal={Psychological Bulletin}, year={2007}, volume={133}, number={5}, pages={859--883}, doi={10.1037/0033-2909.133.5.859}}@article{warner1965randomized, author={Warner, Stanley L.}, title={{Randomized response: A survey technique for eliminating evasive answer bias}}, journal={Journal of the American Statistical Association}, year={1965}, volume={60}, number={309}, pages={63--69}, doi={10.1080/01621459.1965.10480775}}