Pięć typowych projektów w pracy z bezpieczeństwa narodowego
Prace dyplomowe z bezpieczeństwa narodowego rzadko są eksperymentami. Najczęściej to ankieta wśród mieszkańców, studentów albo funkcjonariuszy, czasem porównanie kilku grup zawodowych, a coraz częściej także analiza dokumentów i danych urzędowych. Każdy z tych rodzajów materiału wymaga innych analiz. Najwięcej błędów pojawia się w dwóch miejscach: gdy ta sama osoba odpowiada na kilka podobnych pytań (np. ocenia kilka służb), a wynik analizuje się jak dane z niezależnych grup, oraz gdy z niewielkiej ankiety internetowej wyciąga się wnioski o „Polakach”. Tabela porządkuje pięć projektów omówionych w tym poradniku.
| Projekt | Typowe pytanie | Zmienne | Analiza główna | Wielkość efektu |
|---|---|---|---|---|
| 1. Poczucie bezpieczeństwa mieszkańców | Od czego zależy poczucie bezpieczeństwa w okolicy zamieszkania? | skala 6 pozycji 1–5, ocena zaniedbania okolicy, zaufanie do policji, płeć, wiek | test Wilcoxona dla par, test t Welcha, regresja liniowa | korelacja rangowo-biseryjna, g Hedgesa, β, R² |
| 2. Zaufanie do służb | Którym służbom mieszkańcy ufają najbardziej? | cztery oceny 1–5 od tej samej osoby | test Friedmana, porównania par z korektą Holma | W Kendalla |
| 3. Grupy zawodowe | Czy policjanci, strażacy, żołnierze i urzędnicy różnie oceniają przygotowanie do kryzysu? | skala 8 pozycji 1–5, cztery grupy | test Kruskala–Wallisa i test Dunna | ε² rangowe |
| 4. Tabela krzyżowa | Czy gospodarstwa z dziećmi częściej mają zapas wody i żywności? | dwie zmienne tak/nie | χ² dla tabeli 2 × 2, regresja logistyczna | OR z 95% CI, φ |
| 5. Dokumenty i statystyki | Jak kompletne są lokalne dokumenty dotyczące bezpieczeństwa? | 8 elementów kodowanych 0/1 przez dwie osoby | kappa Cohena, test Manna–Whitneya | κ z 95% CI, korelacja rangowo-biseryjna |
Wszystkie dane w przykładach są symulowane i nie opisują żadnej prawdziwej miejscowości ani formacji. Możesz je pobrać jako plik XLSX (osobny arkusz dla każdego projektu i arkusz z opisem) i powtórzyć analizy w swoim programie. Jeśli nie wiesz jeszcze, który test pasuje do Twojego pytania, przejdź przez kreator doboru testu statystycznego, a cały proces – od hipotez do rozdziału wyników – opisuje przewodnik po statystyce w pracy dyplomowej. Pokrewne projekty o przestępczości i karze omawiamy we wpisie statystyka w pracy z kryminologii, a sondaże, ważenie i postawy – we wpisie statystyka w pracy z socjologii.
Zanim zaczniesz: pojęcie, próba i anonimowość
Najpierw zdefiniuj, co mierzysz. „Poczucie bezpieczeństwa”, „lęk przed przestępczością” i „ocena ryzyka stania się ofiarą” brzmią podobnie, ale to różne pojęcia. Ferraro i LaGrange (1987) przejrzeli sposoby ich pomiaru i pokazali, że ogólne miary lęku i miary postrzeganego ryzyka korelują tylko umiarkowanie, a mimo to wiele badań mierzyło ryzyko i wnioskowało o lęku. Farrall i in. (1997) poszli dalej: obraz lęku przed przestępczością w dużej mierze zależy od tego, jak zadaje się pytania. W praktyce oznacza to trzy rzeczy. Pytaj o konkretne sytuacje („idąc sam(a) po zmroku po swojej okolicy”), a nie o ogólne „czy czujesz się bezpiecznie”. Używaj kilku pozycji, a nie jednej. W rozdziale teoretycznym wyjaśnij, którą definicję przyjmujesz.
Opisz, skąd jest próba. Ankieta rozesłana w mediach społecznościowych, na grupach mieszkańców albo wśród znajomych to dobór wygodny lub metoda kuli śnieżnej. Bethlehem (2010) pokazuje, że niedopokrycie i samoselekcja respondentów obciążają oszacowania z ankiet internetowych, a samoselekcji nie da się w pełni naprawić ważeniem. Na tematy bezpieczeństwa chętniej odpowiadają osoby, które się nim interesują albo mają za sobą złe doświadczenia. Odsetki opisuj więc jako cechę badanej próby, a nie mieszkańców miasta, a związki między zmiennymi – ostrożnie.
Pytania drażliwe i odpowiedzi „właściwe”. Pytania o doświadczenie przestępstwa, ocenę przełożonych czy zaufanie do własnej formacji są drażliwe. Tourangeau i Yan (2007) w przeglądzie badań pokazują, że błędne odpowiedzi na takie pytania są częste i zależą od sytuacji badania, np. od obawy przed konsekwencjami. To zjawisko opisuje hasło aprobata społeczna. Ankieta wśród funkcjonariuszy rozdana przez przełożonego da inne wyniki niż anonimowa ankieta internetowa. Opisz sposób zbierania danych w rozdziale metodologicznym i uwzględnij go w ograniczeniach.
Anonimowość w małych jednostkach. W badaniu jednej komendy, jednostki wojskowej czy wydziału urzędu kilka zmiennych metryczkowych (stopień, staż, komórka, płeć) potrafi wskazać konkretną osobę. Zbieraj tylko to, czego potrzebujesz do analiz, łącz rzadkie kategorie i nie pokazuj wyników dla grup kilkuosobowych. Zasady przygotowania danych opisuje hasło anonimizacja i pseudonimizacja danych. Zgody instytucji, opinię komisji etyki i regulamin uczelni sprawdź u promotora przed rozpoczęciem badania. Nie podajemy tu konkretnych wymogów, bo różnią się między uczelniami i instytucjami.
Projekt 1. Ankieta poczucia bezpieczeństwa mieszkańców
Przykład: 320 dorosłych mieszkańców jednego miasta (49.4% kobiet, wiek M = 47.55, SD = 15.57) wypełniło ankietę. Poczucie bezpieczeństwa zmierzono sześcioma autorskimi pozycjami od 1 („zdecydowanie niebezpiecznie”) do 5 („zdecydowanie bezpiecznie”): w domu, w okolicy w dzień, w okolicy po zmroku, w komunikacji publicznej, w centrum miasta i w miejscowości ogólnie. Dodatkowo respondenci ocenili zaniedbanie okolicy (trzy pozycje: oświetlenie, śmieci, pustostany), zaufanie do czterech służb i odpowiedzieli, czy w ostatnich trzech latach doświadczyli przestępstwa (tak: 13.4%). To jest pełny przykład tego wpisu – kod w R odtwarza go od początku do końca.
Rzetelność i wynik skali
Zanim połączysz pozycje w jeden wynik, sprawdź, czy mierzą to samo. Alfa Cronbacha wyniosła .91, a omega McDonalda (ωt) również .91. Dunn i in. (2014) zalecają podawać omegę obok alfy, bo alfa opiera się na mocnych założeniach, które rzadko są spełnione. Skala zaniedbania okolicy miała α = .83. Wynik skali poczucia bezpieczeństwa policzono jako średnią z sześciu pozycji: M = 3.28, SD = 0.80.
Sullivan i Artino (2013) przypominają, że pojedynczą pozycję skali Likerta traktuje się jak zmienną porządkową i opisuje medianą oraz rozkładem odpowiedzi, a wynik z wielu pozycji można analizować testami parametrycznymi, jeśli połączenie pozycji uzasadniają dowody rzetelności lub struktury. Dlatego w tym projekcie pojedyncze pozycje porównujemy testem rangowym, a wynik całej skali – testem t i regresją.
W dzień i po zmroku: dwie odpowiedzi tej samej osoby
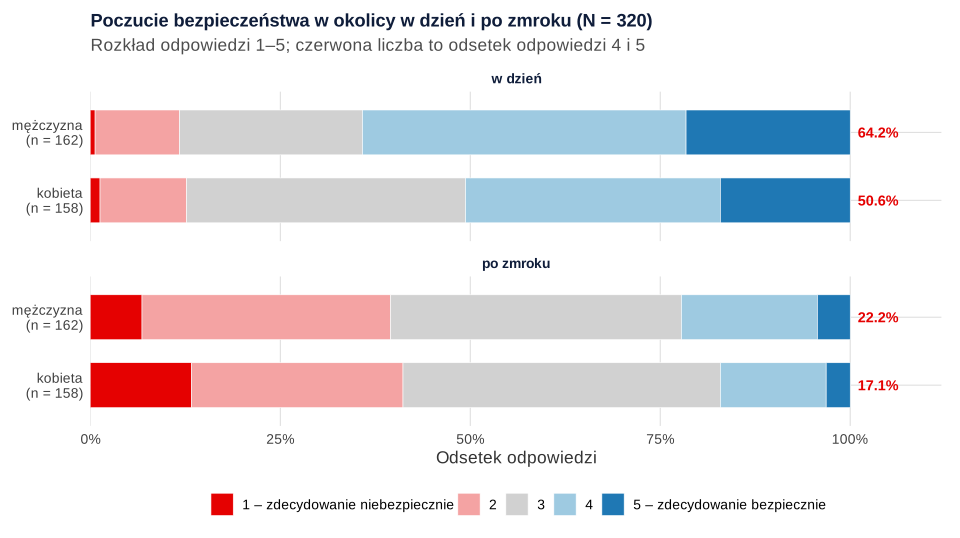
Typowe pytanie w pracy: czy poczucie bezpieczeństwa spada po zmroku? Każdy respondent odpowiedział na obie pozycje, więc dane są zależne. Właściwy jest test Wilcoxona dla par, a nie test dla dwóch niezależnych grup. W dzień bezpiecznie (odpowiedź 4 lub 5) czuło się 57.5% badanych, a po zmroku 19.7%. Mediana spadła z 4 do 3. Po zmroku niżej oceniło swoje bezpieczeństwo 68.1% osób, wyżej – 3.8%, a pozostali odpowiedzieli tak samo. Test Wilcoxona: V = 1118, p < .001. Wielkość efektu to korelacja rangowo-biseryjna dla par: rrb = −.92, 95% CI [−.93, −.89].
Tak duża wartość nie znaczy, że „po zmroku jest dwa razy groźniej”. Korelacja rangowo-biseryjna mówi, że wśród osób, których odpowiedzi się różnią, prawie wszystkie zmiany idą w jedną stronę. Osoby z identyczną odpowiedzią (remisy) test pomija, dlatego obok efektu podaj odsetki, jak wyżej. Rysunek 1 pokazuje cały rozkład odpowiedzi.
Kobiety i mężczyźni: test t Welcha
Wynik skali (średnia z sześciu pozycji) porównano między płciami testem t Welcha. Delacre i in. (2017) zalecają go jako domyślny, bo lepiej kontroluje błąd I rodzaju przy nierównych wariancjach i niewiele traci, gdy wariancje są równe. Mężczyźni (n = 162) mieli wynik M = 3.39 (SD = 0.80), a kobiety (n = 158) M = 3.18 (SD = 0.78), t(318) = 2.43, p = .016, różnica 95% CI [0.04, 0.39], g Hedgesa = 0.27, 95% CI [0.05, 0.49]. To mała różnica. W pracy opisz ją jako różnicę w badanej próbie, a nie jako cechę płci.
Regresja: co wiąże się z poczuciem bezpieczeństwa
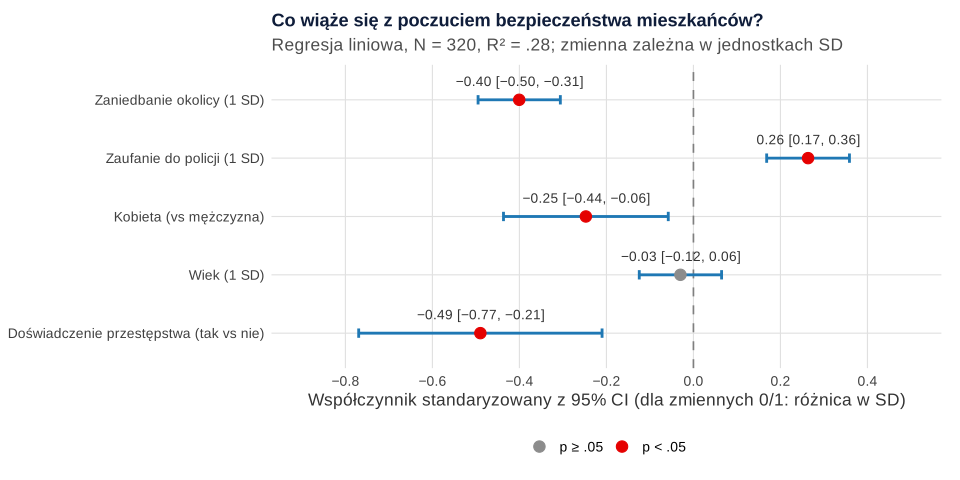
Pytanie „od czego zależy poczucie bezpieczeństwa” wymaga uwzględnienia kilku zmiennych naraz. W regresji liniowej zmienną zależną był wynik skali, a predyktorami: zaniedbanie okolicy, zaufanie do policji, płeć, wiek i doświadczenie przestępstwa. Model wyjaśnił 28% zmienności, R² = .28, skorygowane R² = .27, F(5, 314) = 24.14, p < .001. Współczynniki VIF nie przekraczały 1.02, więc współliniowość nie była problemem.
| Predyktor | b [95% CI] | β | t(314) | p |
|---|---|---|---|---|
| Zaniedbanie okolicy (1–5) | −0.34 [−0.43, −0.26] | −0.40 | −8.33 | < .001 |
| Zaufanie do policji (1–5) | 0.21 [0.13, 0.28] | 0.26 | 5.45 | < .001 |
| Kobieta (vs mężczyzna) | −0.20 [−0.35, −0.05] | −0.25 | −2.57 | .011 |
| Wiek (lata) | −0.002 [−0.006, 0.003] | −0.03 | −0.62 | .535 |
| Doświadczenie przestępstwa (tak vs nie) | −0.39 [−0.61, −0.17] | −0.49 | −3.45 | < .001 |
Dla zmiennych 0/1 kolumna β pokazuje różnicę w jednostkach odchylenia standardowego zmiennej zależnej, bo standaryzowanie zmiennej zero-jedynkowej nie ma sensu. Rysunek 2 zestawia te współczynniki. Najsilniej z niższym poczuciem bezpieczeństwa wiązały się zaniedbanie okolicy i doświadczenie przestępstwa, a z wyższym – zaufanie do policji. Wiek nie miał związku po uwzględnieniu pozostałych zmiennych. Pamiętaj, że to badanie przekrojowe: związek zaufania do policji z poczuciem bezpieczeństwa może działać w obie strony. Pisz „wiązało się”, a nie „wpływało”. Kolejne kroki modelu i diagnostykę reszt opisujemy w poradniku regresja wieloraka krok po kroku.
Projekt 2. Zaufanie do służb: cztery oceny tej samej osoby
Te same 320 osób oceniło od 1 („zdecydowanie nie ufam”) do 5 („zdecydowanie ufam”) policję, straż pożarną, wojsko i straż miejską. To częsty temat prac o postawach wobec służb i instytucji bezpieczeństwa. Błąd polega na tym, że cztery kolumny ocen porównuje się testem Kruskala–Wallisa albo ANOVA dla grup niezależnych. Tymczasem każda osoba oceniła wszystkie służby, a ktoś, kto ogólnie ufa instytucjom, wystawi wyższe oceny wszystkim. Te oceny są zależne.
Właściwy jest test Friedmana, który porównuje rangi ocen w obrębie każdej osoby. Najwyżej oceniono straż pożarną (Me = 4, ufa jej 84.1% badanych), potem wojsko (Me = 4, 68.1%), policję (Me = 3, 45.9%) i straż miejską (Me = 3, 33.8%). Test Friedmana: χ²(3) = 320.37, p < .001. Jako wielkość efektu podaj W Kendalla: W = .33, czyli umiarkowaną zgodność badanych co do kolejności służb.
Wynik testu Friedmana mówi tylko, że gdzieś są różnice. Aby wskazać które, wykonaj porównania par testem Wilcoxona dla par z korektą na wielokrotne porównania. Pereira i in. (2015) w przeglądzie procedur post hoc po teście Friedmana pokazują, że różnią się one wyraźnie liberalnością, więc wybór procedury opisz w metodzie. W przykładzie wszystkie sześć porównań było istotnych po korekcie Holma (wszystkie p < .001). Przy 320 osobach nawet niewielka różnica bywa istotna, dlatego interpretuj odsetki i mediany, a nie same gwiazdki. Średnie ocen (od 3.05 dla straży miejskiej do 4.22 dla straży pożarnej) możesz podać pomocniczo. Gdy chcesz wyjaśnić zaufanie do jednej służby cechami respondentów, sięgnij po regresję porządkową.
Projekt 3. Porównanie grup zawodowych
Przykład: 132 osoby z czterech grup zawodowych – policjanci (n = 38), strażacy (n = 34), żołnierze (n = 31) i pracownicy administracji zajmujący się zarządzaniem kryzysowym (n = 29) – oceniły przygotowanie swojej jednostki do działań w sytuacji kryzysowej w ośmiu autorskich pozycjach 1–5 (α = .90). Takie badanie zwykle powstaje przez dobór celowy lub kulę śnieżną: ankieta trafia do znajomych funkcjonariuszy, a ci przekazują ją dalej. Grupy są więc małe i nierówne, a wyników nie wolno uogólniać na całe formacje.
Rozkład wyniku był lewoskośny (skośność −0.75), a 15.9% osób wybrało najwyższą odpowiedź we wszystkich pozycjach. To typowy efekt sufitu w samoocenie własnej jednostki. Przy takim rozkładzie i małych grupach bezpieczniejszy jest test Kruskala–Wallisa. Mediany wyniosły: policja 4.50 (Q1–Q3: 4.12–4.75), straż pożarna 4.69 (4.25–4.88), wojsko 4.50 (4.06–4.88), administracja 3.88 (3.38–4.50). Test Kruskala–Wallisa: H(3) = 15.26, p = .002. Wielkość efektu to rangowe epsilon-kwadrat: ε²R = .12.
Porównania par wykonano testem Dunna z korektą Holma. Pracownicy administracji oceniali przygotowanie niżej niż strażacy (p < .001), żołnierze (p = .033) i policjanci (p = .039). Między trzema formacjami mundurowymi różnice nie były istotne (p od .508 do .788). Uważaj na interpretację: to ocena własnej jednostki, a nie jej rzeczywiste przygotowanie. Niższa ocena urzędników może wynikać z innej wiedzy o procedurach, innej kultury organizacyjnej albo z większej szczerości w anonimowej ankiecie. Odpowiednik parametryczny i wielkości efektu dla testów rangowych opisujemy w poradniku testy nieparametryczne krok po kroku.
Projekt 4. Tabela krzyżowa: przygotowanie gospodarstw domowych
W pracach o bezpieczeństwie powszechnym i obronie cywilnej często pyta się o przygotowanie mieszkańców na sytuacje kryzysowe: zapasy, wiedzę o ewakuacji, źródła informacji. Przykład: czy gospodarstwa z dziećmi częściej mają zapas wody i żywności na co najmniej trzy dni? Obie zmienne mają dwie kategorie, więc powstaje tabela krzyżowa 2 × 2. Zapas miało 37.0% gospodarstw z dziećmi (44 z 119) i 23.9% gospodarstw bez dzieci (48 z 201).
Test chi-kwadrat niezależności: χ²(1) = 6.26, p = .012. Najmniejsza liczebność oczekiwana wynosiła 34.2, więc warunek testu był spełniony; test dokładny Fishera dał p = .015. W tabeli 2 × 2 najbardziej czytelną miarą efektu jest iloraz szans: OR = 1.87, 95% CI [1.14, 3.06]. Współczynnik φ wyniósł .13. Te same wyniki – χ², test Fishera, OR i RR – policzysz w kalkulatorze tabeli 2 × 2, wpisując cztery liczebności.
Gospodarstwa z dziećmi mogą różnić się wiekiem respondentów, a wiek może wiązać się z gromadzeniem zapasów. Aby sprawdzić związek z kontrolą wieku, użyj regresji logistycznej. Iloraz szans dla dzieci w gospodarstwie wyniósł wtedy 1.95, 95% CI [1.18, 3.22], p = .009, a dla wieku (na każde 10 lat) 1.13, 95% CI [0.96, 1.32], p = .146. Interpretację ilorazów szans i założenia modelu opisujemy w poradniku regresja logistyczna krok po kroku.
Projekt 5. Analiza dokumentów i danych urzędowych
Część prac z bezpieczeństwa narodowego nie ma ankiety. Materiałem są dokumenty – strategie, programy, plany, raporty – albo statystyki publikowane przez instytucje. Tu też potrzebna jest statystyka, choć prostsza.
Kodowanie dokumentów i zgodność kodujących
Przykład: 40 dokumentów strategicznych samorządów dotyczących bezpieczeństwa (18 z gmin miejskich i 22 z gmin wiejskich lub miejsko-wiejskich) zakodowano według klucza ośmiu elementów: diagnoza oparta na danych, mierzalne cele, wskaźniki, harmonogram, budżet, partnerzy, monitorowanie i konsultacje społeczne. Każdy element oznaczano jako obecny (1) albo nieobecny (0). Najczęściej dokumenty wymieniały partnerów (85.0%) i zawierały diagnozę (75.0%), najrzadziej – wskaźniki (27.5%) i budżet (22.5%).
Klucz kategorii jest narzędziem pomiaru, więc trzeba pokazać, że daje powtarzalne wyniki. Druga osoba niezależnie zakodowała te same dokumenty. Lombard i in. (2002) w przeglądzie badań z analizą treści stwierdzili, że autorzy często nie raportują zgodności kodujących albo podają tylko odsetek zgodności, który jest zbyt liberalnym wskaźnikiem. Policz więc kappę Cohena dla każdej kategorii. W przykładzie κ wynosiła od .49 (wskaźniki, 75.0% zgodnych decyzji, 95% CI [.24, .74]) do .93 (budżet). Niska zgodność przy wskaźnikach oznacza, że definicja tej kategorii jest niejasna: doprecyzuj ją w kluczu, uzgodnij rozbieżności i opisz tę procedurę.
Z ośmiu elementów powstał indeks kompletności 0–8. W gminach miejskich mediana wyniosła 4.50 (Q1–Q3: 4.00–5.75), a w pozostałych 3.50 (2.25–4.75); test Manna–Whitneya: W = 279, p = .026, korelacja rangowo-biseryjna rrb = .41, 95% CI [.07, .66]. Szeroki przedział to skutek małej liczby dokumentów.
Statystyki urzędowe: co sprawdzić, zanim zaczniesz liczyć
- Źródło i data. Podaj instytucję, nazwę zestawienia, adres strony i datę odczytu. Liczby z mediów i z prezentacji bez źródła nie nadają się do pracy.
- Definicje. Sprawdź, co dokładnie zliczono (zdarzenia, postępowania, osoby) i czy definicja nie zmieniła się w analizowanych latach. Zmiana sposobu liczenia może wyglądać jak „wzrost” albo „spadek”.
- Wskaźnik na liczbę mieszkańców. Porównując jednostki o różnej wielkości, przelicz liczby na 10 000 albo 100 000 mieszkańców, a mianownik weź z tego samego roku.
- Poziom wnioskowania. Dane dla gmin czy powiatów opisują jednostki, a nie ludzi. Od klasycznego artykułu Robinsona (1950) o korelacjach ekologicznych, czyli liczonych na danych dla obszarów, pochodzi pojęcie błędu ekologicznego: związek widoczny między obszarami nie musi występować między osobami. Jeśli w powiatach z wyższym odsetkiem osób starszych zarejestrowano mniej zdarzeń, nie wynika z tego, że osoby starsze rzadziej ich doświadczają. Takie wnioskowanie to błąd ekologiczny.
- Ciemna liczba. Statystyki rejestrowane obejmują tylko to, co zgłoszono i zarejestrowano. Pisz więc o „zarejestrowanych zdarzeniach”, a nie o „przestępczości”.
Jak opisać analizę statystyczną w pracy
Rozdział metodologiczny powinien pozwolić innej osobie powtórzyć badanie. W pracy z bezpieczeństwa narodowego opisz przede wszystkim definicję mierzonego pojęcia, pochodzenie pozycji ankiety (autorskie czy z opublikowanego narzędzia), dobór próby i sposób dotarcia do respondentów, zapewnienie anonimowości oraz – przy dokumentach – klucz kategorii i procedurę kodowania. Poniżej wzór akapitu o analizie statystycznej dla projektów 1 i 2.
Gotowe zdania dla innych testów złożysz w generatorze opisu wyników w stylu APA, wpisując liczby z własnego wydruku. Jeśli potrzebujesz pomocy w doborze analiz albo w odpowiedzi na uwagi promotora, możesz skonsultować je ze statystykiem w ramach oferty analizy statystyczne dla studentów. Wyniki musisz jednak rozumieć i umieć obronić samodzielnie.
Analizy z pięciu projektów w R
Kod odtwarza wszystkie liczby z tego wpisu, a ostatni przepis – rysunki i plik XLSX do pobrania. Najważniejszy jest przepis 1: pełna analiza ankiety mieszkańców (projekty 1, 2 i 4) od symulacji danych po regresję. Wielkości efektu liczy pakiet effectsize, rzetelność i kappę – pakiet psych, a test Dunna – pakiet DescTools.
1. Projekty 1, 2 i 4: ankieta mieszkańców – rzetelność, Wilcoxon dla par, Welch, regresja, Friedman i tabela 2 × 2
R
# Projekty 1, 2 i 4: ankieta poczucia bezpieczeństwa mieszkańców jednego miasta (dane symulowane).
# 320 dorosłych mieszkańców; skala poczucia bezpieczeństwa (6 pozycji 1–5), ocena zaniedbania okolicy
# (3 pozycje 1–5), zaufanie do czterech służb (1–5), doświadczenie przestępstwa w ostatnich 3 latach,
# zapas wody i żywności na 3 dni, dzieci w gospodarstwie domowym, płeć i wiek.
suppressPackageStartupMessages({ library(effectsize); library(psych) })
set.seed(22101)
n <- 320
plec <- factor(ifelse(runif(n) < .53, "kobieta", "mężczyzna"), levels = c("mężczyzna", "kobieta"))
wiek <- round(pmin(84, pmax(18, rnorm(n, 46, 16))))
dzieci <- factor(ifelse(runif(n) < .36, "tak", "nie"), levels = c("nie", "tak"))
wiktymizacja <- factor(ifelse(runif(n) < .14, "tak", "nie"), levels = c("nie", "tak"))
likert <- function(y, progi) as.integer(cut(y, c(-Inf, progi, Inf)))
zan_lat <- rnorm(n)
zaniedbanie_poz <- sapply(c(0, .2, -.1), function(s) likert(0.8 * zan_lat + rnorm(n, s, .6), c(-1.5, -.5, .4, 1.3)))
colnames(zaniedbanie_poz) <- c("zan_oswietlenie", "zan_smieci", "zan_pustostany")
zaniedbanie <- rowMeans(zaniedbanie_poz)
zaufanie_lat <- rnorm(n)
zaufanie <- data.frame(
  policja        = likert(0.8 * zaufanie_lat + rnorm(n, .05, .7), c(-1.9, -.9, .1, 1.2)),
  straz_pozarna  = likert(0.5 * zaufanie_lat + rnorm(n, .95, .7), c(-1.9, -.9, .1, 1.2)),
  wojsko         = likert(0.6 * zaufanie_lat + rnorm(n, .55, .75), c(-1.9, -.9, .1, 1.2)),
  straz_miejska  = likert(0.6 * zaufanie_lat + rnorm(n, -.30, .8), c(-1.9, -.9, .1, 1.2)))
bezp_lat <- -0.45 * as.numeric(scale(zaniedbanie)) + 0.25 * as.numeric(scale(zaufanie$policja)) -
  0.35 * (plec == "kobieta") - 0.40 * (wiktymizacja == "tak") + 0.004 * (wiek - 46) + rnorm(n, 0, .8)
przes <- c(dom = .9, dzien = .7, zmrok = -.15, komunikacja = .1, centrum = .25, ogolne = .35)
bezp_poz <- sapply(names(przes), function(k) likert(0.85 * bezp_lat + rnorm(n, przes[[k]], .55), c(-1.7, -.7, .3, 1.3)))
colnames(bezp_poz) <- paste0("bezp_", names(przes))
bezp <- rowMeans(bezp_poz)
zapas <- factor(ifelse(runif(n) < plogis(-1.25 + .80 * (dzieci == "tak") + .015 * (wiek - 46)), "tak", "nie"), levels = c("nie", "tak"))
ank <- data.frame(id = 1:n, plec, wiek, dzieci, wiktymizacja, bezp_poz, bezp, zaniedbanie_poz, zaniedbanie,
                  zaufanie, zapas)

# --- Projekt 1. Rzetelność skali poczucia bezpieczeństwa i opis próby
om <- suppressWarnings(suppressMessages(psych::omega(bezp_poz, nfactors = 1, plot = FALSE)))
round(c(alfa = psych::alpha(bezp_poz, warnings = FALSE)$total$raw_alpha, omega_total = om$omega.tot), 2)
round(c(alfa_zaniedbanie = psych::alpha(zaniedbanie_poz, warnings = FALSE)$total$raw_alpha), 2)
round(c(M_bezp = mean(bezp), SD_bezp = sd(bezp), M_zan = mean(zaniedbanie), SD_zan = sd(zaniedbanie),
        proc_kobiet = 100 * mean(plec == "kobieta"), M_wiek = mean(wiek), SD_wiek = sd(wiek),
        proc_wiktym = 100 * mean(wiktymizacja == "tak")), 2)

# Pozycje „w dzień” i „po zmroku”: te same osoby, dwie oceny porządkowe -> test Wilcoxona dla par
round(100 * rbind(dzien = prop.table(table(factor(ank$bezp_dzien, 1:5))),
                  zmrok = prop.table(table(factor(ank$bezp_zmrok, 1:5)))), 1)
round(c(proc_bezp_dzien = 100 * mean(ank$bezp_dzien >= 4), proc_bezp_zmrok = 100 * mean(ank$bezp_zmrok >= 4),
        Me_dzien = median(ank$bezp_dzien), Me_zmrok = median(ank$bezp_zmrok),
        proc_nizej_po_zmroku = 100 * mean(ank$bezp_zmrok < ank$bezp_dzien),
        proc_wyzej_po_zmroku = 100 * mean(ank$bezp_zmrok > ank$bezp_dzien)), 1)
suppressWarnings(wilcox.test(ank$bezp_zmrok, ank$bezp_dzien, paired = TRUE, exact = FALSE))
rank_biserial(ank$bezp_zmrok, ank$bezp_dzien, paired = TRUE)

# Kobiety a mężczyźni: test t Welcha i g Hedgesa
aggregate(bezp ~ plec, ank, function(x) round(c(n = length(x), M = mean(x), SD = sd(x)), 2))
t.test(bezp ~ plec, data = ank)
hedges_g(bezp ~ plec, data = ank, pooled_sd = FALSE)

# Regresja liniowa: co wiąże się z poczuciem bezpieczeństwa
m1 <- lm(bezp ~ zaniedbanie + policja + plec + wiek + wiktymizacja, data = ank)
s1 <- summary(m1)
tab_reg <- data.frame(b = coef(m1), SE = s1$coefficients[, 2], t = s1$coefficients[, 3], p = s1$coefficients[, 4],
                      lo = confint(m1)[, 1], hi = confint(m1)[, 2])
mz <- lm(scale(bezp) ~ scale(zaniedbanie) + scale(policja) + plec + scale(wiek) + wiktymizacja, data = ank)
tab_reg$beta_lub_d <- coef(mz); tab_reg$beta_lo <- confint(mz)[, 1]; tab_reg$beta_hi <- confint(mz)[, 2]
print(cbind(round(tab_reg[, -4], 3), p = signif(tab_reg$p, 3)))
round(c(R2 = s1$r.squared, R2_adj = s1$adj.r.squared, F = unname(s1$fstatistic[1]),
        df1 = unname(s1$fstatistic[2]), df2 = unname(s1$fstatistic[3])), 3)
signif(pf(s1$fstatistic[1], s1$fstatistic[2], s1$fstatistic[3], lower.tail = FALSE), 3)
round(1 / (1 - sapply(c("zaniedbanie", "policja", "wiek"), function(v)
  summary(lm(as.formula(paste(v, "~ .")), data = data.frame(zaniedbanie = ank$zaniedbanie, policja = ank$policja,
                                                             wiek = ank$wiek, kobieta = as.numeric(ank$plec == "kobieta"),
                                                             wiktym = as.numeric(ank$wiktymizacja == "tak"))))$r.squared)), 2)

# --- Projekt 2. Zaufanie do czterech służb: te same osoby -> test Friedmana, W Kendalla, porównania par
sl <- as.matrix(ank[, c("policja", "straz_pozarna", "wojsko", "straz_miejska")])
round(rbind(Me = apply(sl, 2, median), M = colMeans(sl), proc_ufa = 100 * colMeans(sl >= 4)), 2)
friedman.test(sl)
suppressWarnings(kendalls_w(sl))
dl <- data.frame(id = rep(1:n, 4), sluzba = factor(rep(colnames(sl), each = n), levels = colnames(sl)), ocena = as.vector(sl))
suppressWarnings(pairwise.wilcox.test(dl$ocena, dl$sluzba, paired = TRUE, p.adjust.method = "holm", exact = FALSE))

# --- Projekt 4. Tabela 2 × 2: zapas wody i żywności a dzieci w gospodarstwie
tab <- table(dzieci = ank$dzieci, zapas = ank$zapas); tab
round(100 * prop.table(tab, 1), 1)
chisq.test(tab, correct = FALSE)
round(chisq.test(tab, correct = FALSE)$expected, 1)
fisher.test(tab)$p.value
or <- (tab[2, 2] * tab[1, 1]) / (tab[2, 1] * tab[1, 2]); se_log <- sqrt(sum(1 / tab))
round(c(OR = or, lo = exp(log(or) - 1.96 * se_log), hi = exp(log(or) + 1.96 * se_log),
        phi = effectsize::phi(tab, alternative = "two.sided")$phi), 2)
# Ten sam związek z kontrolą wieku: regresja logistyczna
m2 <- glm(zapas ~ dzieci + I(wiek / 10), data = ank, family = binomial)
round(cbind(OR = exp(coef(m2)), exp(confint.default(m2))), 2)
signif(summary(m2)$coefficients[, 4], 3)
Wynik w R
       alfa omega_total
       0.91        0.91
alfa_zaniedbanie
            0.83
     M_bezp     SD_bezp       M_zan      SD_zan proc_kobiet      M_wiek     SD_wiek proc_wiktym
       3.28        0.80        3.12        0.93       49.38       47.55       15.57       13.44
         1    2    3    4    5
dzien  0.9 11.2 30.3 38.1 19.4
zmrok 10.0 30.3 40.0 15.9  3.8
     proc_bezp_dzien      proc_bezp_zmrok             Me_dzien             Me_zmrok proc_nizej_po_zmroku
                57.5                 19.7                  4.0                  3.0                 68.1
proc_wyzej_po_zmroku
                 3.8

	Wilcoxon signed rank test with continuity correction

data:  ank$bezp_zmrok and ank$bezp_dzien
V = 1118, p-value < 2.2e-16
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |         95% CI
----------------------------------
-0.92             | [-0.93, -0.89]
       plec bezp.n bezp.M bezp.SD
1 mężczyzna 162.00   3.39    0.80
2   kobieta 158.00   3.18    0.78

	Welch Two Sample t-test

data:  bezp by plec
t = 2.4263, df = 318, p-value = 0.01581
alternative hypothesis: true difference in means between group mężczyzna and group kobieta is not equal to 0
95 percent confidence interval:
 0.04062681 0.38899761
sample estimates:
mean in group mężczyzna   mean in group kobieta
               3.389918                3.175105

Hedges' g |       95% CI
------------------------
0.27      | [0.05, 0.49]

- Estimated using un-pooled SD.                     b    SE      t     lo     hi beta_lub_d beta_lo beta_hi        p
(Intercept)      3.874 0.227 17.036  3.427  4.321      0.188   0.052   0.324 1.51e-46
zaniedbanie     -0.345 0.041 -8.334 -0.426 -0.264     -0.400  -0.495  -0.306 2.47e-15
policja          0.209 0.038  5.449  0.134  0.285      0.263   0.168   0.359 1.03e-07
pleckobieta     -0.197 0.077 -2.568 -0.348 -0.046     -0.247  -0.437  -0.058 1.07e-02
wiek            -0.002 0.002 -0.622 -0.006  0.003     -0.030  -0.125   0.065 5.35e-01
wiktymizacjatak -0.391 0.113 -3.445 -0.614 -0.168     -0.490  -0.769  -0.210 6.49e-04
     R2  R2_adj       F     df1     df2
  0.278   0.266  24.140   5.000 314.000
   value
1.49e-20
zaniedbanie     policja        wiek
       1.00        1.02        1.01
         policja straz_pozarna wojsko straz_miejska
Me          3.00          4.00   4.00          3.00
M           3.40          4.22   3.88          3.05
proc_ufa   45.94         84.06  68.12         33.75

	Friedman rank sum test

data:  sl
Friedman chi-squared = 320.37, df = 3, p-value < 2.2e-16

Kendall's W |       95% CI
--------------------------
0.33        | [0.29, 1.00]

- One-sided CIs: upper bound fixed at [1.00].
	Pairwise comparisons using Wilcoxon signed rank test with continuity correction

data:  dl$ocena and dl$sluzba

              policja straz_pozarna wojsko
straz_pozarna < 2e-16 -             -
wojsko        1.5e-11 7.9e-09       -
straz_miejska 9.2e-08 < 2e-16       < 2e-16

P value adjustment method: holm
      zapas
dzieci nie tak
   nie 153  48
   tak  75  44
      zapas
dzieci  nie  tak
   nie 76.1 23.9
   tak 63.0 37.0

	Pearson's Chi-squared test

data:  tab
X-squared = 6.2564, df = 1, p-value = 0.01237

      zapas
dzieci   nie  tak
   nie 143.2 57.8
   tak  84.8 34.2
[1] 0.0151296
  OR   lo   hi  phi
1.87 1.14 3.06 0.13
              OR 2.5 % 97.5 %
(Intercept) 0.17  0.07   0.42
dziecitak   1.95  1.18   3.22
I(wiek/10)  1.13  0.96   1.32
(Intercept)   dziecitak  I(wiek/10)
   7.77e-05    8.67e-03    1.46e-01
2. Projekty 3 i 5: grupy zawodowe (Kruskal–Wallis, Dunn) i kodowanie dokumentów (kappa, Mann–Whitney)
R
# Projekt 3: porównanie czterech grup zawodowych; projekt 5: analiza dokumentów samorządów (dane symulowane).
suppressPackageStartupMessages({ library(effectsize); library(psych); library(DescTools) })

# --- Projekt 3. Ocena przygotowania własnej jednostki do działań w sytuacji kryzysowej
# 132 osoby z czterech grup zawodowych (dobór celowy); skala autorska: średnia z 8 pozycji 1–5.
set.seed(22103)
grupy <- c("policja", "straż pożarna", "wojsko", "administracja (zarządzanie kryzysowe)")
ng <- c(38, 34, 31, 29)
grupa <- factor(rep(grupy, ng), levels = grupy)
lat <- rnorm(sum(ng), c(0, .55, .35, -.35)[as.integer(grupa)], 1)
poz <- sapply(1:8, function(j) as.integer(cut(0.8 * lat + rnorm(sum(ng), 1.0, .6), c(-Inf, -1.8, -.8, .2, 1.1, Inf))))
gz <- data.frame(id = seq_along(grupa), grupa, staz = round(pmax(1, rnorm(sum(ng), 12, 7))), poz)
gz$przygotowanie <- rowMeans(poz)
round(psych::alpha(poz, warnings = FALSE)$total$raw_alpha, 2)
aggregate(przygotowanie ~ grupa, gz, function(x) round(c(n = length(x), Me = median(x), Q1 = unname(quantile(x, .25)),
                                                          Q3 = unname(quantile(x, .75)), M = mean(x), SD = sd(x)), 2))
round(c(skosnosc = psych::skew(gz$przygotowanie), proc_max = 100 * mean(gz$przygotowanie == 5)), 2)
kruskal.test(przygotowanie ~ grupa, data = gz)
rank_epsilon_squared(przygotowanie ~ grupa, data = gz)
DunnTest(przygotowanie ~ grupa, data = gz, method = "holm")

# --- Projekt 5. Analiza dokumentów: 40 dokumentów strategicznych samorządów dotyczących bezpieczeństwa,
# 8 elementów kodowanych 0/1 przez dwie osoby kodujące; indeks kompletności 0–8.
set.seed(22105)
el <- c("diagnoza_z_danymi", "cele_mierzalne", "wskazniki", "harmonogram", "budzet", "partnerzy", "monitorowanie", "konsultacje")
typ <- factor(rep(c("gmina miejska", "gmina wiejska lub miejsko-wiejska"), c(18, 22)))
pr <- c(.75, .45, .40, .55, .35, .85, .50, .30)
prawda <- sapply(seq_along(el), function(j) rbinom(40, 1, plogis(qlogis(pr[j]) + .7 * (typ == "gmina miejska") - .35)))
blad <- function(x, q) ifelse(runif(length(x)) < q, 1 - x, x)
k1 <- prawda
k2 <- sapply(seq_along(el), function(j) blad(prawda[, j], c(.05, .15, .12, .05, .05, .05, .17, .07)[j]))
colnames(k1) <- colnames(k2) <- el
kappy <- sapply(el, function(e) {
  k <- suppressWarnings(psych::cohen.kappa(cbind(k1[, e], k2[, e]))); c(zgodnosc = 100 * mean(k1[, e] == k2[, e]), kappa = k$kappa,
                                                       lo = k$confid[1, 1], hi = k$confid[1, 3]) })
round(t(kappy), 2)
dok <- data.frame(dokument = 1:40, typ, k1)
dok$kompletnosc <- rowSums(k1)
aggregate(kompletnosc ~ typ, dok, function(x) round(c(n = length(x), Me = median(x), Q1 = unname(quantile(x, .25)),
                                                      Q3 = unname(quantile(x, .75)), M = mean(x)), 2))
suppressWarnings(wilcox.test(kompletnosc ~ typ, data = dok, exact = FALSE))
rank_biserial(kompletnosc ~ typ, data = dok)
round(100 * colMeans(k1), 1)
Wynik w R
[1] 0.9
                                  grupa przygotowanie.n przygotowanie.Me przygotowanie.Q1 przygotowanie.Q3
1                               policja           38.00             4.50             4.12             4.75
2                         straż pożarna           34.00             4.69             4.25             4.88
3                                wojsko           31.00             4.50             4.06             4.88
4 administracja (zarządzanie kryzysowe)           29.00             3.88             3.38             4.50
  przygotowanie.M przygotowanie.SD
1            4.35             0.55
2            4.50             0.57
3            4.38             0.52
4            3.88             0.70
skosnosc proc_max
   -0.75    15.91

	Kruskal-Wallis rank sum test

data:  przygotowanie by grupa
Kruskal-Wallis chi-squared = 15.264, df = 3, p-value = 0.001605

Epsilon2 (rank) |       95% CI
------------------------------
0.12            | [0.06, 1.00]

- One-sided CIs: upper bound fixed at [1.00].
 Dunn's test of multiple comparisons using rank sums : holm

                                                    mean.rank.diff    pval
straż pożarna-policja                                    12.360681 0.50778
wojsko-policja                                            2.482598 0.78771
administracja (zarządzanie kryzysowe)-policja           -24.272686 0.03904 *
wojsko-straż pożarna                                     -9.878083 0.59275
administracja (zarządzanie kryzysowe)-straż pożarna     -36.633367 0.00085 ***
administracja (zarządzanie kryzysowe)-wojsko            -26.755284 0.03276 *
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

                  zgodnosc kappa   lo   hi
diagnoza_z_danymi     90.0  0.75 0.52 0.98
cele_mierzalne        82.5  0.64 0.41 0.88
wskazniki             75.0  0.49 0.24 0.74
harmonogram           95.0  0.90 0.76 1.00
budzet                97.5  0.93 0.80 1.00
partnerzy             92.5  0.76 0.50 1.00
monitorowanie         92.5  0.85 0.69 1.00
konsultacje           95.0  0.89 0.75 1.00
                                typ kompletnosc.n kompletnosc.Me kompletnosc.Q1 kompletnosc.Q3 kompletnosc.M
1                     gmina miejska         18.00           4.50           4.00           5.75          4.56
2 gmina wiejska lub miejsko-wiejska         22.00           3.50           2.25           4.75          3.45

	Wilcoxon rank sum test with continuity correction

data:  kompletnosc by typ
W = 279, p-value = 0.02563
alternative hypothesis: true location shift is not equal to 0

r (rank biserial) |       95% CI
--------------------------------
0.41              | [0.07, 0.66]
diagnoza_z_danymi    cele_mierzalne         wskazniki       harmonogram            budzet         partnerzy
             75.0              42.5              27.5              55.0              22.5              85.0
    monitorowanie       konsultacje
             47.5              40.0
3. Rysunki i plik XLSX
R
# Rysunki i plik XLSX do wpisu (uruchom z folderu kod/): LANG=en_US.UTF-8 LC_ALL=en_US.UTF-8 Rscript b221-rysunki.R > b221-rysunki-wynik.txt
suppressPackageStartupMessages({ library(ggplot2); library(svglite); library(openxlsx) })
# Motyw i zapis rysunków zdefiniowane lokalnie
KOLORY <- c(akcent = "#e50101", drugi = "#1f78b4", dane = "grey55", neutralny = "#8C8C8C", granat = "#0f1d3a")
theme_metodolog <- function(base_size = 14) {
  theme_minimal(base_size = base_size) +
    theme(plot.title = element_text(face = "bold", colour = KOLORY[["granat"]], size = rel(1.05), margin = margin(b = 6)),
          plot.subtitle = element_text(colour = "grey30", margin = margin(b = 8)),
          panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
          axis.title = element_text(colour = "grey20"), axis.text = element_text(colour = "grey25"),
          strip.text = element_text(face = "bold", colour = KOLORY[["granat"]]), legend.position = "bottom",
          plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
}
zapisz_svg <- function(wykres, plik, szer = 10, wys = 5.6) {
  svglite::svglite(plik, width = szer, height = wys, bg = "white"); print(wykres); invisible(grDevices::dev.off())
  cat(sprintf("Zapisano %s: w HTML width=\"%d\" height=\"%d\" (%d KB)\n", plik, round(szer * 100), round(wys * 100),
              round(file.info(plik)$size / 1024)))
}
minus <- function(x) gsub("-", "−", x)
pdf(NULL)
invisible(capture.output({ for (f in c("b221-1-ankieta-mieszkancow.R", "b221-2-grupy-dokumenty.R")) source(f) }))

# Rysunek 1: poczucie bezpieczeństwa w okolicy w dzień i po zmroku – te same osoby, według płci
d1 <- do.call(rbind, lapply(c("bezp_dzien", "bezp_zmrok"), function(v) do.call(rbind, lapply(levels(ank$plec), function(g) {
  x <- ank[[v]][ank$plec == g]
  data.frame(pora = ifelse(v == "bezp_dzien", "w dzień", "po zmroku"), plec = g, n = length(x),
             odp = factor(1:5, levels = 5:1), proc = 100 * as.vector(prop.table(table(factor(x, 1:5))))) }))))
d1$wiersz <- factor(paste0(d1$plec, "\n(n = ", d1$n, ")"))
d1$pora <- factor(d1$pora, levels = c("w dzień", "po zmroku"))
et1 <- aggregate(proc ~ pora + plec + wiersz, subset(d1, odp %in% c("4", "5")), sum)
print(et1[, c("pora", "plec", "proc")], digits = 3, row.names = FALSE)
r1 <- ggplot(d1, aes(proc, wiersz, fill = odp)) + geom_col(width = .66, colour = "white", linewidth = .2) +
  geom_text(data = et1, aes(x = 101, y = wiersz, label = sprintf("%.1f%%", proc)), inherit.aes = FALSE, hjust = 0, size = 3.8,
            colour = KOLORY[["akcent"]], fontface = "bold") +
  facet_wrap(~ pora, ncol = 1) +
  scale_fill_manual(values = c(`5` = KOLORY[["drugi"]], `4` = "#9ecae1", `3` = "grey82", `2` = "#f4a3a3", `1` = KOLORY[["akcent"]]),
                    breaks = as.character(1:5), name = NULL,
                    labels = c("1 – zdecydowanie niebezpiecznie", "2", "3", "4", "5 – zdecydowanie bezpiecznie")) +
  scale_x_continuous(limits = c(0, 112), breaks = c(0, 25, 50, 75, 100), labels = function(x) paste0(x, "%"),
                     expand = expansion(mult = c(0, 0))) +
  labs(title = "Poczucie bezpieczeństwa w okolicy w dzień i po zmroku (N = 320)",
       subtitle = "Rozkład odpowiedzi 1–5; czerwona liczba to odsetek odpowiedzi 4 i 5",
       x = "Odsetek odpowiedzi", y = NULL) + theme_metodolog(13) + guides(fill = guide_legend(nrow = 1))
zapisz_svg(r1, "../statystyka-bezpieczenstwo-dzien-zmrok.svg", szer = 10, wys = 5.6)

# Rysunek 2: regresja – standaryzowane współczynniki z 95% CI
d2 <- tab_reg[-1, c("beta_lub_d", "beta_lo", "beta_hi", "p")]
d2$zm <- c("Zaniedbanie okolicy (1 SD)", "Zaufanie do policji (1 SD)", "Kobieta (vs mężczyzna)", "Wiek (1 SD)",
           "Doświadczenie przestępstwa (tak vs nie)")
d2$zm <- factor(d2$zm, levels = rev(d2$zm))
d2$etyk <- minus(sprintf("%.2f [%.2f, %.2f]", d2$beta_lub_d, d2$beta_lo, d2$beta_hi))
print(d2[, c("zm", "beta_lub_d", "beta_lo", "beta_hi")], digits = 3, row.names = FALSE)
r2 <- ggplot(d2, aes(beta_lub_d, zm)) + geom_vline(xintercept = 0, linetype = 2, colour = "grey50") +
  geom_errorbar(aes(xmin = beta_lo, xmax = beta_hi), width = .16, orientation = "y", colour = KOLORY[["drugi"]], linewidth = 1) +
  geom_point(aes(colour = p < .05), size = 3.6) +
  geom_text(aes(label = etyk), nudge_y = .32, size = 3.6, colour = "grey20") +
  scale_colour_manual(values = c(`TRUE` = KOLORY[["akcent"]], `FALSE` = KOLORY[["neutralny"]]),
                      labels = c(`TRUE` = "p < .05", `FALSE` = "p ≥ .05"), name = NULL) +
  scale_x_continuous(limits = c(-0.9, 0.5), breaks = seq(-0.8, 0.4, .2), labels = function(x) minus(sprintf("%.1f", x))) +
  labs(title = "Co wiąże się z poczuciem bezpieczeństwa mieszkańców?",
       subtitle = "Regresja liniowa, N = 320, R² = .28; zmienna zależna w jednostkach SD",
       x = "Współczynnik standaryzowany z 95% CI (dla zmiennych 0/1: różnica w SD)", y = NULL) + theme_metodolog(13)
zapisz_svg(r2, "../statystyka-bezpieczenstwo-regresja.svg", szer = 10, wys = 5)

# Plik XLSX z danymi do pobrania
wb <- createWorkbook(creator = "Metodolog.pl", title = "Statystyka w pracy z bezpieczeństwa narodowego – dane przykładowe")
setLastModifiedBy(wb, "Metodolog.pl")
opis <- data.frame(arkusz = c("Ankieta_mieszkancow", "Grupy_zawodowe", "Dokumenty_koder1", "Dokumenty_koder2"),
  zawartosc = c("320 mieszkańców: 6 pozycji poczucia bezpieczeństwa (1–5) i wynik skali, 3 pozycje zaniedbania okolicy, zaufanie do 4 służb (1–5), doświadczenie przestępstwa, zapas wody i żywności, dzieci, płeć, wiek",
                "132 osoby z 4 grup zawodowych: 8 pozycji oceny przygotowania jednostki (1–5), wynik skali, staż",
                "40 dokumentów samorządów: 8 elementów (0/1) według pierwszej osoby kodującej, typ gminy, indeks kompletności",
                "Te same 40 dokumentów według drugiej osoby kodującej"),
  uwaga = "Dane symulowane do nauki analizy; nie pochodzą z prawdziwego badania.")
for (ark in list(list("Opis", opis), list("Ankieta_mieszkancow", ank), list("Grupy_zawodowe", gz),
                 list("Dokumenty_koder1", dok), list("Dokumenty_koder2", data.frame(dokument = 1:40, typ, k2)))) {
  addWorksheet(wb, ark[[1]]); writeData(wb, ark[[1]], ark[[2]]); setColWidths(wb, ark[[1]], 1:ncol(ark[[2]]), "auto") }
plik <- "../statystyka-bezpieczenstwo-dane-przyklad.xlsx"
saveWorkbook(wb, plik, overwrite = TRUE)
# Kontrola pliku: arkusze, liczba wierszy, metadane autora i rozmiar
sapply(getSheetNames(plik), function(s) nrow(read.xlsx(plik, s)))
tmp <- tempfile(); unzip(plik, exdir = tmp)
core <- paste(readLines(file.path(tmp, "docProps", "core.xml"), warn = FALSE, encoding = "UTF-8"), collapse = "")
cat("creator:", sub(".*<dc:creator>(.*?)</dc:creator>.*", "\\1", core), "| lastModifiedBy:",
    sub(".*<cp:lastModifiedBy>(.*?)</cp:lastModifiedBy>.*", "\\1", core), "\n")
cat("rozmiar KB:", round(file.info(plik)$size / 1024), "\n")
Wynik w R
      pora      plec proc
   w dzień   kobieta 50.6
 po zmroku   kobieta 17.1
   w dzień mężczyzna 64.2
 po zmroku mężczyzna 22.2
Zapisano ../statystyka-bezpieczenstwo-dzien-zmrok.svg: w HTML width="1000" height="560" (12 KB)
                                      zm beta_lub_d beta_lo beta_hi
              Zaniedbanie okolicy (1 SD)    -0.4005  -0.495 -0.3059
              Zaufanie do policji (1 SD)     0.2635   0.168  0.3586
                  Kobieta (vs mężczyzna)    -0.2472  -0.437 -0.0578
                             Wiek (1 SD)    -0.0299  -0.125  0.0647
 Doświadczenie przestępstwa (tak vs nie)    -0.4898  -0.769 -0.2100
Zapisano ../statystyka-bezpieczenstwo-regresja.svg: w HTML width="1000" height="500" (9 KB)
               Opis Ankieta_mieszkancow      Grupy_zawodowe    Dokumenty_koder1
                  4                 320                 132                  40
   Dokumenty_koder2
                 40
creator: Metodolog.pl | lastModifiedBy: Metodolog.pl
rozmiar KB: 44
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje wilcox.test(), t.test(), lm(), glm(), friedman.test(), pairwise.wilcox.test(), kruskal.test(), chisq.test() i fisher.test() z pakietu stats); rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research (R package version 2.6.5) [Computer software]. Northwestern University. https://CRAN.R-project.org/package=psych
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics (R package version 0.99.60) [Computer software]. https://CRAN.R-project.org/package=DescTools
- openxlsx (wersja 4.2.8.1): Schauberger, P., & Walker, A. (2025). openxlsx: Read, write and edit xlsx files (R package version 4.2.8.1) [Computer software]. https://doi.org/10.32614/CRAN.package.openxlsx
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w analizach prac z bezpieczeństwa narodowego
- Oceny tej samej osoby analizowane jak niezależne grupy – np. zaufanie do czterech służb porównane testem Kruskala–Wallisa albo pozycje „w dzień” i „po zmroku” testem Manna–Whitneya.
- Mieszanie pojęć: pytanie o ocenę ryzyka opisane jako lęk przed przestępczością albo jedno ogólne pytanie jako „poczucie bezpieczeństwa”.
- Uogólnianie wyników ankiety internetowej na mieszkańców miasta, „Polaków” albo całą formację.
- Brak rzetelności skali przed policzeniem wyniku jako średniej z pozycji.
- Same wartości p bez wielkości efektu i bez odsetków – zwłaszcza przy dużej próbie, w której istotne są nawet drobne różnice.
- Język przyczynowy w badaniu przekrojowym: „zaufanie do policji zwiększa poczucie bezpieczeństwa” zamiast „wiązało się z wyższym poczuciem bezpieczeństwa”.
- Metryczka, która ujawnia tożsamość respondentów z małych jednostek, i wyniki pokazywane dla kilkuosobowych grup.
- Kodowanie dokumentów przez jedną osobę bez klucza kategorii i bez zgodności kodujących.
- Statystyki urzędowe bez źródła, daty i definicji oraz wnioski o osobach z danych dla gmin lub powiatów.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej z bezpieczeństwa narodowego?
Zależy od pytania i danych. Wynik skali poczucia bezpieczeństwa porównasz między grupami testem t Welcha i wyjaśnisz regresją liniową; oceny tej samej osoby (np. zaufanie do kilku służb) – testem Friedmana; trzy i więcej grup zawodowych przy skośnym wyniku – testem Kruskala–Wallisa z testem Dunna; dwie zmienne kategorialne – tabelą krzyżową z χ² i ilorazem szans. Do każdego testu podaj wielkość efektu z 95% CI.
Jak zmierzyć poczucie bezpieczeństwa mieszkańców w ankiecie?
Użyj kilku pozycji o konkretnych sytuacjach (w domu, w okolicy w dzień, po zmroku, w komunikacji publicznej) zamiast jednego ogólnego pytania, policz rzetelność (alfa i omega) i wynik jako średnią pozycji. Oddziel poczucie bezpieczeństwa od oceny ryzyka i od lęku przed przestępczością – to różne pojęcia, a w literaturze pokazano, że miary ryzyka i lęku korelują tylko umiarkowanie.
Czy można porównać zaufanie do policji, straży pożarnej i wojska u tych samych respondentów?
Tak, ale te oceny są zależne, bo pochodzą od tych samych osób. Użyj testu Friedmana z W Kendalla jako wielkością efektu, a potem porównań par testem Wilcoxona z korektą Holma. Nie porównuj tych ocen testem Kruskala–Wallisa ani ANOVA dla grup niezależnych.
Jak opisać w pracy ankietę przeprowadzoną wśród policjantów lub żołnierzy?
Opisz dobór próby (zwykle celowy lub kula śnieżna), zgody instytucji i uczestników, sposób zapewnienia anonimowości i liczbę osób w każdej grupie. Nie zbieraj zmiennych, które razem pozwalają rozpoznać osobę w małej jednostce (np. stopień, staż i komórka), a wyniki pokazuj tylko dla grup na tyle licznych, by nikt nie był identyfikowalny. Wniosków nie uogólniaj na całą formację.
Jak analizować dokumenty i statystyki urzędowe w pracy z bezpieczeństwa?
Dokumenty koduj według klucza kategorii, a część materiału daj do niezależnego zakodowania drugiej osobie i policz kappę Cohena dla każdej kategorii. Przy statystykach urzędowych podaj źródło z datą odczytu, definicje wskaźników i jednostkę (np. gmina, powiat), licz wskaźniki na liczbę mieszkańców i pamiętaj, że z danych zagregowanych nie wolno wnioskować o pojedynczych osobach (błąd ekologiczny).
Powiązane hasła
Przeczytaj też
Testy nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikRegresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikStatystyka w pracy z socjologii
Sondaż, tabele krzyżowe z resztami, ważenie próby, regresja logistyczna z AME i skale postaw: plan analiz, APA, dane XLSX i kod R.
Czytaj →Piszesz pracę z bezpieczeństwa narodowego i masz dane z ankiety?
Pomożemy dobrać analizy do Twoich pytań – od skali poczucia bezpieczeństwa po porównanie grup zawodowych – policzyć je z wielkością efektu i wyjaśnić tak, abyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Bethlehem, J. (2010). Selection bias in web surveys. International Statistical Review, 78(2), 161–188. https://doi.org/10.1111/j.1751-5823.2010.00112.x ● Otwarty dostęp
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82 ● Otwarty dostęp
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Farrall, S., Bannister, J., Ditton, J., & Gilchrist, E. (1997). Questioning the measurement of the ‘fear of crime’: Findings from a major methodological study. British Journal of Criminology, 37(4), 658–679. https://doi.org/10.1093/oxfordjournals.bjc.a014203
- Ferraro, K. F., & LaGrange, R. L. (1987). The measurement of fear of crime. Sociological Inquiry, 57(1), 70–97. https://doi.org/10.1111/j.1475-682x.1987.tb01181.x
- Lombard, M., Snyder-Duch, J., & Bracken, C. C. (2002). Content analysis in mass communication: Assessment and reporting of intercoder reliability. Human Communication Research, 28(4), 587–604. https://doi.org/10.1111/j.1468-2958.2002.tb00826.x
- Pereira, D. G., Afonso, A., & Medeiros, F. M. (2015). Overview of Friedman’s test and post-hoc analysis. Communications in Statistics - Simulation and Computation, 44(10), 2636–2653. https://doi.org/10.1080/03610918.2014.931971
- Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
- Tourangeau, R., & Yan, T. (2007). Sensitive questions in surveys. Psychological Bulletin, 133(5), 859–883. https://doi.org/10.1037/0033-2909.133.5.859
Cytowania BibTeX
@article{bethlehem2010selection, author={Bethlehem, Jelke}, title={{Selection bias in web surveys}}, journal={International Statistical Review}, year={2010}, volume={78}, number={2}, pages={161--188}, doi={10.1111/j.1751-5823.2010.00112.x}}@article{delacre2017why, author={Delacre, Marie and Lakens, Daniël and Leys, Christophe}, title={{Why psychologists should by default use Welch's t-test instead of Student's t-test}}, journal={International Review of Social Psychology}, year={2017}, volume={30}, number={1}, pages={92--101}, doi={10.5334/irsp.82}}@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@article{farrall1997questioning, author={Farrall, S. and Bannister, J. and Ditton, J. and Gilchrist, E.}, title={{Questioning the measurement of the ‘fear of crime’: Findings from a major methodological study}}, journal={British Journal of Criminology}, year={1997}, volume={37}, number={4}, pages={658--679}, doi={10.1093/oxfordjournals.bjc.a014203}}@article{ferraro1987measurement, author={Ferraro, Kenneth F. and LaGrange, Randy L.}, title={{The measurement of fear of crime}}, journal={Sociological Inquiry}, year={1987}, volume={57}, number={1}, pages={70--97}, doi={10.1111/j.1475-682x.1987.tb01181.x}}@article{lombard2002content, author={Lombard, Matthew and Snyder-Duch, Jennifer and Bracken, Cheryl Campanella}, title={{Content analysis in mass communication: Assessment and reporting of intercoder reliability}}, journal={Human Communication Research}, year={2002}, volume={28}, number={4}, pages={587--604}, doi={10.1111/j.1468-2958.2002.tb00826.x}}@article{pereira2015overview, author={Pereira, Dulce G. and Afonso, Anabela and Medeiros, Fátima Melo}, title={{Overview of Friedman’s test and post-hoc analysis}}, journal={Communications in Statistics - Simulation and Computation}, year={2015}, volume={44}, number={10}, pages={2636--2653}, doi={10.1080/03610918.2014.931971}}@article{robinson1950ecological, author={Robinson, W. S.}, title={{Ecological correlations and the behavior of individuals}}, journal={American Sociological Review}, year={1950}, volume={15}, number={3}, pages={351--357}, doi={10.2307/2087176}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}@article{tourangeau2007sensitive, author={Tourangeau, Roger and Yan, Ting}, title={{Sensitive questions in surveys}}, journal={Psychological Bulletin}, year={2007}, volume={133}, number={5}, pages={859--883}, doi={10.1037/0033-2909.133.5.859}}