Co to jest regresja porządkowa?
Regresja porządkowa (ang. ordinal regression; najczęściej porządkowa regresja logistyczna, czyli model proporcjonalnych szans) to model regresji dla zmiennej zależnej mierzonej na skali porządkowej: odpowiedzi na pojedyncze pytanie z skali Likerta, stopnia nasilenia objawów („brak – łagodne – umiarkowane – ciężkie”) czy poziomu wykształcenia. Kategorie mają tu ustaloną kolejność, ale nie wiadomo, czy odstępy między nimi są równe.
Podstawy tej klasy modeli opisał McCullagh (1980): zaproponował modele regresji dla danych porządkowych, które nie wymagają przypisywania kategoriom wartości liczbowych, i za najbardziej użyteczny uznał właśnie model proporcjonalnych szans. Pełny przegląd metod dla uporządkowanych danych kategorialnych zawiera podręcznik Agrestiego (2010). Bürkner i Vuorre (2019) w tutorialu dla psychologów omawiają trzy rodziny modeli porządkowych – kumulacyjne, sekwencyjne i kategorii przyległych. Na tej stronie zajmujemy się najpopularniejszym z nich: kumulacyjnym modelem logitowym. Przy jednym predyktorze dwukategorialnym jest on bliskim krewnym testu Manna-Whitneya, ale – jak każda regresja – pozwala uwzględnić wiele predyktorów naraz, a dla danych zagnieżdżonych ma wersję wielopoziomową (zob. model wielopoziomowy).
Dlaczego nie zwykła regresja liniowa?
Kodowanie odpowiedzi jako 1–5, liczenie średnich i regresja liniowa zakładają, że „rzadko” i „czasami” dzieli taki sam dystans jak „często” i „bardzo często”. Liddell i Kruschke (2018) przeanalizowali artykuły z trzech czołowych czasopism psychologicznych: wszystkie, które analizowały dane porządkowe, traktowały je jak metryczne. Autorzy pokazują, że może to prowadzić do fałszywych alarmów (błędów I rodzaju), utraty mocy, a nawet odwrócenia kierunku efektu, a uśrednienie kilku pozycji nie zawsze rozwiązuje problem. Bürkner i Vuorre (2019) dodają, że takie podejście zniekształca wielkości efektów i zawyża odsetek błędów.
Nie oznacza to, że każdy wynik skali trzeba analizować modelem porządkowym. Sullivan i Artino (2013) przypominają, że odpowiedzi na pojedyncze pozycje Likerta są porządkowe i lepiej opisywać je medianą i rozkładem częstości, ale do wyników skal złożonych z wielu pozycji testy parametryczne bywają stosowane. Model porządkowy jest naturalnym wyborem przede wszystkim wtedy, gdy zmienną zależną jest jedna pozycja albo kilka kategorii.
Model proporcjonalnych szans
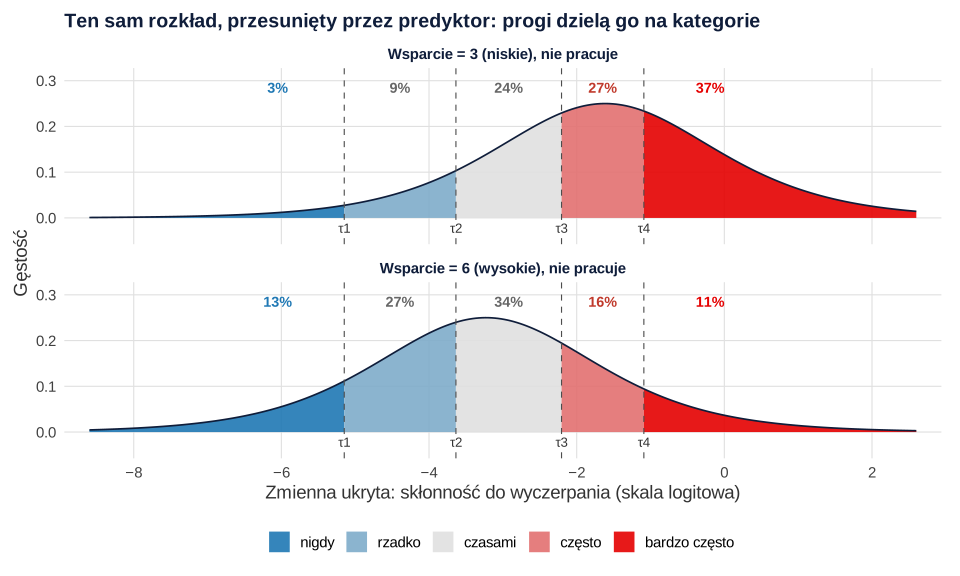
Model najłatwiej zrozumieć przez zmienną ukrytą Y*: ciągłą skłonność (np. do wyczerpania), której nie obserwujemy. Predyktory przesuwają jej rozkład, a progi τ1 < τ2 < … dzielą go na obserwowane kategorie: osoba wybiera kategorię k, gdy jej Y* wypada między τk−1 a τk (rysunek 1). Przy rozkładzie logistycznym daje to równanie:
- τk – progi (w R
Intercepts, w SPSS „Próg”); jest ich o jeden mniej niż kategorii; - β – współczynniki wspólne dla wszystkich progów; dodatni β oznacza przesunięcie w stronę wyższych kategorii;
- exp(β) – iloraz szans (OR): ile razy rosną szanse odpowiedzi powyżej dowolnego progu, gdy predyktor wzrośnie o 1.
Parametry szacuje się metodą największej wiarygodności. To, że jeden OR obowiązuje dla wszystkich progów, jest założeniem proporcjonalnych szans. Znak przed nawiasem to konwencja R (MASS::polr) i SPSS (PLUM) – w niektórych programach współczynniki mają odwrotny znak, więc zawsze sprawdź, co oznacza dodatni β.
Przykład: wyczerpanie nauką, wsparcie i praca zarobkowa
W badaniu (dane symulowane) 250 studentów odpowiedziało na pytanie „Jak często w ostatnim miesiącu czułeś(-aś) się wyczerpany(-a) nauką?” (nigdy – rzadko – czasami – często – bardzo często). Predyktorami były poczucie wsparcia społecznego (1–7; M = 4.82, SD = 1.16) i praca zarobkowa (pracuje 105 osób). Odpowiedzi rozkładały się następująco: 6.4%, 15.2%, 27.6%, 22.8% i 28.0%. Wśród pracujących odpowiedź „bardzo często” wybrało 40.0% osób, wśród niepracujących 19.3% (mediana: „często” wobec „czasami”).
| Predyktor | b (SE) | z | p | OR [95% CI] |
|---|---|---|---|---|
| Wsparcie społeczne (1 pkt) | −0.54 (0.11) | −4.93 | < .001 | 0.58 [0.47, 0.72] |
| Praca zarobkowa (tak vs nie) | 0.99 (0.24) | 4.12 | < .001 | 2.70 [1.69, 4.34] |
Model jako całość istotnie poprawiał dopasowanie w porównaniu z modelem bez predyktorów, χ²(2) = 46.84, p < .001 (R² Nagelkerkego = .18). Z każdym dodatkowym punktem wsparcia szanse odpowiedzi w wyższej kategorii były mniejsze o 41.6% (OR = 0.58), niezależnie od tego, czy porównujemy „nigdy” z resztą, czy „bardzo często” z resztą. Studenci pracujący mieli 2.70 razy większe szanse wyższej kategorii niż niepracujący przy tym samym wsparciu. Progi wyniosły −5.15, −3.64, −2.21 i −1.09.
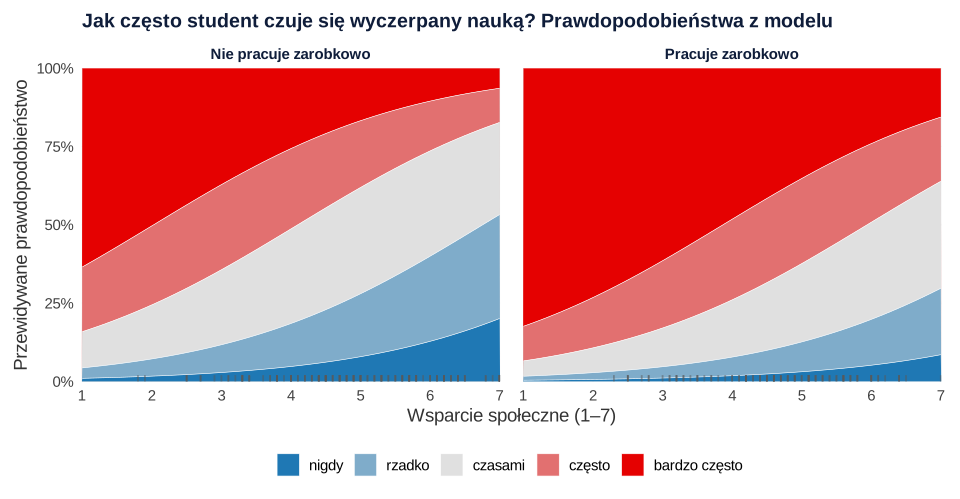
Ilorazy szans warto przełożyć na prawdopodobieństwa. U niepracującego studenta z niskim wsparciem (3 punkty) prawdopodobieństwo odpowiedzi „bardzo często” wynosi .37, a z wysokim (6 punktów) – .11. U pracującego studenta te wartości to .61 i .24. Tak konkretnej informacji nie da model liniowy, który podałby tylko, że średni „wynik” spada o 0.31 punktu na 1 punkt wsparcia – jak gdyby kategorie były równo odległymi liczbami.
Jak sprawdzić założenie proporcjonalnych szans?
Prosty sposób to dopasowanie osobnych regresji logistycznych dla kolejnych podziałów skali (Y ≥ „rzadko”, Y ≥ „czasami”, Y ≥ „często”, Y = „bardzo często”) i porównanie ilorazów szans. Jeśli założenie jest spełnione, powinny być podobne. W przykładzie OR dla wsparcia wyniosły 0.57, 0.58, 0.64 i 0.60, a dla pracy 2.71, 3.13, 2.65 i 2.60 – różnice są małe i bez wyraźnego trendu, więc model proporcjonalnych szans jest uzasadniony. Formalnymi sprawdzianami są test Branta (np. pakiet brant w R) i test równoległości linii w SPSS; przy dużych próbach bywają one nadwrażliwe, więc oceniaj też wielkość różnic.
Gdy założenie jest wyraźnie naruszone dla któregoś predyktora, rozważ model częściowych proporcjonalnych szans, jeden z modeli sekwencyjnych lub kategorii przyległych (Bürkner i Vuorre, 2019) albo wielomianową regresję logistyczną – ta ostatnia ignoruje jednak uporządkowanie kategorii.
Jak opisać wynik w pracy (APA)
Podaj liczbę kategorii, test całego modelu, ilorazy szans z 95% CI i przynajmniej jeden przykład przewidywanych prawdopodobieństw. Przykładowy opis:
Wzór tabeli z ilorazami szans znajdziesz w haśle tabela regresji logistycznej w APA – dla modelu porządkowego dodaj w nocie progi (τ). Więcej o interpretacji OR piszemy w poradniku o regresji logistycznej.
Przykład w R
Pakiet ordinal nie jest tu potrzebny – model proporcjonalnych szans dopasowuje funkcja polr() z pakietu MASS. Kod generuje dane z przykładu, dopasowuje model, liczy wartości p, ilorazy szans z 95% CI, przewidywane prawdopodobieństwa i sprawdza założenie proporcjonalnych szans. Liczby w tekście i na rysunkach pochodzą z tego kodu (test całego modelu i R² – w pełnym skrypcie strony).
Porządkowa regresja logistyczna w MASS::polr
R
library(MASS)
kat <- c("nigdy", "rzadko", "czasami", "często", "bardzo często")
set.seed(154)
n <- 250
wsparcie <- round(pmin(pmax(rnorm(n, 4.8, 1.2), 1), 7), 1)            # wsparcie społeczne 1–7
praca <- factor(rbinom(n, 1, 0.4), labels = c("nie", "tak"))           # praca zarobkowa
y_lat <- -0.55 * (wsparcie - 4.8) + 0.9 * (praca == "tak") + rlogis(n)  # zmienna ukryta
wyczerpanie <- cut(y_lat, c(-Inf, -2.2, -0.9, 0.5, 1.8, Inf), labels = kat, ordered_result = TRUE)
dane <- data.frame(wyczerpanie, wsparcie, praca)

model <- polr(wyczerpanie ~ wsparcie + praca, data = dane, Hess = TRUE)
summary(model)
z <- coef(summary(model))[1:2, "t value"]
round(2 * pnorm(-abs(z)), 6)                          # wartości p (test Walda)
exp(cbind(OR = coef(model), confint(model)))           # ilorazy szans z 95% CI (profilowe)

# Prawdopodobieństwa kategorii dla wybranych profili studentów
nowe <- expand.grid(wsparcie = c(3, 6), praca = c("nie", "tak"))
cbind(nowe, round(predict(model, newdata = nowe, type = "probs"), 3))

# Założenie proporcjonalnych szans: OR z osobnych regresji logistycznych dla progów Y >= k
sapply(2:5, function(k) round(exp(coef(glm(I(as.integer(wyczerpanie) >= k) ~ wsparcie + praca,
                                           family = binomial, data = dane))[-1]), 2))
Wynik w R
Call:
polr(formula = wyczerpanie ~ wsparcie + praca, data = dane, Hess = TRUE)

Coefficients:
           Value Std. Error t value
wsparcie -0.5381     0.1091  -4.930
pracatak  0.9916     0.2406   4.122

Intercepts:
                     Value   Std. Error t value
nigdy|rzadko         -5.1483  0.6414    -8.0262
rzadko|czasami       -3.6358  0.5865    -6.1996
czasami|często       -2.2053  0.5569    -3.9598
często|bardzo często -1.0903  0.5450    -2.0004

Residual Deviance: 708.7106
AIC: 720.7106
wsparcie pracatak
 1.0e-06  3.8e-05
Waiting for profiling to be done...
                OR     2.5 %    97.5 %
wsparcie 0.5838727 0.4701503 0.7216554
pracatak 2.6954767 1.6877691 4.3377831
  wsparcie praca nigdy rzadko czasami często bardzo często
1        3   nie 0.028  0.089   0.239  0.272         0.372
2        6   nie 0.128  0.272   0.336  0.159         0.105
3        3   tak 0.011  0.036   0.124  0.215         0.615
4        6   tak 0.052  0.146   0.310  0.251         0.241
         [,1] [,2] [,3] [,4]
wsparcie 0.57 0.58 0.64  0.6
pracatak 2.71 3.13 2.65  2.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; R² Nagelkerkego policzono w pakiecie performance, a rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- performance (wersja 0.16.0): Lüdecke, D., Ben-Shachar, M. S., Patil, I., Waggoner, P., & Makowski, D. (2021). performance: An R package for assessment, comparison and testing of statistical models. Journal of Open Source Software, 6(60), 3139. https://doi.org/10.21105/joss.03139
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Średnie i regresja liniowa dla jednej pozycji Likerta bez uzasadnienia – zakładają równe odstępy między kategoriami (Liddell i Kruschke, 2018).
- Odwrócona interpretacja znaku – w
polr()dodatni współczynnik oznacza wyższe kategorie; w innych programach może być odwrotnie. - Interpretowanie progów jak efektów – τ to tylko punkty podziału skali ukrytej, a ich istotność nie jest wynikiem badania.
- Pominięcie sprawdzenia proporcjonalnych szans – jeden OR dla wszystkich progów to założenie, a nie fakt.
- Puste lub bardzo rzadkie kategorie – kategorie wybierane przez pojedyncze osoby dają niestabilne progi; rozważ ich połączenie przed analizą (i opisz to).
- Raportowanie samych OR – dla czytelnika bardziej zrozumiałe są przewidywane prawdopodobieństwa kategorii dla typowych wartości predyktorów.
Najczęstsze pytania
Kiedy stosować regresję porządkową?
Gdy zmienna zależna ma kilka uporządkowanych kategorii, a odstępy między nimi nie muszą być równe: pojedyncza pozycja skali Likerta, stopień nasilenia objawów, poziom wykształcenia. Gdy zmienna zależna ma tylko dwie kategorie, wystarczy zwykła regresja logistyczna.
Jak interpretować iloraz szans w regresji porządkowej?
exp(β) mówi, ile razy zmieniają się szanse odpowiedzi powyżej dowolnego progu, gdy predyktor rośnie o 1. W przykładzie na tej stronie OR = 0.58 dla wsparcia oznacza, że z każdym punktem wsparcia szanse wyższej kategorii wyczerpania są mniejsze o 41.6% – tak samo dla podziału „nigdy” vs reszta, jak i „bardzo często” vs reszta.
Co to jest założenie proporcjonalnych szans?
To założenie, że efekt predyktora (iloraz szans) jest taki sam dla wszystkich progów skali. Możesz je sprawdzić, porównując OR z osobnych regresji logistycznych dla kolejnych podziałów skali albo testem Branta (w SPSS: test równoległości linii). Przy wyraźnym naruszeniu rozważ model częściowych proporcjonalnych szans lub regresję wielomianową.
Czy pozycję skali Likerta można analizować regresją liniową?
Można, ale zakłada to równe odstępy między kategoriami. Liddell i Kruschke (2018) pokazali, że taka analiza może dawać fałszywe alarmy, utratę mocy, a nawet odwrócenie kierunku efektu. Dla jednej pozycji bezpieczniejszy jest model porządkowy, który daje też prawdopodobieństwa poszczególnych odpowiedzi.
Jak zrobić regresję porządkową w R?
Najprościej funkcją polr() z pakietu MASS: polr(y ~ x1 + x2, data = dane, Hess = TRUE), gdzie y jest czynnikiem uporządkowanym. Ilorazy szans uzyskasz przez exp(coef(model)), przedziały przez exp(confint(model)), a prawdopodobieństwa kategorii przez predict(model, type = "probs").
Jak zrobić regresję porządkową w SPSS?
Wybierz Analiza → Regresja → Porządkowa (procedura PLUM). Zmienną porządkową wstaw jako zależną, predyktory jakościowe jako czynniki, a ilościowe jako współzmienne. W Wynikach zaznacz test równoległości linii. Progi pojawią się w tabeli jako „Próg”, a ilorazy szans policzysz jako exp(B).
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →PoradnikIle stopni skali Likerta wybrać?
4, 5, 7 czy więcej punktów: co mówią badania, środek skali, etykiety, tabela decyzyjna, symulacja w R i wzór opisu do pracy.
Czytaj →PoradnikAnaliza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Agresti, A. (2010). Analysis of ordinal categorical data (2nd ed.). Wiley. https://doi.org/10.1002/9780470594001
- Bürkner, P.-C., & Vuorre, M. (2019). Ordinal regression models in psychology: A tutorial. Advances in Methods and Practices in Psychological Science, 2(1), 77–101. https://doi.org/10.1177/2515245918823199 ● Otwarty dostęp: pełny tekst
- Liddell, T. M., & Kruschke, J. K. (2018). Analyzing ordinal data with metric models: What could possibly go wrong? Journal of Experimental Social Psychology, 79, 328–348. https://doi.org/10.1016/j.jesp.2018.08.009 ● Otwarty dostęp: pełny tekst
- McCullagh, P. (1980). Regression models for ordinal data. Journal of the Royal Statistical Society: Series B (Methodological), 42(2), 109–127. https://doi.org/10.1111/j.2517-6161.1980.tb01109.x
- Sullivan, G. M., & Artino, A. R., Jr. (2013). Analyzing and interpreting data from Likert-type scales. Journal of Graduate Medical Education, 5(4), 541–542. https://doi.org/10.4300/JGME-5-4-18 ● Otwarty dostęp
Cytowania BibTeX
@book{agresti2010analysis, author={Agresti, Alan}, title={{Analysis of ordinal categorical data (2nd ed.)}}, year={2010}, publisher={Wiley}, doi={10.1002/9780470594001}}@article{burkner2019ordinal, author={Bürkner, Paul-Christian and Vuorre, Matti}, title={{Ordinal regression models in psychology: A tutorial}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={1}, pages={77--101}, doi={10.1177/2515245918823199}}@article{liddell2018analyzing, author={Liddell, Torrin M. and Kruschke, John K.}, title={{Analyzing ordinal data with metric models: What could possibly go wrong?}}, journal={Journal of Experimental Social Psychology}, year={2018}, volume={79}, pages={328--348}, doi={10.1016/j.jesp.2018.08.009}}@article{mccullagh1980regression, author={McCullagh, Peter}, title={{Regression models for ordinal data}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1980}, volume={42}, number={2}, pages={109--127}, doi={10.1111/j.2517-6161.1980.tb01109.x}}@article{sullivan2013analyzing, author={Sullivan, Gail M. and Artino, Jr., Anthony R.}, title={{Analyzing and interpreting data from Likert-type scales}}, journal={Journal of Graduate Medical Education}, year={2013}, volume={5}, number={4}, pages={541--542}, doi={10.4300/jgme-5-4-18}}