Co to jest test Branta?
Test Branta (ang. Brant test) sprawdza założenie proporcjonalnych szans w porządkowej regresji logistycznej – dla całego modelu i osobno dla każdego predyktora. Brant (1990) wyszedł od tego, że model proporcjonalnych szans to seria regresji logistycznych dla kolejnych podziałów skali (Y > 1, Y > 2, …) ze wspólnymi współczynnikami, i zaproponował formalne porównanie osobnych dopasowań tych regresji. Hasło o założeniu wyjaśnia jego sens; tutaj opisujemy sam test.
Jak działa test
Dla skali o J kategoriach dopasowuje się J − 1 regresji logistycznych. Potem test Walda sprawdza, czy nachylenie predyktora jest takie samo we wszystkich regresjach. Regresje korzystają z tych samych osób, więc ich oszacowania są skorelowane; Brant podał wzór na ich łączną macierz kowariancji. Test dla jednego predyktora ma J − 2 stopni swobody, a test globalny (J − 2) · p, gdzie p to liczba predyktorów. H₀: szanse są proporcjonalne.
Przykład
W danych symulowanych 500 osób oceniało usługę w czterostopniowej skali, a predyktorami były wiek (standaryzowany) i płeć. Ilorazy szans dla wieku w trzech regresjach są niemal równe (1.58, 1.54, 1.57) i test Branta tego nie podważa: χ²(2) = 0.14, p = .931. Dla kobiet OR rośnie z progiem (1.04, 1.67, 2.86): χ²(2) = 19.74, p < .001. Test globalny: χ²(4) = 19.77, p < .001. Test ilorazu wiarygodności z pakietu ordinal daje podobny obraz (0.12 i 19.39).
Na rysunku
Test Branta porównuje nachylenia z osobnych regresji logistycznych dla progów. Rysunek pokazuje je dla danych z przykładu jako ilorazy szans z przedziałami ufności i zestawia ze wspólnym ilorazem szans z modelu proporcjonalnych szans. To zwykły wykres współczynników, tyle że każdy predyktor ma tu trzy oszacowania zamiast jednego.
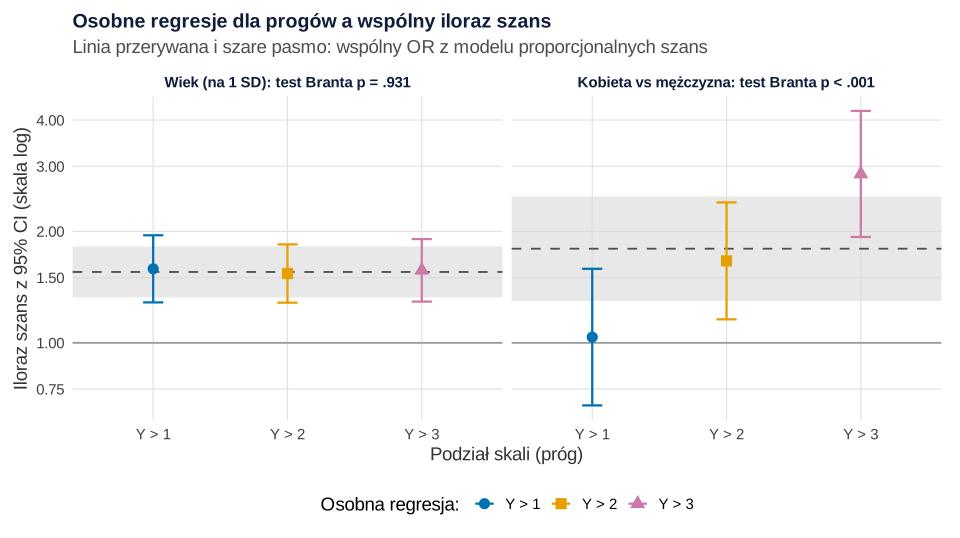
set.seed(597)).Co widać. Dla wieku trzy ilorazy szans (1.58, 1.54, 1.57) leżą niemal dokładnie na wspólnym OR = 1.55, 95% CI [1.33, 1.82]. Dla płci OR rośnie z progiem: 1.04 [0.68, 1.58] dla podziału Y > 1, 1.67 [1.16, 2.40] dla Y > 2 i 2.86 [1.93, 4.23] dla Y > 3. Wspólny OR = 1.80 [1.30, 2.49] uśrednia te trzy efekty: zawyża różnicę między kobietami a mężczyznami na dole skali, a zaniża ją na górze.
Na co uważać. Nakładanie się przedziałów nie zastępuje testu. Trzy regresje korzystają z tych samych osób, więc ich oszacowania są skorelowane, a test Branta tę kowariancję uwzględnia. Przy rzadkich kategoriach skrajnych przedział dla skrajnego progu jest szeroki i wykres może sugerować różnicę, której dane nie potwierdzają. Rysunek nie mówi też, czy różnica ilorazów ma znaczenie praktyczne – to ocenia się z samych wartości OR. Jak czytać ilorazy szans i krzywe w regresji logistycznej, pokazuje wpis Regresja logistyczna w obrazkach.
Podpis do pracy:
Dane i ziarno 597 są te same co w przykładzie. Efekt płci na skali logitu (0.1, 0.5 i 1.0 dla kolejnych progów) ustawiono ręcznie tak, by naruszenie założenia było wyraźne; ziarna nie zmieniano. Rysunek na stronie różni się od wyniku kodu tylko motywem (krój i kolor czcionki, siatka).
R – kod rysunku
# Rysunek 1. Nachylenia z osobnych regresji logistycznych dla progów a wspólne nachylenie modelu
# Dane jak w przykładzie hasła: 500 osób, skala 1–4, wiek (stały efekt), płeć (efekt rośnie z progiem)
library(ggplot2)
suppressPackageStartupMessages(library(ordinal))
set.seed(597)
n <- 500
wiek <- rnorm(n); kobieta <- rbinom(n, 1, 0.5)
a <- c(1.2, 0, -1.2); b_k <- c(0.1, 0.5, 1.0)
p_gt <- sapply(1:3, function(j) plogis(a[j] + 0.6 * wiek + b_k[j] * kobieta))  # P(Y > j)
u <- runif(n); y <- 1 + (u < p_gt[, 1]) + (u < p_gt[, 2]) + (u < p_gt[, 3])

# osobne regresje logistyczne Y > j z 95% CI Walda
osobne <- do.call(rbind, lapply(1:3, function(j) {
  m <- glm(I(y > j) ~ wiek + kobieta, family = binomial)
  ci <- confint.default(m)[-1, ]
  data.frame(prog = paste0("Y > ", j), zmienna = c("wiek", "kobieta"),
             b = coef(m)[-1], lo = ci[, 1], hi = ci[, 2])
}))
# wspólne nachylenie z modelu proporcjonalnych szans (clm, logit)
mw <- clm(factor(y) ~ wiek + kobieta)
ciw <- confint(mw, type = "Wald")
wspolne <- data.frame(zmienna = c("wiek", "kobieta"), b = coef(mw)[c("wiek", "kobieta")],
                      lo = ciw[c("wiek", "kobieta"), 1], hi = ciw[c("wiek", "kobieta"), 2])
print(transform(osobne, OR = round(exp(b), 2), OR_lo = round(exp(lo), 2), OR_hi = round(exp(hi), 2),
                b = NULL, lo = NULL, hi = NULL), row.names = FALSE)
print(transform(wspolne, OR = round(exp(b), 2), OR_lo = round(exp(lo), 2), OR_hi = round(exp(hi), 2),
                b = NULL, lo = NULL, hi = NULL), row.names = FALSE)

poziomy <- c(wiek = "Wiek (na 1 SD): test Branta p = .931", kobieta = "Kobieta vs mężczyzna: test Branta p < .001")
osobne$panel <- factor(poziomy[osobne$zmienna], levels = poziomy)
wspolne$panel <- factor(poziomy[wspolne$zmienna], levels = poziomy)
kol <- c("#0072B2", "#E69F00", "#CC79A7")                 # Okabe–Ito
motyw <- theme_minimal(base_size = 14) + theme(legend.position = "bottom", panel.grid.minor = element_blank())
p1 <- ggplot(osobne, aes(x = prog, y = exp(b))) +
  geom_rect(data = wspolne, aes(xmin = -Inf, xmax = Inf, ymin = exp(lo), ymax = exp(hi)),
            inherit.aes = FALSE, fill = "grey85", alpha = 0.6) +
  geom_hline(data = wspolne, aes(yintercept = exp(b)), linetype = "dashed", colour = "grey30") +
  geom_hline(yintercept = 1, colour = "grey60") +
  geom_errorbar(aes(ymin = exp(lo), ymax = exp(hi), colour = prog), width = 0.15, linewidth = 0.8) +
  geom_point(aes(colour = prog, shape = prog), size = 3.5) +
  facet_wrap(~ panel) +
  scale_y_log10(breaks = c(0.5, 0.75, 1, 1.5, 2, 3, 4)) +
  scale_colour_manual(values = kol, name = "Osobna regresja:") +
  scale_shape_manual(values = c(16, 15, 17), name = "Osobna regresja:") +
  labs(x = "Podział skali (próg)", y = "Iloraz szans z 95% CI (skala log)",
       title = "Osobne regresje dla progów a wspólny iloraz szans",
       subtitle = "Linia przerywana i szare pasmo: wspólny OR z modelu proporcjonalnych szans") +
  motyw
p1   # zapis: ggsave("test-branta-osobne-regresje.svg", p1, width = 10, height = 5.6)
Wynik w R
  prog zmienna   OR OR_lo OR_hi
 Y > 1    wiek 1.58  1.29  1.95
 Y > 1 kobieta 1.04  0.68  1.58
 Y > 2    wiek 1.54  1.28  1.85
 Y > 2 kobieta 1.67  1.16  2.40
 Y > 3    wiek 1.57  1.29  1.91
 Y > 3 kobieta 2.86  1.93  4.23
 zmienna   OR OR_lo OR_hi
    wiek 1.55  1.33  1.82
 kobieta 1.80  1.30  2.49
Jak opisać w pracy
Na co uważać
- Każda regresja potrzebuje wielu osób powyżej i poniżej progu. Przy rzadkich kategoriach skrajnych oszacowania są niestabilne; połącz kategorie albo użyj testu ilorazu wiarygodności.
- W dużej próbie test wykryje różnice bez znaczenia praktycznego. Patrz na ilorazy szans dla progów, nie tylko na p.
- Naruszenie dla jednego predyktora nie przekreśla modelu. Williams (2006) opisuje model częściowych proporcjonalnych szans, mniej restrykcyjny niż model równoległych linii, którego założenia często są naruszane, a oszczędniejszy niż wielomianowa regresja logistyczna.
- Cały proces od wyboru modelu po tabelę wyników opisuje wpis Regresja porządkowa krok po kroku.
Test Branta w R
Kod liczy test ze wzorów Branta (1990): dopasowuje trzy regresje logistyczne dla progów, buduje łączną macierz kowariancji ich oszacowań i wykonuje test Walda. Potem porównuje wynik z testem ilorazu wiarygodności nominal_test(). Funkcja brant::brant() dla modelu MASS::polr() daje ten sam wynik co obliczenie ręczne (χ² = 0.14 dla wieku, 19.74 dla płci i 19.77 globalnie).
Test Branta globalnie i dla każdego predyktora
R
# Test Branta ze wzorów Brant (1990): osobne regresje logistyczne dla progów (dane symulowane)
suppressPackageStartupMessages(library(ordinal))
set.seed(597)
n <- 500
wiek <- rnorm(n); kobieta <- rbinom(n, 1, 0.5)
a <- c(1.2, 0, -1.2); b_k <- c(0.1, 0.5, 1.0)       # efekt płci rośnie z progiem, wieku – stały
p_gt <- sapply(1:3, function(j) plogis(a[j] + 0.6 * wiek + b_k[j] * kobieta))  # P(Y > j)
u <- runif(n); y <- 1 + (u < p_gt[, 1]) + (u < p_gt[, 2]) + (u < p_gt[, 3])
X <- cbind(1, wiek, kobieta); K <- 3; p <- 2
fity <- lapply(1:K, function(j) glm(I(y > j) ~ wiek + kobieta, family = binomial))
B <- sapply(fity, coef); PI <- sapply(fity, fitted)
round(exp(B[-1, ]), 2)                              # OR dla progów Y > 1, Y > 2, Y > 3
V <- matrix(0, K * (p + 1), K * (p + 1))            # kowariancja oszacowań z K regresji
for (j in 1:K) for (l in j:K) {
  W <- PI[, l] - PI[, j] * PI[, l]
  Aj <- solve(t(X) %*% (X * (PI[, j] * (1 - PI[, j]))))
  Al <- solve(t(X) %*% (X * (PI[, l] * (1 - PI[, l]))))
  ij <- (j - 1) * (p + 1) + 1:(p + 1); il <- (l - 1) * (p + 1) + 1:(p + 1)
  V[ij, il] <- Aj %*% (t(X) %*% (X * W)) %*% Al; V[il, ij] <- t(V[ij, il])
}
idx_b <- as.vector(sapply(0:(K - 1), function(j) j * (p + 1) + 2:(p + 1)))
b <- as.vector(B[-1, ]); Vb <- V[idx_b, idx_b]
brant <- function(zm) {                              # Wald: równość nachyleń między progami
  idx <- as.vector(sapply(0:(K - 1), function(j) j * p + zm)); q <- length(zm)
  D <- do.call(rbind, lapply(2:K, function(k) { r <- matrix(0, q, q * K)
    r[, 1:q] <- diag(q); r[, (k - 1) * q + 1:q] <- -diag(q); r }))
  d <- D %*% b[idx]; chi <- as.numeric(t(d) %*% solve(D %*% Vb[idx, idx] %*% t(D)) %*% d)
  c(chi2 = chi, df = nrow(D), p = pchisq(chi, nrow(D), lower.tail = FALSE))
}
round(rbind(globalnie = brant(1:2), wiek = brant(1), kobieta = brant(2)), 3)
# Dla porównania: test ilorazu wiarygodności z pakietu ordinal
nominal_test(clm(factor(y) ~ wiek + kobieta))
# To samo funkcją brant() z pakietu brant (model polr z pakietu MASS)
brant::brant(MASS::polr(factor(y) ~ wiek + kobieta))
Wynik w R
        [,1] [,2] [,3]
wiek    1.58 1.54 1.57
kobieta 1.04 1.67 2.86
            chi2 df     p
globalnie 19.772  4 0.001
wiek       0.142  2 0.931
kobieta   19.739  2 0.000
Tests of nominal effects

formula: factor(y) ~ wiek + kobieta
        Df  logLik    AIC     LRT Pr(>Chi)
<none>     -656.49 1323.0
wiek     2 -656.42 1326.8  0.1244   0.9397
kobieta  2 -646.79 1307.6 19.3865 6.17e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
--------------------------------------------
Test for	X2	df	probability
--------------------------------------------
Omnibus		19.77	4	0
wiek		0.14	2	0.93
kobieta		19.74	2	0
--------------------------------------------

H0: Parallel Regression Assumption holds
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje base i stats, pakiety ordinal, MASS i brant); rysunki narysowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- brant (wersja 0.3.0): Schlegel, B., & Steenbergen, M. (2020). brant: Test for parallel regression assumption [R package]. https://doi.org/10.32614/CRAN.package.brant
- ordinal (wersja 2026.7-26): Christensen, R. H. B. (2026). ordinal: Regression models for ordinal data [R package]. https://doi.org/10.32614/CRAN.package.ordinal
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze pytania
Czym test Branta różni się od testu ilorazu wiarygodności?
Test Branta to test Walda oparty na osobnych regresjach logistycznych dla progów, więc nie wymaga dopasowania modelu uogólnionego. Test ilorazu wiarygodności porównuje model proporcjonalnych szans z modelem z osobnymi nachyleniami. Zwykle prowadzą do podobnych wniosków.
Ile stopni swobody ma test Branta?
Dla jednego predyktora J − 2, gdzie J to liczba kategorii zmiennej zależnej. Test globalny ma (J − 2) · p stopni swobody. Predyktor kategorialny wnosi tyle składników, ile ma zmiennych zero-jedynkowych.
Co zrobić, gdy test Branta jest istotny?
Sprawdź, jak bardzo różnią się ilorazy szans dla progów. Gdy różnica jest duża, uwolnij nachylenie tylko tego predyktora (model częściowych proporcjonalnych szans) albo rozważ inny model porządkowy lub wielomianową regresję logistyczną.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →PoradnikWielomianowa regresja logistyczna
Kategoria odniesienia, RRR, test predyktorów, prawdopodobieństwa przewidywane, założenie IIA i tabela APA – na danych do pobrania z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Brant, R. (1990). Assessing proportionality in the proportional odds model for ordinal logistic regression. Biometrics, 46(4), 1171–1178. https://doi.org/10.2307/2532457
- Williams, R. (2006). Generalized ordered logit/partial proportional odds models for ordinal dependent variables. The Stata Journal, 6(1), 58–82. https://doi.org/10.1177/1536867x0600600104 ● Otwarty dostęp
Cytowania BibTeX
@article{brant1990assessing, author={Brant, Rollin}, title={{Assessing proportionality in the proportional odds model for ordinal logistic regression}}, journal={Biometrics}, year={1990}, volume={46}, number={4}, pages={1171--1178}, doi={10.2307/2532457}}@article{williams2006generalized, author={Williams, Richard}, title={{Generalized ordered logit/partial proportional odds models for ordinal dependent variables}}, journal={The Stata Journal}, year={2006}, volume={6}, number={1}, pages={58--82}, doi={10.1177/1536867x0600600104}}