Kiedy wielomianowa regresja logistyczna
Wielomianową regresję logistyczną stosujesz, gdy zmienna zależna ma trzy lub więcej kategorii bez naturalnego porządku: wybór specjalności, plan po studiach, preferowana forma terapii, typ strategii radzenia sobie. To zmienne na skali nominalnej. Kwak i Clayton-Matthews (2002) podkreślają, że nie trzeba ograniczać analizy do par kategorii ani łączyć ich w dwie grupy – usuwanie obserwacji czy łączenie kategorii daje mniej efektywne oszacowania.
Ten wpis zakłada, że znasz binarną regresję logistyczną: logit, iloraz szans i metodę największej wiarygodności. Jeśli nie, zacznij od poradnika regresja logistyczna krok po kroku, bo tutaj omawiamy tylko to, co się zmienia przy więcej niż dwóch kategoriach.
| Zmienna zależna | Model |
|---|---|
| Dwie kategorie (zdał – nie zdał) | Binarna regresja logistyczna |
| Kilka kategorii uporządkowanych (ocena 2–5, „wcale” – „bardzo”) | Regresja porządkowa |
| Kilka kategorii bez porządku (praca, nauka, inna droga) | Wielomianowa regresja logistyczna |
| Kategorie uporządkowane, ale założenie proporcjonalnych szans wyraźnie naruszone | Model częściowych proporcjonalnych szans albo wielomianowa (kosztem utraty porządku) |
Logika modelu: kategoria odniesienia i kilka równań
Model wybiera jedną kategorię jako kategorię odniesienia i porównuje z nią każdą pozostałą. Przy trzech kategoriach powstają dwa równania logitowe, każde z własną stałą i własnymi współczynnikami:
ln[P(poza zawodem) / P(zawód)] = b20 + b21X1 + … + b2kXk
Wykładnik współczynnika, eb, to względny iloraz ryzyka (ang. relative risk ratio, RRR). Mówi, ile razy zmienia się stosunek prawdopodobieństwa danej kategorii do prawdopodobieństwa kategorii odniesienia, gdy predyktor rośnie o jednostkę. Mimo nazwy nie jest to ryzyko względne w sensie epidemiologicznym, tylko iloraz szans liczony względem kategorii odniesienia. Wszystkie równania szacuje się naraz, dlatego prawdopodobieństwa trzech kategorii zawsze sumują się do 1.
Kategorię odniesienia wybierz świadomie: najliczniejszą albo tę, z którą porównania odpowiadają na hipotezy. Jej zmiana nie zmienia modelu, tylko zapis wyników.
Przykład: plany studentów po studiach
W przykładzie (dane symulowane) 300 studentów ostatniego roku podało swój główny plan po studiach: praca w zawodzie (174 osoby, 58.0%), dalsza nauka, np. doktorat (52 osoby, 17.3%), albo praca poza zawodem (74 osoby, 24.7%). Predyktory to średnia ocen ze studiów (M = 4.11, SD = 0.39), zainteresowanie pracą naukową (skala 1–5; M = 3.07, SD = 0.88) i odbycie praktyk zawodowych poza obowiązkowymi (44% osób). Kategorią odniesienia jest praca w zawodzie.
Plik do pobrania: wielomianowa-regresja-dane-przyklad.csv – 300 wierszy, kolumny id, plan (zawod, nauka, poza), srednia, badania, praktyki (1 = tak). Wszystkie liczby w tekście pochodzą z kodu w sekcji Wielomianowa regresja logistyczna w R.
Zanim zbudujesz model, zestaw zmienną zależną z każdym predyktorem (średnie albo tabela krzyżowa). Średnia ocen wyniosła 4.14 w grupie wybierającej pracę w zawodzie, 4.23 w grupie planującej dalszą naukę i 3.96 w grupie wybierającej pracę poza zawodem; zainteresowanie badaniami – odpowiednio 2.97, 3.62 i 2.92. Praktyki odbyło 51% osób planujących pracę w zawodzie, 42% planujących dalszą naukę i 31% planujących pracę poza zawodem.
Krok 1. Test modelu i test każdego predyktora
Model z trzema predyktorami był lepiej dopasowany niż model bez predyktorów: test ilorazu wiarygodności χ²(6) = 55.34, p < .001 (dewiancja spadła z 578.99 do 523.64). Stopni swobody jest 6, bo każdy z trzech predyktorów ma po jednym współczynniku w dwóch równaniach.
Z tego samego powodu o istotności predyktora decyduje test ilorazu wiarygodności z 2 stopniami swobody, który sprawdza oba jego współczynniki naraz – a nie pojedyncze wartości p w wydruku. W przykładzie istotne były wszystkie trzy predyktory: średnia ocen χ²(2) = 21.25, p < .001, zainteresowanie badaniami χ²(2) = 28.70, p < .001, praktyki χ²(2) = 8.93, p = .011. W R policzysz go funkcją car::Anova() dla modelu z nnet::multinom().
Krok 2. Jak interpretować współczynniki i RRR
Każdy współczynnik czytaj jako porównanie dwóch konkretnych kategorii przy stałych pozostałych predyktorach (Tabela 1):
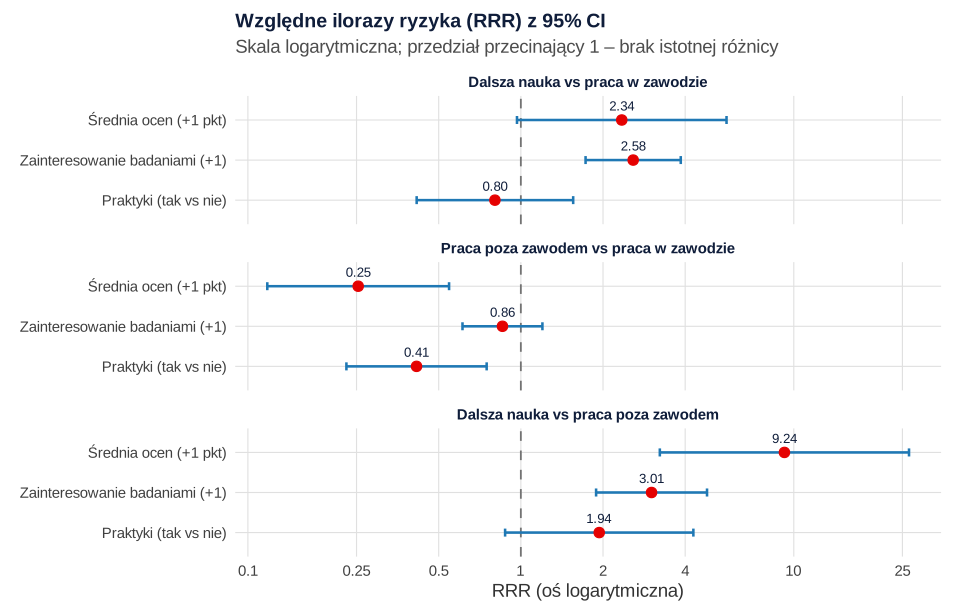
- Dalsza nauka vs praca w zawodzie. Wzrost zainteresowania badaniami o 1 punkt wiązał się z 2.58 raza wyższym stosunkiem szans wyboru dalszej nauki, 95% CI [1.73, 3.85], p < .001. Średnia ocen miała RRR = 2.34, ale przedział [0.97, 5.67] obejmował 1 (p = .059), a praktyki nie różnicowały tych dwóch planów (RRR = 0.80, p = .516).
- Praca poza zawodem vs praca w zawodzie. Wyższa średnia ocen wiązała się z mniejszymi szansami pracy poza zawodem: RRR = 0.25 na 1 punkt, 95% CI [0.12, 0.55], p < .001. Osoby po praktykach miały 0.41 raza mniejszy stosunek szans pracy poza zawodem, 95% CI [0.23, 0.75], p = .004. Zainteresowanie badaniami nie miało tu znaczenia (RRR = 0.86, p = .367).
Jeden punkt średniej ocen to ponad dwa odchylenia standardowe (SD = 0.39); realistyczniejsza jest różnica 0.5 punktu: RRR = 1.53 dla dalszej nauki i 0.50 dla pracy poza zawodem. Stała odpowiada średniej ocen równej 0; aby była interpretowalna, użyj centrowania zmiennych.
Porównania, którego nie ma w wydruku, nie zgaduj. Czy planujący dalszą naukę różnią się od wybierających pracę poza zawodem? Dopasuj model ponownie z inną kategorią odniesienia. Dewiancja jest identyczna (523.64), a nowe porównanie pokazuje, że wyższa średnia ocen (RRR = 9.24, 95% CI [3.23, 26.43]) i większe zainteresowanie badaniami (RRR = 3.01, 95% CI [1.89, 4.81]) silnie odróżniają te dwie grupy, a praktyki już nie (RRR = 1.94, 95% CI [0.88, 4.29], p = .103). Rysunek 1 zestawia wszystkie trzy porównania.
Nie porównuj wprost RRR z modeli o różnych zestawach predyktorów – Mood (2010) pokazała, że ilorazy szans zmieniają się po dodaniu zmiennych nawet z nimi nieskorelowanych.
Krok 3. Prawdopodobieństwa przewidywane
Z RRR trudno wyczytać, jak zmienia się prawdopodobieństwo konkretnego planu – znak współczynnika nie przesądza nawet o kierunku zmiany, bo prawdopodobieństwo każdej kategorii zależy od wszystkich równań naraz. Widać to na rysunku 2: wśród osób bez praktyk prawdopodobieństwo pracy w zawodzie najpierw rośnie wraz ze średnią ocen, a przy najwyższych ocenach lekko spada, bo coraz więcej osób wybiera dalszą naukę.
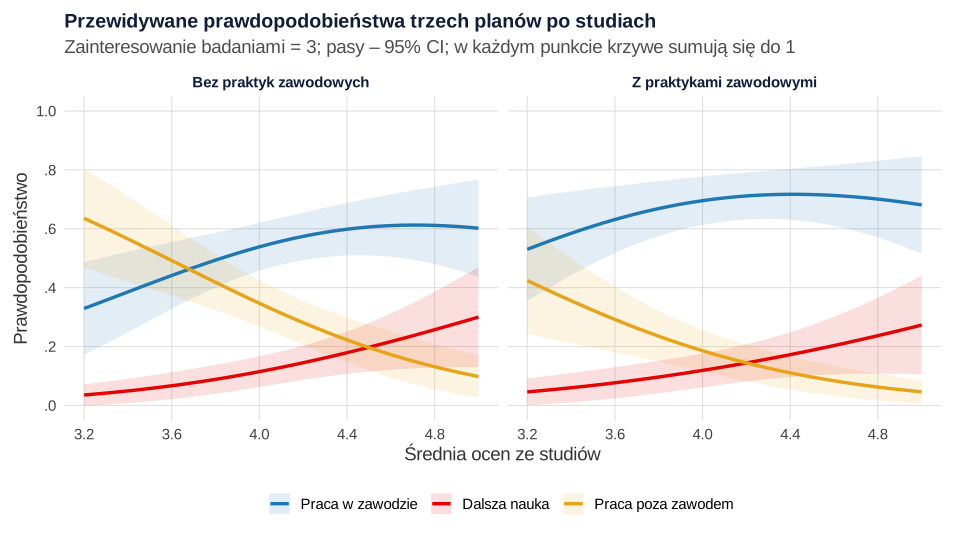
Dla promotora najczytelniejsze są prawdopodobieństwa dla kilku profili (zainteresowanie badaniami = 3):
| Profil | Praca w zawodzie | Dalsza nauka | Praca poza zawodem |
|---|---|---|---|
| Średnia 3.6, bez praktyk | .44 [.33, .56] | .07 [.02, .11] | .49 [.37, .61] |
| Średnia 3.6, z praktykami | .63 [.52, .75] | .08 [.02, .13] | .29 [.18, .40] |
| Średnia 4.6, bez praktyk | .61 [.50, .72] | .22 [.12, .31] | .17 [.09, .25] |
| Średnia 4.6, z praktykami | .71 [.61, .82] | .20 [.11, .30] | .08 [.03, .14] |
Jedną liczbą na predyktor jest przeciętna zmiana prawdopodobieństwa w próbie. Praktyki podnosiły prawdopodobieństwo pracy w zawodzie średnio o 14.0 punktu procentowego i o tyle samo (13.9) obniżały prawdopodobieństwo pracy poza zawodem, nie zmieniając szans dalszej nauki (−0.1). Średnia ocen wyższa o 0.5 punktu zwiększała prawdopodobieństwo dalszej nauki o 8.2 punktu i zmniejszała prawdopodobieństwo pracy poza zawodem o 10.8 punktu. Zmiany trzech kategorii zawsze sumują się do zera.
Krok 4. Założenia i ocena modelu
Model wielomianowy ma te same wymagania co binarny – niezależność obserwacji, liniowość logitu dla predyktorów ciągłych, brak silnej współliniowości – oraz dwie sprawy własne.
Niezależność od nieistotnych alternatyw (IIA). Model zakłada, że stosunek szans dwóch kategorii nie zależy od istnienia pozostałych. Kwak i Clayton-Matthews (2002) opisują sprawdzanie IIA testem Hausmana, ale Cheng i Long (2007) w symulacjach pokazali, że popularne testy IIA często odrzucają założenie przy wyraźnie odrębnych kategoriach i nie odrzucają go przy kategoriach bliskich sobie, i uznali je za niezadowalające w praktyce. Lepiej ocenić IIA merytorycznie: kategorie powinny być wyraźnie różnymi, wzajemnie wykluczającymi się możliwościami. „Praca w zawodzie” i „praca poza zawodem” spełniają ten warunek, ale np. „terapia indywidualna online” i „terapia indywidualna stacjonarna” – już niekoniecznie.
Liczebność. Każde równanie ma własne współczynniki, więc liczy się liczebność najmniejszej kategorii. Tu dalszą naukę wybrały 52 osoby, czyli 17.3 osoby na predyktor przy 8 parametrach modelu. Van Smeden i in. (2016) pokazali, że proste reguły typu „10 zdarzeń na zmienną” mają słabe podstawy, a de Jong i in. (2019) wykazali, że model wielomianowy w małych i średnich próbach jest przeuczony i ważna jest zarówno liczba zdarzeń na zmienną, jak i całkowita liczebność. Nie buduj modelu z kilkunastoma predyktorami przy kilkudziesięciu osobach w najmniejszej grupie.
Dopasowanie. Pseudo-R² McFaddena wyniosło .10. Menard (2000) pokazał, że różne analogi R² prowadzą do różnych wniosków, więc podaj jedną miarę i jej nazwę. Tabela klasyfikacji jest tu pouczająca: model trafnie przypisał 58.3% osób, a „model” przypisujący każdemu pracę w zawodzie trafiłby w 58.0%. Dalszą naukę rozpoznał tylko u 15.4% osób, a pracę poza zawodem – u 14.9%. Predyktory są więc wyraźnie związane z planami, ale słabo pozwalają przewidzieć plan konkretnej osoby. To częsta konkluzja – nie ukrywaj jej.
Krok 5. Jak opisać model w pracy (APA)
Podaj kategorię odniesienia, liczebności kategorii, test całego modelu, testy ilorazu wiarygodności dla predyktorów, jedną miarę pseudo-R², a w tabeli – b, SE, p i RRR z 95% CI dla każdego porównania. Wzór tabeli dla modelu binarnego znajdziesz w haśle tabela regresji logistycznej w APA; w modelu wielomianowym dodajesz po prostu blok wierszy dla każdego porównania.
Tabela 1
Wielomianowa regresja logistyczna: predyktory planów po studiach (kategoria odniesienia: praca w zawodzie)
| Predyktor | B | SE | p | RRR | 95% CI dla RRR |
|---|---|---|---|---|---|
| Dalsza nauka (n = 52) | |||||
| Średnia ocen | 0.85 | 0.45 | .059 | 2.34 | [0.97, 5.67] |
| Zainteresowanie badaniami | 0.95 | 0.20 | < .001 | 2.58 | [1.73, 3.85] |
| Praktyki (1 = tak) | −0.22 | 0.34 | .516 | 0.80 | [0.42, 1.56] |
| Praca poza zawodem (n = 74) | |||||
| Średnia ocen | −1.37 | 0.39 | < .001 | 0.25 | [0.12, 0.55] |
| Zainteresowanie badaniami | −0.16 | 0.17 | .367 | 0.86 | [0.61, 1.20] |
| Praktyki (1 = tak) | −0.88 | 0.30 | .004 | 0.41 | [0.23, 0.75] |
Uwaga. N = 300 (dane symulowane); kategoria odniesienia: praca w zawodzie (n = 174). Model: χ2(6) = 55.34, p < .001; R2 McFaddena = .10. Testy ilorazu wiarygodności (2 df): średnia ocen χ2 = 21.25, p < .001; zainteresowanie badaniami χ2 = 28.70, p < .001; praktyki χ2 = 8.93, p = .011. RRR = względny iloraz ryzyka (eB); 95% CI metodą Walda. Stałe pominięto.
Ogólne zasady tabel znajdziesz w poradniku tabele APA – wzory i przykłady, a gotowe zdania do innych analiz – we wpisie jak opisać wyniki w stylu APA. Jeśli Twoja zmienna zależna ma kilka kategorii i nie wiesz, czy wybrać model wielomianowy, porządkowy czy połączyć kategorie, zajrzyj do oferty analiz statystycznych dla studentów – dobierzemy model i wyjaśnimy wyniki tak, abyś umiał(a) ich samodzielnie bronić.
Wielomianowa regresja logistyczna w R
Kod odtwarza wszystkie liczby z tekstu i tabeli. Pobierz plik wielomianowa-regresja-dane-przyklad.csv, zapisz go w katalogu roboczym R i uruchom przepisy po kolei w jednej sesji – przepisy 2 i 3 korzystają z obiektów dane, m0 i m1 z przepisu 1. Potrzebne pakiety: nnet, car i emmeans.
1. Model nnet::multinom, testy ilorazu wiarygodności i RRR
R
# Krok 1–3: opis danych, model wielomianowy (nnet::multinom), testy ilorazu wiarygodności i względne ilorazy ryzyka
options(width = 110)
suppressPackageStartupMessages({ library(nnet); library(car) })
dane <- read.csv("wielomianowa-regresja-dane-przyklad.csv")
dane$plan <- factor(dane$plan, levels = c("zawod", "nauka", "poza"))   # pierwszy poziom = kategoria odniesienia

# Opis: liczebności kategorii i średnie predyktorów w kategoriach
cbind(n = table(dane$plan), proc = round(100 * prop.table(table(dane$plan)), 1))
round(sapply(dane[, c("srednia", "badania", "praktyki")], function(x) c(M = mean(x), SD = sd(x))), 2)
aggregate(cbind(srednia, badania, praktyki) ~ plan, data = dane, FUN = function(x) round(mean(x), 2))

# Model zerowy i pełny; test ilorazu wiarygodności całego modelu
m0 <- multinom(plan ~ 1, data = dane, trace = FALSE)
m1 <- multinom(plan ~ srednia + badania + praktyki, data = dane, trace = FALSE)
anova(m0, m1)

# Test każdego predyktora naraz w obu równaniach (LR, 2 df)
Anova(m1, type = "II")

# Współczynniki b, SE, z, p oraz RRR = exp(b) z 95% CI (Wald)
b <- coef(m1); se <- summary(m1)$standard.errors; z <- b / se
tab <- do.call(rbind, lapply(rownames(b), function(k) data.frame(porownanie = paste(k, "vs zawod"), predyktor = colnames(b),
  b = b[k, ], SE = se[k, ], z = z[k, ], p = 2 * pnorm(-abs(z[k, ])),
  RRR = exp(b[k, ]), dolna = exp(b[k, ] - 1.96 * se[k, ]), gorna = exp(b[k, ] + 1.96 * se[k, ]))))
rownames(tab) <- NULL
cbind(tab[, 1:2], round(tab[, 3:5], 2), p = round(tab$p, 3), round(tab[, 7:9], 2))

# RRR dla wzrostu średniej ocen o 0.5 punktu
round(exp(0.5 * b[, "srednia"]), 2)
Wynik w R
        n proc
zawod 174 58.0
nauka  52 17.3
poza   74 24.7
   srednia badania praktyki
M     4.11    3.07     0.44
SD    0.39    0.88     0.50
   plan srednia badania praktyki
1 zawod    4.14    2.97     0.51
2 nauka    4.23    3.62     0.42
3  poza    3.96    2.92     0.31
                         Model Resid. df Resid. Dev   Test    Df LR stat.     Pr(Chi)
1                            1       598   578.9873           NA       NA          NA
2 srednia + badania + praktyki       592   523.6446 1 vs 2     6 55.34266 3.95264e-10
Analysis of Deviance Table (Type II tests)

Response: plan
         LR Chisq Df Pr(>Chisq)
srednia   21.2521  2  2.428e-05 ***
badania   28.6957  2  5.872e-07 ***
praktyki   8.9327  2    0.01149 *
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
      porownanie   predyktor     b   SE     z     p    RRR dolna   gorna
1 nauka vs zawod (Intercept) -7.79 2.14 -3.64 0.000   0.00  0.00    0.03
2 nauka vs zawod     srednia  0.85 0.45  1.89 0.059   2.34  0.97    5.67
3 nauka vs zawod     badania  0.95 0.20  4.63 0.000   2.58  1.73    3.85
4 nauka vs zawod    praktyki -0.22 0.34 -0.65 0.516   0.80  0.42    1.56
5  poza vs zawod (Intercept)  5.51 1.73  3.19 0.001 248.15  8.40 7334.96
6  poza vs zawod     srednia -1.37 0.39 -3.51 0.000   0.25  0.12    0.55
7  poza vs zawod     badania -0.16 0.17 -0.90 0.367   0.86  0.61    1.20
8  poza vs zawod    praktyki -0.88 0.30 -2.92 0.004   0.41  0.23    0.75
nauka  poza
 1.53  0.50
2. Prawdopodobieństwa przewidywane i przeciętne zmiany prawdopodobieństw
R
# Krok 4: prawdopodobieństwa przewidywane z 95% CI (emmeans, metoda delta) i przeciętne zmiany prawdopodobieństw
options(width = 110)
suppressPackageStartupMessages(library(emmeans))

# Cztery profile: średnia 3.6 lub 4.6, praktyki tak/nie, zainteresowanie badaniami = 3
emmeans(m1, ~ plan | srednia + praktyki, at = list(srednia = c(3.6, 4.6), praktyki = 0:1, badania = 3),
        mode = "prob", df = Inf)

# Przeciętna zmiana prawdopodobieństw w próbie (w punktach procentowych)
pr <- function(d) colMeans(predict(m1, newdata = d, type = "probs"))
round(100 * rbind(
  praktyki_0_na_1 = pr(transform(dane, praktyki = 1)) - pr(transform(dane, praktyki = 0)),
  srednia_plus_05 = pr(transform(dane, srednia = srednia + 0.5)) - pr(dane),
  badania_plus_1  = pr(transform(dane, badania = badania + 1)) - pr(dane)), 1)
Wynik w R
srednia = 3.6, praktyki = 0:
 plan    prob     SE  df asymp.LCL asymp.UCL
 zawod 0.4413 0.0579 Inf    0.3277     0.555
 nauka 0.0668 0.0233 Inf    0.0212     0.113
 poza  0.4919 0.0609 Inf    0.3726     0.611

srednia = 4.6, praktyki = 0:
 plan    prob     SE  df asymp.LCL asymp.UCL
 zawod 0.6107 0.0540 Inf    0.5048     0.717
 nauka 0.2167 0.0487 Inf    0.1212     0.312
 poza  0.1726 0.0398 Inf    0.0945     0.251

srednia = 3.6, praktyki = 1:
 plan    prob     SE  df asymp.LCL asymp.UCL
 zawod 0.6313 0.0580 Inf    0.5176     0.745
 nauka 0.0768 0.0271 Inf    0.0238     0.130
 poza  0.2919 0.0568 Inf    0.1806     0.403

srednia = 4.6, praktyki = 1:
 plan    prob     SE  df asymp.LCL asymp.UCL
 zawod 0.7131 0.0527 Inf    0.6098     0.816
 nauka 0.2033 0.0498 Inf    0.1056     0.301
 poza  0.0836 0.0261 Inf    0.0324     0.135

Degrees-of-freedom method: user-specified
Confidence level used: 0.95
                zawod nauka  poza
praktyki_0_na_1  14.0  -0.1 -13.9
srednia_plus_05   2.6   8.2 -10.8
badania_plus_1   -9.4  15.5  -6.1
3. Ocena modelu, inna kategoria odniesienia i liczebność
R
# Krok 5: pseudo-R², klasyfikacja, zmiana kategorii odniesienia i liczba osób na parametr
options(width = 110)

# Pseudo-R² McFaddena
round(c(McFadden = 1 - as.numeric(logLik(m1)) / as.numeric(logLik(m0))), 3)

# Tabela klasyfikacji (kategoria o najwyższym przewidywanym prawdopodobieństwie)
pred <- predict(m1, type = "class")
table(przewidywane = pred, obserwowane = dane$plan)
round(100 * c(trafnosc = mean(pred == dane$plan), bez_modelu = max(prop.table(table(dane$plan)))), 1)
round(100 * tapply(pred == dane$plan, dane$plan, mean), 1)          # trafność w każdej kategorii

# Porównanie, którego nie ma w wydruku: dalsza nauka vs praca poza zawodem (inna kategoria odniesienia)
m1_poza <- multinom(plan ~ srednia + badania + praktyki, data = transform(dane, plan = relevel(plan, ref = "poza")), trace = FALSE)
bb <- coef(m1_poza)["nauka", ]; ss <- summary(m1_poza)$standard.errors["nauka", ]
round(cbind(b = bb, SE = ss, p = 2 * pnorm(-abs(bb / ss)), RRR = exp(bb), dolna = exp(bb - 1.96 * ss), gorna = exp(bb + 1.96 * ss)), 3)
# Model jest ten sam – zmienia się tylko parametryzacja
round(c(dewiancja_ref_zawod = deviance(m1), dewiancja_ref_poza = deviance(m1_poza)), 2)

# Liczba osób w najmniejszej kategorii na liczbę predyktorów w równaniu
c(najmniejsza_kategoria = min(table(dane$plan)), predyktory = 3, na_predyktor = round(min(table(dane$plan)) / 3, 1),
  parametry_modelu = length(coef(m1)))
Wynik w R
McFadden
   0.096
            obserwowane
przewidywane zawod nauka poza
       zawod   156    43   63
       nauka    10     8    0
       poza      8     1   11
  trafnosc bez_modelu
      58.3       58.0
zawod nauka  poza
 89.7  15.4  14.9
                  b    SE     p   RRR dolna  gorna
(Intercept) -13.309 2.499 0.000 0.000 0.000  0.000
srednia       2.224 0.536 0.000 9.240 3.230 26.432
badania       1.103 0.239 0.000 3.012 1.887  4.810
praktyki      0.661 0.405 0.103 1.937 0.876  4.286
dewiancja_ref_zawod  dewiancja_ref_poza
             523.64              523.64
najmniejsza_kategoria            predyktory          na_predyktor      parametry_modelu
                 52.0                   3.0                  17.3                   8.0
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nnet (wersja 7.3.20): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- emmeans (wersja 2.0.2): Lenth, R. V., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means [R package]. https://doi.org/10.32614/CRAN.package.emmeans
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy w wielomianowej regresji logistycznej
- Seria osobnych regresji binarnych zamiast jednego modelu. Osobne modele na różnych podzbiorach dają przewidywane prawdopodobieństwa, które nie sumują się do 1, i mniej efektywne oszacowania.
- Ocena predyktora po jednym p z wydruku. O istotności predyktora decyduje test ilorazu wiarygodności dla wszystkich jego współczynników.
- Interpretacja RRR jako zmiany prawdopodobieństwa. RRR dotyczy stosunku dwóch kategorii; prawdopodobieństwa pokaż osobno.
- Niejasna kategoria odniesienia. Zawsze podaj ją w tekście i pod tabelą; programy ustalają ją różnie (w R jest to pierwszy poziom czynnika), więc sprawdź ją w ustawieniach analizy.
- Model wielomianowy dla kategorii uporządkowanych bez powodu. Tracisz informację o porządku; najpierw sprawdź regresję porządkową.
- Za mało osób w najmniejszej kategorii przy wielu predyktorach – szerokie przedziały i przeuczenie.
- Trafność klasyfikacji bez punktu odniesienia. Porównaj ją z odsetkiem najliczniejszej kategorii.
Jeśli nie masz pewności, która analiza pasuje do Twojej zmiennej zależnej, skorzystaj z przewodnika testy statystyczne – przewodnik po wyborze.
Najczęstsze pytania
Czym jest RRR w wielomianowej regresji logistycznej?
RRR (względny iloraz ryzyka) to eb – mnożnik stosunku prawdopodobieństwa danej kategorii do prawdopodobieństwa kategorii odniesienia przy wzroście predyktora o jednostkę. RRR = 2.58 oznacza, że ten stosunek rośnie 2.58 raza. Nie jest to zmiana samego prawdopodobieństwa – tę pokaż osobno jako prawdopodobieństwa przewidywane.
Jak wybrać kategorię odniesienia w regresji wielomianowej?
Wybierz kategorię najliczniejszą albo taką, z którą porównania odpowiadają na Twoje hipotezy, i napisz o tym w pracy. Zmiana kategorii odniesienia nie zmienia dopasowania modelu, tylko sposób zapisu wyników. Porównanie dwóch pozostałych kategorii uzyskasz, dopasowując model ponownie z inną kategorią odniesienia.
Kiedy regresja wielomianowa, a kiedy porządkowa?
Gdy kategorie mają naturalny porządek (np. ocena, stopień nasilenia), zacznij od regresji porządkowej – jest oszczędniejsza i wykorzystuje informację o kolejności. Model wielomianowy wybierz, gdy kategorie są nieuporządkowane albo gdy założenie proporcjonalnych szans jest wyraźnie naruszone i inne modele porządkowe nie pasują.
Co to jest założenie IIA i jak je sprawdzić?
IIA (niezależność od nieistotnych alternatyw) oznacza, że stosunek szans dwóch kategorii nie zależy od istnienia pozostałych. Istnieją testy IIA, np. Hausmana, ale Cheng i Long (2007) wykazali, że ich właściwości w praktyce są niezadowalające. Oceń je merytorycznie: kategorie powinny być wyraźnie odrębnymi, wzajemnie wykluczającymi się możliwościami.
Ile osób potrzeba do wielomianowej regresji logistycznej?
Liczy się liczebność najmniejszej kategorii, bo każde równanie ma własne współczynniki. Sztywne reguły w rodzaju 10 osób na predyktor mają słabe podstawy; de Jong i in. (2019) pokazali, że w małych i średnich próbach model jest przeuczony. W pracy dyplomowej ogranicz liczbę predyktorów i podaj liczebności wszystkich kategorii.
Powiązane hasła
Przeczytaj też
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikRegresja porządkowa krok po kroku
Model proporcjonalnych szans w R: progi, ilorazy szans, prawdopodobieństwa przewidywane, test Branta i tabela APA – na danych do pobrania.
Czytaj →PoradnikTabele APA w pracy z psychologii
Wzory 16 tabel APA z notą — od statystyk opisowych i korelacji po regresję, mediację i CFA — z plikami .docx, rysunkami i opisem wyników w tekście.
Czytaj →Twoja zmienna zależna ma kilka kategorii i nie wiesz, jaki model wybrać?
Dobierzemy model do Twoich danych, przeliczymy wyniki na zrozumiałe prawdopodobieństwa i wyjaśnimy je tak, abyś umiał(a) samodzielnie obronić je przed promotorem.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Cheng, S., & Long, J. S. (2007). Testing for IIA in the multinomial logit model. Sociological Methods & Research, 35(4), 583–600. https://doi.org/10.1177/0049124106292361
- de Jong, V. M. T., Eijkemans, M. J. C., van Calster, B., Timmerman, D., Moons, K. G. M., Steyerberg, E. W., & van Smeden, M. (2019). Sample size considerations and predictive performance of multinomial logistic prediction models. Statistics in Medicine, 38(9), 1601–1619. https://doi.org/10.1002/sim.8063 ● Otwarty dostęp
- Kwak, C., & Clayton-Matthews, A. (2002). Multinomial logistic regression. Nursing Research, 51(6), 404–410. https://doi.org/10.1097/00006199-200211000-00009
- Menard, S. (2000). Coefficients of determination for multiple logistic regression analysis. The American Statistician, 54(1), 17–24. https://doi.org/10.1080/00031305.2000.10474502
- Mood, C. (2010). Logistic regression: Why we cannot do what we think we can do, and what we can do about it. European Sociological Review, 26(1), 67–82. https://doi.org/10.1093/esr/jcp006 ● Otwarty dostęp: pełny tekst
- van Smeden, M., de Groot, J. A. H., Moons, K. G. M., Collins, G. S., Altman, D. G., Eijkemans, M. J. C., & Reitsma, J. B. (2016). No rationale for 1 variable per 10 events criterion for binary logistic regression analysis. BMC Medical Research Methodology, 16(1), Article 163. https://doi.org/10.1186/s12874-016-0267-3 ● Otwarty dostęp
Cytowania BibTeX
@article{cheng2007testing, author={Cheng, Simon and Long, J. Scott}, title={{Testing for IIA in the multinomial logit model}}, journal={Sociological Methods \& Research}, year={2007}, volume={35}, number={4}, pages={583--600}, doi={10.1177/0049124106292361}}@article{dejong2019sample, author={de Jong, Valentijn M. T. and Eijkemans, Marinus J. C. and van Calster, Ben and Timmerman, Dirk and Moons, Karel G. M. and Steyerberg, Ewout W. and van Smeden, Maarten}, title={{Sample size considerations and predictive performance of multinomial logistic prediction models}}, journal={Statistics in Medicine}, year={2019}, volume={38}, number={9}, pages={1601--1619}, doi={10.1002/sim.8063}}@article{kwak2002multinomial, author={Kwak, Chanyeong and Clayton-Matthews, Alan}, title={{Multinomial logistic regression}}, journal={Nursing Research}, year={2002}, volume={51}, number={6}, pages={404--410}, doi={10.1097/00006199-200211000-00009}}@article{menard2000coefficients, author={Menard, Scott}, title={{Coefficients of determination for multiple logistic regression analysis}}, journal={The American Statistician}, year={2000}, volume={54}, number={1}, pages={17--24}, doi={10.1080/00031305.2000.10474502}}@article{mood2010logistic, author={Mood, Carina}, title={{Logistic regression: Why we cannot do what we think we can do, and what we can do about it}}, journal={European Sociological Review}, year={2010}, volume={26}, number={1}, pages={67--82}, doi={10.1093/esr/jcp006}}@article{vansmeden2016no, author={van Smeden, Maarten and de Groot, Joris A. H. and Moons, Karel G. M. and Collins, Gary S. and Altman, Douglas G. and Eijkemans, Marinus J. C. and Reitsma, Johannes B.}, title={{No rationale for 1 variable per 10 events criterion for binary logistic regression analysis}}, journal={BMC Medical Research Methodology}, year={2016}, volume={16}, number={1}, eid={163}, doi={10.1186/s12874-016-0267-3}}