Pięć obrazków zamiast wzorów
Definicję, wzór i zapis APA znajdziesz w haśle regresja logistyczna, a pełną procedurę z założeniami, oceną modelu i klasyfikacją – we wpisie regresja logistyczna krok po kroku. Tu pokazujemy mechanikę modelu na pięciu rysunkach z R: dlaczego prosta nie pasuje do wyniku 0/1, skąd krzywa S, czym logit różni się od prawdopodobieństwa, dlaczego interakcja zależy od skali i co się dzieje, gdy dane są idealnie rozdzielone.
Przykład jest fikcyjny: 150 studentów, tygodniowy czas nauki (0–14 godzin) i zaliczenie egzaminu (1 = zaliczył, 0 = nie). Dane wylosowaliśmy z modelu, w którym logit zaliczenia = −4 + 0.6 × godziny. Ziarno (574) ustaliliśmy raz, bez dobierania pod ładny obraz. Odsetki z symulacji podajemy z błędem Monte Carlo. Przy każdym rysunku znajdziesz: co widać, czego wykres nie pokazuje, podpis do pracy i zdanie do Metody albo Wyników. Ogólne zasady rysowania są we wpisie wykresy w pracy dyplomowej.
Rysunek 1: prosta MNK na wyniku 0/1
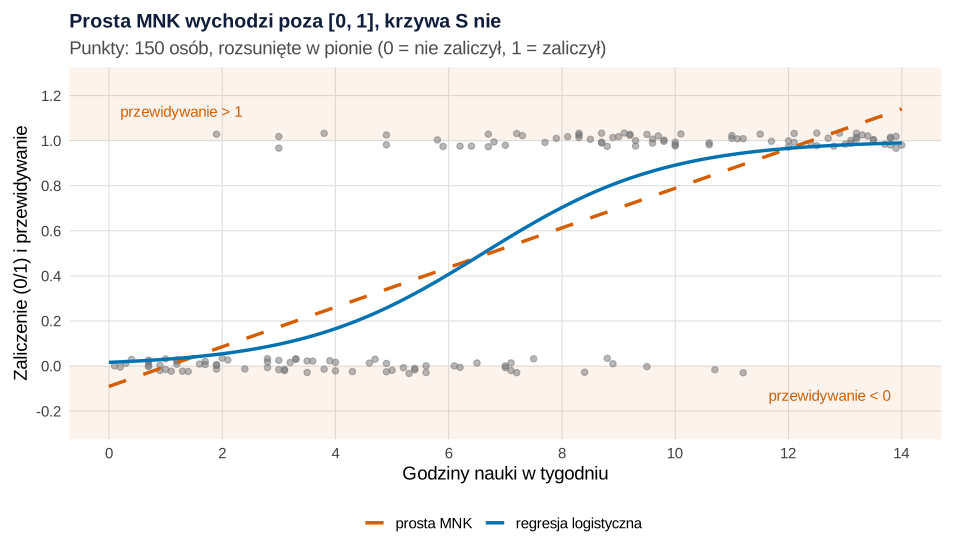
set.seed(574)).Co widać. Wynik ma tylko dwie wartości, więc punkty układają się w dwa pasy (rozsunęliśmy je lekko w pionie, żeby się nie zasłaniały). Egzamin zaliczyło 79 ze 150 osób (52.7%). Prosta dopasowana metodą najmniejszych kwadratów (MNK) mówi: każda godzina nauki to +0.088, czyli 8.8 punktu procentowego. Na krańcach daje jednak przewidywania niemożliwe: −0.091 przy zerze godzin i 1.141 przy 14 godzinach. Takich przewidywań jest 35 na 150 (23.3%): 12 poniżej 0 i 23 powyżej 1. Krzywa logistyczna przy 0 godzin daje .016, a przy 14 – .990. W środku obie metody prawie się zgadzają (przy 7 godzinach .525 i .561).
Czego ten wykres nie pokazuje. Że prosta jest zawsze zła. Przy prawdopodobieństwach w środkowym zakresie liniowy model prawdopodobieństwa daje podobne wnioski, a jego współczynnik czyta się wprost w punktach procentowych. Gomila (2021) zaleca go do szacowania efektu manipulacji eksperymentalnej na wynik binarny. Do przewidywań dla osób o skrajnych wartościach, a także do modelu, który ma być „uczciwy” w całym zakresie, potrzebna jest jednak krzywa ograniczona do przedziału od 0 do 1. Reszty prostej na wyniku 0/1 nie mają też stałej wariancji – to widać w galerii wykresów reszt jako lejek. Skąd się bierze sama prosta MNK, pokazuje wpis metoda najmniejszych kwadratów w obrazkach.
Podpis do pracy (np. w rozdziale uzasadniającym wybór metody):
Zdanie do Metody:
Kod rysunku 1: dane, prosta MNK i model logistyczny
Kod uruchamiaj po kolei w jednej sesji R – kolejne bloki korzystają z obiektów z bloku 1 (dane dane, model m_log, motyw motyw, paleta kol). Rysunki na tej stronie powstały dokładnie z tego kodu: motyw to skrócona wersja motywu serwisu, a pliki zapisano w formacie SVG (w kodzie – zakomentowane wywołanie ggsave()). Dane z rysunków 1–3 pobierzesz też jako plik regresja-logistyczna-godziny-nauki.csv (dane symulowane).
1. Motyw, paleta, 150 osób i dwa modele
R
# Rysunek 1. Zaliczenie egzaminu (0/1) a godziny nauki: prosta MNK i krzywa S (dane fikcyjne, symulowane)
library(ggplot2)

# Motyw i paleta (Okabe–Ito: niebieski, cynober i pomarańczowy są rozróżnialne także przy deuteranopii)
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.05)),
        plot.subtitle = element_text(colour = "grey30"),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        axis.text = element_text(colour = "grey25"), strip.text = element_text(face = "bold", colour = "#0f1d3a"),
        legend.position = "bottom", plot.caption = element_text(colour = "grey30", hjust = 0),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
kol <- c(logit = "#0072B2", mnk = "#D55E00", trzeci = "#E69F00", dane = "grey45")

set.seed(574)                                    # ziarno ustalone raz, bez dobierania pod wynik
n <- 150
godziny <- round(runif(n, 0, 14), 1)              # tygodniowy czas nauki (0–14 godzin)
zaliczenie <- rbinom(n, 1, plogis(-4 + 0.6 * godziny))   # prawdziwy model: logit(p) = −4 + 0.6 × godziny
dane <- data.frame(godziny, zaliczenie)
data.frame(n = n, zaliczylo = sum(zaliczenie), odsetek = round(mean(zaliczenie), 3))

m_mnk <- lm(zaliczenie ~ godziny, data = dane)                       # prosta MNK na wyniku 0/1
m_log <- glm(zaliczenie ~ godziny, family = binomial, data = dane)  # regresja logistyczna
round(coef(m_mnk), 3)
round(summary(m_log)$coefficients, 3)
round(cbind(OR = exp(coef(m_log)), exp(confint(m_log))), 3)   # OR z 95% CI z profilu wiarygodności

# Przewidywania prostej MNK poza przedziałem [0, 1]
p_mnk <- fitted(m_mnk)
c(ponizej_0 = sum(p_mnk < 0), powyzej_1 = sum(p_mnk > 1), razem_proc = round(100 * mean(p_mnk < 0 | p_mnk > 1), 1))
siatka <- data.frame(godziny = c(0, 2, 7, 12, 14))
round(data.frame(siatka, MNK = predict(m_mnk, siatka), logistyczna = predict(m_log, siatka, type = "response")), 3)

krzywe <- data.frame(godziny = seq(0, 14, by = 0.1))
krzywe$MNK <- predict(m_mnk, krzywe)
krzywe$logistyczna <- predict(m_log, krzywe, type = "response")
p1 <- ggplot(dane, aes(godziny, zaliczenie)) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = 1, ymax = Inf, fill = kol[["mnk"]], alpha = 0.08) +
  annotate("rect", xmin = -Inf, xmax = Inf, ymin = -Inf, ymax = 0, fill = kol[["mnk"]], alpha = 0.08) +
  geom_jitter(width = 0, height = 0.035, colour = kol[["dane"]], alpha = 0.5, size = 1.8) +
  geom_line(data = krzywe, aes(y = MNK, linetype = "prosta MNK", colour = "prosta MNK"), linewidth = 1.2) +
  geom_line(data = krzywe, aes(y = logistyczna, linetype = "regresja logistyczna", colour = "regresja logistyczna"), linewidth = 1.2) +
  scale_colour_manual(values = c("prosta MNK" = kol[["mnk"]], "regresja logistyczna" = kol[["logit"]]), name = NULL) +
  scale_linetype_manual(values = c("prosta MNK" = "dashed", "regresja logistyczna" = "solid"), name = NULL) +
  annotate("text", x = 0.2, y = 1.13, label = "przewidywanie > 1", hjust = 0, colour = kol[["mnk"]], size = 4) +
  annotate("text", x = 13.8, y = -0.13, label = "przewidywanie < 0", hjust = 1, colour = kol[["mnk"]], size = 4) +
  scale_x_continuous(breaks = seq(0, 14, 2)) +
  scale_y_continuous(breaks = seq(-0.2, 1.2, 0.2), limits = c(-0.25, 1.25)) +
  labs(x = "Godziny nauki w tygodniu", y = "Zaliczenie (0/1) i przewidywanie",
       title = "Prosta MNK wychodzi poza [0, 1], krzywa S nie",
       subtitle = "Punkty: 150 osób, rozsunięte w pionie (0 = nie zaliczył, 1 = zaliczył)") + motyw
# p1   # wyświetl; zapis: ggsave("regresja-logistyczna-prosta-mnk-a-krzywa-s.svg", p1, width = 10, height = 5.8)
Wynik w R
    n zaliczylo odsetek
1 150        79   0.527
(Intercept)     godziny
     -0.091       0.088
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   -4.097      0.673  -6.083        0
godziny        0.620      0.094   6.608        0
               OR 2.5 % 97.5 %
(Intercept) 0.017 0.004  0.055
godziny     1.859 1.575  2.284
 ponizej_0  powyzej_1 razem_proc
      12.0       23.0       23.3
  godziny    MNK logistyczna
1       0 -0.091       0.016
2       2  0.085       0.054
3       7  0.525       0.561
4      12  0.965       0.966
5      14  1.141       0.990
Rysunek 2: krzywa S i odsetki zaliczeń w przedziałach
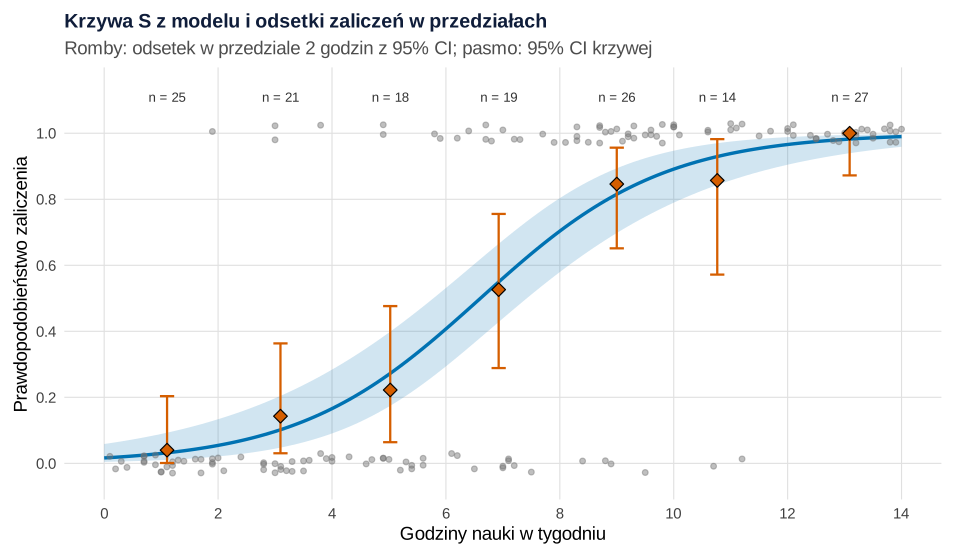
Co widać. Pojedyncze punkty 0/1 niewiele mówią, dopóki nie policzysz, jaka część osób zaliczyła w wąskim przedziale czasu nauki. Tak robią romby: przy 0–2 godzinach zaliczyła 1 osoba na 25 (4.0%), przy 6–8 godzinach 10 na 19 (52.6%, 95% CI [28.9, 75.6]), a przy 12–14 godzinach wszystkie 27 osób. Krzywa S z modelu przechodzi przez te odsetki, a średnie przewidywanie w każdym przedziale (od .034 do .981) leży wewnątrz przedziału ufności odsetka. Model przewiduje przy 2 godzinach .054, 95% CI [.021, .134], przy 7 godzinach .561, 95% CI [.439, .676], przy 12 godzinach .966, 95% CI [.905, .988]. Pasmo jest najszersze w środku: tam ta sama niepewność w skali logitu przekłada się na największy rozrzut prawdopodobieństw.
Czego ten wykres nie pokazuje i jak może zmylić. Granice przedziałów wybrałeś Ty. Inne cięcie (np. co 3 godziny) da inne romby, a przy 14–27 osobach w przedziale ich przedziały ufności są szerokie. To szybki, wzrokowy test, czy krzywa S w ogóle pasuje, a nie formalna ocena dopasowania. Na podobnym grupowaniu opiera się test Hosmera–Lemeshowa, a dokładniej dopasowanie sprawdza wykres kalibracji modelu. Gdy romby układają się w łuk wokół krzywej, zależność w skali logitu może nie być liniowa (wtedy dodaj np. składnik kwadratowy albo splajn).
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 2: krzywa S z pasmem i odsetki w przedziałach
2. Odsetki w przedziałach i przedział ufności krzywej
R
# Rysunek 2. Krzywa S z przedziałem ufności, punktami i odsetkami zaliczeń w przedziałach godzin (kontynuacja: dane, m_log, kol, motyw)
library(ggplot2)

# Odsetek zaliczeń w siedmiu przedziałach po 2 godziny i dokładny (Cloppera–Pearsona) 95% CI
dane$przedzial <- cut(dane$godziny, breaks = seq(0, 14, 2), include.lowest = TRUE, right = FALSE)
przedzialy <- do.call(rbind, lapply(split(dane, dane$przedzial), function(d) {
  ci <- binom.test(sum(d$zaliczenie), nrow(d))$conf.int
  data.frame(srodek = mean(d$godziny), n = nrow(d), zaliczylo = sum(d$zaliczenie),
             odsetek = mean(d$zaliczenie), dolna = ci[1], gorna = ci[2],
             model = mean(predict(m_log, d, type = "response")))   # średnie przewidywanie modelu w przedziale
}))
round(przedzialy, 3)

# Krzywa z 95% CI: przedział liczony na skali logitu i przekształcony funkcją plogis()
krzywa <- data.frame(godziny = seq(0, 14, by = 0.1))
pr <- predict(m_log, krzywa, type = "link", se.fit = TRUE)
krzywa$p <- plogis(pr$fit); krzywa$dolna <- plogis(pr$fit - 1.96 * pr$se.fit); krzywa$gorna <- plogis(pr$fit + 1.96 * pr$se.fit)
round(krzywa[krzywa$godziny %in% c(2, 7, 12), ], 3)

p2 <- ggplot() +
  geom_ribbon(data = krzywa, aes(godziny, ymin = dolna, ymax = gorna), fill = kol[["logit"]], alpha = 0.18) +
  geom_line(data = krzywa, aes(godziny, p), colour = kol[["logit"]], linewidth = 1.2) +
  geom_jitter(data = dane, aes(godziny, zaliczenie), width = 0, height = 0.03, colour = kol[["dane"]], alpha = 0.45, size = 1.6) +
  geom_errorbar(data = przedzialy, aes(srodek, ymin = dolna, ymax = gorna), width = 0.25, colour = kol[["mnk"]], linewidth = 0.8) +
  geom_point(data = przedzialy, aes(srodek, odsetek), shape = 23, size = 3.4, fill = kol[["mnk"]], colour = "black") +
  geom_text(data = przedzialy, aes(srodek, 1.11, label = paste0("n = ", n)), size = 3.5, colour = "grey20") +   # liczebność nad przedziałem
  scale_x_continuous(breaks = seq(0, 14, 2)) +
  scale_y_continuous(breaks = seq(0, 1, 0.2), limits = c(-0.05, 1.14)) +
  labs(x = "Godziny nauki w tygodniu", y = "Prawdopodobieństwo zaliczenia",
       title = "Krzywa S z modelu i odsetki zaliczeń w przedziałach",
       subtitle = "Romby: odsetek w przedziale 2 godzin z 95% CI; pasmo: 95% CI krzywej") + motyw
# p2   # zapis: ggsave("regresja-logistyczna-krzywa-s-i-odsetki.svg", p2, width = 10, height = 5.8)
Wynik w R
        srodek  n zaliczylo odsetek dolna gorna model
[0,2)    1.104 25         1   0.040 0.001 0.204 0.034
[2,4)    3.095 21         3   0.143 0.030 0.363 0.105
[4,6)    5.022 18         4   0.222 0.064 0.476 0.278
[6,8)    6.926 19        10   0.526 0.289 0.756 0.548
[8,10)   9.000 26        22   0.846 0.651 0.956 0.811
[10,12) 10.764 14        12   0.857 0.572 0.982 0.926
[12,14] 13.089 27        27   1.000 0.872 1.000 0.981
    godziny     p dolna gorna
21        2 0.054 0.021 0.134
71        7 0.561 0.439 0.676
121      12 0.966 0.905 0.988
Rysunek 3: logit – prosta, prawdopodobieństwo – krzywa S
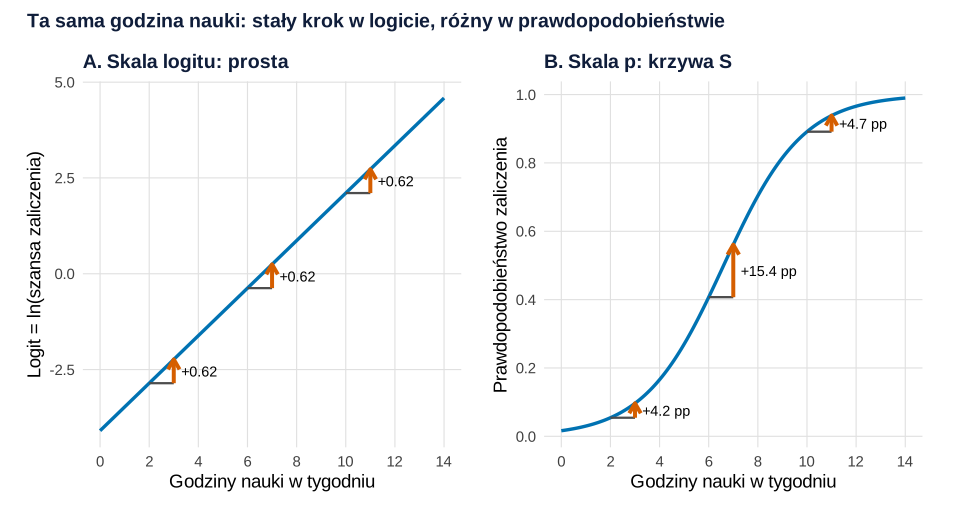
Co widać. Model logistyczny jest liniowy, tylko nie w prawdopodobieństwie. W skali logitu, czyli logarytmu szansy (transformacja logitowa), mamy prostą: każda godzina dodaje b = 0.62, wszędzie tyle samo. Po przeliczeniu na szanse to stały mnożnik, iloraz szans OR = 1.86, 95% CI [1.58, 2.28]. Funkcja logistyczna wygina tę prostą w literę S. Ten sam krok daje więc +4.2 punktu procentowego między 2 a 3 godzinami (z .054 do .097), +15.4 punktu między 6 a 7 godzinami (z .407 do .561) i tylko +4.7 punktu między 10 a 11 godzinami (z .891 do .938). Krzywa jest najbardziej stroma przy prawdopodobieństwie .5, tu przy 6.61 godzinach. Nachylenie wynosi tam b/4 = 15.5 punktu procentowego na godzinę – to górna granica z reguły „dzielenia przez 4”.
Czego ten wykres nie pokazuje. Przy kilku predyktorach to, „gdzie na krzywej” jest osoba, zależy od wszystkich jej wartości. Ta sama godzina nauki znaczy więcej u osoby, której pozostałe cechy dają szansę bliską .5. Jedną liczbę w punktach procentowych daje przeciętny efekt krańcowy (AME). Krzywe dla kilku profili z przedziałami ufności rysuje wpis wynik regresji na wykresie – tu ich nie powtarzamy. Pamiętaj też, że współczynniki logitowe zmieniają się po dodaniu do modelu innych zmiennych, nawet nieskorelowanych z predyktorem. Dlatego nie porównuj wprost OR z różnych modeli ani grup (Mood, 2010).
Podpis do pracy:
Zdanie do Wyników:
Kod rysunku 3: dwie skale, trzy kroki o jedną godzinę
3. Logit, prawdopodobieństwo i reguła dzielenia przez 4
R
# Rysunek 3. Ten sam model w skali logitu (prosta) i prawdopodobieństwa (krzywa S); krok +1 godzina w trzech miejscach
# (kontynuacja: m_log, kol, motyw)
library(ggplot2)
library(patchwork)

a <- coef(m_log)[[1]]; b <- coef(m_log)[[2]]
kroki <- data.frame(od = c(2, 6, 10))
kroki$do <- kroki$od + 1
kroki$logit_od <- a + b * kroki$od; kroki$logit_do <- a + b * kroki$do
kroki$p_od <- plogis(kroki$logit_od); kroki$p_do <- plogis(kroki$logit_do)
kroki$roznica_pp <- 100 * (kroki$p_do - kroki$p_od)                       # zmiana prawdopodobieństwa w pp
kroki$OR <- (kroki$p_do / (1 - kroki$p_do)) / (kroki$p_od / (1 - kroki$p_od))   # iloraz szans za +1 godzinę
round(kroki, 3)

# Gdzie krzywa jest najbardziej stroma: p = .5, czyli godziny = −a/b; tam nachylenie = b/4 ("reguła dzielenia przez 4")
round(c(godziny_p_050 = -a / b, nachylenie_max_pp = 100 * b / 4, OR = exp(b)), 3)

siatka <- data.frame(godziny = seq(0, 14, by = 0.1))
siatka$logit <- a + b * siatka$godziny; siatka$p <- plogis(siatka$logit)
kroki$etykieta <- sprintf("%+.1f pp", kroki$roznica_pp)
kroki$etykieta_logit <- sprintf("%+.2f", kroki$logit_do - kroki$logit_od)

p3a <- ggplot(siatka, aes(godziny, logit)) +
  geom_line(colour = kol[["logit"]], linewidth = 1.2) +
  geom_segment(data = kroki, aes(x = od, xend = do, y = logit_od, yend = logit_od), colour = "grey30", linewidth = 0.8) +
  geom_segment(data = kroki, aes(x = do, xend = do, y = logit_od, yend = logit_do), colour = kol[["mnk"]], linewidth = 1.4,
               arrow = arrow(length = unit(0.12, "inches"))) +
  geom_text(data = kroki, aes(x = do + 0.3, y = (logit_od + logit_do) / 2, label = etykieta_logit), hjust = 0, size = 3.8) +
  scale_x_continuous(breaks = seq(0, 14, 2)) +
  labs(x = "Godziny nauki w tygodniu", y = "Logit = ln(szansa zaliczenia)", title = "A. Skala logitu: prosta") + motyw
p3b <- ggplot(siatka, aes(godziny, p)) +
  geom_line(colour = kol[["logit"]], linewidth = 1.2) +
  geom_segment(data = kroki, aes(x = od, xend = do, y = p_od, yend = p_od), colour = "grey30", linewidth = 0.8) +
  geom_segment(data = kroki, aes(x = do, xend = do, y = p_od, yend = p_do), colour = kol[["mnk"]], linewidth = 1.4,
               arrow = arrow(length = unit(0.12, "inches"))) +
  geom_text(data = kroki, aes(x = do + 0.3, y = (p_od + p_do) / 2, label = etykieta), hjust = 0, size = 3.8) +
  scale_x_continuous(breaks = seq(0, 14, 2)) + scale_y_continuous(breaks = seq(0, 1, 0.2)) +
  labs(x = "Godziny nauki w tygodniu", y = "Prawdopodobieństwo zaliczenia", title = "B. Skala p: krzywa S") + motyw
p3 <- p3a + p3b + plot_annotation(title = "Ta sama godzina nauki: stały krok w logicie, różny w prawdopodobieństwie",
                                  theme = motyw)
# p3   # zapis: ggsave("regresja-logistyczna-logit-i-prawdopodobienstwo.svg", p3, width = 10, height = 5.4)
Wynik w R
  od do logit_od logit_do  p_od  p_do roznica_pp    OR
1  2  3   -2.856   -2.236 0.054 0.097      4.219 1.859
2  6  7   -0.376    0.244 0.407 0.561     15.364 1.859
3 10 11    2.105    2.725 0.891 0.938      4.711 1.859
    godziny_p_050 nachylenie_max_pp                OR
            6.606            15.503             1.859
Rysunek 4: interakcja zależy od skali
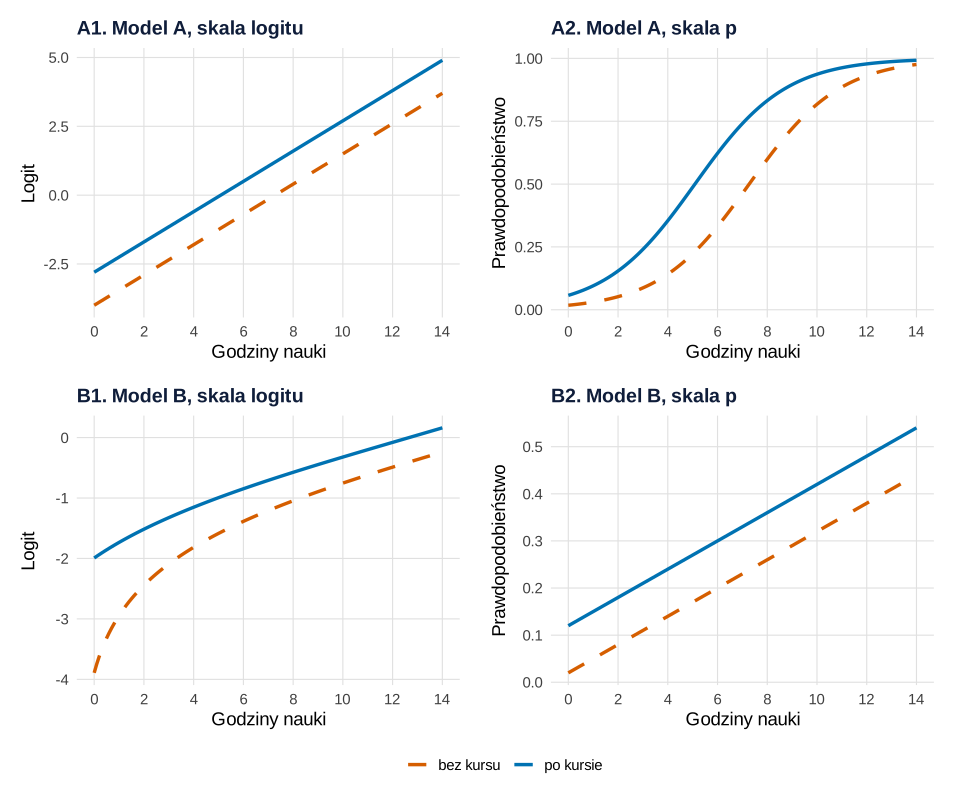
Co widać. Dodajemy drugi predyktor: kurs przygotowawczy (tak/nie). W modelu A kurs przesuwa logit o stałe 1.20 – w skali logitu proste są równoległe, więc interakcji nie ma. W skali prawdopodobieństwa różnica „po kursie − bez kursu” wynosi jednak 10.2 punktu procentowego przy 2 godzinach, 27.8 przy 7 i 4.7 przy 12 godzinach. W modelu B jest odwrotnie: kurs dodaje stałe 10 punktów procentowych, a w skali logitu różnica maleje z 0.93 do 0.50 i 0.41. Brak interakcji w jednej skali oznacza więc interakcję w drugiej (wyjątkiem jest sytuacja, gdy jeden z czynników nie ma żadnego efektu). Sprawdziliśmy to symulacją: 1000 prób po 1000 osób z każdego modelu, test członu godziny × kurs na poziomie .05. W modelu A test w regresji logistycznej dał wynik istotny w 4.8% prób (błąd Monte Carlo 0.7 pp), czyli tyle, ile powinien. Ten sam człon w regresji liniowej na wyniku 0/1 – w 13.2% (1.1 pp). W modelu B test w regresji logistycznej „znalazł” interakcję w 17.7% prób (1.2 pp), a w liniowej – w 5.3% (0.7 pp).
Czego ten wykres nie pokazuje. Który model jest prawdziwy – tego rysunek nie rozstrzygnie, bo to pytanie o skalę, w której formułujesz hipotezę. Jeśli pytasz, czy kurs pomaga bardziej osobom uczącym się mało w sensie szans zaliczenia, testujesz człon iloczynowy w logicie. Jeśli pytasz o punkty procentowe, oceniasz różnicę różnic przewidywanych prawdopodobieństw. McCabe i in. (2022) pokazują, że w regresji logistycznej efekt interakcji w skali prawdopodobieństwa nie jest równy współczynnikowi iloczynu i zależy od wartości predyktorów. Proponują liczyć go jako zmianę efektu brzegowego. Ogólnie o interakcji pisze hasło efekt interakcji.
Podpis do pracy:
Zdanie do Metody:
Kod rysunku 4: dwa modele i test interakcji w dwóch skalach
4. Model A i model B, 1000 powtórzeń testu iloczynu
R
# Rysunek 4. Interakcja zależy od skali: równoległe proste w logicie i równoległe linie w p to dwa różne modele
# (kontynuacja: kol, motyw; dwa fikcyjne modele populacyjne + symulacja testu interakcji)
library(ggplot2)
library(patchwork)

# Model A: kurs przesuwa logit o stałe 1.2 (brak interakcji w skali logitu)
pA <- function(godz, kurs) plogis(-4 + 0.55 * godz + 1.2 * kurs)
# Model B: kurs dodaje stałe 10 punktów procentowych (brak interakcji w skali prawdopodobieństwa)
pB <- function(godz, kurs) 0.02 + 0.03 * godz + 0.10 * kurs
logit <- function(p) log(p / (1 - p))           # to samo co qlogis(p)

# Różnica „po kursie − bez kursu” przy 2, 7 i 12 godzinach – w logicie i w punktach procentowych
roznice <- do.call(rbind, lapply(c("A", "B"), function(s) {
  f <- if (s == "A") pA else pB; g <- c(2, 7, 12)
  data.frame(model = s, godz = g, p_bez = f(g, 0), p_po = f(g, 1),
             roznica_logit = logit(f(g, 1)) - logit(f(g, 0)), roznica_pp = 100 * (f(g, 1) - f(g, 0)))
}))
roznice[, 3:6] <- round(roznice[, 3:6], 3); roznice

# Symulacja: jak często test iloczynu godz × kurs daje p < .05, gdy w danej skali interakcji NIE ma
set.seed(574)
R4 <- 1000; n4 <- 1000                           # 1000 powtórzeń, po 1000 osób (500 w grupie)
odrzucenia <- replicate(R4, {
  kurs <- rep(0:1, each = n4 / 2); godz <- runif(n4, 0, 14)
  yA <- rbinom(n4, 1, pA(godz, kurs)); yB <- rbinom(n4, 1, pB(godz, kurs))
  c(A_logit_glm = summary(glm(yA ~ godz * kurs, family = binomial))$coefficients["godz:kurs", 4],
    A_p_lm      = summary(lm(yA ~ godz * kurs))$coefficients["godz:kurs", 4],
    B_logit_glm = summary(glm(yB ~ godz * kurs, family = binomial))$coefficients["godz:kurs", 4],
    B_p_lm      = summary(lm(yB ~ godz * kurs))$coefficients["godz:kurs", 4]) < .05
})
odsetek <- rowMeans(odrzucenia)
round(data.frame(odsetek_p_ponizej_05_proc = 100 * odsetek, blad_MC_pp = 100 * sqrt(odsetek * (1 - odsetek) / R4)), 1)

siatka <- expand.grid(godz = seq(0, 14, by = 0.1), kurs = 0:1)
krzywe <- rbind(data.frame(siatka, model = "A", p = pA(siatka$godz, siatka$kurs)),
                data.frame(siatka, model = "B", p = pB(siatka$godz, siatka$kurs)))
krzywe$logit <- logit(krzywe$p)
krzywe$grupa <- factor(krzywe$kurs, 0:1, c("bez kursu", "po kursie"))

rysuj <- function(s, skala, tytul) {
  ggplot(krzywe[krzywe$model == s, ], aes(godz, .data[[skala]], colour = grupa, linetype = grupa)) +
    geom_line(linewidth = 1.2) +
    scale_colour_manual(values = c("bez kursu" = kol[["mnk"]], "po kursie" = kol[["logit"]]), name = NULL) +
    scale_linetype_manual(values = c("bez kursu" = "dashed", "po kursie" = "solid"), name = NULL) +
    scale_x_continuous(breaks = seq(0, 14, 2)) +
    labs(x = "Godziny nauki", y = if (skala == "p") "Prawdopodobieństwo" else "Logit", title = tytul) + motyw
}
p4 <- (rysuj("A", "logit", "A1. Model A, skala logitu") + rysuj("A", "p", "A2. Model A, skala p") +
       rysuj("B", "logit", "B1. Model B, skala logitu") + rysuj("B", "p", "B2. Model B, skala p")) +
  plot_layout(ncol = 2, guides = "collect") & theme(legend.position = "bottom")
# p4   # zapis: ggsave("regresja-logistyczna-interakcja-skala.svg", p4, width = 10, height = 8.4)
Wynik w R
  model godz p_bez  p_po roznica_logit roznica_pp
1     A    2 0.052 0.154         1.200     10.231
2     A    7 0.463 0.741         1.200     27.820
3     A   12 0.931 0.978         1.200      4.726
4     B    2 0.080 0.180         0.926     10.000
5     B    7 0.230 0.330         0.500     10.000
6     B   12 0.380 0.480         0.410     10.000
            odsetek_p_ponizej_05_proc blad_MC_pp
A_logit_glm                       4.8        0.7
A_p_lm                           13.2        1.1
B_logit_glm                      17.7        1.2
B_p_lm                            5.3        0.7
Rysunek 5: separacja – wiarygodność bez szczytu
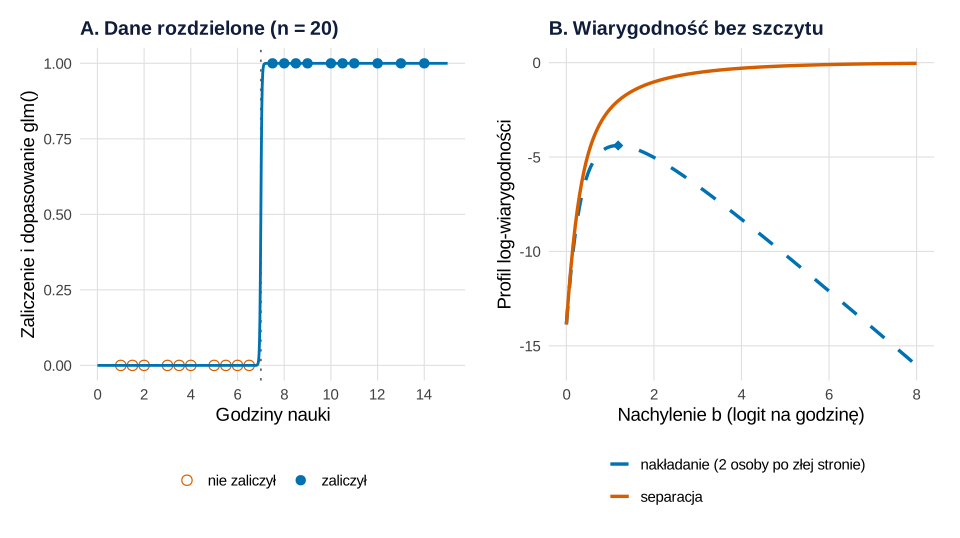
Co widać. W małej grupie 20 osób nikt, kto uczył się mniej niż 7 godzin, nie zaliczył, a zaliczyli wszyscy powyżej tej granicy. To separacja całkowita. Model idealnie rozdzielający grupy to pionowy schodek, a krzywa S może się do niego zbliżać tylko przez coraz większe nachylenie. Prawy panel pokazuje, dlaczego tak się dzieje. Metoda największej wiarygodności szuka szczytu log-wiarygodności, a przy separacji szczytu nie ma: przy b = 1, 2, 4 i 8 profil wynosi −2.45, −1.02, −0.30 i −0.04 i rośnie dalej w stronę zera. Wystarczy przestawić dwie osoby „na złą stronę” granicy, a szczyt się pojawia (b = 1.18, SE = 0.57, p = .039). Albert i Anderson (1984) wyróżnili trzy układy danych: separację całkowitą, quasi-całkowitą i nakładanie się – skończone oszacowania istnieją tylko w ostatnim.
Funkcja glm() zatrzymała się po 25 iteracjach z ostrzeżeniami o braku zbieżności i o dopasowanych prawdopodobieństwach równych 0 lub 1. Zwróciła b = 42.44 przy SE = 34 764.41 i p = .999 w teście Walda – to objawy, a nie wynik. Pakiet detectseparation potwierdził, że oba oszacowania są nieskończone. Ten sam związek w teście ilorazu wiarygodności jest bardzo silny: dewiancja spada z 27.73 do zera, χ²(1) = 27.73, p < .001. Heinze i Schemper (2002) piszą, że separacja zdarza się głównie w małych próbach. Jako rozwiązanie proponują ukaraną wiarygodność (regresję Firtha), a zamiast testów Walda – testy ilorazu wiarygodności i profilowe przedziały ufności. Tu kara Firtha dała b = 1.52, SE = 0.80.
Czy separacja to tylko „sztuczny” przykład? W symulacji 10 000 prób z prawdziwego modelu z rysunku 1 przypadkowa separacja wystąpiła w 40.19% prób po 10 osób (błąd Monte Carlo 0.49 pp) i w 9.84% prób po 20 osób (0.30 pp). Przy 40 osobach odsetek spadł do 0.36% (0.06 pp), a przy 80 nie zdarzyła się ani razu.
Czego ten wykres nie pokazuje. Przy kilku predyktorach separację może dawać ich kombinacja, niewidoczna na wykresie jednej zmiennej. Częściej spotkasz separację quasi-całkowitą, np. zero w jednej komórce tabeli predyktora kategorialnego. Przykład z kursem i reguły postępowania są w haśle o separacji. Nie usuwaj predyktora tylko dlatego, że „psuje” model: zwykle jest najsilniejszy. Planuj liczebność z wyprzedzeniem, z myślą o liczbie zdarzeń na predyktor (EPV).
Podpis do pracy:
Zdanie do Metody/Wyników:
Kod rysunku 5: separacja, profil wiarygodności i symulacja
5. glm przy separacji, detectseparation, kara Firtha i profil log-wiarygodności
R
# Rysunek 5. Separacja: w małej grupie nikt poniżej 7 godzin nie zaliczył, a wszyscy powyżej zaliczyli
# (kontynuacja: kol, motyw; dane fikcyjne wpisane ręcznie)
library(ggplot2)
library(patchwork)

godz5 <- c(1.0, 1.5, 2.0, 3.0, 3.5, 4.0, 5.0, 5.5, 6.0, 6.5, 7.5, 8.0, 8.5, 9.0, 10.0, 10.5, 11.0, 12.0, 13.0, 14.0)
sep <- data.frame(godz = godz5, y = rep(0:1, each = 10))          # separacja całkowita: rozdział przy 7 godzinach
nak <- sep; nak$y[nak$godz == 6.0] <- 1; nak$y[nak$godz == 8.0] <- 0   # te same godziny, dwie osoby „po złej stronie”

# glm przy separacji: zbierz ostrzeżenia zamiast je wyświetlać
ostrzezenia <- character()
m_sep <- withCallingHandlers(glm(y ~ godz, family = binomial, data = sep),
  warning = function(w) { ostrzezenia <<- c(ostrzezenia, conditionMessage(w)); invokeRestart("muffleWarning") })
ostrzezenia
data.frame(iteracje = m_sep$iter, zbiezny = m_sep$converged)
round(summary(m_sep)$coefficients, 3)
m_nak <- glm(y ~ godz, family = binomial, data = nak)
round(summary(m_nak)$coefficients, 3)

# Test ilorazu wiarygodności działa: dewiancja spada niemal do zera
anova(m_sep, test = "LRT")

# Wykrycie separacji (pakiet detectseparation) i oszacowanie z karą Firtha (pakiet brglm2)
glm(y ~ godz, family = binomial, data = sep, method = detectseparation::detect_separation)
m_firth <- glm(y ~ godz, family = binomial, data = sep, method = brglm2::brglmFit, type = "AS_mean")
round(summary(m_firth)$coefficients, 3)

# Profil log-wiarygodności: dla każdego nachylenia b najlepszy wyraz wolny, potem maksimum logL
profil <- function(d, b) {
  ll <- function(a) { eta <- a + b * d$godz                         # log p i log(1 − p) liczone stabilnie
    sum(d$y * plogis(eta, log.p = TRUE) + (1 - d$y) * plogis(-eta, log.p = TRUE)) }
  optimize(ll, c(-200, 50), maximum = TRUE)$objective
}
b_siatka <- seq(0, 8, by = 0.05)
prof <- rbind(data.frame(dane = "separacja", b = b_siatka, logL = sapply(b_siatka, profil, d = sep)),
              data.frame(dane = "nakładanie", b = b_siatka, logL = sapply(b_siatka, profil, d = nak)))
round(sapply(c(1, 2, 4, 8), profil, d = sep), 4)    # logL przy b = 1, 2, 4, 8: rośnie bez końca w stronę 0
round(c(b_max_nakladanie = coef(m_nak)[[2]], logL_max = as.numeric(logLik(m_nak))), 3)

# Symulacja: jak często separacja pojawia się przypadkiem w małej próbie z prawdziwego modelu z rysunku 1
set.seed(574)
R5 <- 10000
czy_separacja <- function(x, y) all(y == y[1]) || max(x[y == 0]) <= min(x[y == 1]) || max(x[y == 1]) <= min(x[y == 0])
odsetek_sep <- sapply(c(10, 20, 40, 80), function(k) mean(replicate(R5, {
  x <- runif(k, 0, 14); czy_separacja(x, rbinom(k, 1, plogis(-4 + 0.6 * x))) })))
round(data.frame(n = c(10, 20, 40, 80), separacja_proc = 100 * odsetek_sep,
                 blad_MC_pp = 100 * sqrt(odsetek_sep * (1 - odsetek_sep) / R5)), 2)

p5a <- ggplot(sep, aes(godz, y)) +
  geom_vline(xintercept = 7, linetype = "dotted", colour = "grey40") +
  geom_point(aes(shape = factor(y), colour = factor(y)), size = 3.2) +
  geom_line(data = data.frame(godz = seq(0, 15, 0.02)), aes(godz, plogis(coef(m_sep)[1] + coef(m_sep)[2] * godz)),
            colour = kol[["logit"]], linewidth = 1) +
  scale_shape_manual(values = c(`0` = 1, `1` = 16), labels = c("nie zaliczył", "zaliczył"), name = NULL) +
  scale_colour_manual(values = c(`0` = kol[["mnk"]], `1` = kol[["logit"]]), labels = c("nie zaliczył", "zaliczył"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 14, 2)) +
  labs(x = "Godziny nauki", y = "Zaliczenie i dopasowanie glm()", title = "A. Dane rozdzielone (n = 20)") + motyw
p5b <- ggplot(prof, aes(b, logL, colour = dane, linetype = dane)) +
  geom_line(linewidth = 1.2) +
  geom_point(data = data.frame(dane = "nakładanie", b = coef(m_nak)[[2]], logL = as.numeric(logLik(m_nak))),
             size = 3.2, shape = 18, show.legend = FALSE) +
  scale_colour_manual(values = c(separacja = kol[["mnk"]], `nakładanie` = kol[["logit"]]),
                      labels = c("nakładanie (2 osoby po złej stronie)", "separacja"), name = NULL) +
  scale_linetype_manual(values = c(separacja = "solid", `nakładanie` = "dashed"),
                        labels = c("nakładanie (2 osoby po złej stronie)", "separacja"), name = NULL) +
  guides(colour = guide_legend(ncol = 1), linetype = guide_legend(ncol = 1)) +
  labs(x = "Nachylenie b (logit na godzinę)", y = "Profil log-wiarygodności", title = "B. Wiarygodność bez szczytu") + motyw
p5 <- p5a + p5b
# p5   # zapis: ggsave("regresja-logistyczna-separacja.svg", p5, width = 10, height = 5.6)
Wynik w R
[1] "glm.fit: algorithm did not converge"
[2] "glm.fit: fitted probabilities numerically 0 or 1 occurred"
  iteracje zbiezny
1       25   FALSE
            Estimate Std. Error z value Pr(>|z|)
(Intercept) -297.075  243984.18  -0.001    0.999
godz          42.439   34764.41   0.001    0.999
            Estimate Std. Error z value Pr(>|z|)
(Intercept)   -8.276      4.092  -2.022    0.043
godz           1.182      0.572   2.068    0.039
Analysis of Deviance Table

Model: binomial, link: logit

Response: y

Terms added sequentially (first to last)


     Df Deviance Resid. Df Resid. Dev  Pr(>Chi)
NULL                    19     27.726
godz  1   27.726        18      0.000 1.398e-07 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Implementation: ROI | Solver: lpsolve
Separation: TRUE
Existence of maximum likelihood estimates
(Intercept)        godz
       -Inf         Inf
0: finite value, Inf: infinity, -Inf: -infinity
            Estimate Std. Error z value Pr(>|z|)
(Intercept)  -10.626      5.703  -1.863    0.062
godz           1.518      0.803   1.892    0.059
[1] -2.4477 -1.0214 -0.2958 -0.0370
b_max_nakladanie         logL_max
           1.182           -4.389
   n separacja_proc blad_MC_pp
1 10          40.19       0.49
2 20           9.84       0.30
3 40           0.36       0.06
4 80           0.00       0.00
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, modele lm() i glm(), test dokładny dla odsetków – pakiet stats). Separację wykryto pakietem detectseparation, a model z karą Firtha oszacowano pakietem brglm2. Rysunki wykonano w ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite; paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- detectseparation (wersja 0.4.0): Kosmidis, I., Schumacher, D., & Schwendinger, F. (2026). detectseparation: Detect and check for separation and infinite maximum likelihood estimates [R package]. https://doi.org/10.32614/CRAN.package.detectseparation
- brglm2 (wersja 1.1.1): Kosmidis, I. (2026). brglm2: Bias reduction in generalized linear models [R package]. https://CRAN.R-project.org/package=brglm2
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy
- Prosta MNK do przewidywań na wyniku 0/1 bez sprawdzenia, ile przewidywań wypada poza [0, 1] (rysunek 1).
- Krzywa S bez danych. Dorysuj odsetki w przedziałach z liczebnościami albo przynajmniej punkty 0/1 (rysunek 2).
- „OR = 1.86, czyli prawdopodobieństwo rośnie o 86%”. OR mnoży szanse, a zmiana prawdopodobieństwa zależy od miejsca na krzywej (rysunek 3).
- Jeden efekt w punktach procentowych bez podania punktu wyjścia. Podaj profil osoby albo AME (rysunek 3).
- „Brak interakcji” bez dopowiedzenia, w jakiej skali. Równoległe proste w logicie nie oznaczają równoległych krzywych w prawdopodobieństwie (rysunek 4).
- Interpretowanie ogromnego b i p = .999 przy separacji. To objaw braku oszacowania; użyj testu ilorazu wiarygodności i kary Firtha (rysunek 5).
Więcej ćwiczeń z liczbami znajdziesz w zbiorze regresja logistyczna – zadania z rozwiązaniami, a te same modele w programach – we wpisach o regresji logistycznej w SPSS i w jamovi. Gdy wynik ma więcej niż dwie kategorie, zajrzyj do wpisu wielomianowa regresja logistyczna, a gdy osoby są zagnieżdżone w grupach – do wpisu wielopoziomowa regresja logistyczna.
Najczęstsze pytania
Dlaczego nie używać zwykłej regresji liniowej dla zmiennej 0/1?
Prosta nie zna granic prawdopodobieństwa: w przykładzie ze 150 osobami przewidywała −0.091 przy zerze godzin nauki i 1.141 przy 14 godzinach, a 23.3% przewidywań wypadło poza [0, 1]. Regresja logistyczna wygina zależność w krzywą S ograniczoną do przedziału od 0 do 1. Liniowy model prawdopodobieństwa bywa jednak zalecany do szacowania efektu manipulacji eksperymentalnej, bo jego współczynnik czyta się wprost w punktach procentowych (Gomila, 2021).
Dlaczego regresja logistyczna ma kształt litery S?
Bo model jest liniowy w skali logitu, czyli logarytmu szansy, a funkcja logistyczna przekształca prostą z tej skali na prawdopodobieństwa od 0 do 1. Na krańcach krzywa się spłaszcza, a najbardziej stroma jest przy prawdopodobieństwie .5. Jej nachylenie wynosi tam b/4 – w przykładzie 15.5 punktu procentowego na godzinę nauki.
Czy iloraz szans mówi, o ile wzrośnie prawdopodobieństwo?
Nie. OR mnoży szanse, a nie prawdopodobieństwo. W przykładzie OR = 1.86 za godzinę nauki oznaczał wzrost prawdopodobieństwa zaliczenia o 4.2 punktu procentowego między 2 a 3 godzinami, o 15.4 punktu między 6 a 7 godzinami i o 4.7 punktu między 10 a 11 godzinami. Jedną liczbę w punktach procentowych daje przeciętny efekt krańcowy (AME).
Jak rozpoznać separację w regresji logistycznej?
Objawy to ogromny współczynnik, jeszcze większy błąd standardowy, p bliskie 1 w teście Walda i ostrzeżenia o braku zbieżności albo o dopasowanych prawdopodobieństwach równych 0 lub 1. W przykładzie z 20 osobami glm() dał b = 42.44 przy SE = 34 764.41, a pakiet detectseparation potwierdził nieskończone oszacowania. Związek oceń testem ilorazu wiarygodności, a nachylenie – regresją z karą Firtha (Heinze i Schemper, 2002).
Czy interakcja w regresji logistycznej to to samo co interakcja w prawdopodobieństwach?
Nie. Równoległe proste w skali logitu dają w skali prawdopodobieństwa krzywe o zmiennym odstępie (w przykładzie od 4.7 do 27.8 punktu procentowego), a równoległe linie prawdopodobieństwa – nierównoległe proste w logicie. Współczynnik iloczynu w regresji logistycznej opisuje interakcję w logicie; interakcję w prawdopodobieństwach ocenia się jako zmianę efektu brzegowego (McCabe i in., 2022).
Powiązane hasła
Przeczytaj też
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikWynik regresji na wykresie
Współczynniki z CI, pasmo ufności a predykcji, ekstrapolacja, interakcja, efekty brzegowe i prawdopodobieństwa – pięć rysunków z kodem R i podpisami APA.
Czytaj →PoradnikMetoda najmniejszych kwadratów w obrazkach
Reszty jako kwadraty, parabola sumy kwadratów, regresja y na x i x na y, oś główna, dźwignia i R² – skąd się bierze prosta regresji, na rysunkach z R.
Czytaj →Nie wiesz, jak opisać regresję logistyczną w swojej pracy?
Pomożemy dobrać model dla wyniku 0/1, przygotować czytelne wykresy przewidywanych prawdopodobieństw i opisać wyniki tak, żebyś umiał(a) je wyjaśnić na obronie.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1–10. https://doi.org/10.1093/biomet/71.1.1
- Gomila, R. (2021). Logistic or linear? Estimating causal effects of experimental treatments on binary outcomes using regression analysis. Journal of Experimental Psychology: General, 150(4), 700–709. https://doi.org/10.1037/xge0000920 ● Otwarty dostęp: pełny tekst
- Heinze, G., & Schemper, M. (2002). A solution to the problem of separation in logistic regression. Statistics in Medicine, 21(16), 2409–2419. https://doi.org/10.1002/sim.1047
- McCabe, C. J., Halvorson, M. A., King, K. M., Cao, X., & Kim, D. S. (2022). Interpreting interaction effects in generalized linear models of nonlinear probabilities and counts. Multivariate Behavioral Research, 57(2–3), 243–263. https://doi.org/10.1080/00273171.2020.1868966 ● Otwarty dostęp: pełny tekst
- Mood, C. (2010). Logistic regression: Why we cannot do what we think we can do, and what we can do about it. European Sociological Review, 26(1), 67–82. https://doi.org/10.1093/esr/jcp006 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{albert1984existence, author={Albert, A. and Anderson, J. A.}, title={{On the existence of maximum likelihood estimates in logistic regression models}}, journal={Biometrika}, year={1984}, volume={71}, number={1}, pages={1--10}, doi={10.1093/biomet/71.1.1}}@article{gomila2021logistic, author={Gomila, Robin}, title={{Logistic or linear? Estimating causal effects of experimental treatments on binary outcomes using regression analysis}}, journal={Journal of Experimental Psychology: General}, year={2021}, volume={150}, number={4}, pages={700--709}, doi={10.1037/xge0000920}}@article{heinze2002solution, author={Heinze, Georg and Schemper, Michael}, title={{A solution to the problem of separation in logistic regression}}, journal={Statistics in Medicine}, year={2002}, volume={21}, number={16}, pages={2409--2419}, doi={10.1002/sim.1047}}@article{mccabe2022interpreting, author={McCabe, Connor J. and Halvorson, Max A. and King, Kevin M. and Cao, Xiaolin and Kim, Dale S.}, title={{Interpreting interaction effects in generalized linear models of nonlinear probabilities and counts}}, journal={Multivariate Behavioral Research}, year={2022}, volume={57}, number={2–3}, pages={243--263}, doi={10.1080/00273171.2020.1868966}}@article{mood2010logistic, author={Mood, Carina}, title={{Logistic regression: Why we cannot do what we think we can do, and what we can do about it}}, journal={European Sociological Review}, year={2010}, volume={26}, number={1}, pages={67--82}, doi={10.1093/esr/jcp006}}