Kiedy regresja logistyczna i co zrobisz w jamovi
Regresja logistyczna przewiduje wynik o dwóch wartościach, a jej współczynniki przelicza się na ilorazy szans (OR). Logikę modelu omawia poradnik regresja logistyczna krok po kroku, a ten sam model w SPSS – wpis regresja logistyczna w SPSS. Tu pokazujemy jamovi; interfejs programu opisuje wpis jamovi krok po kroku.
Menu i nazwy opcji sprawdziliśmy w dokumentacji jamovi (The jamovi project, b.d.) i w definicji analizy w pakiecie jmv, który wykonuje obliczenia jamovi (Selker i in., 2025). Podajemy je po angielsku; polskie odpowiedniki pochodzą z pliku tłumaczeń jmv i w Twojej wersji mogą brzmieć inaczej.
Przykład. 260 studentów (dane symulowane) podało, czy w ostatnim roku skorzystało z konsultacji psychologicznej (konsultacja: 0 = nie, 1 = tak). Predyktory to stres w ostatnim miesiącu (średnia ze skali 1–5, stres), wsparcie społeczne (średnia 1–7, wsparcie) i kierunek studiów (kierunek: 1 = psychologia, 2 = pedagogika, 3 = informatyka). Dane pobierzesz jako plik CSV (same kody liczbowe) albo plik .sav z etykietami zmiennych i wartości.
Przygotowanie danych: typy zmiennych i poziomy
Dwuklik na nagłówku kolumny otwiera edytor zmiennej: typ pomiaru (Measure type), etykiety i kolejność poziomów oraz kody braków (Missing values) (The jamovi project, b.d.).
- Zmienna zależna:
konsultacjajako Nominal z etykietami „nie” (0) i „tak” (1). Przy więcej niż dwóch poziomach jamovi przerwie analizę z komunikatem (Selker i in., 2025). - Predyktor kategorialny:
kierunekteż jako Nominal, z etykietami. Kolejność poziomów ma znaczenie: poziom na górze listy w edytorze zmiennej jest pierwszy w tabelach (The jamovi project, b.d.), a pierwszy poziom staje się domyślnie poziomem referencyjnym (krok 2). stresiwsparcie– Continuous.- Braki: osoba z brakiem w którejkolwiek zmiennej modelu wypada z analizy. Kody typu 99 zdefiniuj w Missing values.
Statystyki opisowe z Exploration → Descriptives (z opcją tabeli częstości): z konsultacji skorzystały 64 osoby (24.6%), stres M = 3.06 (SD = 0.73), wsparcie M = 4.94 (SD = 1.04; 255 ważnych odpowiedzi). Po usunięciu braków w modelu zostaje 255 osób, w tym 63 z wynikiem „tak”. Policz zdarzenia, zanim dodasz kolejne predyktory.
Krok 1. Analyses → Regression → 2 Outcomes
Na pasku Analyses wybierz Regression, a w grupie Logistic Regression pozycję 2 Outcomes (podpis Binomial). Okno nazywa się Binomial Logistic Regression (Selker i in., 2025; The jamovi project, b.d.). N Outcomes i Ordinal Outcomes są dla wyniku o kilku kategoriach.
konsultacjaprzenieś do Dependent Variable.stresiwsparcieprzenieś do Covariates – to pole na predyktory ilościowe.kierunekprzenieś do Factors. jamovi utworzy dwie zmienne zero-jedynkowe (dummy coding), porównujące kierunki z poziomem referencyjnym.
Pułapka: zmienna nominalna w Covariates. Pole Covariates traktuje zmienną jak liczby (Selker i in., 2025), więc kierunek o kodach 1–3 da jeden współczynnik „na jednostkę kodu” (tu OR = 0.813, p = .336). To zakłada, że przejście z psychologii na pedagogikę znaczy to samo co z pedagogiki na informatykę. Zmienną 0/1 wolno wpisać do Covariates, ale zmienną o trzech i więcej kategoriach – tylko do Factors.
Krok 2. Reference Levels – najważniejsza pułapka
W sekcji Reference Levels wybierasz Reference Level dla zmiennej zależnej i każdego czynnika; domyślnie to pierwszy poziom (The jamovi project, b.d.; Selker i in., 2025). Model przewiduje szanse drugiego poziomu zmiennej zależnej względem poziomu referencyjnego. Ustaw:
konsultacja: nie – model opisze szanse wyniku „tak”;kierunek: psychologia – pedagogika i informatyka zostaną porównane z psychologią.
Sprawdź to w nocie pod tabelą współczynników, np. Estimates represent the log odds of "konsultacja = tak" vs. "konsultacja = nie". Gdy plik z ankiety ma kody 1 = tak, 2 = nie, pierwszym poziomem jest „tak”: model opisze szanse, że ktoś nie skorzystał z konsultacji, i znaki się odwrócą (tabela 1).
Tabela 1. Ten sam model przy dwóch poziomach referencyjnych zmiennej zależnej (zestawienie z dwóch uruchomień). Liczby policzone pakietem jmv (silnik analiz jamovi).
| Predictor | Reference Level = nie (szanse „tak”) | Reference Level = tak (szanse „nie”) |
|---|---|---|
| stres | OR = 3.537 [2.154, 5.807] | OR = 0.283 [0.172, 0.464] |
| wsparcie | OR = 0.602 [0.439, 0.825] | OR = 1.661 [1.212, 2.276] |
Prawa kolumna to odwrotności lewej (1 / 3.537 = 0.283). Napisz w pracy, który wynik modelujesz i która kategoria jest odniesieniem.
Krok 3. Model Builder: predyktory w blokach
Sekcja Model Builder pozwala wprowadzać predyktory w blokach, jak w regresji hierarchicznej. Kolejny blok dodasz przyciskiem + Add New Block (The jamovi project, b.d.). W przykładzie Block 1 to kierunek (zmienna kontrolna), a Block 2 – stres i wsparcie. Pytanie: czy stres i wsparcie przewidują konsultację ponad kierunek?
Krok 4. Które opcje zaznaczyć
Tabela 2. Opcje okna Binomial Logistic Regression. Nazwy według definicji analizy w pakiecie jmv (Selker i in., 2025); polskie odpowiedniki z pliku tłumaczeń jmv.
| Sekcja | Zaznacz | W polskiej wersji |
|---|---|---|
| Model Fit | Overall model test; Pseudo R²: Nagelkerke's R², Tjur's R² (McFadden's jest domyślnie); Deviance i AIC są domyślnie | Dopasowanie modelu; Ogólny test modelu |
| Model Coefficients | Omnibus Tests: Likelihood ratio tests; Odds Ratio: Odds ratio i Confidence interval (95) | Współczynniki modelu; Iloraz szans |
| Assumption Checks | Collinearity statistics | Statystyki współliniowości |
| Estimated Marginal Means | predyktor w polu Term 1; Marginal means tables | Oszacowane średnie brzegowe |
| Prediction | Classification table, Accuracy, Specificity, Sensitivity, ROC curve, AUC; Cut-off value (domyślnie 0.5); Cut-off plot | Przewidywanie; Wartość graniczna; Tabela klasyfikacji |
| Save | Predicted values (opcjonalnie) | Zapisz; Wartości przewidywane |
W sekcji Model Fit polskie tłumaczenie nazywa Deviance „Odchyleniem”. W pracy pisz o dewiancji (−2LL). Okno nie ma testu Hosmera–Lemeshowa (Selker i in., 2025); w razie potrzeby policz go w R albo w SPSS.
Krok 5. Model Fit Measures i Model Comparisons
Tabela 3. Model Fit Measures. Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi.
| Model | Deviance | AIC | R²McF | R²CS | R²N | R²T | Overall Model Test | ||
|---|---|---|---|---|---|---|---|---|---|
| χ² | df | p | |||||||
| 1 | 283.113 | 289.113 | 0.007 | 0.008 | 0.012 | 0.008 | 2.018 | 2 | 0.365 |
| 2 | 244.059 | 254.059 | 0.144 | 0.149 | 0.221 | 0.160 | 41.072 | 4 | < .001 |
Tabela 4. Model Comparisons. Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi.
| Comparison | χ² | df | p | ||
|---|---|---|---|---|---|
| Model | Model | ||||
| 1 | - | 2 | 39.054 | 2 | < .001 |
- Overall Model Test to test ilorazu wiarygodności: porównuje model z modelem bez predyktorów. Sam kierunek nic nie wnosi, χ²(2) = 2.02, p = .365. Model 2 jest istotny, χ²(4) = 41.07, p < .001.
- Model Comparisons to przyrost dopasowania po dodaniu bloku 2: Δχ²(2) = 39.05, p < .001. AIC spadło z 289.11 do 254.06.
- Pseudo-R²: cztery miary dają różne wartości (dla modelu 2 od .14 do .22). Podaj jedną lub dwie z nazwą. Tjur (2009) zaproponował różnicę średnich przewidywanych prawdopodobieństw w obu grupach (tu .16). Nie pisz, że model „wyjaśnia 22% wariancji”: analogi R² nie są odpowiednikiem R² z regresji liniowej (Menard, 2000).
Wyniki modelu 2 wybierzesz z listy Model Specific Results (The jamovi project, b.d.).
Krok 6. Omnibus Likelihood Ratio Tests i Model Coefficients
Tabela 5. Omnibus Likelihood Ratio Tests i Model Coefficients – konsultacja (model 2). Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabel jak w jamovi.
| Predictor | χ² | df | p |
|---|---|---|---|
| kierunek | 1.118 | 2 | 0.572 |
| stres | 30.284 | 1 | < .001 |
| wsparcie | 10.703 | 1 | 0.001 |
| Predictor | Estimate | SE | Z | p | Odds ratio | 95% Confidence Interval | |
|---|---|---|---|---|---|---|---|
| Lower | Upper | ||||||
| Intercept | −2.576 | 1.089 | −2.365 | 0.018 | 0.076 | 0.009 | 0.644 |
| kierunek: | |||||||
| pedagogika – psychologia | −0.085 | 0.359 | −0.236 | 0.813 | 0.919 | 0.455 | 1.856 |
| informatyka – psychologia | −0.454 | 0.448 | −1.015 | 0.310 | 0.635 | 0.264 | 1.526 |
| stres | 1.263 | 0.253 | 4.993 | < .001 | 3.537 | 2.154 | 5.807 |
| wsparcie | −0.507 | 0.161 | −3.155 | 0.002 | 0.602 | 0.439 | 0.825 |
Note. Estimates represent the log odds of "konsultacja = tak" vs. "konsultacja = nie"
- Omnibus Likelihood Ratio Tests testuje każdy predyktor jako całość. Przy czynniku zacznij od niej: kierunek nie wiąże się z konsultacją, χ²(2) = 1.12, p = .572, więc nie interpretujesz porównań kierunków.
- Estimate to zmiana logitu, a Odds ratio = eEstimate. Z = Estimate / SE to test Walda (SPSS podaje Z²); przedziały ufności też są przedziałami Walda (Selker i in., 2025).
- Stres: wzrost o 1 punkt wiąże się z 3.54 raza większymi szansami konsultacji, 95% CI [2.15, 5.81], przy stałych pozostałych predyktorach.
- Wsparcie: OR = 0.60 na punkt, czyli szanse maleją mniej więcej o 40% z każdym punktem.
- Wiersze kierunku porównują pedagogikę i informatykę z psychologią. Porównanie pedagogiki z informatyką uzyskasz po zmianie poziomu referencyjnego.
- Intercept (logit przy zerowych predyktorach) pomijasz, bo skale zaczynają się od 1.
OR nie jest ilorazem prawdopodobieństw, więc nie pisz, że stres „zwiększa prawdopodobieństwo 3.5 raza”. Skalę efektu pokażą przewidywane prawdopodobieństwa z sekcji Estimated Marginal Means: po wpisaniu stres do Term 1 jamovi podaje prawdopodobieństwo „tak” przy średniej i ±1 SD (kierunki z równymi wagami, Equal cell weights).
Tabela 6. Estimated Marginal Means – stres (model 2). Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi.
| stres | Probability | SE | 95% Confidence Interval | |
|---|---|---|---|---|
| Lower | Upper | |||
| 2.334⁻ | 0.090 | 0.025 | 0.051 | 0.153 |
| 3.063μ | 0.199 | 0.029 | 0.147 | 0.263 |
| 3.791⁺ | 0.384 | 0.049 | 0.294 | 0.482 |
Note. ⁻ mean − 1SD, μ mean, ⁺ mean + 1SD
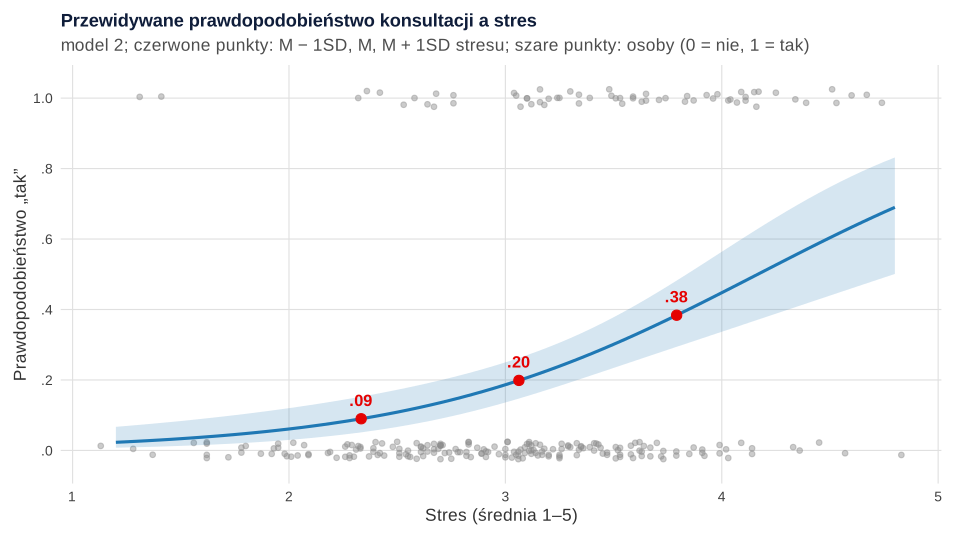
Przewidywane prawdopodobieństwo rośnie z .09 przy stresie o 1 SD poniżej średniej do .38 przy stresie o 1 SD powyżej. OR jest stały, ale przyrost prawdopodobieństwa zależy od punktu wyjścia.
Krok 7. Prediction: tabela klasyfikacji, AUC i cut-off
Tabela 7. Classification Table i Predictive Measures (model 2, Cut-off value = 0.5). Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabel jak w jamovi.
| Observed | Predicted | % Correct | |
|---|---|---|---|
| nie | tak | ||
| nie | 180 | 12 | 93.750 |
| tak | 49 | 14 | 22.222 |
| Accuracy | Specificity | Sensitivity | AUC |
|---|---|---|---|
| 0.761 | 0.938 | 0.222 | 0.756 |
Note. The cut-off value is set to 0.5
Osoba trafia do grupy „tak”, gdy przewidywane prawdopodobieństwo przekracza próg (Selker i in., 2025). Trafność 76.1% wygląda dobrze, ale model 1 zaklasyfikował wszystkich jako „nie” i miał 75.3% – tyle, ile wynosi odsetek „nie”. Model 2 rozpoznał tylko 14 z 63 osób, które skorzystały z konsultacji: czułość 22.2% przy swoistości 93.8%. Przy rzadkim wyniku próg 0.5 zwykle daje niską czułość.
Zdolność rozróżniania grup niezależnie od progu opisuje pole pod krzywą ROC. AUC = .76 to prawdopodobieństwo, że losowo wybrana osoba z wynikiem „tak” dostanie od modelu wyższe przewidywane prawdopodobieństwo niż losowo wybrana osoba z wynikiem „nie” (Hanley i McNeil, 1982).
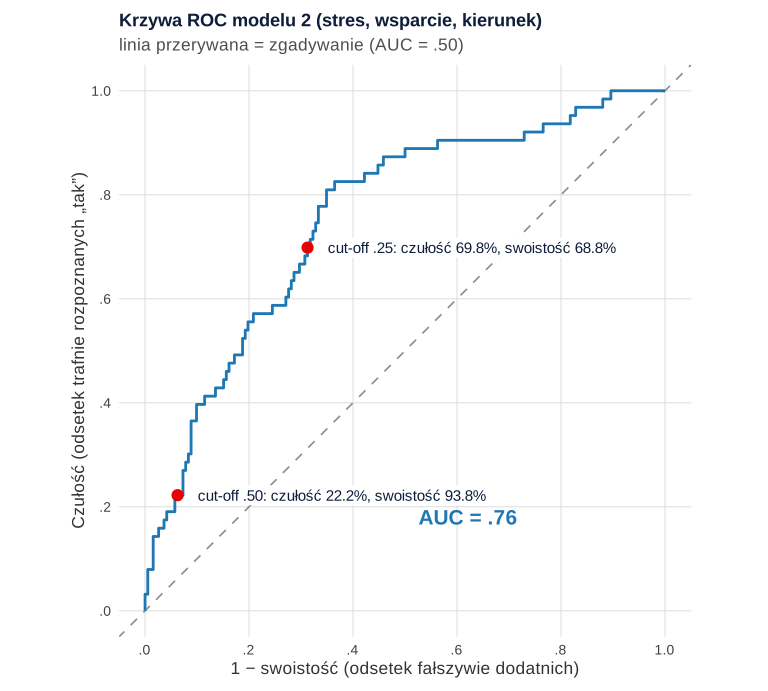
Cut-off value = 0.25 (mniej więcej odsetek „tak”) daje czułość 69.8% (44 z 63) i swoistość 68.8%, przy ogólnej trafności 69.0%. Wybór punktu odcięcia zależy od kosztu pomyłek. Opcja Cut-off plot pokazuje, jak czułość i swoistość zmieniają się z progiem (rysunek 3).
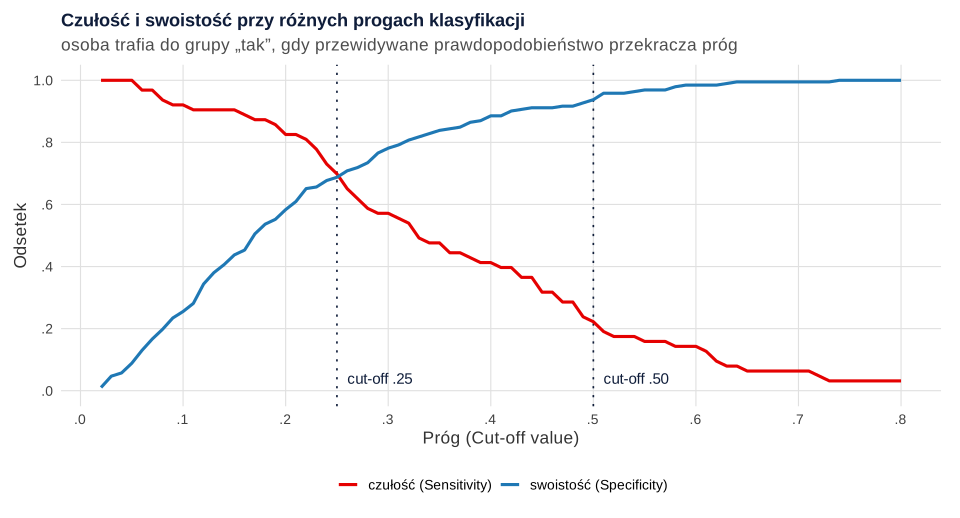
Tabela klasyfikacji liczona na danych, na których dopasowano model, jest optymistyczna.
Krok 8. Współliniowość i inne założenia
Tabela 8. Collinearity Statistics (model 2). Liczby policzone pakietem jmv (silnik analiz jamovi); układ tabeli jak w jamovi.
| VIF | Tolerance | |
|---|---|---|
| kierunek | 1.008 | 0.992 |
| stres | 1.018 | 0.983 |
| wsparcie | 1.033 | 0.968 |
Wartości bliskie 1 oznaczają, że predyktory prawie się nie pokrywają. Uwaga na szczegół z kodu jmv: gdy w modelu jest czynnik, kolumna VIF zawiera uogólniony VIF podniesiony do potęgi 1/(2df) (Selker i in., 2025). Dla predyktora ilościowego to pierwiastek ze zwykłego VIF. Przed porównaniem z progami typu 5 czy 10 podnieś więc wartość do kwadratu (stres: 1.018² ≈ 1.04). Liniowości logitu i separacji okno nie sprawdza wprost; reszty i odległości Cooka zapiszesz w Save. Pełną diagnostykę w R pokazuje poradnik regresja logistyczna krok po kroku.
Zapis wyników w stylu APA
Peng i in. (2002) zalecają podać test modelu, miarę dopasowania, współczynniki z SE, statystykę testu, p, OR i wyniki klasyfikacji. Tabelę przygotuj według wzoru tabeli regresji logistycznej w APA. Prostsze analizy opiszesz w generatorze opisu wyników APA.
Ćwiczenia znajdziesz w zbiorze regresja logistyczna – zadania z rozwiązaniami. Gdy nie wiesz, czy potrzebujesz regresji logistycznej, sprawdź kreator doboru testu.
To samo w R (pakiet jmv)
Wszystkie liczby z tabel 1 i 3–8 policzyliśmy funkcjami pakietu jmv – tymi samymi, które uruchamia jamovi (descriptives, logRegBin). Argumenty funkcji odpowiadają opcjom okna: blocks to Model Builder, refLevels – Reference Levels, pseudoR2, modelTest, omni, OR, ciOR, class, auc, cutOff i emMeans – opcje z tabeli 2. Kod analizy pokaże też sam jamovi w trybie składni (Syntax mode), opisanym we wpisie jamovi krok po kroku. Uruchom przepisy po kolei z folderu, w którym zapiszesz pliki danych. Przepis 1 tworzy plik CSV i plik .sav (pakiet haven).
1. Dane: CSV i plik .sav z etykietami
R
# B410 – dane przykładowe: konsultacja psychologiczna w ostatnim roku (dane symulowane, set.seed(4101))
# 260 studentów; plik CSV (kody liczbowe) i plik SPSS .sav z etykietami – oba otworzysz w jamovi
suppressPackageStartupMessages(library(haven))
set.seed(4101)
n <- 260
kierunek <- sample(1:3, n, replace = TRUE, prob = c(.40, .35, .25))     # 1 = psychologia, 2 = pedagogika, 3 = informatyka
stres <- round(pmin(pmax(rnorm(n, 3.0, 0.7), 1), 5), 2)                  # stres w ostatnim miesiącu, średnia 1–5
wsparcie <- round(pmin(pmax(rnorm(n, 5.0, 1.1), 1), 7), 2)               # wsparcie społeczne, średnia 1–7
logit <- -0.9 + 1.0 * (stres - 3) - 0.4 * (wsparcie - 5) + c(0, -0.5, -0.9)[kierunek]
konsultacja <- rbinom(n, 1, plogis(logit))                               # 1 = tak, 0 = nie
wsparcie[sample(1:n, 5)] <- NA                                           # braki: 5 osób bez skali wsparcia
dane <- data.frame(id = 1:n, konsultacja, kierunek, stres, wsparcie)
write.csv(dane, "../regresja-logistyczna-jamovi-dane.csv", row.names = FALSE, na = "")

sav <- dane
attr(sav$id, "label") <- "Numer osoby"
sav$konsultacja <- labelled(sav$konsultacja, c("nie" = 0, "tak" = 1), label = "Konsultacja psychologiczna w ostatnim roku")
sav$kierunek <- labelled(sav$kierunek, c("psychologia" = 1, "pedagogika" = 2, "informatyka" = 3), label = "Kierunek studiów")
attr(sav$stres, "label") <- "Stres w ostatnim miesiącu (średnia 1–5)"
attr(sav$wsparcie, "label") <- "Wsparcie społeczne (średnia 1–7)"
write_sav(sav, "../regresja-logistyczna-jamovi-dane.sav")

# Kontrola: odczyt pliku .sav (etykiety wartości) i liczba braków w każdej kolumnie
str(read_sav("../regresja-logistyczna-jamovi-dane.sav")[, c("konsultacja", "kierunek")])
colSums(is.na(dane))
Wynik w R
tibble [260 × 2] (S3: tbl_df/tbl/data.frame)
 $ konsultacja: dbl+lbl [1:260] 0, 1, 1, 0, 0, 0, 1, 0, 0, 0, 0, 0, 0, 0, 1, 1, 0, 1, 0, 1, 0, 0, 0, 0, 0,...
   ..@ label      : chr "Konsultacja psychologiczna w ostatnim roku"
   ..@ format.spss: chr "F8.0"
   ..@ labels     : Named num [1:2] 0 1
   .. ..- attr(*, "names")= chr [1:2] "nie" "tak"
 $ kierunek   : dbl+lbl [1:260] 2, 1, 1, 1, 3, 1, 2, 2, 2, 1, 1, 2, 1, 3, 1, 1, 2, 2, 3, 2, 1, 2, 1, 3, 1,...
   ..@ label      : chr "Kierunek studiów"
   ..@ format.spss: chr "F8.0"
   ..@ labels     : Named num [1:3] 1 2 3
   .. ..- attr(*, "names")= chr [1:3] "psychologia" "pedagogika" "informatyka"
         id konsultacja    kierunek       stres    wsparcie
          0           0           0           0           5
2. Descriptives i 2 Outcomes z dwoma blokami
R
# B410 – regresja logistyczna jak w jamovi: Analyses → Regression → 2 Outcomes (Binomial)
# Te same funkcje, które uruchamia jamovi (pakiet jmv); dane z przepisu 1
library(jmv)
dane <- read.csv("../regresja-logistyczna-jamovi-dane.csv")
# W jamovi: konsultacja i kierunek jako Nominal z etykietami poziomów (kolejność poziomów = kolejność kodów)
dane$konsultacja <- factor(dane$konsultacja, levels = 0:1, labels = c("nie", "tak"))
dane$kierunek <- factor(dane$kierunek, levels = 1:3, labels = c("psychologia", "pedagogika", "informatyka"))

# Exploration → Descriptives: liczebności, braki, M i SD
descriptives(data = dane, vars = vars(konsultacja, kierunek, stres, wsparcie), freq = TRUE,
             median = FALSE, min = FALSE, max = FALSE)

# 2 Outcomes: blok 1 = kierunek, blok 2 = + stres i wsparcie (Model Builder)
# Reference Levels: konsultacja = nie, kierunek = psychologia
model <- logRegBin(data = dane, dep = konsultacja,
  covs = vars(stres, wsparcie), factors = vars(kierunek),
  blocks = list(list("kierunek"), list("stres", "wsparcie")),
  refLevels = list(list(var = "konsultacja", ref = "nie"), list(var = "kierunek", ref = "psychologia")),
  modelTest = TRUE, pseudoR2 = c("r2mf", "r2cs", "r2n", "r2t"),   # Model Fit
  omni = TRUE, OR = TRUE, ciOR = TRUE,                              # Model Coefficients
  collin = TRUE,                                                    # Assumption Checks
  class = TRUE, acc = TRUE, spec = TRUE, sens = TRUE, auc = TRUE)   # Prediction (cut-off 0.5)
model
Wynik w R
 DESCRIPTIVES

 Descriptives
 ──────────────────────────────────────────────────────────────────────────
                         konsultacja    kierunek    stres        wsparcie
 ──────────────────────────────────────────────────────────────────────────
   N                             260         260          260         255
   Missing                         0           0            0           5
   Mean                                              3.056192    4.942235
   Standard deviation                               0.7296774    1.035665
 ──────────────────────────────────────────────────────────────────────────


 FREQUENCIES

 Frequencies of konsultacja
 ───────────────────────────────────────────────────────
   konsultacja    Counts    % of Total    Cumulative %
 ───────────────────────────────────────────────────────
   nie               196      75.38462        75.38462
   tak                64      24.61538       100.00000
 ───────────────────────────────────────────────────────


 Frequencies of kierunek
 ───────────────────────────────────────────────────────
   kierunek       Counts    % of Total    Cumulative %
 ───────────────────────────────────────────────────────
   psychologia        90      34.61538        34.61538
   pedagogika        106      40.76923        75.38462
   informatyka        64      24.61538       100.00000
 ───────────────────────────────────────────────────────


 BINOMIAL LOGISTIC REGRESSION

 Model Fit Measures
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Model    Deviance    AIC         R²-McF         R²-CS          R²-N          R²-T           χ²           df    p
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
       1    283.1131    289.1131    0.007077667    0.007882743    0.01171076    0.007536107     2.018064     2     0.3645717
       2    244.0590    254.0590    0.144046540    0.148765228    0.22100854    0.159708348    41.072164     4    < .0000001
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Models estimated using sample size of N=255


 Model Comparisons
 ───────────────────────────────────────────────────────
   Model         Model    χ²          df    p
 ───────────────────────────────────────────────────────
       1    -        2    39.05410     2    < .0000001
 ───────────────────────────────────────────────────────


 MODEL SPECIFIC RESULTS

 MODEL 1

 Omnibus Likelihood Ratio Tests
 ────────────────────────────────────────────
   Predictor    χ²          df    p
 ────────────────────────────────────────────
   kierunek     2.018064     2    0.3645717
 ────────────────────────────────────────────


 Model Coefficients - konsultacja
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Predictor                    Estimate       SE           Z              p            Odds ratio    Lower        Upper
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Intercept                    -0.99633344    0.2388539    -4.17130884    0.0000303     0.3692308    0.2311985    0.5896723
   kierunek:
   pedagogika – psychologia     -0.01526747    0.3251960    -0.04694853    0.9625542     0.9848485    0.5206695    1.8628450
   informatyka – psychologia    -0.51779429    0.4098296    -1.26343810    0.2064318     0.5958333    0.2668562    1.3303697
 ─────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Estimates represent the log odds of "konsultacja = tak" vs. "konsultacja = nie"


 ASSUMPTION CHECKS

 Collinearity Statistics
 ─────────────────────────────────────
               VIF         Tolerance
 ─────────────────────────────────────
   kierunek    1.000000     1.000000
 ─────────────────────────────────────


 PREDICTION

 Classification Table – …
 ───────────────────────────────────────
   Observed    nie    tak    % Correct
 ───────────────────────────────────────
        nie    192      0     100.0000
        tak     63      0     0.000000
 ───────────────────────────────────────
   Note. The cut-off value is set to
   0.5


 Predictive Measures
 ────────────────────────────────────────────────────────
   Accuracy     Specificity    Sensitivity    AUC
 ────────────────────────────────────────────────────────
   0.7529412       1.000000       0.000000    0.5440642
 ────────────────────────────────────────────────────────
   Note. The cut-off value is set to 0.5


 MODEL 2

 Omnibus Likelihood Ratio Tests
 ──────────────────────────────────────────────
   Predictor    χ²           df    p
 ──────────────────────────────────────────────
   kierunek      1.117871     2     0.5718175
   stres        30.283921     1    < .0000001
   wsparcie     10.703183     1     0.0010695
 ──────────────────────────────────────────────


 Model Coefficients - konsultacja
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Predictor                    Estimate       SE           Z             p            Odds ratio    Lower          Upper
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Intercept                    -2.57595422    1.0893785    -2.3646090    0.0180491    0.07608119    0.008994906    0.6435139
   kierunek:
   pedagogika – psychologia     -0.08485588    0.3588129    -0.2364906    0.8130520    0.91864467    0.454700499    1.8559646
   informatyka – psychologia    -0.45444077    0.4475719    -1.0153470    0.3099405    0.63480287    0.264037122    1.5262047
   stres                         1.26327086    0.2529981     4.9932033    0.0000006    3.53697153    2.154166184    5.8074292
   wsparcie                     -0.50737778    0.1608014    -3.1553068    0.0016033    0.60207227    0.439313165    0.8251313
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Estimates represent the log odds of "konsultacja = tak" vs. "konsultacja = nie"


 ASSUMPTION CHECKS

 Collinearity Statistics
 ─────────────────────────────────────
               VIF         Tolerance
 ─────────────────────────────────────
   kierunek    1.008441    0.9916294
   stres       1.017664    0.9826426
   wsparcie    1.033386    0.9676922
 ─────────────────────────────────────


 PREDICTION

 Classification Table – …
 ───────────────────────────────────────
   Observed    nie    tak    % Correct
 ───────────────────────────────────────
        nie    180     12     93.75000
        tak     49     14     22.22222
 ───────────────────────────────────────
   Note. The cut-off value is set to
   0.5


 Predictive Measures
 ────────────────────────────────────────────────────────
   Accuracy     Specificity    Sensitivity    AUC
 ────────────────────────────────────────────────────────
   0.7607843      0.9375000      0.2222222    0.7559524
 ────────────────────────────────────────────────────────
   Note. The cut-off value is set to 0.5
3. Cut-off 0.25, Estimated Marginal Means i dwie pułapki
R
# B410 – ten sam model 2 jako jeden blok: inny cut-off, Estimated Marginal Means i dwie pułapki
library(jmv)
dane <- read.csv("../regresja-logistyczna-jamovi-dane.csv")
dane$konsultacja <- factor(dane$konsultacja, levels = 0:1, labels = c("nie", "tak"))
dane$kierunek <- factor(dane$kierunek, levels = 1:3, labels = c("psychologia", "pedagogika", "informatyka"))
ref <- list(list(var = "konsultacja", ref = "nie"), list(var = "kierunek", ref = "psychologia"))

# Prediction: Cut-off value = 0.25 (mniej więcej odsetek osób z wynikiem „tak”)
m25 <- logRegBin(data = dane, dep = konsultacja, covs = vars(stres, wsparcie), factors = vars(kierunek),
  blocks = list(list("kierunek", "stres", "wsparcie")), refLevels = ref,
  class = TRUE, acc = TRUE, spec = TRUE, sens = TRUE, cutOff = 0.25)
m25$models[[1]]$pred

# Estimated Marginal Means: przewidywane prawdopodobieństwo przy M − 1SD, M i M + 1SD stresu
emm <- logRegBin(data = dane, dep = konsultacja, covs = vars(stres, wsparcie), factors = vars(kierunek),
  blocks = list(list("kierunek", "stres", "wsparcie")), refLevels = ref,
  emMeans = list("stres"), emmTables = TRUE, emmPlots = FALSE)
emm$models[[1]]$emm

# Pułapka 1: poziom referencyjny zmiennej zależnej = „tak” (model przewiduje „nie”)
odwr <- logRegBin(data = dane, dep = konsultacja, covs = vars(stres, wsparcie), factors = vars(kierunek),
  blocks = list(list("kierunek", "stres", "wsparcie")),
  refLevels = list(list(var = "konsultacja", ref = "tak"), list(var = "kierunek", ref = "psychologia")),
  OR = TRUE, ciOR = TRUE)
odwr$models[[1]]$coef

# Pułapka 2: kierunek (kody 1–3) wpisany do Covariates zamiast do Factors
d_zle <- dane; d_zle$kierunek <- as.integer(d_zle$kierunek)
zle <- logRegBin(data = d_zle, dep = konsultacja, covs = vars(kierunek, stres, wsparcie),
  blocks = list(list("kierunek", "stres", "wsparcie")),
  refLevels = list(list(var = "konsultacja", ref = "nie")), OR = TRUE)
zle$models[[1]]$coef
Wynik w R
 PREDICTION

 Classification Table – …
 ───────────────────────────────────────
   Observed    nie    tak    % Correct
 ───────────────────────────────────────
        nie    132     60     68.75000
        tak     19     44     69.84127
 ───────────────────────────────────────
   Note. The cut-off value is set to
   0.25


 Predictive Measures
 ───────────────────────────────────────────
   Accuracy     Specificity    Sensitivity
 ───────────────────────────────────────────
   0.6901961      0.6875000      0.6984127
 ───────────────────────────────────────────
   Note. The cut-off value is set to
   0.25


 ESTIMATED MARGINAL MEANS

 STRES

 Estimated Marginal Means - stres
 ────────────────────────────────────────────────────────────────────
   stres       Probability    SE            Lower         Upper
 ────────────────────────────────────────────────────────────────────
   2.333531     0.08985403    0.02509495    0.05132689    0.1526472
   3.062510     0.19868702    0.02939857    0.14723771    0.2625786
   3.791489     0.38375909    0.04850023    0.29409396    0.4820919
 ────────────────────────────────────────────────────────────────────
   Note. ⁻ mean - 1SD, <sup>μ</sup> mean, ⁺ mean + 1SD


 Model Coefficients - konsultacja
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Predictor                    Estimate       SE           Z             p            Odds ratio    Lower        Upper
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Intercept                     2.57595422    1.0893785     2.3646090    0.0180491    13.1438533    1.5539679    111.1740315
   kierunek:
   pedagogika – psychologia      0.08485588    0.3588129     0.2364906    0.8130520     1.0885602    0.5388034      2.1992498
   informatyka – psychologia     0.45444077    0.4475719     1.0153470    0.3099405     1.5752922    0.6552201      3.7873462
   stres                        -1.26327086    0.2529981    -4.9932033    0.0000006     0.2827277    0.1721932      0.4642167
   wsparcie                      0.50737778    0.1608014     3.1553068    0.0016033     1.6609302    1.2119284      2.2762805
 ──────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Estimates represent the log odds of "konsultacja = nie" vs. "konsultacja = tak"


 Model Coefficients - konsultacja
 ─────────────────────────────────────────────────────────────────────────────────
   Predictor    Estimate      SE           Z             p            Odds ratio
 ─────────────────────────────────────────────────────────────────────────────────
   Intercept    -2.2705136    1.1327548    -2.0044176    0.0450253     0.1032591
   kierunek     -0.2075839    0.2159610    -0.9612102    0.3364465     0.8125451
   stres         1.2621319    0.2527874     4.9928592    0.0000006     3.5329455
   wsparcie     -0.5176446    0.1591013    -3.2535525    0.0011397     0.5959226
 ─────────────────────────────────────────────────────────────────────────────────
   Note. Estimates represent the log odds of "konsultacja = tak" vs.
   "konsultacja = nie"
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv. Rysunki przygotowano w pakiecie ggplot2 (zapis SVG: svglite); krzywą ROC i wykres progów policzono pakietem ROCR (z niego korzysta jmv), a krzywą prawdopodobieństwa – pakietem emmeans. W pracy podaj wersję jamovi, której używasz.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files (R package version 2.5.5) [Computer software]. https://CRAN.R-project.org/package=haven
- ROCR (wersja 1.0.12): Sing, T., Sander, O., Beerenwinkel, N., & Lengauer, T. (2005). ROCR: Visualizing classifier performance in R. Bioinformatics, 21(20), 3940–3941. https://doi.org/10.1093/bioinformatics/bti623
- emmeans (wersja 2.0.2): Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R package version 2.0.2) [Computer software]. https://doi.org/10.32614/CRAN.package.emmeans
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device (R package version 2.2.2) [Computer software]. https://doi.org/10.32614/CRAN.package.svglite
Najczęstsze błędy w regresji logistycznej w jamovi
- Nie ten poziom referencyjny zmiennej zależnej – przeczytaj notę pod tabelą Model Coefficients.
- Zmienna nominalna o 3+ kategoriach w Covariates zamiast w Factors.
- Cztery pseudo-R² bez nazw albo „model wyjaśnia 22% wariancji”.
- Sama ogólna trafność klasyfikacji bez czułości.
- OR opisany jak ryzyko względne albo zapis „.000” w miejscu p < .001.
Ustawienia modelu i opis wyników sprawdzimy w ramach oferty analizy statystyczne dla studentów. Poprzedni wpis serii opisuje korelację i regresję liniową w jamovi, a następny – testy nieparametryczne w jamovi.
Najczęstsze pytania
Gdzie w jamovi jest regresja logistyczna?
Na pasku Analyses wybierz Regression, a w grupie Logistic Regression pozycję 2 Outcomes (Binomial). Dla wyniku o kilku kategoriach są N Outcomes i Ordinal Outcomes (The jamovi project, b.d.).
Jak zmienić poziom referencyjny w regresji logistycznej w jamovi?
Rozwiń sekcję Reference Levels i dla zmiennej zależnej oraz każdego czynnika wybierz Reference Level. Domyślnie jest to pierwszy poziom z listy w edytorze zmiennej. Model opisuje szanse drugiego poziomu zmiennej zależnej, co potwierdza nota pod tabelą Model Coefficients.
Dlaczego jamovi pokazuje ilorazy szans odwrotne, niż się spodziewałem?
Najczęściej poziomem referencyjnym zmiennej zależnej jest wynik, który chcesz przewidywać, np. „tak”. Wtedy model opisuje szanse wyniku „nie” i każdy OR jest odwrotnością oczekiwanego (w przykładzie 0.283 zamiast 3.537). Zmień poziom w Reference Levels.
Czy jamovi ma test Hosmera–Lemeshowa?
Okno Binomial Logistic Regression go nie zawiera (Selker i in., 2025). Dopasowanie opiszesz testem całego modelu, pseudo-R² i AUC, a jeśli test Hosmera–Lemeshowa jest wymagany, policz go w R albo w SPSS.
Jaki cut-off ustawić w tabeli klasyfikacji w jamovi?
Domyślny próg 0.5 przy rzadkim wyniku daje niską czułość: w przykładzie 22.2% przy 25% osób z wynikiem „tak”. Próg 0.25 dał czułość 69.8% i swoistość 68.8%. Wybór progu zależy od kosztu pomyłek, a zdolność rozróżniania niezależną od progu opisuje AUC.
Powiązane hasła
Przeczytaj też
Regresja logistyczna krok po kroku
Ilorazy szans i prawdopodobieństwa przewidywane, założenia, separacja, pseudo-R², AUC i kalibracja, tabela APA – na danych do pobrania z kodem R.
Czytaj →PoradnikRegresja logistyczna w SPSS
Binary Logistic krok po kroku: kategoria odniesienia, Hosmer–Lemeshow, pseudo-R², tabela klasyfikacji, Exp(B) z przedziałami ufności i zapis APA.
Czytaj →PoradnikKrzywa ROC i punkt odcięcia krok po kroku
AUC z 95% CI, tabela progów, trzy reguły wyboru progu, czułość i swoistość z przedziałami oraz test DeLonga dla dwóch skal – w R z pakietem pROC.
Czytaj →Masz regresję logistyczną w jamovi i nie wiesz, czy dobrze ją ustawiłeś(-aś)?
Sprawdzimy Twój plik .omv, typy zmiennych, poziomy referencyjne i opcje modelu oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Menard, S. (2000). Coefficients of determination for multiple logistic regression analysis. The American Statistician, 54(1), 17–24. https://doi.org/10.1080/00031305.2000.10474502
- Peng, C.-Y. J., Lee, K. L., & Ingersoll, G. M. (2002). An introduction to logistic regression analysis and reporting. The Journal of Educational Research, 96(1), 3–14. https://doi.org/10.1080/00220670209598786
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (R package version 2.7.7) – Binomial Logistic Regression (logRegBin): definicja analizy, kod R i polskie tłumaczenie etykiet. https://github.com/jamovi/jmv/blob/master/jamovi/logregbin.a.yaml ● Otwarty dostęp: pełny tekst
- The jamovi project. (b.d.). Logistic Regression; From SPSS to jamovi: Logistic Regression; Data Variables. jamovi docs. Pobrano 7 listopada 2026 z https://docs.jamovi.org/analyses/jg_43_regression-logistic.html ● Otwarty dostęp: pełny tekst
- Tjur, T. (2009). Coefficients of determination in logistic regression models—A new proposal: The coefficient of discrimination. The American Statistician, 63(4), 366–372. https://doi.org/10.1198/tast.2009.08210
Cytowania BibTeX
@article{hanley1982meaning, author={Hanley, James A. and McNeil, Barbara J.}, title={{The meaning and use of the area under a receiver operating characteristic (ROC) curve}}, journal={Radiology}, year={1982}, volume={143}, number={1}, pages={29--36}, doi={10.1148/radiology.143.1.7063747}}@article{menard2000coefficients, author={Menard, Scott}, title={{Coefficients of determination for multiple logistic regression analysis}}, journal={The American Statistician}, year={2000}, volume={54}, number={1}, pages={17--24}, doi={10.1080/00031305.2000.10474502}}@article{peng2002introduction, author={Peng, Chao-Ying Joanne and Lee, Kuk Lida and Ingersoll, Gary M.}, title={{An introduction to logistic regression analysis and reporting}}, journal={The Journal of Educational Research}, year={2002}, volume={96}, number={1}, pages={3--14}, doi={10.1080/00220670209598786}}@misc{selker2025logregbin, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) – Binomial Logistic Regression (logRegBin): definicja analizy, kod R i polskie tłumaczenie etykiet}}, year={2025}, url={https://github.com/jamovi/jmv/blob/master/jamovi/logregbin.a.yaml}}@misc{jamovindlogreg, author={{The jamovi project}}, title={{Logistic Regression; From SPSS to jamovi: Logistic Regression; Data Variables}}, howpublished={jamovi docs}, url={https://docs.jamovi.org/analyses/jg_43_regression-logistic.html}}@article{tjur2009coefficients, author={Tjur, Tue}, title={{Coefficients of determination in logistic regression models—A new proposal: The coefficient of discrimination}}, journal={The American Statistician}, year={2009}, volume={63}, number={4}, pages={366--372}, doi={10.1198/tast.2009.08210}}