Gdzie są testy nieparametryczne w jamovi
jamovi nie ma osobnego menu z testami nieparametrycznymi. Każdy test rangowy siedzi obok swojego odpowiednika parametrycznego: test Manna–Whitneya i test Wilcoxona to pola w oknach testu t, a testy Kruskala–Wallisa i Friedmana są w grupie ANOVA, w podgrupie Non-Parametric. Takie zestawienie podaje porównanie SPSS i jamovi w dokumentacji programu (The jamovi project, b.d.-a). Etykiety okien sprawdziliśmy w plikach definicji analiz pakietu jmv (The jamovi project, b.d.-b; Selker i in., 2025). Podajemy je po angielsku. W polskiej wersji językowej interfejsu nazwy mogą brzmieć inaczej.
| Schemat | Test | Ścieżka w Analyses | Co zaznaczyć |
|---|---|---|---|
| 2 grupy niezależne | Mann–Whitney | T-Tests → Independent Samples T-Test | Mann-Whitney U, Mean difference, Effect size |
| 2 pomiary tych samych osób | Wilcoxon | T-Tests → Paired Samples T-Test | Wilcoxon rank, Mean difference, Effect size |
| 3+ grupy niezależne | Kruskal–Wallis | ANOVA → Non-Parametric → One-Way ANOVA | ε², DSCF pairwise comparisons (lub Dunn's) |
| 3+ pomiary tych samych osób | Friedman | ANOVA → Non-Parametric → Repeated Measures ANOVA | Pairwise comparisons (Durbin-Conover), Descriptives |
| związek dwóch zmiennych | Spearman | Regression → Correlation Matrix | Spearman, Report significance, N |
Podstawy programu opisuje poradnik jamovi krok po kroku. Kiedy sięgać po test rangowy, a kiedy wystarczy test Welcha, wyjaśnia poradnik o testach nieparametrycznych, a test do hipotezy dobierzesz w kreatorze wyboru testu. Te same cztery testy w SPSS opisuje wpis testy nieparametryczne w SPSS.
Przykład i pliki do pobrania
Sześćdziesiąt trzy osoby studiujące psychologię, pedagogikę i ekonomię (po 21) wypełniły pięciopozycyjną skalę lęku przed statystyką (suma 5–25) trzy razy: na początku semestru (lek_t1), tydzień przed kolokwium (lek_t2) i po egzaminie (lek_t3). Podały też tryb studiów (30 stacjonarnych, 33 niestacjonarnych) i liczbę godzin nauki statystyki w tygodniu (godziny). Dane są symulowane. Pobierz plik CSV albo ten sam zbiór jako plik .sav z etykietami zmiennych i wartości. jamovi otworzy oba formaty.
Przygotowanie danych
Ustaw kierunek i tryb jako Nominal, a godziny i trzy pomiary lęku jako Continuous. Pola zmiennych zależnych w oknach testu t przyjmują tylko zmienne liczbowe, a zmienna grupująca musi być czynnikiem (The jamovi project, b.d.-b). Kodu grupy wczytanego jako Continuous nie przeciągniesz do Grouping Variable. Pomiary powtarzane muszą leżeć w osobnych kolumnach, jedna osoba to jeden wiersz (format szeroki). Kolejność poziomów kierunek ustal w edytorze zmiennej. W tej kolejności pojawią się wiersze tabel porównań parami. Jak ustawić typy, etykiety i braki danych, opisuje wpis przygotowanie danych i statystyki opisowe w jamovi.
Do opisu testów rangowych potrzebujesz median i kwartyli, a nie średnich. W Exploration → Descriptives przeciągnij godziny do Variables, a tryb do Split by. Na karcie Statistics zaznacz Median i Percentiles z wartościami 25,75 (The jamovi project, b.d.-b). Godziny nauki są wyraźnie skośne: test Shapiro–Wilka dał p < .001 w obu grupach, a pojedyncza osoba uczy się 25.3 godziny tygodniowo. Rozkład obejrzyj też na wykresie.
Test Manna–Whitneya: dwie grupy
Pytanie: czy osoby studiujące stacjonarnie uczą się statystyki dłużej niż niestacjonarne? Wybierz Analyses → T-Tests → Independent Samples T-Test. Przeciągnij godziny do Dependent Variables, a tryb do Grouping Variable. W części Tests odznacz Student's i zaznacz Mann-Whitney U. W części Additional Statistics zaznacz Mean difference z Confidence interval, Effect size i Descriptives (The jamovi project, b.d.-b).
| Statistic | p | Mean difference | 95% CI Lower | 95% CI Upper | Effect Size | |||
|---|---|---|---|---|---|---|---|---|
| godziny | Mann-Whitney U | 324.00 | .019 | 1.30 | 0.20 | 2.90 | Rank biserial correlation | −0.35 |
Jak czytać tabelę. U = 324.00 to mniejsza z dwóch statystyk U. Wartość p = .019 pochodzi z przybliżenia normalnego, bo jmv wywołuje test z opcją exact = FALSE (The jamovi project, b.d.-b). Kolumna Mean difference przy teście Manna–Whitneya nie zawiera różnicy średnich. To estymator Hodgesa–Lehmanna, czyli mediana różnic między wszystkimi parami osób z dwóch grup: 1.30 godziny, 95% CI [0.20, 2.90]. Mediany wyniosły 3.75 [1.78; 7.85] i 2.10 [1.10; 4.30] godziny (rysunek 1).
Uwaga na znak efektu. jamovi podał korelację rangowo-biseryjną −0.35, choć to grupa 1 (stacjonarni) ma wyższe wartości. W kodzie jmv 2.7.7 wynosi ona 1 − 2U1/(n1n2), gdzie U1 liczy pary, w których wygrywa grupa 1. Ujemny znak oznacza więc przewagę grupy 1. Przy konwencji r = f − u, w której f to odsetek par zgodnych z hipotezą (Kerby, 2014), a hipoteza mówi o przewadze osób stacjonarnych, wynik to rrb = .35, 95% CI [.07, .57]. Taką wartość i przedział daje pakiet effectsize w R; jamovi przedziału nie podaje. Kierunek zawsze opisuj słowami („wyższe wartości u…”), a nie samym znakiem.
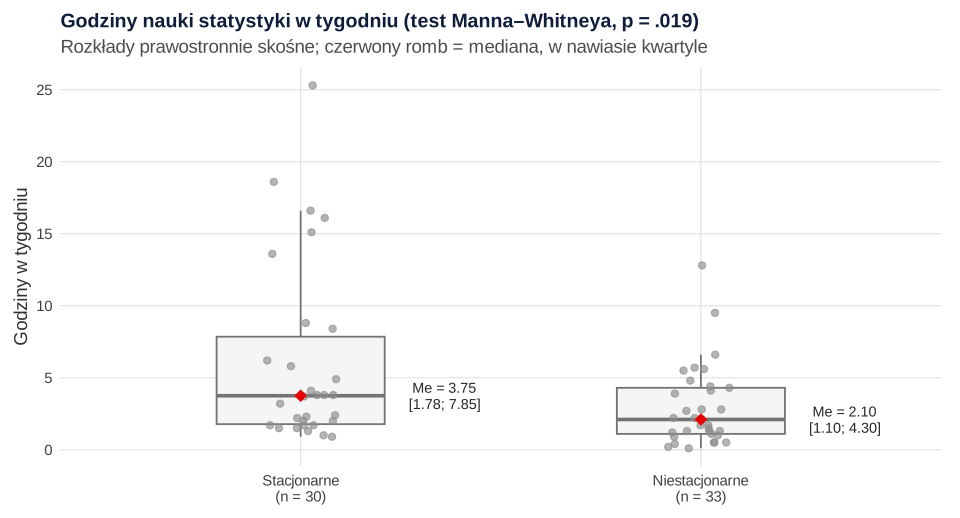
Test Manna–Whitneya nie jest testem median: porównuje, jak często wartości jednej grupy przewyższają wartości drugiej. Test Welcha w tym samym oknie omawia wpis test t w jamovi.
Test Kruskala–Wallisa i porównania parami
Pytanie: czy lęk na początku semestru różni się między kierunkami? Wybierz Analyses → ANOVA → Non-Parametric → One-Way ANOVA (podpis Kruskal-Wallis). Przeciągnij lek_t1 do Dependent Variables, a kierunek do Grouping Variable. Zaznacz ε² w części Effect Size, a w części Post Hoc Tests – DSCF pairwise comparisons. W definicji analizy z jmv 2.7.7 jest też druga opcja: Dunn's pairwise comparisons (The jamovi project, b.d.-b). Jeśli Twoja wersja programu jej nie ma, użyj DSCF.
| χ² | df | p | ε² | |
|---|---|---|---|---|
| lek_t1 | 17.51 | 2 | < .001 | 0.28 |
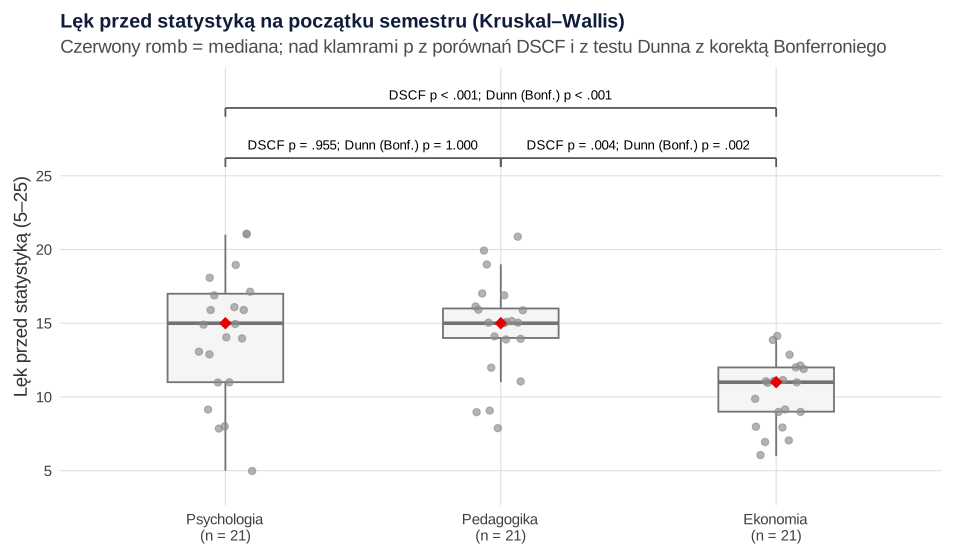
jamovi oznacza statystykę H jako χ², bo przy większych grupach ma ona w przybliżeniu rozkład χ² z k − 1 stopniami swobody. Wielkość efektu ε² = .28 jmv liczy wzorem H(n + 1)/(n² − 1), co daje to samo co H/(n − 1). Mediany wyniosły 15 [11; 17] na psychologii, 15 [14; 16] na pedagogice i 11 [9; 12] na ekonomii.
| DSCF W | DSCF p | Dunn z | p(unadj) | p(Bonferroni) | ||
|---|---|---|---|---|---|---|
| psychologia | pedagogika | 0.41 | .955 | −0.46 | .642 | 1.000 |
| psychologia | ekonomia | −4.51 | .004 | 3.37 | < .001 | .002 |
| pedagogika | ekonomia | −5.65 | < .001 | 3.83 | < .001 | < .001 |
DSCF a test Dunna. Procedura Dwassa–Steela–Critchlowa–Flignera (DSCF) dla każdej pary ranguje od nowa tylko obserwacje tych dwóch grup. Statystykę porównuje z rozkładem rozstępu dla wszystkich k grup, więc podane p są już skorygowane na liczbę porównań. Tak wynika z kodu jmv 2.7.7 (The jamovi project, b.d.-b). Procedura kontroluje błąd dla całego zestawu porównań, ale przy bardzo małych i nierównych grupach bywa zawodna (Spurrier, 2006). Test Dunna korzysta z rang nadanych wspólnie wszystkim grupom w teście Kruskala–Wallisa (Dunn, 1964). jamovi pokazuje dla niego p bez korekty i z korektą Bonferroniego. W pracy przepisz tylko tę drugą kolumnę. Znak W i z zależy od kolejności grup w wierszu, dlatego kierunek odczytuj z median. Tu obie metody prowadzą do tego samego wniosku (rysunek 2). Wybierz jedną przed analizą i nazwij ją w tekście.
Test Wilcoxona: dwa pomiary
Pytanie: czy lęk wzrósł od początku semestru do tygodnia przed kolokwium? Wybierz Analyses → T-Tests → Paired Samples T-Test i przeciągnij lek_t1 oraz lek_t2 do Paired Variables. W części Tests odznacz Student's i zaznacz Wilcoxon rank. Dodaj Mean difference z przedziałem ufności, Effect size i Descriptives (The jamovi project, b.d.-b).
| Statistic | p | Mean difference | 95% CI Lower | 95% CI Upper | Effect Size | ||||
|---|---|---|---|---|---|---|---|---|---|
| lek_t1 | lek_t2 | Wilcoxon W | 190.50a | < .001 | −2.50 | −3.00 | −2.00 | Rank biserial correlation | −0.78 |
| a 4 pair(s) of values were tied | |||||||||
W = 190.50 to suma rang dodatnich różnic lek_t1 − lek_t2. Mała wartość oznacza, że różnice są głównie ujemne, czyli lęk zwykle rósł. Wzrost wystąpił u 77.8% osób. Przypis „tied” oznacza cztery osoby bez zmiany wyniku; zerowe różnice nie wchodzą do testu, więc liczy się on na 59 parach. Pole Mean difference zawiera tu estymator Hodgesa–Lehmanna, czyli medianę średnich ze wszystkich par różnic: −2.50 punktu, 95% CI [−3.00, −2.00]. Korelacja rangowo-biseryjna dla par −.78, 95% CI [−.87, −.65] (przedział z R), ma tę samą orientację: ujemna oznacza wyższe wartości w drugim pomiarze.
Test Friedmana i porównania Durbina–Conovera
Pytanie: jak zmieniał się lęk w trzech pomiarach? Wybierz Analyses → ANOVA → Non-Parametric → Repeated Measures ANOVA (podpis Friedman). Przeciągnij trzy kolumny do pola Measures i zaznacz Pairwise comparisons (Durbin-Conover) oraz Descriptives. Opcja Descriptive plot rysuje wykres z wyborem Means albo Medians (The jamovi project, b.d.-b).
| Tabela | Porównanie | Statistic | df | p | p po korekcie Holma |
|---|---|---|---|---|---|
| Friedman | χ² | 32.94 | 2 | < .001 | |
| Durbin-Conover | lek_t1 – lek_t2 | 6.10 | < .001 | < .001 | |
| Durbin-Conover | lek_t1 – lek_t3 | 0.80 | .424 | .424 | |
| Durbin-Conover | lek_t2 – lek_t3 | 5.29 | < .001 | < .001 |
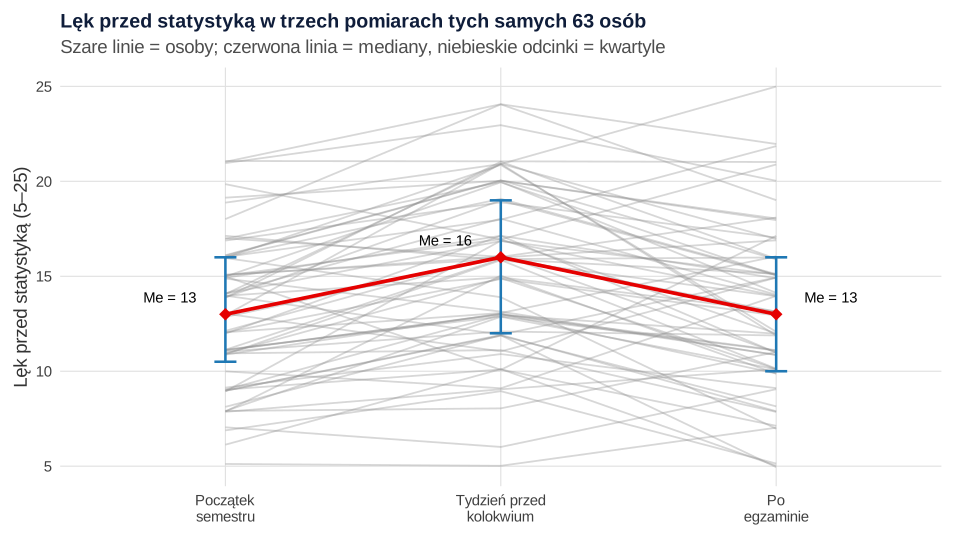
Ważne: w jmv 2.7.7 p z porównań Durbina–Conovera są bez korekty na liczbę porównań. Kod analizy wywołuje funkcję z opcją p.adjust = "none" (The jamovi project, b.d.-b), a okno nie ma opcji korekty. Durbin–Conover to porównanie sum rang podobne do testu LSD Fishera. W symulacjach procedury typu LSD na rangach okazały się najbardziej liberalne (Pereira i in., 2015). Dlatego popraw p sam, np. poprawką Holma w R albo w arkuszu. Wniosek się nie zmienia: lęk rośnie przed kolokwium i wraca do poziomu wyjściowego po egzaminie (mediany 13, 16 i 13; rysunek 3).
Okno Friedmana nie podaje wielkości efektu. Policz W Kendalla ze wzoru χ²/(n(k − 1)) = 32.94/(63 × 2) = .26. Więcej wzorów i ich interpretację znajdziesz we wpisie wielkość efektu w testach nieparametrycznych.
Korelacja Spearmana
Wybierz Analyses → Regression → Correlation Matrix, przeciągnij godziny i lek_t2, odznacz Pearson i zaznacz Spearman, a także Report significance i N. Możesz dodać Kendall's tau-b. Opcja Confidence intervals dotyczy tylko r Pearsona (The jamovi project, b.d.-b), więc dla ρ jamovi przedziału nie poda. Wynik: ρ Spearmana = −.33, p = .008 (df = 61), τb = −.23, p = .009.
Pearsona i pozostałe opcje macierzy opisuje wpis korelacja i regresja w jamovi.
Wielkość efektu: co daje jamovi, a co liczysz sam
| Test | W oknie jamovi | Co dopisać |
|---|---|---|
| Mann–Whitney | korelacja rangowo-biseryjna (bez CI; znak odwrotny do zwykłej konwencji) | CI, kierunek słowami |
| Wilcoxon | korelacja rangowo-biseryjna dla par (bez CI) | CI, liczba par bez zmiany |
| Kruskal–Wallis | ε² | – |
| Friedman | brak | W Kendalla = χ²/(n(k − 1)) |
| Spearman | ρ (sam jest miarą efektu, bez CI) | CI, jeśli wymaga go promotor |
Korelacja rangowo-biseryjna ma prostą interpretację: to różnica między odsetkiem par „zgodnych z hipotezą” a odsetkiem par „przeciwnych” (Kerby, 2014). Wartość .35 oznacza o 35 punktów procentowych więcej par z przewagą osoby stacjonarnej niż par odwrotnych. Gotowe zdania do pracy złożysz też w generatorze opisu wyników APA.
Te same testy w R (pakiet jmv)
Pakiet jmv zawiera analizy jamovi, więc poniższy kod daje te same tabele co program. Samego jamovi tu nie uruchamialiśmy – liczby w tekście pochodzą z tego kodu. Tabele są szerokie: przewiń je w poziomie.
Mann–Whitney, Kruskal–Wallis, Wilcoxon, Friedman i Spearman funkcjami jmv
R
# Testy nieparametryczne jak w jamovi, wykonane w R pakietem jmv (jamovi korzysta z tych samych funkcji)
library(jmv)
dane <- read.csv("testy-nieparametryczne-w-jamovi-dane.csv")
dane$kierunek <- factor(dane$kierunek, levels = c("psychologia", "pedagogika", "ekonomia"))
dane$tryb <- factor(dane$tryb, levels = c("stacjonarne", "niestacjonarne"))

# 0. Exploration → Descriptives: mediany i kwartyle (Split by: tryb, potem kierunek)
descriptives(data = dane, vars = "godziny", splitBy = "tryb", mean = FALSE, sd = FALSE,
             median = TRUE, pc = TRUE, pcValues = "25,75", sw = TRUE)
descriptives(data = dane, vars = "lek_t1", splitBy = "kierunek", mean = FALSE, sd = FALSE,
             median = TRUE, pc = TRUE, pcValues = "25,75", min = FALSE, max = FALSE)

# 1. T-Tests → Independent Samples T-Test: tylko Mann-Whitney U, różnica i wielkość efektu
ttestIS(data = dane, vars = "godziny", group = "tryb", students = FALSE, mann = TRUE,
        meanDiff = TRUE, ci = TRUE, effectSize = TRUE, desc = TRUE)
# Ta sama korelacja rangowo-biseryjna z 95% CI (znak: dodatni = wyższe wartości w grupie 1)
effectsize::rank_biserial(godziny ~ tryb, data = dane)

# 2. ANOVA → Non-Parametric → One-Way ANOVA (Kruskal-Wallis): ε², DSCF i Dunn
anovaNP(data = dane, deps = "lek_t1", group = "kierunek", es = TRUE, pairs = TRUE, pairsDunn = TRUE)

# 3. T-Tests → Paired Samples T-Test: tylko Wilcoxon rank, różnica i wielkość efektu
ttestPS(data = dane, pairs = list(list(i1 = "lek_t1", i2 = "lek_t2")), students = FALSE,
        wilcoxon = TRUE, meanDiff = TRUE, ci = TRUE, effectSize = TRUE, desc = TRUE)
effectsize::rank_biserial(dane$lek_t1, dane$lek_t2, paired = TRUE)

# 4. ANOVA → Non-Parametric → Repeated Measures ANOVA (Friedman): Durbin-Conover i opis
# (jmv 2.7.7 woła starą nazwę funkcji z pakietu PMCMR – ostrzeżenie o tym pomijamy)
fr <- suppressWarnings(anovaRMNP(data = dane, measures = c("lek_t1", "lek_t2", "lek_t3"),
                                 pairs = TRUE, desc = TRUE))
fr
# p porównań Durbina-Conovera są nieskorygowane – korekta Holma dla trzech par
signif(p.adjust(fr$comp$asDF$p, method = "holm"), 3)
# W Kendalla nie ma w oknie Friedmana – liczymy ją z χ²: W = χ² / (n(k − 1))
round(fr$table$asDF$stat / (nrow(dane) * (3 - 1)), 3)

# 5. Regression → Correlation Matrix: Spearman (i Kendall's tau-b)
corrMatrix(data = dane, vars = c("godziny", "lek_t2"), pearson = FALSE, spearman = TRUE,
           kendall = TRUE, sig = TRUE, n = TRUE)
packageVersion("jmv")
Wynik w R
 DESCRIPTIVES

 Descriptives
 ──────────────────────────────────────────────────
                      tryb              godziny
 ──────────────────────────────────────────────────
   N                  stacjonarne              30
                      niestacjonarne           33
   Missing            stacjonarne               0
                      niestacjonarne            0
   Median             stacjonarne        3.750000
                      niestacjonarne     2.100000
   Minimum            stacjonarne       0.9000000
                      niestacjonarne    0.1000000
   Maximum            stacjonarne        25.30000
                      niestacjonarne     12.80000
   Shapiro-Wilk W     stacjonarne       0.7631069
                      niestacjonarne    0.8237666
   Shapiro-Wilk p     stacjonarne       0.0000149
                      niestacjonarne    0.0000948
   25th percentile    stacjonarne        1.775000
                      niestacjonarne     1.100000
   75th percentile    stacjonarne        7.850000
                      niestacjonarne     4.300000
 ──────────────────────────────────────────────────


 DESCRIPTIVES

 Descriptives
 ──────────────────────────────────────────────
                      kierunek       lek_t1
 ──────────────────────────────────────────────
   N                  psychologia          21
                      pedagogika           21
                      ekonomia             21
   Missing            psychologia           0
                      pedagogika            0
                      ekonomia              0
   Median             psychologia          15
                      pedagogika           15
                      ekonomia             11
   25th percentile    psychologia    11.00000
                      pedagogika     14.00000
                      ekonomia       9.000000
   75th percentile    psychologia    17.00000
                      pedagogika     16.00000
                      ekonomia       12.00000
 ──────────────────────────────────────────────


 INDEPENDENT SAMPLES T-TEST

 Independent Samples T-Test
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                                Statistic    p            Mean difference    SE difference    Lower        Upper                                    Effect Size
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   godziny    Mann-Whitney U     324.0000    0.0188813           1.299955                     0.2000602    2.899977    Rank biserial correlation     -0.3454545
 ────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Hₐ μ <sub>stacjonarne</sub> ≠ μ <sub>niestacjonarne</sub>


 Group Descriptives
 ────────────────────────────────────────────────────────────────────────────────────
              Group             N     Mean        Median      SD          SE
 ────────────────────────────────────────────────────────────────────────────────────
   godziny    stacjonarne       30    6.133333    3.750000    6.362516     1.161631
              niestacjonarne    33    2.945455    2.100000    2.817034    0.4903827
 ────────────────────────────────────────────────────────────────────────────────────

r (rank biserial) |       95% CI
--------------------------------
0.35              | [0.07, 0.57]

 ONE-WAY ANOVA (NON-PARAMETRIC)

 Kruskal-Wallis
 ──────────────────────────────────────────────────────
             χ²          df    p            ε²
 ──────────────────────────────────────────────────────
   lek_t1    17.50854     2    0.0001578    0.2823958
 ──────────────────────────────────────────────────────


 DWASS-STEEL-CRITCHLOW-FLIGNER PAIRWISE COMPARISONS

 Pairwise comparisons - lek_t1
 ────────────────────────────────────────────────────────
                                W             p
 ────────────────────────────────────────────────────────
   psychologia    pedagogika     0.4114429    0.9546181
   psychologia    ekonomia      -4.5063218    0.0041214
   pedagogika     ekonomia      -5.6521733    0.0001901
 ────────────────────────────────────────────────────────


 DUNN'S PAIRWISE COMPARISONS

 Pairwise comparisons - lek_t1
 ──────────────────────────────────────────────────────────────────────────
                                z             p-(unadj)    p-(Bonferroni)
 ──────────────────────────────────────────────────────────────────────────
   psychologia    pedagogika    -0.4649548    0.6419638         1.0000000
   psychologia    ekonomia       3.3688092    0.0007549         0.0022648
   pedagogika     ekonomia       3.8337640    0.0001262         0.0003786
 ──────────────────────────────────────────────────────────────────────────


 PAIRED SAMPLES T-TEST

 Paired Samples T-Test
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                                     Statistic     p            Mean difference    SE difference    Lower        Upper                                     Effect Size
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   lek_t1    lek_t2    Wilcoxon W    190.5000 ᵃ    0.0000001          -2.500089        0.3422953    -3.000010    -1.999938    Rank biserial correlation     -0.7847458
 ───────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
   Note. Hₐ μ <sub>Measure 1 - Measure 2</sub> ≠ 0
   ᵃ 4 pair(s) of values were tied


 Descriptives
 ───────────────────────────────────────────────────────────────
             N     Mean        Median    SD          SE
 ───────────────────────────────────────────────────────────────
   lek_t1    63    13.03175        13    3.906026    0.4921130
   lek_t2    63    15.34921        16    4.392658    0.5534229
 ───────────────────────────────────────────────────────────────

r (rank biserial) |         95% CI
----------------------------------
-0.78             | [-0.87, -0.65]

 REPEATED MEASURES ANOVA (NON-PARAMETRIC)

 Friedman
 ────────────────────────────────
   χ²          df    p
 ────────────────────────────────
   32.93562     2    < .0000001
 ────────────────────────────────


 Pairwise Comparisons (Durbin-Conover)
 ────────────────────────────────────────────────────
                            Statistic    p
 ────────────────────────────────────────────────────
   lek_t1    -    lek_t2    6.0958040    < .0000001
   lek_t1    -    lek_t3    0.8020795     0.4240415
   lek_t2    -    lek_t3    5.2937246     0.0000005
 ────────────────────────────────────────────────────


 Descriptives
 ────────────────────────────────
             Mean        Median
 ────────────────────────────────
   lek_t1    13.03175        13
   lek_t2    15.34921        16
   lek_t3    13.33333        13
 ────────────────────────────────

[1] 3.82e-08 4.24e-01 1.05e-06
[1] 0.261

 CORRELATION MATRIX

 Correlation Matrix
 ─────────────────────────────────────────────────────────
                                 godziny       lek_t2
 ─────────────────────────────────────────────────────────
   godziny    Spearman's rho              —
              df                          —
              p-value                     —
              Kendall's Tau B             —
              p-value                     —
              N                           —

   lek_t2     Spearman's rho     -0.3297071            —
              df                         61            —
              p-value             0.0083201            —
              Kendall's Tau B    -0.2338591            —
              p-value             0.0090247            —
              N                          63            —
 ─────────────────────────────────────────────────────────

[1] ‘2.7.7’
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 z pakietem jmv, który do porównań Durbina–Conovera korzysta z pakietu PMCMR. Przedziały ufności dla korelacji rangowo-biseryjnej policzono pakietem effectsize, plik .sav zapisano pakietem haven, a rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- jmv (wersja 2.7.7): Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses [R package]. https://doi.org/10.32614/CRAN.package.jmv
- PMCMR (wersja 4.4): Pohlert, T. (2014). The pairwise multiple comparison of mean ranks package (PMCMR) [R package]. https://CRAN.R-project.org/package=PMCMR
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Typowe błędy w jamovi
- Zostawienie Student's obok testu rangowego. Dwa testy w jednej tabeli kuszą, by wybrać „lepszy” wynik.
- Przepisanie „Mean difference” jako różnicy średnich. W wierszu testu rangowego to estymator Hodgesa–Lehmanna.
- Odczyt kierunku ze znaku korelacji rangowo-biseryjnej. Dla testu Manna–Whitneya znak w jmv 2.7.7 jest odwrotny do zwykłej konwencji. Kierunek ustal z median.
- Nieskorygowane p po teście Friedmana. Durbin–Conover w jamovi nie ma korekty. Dodaj ją sam, a w tekście nazwij metodę.
- Kolumna p(unadj) z testu Dunna w pracy. Przepisuj p(Bonferroni) albo wyniki DSCF.
- Dane w formacie długim przy Friedmanie i Wilcoxonie. jamovi potrzebuje osobnych kolumn dla każdego pomiaru.
Rangi, statystyki i wielkości efektu przećwiczysz na przykładach w zbiorze testy nieparametryczne – zadania z rozwiązaniami. Parametryczne odpowiedniki tych analiz opisuje wpis ANOVA w jamovi.
Najczęstsze pytania
Gdzie w jamovi znajdę test Manna–Whitneya i test Wilcoxona?
W oknach testu t. Test Manna–Whitneya to pole Mann-Whitney U w Analyses → T-Tests → Independent Samples T-Test, a test Wilcoxona to pole Wilcoxon rank w Paired Samples T-Test. Odznacz wtedy Student's i zaznacz Effect size oraz Mean difference z przedziałem ufności.
Czym różnią się porównania DSCF od testu Dunna w jamovi?
DSCF (Dwass–Steel–Critchlow–Fligner) ranguje od nowa obserwacje każdej pary grup i podaje p już skorygowane na liczbę porównań. Test Dunna korzysta z rang wspólnych dla wszystkich grup, a jamovi pokazuje dla niego p bez korekty i z korektą Bonferroniego. W przykładzie obie metody dały ten sam wniosek: ekonomia różniła się od psychologii (DSCF p = .004) i pedagogiki (p < .001).
Czy porównania Durbina–Conovera po teście Friedmana w jamovi są skorygowane?
Nie. W jmv 2.7.7 kod analizy przekazuje p.adjust = "none", a okno nie ma opcji korekty. Popraw p sam, np. metodą Holma (w R: p.adjust(p, method = "holm")), i nazwij metodę w tekście pracy.
Dlaczego korelacja rangowo-biseryjna w jamovi ma ujemny znak, choć grupa 1 ma wyższe wyniki?
W teście Manna–Whitneya jmv 2.7.7 liczy ją jako 1 − 2U1/(n1n2), więc przewaga grupy 1 daje wartość ujemną. W przykładzie jamovi podał −0.35, a przy konwencji „dodatnia = przewaga grupy 1” wynik to .35, 95% CI [.07, .57]. Kierunek opisuj słowami na podstawie median.
Jak policzyć wielkość efektu dla testu Friedmana w jamovi?
Okno Friedmana jej nie podaje. Policz W Kendalla ze wzoru χ²/(n(k − 1)). W przykładzie χ²(2) = 32.94 dla 63 osób i trzech pomiarów, więc W = 32.94/(63 × 2) = .26.
Powiązane hasła
Przeczytaj też
jamovi krok po kroku
Descriptives, test t Welcha, Correlation Matrix i One-Way ANOVA na jednym zbiorze danych: nazwy opcji z dokumentacji, gotowe zdania APA, kod jmv.
Czytaj →PoradnikTesty nieparametryczne w SPSS
Mann–Whitney, Wilcoxon, Kruskal–Wallis i Friedman w SPSS: stare i nowe okna, tabele Ranks i Test Statistics, porównania parami, wielkość efektu i składnia – z plikiem .sav do pobrania.
Czytaj →PoradnikWielkość efektu w testach nieparametrycznych
r = Z/√N, korelacja rangowo-biseryjna, delta Cliffa, A Varghi–Delaneya, ε² i W Kendalla: co mierzą, jak je przeliczać i podać z CI – z kodem R.
Czytaj →Masz wyniki testów rangowych z jamovi i nie wiesz, co przepisać do pracy?
Sprawdzimy Twój plik .omv, dobór testu i porównań parami, policzymy brakujące wielkości efektu i korekty oraz wyjaśnimy wyniki tak, żebyś umiał(a) je samodzielnie opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- Pereira, D. G., Afonso, A., & Medeiros, F. M. (2015). Overview of Friedman’s test and post-hoc analysis. Communications in Statistics - Simulation and Computation, 44(10), 2636–2653. https://doi.org/10.1080/03610918.2014.931971
- Selker, R., Love, J., & Dropmann, D. (2025). jmv: The 'jamovi' analyses (Version 2.7.7) [R package]. https://CRAN.R-project.org/package=jmv ● Otwarty dostęp: pełny tekst
- Spurrier, J. D. (2006). Additional tables for Steel–Dwass–Critchlow–Fligner distribution-free multiple comparisons of three treatments. Communications in Statistics - Simulation and Computation, 35(2), 441–446. https://doi.org/10.1080/03610910600591834
- The jamovi project. (b.d.-a). Comparison of which analyses are available in SPSS and jamovi. jamovi documentation. https://docs.jamovi.org/spss2jamovi/s2j_Comparison_of_analyses.html ● Otwarty dostęp
- The jamovi project. (b.d.-b). jmv: Definition files of the jamovi analyses (descriptives, anovanp, anovarmnp, ttestis, ttestps, corrmatrix). GitHub repository jamovi/jmv. https://github.com/jamovi/jmv/tree/master/jamovi ● Otwarty dostęp
Cytowania BibTeX
@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@article{pereira2015overview, author={Pereira, Dulce G. and Afonso, Anabela and Medeiros, Fátima Melo}, title={{Overview of Friedman’s test and post-hoc analysis}}, journal={Communications in Statistics - Simulation and Computation}, year={2015}, volume={44}, number={10}, pages={2636--2653}, doi={10.1080/03610918.2014.931971}}@misc{selker2025jmv, author={Selker, Ravi and Love, Jonathon and Dropmann, Damian}, title={{jmv: The 'jamovi' analyses (R package version 2.7.7) [Computer software]}}, year={2025}, url={https://CRAN.R-project.org/package=jmv}}@article{spurrier2006additional, author={Spurrier, John D.}, title={{Additional tables for Steel–Dwass–Critchlow–Fligner distribution-free multiple comparisons of three treatments}}, journal={Communications in Statistics - Simulation and Computation}, year={2006}, volume={35}, number={2}, pages={441--446}, doi={10.1080/03610910600591834}}@misc{jamovindporownanieanaliz, author={{The jamovi project}}, title={{Comparison of which analyses are available in SPSS and jamovi}}, howpublished={jamovi documentation}, year={b.d.-a}, publisher={The jamovi project}, url={https://docs.jamovi.org/spss2jamovi/s2j_Comparison_of_analyses.html}}@misc{jamovindjmvdefinicje, author={{The jamovi project}}, title={{jmv: Definition files of the jamovi analyses (descriptives, anovanp, anovarmnp, ttestis, ttestps, corrmatrix)}}, howpublished={GitHub repository jamovi/jmv}, year={b.d.-b}, publisher={The jamovi project}, url={https://github.com/jamovi/jmv/tree/master/jamovi}}