Testy nieparametryczne – zadania z rozwiązaniami: jak z nich korzystać
Poniżej znajdziesz testy nieparametryczne – zadania z rozwiązaniami krok po kroku, w stylu kolokwium lub egzaminu ze statystyki na 1. i 2. roku. Historyjki pochodzą z pedagogiki, zarządzania i ekonomii, a dane są na tyle małe, że policzysz je kalkulatorem.
Każde zadanie ma stały układ: treść, rozwiązanie krok po kroku, interpretacja w stylu APA i typowy błąd. Wszystkie liczby sprawdziliśmy w R (kod na końcu wpisu); gdy funkcja R różni się od rachunku z tablic, piszemy o tym przy zadaniu.
Co właściwie sprawdzają testy rangowe i jak opisać je w pracy, wyjaśnia poradnik testy nieparametryczne krok po kroku. Wzory są standardowe (King i Minium, 2009).
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | czas rozwiązania zadania przy dwóch metodach nauczania | test U Manna–Whitneya, dokładne p, Ukryt z tablic |
| 2 | ocena zajęć online i stacjonarnych (1–5) | test U z rangami wiązanymi, przybliżenie normalne, r i rrb |
| 3 | degustacja nowej i starej receptury | test znaków (rozkład dwumianowy) |
| 4 | spóźnienia przed i po wprowadzeniu elastycznych godzin | test Wilcoxona dla par, zera i remisy |
| 5 | punkty ze sprawdzianu po trzech formach zajęć | test Kruskala–Wallisa, ε², test Dunna |
| 6 | ocena trzech projektów opakowania przez tych samych klientów | test Friedmana, W Kendalla |
| 7 | staż pracy a ocena przełożonego | korelacja Spearmana z rangami wiązanymi |
| 8 | wyniki z artykułu bez dostępu do danych | wielkość efektu: r = Z/√N, rrb, ε² |
| 9 | czas obsługi klienta z jedną skrajną wartością | test t Welcha a test Manna–Whitneya |
| 10 | sześć krótkich opisów badań | wybór testu: parametryczny czy nieparametryczny |
Wartości krytyczne U i T bierzesz z tablic testów rangowych, a χ² – z tablic rozkładów t, χ² i F. Uwaga na kierunek: w testach Manna–Whitneya i Wilcoxona odrzucasz H0, gdy statystyka jest mniejsza lub równa wartości krytycznej. W testach χ², Kruskala–Wallisa i Friedmana – gdy jest większa. Dane do zadań: testy-nieparametryczne-zadania-dane.csv (format długi: zadanie, osoba, grupa, zmienna, wartość).
Zadanie 1. Test U Manna–Whitneya bez remisów
Treść zadania
Nauczyciel matematyki porównał dwie metody nauczania. Uczniowie uczeni metodą A (z instrukcją krok po kroku, n = 6) rozwiązywali zadanie logiczne w czasie (w minutach): 12, 15, 9, 18, 11, 14. Uczniowie uczeni metodą B (bez instrukcji, n = 7): 19, 16, 22, 13, 25, 20, 17. Czy metody różnią się czasem rozwiązania (α = .05, dwustronnie)?
Rozwiązanie krok po kroku
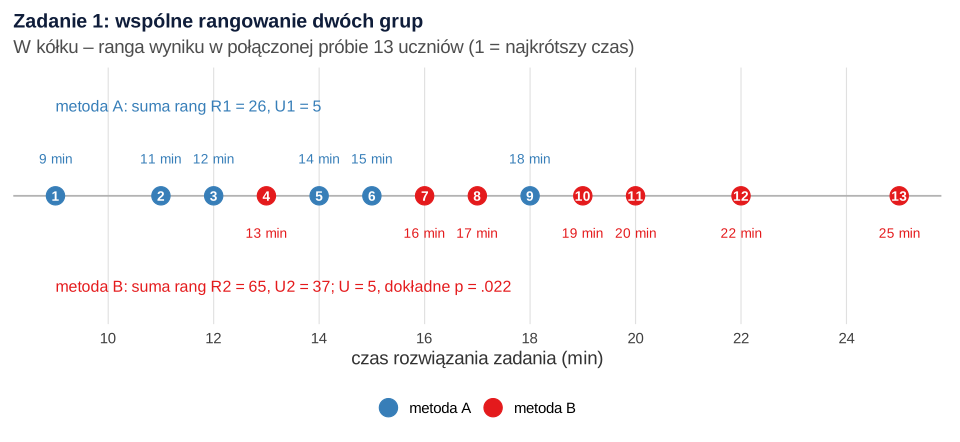
Krok 1. Wspólne rangowanie. Połącz oba zbiory (N = 13) i uporządkuj: 9, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 22, 25. Najkrótszy czas dostaje rangę 1 (rysunek 1). Rangowanie robisz na połączonej próbie, nie osobno w grupach.
Krok 2. Sumy rang. Metoda A: 3 + 6 + 1 + 9 + 2 + 5 = 26. Metoda B: 10 + 7 + 12 + 4 + 13 + 11 + 8 = 65. Kontrola: 26 + 65 = 91 = N(N + 1)/2 = 13 × 14 / 2.
Krok 3. Decyzja. Z tablic dla n1 = 6, n2 = 7 i α = .05 (dwustronnie) Ukryt = 6. Ponieważ 5 ≤ 6, odrzucasz H0. Bez remisów i przy małych grupach R liczy dokładne p = .022 (podaje W = 5, czyli U dla pierwszej grupy).
Krok 4. Opis i wielkość efektu. Mediany: 13.00 min (A) i 19.00 min (B). Korelacja rangowo-biseryjna rrb = (U2 − U1)/(n1n2) = (37 − 5)/42 = .76.
Interpretacja
Mann i Whitney (1947) zaproponowali statystykę U opartą na względnych rangach obu prób i podali tablice prawdopodobieństw dla małych grup; test równoważny opisał wcześniej Wilcoxon (1945). Więcej: test U Manna–Whitneya.
Typowy błąd
Porównanie U z wartością krytyczną „jak w teście t”, czyli odrzucanie H0 przy U większym od Ukryt. W teście U jest odwrotnie.
Zadanie 2. Test U z rangami wiązanymi i przybliżeniem normalnym
Treść zadania
Studenci ocenili zajęcia na skali 1–5 (1 – bardzo źle, 5 – bardzo dobrze). Grupa online (n = 10): 3, 4, 2, 5, 3, 3, 4, 2, 3, 4. Grupa stacjonarna (n = 12): 4, 5, 4, 3, 5, 4, 5, 4, 3, 5, 4, 5. Zmienna jest porządkowa i ma dużo remisów. Porównaj grupy testem Manna–Whitneya (przybliżenie normalne) i oblicz dwie miary efektu.
Rozwiązanie krok po kroku
Krok 1. Rangi średnie dla remisów. W połączonej próbie (N = 22) ocenę 2 ma 2 osoby, ocenę 3 – 6 osób, ocenę 4 – 8 osób, a ocenę 5 – 6 osób. Remisy dostają średnią z zajmowanych miejsc: ocena 2 (miejsca 1–2) – rangę 1.5, ocena 3 (miejsca 3–8) – 5.5, ocena 4 (9–16) – 12.5, ocena 5 (17–22) – 19.5.
Krok 2. Sumy rang i U. Online: 2 × 1.5 + 4 × 5.5 + 3 × 12.5 + 1 × 19.5 = 82. Stacjonarna: 171 (kontrola: 82 + 171 = 253 = 22 × 23 / 2). U1 = 82 − 10 × 11 / 2 = 27, U2 = 120 − 27 = 93.
Krok 3. Średnia i odchylenie U z korektą na remisy. Przy H0 średnia U wynosi n1n2/2 = 60. Remisy zmniejszają wariancję; dla każdej grupy remisów policz t³ − t (t – liczba osób z tym samym wynikiem): 6 + 210 + 504 + 210 = 930.
Krok 4. Decyzja. |Z| = 2.28 > 1.96, więc odrzucasz H0. R domyślnie dodaje poprawkę na ciągłość (p = .025); bez niej daje .023.
Krok 5. Wielkość efektu. r = |Z|/√N = 2.28/√22 = .49. rrb = (U2 − U1)/(n1n2) = (93 − 27)/120 = .55. Kerby (2014) opisuje ją jako prostą różnicę odsetka par zgodnych i niezgodnych z hipotezą: 93/120 − 27/120.
Interpretacja
Obie miary są poprawne, ale nie zamienne – napisz, którą podajesz (zob. wielkość efektu w testach nieparametrycznych).
Typowy błąd
Pominięcie korekty na remisy we wzorze na σU: daje Z = −2.18 zamiast −2.28.
Zadanie 3. Test znaków
Treść zadania
Piekarnia sprawdza nową recepturę chleba. Każda z 15 osób spróbowała dwóch kromek (nowa i stara receptura, w losowej kolejności) i wskazała, która jej bardziej smakuje. 11 osób wolało nową, 3 – starą, a 1 osoba nie miała zdania. Czy osoby częściej wybierały nową recepturę (α = .05, dwustronnie)?
Rozwiązanie krok po kroku
Krok 1. Odrzuć remisy. W teście znaków osoba bez preferencji nie niesie informacji o kierunku. Zostaje n = 14: 11 plusów i 3 minusy.
Krok 2. Rozkład dwumianowy. Przy H0 każda osoba z prawdopodobieństwem 0.5 wybiera nową recepturę. Policz prawdopodobieństwo wyniku tak skrajnego jak 3 minusy lub mniej:
Krok 3. Decyzja. Test dwustronny: p = 2 × 470/16384 = .057 (tak samo binom.test(11, 14)). Ponieważ .057 > .05, nie odrzucasz H0. Przybliżenie normalne (Z = 1.87, p = .061) przy 14 osobach zastąp dokładnym p.
Interpretacja
Test jednostronny dałby p = .029, ale wolno go użyć tylko wtedy, gdy kierunek zapisano przed zebraniem danych.
Typowy błąd
Wliczenie osoby bez zdania do n (11 plusów na 15 osób): binom.test(11, 15) daje p = .118 – remis staje się wtedy ukrytym „minusem” i osłabia test.
Zadanie 4. Test Wilcoxona dla par: zera i remisy
Treść zadania
Firma wprowadziła elastyczne godziny pracy. Dla 10 pracowników zapisano liczbę spóźnień w miesiącu przed zmianą i po niej. Przed: 9, 6, 8, 7, 5, 10, 6, 4, 11, 5. Po: 5, 6, 3, 4, 6, 5, 2, 2, 4, 7 (ta sama kolejność osób). Czy liczba spóźnień się zmieniła? Użyj testu Wilcoxona dla par (α = .05, dwustronnie).
Rozwiązanie krok po kroku
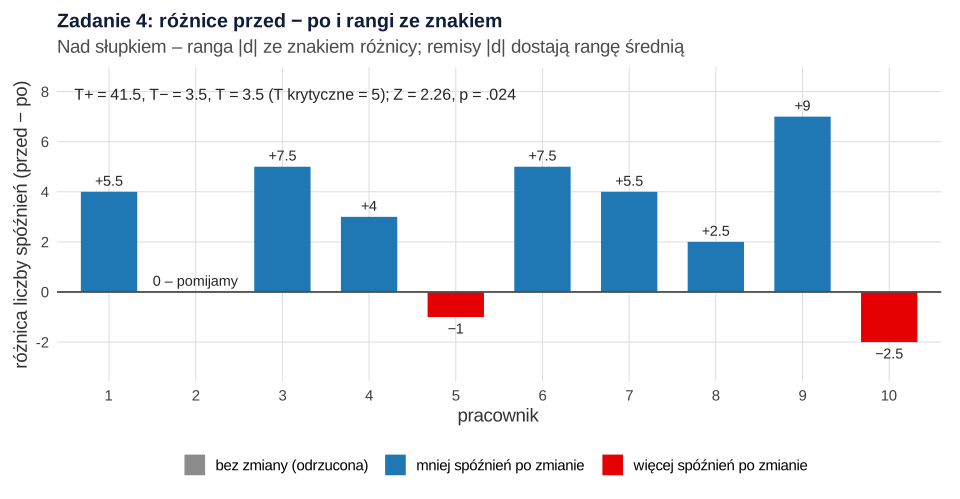
Krok 1. Różnice (przed − po): 4, 0, 5, 3, −1, 5, 4, 2, 7, −2. Jedna osoba ma różnicę 0 – w klasycznym teście Wilcoxona ją pomijasz, więc n = 9.
Krok 2. Rangi wartości bezwzględnych. |d| po uporządkowaniu: 1, 2, 2, 3, 4, 4, 5, 5, 7. Remisy dostają rangę średnią: |d| = 2 → 2.5; 4 → 5.5; 5 → 7.5. Pozostałe: 1 → 1, 3 → 4, 7 → 9.
Krok 3. Sumy rang ze znakiem. Ujemne różnice to −1 (ranga 1) i −2 (ranga 2.5), więc T− = 3.5. T+ = 45 − 3.5 = 41.5 (kontrola: suma wszystkich rang = 9 × 10 / 2 = 45). T = min(41.5, 3.5) = 3.5.
Krok 4. Decyzja z tablic. Dla n = 9 i α = .05 (dwustronnie) Tkryt = 5. Ponieważ 3.5 ≤ 5, odrzucasz H0.
Krok 5. Przybliżenie normalne (liczy je R przy zerach i remisach):
R podaje V = 41.5 (to T+) i p = .024.
Krok 6. Wielkość efektu. rrb dla par = (T+ − T−)/(T+ + T−) = (41.5 − 3.5)/45 = .84.
Interpretacja
Bez grupy porównawczej nie wiesz, czy spadek wynika ze zmiany godzin. Więcej: test Wilcoxona.
Typowy błąd
Użycie testu znaków „bo prościej”: na tych danych (7 plusów, 2 minusy) daje p = .180, bo pomija wielkość różnic. Zostaw go na sytuacje, gdy znasz tylko kierunek (zadanie 3).
Zadanie 5. Test Kruskala–Wallisa i test Dunna
Treść zadania
Szkoła porównała trzy formy zajęć z geografii. Po 6 uczniów z każdej grupy napisało sprawdzian (0–20 pkt). Wykład: 8, 11, 7, 10, 12, 9. Ćwiczenia: 13, 10, 15, 12, 14, 11. Projekt: 16, 14, 18, 13, 17, 19. Czy forma zajęć wiąże się z wynikiem? Jeśli tak – które grupy się różnią?
Rozwiązanie krok po kroku
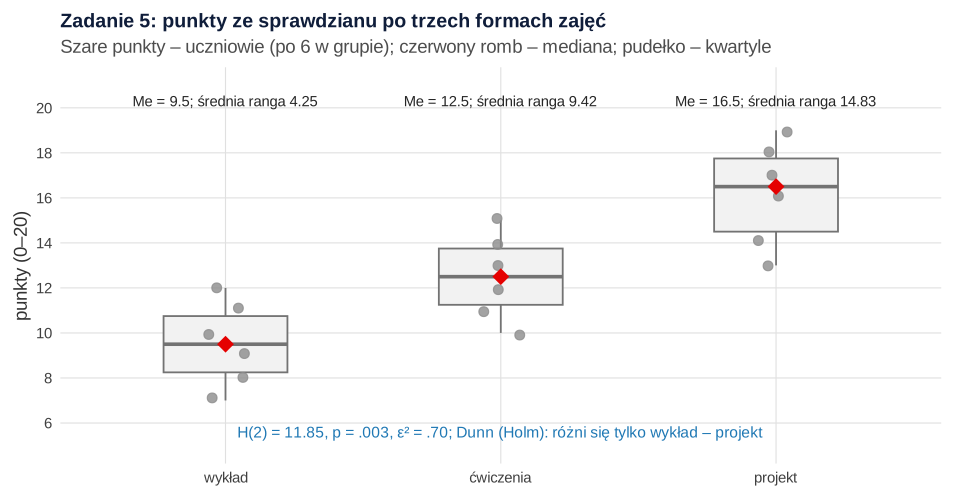
Krok 1. Wspólne rangowanie 18 wyników (remisy: 10, 11, 12, 13 i 14 występują po dwa razy, więc dostają rangi 4.5, 6.5, 8.5, 10.5 i 12.5). Sumy rang: wykład R1 = 25.5, ćwiczenia R2 = 56.5, projekt R3 = 89. Średnie rangi: 4.25, 9.42 i 14.83.
Krok 2. Korekta na remisy. C = 1 − Σ(t³ − t)/(N³ − N) = 0.995, więc H = 11.79 / 0.995 = 11.85.
Krok 3. Decyzja. df = k − 1 = 2; χ²kryt(2) = 5.99. Ponieważ 11.85 > 5.99, odrzucasz H0; p = .003. Kruskal i Wallis (1952) podali, że przy H0 H ma w przybliżeniu rozkład χ²(k − 1), chyba że próby są bardzo małe.
Krok 4. Wielkość efektu. ε² = H/(N − 1) = 11.85/17 = .70 (zob. epsilon-kwadrat).
Krok 5. Test Dunna (krótko). Dunn (1964) zaproponował porównania oparte na wspólnym rangowaniu wszystkich grup zamiast osobnego rangowania każdej pary. z = różnica średnich rang / 3.07 (błąd standardowy z korektą na remisy), a p poprawiasz metodą Holma.
| Para | Różnica średnich rang | z | p | p (Holm) |
|---|---|---|---|---|
| wykład – ćwiczenia | 5.17 | 1.68 | .093 | .156 |
| wykład – projekt | 10.58 | 3.44 | .001 | .002 |
| ćwiczenia – projekt | 5.42 | 1.76 | .078 | .156 |
Interpretacja
Więcej: test Kruskala–Wallisa, test Dunna i poprawka Holma.
Typowy błąd
Zamiast testu Dunna – trzy osobne testy Manna–Whitneya bez korekty. Dają p = .036, .005 i .030, czyli „wszystko istotne”, a ryzyko błędu I rodzaju rośnie z liczbą porównań.
Zadanie 6. Test Friedmana dla małych danych
Treść zadania
Siedmiu klientów oceniło trzy projekty opakowania (A, B, C) na skali 1–10.
| Klient | A: ocena (ranga) | B: ocena (ranga) | C: ocena (ranga) |
|---|---|---|---|
| 1 | 6 (2) | 8 (3) | 5 (1) |
| 2 | 7 (2) | 9 (3) | 6 (1) |
| 3 | 5 (1) | 7 (2) | 8 (3) |
| 4 | 6 (2) | 9 (3) | 4 (1) |
| 5 | 5 (2) | 8 (3) | 4 (1) |
| 6 | 4 (1) | 8 (3) | 6 (2) |
| 7 | 7 (2) | 9 (3) | 5 (1) |
| Suma rang | 12 | 20 | 10 |
Czy projekty różnią się ocenami (α = .05)?
Rozwiązanie krok po kroku
Krok 1. Rangi w wierszach. W teście Friedmana rangujesz oceny każdego klienta osobno (1 – najniższa, 3 – najwyższa). Sumy rang: A = 12, B = 20, C = 10. Kontrola: 12 + 20 + 10 = 42 = 7 × 6.
Krok 2. Decyzja. df = k − 1 = 2; χ²kryt(2) = 5.99; 8.00 > 5.99, p = .018. Przy tak małym n przybliżenie χ² bywa niedokładne. Dokładny rozkład (wszystkie 67 = 279936 możliwych układów rang przy H0) daje wartość krytyczną 7.14 i dokładne p = .016 – wniosek się nie zmienia.
Krok 3. Wielkość efektu. W Kendalla = χ²F/(n(k − 1)) = 8.00/14 = .57. Projekt B oceniło najwyżej 6 z 7 klientów.
Krok 4. Porównania par. Testy Wilcoxona dla par z korektą Holma dają p = .060 (A–B), .797 (A–C) i .068 (B–C). Przy 7 osobach testy par mają bardzo małą moc – to nie błąd w rachunkach.
Interpretacja
Friedman (1937) zaproponował ten test jako sposób na uniknięcie założenia normalności w analizie wariancji z powtarzanymi pomiarami. Więcej: test Friedmana.
Typowy błąd
Rangowanie wszystkich 21 ocen razem, jak w teście Kruskala–Wallisa, zamiast w każdym wierszu osobno.
Zadanie 7. Korelacja Spearmana z rangami wiązanymi (krótko)
Treść zadania
W małej firmie zebrano staż pracy (lata) i ocenę przełożonego (1–5) ośmiu pracowników. Staż: 1, 3, 2, 6, 4, 8, 5, 10. Ocena: 2, 3, 3, 4, 2, 5, 4, 3. Oblicz współczynnik korelacji Spearmana i sprawdź jego istotność.
Rozwiązanie krok po kroku
Krok 1. Rangi. Staż: 1, 3, 2, 6, 4, 7, 5, 8. Ocena (z remisami): 1.5, 4, 4, 6.5, 1.5, 8, 6.5, 4.
Krok 2. Wzór skrócony. Różnice rang d: −0.5, −1, −2, −0.5, 2.5, −1, −1.5, 4; Σd² = 31. ρ = 1 − 6 × 31 / (8 × 63) = .631.
Krok 3. Wersja dokładna przy remisach. Gdy są rangi wiązane, wzór skrócony jest tylko przybliżeniem. Dokładnie liczysz korelację Pearsona na rangach: ρ = .618.
Interpretacja
Przy 8 osobach nawet ρ ≈ .6 może być przypadkiem. Więcej zadań: zbiór korelacja i regresja – zadania z rozwiązaniami i poradnik korelacja Pearsona i Spearmana krok po kroku.
Typowy błąd
Wzór 1 − 6Σd²/(n(n² − 1)) przy wielu remisach bez komentarza. Tu różnica jest mała (.631 wobec .618), ale rośnie z liczbą remisów (zob. korelacja Spearmana).
Zadanie 8. Wielkość efektu z opublikowanych wyników
Treść zadania
Piszesz przegląd literatury i masz tylko wyniki z artykułów, bez danych. Oblicz wielkości efektu: (a) test Manna–Whitneya: U = 150, n1 = 20, n2 = 25 (bez remisów); (b) test Wilcoxona dla par: T+ = 160, T− = 50, 20 par bez zer; (c) test Kruskala–Wallisa: H(2) = 9.60, N = 48.
Rozwiązanie krok po kroku
(a) Z = (150 − 20 × 25/2) / √(20 × 25 × 46/12) = −2.28, p = .022. r = 2.28/√45 = .34. rrb = 1 − 2U/(n1n2) = 1 − 300/500 = .40.
(b) Kontrola: 160 + 50 = 210 = 20 × 21/2, więc dane są spójne. Z = (160 − 105) / √(20 × 21 × 41/24) = 2.05, p = .040. rrb = (160 − 50)/210 = .52. r = Z/√N zależy od tego, co przyjmiesz za N: przy 20 parach .46, przy 40 obserwacjach .32.
(c) p = .008; ε² = 9.60/47 = .20.
Interpretacja
W tabeli przeglądu podaj miarę i sposób obliczenia, np. „rrb = .40 (z U)”; rrb ma jedną definicję, więc łatwiej je porównywać.
Typowy błąd
Wstawienie do r = Z/√N liczby obserwacji (40) zamiast par (20) bez informacji w tekście: .32 zamiast .46.
Zadanie 9. Jedna skrajna wartość: test t czy test Manna–Whitneya?
Treść zadania
Bank zmierzył czas obsługi klienta (w minutach) w dwóch oddziałach, po 8 klientów. Oddział A: 6, 8, 7, 9, 5, 8, 7, 6. Oddział B: 10, 12, 9, 11, 13, 10, 12, 58. Wynik 58 min to prawdziwy pomiar (zakładanie konta firmowego). Porównaj oddziały testem t Welcha i testem Manna–Whitneya.
Rozwiązanie krok po kroku
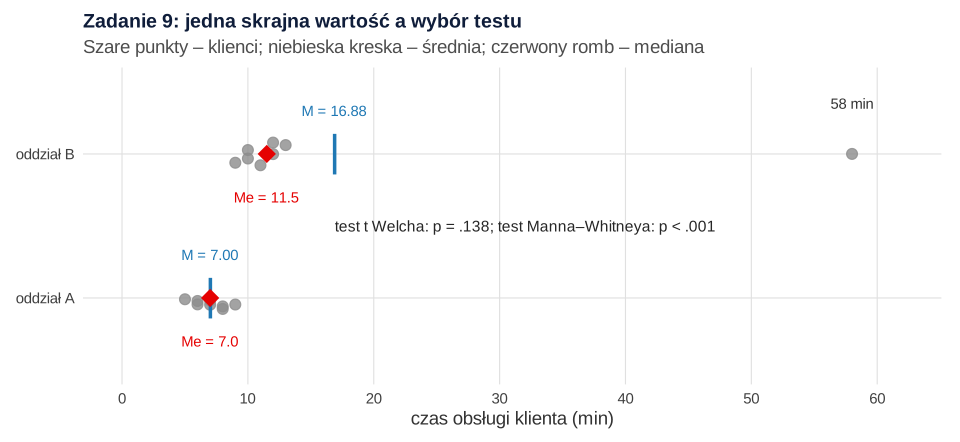
Krok 1. Opis. Oddział A: M = 7.00, SD = 1.31, Me = 7.00. Oddział B: M = 16.88, SD = 16.67, Me = 11.50. Jedna wartość 58 odsuwa średnią B od mediany o ponad 5 minut.
Krok 2. Test t Welcha. t(7.09) = 1.67, p = .138.
Krok 3. Test Manna–Whitneya. Rangi oddziału A: 2.5, 6.5, 4.5, 8.5, 1, 6.5, 4.5, 2.5 (R1 = 36.5). U = 36.5 − 8 × 9/2 = 0.5: na 64 pary jeden remis (9 i 9 min), w pozostałych klient z A był obsłużony szybciej. p < .001. Dla testu rangowego 58 minut to po prostu ranga 16.
Interpretacja
Gdyby skrajny klient w B był obsługiwany 14 minut, oba testy dałyby p < .001. O wyborze testu zdecydowała więc jedna prawdziwa obserwacja odstająca, a nie „nienormalność” jako taka.
Typowy błąd
Usunięcie 58 minut „bo psuje wynik”. Bez tej osoby test t Welcha daje t(12.40) = 5.66, p < .001, ale wnioskujesz wtedy o innej populacji klientów – bez tych, którzy załatwiają długie sprawy. Prawdziwych wartości nie usuwaj – wybierz metodę na nie odporną.
Zadanie 10. Kiedy test nieparametryczny, a kiedy nie?
Treść zadania
Dla każdego opisu wskaż test i krótko uzasadnij wybór.
- Dwie grupy po 60 osób, wynik skali z 20 pozycji (suma), rozkład lekko skośny.
- Dwie grupy po 9 osób, liczba wizyt u lekarza w roku (dużo zer, jedna osoba z 25 wizytami).
- Te same 30 osób oceniło jedno twierdzenie na skali 1–5 przed szkoleniem i po nim.
- Cztery grupy po 40 osób, wynik testu wiedzy zbliżony do normalnego, różne wariancje.
- 12 osób porównuje dwa produkty i mówi tylko, który woli.
- Pięć pomiarów nastroju tych samych 15 osób na pojedynczej pozycji 1–7.
Rozwiązanie
- Test t Welcha. Przy 60 osobach w grupie średnie mają rozkład bliski normalnemu; istotny test Shapiro–Wilka nie jest powodem zmiany testu.
- Test Manna–Whitneya: mała próba, wiele zer i prawdziwa wartość skrajna – jak w zadaniu 9.
- Test Wilcoxona dla par: pojedyncza pozycja porządkowa i te same osoby.
- ANOVA Welcha (z post hoc Gamesa–Howella), a nie test Kruskala–Wallisa – problemem są wariancje, nie kształt rozkładu.
- Test znaków – znasz tylko kierunek preferencji (zadanie 3).
- Test Friedmana (pięć pomiarów tych samych osób, pozycja porządkowa).
Typowy błąd
Wybór testu po tym, który daje mniejsze p – test zapisz w planie analizy przed wynikami. Pełna mapa wyboru: jaki test statystyczny do jakiej hipotezy.
Testy w programie: testy nieparametryczne w SPSS.
Inne zbiory zadań
- Zadania ze statystyki na psychologii
- Statystyka opisowa – zadania z rozwiązaniami
- Prawdopodobieństwo i rozkłady – zadania
- Estymacja i testowanie hipotez – zadania
- Korelacja i regresja – zadania
- Statystyka medyczna – zadania
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Każde zadanie jest policzone wzorem, jak na kartce, a potem gotową funkcją R jako kontrola. Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z tych przepisów.
Zadania 1–4: test Manna–Whitneya, test znaków i test Wilcoxona dla par
R
# B382 – zadania 1–4: test U Manna–Whitneya (bez remisów i z remisami), test znaków, test Wilcoxona dla par
# Dane wpisane na sztywno – te same co w treści zadań. Tylko funkcje bazowego R (stats).
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))   # bez zera przed kropką (p, r)

# Zadanie 1. Czas rozwiązania zadania logicznego (min): metoda A (n = 6) i metoda B (n = 7)
A <- c(12, 15, 9, 18, 11, 14)
B <- c(19, 16, 22, 13, 25, 20, 17)
n1 <- length(A); n2 <- length(B)
rangi <- rank(c(A, B))
R1 <- sum(rangi[1:n1]); R2 <- sum(rangi[-(1:n1)])
U1 <- R1 - n1 * (n1 + 1) / 2; U2 <- n1 * n2 - U1
Ukr <- max(which(pwilcox(0:(n1 * n2), n1, n2) <= 0.025)) - 1   # największe U z P(U <= Ukr) <= .025
cat("Zadanie 1\n")
cat("Uporządkowane wyniki:", sort(c(A, B)), "\n")
cat("Rangi grupy A:", rangi[1:n1], "; suma R1 =", R1, "\n")
cat("Rangi grupy B:", rangi[-(1:n1)], "; suma R2 =", R2, "; kontrola R1 + R2 =", R1 + R2, "= N(N + 1)/2 =", (n1 + n2) * (n1 + n2 + 1) / 2, "\n")
cat("U1 =", U1, "; U2 =", U2, "; U = min =", min(U1, U2), "\n")
cat("U krytyczne (n1 = 6, n2 = 7, alfa = .05, dwustronnie) =", Ukr, "\n")
cat("Mediany: A =", z2(median(A)), "; B =", z2(median(B)), "\n")
w1 <- wilcox.test(A, B)
cat("Kontrola wilcox.test(): W =", w1$statistic, "; dokładne p =", bz(w1$p.value), "\n")
cat("Korelacja rangowo-biseryjna rrb = (U2 - U1) / (n1 * n2) =", bz((U2 - U1) / (n1 * n2)), "\n\n")

# Zadanie 2. Ocena zajęć (1–5): grupa online (n = 10) i stacjonarna (n = 12) – rangi wiązane
online <- c(3, 4, 2, 5, 3, 3, 4, 2, 3, 4)
stacj  <- c(4, 5, 4, 3, 5, 4, 5, 4, 3, 5, 4, 5)
n1 <- length(online); n2 <- length(stacj); N <- n1 + n2
rangi <- rank(c(online, stacj))
cat("Zadanie 2\n")
tab <- table(c(online, stacj))
cat("Liczba osób z każdą oceną:", paste0(names(tab), ": ", tab), "\n")
cat("Ranga średnia dla każdej oceny:", paste0(sort(unique(c(online, stacj))), " -> ", tapply(rangi, c(online, stacj), mean)), "\n")
R1 <- sum(rangi[1:n1]); R2 <- sum(rangi[-(1:n1)])
U1 <- R1 - n1 * (n1 + 1) / 2; U2 <- n1 * n2 - U1
cat("R1 (online) =", R1, "; R2 (stacjonarna) =", R2, "; U1 =", U1, "; U2 =", U2, "\n")
mU <- n1 * n2 / 2
t <- as.numeric(tab)
sU_bez <- sqrt(n1 * n2 * (N + 1) / 12)
sU <- sqrt(n1 * n2 / 12 * ((N + 1) - sum(t^3 - t) / (N * (N - 1))))
Z <- (U1 - mU) / sU
cat("Średnia U =", mU, "; suma (t^3 - t) =", sum(t^3 - t), "; SD U bez korekty =", z2(sU_bez), "; z korektą na remisy =", z2(sU), "\n")
cat("Z =", z2(Z), "; p (dwustronnie) =", bz(2 * pnorm(-abs(Z))), "\n")
cat("r = |Z| / sqrt(N) =", bz(abs(Z) / sqrt(N)), "; rrb = (U2 - U1) / (n1 * n2) =", bz((U2 - U1) / (n1 * n2)), "\n")
cat("Mediany: online =", z2(median(online)), "; stacjonarna =", z2(median(stacj)), "\n")
w2 <- wilcox.test(online, stacj, exact = FALSE, correct = FALSE)
cat("Kontrola wilcox.test(correct = FALSE): W =", w2$statistic, "; p =", bz(w2$p.value), "\n")
w2c <- wilcox.test(online, stacj, exact = FALSE)
cat("Z poprawką na ciągłość (domyślnie w R): p =", bz(w2c$p.value), "\n")
cat("Błąd: SD U bez korekty na remisy daje Z =", z2((U1 - mU) / sU_bez), "\n\n")

# Zadanie 3. Test znaków: 15 osób porównało nową i starą recepturę (11 woli nową, 3 starą, 1 bez zdania)
plus <- 11; minus <- 3; zera <- 1
n3 <- plus + minus
cat("Zadanie 3\n")
cat("n po odrzuceniu remisów =", n3, "; mniejsza liczba znaków =", min(plus, minus), "\n")
cat("P(X <= 3) przy prawdopodobieństwie 1/2:", "suma C(14, k) dla k = 0..3 =", sum(choose(n3, 0:3)), "; 2^14 =", 2^n3,
    "; wynik =", bz(pbinom(min(plus, minus), n3, 0.5)), "\n")
cat("p dwustronne =", bz(2 * pbinom(min(plus, minus), n3, 0.5)), "; p jednostronne =", bz(pbinom(min(plus, minus), n3, 0.5)), "\n")
b3 <- binom.test(plus, n3)
cat("Kontrola binom.test(): p =", bz(b3$p.value), "; odsetek wolących nową =", z2(100 * plus / n3), "%; 95% CI [",
    z2(100 * b3$conf.int), "] %\n")
Zs <- (abs(plus - n3 / 2) - 0.5) / sqrt(n3 / 4)
cat("Przybliżenie normalne z poprawką na ciągłość: Z =", z2(Zs), "; p =", bz(2 * pnorm(-Zs)), "\n")
cat("Błąd: remis wliczony do n (11 plusów na 15 osób) daje p =", bz(binom.test(plus, n3 + zera)$p.value), "\n\n")

# Zadanie 4. Test Wilcoxona dla par: liczba spóźnień w miesiącu przed i po wprowadzeniu elastycznych godzin (10 osób)
przed <- c(9, 6, 8, 7, 5, 10, 6, 4, 11, 5)
po    <- c(5, 6, 3, 4, 6, 5, 2, 2, 4, 7)
d <- przed - po
cat("Zadanie 4\n")
cat("Różnice przed - po:", d, "\n")
dn <- d[d != 0]; n4 <- length(dn)
rg <- rank(abs(dn))
cat("Bez zer: n =", n4, "; |d|:", abs(dn), "\n")
cat("Rangi |d|:", rg, "\n")
Tp <- sum(rg[dn > 0]); Tm <- sum(rg[dn < 0])
cat("T+ =", Tp, "; T- =", Tm, "; T = min =", min(Tp, Tm), "; kontrola T+ + T- =", Tp + Tm, "= n(n + 1)/2 =", n4 * (n4 + 1) / 2, "\n")
Tkr <- max(which(psignrank(0:(n4 * (n4 + 1) / 2), n4) <= 0.025)) - 1
cat("T krytyczne (n = 9, alfa = .05, dwustronnie) =", Tkr, "\n")
tt <- table(abs(dn))
mT <- n4 * (n4 + 1) / 4
sT <- sqrt(n4 * (n4 + 1) * (2 * n4 + 1) / 24 - sum(tt^3 - tt) / 48)
Z4 <- (Tp - mT) / sT
cat("Średnia T =", mT, "; SD T z korektą na remisy =", z2(sT), "; Z =", z2(Z4), "; p =", bz(2 * pnorm(-abs(Z4))), "\n")
cat("rrb dla par = (T+ - T-) / (T+ + T-) =", bz((Tp - Tm) / (Tp + Tm)), "; r = Z / sqrt(9) =", bz(Z4 / sqrt(n4)), "\n")
cat("Mediany: przed =", z2(median(przed)), "; po =", z2(median(po)), "; mediana różnic =", z2(median(d)), "\n")
w4 <- wilcox.test(przed, po, paired = TRUE, exact = FALSE, correct = FALSE)
cat("Kontrola wilcox.test(paired, correct = FALSE): V =", w4$statistic, "; p =", bz(w4$p.value), "\n")
cat("Test znaków na tych samych danych: plusy =", sum(d > 0), "; minusy =", sum(d < 0), "; p =", bz(binom.test(sum(d > 0), n4)$p.value), "\n")
Wynik w R
Zadanie 1
Uporządkowane wyniki: 9 11 12 13 14 15 16 17 18 19 20 22 25
Rangi grupy A: 3 6 1 9 2 5 ; suma R1 = 26
Rangi grupy B: 10 7 12 4 13 11 8 ; suma R2 = 65 ; kontrola R1 + R2 = 91 = N(N + 1)/2 = 91
U1 = 5 ; U2 = 37 ; U = min = 5
U krytyczne (n1 = 6, n2 = 7, alfa = .05, dwustronnie) = 6
Mediany: A = 13.00 ; B = 19.00
Kontrola wilcox.test(): W = 5 ; dokładne p = .022
Korelacja rangowo-biseryjna rrb = (U2 - U1) / (n1 * n2) = .762

Zadanie 2
Liczba osób z każdą oceną: 2: 2 3: 6 4: 8 5: 6
Ranga średnia dla każdej oceny: 2 -> 1.5 3 -> 5.5 4 -> 12.5 5 -> 19.5
R1 (online) = 82 ; R2 (stacjonarna) = 171 ; U1 = 27 ; U2 = 93
Średnia U = 60 ; suma (t^3 - t) = 930 ; SD U bez korekty = 15.17 ; z korektą na remisy = 14.49
Z = -2.28 ; p (dwustronnie) = .023
r = |Z| / sqrt(N) = .486 ; rrb = (U2 - U1) / (n1 * n2) = .550
Mediany: online = 3.00 ; stacjonarna = 4.00
Kontrola wilcox.test(correct = FALSE): W = 27 ; p = .023
Z poprawką na ciągłość (domyślnie w R): p = .025
Błąd: SD U bez korekty na remisy daje Z = -2.18

Zadanie 3
n po odrzuceniu remisów = 14 ; mniejsza liczba znaków = 3
P(X <= 3) przy prawdopodobieństwie 1/2: suma C(14, k) dla k = 0..3 = 470 ; 2^14 = 16384 ; wynik = .029
p dwustronne = .057 ; p jednostronne = .029
Kontrola binom.test(): p = .057 ; odsetek wolących nową = 78.57 %; 95% CI [ 49.20 95.34 ] %
Przybliżenie normalne z poprawką na ciągłość: Z = 1.87 ; p = .061
Błąd: remis wliczony do n (11 plusów na 15 osób) daje p = .118

Zadanie 4
Różnice przed - po: 4 0 5 3 -1 5 4 2 7 -2
Bez zer: n = 9 ; |d|: 4 5 3 1 5 4 2 7 2
Rangi |d|: 5.5 7.5 4 1 7.5 5.5 2.5 9 2.5
T+ = 41.5 ; T- = 3.5 ; T = min = 3.5 ; kontrola T+ + T- = 45 = n(n + 1)/2 = 45
T krytyczne (n = 9, alfa = .05, dwustronnie) = 5
Średnia T = 22.5 ; SD T z korektą na remisy = 8.42 ; Z = 2.26 ; p = .024
rrb dla par = (T+ - T-) / (T+ + T-) = .844 ; r = Z / sqrt(9) = .752
Mediany: przed = 6.50 ; po = 4.50 ; mediana różnic = 3.50
Kontrola wilcox.test(paired, correct = FALSE): V = 41.5 ; p = .024
Test znaków na tych samych danych: plusy = 7 ; minusy = 2 ; p = .180
Zadania 5–9: Kruskal–Wallis z testem Dunna, Friedman, Spearman, wielkość efektu i wartość skrajna
R
# B382 – zadania 5–9: test Kruskala–Wallisa z testem Dunna, test Friedmana, korelacja Spearmana,
# wielkość efektu z opublikowanych wyników, wartość skrajna: test t a test Manna–Whitneya
# Dane wpisane na sztywno – te same co w treści zadań. Funkcje bazowego R (stats) i kontrola testu Dunna w PMCMRplus.
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x) sub("^(-?)0\\.", "\\1.", z3(x))
bp <- function(p) if (p < .001) "p < .001" else paste("p =", bz(p))   # p w zapisie APA

# Zadanie 5. Punkty ze sprawdzianu (0–20) po trzech formach zajęć (po 6 uczniów)
wyklad <- c(8, 11, 7, 10, 12, 9)
cwicz  <- c(13, 10, 15, 12, 14, 11)
projekt <- c(16, 14, 18, 13, 17, 19)
wynik <- c(wyklad, cwicz, projekt)
forma <- factor(rep(c("wykład", "ćwiczenia", "projekt"), each = 6), levels = c("wykład", "ćwiczenia", "projekt"))
N <- length(wynik); k <- nlevels(forma); nj <- tapply(wynik, forma, length)
rg <- rank(wynik)
Rj <- tapply(rg, forma, sum)
cat("Zadanie 5\n")
cat("Rangi:", paste(forma, wynik, rg, sep = ":"), "\n")
cat("Sumy rang:", paste(names(Rj), Rj), "; średnie rangi:", paste(names(Rj), z2(Rj / nj)), "\n")
H0 <- 12 / (N * (N + 1)) * sum(Rj^2 / nj) - 3 * (N + 1)
tt <- table(wynik); C <- 1 - sum(tt^3 - tt) / (N^3 - N)
H <- H0 / C
cat("Suma R^2/n =", z2(sum(Rj^2 / nj)), "; H bez korekty =", z2(H0), "; korekta na remisy C =", z3(C), "; H =", z2(H), "\n")
cat("df =", k - 1, "; chi^2 krytyczne =", z2(qchisq(0.95, k - 1)), "; p =", bz(pchisq(H, k - 1, lower.tail = FALSE)), "\n")
cat("epsilon^2 = H / (N - 1) =", bz(H / (N - 1)), "\n")
cat("Mediany:", paste(levels(forma), z2(tapply(wynik, forma, median))), "\n")
kw <- kruskal.test(wynik ~ forma)
cat("Kontrola kruskal.test(): chi^2 =", z2(kw$statistic), "; df =", kw$parameter, "; p =", bz(kw$p.value), "\n")
# Test Dunna: różnice średnich rang, błąd standardowy z korektą na remisy, korekta Holma
sr <- Rj / nj
s2 <- (N * (N + 1) / 12 - sum(tt^3 - tt) / (12 * (N - 1)))
pary <- combn(levels(forma), 2)
zD <- apply(pary, 2, function(p) (sr[p[2]] - sr[p[1]]) / sqrt(s2 * (1 / nj[p[1]] + 1 / nj[p[2]])))
pD <- 2 * pnorm(-abs(zD))
dunn <- data.frame(para = apply(pary, 2, paste, collapse = " - "), roznica_rang = z2(apply(pary, 2, function(p) sr[p[2]] - sr[p[1]])),
                   z = z2(zD), p = bz(pD), p_Holm = bz(p.adjust(pD, "holm")))
cat("Test Dunna (SE różnicy średnich rang =", z2(sqrt(s2 * (1 / 6 + 1 / 6))), "):\n"); print(dunn, row.names = FALSE)
dk <- suppressWarnings(PMCMRplus::kwAllPairsDunnTest(wynik, forma, p.adjust.method = "holm"))
cat("Kontrola PMCMRplus::kwAllPairsDunnTest (Holm):\n"); print(round(dk$p.value, 3))
cat("Błąd: trzy testy Manna–Whitneya bez korekty: p =",
    bz(apply(pary, 2, function(p) wilcox.test(wynik[forma == p[1]], wynik[forma == p[2]], exact = FALSE)$p.value)), "\n\n")

# Zadanie 6. Test Friedmana: 7 klientów oceniło trzy projekty opakowania (1–10)
oceny <- matrix(c(6, 8, 5,
                  7, 9, 6,
                  5, 7, 8,
                  6, 9, 4,
                  5, 8, 4,
                  4, 8, 6,
                  7, 9, 5), ncol = 3, byrow = TRUE, dimnames = list(klient = 1:7, projekt = c("A", "B", "C")))
n6 <- nrow(oceny); k6 <- ncol(oceny)
rw <- t(apply(oceny, 1, rank))
cat("Zadanie 6\n"); cat("Rangi w wierszach (każdy klient osobno):\n"); print(rw)
Rk <- colSums(rw)
chiF <- 12 / (n6 * k6 * (k6 + 1)) * sum(Rk^2) - 3 * n6 * (k6 + 1)
cat("Sumy rang:", paste(names(Rk), Rk), "; suma kwadratów =", sum(Rk^2), "; średnie rangi:", paste(names(Rk), z2(Rk / n6)), "\n")
cat("chi^2_F =", z2(chiF), "; df =", k6 - 1, "; chi^2 krytyczne =", z2(qchisq(0.95, k6 - 1)), "; p =", bz(pchisq(chiF, k6 - 1, lower.tail = FALSE)), "\n")
cat("W Kendalla = chi^2_F / (n(k - 1)) =", bz(chiF / (n6 * (k6 - 1))), "\n")
cat("Mediany ocen:", paste(colnames(oceny), z2(apply(oceny, 2, median))), "\n")
fr <- friedman.test(oceny)
cat("Kontrola friedman.test(): chi^2 =", z2(fr$statistic), "; p =", bz(fr$p.value), "\n")
# Dokładne p: wszystkie 6^7 układów rang w wierszach przy H0 są jednakowo prawdopodobne
perm <- rbind(c(1, 2, 3), c(1, 3, 2), c(2, 1, 3), c(2, 3, 1), c(3, 1, 2), c(3, 2, 1))
uklady <- as.matrix(expand.grid(rep(list(1:6), n6)))
sumy <- sapply(1:k6, function(j) rowSums(matrix(perm[uklady, j], ncol = n6)))
chi_all <- 12 / (n6 * k6 * (k6 + 1)) * rowSums(sumy^2) - 3 * n6 * (k6 + 1)
rozklad <- table(round(chi_all, 6)); wart <- as.numeric(names(rozklad))
p_ogon <- rev(cumsum(rev(as.numeric(rozklad)))) / length(chi_all)   # P(chi^2_F >= wartość)
cat("Dokładne p (", length(chi_all), "układów rang ) =", bz(mean(chi_all >= chiF - 1e-9)),
    "; najmniejsza chi^2_F z dokładnym p <= .05 =", z2(min(wart[p_ogon <= .05])), "\n")
pw <- c("A-B" = wilcox.test(oceny[, "A"], oceny[, "B"], paired = TRUE, exact = FALSE)$p.value,
        "A-C" = wilcox.test(oceny[, "A"], oceny[, "C"], paired = TRUE, exact = FALSE)$p.value,
        "B-C" = wilcox.test(oceny[, "B"], oceny[, "C"], paired = TRUE, exact = FALSE)$p.value)
cat("Post hoc: Wilcoxon dla par, p z korektą Holma:", paste(names(pw), bz(p.adjust(pw, "holm"))), "\n")
cat("Projekt B oceniony najwyżej przez", sum(rw[, "B"] == 3), "z", n6, "klientów\n\n")

# Zadanie 7. Korelacja Spearmana: staż pracy (lata) i ocena przełożonego (1–5), 8 pracowników
staz <- c(1, 3, 2, 6, 4, 8, 5, 10)
ocena <- c(2, 3, 3, 4, 2, 5, 4, 3)
rx <- rank(staz); ry <- rank(ocena); dd <- rx - ry
cat("Zadanie 7\n")
cat("Rangi stażu:", rx, "\n"); cat("Rangi oceny:", ry, "\n"); cat("d:", dd, "; suma d^2 =", sum(dd^2), "\n")
cat("Wzór skrócony 1 - 6 suma d^2 / (n(n^2 - 1)) =", z3(1 - 6 * sum(dd^2) / (8 * 63)), "\n")
cat("Pearson na rangach (dokładnie przy remisach) rho =", z3(cor(rx, ry)), "\n")
tS <- cor(rx, ry) * sqrt(6) / sqrt(1 - cor(rx, ry)^2)
cat("t(6) =", z2(tS), "; t krytyczne =", z3(qt(0.975, 6)), "; p =", bz(2 * pt(-abs(tS), 6)), "\n")
cs <- suppressWarnings(cor.test(staz, ocena, method = "spearman", exact = FALSE))
cat("Kontrola cor.test(method = 'spearman'): rho =", z3(cs$estimate), "; p =", bz(cs$p.value), "\n\n")

# Zadanie 8. Wielkość efektu z wyników podanych w artykule (bez dostępu do danych)
cat("Zadanie 8\n")
# a) Manna–Whitneya: U = 150, n1 = 20, n2 = 25 (brak remisów)
U <- 150; m1 <- 20; m2 <- 25; Na <- m1 + m2
Za <- (U - m1 * m2 / 2) / sqrt(m1 * m2 * (Na + 1) / 12)
cat("a) Z =", z2(Za), "; p =", bz(2 * pnorm(-abs(Za))), "; r = |Z|/sqrt(N) =", bz(abs(Za) / sqrt(Na)), "; rrb = 1 - 2U/(n1 n2) =", bz(1 - 2 * U / (m1 * m2)), "\n")
# b) Wilcoxon dla par: T+ = 160, T- = 50, n = 20 par bez zer
Tp8 <- 160; Tm8 <- 50; nb <- 20
Zb <- (Tp8 - nb * (nb + 1) / 4) / sqrt(nb * (nb + 1) * (2 * nb + 1) / 24)
cat("b) kontrola T+ + T- =", Tp8 + Tm8, "= n(n + 1)/2 =", nb * (nb + 1) / 2, "; Z =", z2(Zb), "; p =", bz(2 * pnorm(-abs(Zb))),
    "; rrb = (T+ - T-)/(T+ + T-) =", bz((Tp8 - Tm8) / (Tp8 + Tm8)), "; r (N = 20) =", bz(Zb / sqrt(nb)), "; r (N = 40) =", bz(Zb / sqrt(2 * nb)), "\n")
# c) Kruskal–Wallis: H(2) = 9.60, N = 48
Hc <- 9.6; Nc <- 48
cat("c) p =", bz(pchisq(Hc, 2, lower.tail = FALSE)), "; epsilon^2 = H/(N - 1) =", bz(Hc / (Nc - 1)), "\n\n")

# Zadanie 9. Jedna skrajna wartość: czas obsługi klienta (min) w dwóch oddziałach, po 8 klientów
oddzA <- c(6, 8, 7, 9, 5, 8, 7, 6)
oddzB <- c(10, 12, 9, 11, 13, 10, 12, 58)
cat("Zadanie 9\n")
cat("Oddział A: M =", z2(mean(oddzA)), "; SD =", z2(sd(oddzA)), "; Me =", z2(median(oddzA)), "\n")
cat("Oddział B: M =", z2(mean(oddzB)), "; SD =", z2(sd(oddzB)), "; Me =", z2(median(oddzB)), "\n")
tw <- t.test(oddzB, oddzA)
cat("Test t Welcha: t(", z2(tw$parameter), ") =", z2(tw$statistic), ";", bp(tw$p.value), "\n")
rg9 <- rank(c(oddzA, oddzB)); R1 <- sum(rg9[1:8]); U9 <- R1 - 8 * 9 / 2
cat("Rangi oddziału A:", rg9[1:8], "; R1 =", R1, "; U =", U9, "\n")
w9 <- wilcox.test(oddzA, oddzB, exact = FALSE, correct = FALSE)
cat("Test Manna–Whitneya: W =", w9$statistic, ";", bp(w9$p.value), "\n")
oddzB2 <- replace(oddzB, 8, 14)
cat("Gdyby skrajny wynik wynosił 14 min: test t Welcha", bp(t.test(oddzB2, oddzA)$p.value),
    "; Mann–Whitney", bp(wilcox.test(oddzA, oddzB2, exact = FALSE, correct = FALSE)$p.value), "\n")
tw7 <- t.test(oddzB[-8], oddzA)
cat("Bez wartości skrajnej (n = 7 w B): test t Welcha t(", z2(tw7$parameter), ") =", z2(tw7$statistic), ";", bp(tw7$p.value), "\n")
Wynik w R
Zadanie 5
Rangi: wykład:8:2 wykład:11:6.5 wykład:7:1 wykład:10:4.5 wykład:12:8.5 wykład:9:3 ćwiczenia:13:10.5 ćwiczenia:10:4.5 ćwiczenia:15:14 ćwiczenia:12:8.5 ćwiczenia:14:12.5 ćwiczenia:11:6.5 projekt:16:15 projekt:14:12.5 projekt:18:17 projekt:13:10.5 projekt:17:16 projekt:19:18
Sumy rang: wykład 25.5 ćwiczenia 56.5 projekt 89 ; średnie rangi: wykład 4.25 ćwiczenia 9.42 projekt 14.83
Suma R^2/n = 1960.58 ; H bez korekty = 11.79 ; korekta na remisy C = 0.995 ; H = 11.85
df = 2 ; chi^2 krytyczne = 5.99 ; p = .003
epsilon^2 = H / (N - 1) = .697
Mediany: wykład 9.50 ćwiczenia 12.50 projekt 16.50
Kontrola kruskal.test(): chi^2 = 11.85 ; df = 2 ; p = .003
Test Dunna (SE różnicy średnich rang = 3.07 ):
                para roznica_rang    z    p p_Holm
  wykład - ćwiczenia         5.17 1.68 .093   .156
    wykład - projekt        10.58 3.44 .001   .002
 ćwiczenia - projekt         5.42 1.76 .078   .156
Kontrola PMCMRplus::kwAllPairsDunnTest (Holm):
          wykład ćwiczenia
ćwiczenia  0.156        NA
projekt    0.002     0.156
Błąd: trzy testy Manna–Whitneya bez korekty: p = .036 .005 .030

Zadanie 6
Rangi w wierszach (każdy klient osobno):
      projekt
klient A B C
     1 2 3 1
     2 2 3 1
     3 1 2 3
     4 2 3 1
     5 2 3 1
     6 1 3 2
     7 2 3 1
Sumy rang: A 12 B 20 C 10 ; suma kwadratów = 644 ; średnie rangi: A 1.71 B 2.86 C 1.43
chi^2_F = 8.00 ; df = 2 ; chi^2 krytyczne = 5.99 ; p = .018
W Kendalla = chi^2_F / (n(k - 1)) = .571
Mediany ocen: A 6.00 B 8.00 C 5.00
Kontrola friedman.test(): chi^2 = 8.00 ; p = .018
Dokładne p ( 279936 układów rang ) = .016 ; najmniejsza chi^2_F z dokładnym p <= .05 = 7.14
Post hoc: Wilcoxon dla par, p z korektą Holma: A-B .060 A-C .797 B-C .068
Projekt B oceniony najwyżej przez 6 z 7 klientów

Zadanie 7
Rangi stażu: 1 3 2 6 4 7 5 8
Rangi oceny: 1.5 4 4 6.5 1.5 8 6.5 4
d: -0.5 -1 -2 -0.5 2.5 -1 -1.5 4 ; suma d^2 = 31
Wzór skrócony 1 - 6 suma d^2 / (n(n^2 - 1)) = 0.631
Pearson na rangach (dokładnie przy remisach) rho = 0.618
t(6) = 1.92 ; t krytyczne = 2.447 ; p = .103
Kontrola cor.test(method = 'spearman'): rho = 0.618 ; p = .103

Zadanie 8
a) Z = -2.28 ; p = .022 ; r = |Z|/sqrt(N) = .341 ; rrb = 1 - 2U/(n1 n2) = .400
b) kontrola T+ + T- = 210 = n(n + 1)/2 = 210 ; Z = 2.05 ; p = .040 ; rrb = (T+ - T-)/(T+ + T-) = .524 ; r (N = 20) = .459 ; r (N = 40) = .325
c) p = .008 ; epsilon^2 = H/(N - 1) = .204

Zadanie 9
Oddział A: M = 7.00 ; SD = 1.31 ; Me = 7.00
Oddział B: M = 16.88 ; SD = 16.67 ; Me = 11.50
Test t Welcha: t( 7.09 ) = 1.67 ; p = .138
Rangi oddziału A: 2.5 6.5 4.5 8.5 1 6.5 4.5 2.5 ; R1 = 36.5 ; U = 0.5
Test Manna–Whitneya: W = 0.5 ; p < .001
Gdyby skrajny wynik wynosił 14 min: test t Welcha p < .001 ; Mann–Whitney p < .001
Bez wartości skrajnej (n = 7 w B): test t Welcha t( 12.40 ) = 5.66 ; p < .001
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz PMCMRplus); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- PMCMRplus (wersja 1.9.12): Pohlert, T. (2024). PMCMRplus: Calculate pairwise multiple comparisons of mean rank sums extended [R package]. https://doi.org/10.32614/CRAN.package.PMCMRplus
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Dlaczego w teście Manna–Whitneya odrzucam H0, gdy U jest mniejsze od wartości krytycznej?
Małe U oznacza, że wyniki jednej grupy prawie zawsze leżą poniżej wyników drugiej, czyli grupy się nie przeplatają. Dlatego w tablicach testu U (i testu Wilcoxona dla par) odrzucasz H0, gdy statystyka jest mniejsza lub równa wartości krytycznej. W zadaniu 1 U = 5 ≤ Ukryt = 6, więc wynik jest istotny.
Jak sprawdzić, czy dobrze nadałem rangi w zadaniu z testem nieparametrycznym?
Suma wszystkich rang musi wynosić N(N + 1)/2. Dla 13 osób to 91, dla 22 osób – 253. W teście Friedmana sumy rang kolumn dają n × k(k + 1)/2, a w teście Wilcoxona T+ + T− = n(n + 1)/2 po pominięciu zer.
Kiedy w zadaniu liczyć dokładne p, a kiedy przybliżenie normalne?
Dokładne p (lub tablice wartości krytycznych) stosuj przy małych grupach bez remisów, np. dwie grupy po kilka osób. Przy remisach, zerach w różnicach albo większych grupach licz Z z korektą na remisy. Na tych samych danych oba podejścia zwykle prowadzą do tego samego wniosku.
Dlaczego R daje inne p niż moje obliczenia ręczne w teście Wilcoxona lub Manna–Whitneya?
Najczęściej z trzech powodów: R domyślnie dodaje poprawkę na ciągłość (w zadaniu 2 p = .025 zamiast .023), przy małych próbach bez remisów liczy dokładne p zamiast Z, a przy remisach stosuje korektę wariancji. Ustaw exact i correct tak, jak liczyłeś na kartce, i porównaj ponownie.
Jakie zadania z testów nieparametrycznych pojawiają się na kolokwium?
Najczęściej: test U Manna–Whitneya z rangami wiązanymi, test Wilcoxona dla par, test Kruskala–Wallisa, test Friedmana i korelacja Spearmana, rzadziej test znaków i wielkość efektu. Częstym poleceniem jest też wybór testu do opisu badania, jak w zadaniu 10 – zakres porównaj z sylabusem przedmiotu.
Powiązane hasła
Przeczytaj też
Zadania ze statystyki z rozwiązaniami
Wszystkie zbiory zadań w jednym miejscu: tabela działów, poziomów i kierunków, dziewięć przykładowych zadań, ściąga wyboru testu i najczęstsze błędy.
Czytaj →PoradnikTesty nieparametryczne krok po kroku
Kiedy test rangowy ma sens, Mann–Whitney, Wilcoxon, Kruskal–Wallis z testem Dunna i Friedman na jednym badaniu – z wielkością efektu i opisem APA.
Czytaj →PoradnikWielkość efektu w testach nieparametrycznych
r = Z/√N, korelacja rangowo-biseryjna, delta Cliffa, A Varghi–Delaneya, ε² i W Kendalla: co mierzą, jak je przeliczać i podać z CI – z kodem R.
Czytaj →PoradnikZadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →Masz własne dane do pracy i nie wiesz, który test wybrać?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Friedman, M. (1937). The use of ranks to avoid the assumption of normality implicit in the analysis of variance. Journal of the American Statistical Association, 32(200), 675–701. https://doi.org/10.1080/01621459.1937.10503522
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, Article 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1 ● Otwarty dostęp
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491 ● Otwarty dostęp
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968
Cytowania BibTeX
@article{dunn1964multiple, author={Dunn, Olive Jean}, title={{Multiple comparisons using rank sums}}, journal={Technometrics}, year={1964}, volume={6}, number={3}, pages={241--252}, doi={10.1080/00401706.1964.10490181}}@article{friedman1937use, author={Friedman, Milton}, title={{The use of ranks to avoid the assumption of normality implicit in the analysis of variance}}, journal={Journal of the American Statistical Association}, year={1937}, volume={32}, number={200}, pages={675--701}, doi={10.1080/01621459.1937.10503522}}@article{kerby2014simple, author={Kerby, Dave S.}, title={{The simple difference formula: An approach to teaching nonparametric correlation}}, journal={Comprehensive Psychology}, year={2014}, volume={3}, eid={11.IT.3.1}, doi={10.2466/11.it.3.1}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@article{kruskal1952use, author={Kruskal, William H. and Wallis, W. Allen}, title={{Use of ranks in one-criterion variance analysis}}, journal={Journal of the American Statistical Association}, year={1952}, volume={47}, number={260}, pages={583--621}, doi={10.1080/01621459.1952.10483441}}@article{mann1947test, author={Mann, H. B. and Whitney, D. R.}, title={{On a test of whether one of two random variables is stochastically larger than the other}}, journal={The Annals of Mathematical Statistics}, year={1947}, volume={18}, number={1}, pages={50--60}, doi={10.1214/aoms/1177730491}}@article{wilcoxon1945individual, author={Wilcoxon, Frank}, title={{Individual comparisons by ranking methods}}, journal={Biometrics Bulletin}, year={1945}, volume={1}, number={6}, pages={80--83}, doi={10.2307/3001968}}