Zadania ze statystyki z rozwiązaniami: wszystkie zbiory w jednym miejscu
Ta strona zbiera zadania ze statystyki z rozwiązaniami z całego serwisu: piętnaście zbiorów ułożonych według działów, od statystyki opisowej po regresję logistyczną i analizę mocy. Każdy zbiór ma ten sam układ: treść z danymi do policzenia na kartce, rozwiązanie krok po kroku, interpretację w stylu APA i typowy błąd. Wszystkie liczby sprawdzono w R.
W tabeli znajdziesz dział, zbiór, przykładowe tematy, etap studiów, na którym zwykle pojawia się dany materiał, i kierunki, dla których historyjki w zadaniach są najbliższe. Etap jest orientacyjny – zakres przedmiotu zależy od uczelni, więc porównaj go z sylabusem. Pod tabelą jest po jednym krótkim zadaniu z każdego działu (dziewięć zadań z nowymi danymi), a dalej wskazówki, jak ćwiczyć, jak rozpoznać test w treści i jakich błędów unikać. Wzory są standardowe i znajdziesz je w podręcznikach statystyki dla psychologów i pedagogów (King i Minium, 2009; Field, 2018), dla ekonomii i zarządzania (Aczel i Sounderpandian, 2018) oraz dla kierunków medycznych (Petrie i Sabin, 2006).
| Dział | Zbiór | Przykładowe tematy | Poziom | Dla kogo |
|---|---|---|---|---|
| Statystyka opisowa | Statystyka opisowa – zadania | szereg rozdzielczy, średnia ważona, kwartyle ze wzoru interpolacyjnego, CV, skośność, reguła 1.5 IQR | 1. rok | ekonomia, zarządzanie, pedagogika |
| Statystyka w ekonomii | Statystyka w ekonomii i zarządzaniu – zadania | indeksy łańcuchowe, średnie tempo zmian, indeksy Laspeyresa i Paaschego, Gini i krzywa Lorenza, trend i sezonowość | 1. rok | ekonomia, zarządzanie, finanse, logistyka |
| Statystyka w Excelu | Statystyka w Excelu – zadania | funkcje opisowe, kwartyle, rozkład normalny, przedział ufności, T.TEST, CHI.TEST, korelacja i regresja w arkuszu | 1. rok | ekonomia, zarządzanie, kierunki bez zajęć z R i SPSS |
| Prawdopodobieństwo i rozkłady | Prawdopodobieństwo i rozkłady – zadania | prawdopodobieństwo warunkowe, test przesiewowy, rozkład dwumianowy, Poissona i normalny, CTG | 1. rok | wszystkie kierunki |
| Estymacja i testowanie hipotez | Estymacja i testowanie hipotez – zadania | przedział ufności z z i t, przedział Wilsona, test dla proporcji, błąd I i II rodzaju | 1. rok | wszystkie kierunki |
| Moc i liczebność próby | Moc testu i liczebność próby – zadania | n na grupę dla testu t i dwóch proporcji, minimalny wykrywalny efekt, ubytek, efekt schematu | praca dyplomowa | wszystkie kierunki, zwłaszcza magisterka |
| Testy t i przekrój materiału | Zadania ze statystyki na psychologii | wynik z, sten i centyl, testy t, korelacja, χ², ANOVA, regresja w jednym zbiorze | 1.–2. rok | psychologia, pedagogika |
| ANOVA | ANOVA – zadania | uzupełnianie tabeli ANOVA, Tukey HSD, Welch, η² i ω², ANOVA 2 × 2 z interakcją, pomiary powtarzane | 2. rok | psychologia, pedagogika, kierunki przyrodnicze |
| Chi-kwadrat i tabele krzyżowe | Test chi-kwadrat i tabele krzyżowe – zadania | test zgodności, tabele 2 × 3 i 3 × 3, reszty skorygowane, V Craméra, poprawka Yatesa, paradoks Simpsona | 1.–2. rok | socjologia, pedagogika, zdrowie publiczne |
| Statystyka medyczna | Statystyka medyczna – zadania | RR, OR, NNT, czułość i swoistość, PPV i NPV, McNemar, Kaplan–Meier | 2. rok | pielęgniarstwo, ratownictwo, fizjoterapia |
| Korelacja i regresja liniowa | Korelacja i regresja – zadania | r Pearsona z tabeli pomocniczej, Spearman, MNK, R², przedział predykcji, punkt wpływowy | 2. rok | wszystkie kierunki |
| Regresja logistyczna | Regresja logistyczna – zadania | szansa i logit, OR z wydruku, tabela klasyfikacji, krzywa ROC, pseudo-R², test ilorazu wiarygodności | praca dyplomowa | zdrowie publiczne, psychologia, ekonomia |
| Testy nieparametryczne | Testy nieparametryczne – zadania | Mann–Whitney, Wilcoxon, test znaków, Kruskal–Wallis, Friedman, wielkość efektu | 2. rok | psychologia, pielęgniarstwo, fizjoterapia |
| Psychometria | Psychometria – zadania | alfa Cronbacha ręcznie, omega, moc dyskryminacyjna pozycji, błąd pomiaru, RCI, Spearman–Brown | 2. rok, praca dyplomowa | psychologia, pedagogika |
| Metodologia badań | Metodologia badań – zadania | zmienne i skale, schemat badania, trafność wewnętrzna, hipotezy, operacjonalizacja, dobór próby | praca dyplomowa | wszystkie kierunki |
| Teoria na egzamin | Pytania na egzamin ze statystyki | 66 pytań z krótkimi odpowiedziami: skale, rozkłady, wartość p, moc, wybór testu | 1.–2. rok | wszystkie kierunki |
| Obrona: statystyka | Pytania ze statystyki na obronę | pytania komisji według analizy w pracy: test t, χ², regresja, alfa | praca dyplomowa | magistranci i licencjaci |
| Obrona: metodologia | Pytania z metodologii na obronę | pytania według typu badania: ankieta, eksperyment, badanie przed i po | praca dyplomowa | magistranci i licencjaci |
| Narzędzie | Tablice rozkładów t, χ², F i z | wartości krytyczne do wszystkich zbiorów i kalkulator wartości krytycznej | każdy etap | wszystkie kierunki |
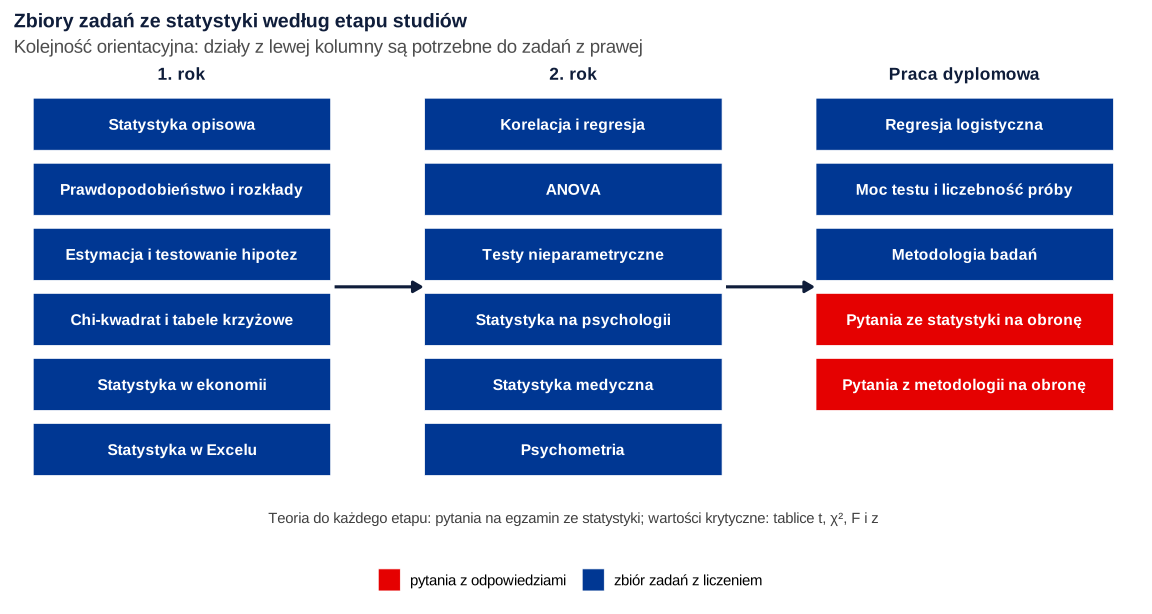
Rysunek 1 pokazuje te same zbiory jako mapę. Zadania z prawej kolumny korzystają z umiejętności z lewej: bez przedziału ufności i logiki testu trudno zrozumieć ANOVA, a bez regresji liniowej – logistyczną.
Zadanie 1. Statystyka opisowa: średnia, mediana, SD i CV
Treść. Ośmiu studentów ekonomii podało liczbę godzin pracy dorywczej w tygodniu: 6, 10, 12, 8, 20, 14, 10, 16. Oblicz średnią, medianę, odchylenie standardowe z próby i współczynnik zmienności.
Rozwiązanie. Σx = 96, więc M = 96 / 8 = 12.00. Po uporządkowaniu (6, 8, 10, 10, 12, 14, 16, 20) mediana to (10 + 12) / 2 = 11.00. Odchylenia od średniej: −6, −2, 0, −4, 8, 2, −2, 4; suma ich kwadratów SS = 144. Wariancja s² = 144 / 7 = 20.57, SD = 4.54.
Odpowiedź. Studenci pracują średnio 12 godzin tygodniowo (SD = 4.54, Me = 11.00), a odchylenie standardowe to prawie 38% średniej. Z zaokrąglonym SD = 4.54 wyjdzie 37.83% – stąd zasada, by zaokrąglać dopiero na końcu (więcej o współczynniku zmienności). Więcej zadań: statystyka opisowa – zadania z rozwiązaniami; zadania z indeksów i średniej geometrycznej są w zbiorze statystyka w ekonomii, a te same miary policzone formułami arkusza – w zbiorze statystyka w Excelu.
Zadanie 2. Prawdopodobieństwo: rozkład dwumianowy
Treść. Lek wywołuje działanie niepożądane u 10% pacjentów. Pielęgniarka podaje go ośmiu pacjentom, a reakcje są od siebie niezależne. Jakie jest prawdopodobieństwo, że działanie niepożądane wystąpi u co najmniej dwóch osób? Ilu pacjentów z działaniem niepożądanym należy oczekiwać?
Rozwiązanie. Liczba pacjentów z działaniem niepożądanym ma rozkład dwumianowy z n = 8 i prawdopodobieństwem sukcesu 0.1. „Co najmniej dwóch” najłatwiej policzyć przez zdarzenie przeciwne:
Odpowiedź. Prawdopodobieństwo wynosi ok. 0.19, a wartość oczekiwana to np = 0.8 pacjenta. Typowy błąd to policzenie samego P(X = 2) zamiast sumy dla 2, 3, …, 8. Więcej zadań: prawdopodobieństwo i rozkłady – zadania z rozwiązaniami.
Zadanie 3. Testowanie hipotez: test t dla jednej próby
Treść. Dziekanat deklaruje, że średni czas oczekiwania w kolejce wynosi 15 minut. Dziewięciu studentów zmierzyło swój czas: 18, 14, 20, 17, 16, 19, 15, 21, 13. Sprawdź deklarację (α = .05, test dwustronny) i podaj 95% przedział ufności.
Rozwiązanie. M = 17.00, SS = 60, s² = 7.5, SD = 2.74, SE = 2.74 / √9 = 0.913. Statystyka testu t dla jednej próby:
Ponieważ 2.19 < 2.306, nie ma podstaw do odrzucenia H0 (p = .060). Przedział: 17 ± 2.306 × 0.913 = [14.89, 19.11].
Odpowiedź. t(8) = 2.19, p = .060; przedział obejmuje 15. To nie dowód, że deklaracja jest prawdziwa: przy dziewięciu pomiarach przedział jest szeroki, a test ma małą moc. Więcej zadań: estymacja i testowanie hipotez; jak zaplanować liczbę pomiarów – moc testu i liczebność próby.
Zadanie 4. ANOVA z danych zbiorczych
Treść. Trzy grupy po sześć osób uczyły się słówek różnymi metodami. Średnie wyniki: 14, 17 i 20 punktów, odchylenia standardowe: 3, 4 i 3.5. Czy metody różnią się skutecznością (α = .05)? Oblicz η².
Rozwiązanie. Średnia ogólna = 17. Suma kwadratów między grupami: SSB = 6 × [(14 − 17)² + 0² + (20 − 17)²] = 108. Wewnątrz grup: SSW = Σ(n − 1)s² = 5 × (9 + 16 + 12.25) = 186.25. Stopnie swobody: 2 i 15.
Odpowiedź. F(2, 15) = 4.35, p = .032, η² = .37: metody różnią się, a różnica między grupami wyjaśnia 37% zmienności wyników w próbie. Które pary się różnią, pokaże test post hoc. Wynik sprawdzisz w kalkulatorze testu t i ANOVA ze średnich i SD, a więcej zadań (Tukey, Welch, interakcja) jest w zbiorze ANOVA – zadania z rozwiązaniami.
Zadanie 5. Testy nieparametryczne: test U Manna–Whitneya
Treść. Pięć osób wypełniło formularz w nowej wersji systemu, pięć innych – w starej. Czas (min): nowa wersja 9, 11, 12, 15, 13; stara 14, 16, 18, 20, 22. Porównaj grupy testem U Manna–Whitneya (α = .05, dwustronnie).
Rozwiązanie. Uporządkuj wszystkie 10 wyników i nadaj rangi od 1 do 10. Rangi nowej wersji: 1, 2, 3, 6, 4, czyli R1 = 16.
Mniejsza wartość U = 1. Wartość krytyczna z tablic dla n1 = n2 = 5 wynosi 2, a H0 odrzucasz, gdy U ≤ 2.
Odpowiedź. U = 1, dokładne p = .016: w nowej wersji formularz wypełnia się szybciej. Uwaga na kierunek: w tym teście małe U oznacza dużą różnicę. Więcej zadań: testy nieparametryczne – zadania z rozwiązaniami.
Zadanie 6. Tabela 2 × 2: chi-kwadrat, RR i NNT
Treść. W badaniu z losowym przydziałem 160 pacjentów (po 80) w grupie objętej programem zapobiegania upadkom upadło 6 osób, a w grupie z opieką standardową – 16. Wykonaj test χ² (bez poprawki), oblicz ryzyko względne i NNT.
Rozwiązanie. Liczności oczekiwane: upadek 22 × 80 / 160 = 11 w każdym wierszu, brak upadku 69.
Ryzyko upadku: 6 / 80 = 0.075 i 16 / 80 = 0.200, więc RR = 0.375. Bezwzględna redukcja ryzyka to 0.125, a NNT = 1 / 0.125 = 8.
Odpowiedź. χ²(1, N = 160) = 5.27, p = .022, φ = .18. Ryzyko upadku w programie stanowi 37.5% ryzyka w opiece standardowej; jednego upadku unika się średnio na ośmiu objętych programem. Z poprawką Yatesa χ² = 4.27. Więcej zadań: chi-kwadrat i tabele krzyżowe oraz statystyka medyczna dla pielęgniarstwa.
Zadanie 7. Korelacja Pearsona i jej test
Treść. Sześć osób podało liczbę godzin snu przed badaniem i uzyskało wynik w teście uwagi. Sen: 5, 6, 6, 7, 8, 10; uwaga: 10, 12, 14, 13, 17, 18. Oblicz r Pearsona i sprawdź jego istotność (α = .05).
Rozwiązanie. Średnie: 7 i 14. Z tabeli pomocniczej: suma iloczynów odchyleń SP = 25, SSx = 16, SSy = 46.
Odpowiedź. r(4) = .92, p = .009: dłuższy sen współwystępuje z lepszym wynikiem testu uwagi. Badanie jest korelacyjne i ma sześć osób, więc nie dowodzi, że sen poprawia uwagę, a oszacowanie korelacji jest bardzo nieprecyzyjne. Więcej zadań: korelacja i regresja – zadania z rozwiązaniami.
Zadanie 8. Regresja logistyczna: od logitu do prawdopodobieństwa
Treść. Model regresji logistycznej dla zdania egzaminu ma postać logit(p) = −2.4 + 0.15 × godziny nauki. Oblicz prawdopodobieństwo zdania dla osoby, która uczyła się 20 godzin, oraz iloraz szans dla 1 i 10 godzin nauki.
Rozwiązanie. Logit = −2.4 + 0.15 × 20 = 0.6. Szansa = e0.6 = 1.822, a prawdopodobieństwo = szansa / (1 + szansa) = 1.822 / 2.822 = 0.646. Iloraz szans na godzinę: e0.15 = 1.162; na 10 godzin: e1.5 = 4.48 (nie 10 × 1.162).
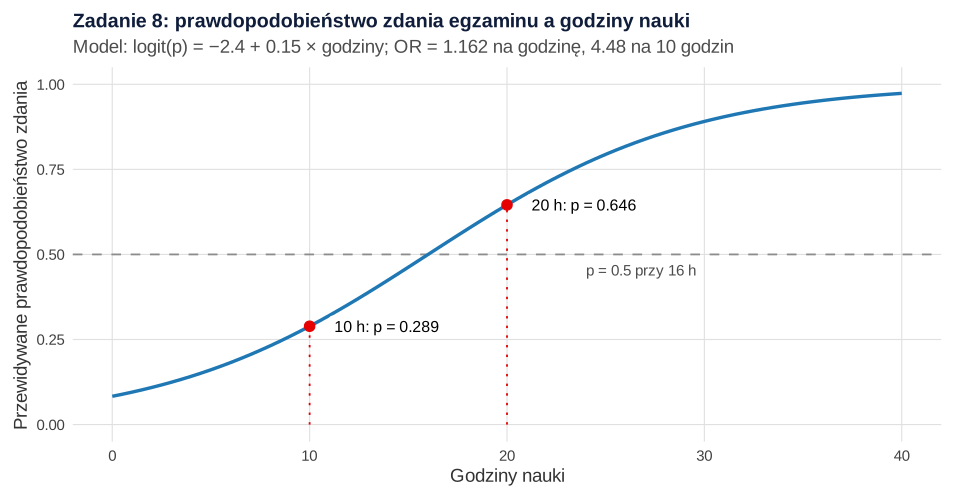
Odpowiedź. Osoba po 20 godzinach nauki zda z prawdopodobieństwem ok. 0.65; każda godzina zwiększa szansę (nie prawdopodobieństwo) o 16.2%. Rysunek 2 pokazuje, że po 10 godzinach prawdopodobieństwo wynosi tylko 0.289. Więcej zadań: regresja logistyczna – zadania z rozwiązaniami.
Zadanie 9. Psychometria: standardowy błąd pomiaru
Treść. Test ma wyniki w skali tenowej (M = 50, SD = 10) i rzetelność .91. Osoba uzyskała 62 punkty. Oblicz standardowy błąd pomiaru i 95% przedział dla jej wyniku.
Rozwiązanie. Standardowy błąd pomiaru zależy od rozproszenia wyników i rzetelności:
Odpowiedź. Przy rzetelności .91 wynik 62 należy czytać jako „najpewniej między 56 a 68”, a nie jako dokładną liczbę. To wersja uproszczona – przedział zbudowany wokół wyniku otrzymanego. Więcej zadań: psychometria – zadania z rozwiązaniami; przeliczanie wyniku na normy ułatwia konwerter wyników na normy.
Jak ćwiczyć przed kolokwium
Kolejność działów. Zacznij od statystyki opisowej i rozkładu normalnego, potem przedział ufności i logika testu (H0, p, α), a dopiero później konkretne testy: t, χ², korelacja, ANOVA, testy nieparametryczne. Regresja logistyczna, psychometria i analiza mocy przydają się głównie przy pracy dyplomowej. Ta kolejność odpowiada kolumnom na rysunku 1.
Rozwiązuj bez patrzenia. Zakryj rozwiązanie i daj sobie tyle czasu, ile będziesz mieć na kolokwium (zwykle kilka–kilkanaście minut na zadanie). Najpierw zapisz, jaki test wybierasz i dlaczego, potem wzór, dopiero wtedy podstawienie. Jeśli utkniesz, odsłoń tylko pierwszy krok rozwiązania i wróć do liczenia. Po kilku dniach rozwiąż to samo zadanie jeszcze raz – utrwala to procedurę lepiej niż czytanie kolejnych rozwiązań.
Sprawdzaj wynik programem. Każde zadanie z tej strony i ze zbiorów sprawdzisz w R (kod niżej) albo w kalkulatorach serwisu, bez instalowania czegokolwiek:
- średnia, SD, kwartyle i normalność – kalkulator statystyk opisowych;
- przedział ufności dla średniej i proporcji – kalkulator przedziału ufności;
- p z gotowej statystyki t, z, χ² lub F – kalkulator wartości p, a wartości krytyczne – tablice rozkładów;
- test t i ANOVA ze średnich i SD – kalkulator z zadania 4;
- tabele 2 × 2 i r × c (χ², Fisher, RR, OR) – kalkulator tabeli 2 × 2;
- istotność korelacji i porównanie dwóch korelacji – kalkulator korelacji;
- liczebność próby – kalkulator liczebności próby.
Pełna lista narzędzi jest na stronie kalkulatory statystyczne online. Jeśli wynik różni się od rozwiązania tylko na ostatnim miejscu po kropce, to zwykle skutek zaokrągleń pośrednich. Większa różnica oznacza najczęściej zły wzór, złe df albo inny test. Teorię (definicje, „wyjaśnij różnicę”) powtórzysz z pytań na egzamin ze statystyki – ta strona dotyczy liczenia.
Jak rozpoznać, który test w zadaniu
W treści zadania prawie zawsze jest sygnał, który test wybrać. Szukaj słów o liczbie grup, o tym, czy osoby są te same, i o rodzaju wyniku: liczba, kategoria czy „tak/nie”.
| Sygnał w treści | Metoda | Gdzie ćwiczyć |
|---|---|---|
| „producent deklaruje średnio…”, jedna grupa i wartość z zewnątrz | test t dla jednej próby, przedział ufności | zadanie 3, estymacja i testowanie |
| „dwie grupy”, różne osoby, wynik liczbowy | test t dla prób niezależnych; przy rangach lub skrajnych wartościach Mann–Whitney | psychologia, testy nieparametryczne |
| „przed i po”, „te same osoby” | test t dla prób zależnych; Wilcoxon | psychologia, testy nieparametryczne |
| „trzy metody”, „cztery grupy” | ANOVA; Kruskal–Wallis | ANOVA, testy nieparametryczne |
| „odsetek”, „liczba osób w kategoriach”, tabela | χ², test Fishera przy małych licznościach; RR, OR | chi-kwadrat, statystyka medyczna |
| „związek”, „czy im więcej…, tym…” | korelacja Pearsona lub Spearmana | korelacja i regresja |
| „przewidź wynik”, „o ile wzrośnie” | regresja liniowa | korelacja i regresja |
| „zda / nie zda”, „szansa” | regresja logistyczna | regresja logistyczna |
| „ile osób potrzeba” | analiza mocy | moc testu i liczebność próby |
| „rzetelność skali”, „wynik prawdziwy” | alfa, błąd pomiaru, RCI | psychometria |
Pełny schemat z modelami dla wielu zmiennych znajdziesz we wpisie jaki test statystyczny do jakiej hipotezy. W zadaniach z metodologii (rozpoznaj schemat badania, nazwij zmienne, oceń wniosek) zwykle się nie liczy – ćwiczysz je w zbiorze metodologia badań – zadania z rozwiązaniami.
Najczęstsze błędy w rozwiązaniach
- Dzielenie przez n zamiast n − 1 przy wariancji z próby. W zadaniu 1 dałoby to SD = 4.24 zamiast 4.54.
- Test dla prób niezależnych przy pomiarze przed i po. Te same osoby to próby zależne – inny wzór i inne df.
- Złe stopnie swobody. Dla jednej próby n − 1, dla dwóch grup n1 + n2 − 2, dla korelacji n − 2, dla χ² (w − 1)(k − 1). Złe df to zła wartość krytyczna.
- „Przyjmujemy H0, więc różnicy nie ma”. Wynik nieistotny (zadanie 3) oznacza brak podstaw do odrzucenia H0, a nie dowód równości.
- χ² liczony na procentach. Do wzoru wstawiasz liczności, nie odsetki. Sprawdź też liczności oczekiwane – przy bardzo małych wybierz test Fishera.
- Zaokrąglanie w trakcie liczenia. Zachowuj 3–4 miejsca w obliczeniach pośrednich i zaokrąglaj dopiero wynik (zadanie 1: 37.80% a 37.83%).
- Mylenie ilorazu szans z ryzykiem względnym i prawdopodobieństwem. OR = 1.16 nie znaczy „prawdopodobieństwo większe o 16%” (zadanie 8), a RR liczysz z ryzyk, nie z szans (zadanie 6).
- Sam wynik testu bez wielkości efektu i zapisu APA. Wartość p nie mówi, jak duży jest efekt – dopisz d, η², r lub RR i zinterpretuj je (wielkość efektu – interpretacja).
Jeśli po kolokwium przychodzi czas na własne badanie, a dane są większe niż w zadaniach, możesz skorzystać z konsultacji analizy statystycznej dla studentów – pomożemy dobrać metodę i wyjaśnimy wyniki tak, żebyś umiał(a) je samodzielnie opisać.
Sprawdź wyniki w R: kod i wynik
Jeden krótki przepis liczy wszystkie liczby z dziewięciu zadań na danych wpisanych w kod (bez losowania). Rachunek „jak na kartce” jest sprawdzany gotową funkcją R (t.test, wilcox.test, chisq.test, cor.test). Rysunki przygotowano w osobnym skrypcie.
Zadania 1–9: przykładowe zadania ze wszystkich działów
R
# B386 – sprawdzenie 9 przykładowych zadań ze statystyki (dane z treści wpisane na sztywno, bazowy R)
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
bz <- function(x, d = 3) sub("^(-?)0\\.", "\\1.", formatC(x, format = "f", digits = d))   # bez zera: p, r, η²

cat("Zadanie 1. Godziny pracy dorywczej w tygodniu (8 studentów)\n")
x1 <- c(6, 10, 12, 8, 20, 14, 10, 16)
cat("Suma =", sum(x1), "; M =", z2(mean(x1)), "; Me =", z2(median(x1)), "; SS =", sum((x1 - mean(x1))^2), "\n")
cat("Odchylenia:", x1 - mean(x1), "; uporządkowane:", sort(x1), "\n")
cat("s^2 =", z2(var(x1)), "; SD =", z2(sd(x1)), "; CV =", z2(100 * sd(x1) / mean(x1)), "%\n")
cat("CV z zaokrąglonym SD = 4.54:", z2(100 * 4.54 / 12), "%; błąd: SD liczone z n =", z2(sqrt(sum((x1 - mean(x1))^2) / 8)), "\n\n")

cat("Zadanie 2. Działanie niepożądane u 8 pacjentów, prawdopodobieństwo 0.10\n")
cat("P(X = 0) =", z3(dbinom(0, 8, .1)), "; P(X = 1) =", z3(dbinom(1, 8, .1)),
    "; P(X >= 2) =", z3(pbinom(1, 8, .1, lower.tail = FALSE)), "; E(X) =", 8 * .1, "\n\n")

cat("Zadanie 3. Czas oczekiwania w dziekanacie (min), H0: mu = 15\n")
x3 <- c(18, 14, 20, 17, 16, 19, 15, 21, 13)
se3 <- sd(x3) / sqrt(length(x3)); t3 <- (mean(x3) - 15) / se3; tk3 <- qt(.975, length(x3) - 1)
cat("M =", z2(mean(x3)), "; SS =", sum((x3 - mean(x3))^2), "; s^2 =", var(x3), "; SD =", z2(sd(x3)), "; SE =", z3(se3), "; t(8) =", z2(t3), "; t kryt. =", z3(tk3), "\n")
tt3 <- t.test(x3, mu = 15)
cat("Kontrola t.test(): t =", z2(tt3$statistic), "; p =", bz(tt3$p.value), "; 95% CI [", z2(tt3$conf.int), "]\n\n")

cat("Zadanie 4. ANOVA z danych zbiorczych: 3 grupy po 6 osób\n")
n4 <- c(6, 6, 6); M4 <- c(14, 17, 20); SD4 <- c(3, 4, 3.5)
GM <- sum(n4 * M4) / sum(n4)
SSb <- sum(n4 * (M4 - GM)^2); SSw <- sum((n4 - 1) * SD4^2)
dfb <- length(M4) - 1; dfw <- sum(n4) - length(M4); F4 <- (SSb / dfb) / (SSw / dfw)
cat("Średnia ogólna =", GM, "; SSb =", SSb, "; SSw =", SSw, "; MSb =", SSb / dfb, "; MSw =", z2(SSw / dfw), "\n")
cat("F(", dfb, ",", dfw, ") =", z2(F4), "; F kryt. =", z2(qf(.95, dfb, dfw)), "; p =",
    bz(pf(F4, dfb, dfw, lower.tail = FALSE)), "; eta^2 =", bz(SSb / (SSb + SSw)), "\n\n")

cat("Zadanie 5. Test U Manna–Whitneya: czas wypełnienia formularza (min)\n")
nowa <- c(9, 11, 12, 15, 13); stara <- c(14, 16, 18, 20, 22)
rg <- rank(c(nowa, stara)); R1 <- sum(rg[1:5]); U1 <- R1 - 5 * 6 / 2
cat("Rangi nowej wersji:", rg[1:5], "; R1 =", R1, "; U1 =", U1, "; U2 =", 25 - U1, "\n")
cat("U krytyczne (n1 = n2 = 5, alfa = .05 dwustronnie) =", qwilcox(.025, 5, 5) - 1, "\n")
w5 <- wilcox.test(nowa, stara)
cat("Kontrola wilcox.test(): W =", w5$statistic, "; p (dokładne) =", bz(w5$p.value), "\n\n")

cat("Zadanie 6. Upadki pacjentów: program prewencji a opieka standardowa\n")
tab6 <- matrix(c(6, 16, 74, 64), nrow = 2, dimnames = list(c("program", "standard"), c("upadek", "brak")))
E6 <- outer(rowSums(tab6), colSums(tab6)) / sum(tab6); print(E6)
chi6 <- sum((tab6 - E6)^2 / E6)
cat("Składniki (O - E)^2 / E:", z3((tab6 - E6)^2 / E6), "\n")
cat("chi^2(1) =", z2(chi6), "; chi^2 kryt. =", z2(qchisq(.95, 1)), "; p =", bz(pchisq(chi6, 1, lower.tail = FALSE)), "; phi =", bz(sqrt(chi6 / sum(tab6))), "\n")
r1 <- 6 / 80; r2 <- 16 / 80
cat("Ryzyko: program =", z3(r1), "; standard =", z3(r2), "; RR =", z3(r1 / r2), "; ARR =", z3(r2 - r1),
    "; NNT =", 1 / (r2 - r1), "\n")
cat("Kontrola chisq.test(correct = FALSE): chi^2 =", z2(chisq.test(tab6, correct = FALSE)$statistic),
    "; z poprawką Yatesa =", z2(chisq.test(tab6)$statistic), "\n\n")

cat("Zadanie 7. Korelacja Pearsona: godziny snu a wynik testu uwagi (6 osób)\n")
sen <- c(5, 6, 6, 7, 8, 10); uwaga <- c(10, 12, 14, 13, 17, 18)
dx <- sen - mean(sen); dy <- uwaga - mean(uwaga)
r7 <- sum(dx * dy) / sqrt(sum(dx^2) * sum(dy^2)); t7 <- r7 * sqrt(4) / sqrt(1 - r7^2)
cat("M sen =", mean(sen), "; M uwaga =", mean(uwaga), "; pierwiastek z SSx * SSy =", z2(sqrt(sum(dx^2) * sum(dy^2))), "\n")
cat("SP =", sum(dx * dy), "; SSx =", sum(dx^2), "; SSy =", sum(dy^2), "; r =", bz(r7), "; t(4) =", z2(t7),
    "; t kryt. =", z3(qt(.975, 4)), "\n")
cat("Kontrola cor.test(): p =", bz(cor.test(sen, uwaga)$p.value), "\n\n")

cat("Zadanie 8. Regresja logistyczna: logit(p) = -2.4 + 0.15 * godziny nauki\n")
lg <- -2.4 + 0.15 * 20
cat("logit dla 20 h =", lg, "; szansa =", z3(exp(lg)), "; prawdopodobieństwo =", z3(plogis(lg)), "\n")
cat("OR na 1 h =", z3(exp(0.15)), "; OR na 10 h =", z2(exp(1.5)), "; prawdopodobieństwo dla 10 h =", z3(plogis(-2.4 + 1.5)), "\n\n")

cat("Zadanie 9. Standardowy błąd pomiaru: SD = 10, rzetelność .91, wynik 62\n")
sem <- 10 * sqrt(1 - .91)
cat("SEM =", z2(sem), "; 95% przedział [", z2(62 - 1.96 * sem), ",", z2(62 + 1.96 * sem), "]\n")
Wynik w R
Zadanie 1. Godziny pracy dorywczej w tygodniu (8 studentów)
Suma = 96 ; M = 12.00 ; Me = 11.00 ; SS = 144
Odchylenia: -6 -2 0 -4 8 2 -2 4 ; uporządkowane: 6 8 10 10 12 14 16 20
s^2 = 20.57 ; SD = 4.54 ; CV = 37.80 %
CV z zaokrąglonym SD = 4.54: 37.83 %; błąd: SD liczone z n = 4.24

Zadanie 2. Działanie niepożądane u 8 pacjentów, prawdopodobieństwo 0.10
P(X = 0) = 0.430 ; P(X = 1) = 0.383 ; P(X >= 2) = 0.187 ; E(X) = 0.8

Zadanie 3. Czas oczekiwania w dziekanacie (min), H0: mu = 15
M = 17.00 ; SS = 60 ; s^2 = 7.5 ; SD = 2.74 ; SE = 0.913 ; t(8) = 2.19 ; t kryt. = 2.306
Kontrola t.test(): t = 2.19 ; p = .060 ; 95% CI [ 14.89 19.11 ]

Zadanie 4. ANOVA z danych zbiorczych: 3 grupy po 6 osób
Średnia ogólna = 17 ; SSb = 108 ; SSw = 186.25 ; MSb = 54 ; MSw = 12.42
F( 2 , 15 ) = 4.35 ; F kryt. = 3.68 ; p = .032 ; eta^2 = .367

Zadanie 5. Test U Manna–Whitneya: czas wypełnienia formularza (min)
Rangi nowej wersji: 1 2 3 6 4 ; R1 = 16 ; U1 = 1 ; U2 = 24
U krytyczne (n1 = n2 = 5, alfa = .05 dwustronnie) = 2
Kontrola wilcox.test(): W = 1 ; p (dokładne) = .016

Zadanie 6. Upadki pacjentów: program prewencji a opieka standardowa
         upadek brak
program      11   69
standard     11   69
Składniki (O - E)^2 / E: 2.273 2.273 0.362 0.362
chi^2(1) = 5.27 ; chi^2 kryt. = 3.84 ; p = .022 ; phi = .181
Ryzyko: program = 0.075 ; standard = 0.200 ; RR = 0.375 ; ARR = 0.125 ; NNT = 8
Kontrola chisq.test(correct = FALSE): chi^2 = 5.27 ; z poprawką Yatesa = 4.27

Zadanie 7. Korelacja Pearsona: godziny snu a wynik testu uwagi (6 osób)
M sen = 7 ; M uwaga = 14 ; pierwiastek z SSx * SSy = 27.13
SP = 25 ; SSx = 16 ; SSy = 46 ; r = .922 ; t(4) = 4.75 ; t kryt. = 2.776
Kontrola cor.test(): p = .009

Zadanie 8. Regresja logistyczna: logit(p) = -2.4 + 0.15 * godziny nauki
logit dla 20 h = 0.6 ; szansa = 1.822 ; prawdopodobieństwo = 0.646
OR na 1 h = 1.162 ; OR na 10 h = 4.48 ; prawdopodobieństwo dla 10 h = 0.289

Zadanie 9. Standardowy błąd pomiaru: SD = 10, rzetelność .91, wynik 62
SEM = 3.00 ; 95% przedział [ 56.12 , 67.88 ]
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Od którego zbioru zadań ze statystyki zacząć naukę?
Od statystyki opisowej, potem prawdopodobieństwo i rozkłady oraz estymacja i testowanie hipotez – to podstawa wszystkich dalszych testów. Korelację, ANOVA i testy nieparametryczne ćwicz dopiero wtedy, gdy rozumiesz przedział ufności i wartość p. Regresję logistyczną, psychometrię i analizę mocy zostaw na czas pracy dyplomowej, chyba że są w sylabusie.
Czy zadania ze statystyki z rozwiązaniami wystarczą do zdania kolokwium?
Pomogą, jeśli rozwiązujesz je samodzielnie, z zakrytym rozwiązaniem i w limicie czasu, a nie tylko czytasz. Porównaj zakres zbiorów z sylabusem i zadaniami z poprzednich lat. Teorię, o którą pytają w części opisowej, powtórz osobno z pytań na egzamin ze statystyki.
Jak sprawdzić rozwiązanie zadania ze statystyki bez SPSS?
Wpisz dane do kalkulatora w przeglądarce (statystyki opisowe, przedział ufności, wartość p, tabela 2 × 2, ANOVA ze średnich i SD) albo uruchom krótki kod R pokazany na tej stronie. Wynik z programu powinien zgadzać się z ręcznym do drugiego miejsca po kropce; większa różnica wskazuje zwykle zły wzór albo złe df.
Dlaczego mój wynik różni się od rozwiązania o kilka setnych?
Najczęściej przez zaokrąglanie w trakcie liczenia. W zadaniu 1 współczynnik zmienności z pełnym SD wynosi 37.80%, a z SD zaokrąglonym do 4.54 – 37.83%. Zachowuj 3–4 miejsca po kropce w obliczeniach pośrednich i zaokrąglaj dopiero wynik końcowy.
Które zbiory zadań przydadzą się przy pisaniu pracy magisterskiej?
Moc testu i liczebność próby (ile osób zbadać), metodologia badań (zmienne, schemat, trafność), regresja logistyczna i psychometria (rzetelność skal), a przed obroną – pytania ze statystyki i z metodologii na obronę. Zadania pomagają zrozumieć analizę, ale nie zastąpią jej wykonania na własnych danych.
Powiązane hasła
Przeczytaj też
Zadania ze statystyki na psychologii
Dziesięć zadań jak na kolokwium: opisowe, steny i centyle, przedział ufności, testy t, korelacja, χ², ANOVA i regresja – z rozwiązaniami krok po kroku.
Czytaj →PoradnikStatystyka opisowa – zadania z rozwiązaniami
Dziewięć zadań jak na kolokwium: szeregi rozdzielcze, średnia ważona, mediana i kwartyle ze wzoru interpolacyjnego, wariancja, CV, skośność i reguła 1.5 IQR.
Czytaj →PoradnikEstymacja i testowanie hipotez – zadania
Dziesięć zadań jak na kolokwium: przedziały ufności (z, t, Wilson), liczebność próby, testy dla średniej i proporcji, test jednostronny, błąd II rodzaju i moc.
Czytaj →PoradnikANOVA – zadania z rozwiązaniami
Dziesięć zadań: tabela ANOVA, Tukey HSD, Levene i Welch, ANOVA 2 × 2 z interakcją, η² i ω², pomiary powtarzane, kontrast planowany i F = t².
Czytaj →PoradnikChi-kwadrat i tabele krzyżowe – zadania z rozwiązaniami
Dziesięć zadań z testu χ²: zgodność, tabele krzyżowe, reszty skorygowane, φ i V, Yates, małe liczności, test trendu i paradoks Simpsona – krok po kroku.
Czytaj →PoradnikKorelacja i regresja – zadania z rozwiązaniami
Dziesięć zadań: kowariancja, Pearson i Spearman, metoda najmniejszych kwadratów, R², przedział predykcji, reszty, punkt wpływowy, regresja wieloraka i kwartet Anscombe’a.
Czytaj →PoradnikPytania na egzamin ze statystyki
66 krótkich pytań z odpowiedziami w 9 działach – od skal pomiarowych i SD po wartość p, moc, wybór testu, regresję i pytania „wyjaśnij różnicę”.
Czytaj →PoradnikTablice rozkładów t, χ², F i z
Wartości krytyczne t, χ², F i z policzone w R oraz kalkulator wartości krytycznej i p dla dowolnych df z wykresem obszaru odrzucenia.
Czytaj →PoradnikJaki test statystyczny do jakiej hipotezy?
Tabela doboru: typ hipotezy, test, alternatywa nieparametryczna i miara efektu. Cztery przykłady w R z gotowym zapisem APA.
Czytaj →Zadania już umiesz, a teraz czas na własne dane do pracy?
Pomożemy dobrać analizę do hipotez, sprawdzimy obliczenia w R lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aczel, A. D., & Sounderpandian, J. (2018). Statystyka w zarządzaniu (Wyd. 2). Wydawnictwo Naukowe PWN.
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE.
- King, B. M., & Minium, E. W. (2009). Statystyka dla psychologów i pedagogów. Wydawnictwo Naukowe PWN.
- Petrie, A., & Sabin, C. (2006). Statystyka medyczna w zarysie. Wydawnictwo Lekarskie PZWL.
Cytowania BibTeX
@book{aczel2018statystyka, author={Aczel, Amir D. and Sounderpandian, Jayavel}, title={{Statystyka w zarządzaniu}}, year={2018}, edition={Wyd. 2}, publisher={Wydawnictwo Naukowe PWN}}@book{field2018discovering, author={Field, Andy}, title={{Discovering statistics using IBM SPSS Statistics}}, year={2018}, edition={5th}, publisher={SAGE}}@book{king2009statystyka, author={King, Bruce M. and Minium, Edward W.}, title={{Statystyka dla psychologów i pedagogów}}, year={2009}, publisher={Wydawnictwo Naukowe PWN}}@book{petrie2006statystyka, author={Petrie, Aviva and Sabin, Caroline}, title={{Statystyka medyczna w zarysie}}, year={2006}, publisher={Wydawnictwo Lekarskie PZWL}}