Statystyka w ekonomii – zadania z rozwiązaniami: jak korzystać ze zbioru
Na ekonomii i zarządzaniu kolokwium ze statystyki szybko wychodzi poza średnią: pojawiają się indeksy, inflacja, nierówności, trend i sezonowość. Poniżej znajdziesz statystykę w ekonomii i zarządzaniu w formie zadań z rozwiązaniami: dziesięć zadań z danymi do policzenia na kalkulatorze.
Każde zadanie ma ten sam układ: treść z danymi, rozwiązanie krok po kroku, krótką interpretację i jeden typowy błąd. Najpierw spróbuj rozwiązać zadanie sam(a). Wszystkie liczby sprawdziliśmy w R (kod na końcu wpisu). Dane są wymyślone do ćwiczeń – nie są danymi GUS ani żadnej firmy, także wtedy, gdy nazywamy wskaźnik „wskaźnikiem cen”. Wzory są standardowe i znajdziesz je w podręcznikach statystyki dla ekonomistów i menedżerów (np. Aczel i Sounderpandian, 2018).
Ten zbiór nie powtarza materiału ze statystyki opisowej w zadaniach (szeregi rozdzielcze, kwartyle, współczynnik zmienności).
| Zadanie | Historyjka | Co liczysz |
|---|---|---|
| 1 | sprzedaż firmy w latach 2019–2024 | indeksy jednopodstawowe i łańcuchowe, zmiana podstawy |
| 2 | ta sama sprzedaż | średnie tempo zmian (średnia geometryczna), prognoza |
| 3 | zakup surowca za stałą kwotę; czas pracy na sztukę | średnia harmoniczna |
| 4 | ceny i ilości trzech produktów piekarni | indeksy agregatowe wartości, cen i ilości: Laspeyres, Paasche, Fisher |
| 5 | wynagrodzenie w firmie i wskaźnik cen | zmiana nominalna i realna, deflowanie |
| 6 | udziały kwintylowe dochodów w dwóch regionach | krzywa Lorenza, współczynnik Giniego z trapezów, S80/S20 |
| 7 | obroty 10 klientów hurtowni | udział top 20%, wykres Pareto, Gini z danych jednostkowych |
| 8 | kwartalna sprzedaż sklepu 2022–2024 | wyśrodkowana średnia ruchoma 2×4 |
| 9 | ta sama sprzedaż | trend liniowy metodą najmniejszych kwadratów, R², prognoza trendu |
| 10 | ta sama sprzedaż | wskaźniki sezonowości (multiplikatywne i addytywne), prognoza kwartalna |
Dane do wszystkich zadań możesz pobrać w jednym pliku: statystyka-w-ekonomii-zadania-dane.csv (format długi: zadanie, okres, grupa, zmienna, wartość).
Zadanie 1. Indeksy jednopodstawowe i łańcuchowe
Treść zadania
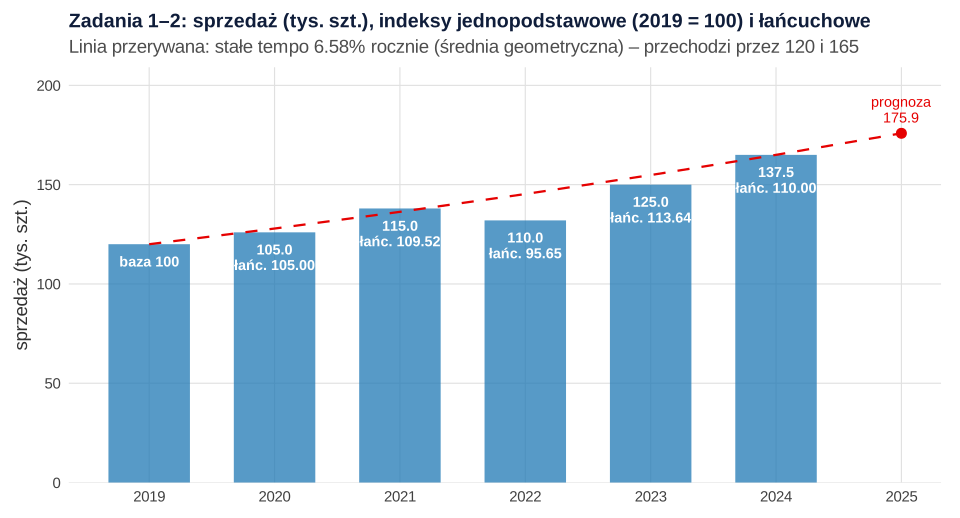
Firma sprzedała w kolejnych latach (w tys. sztuk): 2019 – 120, 2020 – 126, 2021 – 138, 2022 – 132, 2023 – 150, 2024 – 165. (a) Oblicz indeksy jednopodstawowe (2019 = 100) i łańcuchowe (rok poprzedni = 100). (b) Wyznacz indeks łańcuchowy 2023/2022 z indeksów jednopodstawowych, a indeks jednopodstawowy 2024 z łańcuchowych. (c) O ile procent sprzedaż w 2024 r. była wyższa niż w 2021 r.?
Rozwiązanie krok po kroku
Krok 1. Wzory. Indeks indywidualny to iloraz poziomu zjawiska w okresie badanym i w okresie podstawowym, zwykle razy 100:
Krok 2. Rachunek. Na przykład 2022: jednopodstawowy 132 / 120 × 100 = 110.0, łańcuchowy 132 / 138 × 100 = 95.65.
| Rok | Sprzedaż (tys. szt.) | Indeks 2019 = 100 | Indeks rok poprzedni = 100 |
|---|---|---|---|
| 2019 | 120 | 100.0 | – |
| 2020 | 126 | 105.0 | 105.00 |
| 2021 | 138 | 115.0 | 109.52 |
| 2022 | 132 | 110.0 | 95.65 |
| 2023 | 150 | 125.0 | 113.64 |
| 2024 | 165 | 137.5 | 110.00 |
Krok 3. Przeliczanie (b). Łańcuchowy z jednopodstawowych: dzielisz sąsiednie indeksy, 125.0 / 110.0 × 100 = 113.64. Jednopodstawowy z łańcuchowych: mnożysz kolejne indeksy łańcuchowe jako krotności, 1.0500 × 1.0952 × 0.9565 × 1.1364 × 1.1000 = 1.375, czyli 137.50.
Krok 4. Zmiana 2024/2021 (c). 165 / 138 × 100 = 119.57, czyli wzrost o 19.57%. To samo daje zmiana podstawy na 2021 = 100 (wszystkie indeksy dzielisz przez 115.0).
Interpretacja
W ciągu pięciu lat sprzedaż wzrosła o 37.5%. Jedynym rokiem spadku był 2022 (o 4.35% względem 2021). Największy wzrost rok do roku przyniósł 2023 (o 13.64%).
Typowy błąd
Odejmowanie indeksów jednopodstawowych: 137.5 − 115.0 = 22.5 to różnica w punktach procentowych względem 2019 r., a nie wzrost o 22.5% między 2021 a 2024 r. (ten wynosi 19.57%). Różnicę między procentem a punktem procentowym omawia hasło zmiana procentowa.
Zadanie 2. Średnie tempo zmian ze średniej geometrycznej
Treść zadania
Na podstawie danych z zadania 1 oblicz średnie roczne tempo zmian sprzedaży w latach 2019–2024. Jaką sprzedaż przewidujesz na 2025 r., jeśli tempo się utrzyma? Porównaj wynik ze średnią arytmetyczną indeksów łańcuchowych.
Rozwiązanie krok po kroku
Krok 1. Dlaczego geometryczna. Zmiany z roku na rok mnożą się, a nie dodają: sprzedaż 2024 = sprzedaż 2019 × iloczyn pięciu krotności łańcuchowych. Szukasz więc jednej stałej krotności G, która powtórzona pięć razy da ten sam iloczyn. To średnia geometryczna indeksów łańcuchowych.
Krok 2. Tempo. Średnie tempo zmian to G − 1 = 0.0658, czyli 6.58% rocznie. Kontrola: 120 × 1.06585 = 165.00. Bez potęgi ułamkowej: G = exp[ln(1.375) / 5].
Krok 3. Prognoza. 165 × 1.0658 = 175.85 tys. szt. w 2025 r.
Interpretacja
Sprzedaż rosła przeciętnie o 6.58% rocznie. Liczą się tylko poziomy z pierwszego i ostatniego roku. Prognoza zakłada, że tempo się utrzyma – to założenie, a nie wynik rachunku.
Typowy błąd
Średnia arytmetyczna indeksów łańcuchowych: (105.00 + 109.52 + 95.65 + 113.64 + 110.00) / 5 = 106.76, czyli „6.76% rocznie”. Przy takim tempie z 120 tys. szt. wyszłoby 166.45, a nie faktyczne 165.
Zadanie 3. Średnia harmoniczna: cena surowca i czas pracy
Treść zadania
(a) Zakład kupuje surowiec raz w miesiącu, zawsze za 6000 zł. Przez cztery miesiące płacił kolejno 20, 24, 25 i 30 zł za kg. Jaka była średnia cena kilograma? (b) Trzech pracowników pracuje na tej samej ośmiogodzinnej zmianie (480 minut). Na wykonanie jednej sztuki potrzebują odpowiednio 4, 5 i 8 minut. Ile wynosi średni czas wykonania sztuki w tym zespole?
Rozwiązanie krok po kroku
Krok 1. Co jest stałe? W części (a) stała jest wydana kwota, a zmienia się liczba kupionych kilogramów. W części (b) stały jest czas pracy, a zmienia się liczba sztuk. Gdy stały jest licznik wskaźnika (zł w „zł/kg”, minuty w „min/szt.”), właściwa jest średnia harmoniczna:
Krok 2. Cena (a). Kupione ilości: 6000 / 20 = 300 kg, potem 250, 240 i 200 kg; razem 990 kg za 24 000 zł. Średnia cena = 24 000 / 990 = 24.24 zł/kg. Ze wzoru: 4 / (1/20 + 1/24 + 1/25 + 1/30) = 24.24 zł/kg – ten sam wynik.
Krok 3. Czas (b). Pracownicy wykonują 480 / 4 = 120, 480 / 5 = 96 i 480 / 8 = 60 sztuk, razem 276 sztuk w 1440 minut. Średni czas = 1440 / 276 = 5.217 min/szt. = 3 / (1/4 + 1/5 + 1/8).
Interpretacja
Kilogram surowca kosztował przeciętnie 24.24 zł. To mniej niż średnia z czterech cen (24.75 zł), bo przy niskich cenach kupowano więcej kilogramów. Zespół potrzebuje średnio 5.22 minuty na sztukę, a nie 5.67, bo najszybszy pracownik wykonuje najwięcej sztuk. Przy stałej liczbie kilogramów (np. po 250 kg) właściwa byłaby średnia arytmetyczna: 24.75 zł/kg.
Typowy błąd
Liczenie średniej arytmetycznej wskaźników „na jednostkę” bez sprawdzenia, co jest stałe. Gdy nie jest stały ani licznik, ani mianownik, użyj średniej ważonej (np. ceny ważone liczbą kilogramów).
Zadanie 4. Indeksy agregatowe: Laspeyres, Paasche i Fisher
Treść zadania
Piekarnia sprzedaje trzy produkty. W okresie bazowym (0) i badanym (1) ceny i tygodniowe ilości sprzedaży były takie jak w tabeli. Oblicz indeks wartości sprzedaży, agregatowe indeksy cen i ilości Laspeyresa i Paaschego oraz indeks cen Fishera. Sprawdź, czy indeks wartości równa się iloczynowi indeksu cen i indeksu ilości.
| Produkt | p0 (zł) | q0 | p1 (zł) | q1 | p0q0 | p1q1 | p1q0 | p0q1 |
|---|---|---|---|---|---|---|---|---|
| chleb | 4.00 | 500 | 5.00 | 450 | 2000 | 2250 | 2500 | 1800 |
| mleko | 3.00 | 400 | 3.60 | 420 | 1200 | 1512 | 1440 | 1260 |
| masło | 6.00 | 200 | 9.00 | 150 | 1200 | 1350 | 1800 | 900 |
| Razem | 4400 | 5112 | 5740 | 3960 |
Rozwiązanie krok po kroku
Krok 1. Indeks wartości. Iw = Σp1q1 / Σp0q0 × 100 = 5112 / 4400 × 100 = 116.18.
Krok 2. Indeksy cen. Laspeyres waży ceny ilościami z okresu bazowego, Paasche – z okresu badanego:
Indeks Fishera to średnia geometryczna obu: Fp = √(130.45 × 129.09) = 129.77.
Krok 3. Indeksy ilości. Tu ważysz ilości cenami: Lq = Σp0q1 / Σp0q0 = 3960 / 4400 = 90.00; Pq = Σp1q1 / Σp1q0 = 5112 / 5740 = 89.06; Fisher 89.53.
Krok 4. Kontrola. Pary „krzyżowe” odtwarzają indeks wartości: Lp × Pq = 1.3045 × 0.8906 = 1.1618 i Pp × Lq = 1.2909 × 0.9000 = 1.1618.
Interpretacja
Wartość sprzedaży wzrosła o 16.18%. Wynikało to ze wzrostu cen o około 30% (Laspeyres 30.45%, Paasche 29.09%) przy spadku sprzedanych ilości o około 10–11%. Indeks Paaschego jest niższy, bo najbardziej podrożało masło (o 50%), a jego sprzedaż spadła najmocniej (o 25%). To w małej skali zjawisko substytucji. Hausman (2003) wskazuje obciążenie substytucyjne jako najczęściej omawiane źródło obciążenia indeksu cen konsumpcyjnych.
Typowy błąd
Średnia arytmetyczna indeksów indywidualnych cen bez wag: (125 + 120 + 150) / 3 = 131.67.
Zadanie 5. Zmiana nominalna i realna: deflowanie wskaźnikiem cen
Treść zadania
Przeciętne miesięczne wynagrodzenie brutto w firmie wynosiło 6000 zł w 2022 r., 6900 zł w 2023 r. i 7400 zł w 2024 r. Przyjmij umowny wskaźnik cen konsumpcyjnych (rok poprzedni = 100): 111.0 w 2023 r. i 104.0 w 2024 r. Oblicz nominalne i realne indeksy wynagrodzeń rok do roku oraz realną zmianę za cały okres 2022–2024. Ile wynosi wynagrodzenie z 2024 r. w cenach z 2022 r.?
Rozwiązanie krok po kroku
Krok 1. Indeksy nominalne. 6900 / 6000 × 100 = 115.00; 7400 / 6900 × 100 = 107.25.
Krok 2. Indeksy realne. Indeks realny to indeks nominalny podzielony przez indeks cen (oba jako krotności):
Krok 3. Cały okres. Indeks nominalny 2024/2022 = 7400 / 6000 = 123.33. Indeks cen za dwa lata to iloczyn: 1.110 × 1.040 = 1.1544, czyli 115.44. Indeks realny = 123.33 / 115.44 × 100 = 106.84.
Krok 4. Deflowanie. Wynagrodzenie z 2024 r. w cenach z 2022 r. = 7400 / 1.1544 = 6410.26 zł (dla 2023 r.: 6900 / 1.110 = 6216.22 zł).
Interpretacja
Nominalnie wynagrodzenia wzrosły w dwa lata o 23.33%, ale ceny wzrosły o 15.44%, więc siła nabywcza wynagrodzenia wzrosła tylko o 6.84%. W cenach z 2022 r. pracownik zarabia 6410.26 zł zamiast 6000 zł. Tak samo przed porównaniem sprzedaży czy kosztów z różnych lat sprowadzasz je do cen stałych.
Typowy błąd
Odejmowanie inflacji od wzrostu nominalnego: 15% − 11% = 4 punkty procentowe zamiast poprawnych 3.60%. Wskaźniki cen z kolejnych lat mnożysz, a nie dodajesz.
Zadanie 6. Krzywa Lorenza i współczynnik Giniego z kwintyli
Treść zadania
W badaniu budżetów gospodarstw domowych w dwóch regionach podzielono gospodarstwa na pięć grup po 20% (kwintyle, od najuboższych). Udziały kolejnych grup w sumie dochodów wyniosły: region A – 6, 11, 16, 23 i 44%; region B – 9, 14, 18, 23 i 36%. Narysuj krzywe Lorenza, oblicz współczynnik Giniego metodą trapezów i wskaźnik zróżnicowania S80/S20. W którym regionie dochody są rozłożone bardziej nierówno?
Rozwiązanie krok po kroku
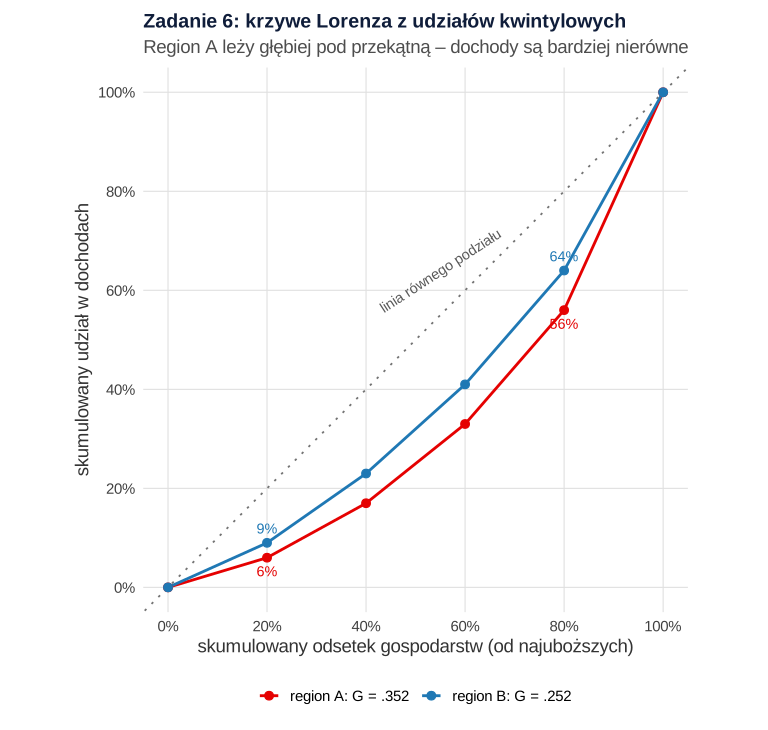
Krok 1. Punkty krzywej. Krzywa Lorenza łączy skumulowany odsetek gospodarstw (F) ze skumulowanym udziałem w dochodach (L). Lorenz (1905) zaproponował ją jako metodę mierzenia koncentracji bogactwa. Region A: L = 0, 6, 17, 33, 56, 100%. Region B: 0, 9, 23, 41, 64, 100%.
Krok 2. Wzór z trapezów. Pole pod krzywą to suma trapezów o szerokości 0.2. Współczynnik Giniego to 1 minus dwukrotne pole:
Krok 3. Region A. Sumy sąsiednich L: 0 + 6 = 6, 6 + 17 = 23, 17 + 33 = 50, 33 + 56 = 89, 56 + 100 = 156; razem 324. Dwukrotne pole = 324 × 0.2 / 100 = 0.648, więc GA = 1 − 0.648 = 0.352.
Krok 4. Region B. Sumy: 9, 32, 64, 105, 164; razem 374. Dwukrotne pole = 0.748, GB = 0.252.
Krok 5. S80/S20. Iloraz udziału najbogatszych 20% i najuboższych 20%: A – 44 / 6 = 7.33; B – 36 / 9 = 4.00.
Interpretacja
Dochody są bardziej nierówne w regionie A: krzywa leży głębiej pod przekątną, G = .352 wobec .252, a najbogatsze 20% gospodarstw ma 7.33 razy większy udział w dochodach niż najuboższe 20% (w regionie B – 4 razy).
Typowy błąd
Liczenie pola z samych udziałów (6, 11, 16…) zamiast z udziałów skumulowanych. Pamiętaj też, że Gini z pięciu grup jest przybliżeniem: krzywa z odcinków pomija nierówność wewnątrz kwintyli, więc wynik jest zwykle nieco niższy niż z danych o pojedynczych gospodarstwach. Porównuj tylko współczynniki policzone z takiego samego podziału na grupy.
Zadanie 7. Koncentracja sprzedaży: udział top 20% i Gini z danych jednostkowych
Treść zadania
Roczne obroty 10 klientów hurtowni (tys. zł) wyniosły: 25, 8, 100, 12, 5, 40, 15, 65, 10, 20. Jaki odsetek obrotów przypada na 20% największych klientów? Oblicz współczynnik Giniego z danych jednostkowych i oceń koncentrację sprzedaży.
Rozwiązanie krok po kroku
Krok 1. Uporządkuj rosnąco: 5, 8, 10, 12, 15, 20, 25, 40, 65, 100; suma 300, średnia 30 tys. zł.
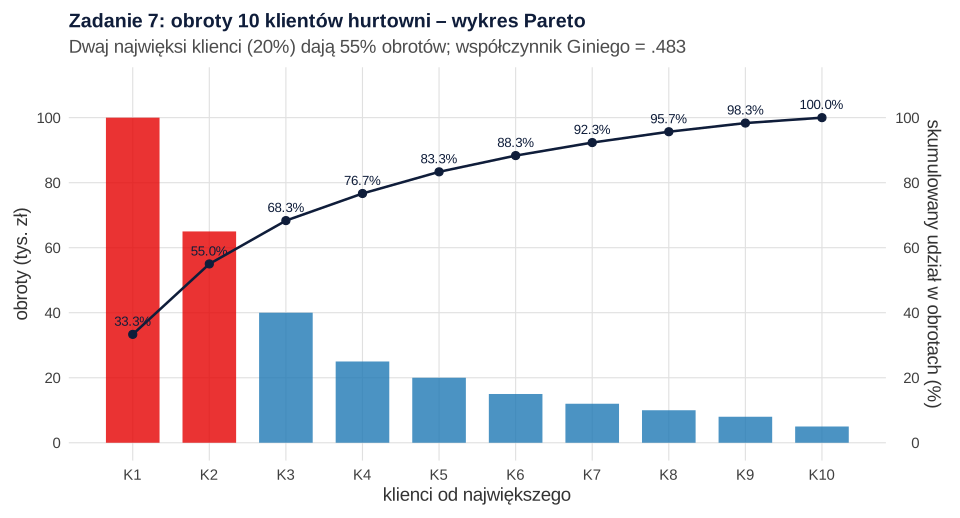
Krok 2. Udział top 20%. Dwaj najwięksi klienci (20% z 10) mają 100 + 65 = 165 tys. zł, czyli 55.00% obrotów. Trzej najwięksi mają 68.33%, a pięciu najmniejszych łącznie tylko 16.67%.
Krok 3. Gini. Dla danych jednostkowych uporządkowanych rosnąco (i – pozycja) wygodny jest wzór z rangami:
Wagi (2i − 11) wynoszą −9, −7, …, 7, 9; suma iloczynów to 1448, a 1448 / (10 × 300) = 0.483. Ten sam wynik daje metoda trapezów z zadania 6 (szerokość 0.1) i średnia różnica |xi − xj| między parami podzielona przez dwukrotność średniej.
Krok 4. Mała liczba jednostek. Przy 10 klientach G nie może przekroczyć (n − 1) / n = 0.900. Deltas (2003) pokazał, że w małych zbiorowościach współczynnik Giniego zaniża nierówność, a poprawka na małą próbę zmniejsza to obciążenie. Wersja z poprawką n / (n − 1) daje 0.536.
Interpretacja
Sprzedaż jest silnie skoncentrowana: 20% klientów daje 55% obrotów, a G = .483. Dla hurtowni oznacza to ryzyko zależności od dwóch odbiorców. Utrata największego klienta to jedna trzecia przychodów. To punkt wyjścia analizy ABC klientów.
Typowy błąd
Porównywanie Giniego z 10 klientów z wynikiem dla 200 klientów bez informacji o wersji wzoru – napisz, czy podajesz wynik z poprawką (.536), czy bez (.483). Nie zastępuj też Giniego współczynnikiem zmienności (tu 101.88%): obie miary opisują rozproszenie, ale tylko Gini ma interpretację udziałów.
Zadanie 8. Średnia ruchoma 2×4 dla danych kwartalnych
Treść zadania
Kwartalna sprzedaż sklepu (tys. zł) w latach 2022–2024 wyniosła: 2022 – 88, 105, 137, 100; 2023 – 97, 119, 150, 112; 2024 – 109, 129, 167, 121. Wygładź szereg czasowy wyśrodkowaną średnią ruchomą. Dla których kwartałów nie da się jej policzyć?
Rozwiązanie krok po kroku
Krok 1. Długość okna. Okno musi objąć pełny rok (4 kwartały), żeby sezonowość się zniosła. Średnia z 4 kwartałów wypada jednak „między” kwartałami, więc uśredniasz dwie sąsiednie średnie czterookresowe. Taka średnia ruchoma 2×4 to średnia ważona pięciu kwartałów z wagami 1/8, 1/4, 1/4, 1/4, 1/8 (Hyndman i Athanasopoulos, 2021).
Krok 2. Pierwsza wartość (III kw. 2022).
Krok 3. Kolejne wartości. Prościej z sum czterech kolejnych kwartałów: 430, 439, 453, 466, 478, 490, 500, 517, 526. Średnia ruchoma to (sumak + sumak+1) / 8, np. dla IV kw. 2022: (439 + 453) / 8 = 111.500. Kolejne wartości to 114.875, 118.000, 121.000, 123.750, 127.125 i 130.375 (II kw. 2024).
Interpretacja
Po wygładzeniu sezonowość znika i widać stały wzrost: od 108.6 tys. zł w III kw. 2022 r. do 130.4 tys. zł w II kw. 2024 r., czyli o 21.75 tys. zł w ciągu 7 kwartałów. Odchylenie standardowe spada z 23.04 (surowy szereg) do 7.58. Za gładkość płacisz brakami: nie ma wartości dla dwóch pierwszych i dwóch ostatnich kwartałów.
Typowy błąd
Zwykła średnia z 4 kwartałów przypisana do jednego z nich (np. do IV kw.) – wtedy wygładzony szereg jest przesunięty w czasie. Okno krótsze niż pełny cykl nie usuwa sezonowości.
Zadanie 9. Trend liniowy metodą najmniejszych kwadratów i prognoza
Treść zadania
Dla sprzedaży z zadania 8 oszacuj trend liniowy ŷ = a + bt (t = 1 dla I kw. 2022, …, 12 dla IV kw. 2024). Zinterpretuj współczynniki i R². Oblicz wartości trendu na cztery kwartały 2025 r.
Rozwiązanie krok po kroku
Krok 1. Średnie. Σt = 78, t̄ = 6.5; Σy = 1434, ȳ = 119.5.
Krok 2. Sumy. Σ(t − t̄)² = 143, Σ(t − t̄)(y − ȳ) = 493. Metoda najmniejszych kwadratów daje:
Krok 3. Dopasowanie. R² = .291 – trend wyjaśnia 29.1% zmienności sprzedaży.
Krok 4. Trend na 2025 r. Dla t = 13, …, 16: 97.0909 + 3.4476t = 141.91, 145.36, 148.80 i 152.25 tys. zł.
Interpretacja
Sprzedaż rośnie przeciętnie o 3.45 tys. zł na kwartał. Stała 97.09 to wartość trendu dla t = 0, czyli dla IV kw. 2021 r., poza zakresem danych. Niskie R² nie oznacza, że trendu nie ma. Większość zmienności to sezonowość, której linia prosta nie opisuje. Ten sam rachunek w wersji dla dwóch dowolnych zmiennych ćwiczysz w zbiorze korelacja i regresja – zadania z rozwiązaniami.
Typowy błąd
Podanie samego trendu jako prognozy kwartalnej: 152.25 tys. zł na IV kw. 2025 r. wobec 121 tys. zł w IV kw. 2024 r. Nie testuj też b zwykłym testem t bez sprawdzenia autokorelacji reszt.
Zadanie 10. Wskaźniki sezonowości i prognoza na kolejny rok
Treść zadania
Na podstawie trendu z zadania 9 oblicz surowe i oczyszczone wskaźniki sezonowości dla czterech kwartałów (model multiplikatywny) oraz składniki sezonowe w modelu addytywnym. Podaj prognozę sprzedaży na każdy kwartał 2025 r.
Rozwiązanie krok po kroku
Krok 1. Ilorazy do trendu. Dla każdego kwartału dziel sprzedaż przez wartość trendu, np. I kw. 2022: 88 / 100.538 = 0.8753. Pozostałe ilorazy dla I kw. to 0.8484 (2023) i 0.8508 (2024).
Krok 2. Metoda średnich. Uśrednij ilorazy jednoimiennych kwartałów (wszystkie I kw., wszystkie II kw. itd.). Surowe wskaźniki: 0.8582, 1.0002, 1.2498, 0.8914; ich suma 3.9996.
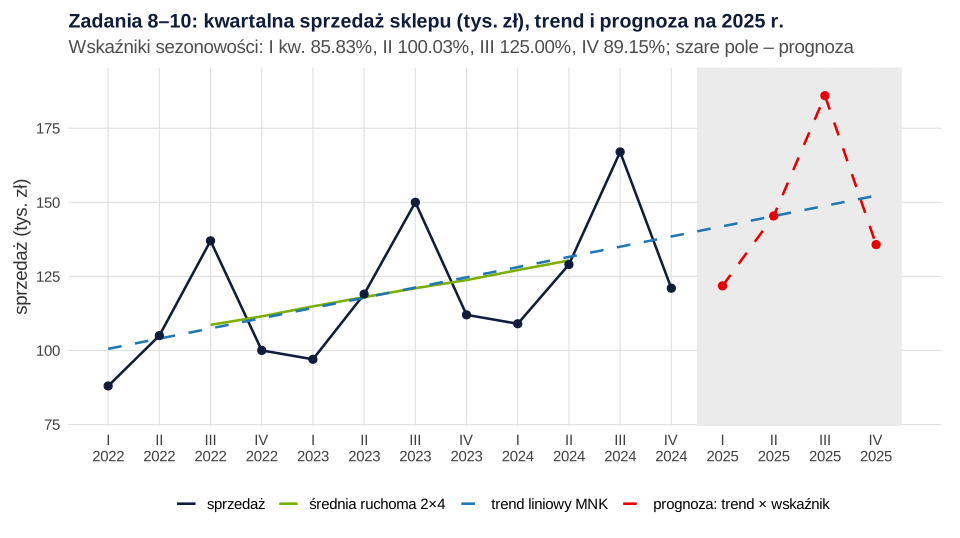
Krok 3. Oczyszczenie. Wskaźniki muszą sumować się do 4 (średnio 100%), więc dzielisz każdy przez średnią surowych (0.9999): 85.83%, 100.03%, 125.00%, 89.15%.
Krok 4. Prognoza. W modelu multiplikatywnym prognoza = trend × wskaźnik: I kw. 2025 – 141.91 × 0.8583 ≈ 121.79; II kw. – 145.40; III kw. – 186.00; IV kw. – 135.73 tys. zł (razem 588.92 tys. zł).
Krok 5. Wersja addytywna. Zamiast ilorazów liczysz różnice y − ŷ i uśredniasz je w kwartałach: −16.329, −0.110, +30.110, −13.671 tys. zł. Suma wynosi tu 0, bo reszty z MNK sumują się do zera, więc korekta nic nie zmienia. Prognoza = trend + składnik: 125.58, 145.25, 178.91 i 138.58 tys. zł.
Interpretacja
W III kwartale sprzedaż jest o 25% wyższa od trendu, a w I kwartale o około 14% niższa. Model multiplikatywny zakłada, że wahania rosną razem z poziomem sprzedaży, a addytywny – że mają stałą wielkość w tys. zł. Tu amplituda rośnie (różnica III − I kw.: 49, 53 i 58 tys. zł), więc lepiej pasuje model multiplikatywny. Dekompozycję szeregu na trend, sezonowość i resztę jako narzędzie badań organizacyjnych opisują Jebb i Tay (2017). Ich kontrolą jest funkcja decompose() w R, która liczy wskaźniki z ilorazów do średniej ruchomej z zadania 8: 85.06%, 99.86%, 125.00% i 90.07%.
Typowy błąd
Porównywanie sprzedaży z różnych kwartałów bez usunięcia sezonowości. Spadek z 167 tys. zł w III kw. do 121 tys. zł w IV kw. 2024 r. nie jest „kryzysem”. Po podzieleniu przez wskaźniki sprzedaż oczyszczona z sezonowości wynosi 133.60 i 135.73 tys. zł, więc nadal rośnie. Więcej o tym składniku szeregu: sezonowość.
Ściąga: który wskaźnik w zadaniu
| Pytanie w zadaniu | Miara | Na co uważać |
|---|---|---|
| Jak zmieniło się zjawisko względem roku bazowego / poprzedniego? | indeks jednopodstawowy / łańcuchowy | punkty procentowe to nie procenty |
| Jakie było przeciętne tempo zmian? | średnia geometryczna indeksów łańcuchowych | nie średnia arytmetyczna |
| Średnia cena, wydajność, prędkość | harmoniczna (stały licznik), arytmetyczna (stały mianownik), ważona (inne) | najpierw ustal, co jest stałe |
| Zmiana cen lub ilości koszyka produktów | indeks Laspeyresa, Paaschego, Fishera | wagi bazowe czy bieżące |
| Czy płace / sprzedaż rosną realnie? | indeks nominalny / indeks cen | dziel, nie odejmuj; indeksy cen mnóż |
| Nierówność, koncentracja | krzywa Lorenza, Gini, udział top 20%, S80/S20 | dane pogrupowane zaniżają Giniego |
| Kierunek zmian w czasie i prognoza | średnia ruchoma, trend MNK, wskaźniki sezonowości | okno = pełny cykl; trend × wskaźnik |
Te rachunki zrobisz też w arkuszu (zob. analiza statystyczna w Excelu). Dłuższe szeregi wymagają modeli z poradnika szeregi czasowe i ARIMA w praktyce. Prognozę możesz też oprzeć na wygładzaniu wykładniczym Holta–Wintersa, a jej trafność ocenić miarami błędu prognozy (MAE, RMSE, MAPE). Jak wykorzystać statystykę we własnej pracy dyplomowej, pokazują wpisy statystyka w pracy z zarządzania i ekonomii oraz statystyka w pracy z marketingu.
Inne zbiory zadań
Wszystkie zbiory zebraliśmy na stronie zadania ze statystyki z rozwiązaniami. Najbliżej tego zbioru są:
- statystyka opisowa – zadania z rozwiązaniami (szeregi rozdzielcze, średnia ważona, kwartyle, współczynnik zmienności);
- korelacja i regresja – zadania z rozwiązaniami (MNK ręcznie, prognoza, reszty);
- statystyka w Excelu – zadania z rozwiązaniami (te same typy rachunków w formułach arkusza);
- prawdopodobieństwo i rozkłady – zadania z rozwiązaniami.
Jeśli po kolokwium przychodzi czas na własne dane do pracy dyplomowej, możesz skorzystać z konsultacji analizy statystycznej dla studentów.
Sprawdź wyniki w R: kod i wynik
Dwa przepisy liczą wszystkie liczby z rozwiązań na danych wpisanych w kod (bez losowania). Każde zadanie jest policzone wzorem, tak jak na kartce, a tam, gdzie R ma gotową funkcję (lm, decompose, stats::filter, DescTools::Gini), także nią jako kontrola. Rysunki i plik CSV powstały w osobnym skrypcie, który wczytuje dane z tych przepisów.
Zadania 1–5: indeksy, średnia geometryczna i harmoniczna, Laspeyres, Paasche i Fisher, zmiana realna
R
# B392 – zadania 1–5: indeksy jednopodstawowe i łańcuchowe, średnie tempo zmian (średnia geometryczna),
# średnia harmoniczna, indeksy agregatowe Laspeyresa, Paaschego i Fishera, zmiana nominalna i realna.
# Dane wymyślone do ćwiczeń (nie są danymi GUS), wpisane na sztywno – te same co w treści zadań.
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
z4 <- function(x) formatC(x, format = "f", digits = 4)

# Zadanie 1. Sprzedaż firmy (tys. sztuk) w latach 2019–2024
rok <- 2019:2024
y   <- c(120, 126, 138, 132, 150, 165)
i_baza <- 100 * y / y[1]                         # indeksy jednopodstawowe, 2019 = 100
i_lanc <- c(NA, 100 * y[-1] / y[-length(y)])     # indeksy łańcuchowe, rok poprzedni = 100
cat("Zadanie 1\n")
print(data.frame(rok, y, i_baza = round(i_baza, 2), i_lanc = round(i_lanc, 2)), row.names = FALSE)
cat("Łańcuchowy 2023/2022 z jednopodstawowych: 125 / 110 * 100 =", z2(100 * i_baza[5] / i_baza[4]), "\n")
cat("Jednopodstawowy 2024 z łańcuchowych: iloczyn / 100^4 =", z2(100 * prod(i_lanc[-1] / 100)), "\n")
cat("Zmiana 2024 względem 2021:", z2(100 * y[6] / y[3]), "% (wzrost o", z2(100 * y[6] / y[3] - 100), "%)\n")
cat("Nowa podstawa 2021 = 100:", z2(100 * y / y[3]), "\n")
cat("Błąd – różnica indeksów 137.5 - 115.0 jako „wzrost o", z2(i_baza[6] - i_baza[3]), "%” (to punkty procentowe)\n\n")

# Zadanie 2. Średnie tempo zmian sprzedaży 2019–2024 (dane z zadania 1)
lanc <- i_lanc[-1] / 100                         # współczynniki łańcuchowe (krotności)
G <- prod(lanc)^(1 / length(lanc))
cat("Zadanie 2\n")
cat("Współczynniki łańcuchowe:", z4(lanc), "\n")
cat("Średnia geometryczna (iloczyn^(1/5)) =", z4(G), "; skrót (y_2024 / y_2019)^(1/5) =", z4((y[6] / y[1])^(1 / 5)),
    "; kontrola exp(mean(log)) =", z4(exp(mean(log(lanc)))), "\n")
cat("Średnie tempo zmian =", z2(100 * (G - 1)), "% rocznie\n")
cat("Kontrola: 120 * G^5 =", z2(120 * G^5), "\n")
cat("Prognoza 2025 = 165 * G =", z2(165 * G), "tys. szt.\n")
cat("Błąd – średnia arytmetyczna indeksów łańcuchowych =", z2(100 * mean(lanc)), "%; 120 * (śr. arytm.)^5 =",
    z2(120 * mean(lanc)^5), "\n\n")

# Zadanie 3. Średnia harmoniczna
# (a) zakup surowca co miesiąc za stałą kwotę 6000 zł po różnych cenach za kg
cena <- c(20, 24, 25, 30); kwota <- 6000
kg <- kwota / cena
cat("Zadanie 3\n")
cat("Kupione kg:", kg, "; razem kg =", sum(kg), "; wydano =", kwota * length(cena), "zł\n")
cat("Średnia cena = wydatki / kg =", z2(kwota * length(cena) / sum(kg)), "; średnia harmoniczna =",
    z2(length(cena) / sum(1 / cena)), "zł/kg\n")
cat("Błąd – średnia arytmetyczna cen =", z2(mean(cena)), "zł/kg\n")
cat("Gdyby co miesiąc kupować po 250 kg: średnia cena =", z2(sum(250 * cena) / (250 * 4)), "(arytmetyczna)\n")
# (b) trzech pracowników na tej samej 8-godzinnej zmianie, czas wykonania jednej sztuki (min)
czas <- c(4, 5, 8); zmiana <- 480
szt <- zmiana / czas
cat("Sztuki na zmianę:", szt, "; razem =", sum(szt), "; minut pracy razem =", zmiana * 3, "\n")
cat("Średni czas na sztukę = minuty / sztuki =", z3(zmiana * 3 / sum(szt)), "; harmoniczna =",
    z3(length(czas) / sum(1 / czas)), "; arytmetyczna (błąd) =", z3(mean(czas)), "min\n\n")

# Zadanie 4. Indeksy agregatowe: trzy produkty piekarni, okres bazowy 0 i badany 1
p0 <- c(chleb = 4.00, mleko = 3.00, maslo = 6.00); p1 <- c(5.00, 3.60, 9.00)
q0 <- c(500, 400, 200);                                 q1 <- c(450, 420, 150)
S00 <- sum(p0 * q0); S11 <- sum(p1 * q1); S10 <- sum(p1 * q0); S01 <- sum(p0 * q1)
cat("Zadanie 4\n")
print(data.frame(produkt = names(p0), p0q0 = p0 * q0, p1q1 = p1 * q1, p1q0 = p1 * q0, p0q1 = p0 * q1,
                 i_ceny = round(100 * p1 / p0, 2), i_ilosci = round(100 * q1 / q0, 2)), row.names = FALSE)
cat("Sumy: p0q0 =", S00, "; p1q1 =", S11, "; p1q0 =", S10, "; p0q1 =", S01, "\n")
Iw <- S11 / S00; Lp <- S10 / S00; Pp <- S11 / S01; Lq <- S01 / S00; Pq <- S11 / S10
Fp <- sqrt(Lp * Pp); Fq <- sqrt(Lq * Pq)
cat("Indeks wartości Iw =", z2(100 * Iw), "\n")
cat("Ceny: Laspeyres =", z2(100 * Lp), "; Paasche =", z2(100 * Pp), "; Fisher =", z2(100 * Fp), "\n")
cat("Ilości: Laspeyres =", z2(100 * Lq), "; Paasche =", z2(100 * Pq), "; Fisher =", z2(100 * Fq), "\n")
cat("Kontrola: Lp * Pq =", z4(Lp * Pq), "; Pp * Lq =", z4(Pp * Lq), "; Fp * Fq =", z4(Fp * Fq), "; Iw =", z4(Iw), "\n")
cat("Błąd – średnia arytmetyczna indywidualnych indeksów cen =", z2(mean(100 * p1 / p0)), "\n\n")

# Zadanie 5. Wynagrodzenie nominalne i realne; wskaźnik cen rok do roku (dane umowne)
wyn  <- c("2022" = 6000, "2023" = 6900, "2024" = 7400)
ceny <- c("2023" = 111.0, "2024" = 104.0)          # rok poprzedni = 100
nom  <- 100 * wyn[-1] / wyn[-3]
real <- 100 * nom / ceny
cat("Zadanie 5\n")
cat("Indeksy nominalne r/r:", z2(nom), "; realne r/r = nominalny / cen * 100:", z2(real), "\n")
cat("Realna zmiana r/r:", z2(real - 100), "%\n")
cat("Błąd – odejmowanie: 115.00 - 111.00 =", z2(nom[1] - ceny[1]), "pp zamiast", z2(real[1] - 100), "%\n")
ceny_2l <- prod(ceny / 100); nom_2l <- wyn[3] / wyn[1]
cat("Dwa lata: nominalny =", z2(100 * nom_2l), "; cen =", z2(100 * ceny_2l), "; realny =", z2(100 * nom_2l / ceny_2l), "\n")
deflator <- c(1, cumprod(ceny / 100))
cat("Wynagrodzenia w cenach z 2022 r. (wyn / skumulowany wskaźnik cen):", z2(wyn / deflator), "zł\n")
Wynik w R
Zadanie 1
  rok   y i_baza i_lanc
 2019 120  100.0     NA
 2020 126  105.0 105.00
 2021 138  115.0 109.52
 2022 132  110.0  95.65
 2023 150  125.0 113.64
 2024 165  137.5 110.00
Łańcuchowy 2023/2022 z jednopodstawowych: 125 / 110 * 100 = 113.64
Jednopodstawowy 2024 z łańcuchowych: iloczyn / 100^4 = 137.50
Zmiana 2024 względem 2021: 119.57 % (wzrost o 19.57 %)
Nowa podstawa 2021 = 100: 86.96 91.30 100.00 95.65 108.70 119.57
Błąd – różnica indeksów 137.5 - 115.0 jako „wzrost o 22.50 %” (to punkty procentowe)

Zadanie 2
Współczynniki łańcuchowe: 1.0500 1.0952 0.9565 1.1364 1.1000
Średnia geometryczna (iloczyn^(1/5)) = 1.0658 ; skrót (y_2024 / y_2019)^(1/5) = 1.0658 ; kontrola exp(mean(log)) = 1.0658
Średnie tempo zmian = 6.58 % rocznie
Kontrola: 120 * G^5 = 165.00
Prognoza 2025 = 165 * G = 175.85 tys. szt.
Błąd – średnia arytmetyczna indeksów łańcuchowych = 106.76 %; 120 * (śr. arytm.)^5 = 166.45

Zadanie 3
Kupione kg: 300 250 240 200 ; razem kg = 990 ; wydano = 24000 zł
Średnia cena = wydatki / kg = 24.24 ; średnia harmoniczna = 24.24 zł/kg
Błąd – średnia arytmetyczna cen = 24.75 zł/kg
Gdyby co miesiąc kupować po 250 kg: średnia cena = 24.75 (arytmetyczna)
Sztuki na zmianę: 120 96 60 ; razem = 276 ; minut pracy razem = 1440
Średni czas na sztukę = minuty / sztuki = 5.217 ; harmoniczna = 5.217 ; arytmetyczna (błąd) = 5.667 min

Zadanie 4
 produkt p0q0 p1q1 p1q0 p0q1 i_ceny i_ilosci
   chleb 2000 2250 2500 1800    125       90
   mleko 1200 1512 1440 1260    120      105
   maslo 1200 1350 1800  900    150       75
Sumy: p0q0 = 4400 ; p1q1 = 5112 ; p1q0 = 5740 ; p0q1 = 3960
Indeks wartości Iw = 116.18
Ceny: Laspeyres = 130.45 ; Paasche = 129.09 ; Fisher = 129.77
Ilości: Laspeyres = 90.00 ; Paasche = 89.06 ; Fisher = 89.53
Kontrola: Lp * Pq = 1.1618 ; Pp * Lq = 1.1618 ; Fp * Fq = 1.1618 ; Iw = 1.1618
Błąd – średnia arytmetyczna indywidualnych indeksów cen = 131.67

Zadanie 5
Indeksy nominalne r/r: 115.00 107.25 ; realne r/r = nominalny / cen * 100: 103.60 103.12
Realna zmiana r/r: 3.60 3.12 %
Błąd – odejmowanie: 115.00 - 111.00 = 4.00 pp zamiast 3.60 %
Dwa lata: nominalny = 123.33 ; cen = 115.44 ; realny = 106.84
Wynagrodzenia w cenach z 2022 r. (wyn / skumulowany wskaźnik cen): 6000.00 6216.22 6410.26 zł
Zadania 6–10: Lorenz i Gini, koncentracja, średnia ruchoma, trend MNK i sezonowość
R
# B392 – zadania 6–10: krzywa Lorenza i współczynnik Giniego z kwintyli, koncentracja sprzedaży (udział
# top 20%, Gini z danych jednostkowych), średnia ruchoma 2×4, trend liniowy MNK z prognozą, wskaźniki sezonowości.
# Dane wymyślone do ćwiczeń (nie są danymi GUS), wpisane na sztywno – te same co w treści zadań.
z2 <- function(x) formatC(x, format = "f", digits = 2)
z3 <- function(x) formatC(x, format = "f", digits = 3)
z4 <- function(x) formatC(x, format = "f", digits = 4)

# Zadanie 6. Udziały kwintylowych grup gospodarstw w sumie dochodów (%) w dwóch regionach
udz <- list(A = c(6, 11, 16, 23, 44), B = c(9, 14, 18, 23, 36))
cat("Zadanie 6\n")
gini_kw <- function(u) {                         # wzór z trapezów: G = 1 - suma (F_i - F_i-1)(L_i + L_i-1)
  L <- c(0, cumsum(u)) / 100; F <- seq(0, 1, length.out = length(u) + 1)
  pola <- diff(F) * (L[-1] + L[-length(L)])
  list(L = L, pola = pola, G = 1 - sum(pola))
}
for (r in names(udz)) {
  w <- gini_kw(udz[[r]])
  cat("Region", r, ": L skumulowane =", 100 * w$L[-1], "; L_i + L_i-1 =", 100 * (w$L[-1] + w$L[-6]),
      "; suma =", sum(100 * (w$L[-1] + w$L[-6])), "\n")
  cat("   2 x pole pod krzywą = suma * 0.2 / 100 =", z3(sum(w$pola)), "; G =", z3(w$G),
      "; udział top 20% =", udz[[r]][5], "%; S80/S20 =", z2(udz[[r]][5] / udz[[r]][1]),
      "; udział dolnych 40% =", sum(udz[[r]][1:2]), "%\n")
}
cat("Kontrola: Gini dla podziału po równo (20, 20, 20, 20, 20) =", z3(gini_kw(rep(20, 5))$G), "\n\n")

# Zadanie 7. Roczne obroty 10 klientów hurtowni (tys. zł)
obr <- c(25, 8, 100, 12, 5, 40, 15, 65, 10, 20)
x <- sort(obr); n <- length(x); S <- sum(x)
cat("Zadanie 7\n")
cat("Uporządkowane:", x, "; suma =", S, "; średnia =", mean(x), "\n")
cat("Udział największego klienta =", z2(100 * max(x) / S), "%\n")
cat("Udział 2 największych klientów (top 20%) =", z2(100 * sum(tail(x, 2)) / S), "%; top 30% =",
    z2(100 * sum(tail(x, 3)) / S), "%; dolne 50% =", z2(100 * sum(head(x, 5)) / S), "%\n")
L <- c(0, cumsum(x)) / S
cat("Krzywa Lorenza L_i (%):", z2(100 * L[-1]), "\n")
G_trap <- 1 - sum((1 / n) * (L[-1] + L[-(n + 1)]))
G_wzor <- sum((2 * seq_len(n) - n - 1) * x) / (n * S)
G_par  <- sum(abs(outer(x, x, "-"))) / (2 * n^2 * mean(x))
cat("Wagi 2i - n - 1:", 2 * seq_len(n) - n - 1, "; suma (2i - n - 1) * x =", sum((2 * seq_len(n) - n - 1) * x), "\n")
cat("Gini z trapezów =", z3(G_trap), "; ze wzoru z rangami =", z3(G_wzor), "; z par |xi - xj| =", z3(G_par), "\n")
cat("Maksimum dla n = 10: (n - 1) / n =", z3((n - 1) / n), "; Gini z poprawką n / (n - 1) =", z3(G_wzor * n / (n - 1)), "\n")
cat("Kontrola DescTools::Gini (unbiased = FALSE / TRUE):", z3(DescTools::Gini(x, unbiased = FALSE)),
    z3(DescTools::Gini(x, unbiased = TRUE)), "\n")
cat("Współczynnik zmienności (SD z n - 1) =", z2(100 * sd(x) / mean(x)), "%\n\n")

# Zadania 8–10. Kwartalna sprzedaż sklepu (tys. zł), 2022–2024
y <- c(88, 105, 137, 100,  97, 119, 150, 112,  109, 129, 167, 121)
t <- seq_along(y); kw <- rep(1:4, 3); rok <- rep(2022:2024, each = 4)

# Zadanie 8. Wyśrodkowana średnia ruchoma 2×4 (wagi 1/8, 1/4, 1/4, 1/4, 1/8)
w <- c(1, 2, 2, 2, 1) / 8
ma <- as.numeric(stats::filter(y, w, sides = 2))
ma4 <- as.numeric(stats::filter(y, rep(1 / 4, 4), sides = 2))
cat("Zadanie 8\n")
cat("Suma 4 pierwszych kwartałów =", sum(y[1:4]), "; kolejne sumy 4 kwartałów:",
    sapply(1:9, function(i) sum(y[i:(i + 3)])), "\n")
cat("Ręcznie MA dla III kw. 2022: (88/2 + 105 + 137 + 100 + 97/2) / 4 =",
    z3((y[1] / 2 + y[2] + y[3] + y[4] + y[5] / 2) / 4), "\n")
print(data.frame(rok, kw, y, ma_2x4 = round(ma, 3)), row.names = FALSE)
cat("Liczba braków na brzegach =", sum(is.na(ma)), "; SD surowego szeregu =", z2(sd(y)),
    "; SD średniej ruchomej =", z2(sd(ma, na.rm = TRUE)), "\n")
cat("Wzrost średniej ruchomej od III kw. 2022 do II kw. 2024 =", z3(ma[10] - ma[3]), "tys. zł\n\n")

# Zadanie 9. Trend liniowy MNK: y = a + b t, t = 1, ..., 12
tc <- t - mean(t); yc <- y - mean(y)
b <- sum(tc * yc) / sum(tc^2); a <- mean(y) - b * mean(t)
fit <- lm(y ~ t)
cat("Zadanie 9\n")
cat("Suma t =", sum(t), "; średnia t =", mean(t), "; suma y =", sum(y), "; średnia y =", z4(mean(y)), "\n")
cat("Suma (t - t_śr)(y - y_śr) =", sum(tc * yc), "; suma (t - t_śr)^2 =", sum(tc^2), "\n")
cat("b =", z4(b), "; a =", z4(a), "; kontrola lm():", z4(coef(fit)), "\n")
R2 <- 1 - sum(resid(fit)^2) / sum(yc^2)
cat("R^2 =", z3(R2), "; kontrola summary(lm)$r.squared =", z3(summary(fit)$r.squared), "\n")
cat("Trend dla t = 13..16 (2025):", z2(a + b * 13:16), "\n")
cat("Błąd – prognoza tylko z trendu dla IV kw. 2025 =", z2(a + b * 16), "wobec IV kw. 2024 =", y[12], "\n\n")

# Zadanie 10. Wskaźniki sezonowości (metoda średnich jednoimiennych okresów)
tr <- fitted(fit)
cat("Zadanie 10\n")
iloraz <- y / tr; roznica <- y - tr
print(data.frame(rok, kw, y, trend = round(tr, 3), y_do_trendu = round(iloraz, 4), y_minus_trend = round(roznica, 3)),
      row.names = FALSE)
s_mult_surowe <- tapply(iloraz, kw, mean)
s_mult <- s_mult_surowe / mean(s_mult_surowe)          # korekta: średnia wskaźników = 1 (suma = 4)
s_add_surowe <- tapply(roznica, kw, mean)
s_add <- s_add_surowe - mean(s_add_surowe)              # korekta: suma składników = 0
cat("Multiplikatywne surowe:", z4(s_mult_surowe), "; suma =", z4(sum(s_mult_surowe)), "; średnia =", z4(mean(s_mult_surowe)), "\n")
cat("Multiplikatywne po korekcie (%):", z2(100 * s_mult), "; suma =", z2(sum(100 * s_mult)), "\n")
cat("Addytywne surowe:", z3(s_add_surowe), "; suma =", z3(round(sum(s_add_surowe), 10) + 0), "; po korekcie:", z3(s_add), "\n")
tr25 <- a + b * 13:16
cat("Prognoza 2025 multiplikatywna = trend * wskaźnik:", z2(tr25 * s_mult), "; suma roku =", z2(sum(tr25 * s_mult)), "\n")
cat("Prognoza 2025 addytywna = trend + składnik:", z2(tr25 + s_add), "\n")
cat("Różnica III kw. - I kw. w kolejnych latach:", y[kw == 3] - y[kw == 1], "\n")
dm <- decompose(ts(y, frequency = 4), type = "multiplicative")
cat("Kontrola decompose() (wskaźniki z ilorazów do średniej ruchomej 2×4, %):", z2(100 * dm$figure), "\n")
cat("Sprzedaż oczyszczona z sezonowości 2024 (y / wskaźnik):", z2(y[9:12] / s_mult), "\n")
Wynik w R
Zadanie 6
Region A : L skumulowane = 6 17 33 56 100 ; L_i + L_i-1 = 6 23 50 89 156 ; suma = 324
   2 x pole pod krzywą = suma * 0.2 / 100 = 0.648 ; G = 0.352 ; udział top 20% = 44 %; S80/S20 = 7.33 ; udział dolnych 40% = 17 %
Region B : L skumulowane = 9 23 41 64 100 ; L_i + L_i-1 = 9 32 64 105 164 ; suma = 374
   2 x pole pod krzywą = suma * 0.2 / 100 = 0.748 ; G = 0.252 ; udział top 20% = 36 %; S80/S20 = 4.00 ; udział dolnych 40% = 23 %
Kontrola: Gini dla podziału po równo (20, 20, 20, 20, 20) = 0.000

Zadanie 7
Uporządkowane: 5 8 10 12 15 20 25 40 65 100 ; suma = 300 ; średnia = 30
Udział największego klienta = 33.33 %
Udział 2 największych klientów (top 20%) = 55.00 %; top 30% = 68.33 %; dolne 50% = 16.67 %
Krzywa Lorenza L_i (%): 1.67 4.33 7.67 11.67 16.67 23.33 31.67 45.00 66.67 100.00
Wagi 2i - n - 1: -9 -7 -5 -3 -1 1 3 5 7 9 ; suma (2i - n - 1) * x = 1448
Gini z trapezów = 0.483 ; ze wzoru z rangami = 0.483 ; z par |xi - xj| = 0.483
Maksimum dla n = 10: (n - 1) / n = 0.900 ; Gini z poprawką n / (n - 1) = 0.536
Kontrola DescTools::Gini (unbiased = FALSE / TRUE): 0.483 0.536
Współczynnik zmienności (SD z n - 1) = 101.88 %

Zadanie 8
Suma 4 pierwszych kwartałów = 430 ; kolejne sumy 4 kwartałów: 430 439 453 466 478 490 500 517 526
Ręcznie MA dla III kw. 2022: (88/2 + 105 + 137 + 100 + 97/2) / 4 = 108.625
  rok kw   y  ma_2x4
 2022  1  88      NA
 2022  2 105      NA
 2022  3 137 108.625
 2022  4 100 111.500
 2023  1  97 114.875
 2023  2 119 118.000
 2023  3 150 121.000
 2023  4 112 123.750
 2024  1 109 127.125
 2024  2 129 130.375
 2024  3 167      NA
 2024  4 121      NA
Liczba braków na brzegach = 4 ; SD surowego szeregu = 23.04 ; SD średniej ruchomej = 7.58
Wzrost średniej ruchomej od III kw. 2022 do II kw. 2024 = 21.750 tys. zł

Zadanie 9
Suma t = 78 ; średnia t = 6.5 ; suma y = 1434 ; średnia y = 119.5000
Suma (t - t_śr)(y - y_śr) = 493 ; suma (t - t_śr)^2 = 143
b = 3.4476 ; a = 97.0909 ; kontrola lm(): 97.0909 3.4476
R^2 = 0.291 ; kontrola summary(lm)$r.squared = 0.291
Trend dla t = 13..16 (2025): 141.91 145.36 148.80 152.25
Błąd – prognoza tylko z trendu dla IV kw. 2025 = 152.25 wobec IV kw. 2024 = 121

Zadanie 10
  rok kw   y   trend y_do_trendu y_minus_trend
 2022  1  88 100.538      0.8753       -12.538
 2022  2 105 103.986      1.0098         1.014
 2022  3 137 107.434      1.2752        29.566
 2022  4 100 110.881      0.9019       -10.881
 2023  1  97 114.329      0.8484       -17.329
 2023  2 119 117.776      1.0104         1.224
 2023  3 150 121.224      1.2374        28.776
 2023  4 112 124.671      0.8984       -12.671
 2024  1 109 128.119      0.8508       -19.119
 2024  2 129 131.566      0.9805        -2.566
 2024  3 167 135.014      1.2369        31.986
 2024  4 121 138.462      0.8739       -17.462
Multiplikatywne surowe: 0.8582 1.0002 1.2498 0.8914 ; suma = 3.9996 ; średnia = 0.9999
Multiplikatywne po korekcie (%): 85.83 100.03 125.00 89.15 ; suma = 400.00
Addytywne surowe: -16.329 -0.110 30.110 -13.671 ; suma = 0.000 ; po korekcie: -16.329 -0.110 30.110 -13.671
Prognoza 2025 multiplikatywna = trend * wskaźnik: 121.79 145.40 186.00 135.73 ; suma roku = 588.92
Prognoza 2025 addytywna = trend + składnik: 125.58 145.25 178.91 138.58
Różnica III kw. - I kw. w kolejnych latach: 49 53 58
Kontrola decompose() (wskaźniki z ilorazów do średniej ruchomej 2×4, %): 85.06 99.86 125.00 90.07
Sprzedaż oczyszczona z sezonowości 2024 (y / wskaźnik): 127.00 128.96 133.60 135.73
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats oraz pakiet DescTools); rysunki przygotowano w pakietach ggplot2, svglite i magick. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- DescTools (wersja 0.99.60): Signorell, A. (2025). DescTools: Tools for descriptive statistics [R package]. https://doi.org/10.32614/CRAN.package.DescTools
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An ‘SVG’ graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
- magick (wersja 2.9.1): Ooms, J. (2026). magick: Advanced graphics and image-processing in R [R package]. https://doi.org/10.32614/CRAN.package.magick
Najczęstsze pytania
Jak przeliczyć indeksy łańcuchowe na jednopodstawowe?
Zamień indeksy łańcuchowe na krotności (np. 109.52 → 1.0952) i mnóż je kolejno od roku bazowego. W zadaniu 1 iloczyn 1.0500 × 1.0952 × 0.9565 × 1.1364 × 1.1000 daje 1.375, czyli indeks 2024 r. = 137.50 (2019 = 100). W drugą stronę dzielisz sąsiednie indeksy jednopodstawowe: 125.0 / 110.0 × 100 = 113.64.
Czym różni się indeks cen Laspeyresa od indeksu cen Paaschego?
Oba porównują koszt tego samego koszyka w cenach bieżących i bazowych, ale Laspeyres bierze ilości z okresu bazowego, a Paasche – z okresu badanego. Gdy klienci kupują mniej produktów, które najbardziej drożeją, indeks Paaschego wychodzi niższy. W zadaniu 4 jest to 129.09 wobec 130.45, a indeks Fishera (ich średnia geometryczna) wynosi 129.77.
Jak obliczyć realny wzrost wynagrodzeń, znając inflację?
Podziel indeks nominalny przez indeks cen, oba jako krotności, i odejmij 1. Przy wzroście płac o 15% i cenach wyższych o 11% realny wzrost to 1.15 / 1.11 − 1 = 3.60%, a nie 4 punkty procentowe. Dla kilku lat najpierw pomnóż wskaźniki cen z kolejnych lat – w zadaniu 5 daje to 115.44 i realny wzrost o 6.84%.
Jak policzyć współczynnik Giniego z udziałów kwintylowych?
Skumuluj udziały (np. 6, 17, 33, 56, 100%), dodaj sąsiednie wartości skumulowane, zsumuj je, pomnóż przez szerokość grupy 0.2 i podziel przez 100 – to dwukrotne pole pod krzywą Lorenza. Gini = 1 minus ten wynik; w zadaniu 6: 1 − 0.648 = 0.352. Z danych pogrupowanych wynik jest zwykle nieco niższy niż z danych jednostkowych.
Kiedy wskaźniki sezonowości liczyć w modelu multiplikatywnym, a kiedy w addytywnym?
Model multiplikatywny wybierz, gdy wahania sezonowe rosną razem z poziomem szeregu (tu różnica III i I kwartału rośnie z 49 do 58 tys. zł). Addytywny wybierz, gdy wahania mają mniej więcej stałą wielkość. W multiplikatywnym prognoza to trend × wskaźnik, a wskaźniki sumują się do 4 dla kwartałów. W addytywnym prognoza to trend + składnik, a składniki sumują się do 0.
Powiązane hasła
Przeczytaj też
Statystyka w pracy z zarządzania i ekonomii
Ankieta wśród pracowników i model ekonometryczny na danych wtórnych: regresja, weryfikacja modelu, elastyczności, kod R i gotowe opisy wyników.
Czytaj →PoradnikSzeregi czasowe i ARIMA w praktyce
Trend, sezonowość, ACF i test Ljunga–Boxa, wybór modelu ARIMA w stats::arima, prognoza kontrfaktyczna i regresja segmentowa z kodem R.
Czytaj →PoradnikStatystyka opisowa – zadania z rozwiązaniami
Dziewięć zadań jak na kolokwium: szeregi rozdzielcze, średnia ważona, mediana i kwartyle ze wzoru interpolacyjnego, wariancja, CV, skośność i reguła 1.5 IQR.
Czytaj →Piszesz pracę z ekonomii lub zarządzania i masz własne dane?
Pomożemy dobrać wskaźniki i model do celu pracy, sprawdzimy obliczenia w R, Excelu lub SPSS i wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je opisać i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Aczel, A. D., & Sounderpandian, J. (2018). Statystyka w zarządzaniu (Wyd. 2). Wydawnictwo Naukowe PWN.
- Deltas, G. (2003). The small-sample bias of the Gini coefficient: Results and implications for empirical research. Review of Economics and Statistics, 85(1), 226–234. https://doi.org/10.1162/rest.2003.85.1.226 ● Otwarty dostęp: pełny tekst
- Hausman, J. (2003). Sources of bias and solutions to bias in the Consumer Price Index. Journal of Economic Perspectives, 17(1), 23–44. https://doi.org/10.1257/089533003321164930 ● Otwarty dostęp
- Hyndman, R. J., & Athanasopoulos, G. (2021). Forecasting: Principles and practice (3rd ed.). OTexts. https://otexts.com/fpp3/ ● Otwarty dostęp: pełny tekst
- Jebb, A. T., & Tay, L. (2017). Introduction to time series analysis for organizational research: Methods for longitudinal analyses. Organizational Research Methods, 20(1), 61–94. https://doi.org/10.1177/1094428116668035
- Lorenz, M. O. (1905). Methods of measuring the concentration of wealth. Publications of the American Statistical Association, 9(70), 209–219. https://doi.org/10.1080/15225437.1905.10503443
Cytowania BibTeX
@book{aczel2018statystyka, author={Aczel, Amir D. and Sounderpandian, Jayavel}, title={{Statystyka w zarządzaniu}}, year={2018}, edition={Wyd. 2}, publisher={Wydawnictwo Naukowe PWN}}@article{deltas2003small, author={Deltas, George}, title={{The small-sample bias of the Gini coefficient: Results and implications for empirical research}}, journal={Review of Economics and Statistics}, year={2003}, volume={85}, number={1}, pages={226--234}, doi={10.1162/rest.2003.85.1.226}}@article{hausman2003sources, author={Hausman, Jerry}, title={{Sources of bias and solutions to bias in the Consumer Price Index}}, journal={Journal of Economic Perspectives}, year={2003}, volume={17}, number={1}, pages={23--44}, doi={10.1257/089533003321164930}}@book{hyndman2021forecasting, author={Hyndman, Rob J. and Athanasopoulos, George}, title={{Forecasting: Principles and practice (3rd ed.)}}, year={2021}, publisher={OTexts}, url={https://otexts.com/fpp3/}}@article{jebb2017introduction, author={Jebb, Andrew T. and Tay, Louis}, title={{Introduction to time series analysis for organizational research: Methods for longitudinal analyses}}, journal={Organizational Research Methods}, year={2017}, volume={20}, number={1}, pages={61--94}, doi={10.1177/1094428116668035}}@article{lorenz1905methods, author={Lorenz, M. O.}, title={{Methods of measuring the concentration of wealth}}, journal={Publications of the American Statistical Association}, year={1905}, volume={9}, number={70}, pages={209--219}, doi={10.1080/15225437.1905.10503443}}