Dwa typy prac empirycznych w zarządzaniu i ekonomii
W pracy z zarządzania, finansów czy ekonomii promotor oczekuje części empirycznej z analizą statystyczną. Najczęściej spotkasz dwa typy prac. W pierwszym zbierasz własne dane – ankietę wśród pracowników, klientów lub menedżerów – i sprawdzasz związki między konstruktami mierzonymi skalami. W drugim korzystasz z danych wtórnych, np. ze statystyki publicznej albo ze sprawozdań firm, i budujesz model ekonometryczny. Oba typy prowadzą do regresji, ale różnią się danymi, pułapkami i tym, co trzeba pokazać w rozdziale wyników.
Przechodzimy przez oba typy na przykładach (dane symulowane): ankiecie wśród 240 pracowników z trzech branż i modelu cen mieszkań w 150 powiatach; wszystkie liczby pochodzą z kodu w sekcji Przykład w R. Podstaw regresji nie powtarzamy – pełną procedurę z diagnostyką reszt i interpretacją b, β i sr² opisuje poradnik regresja wieloraka krok po kroku.
| Element | Ankieta (dane pierwotne) | Dane wtórne i model ekonometryczny |
|---|---|---|
| Jednostka obserwacji | pracownik, klient, menedżer | powiat, gmina, firma, rok |
| Typowe zmienne | wyniki skal Likerta (satysfakcja, zaangażowanie, intencja odejścia), staż, branża | wskaźniki: wynagrodzenia, ceny, bezrobocie, sprzedaż, koszty |
| Główne analizy | rzetelność skal, korelacje, regresja wieloraka i logistyczna | MNK, testy diagnostyczne, model log-log |
| Główne zagrożenia | dobór próby, wspólna metoda pomiaru, dzielenie skal na grupy | zła postać funkcyjna, heteroskedastyczność, endogeniczność, trendy w szeregach czasowych |
| Co raportujesz | α i ω, M, SD, r, b i OR z 95% CI | współczynniki (często elastyczności) z błędami standardowymi, R², wyniki testów diagnostycznych |
Rzadszy, trzeci typ pracy to segmentacja klientów albo pracowników – podział respondentów na grupy o podobnych profilach odpowiedzi. Jak przeprowadzić ją analizą skupień k-średnich albo analizą profili latentnych i jak uniknąć typowych pułapek, pokazujemy w poradniku segmentacja respondentów.
Typ 1: ankieta wśród pracowników – konstrukty, hipotezy i pułapki
Typowy temat brzmi: „Satysfakcja z pracy i zaangażowanie a intencja odejścia pracowników”. Takie konstrukty mierzy się kilkoma stwierdzeniami ocenianymi na skali Likerta, a wynikiem skali jest średnia (albo suma) odpowiedzi. Jeśli to możliwe, użyj skal o sprawdzonych właściwościach psychometrycznych, zamiast układać pytania od zera (zob. jak zrobić ankietę do pracy dyplomowej).
W przykładzie 240 pracowników (82 z produkcji, 98 z handlu i 60 z usług) wypełniło cztery skale 1–5: satysfakcję z pracy (5 pozycji, w tym jedna sformułowana odwrotnie), zaangażowanie w pracę (5 pozycji), wsparcie przełożonego (4) i intencję odejścia (3). Badani podali też staż w firmie i odpowiedzieli na pytanie „Czy w ciągu najbliższych 12 miesięcy planujesz zmienić pracodawcę?”. Odpowiedź „tak” zaznaczyło 55 osób (22.9%). Hipotezy:
- H1. Wyższa satysfakcja z pracy i wyższe zaangażowanie wiążą się z niższą intencją odejścia przy kontroli stażu i branży.
- H2. Satysfakcja, zaangażowanie i wsparcie przełożonego wyjaśniają intencję odejścia w stopniu wykraczającym poza zmienne kontrolne.
- H3. Osoby bardziej zadowolone z pracy rzadziej deklarują plan zmiany pracodawcy w ciągu roku.
Już na etapie projektu zaplanuj, jak poradzisz sobie z czterema pułapkami typowymi dla ankiet w organizacjach.
- Dobór próby. Ankieta rozesłana znajomym albo w jednej firmie opisuje tę grupę, a nie „pracowników w Polsce”. Stantcheva (2023) w przewodniku po badaniach ankietowych dla ekonomistów omawia m.in. dobór próby, porzucanie ankiety, nieuważne odpowiedzi i tendencyjność odpowiedzi – to dobra lista kontrolna przed startem badania.
- Wspólna metoda pomiaru. Gdy satysfakcję, zaangażowanie i intencję odejścia mierzysz w jednej ankiecie u tych samych osób, część korelacji może wynikać z samego sposobu pomiaru, a nie z powiązań między konstruktami. Podsakoff i in. (2003) opisują źródła tego zjawiska oraz proceduralne i statystyczne sposoby jego ograniczania. Zadbaj przynajmniej o anonimowość, oddziel w kwestionariuszu skale predyktorów od skali wyniku i opisz to ograniczenie w dyskusji.
- Nie dziel skali na „tak” i „nie”. Jeśli potrzebujesz wyniku dwuwartościowego, zadaj osobne pytanie, tak jak tu o plan zmiany pracodawcy. Dzielenie wyniku skali medianą lub innym punktem odcięcia MacCallum i in. (2002) uznają za rzadko uzasadnione i często prowadzące do mylących wyników (zob. skala dychotomiczna).
- Zmienne kontrolne z uzasadnieniem. Staż i branżę kontrolujemy, bo mogą wiązać się i z predyktorami, i z intencją odejścia. Spector i Brannick (2011) nazywają automatyczne dorzucanie zmiennych kontrolnych „metodologiczną miejską legendą” i zalecają jawne określenie roli każdej z nich oraz dopasowanie zmiennych i analiz do hipotez.
Rzetelność skal i korelacje
Zacznij od przygotowania danych: odwróć pozycję sformułowaną negatywnie (na skali 1–5 nowa wartość to 6 minus stara), sprawdź braki i zakresy, a dopiero potem licz wyniki skal. Rzetelność każdej skali oceń współczynnikiem α Cronbacha i ω McDonalda. Dunn i in. (2014) proponują ω jako praktyczną alternatywę dla α, łatwą do policzenia w darmowym oprogramowaniu. Szerzej piszemy o tym w poradniku alfa Cronbacha: jak oceniać rzetelność skali i w haśle omega McDonalda.
| Skala | Liczba pozycji | α Cronbacha | ω McDonalda |
|---|---|---|---|
| Satysfakcja z pracy | 5 | .86 | .86 |
| Zaangażowanie w pracę | 5 | .85 | .85 |
| Wsparcie przełożonego | 4 | .86 | .86 |
| Intencja odejścia | 3 | .85 | .85 |
Wszystkie skale miały wysoką spójność wewnętrzną. Kolejny krok to statystyki opisowe i korelacje Pearsona.
| Zmienna | M | SD | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|---|
| 1. Satysfakcja z pracy (1–5) | 3.06 | 0.80 | — | |||
| 2. Zaangażowanie w pracę (1–5) | 3.31 | 0.76 | .42 | — | ||
| 3. Wsparcie przełożonego (1–5) | 3.02 | 0.90 | .51 | .35 | — | |
| 4. Intencja odejścia (1–5) | 2.67 | 1.04 | −.51 | −.41 | −.34 | — |
| 5. Staż w firmie (lata) | 6.60 | 5.33 | .11 | .09 | .04 | −.30 |
Intencja odejścia była tym niższa, im wyższe były satysfakcja (r = −.51), zaangażowanie (r = −.41), wsparcie przełożonego (r = −.34) i staż (r = −.30); wszystkie te korelacje były istotne, p < .001. Staż nie wiązał się istotnie z satysfakcją (p = .088), zaangażowaniem (p = .174) ani wsparciem (p = .561). Satysfakcja korelowała ze wsparciem przełożonego (r = .51), więc w modelu wielorakim ich współczynniki będą słabsze, niż sugerują same korelacje.
Regresja wieloraka z kontrolą stażu i branży
H1 i H2 sprawdza regresja wieloraka w wersji hierarchicznej: w kroku 1 wprowadzasz zmienne kontrolne, w kroku 2 – predyktory z hipotez (zob. regresja hierarchiczna). Branża ma trzy kategorie, więc wchodzi do modelu jako dwie zmienne zero-jedynkowe z produkcją jako kategorią odniesienia (dummy coding). Model końcowy ma postać:
Zmienne kontrolne wyjaśniały 13% wariancji intencji odejścia, R² = .13, F(3, 236) = 12.00, p < .001. Dodanie satysfakcji, zaangażowania i wsparcia zwiększyło wyjaśnioną wariancję o 28 punktów procentowych, ΔR² = .28, F(3, 233) = 36.53, p < .001, do R² = .41 (skorygowane R² = .39), F(6, 233) = 26.97, p < .001.
| Predyktor | b | 95% CI dla b | β | t(233) | p |
|---|---|---|---|---|---|
| Stała | 5.32 | [4.77, 5.87] | — | 19.20 | < .001 |
| Staż w firmie (lata) | −0.04 | [−0.06, −0.02] | −0.21 | −4.12 | < .001 |
| Handel (vs produkcja) | 0.51 | [0.27, 0.75] | 0.50 | 4.20 | < .001 |
| Usługi (vs produkcja) | 0.23 | [−0.04, 0.50] | 0.22 | 1.66 | .098 |
| Satysfakcja z pracy | −0.46 | [−0.62, −0.30] | −0.35 | −5.72 | < .001 |
| Zaangażowanie w pracę | −0.28 | [−0.44, −0.13] | −0.21 | −3.69 | < .001 |
| Wsparcie przełożonego | −0.10 | [−0.24, 0.03] | −0.09 | −1.48 | .140 |
Jak czytać te liczby w języku zarządzania:
- Satysfakcja, b = −0.46. Osoby z tej samej branży, o tym samym stażu, zaangażowaniu i wsparciu, różniące się o 1 punkt satysfakcji, różnią się przeciętnie o 0.46 punktu intencji odejścia. To najsilniejszy predyktor (β = −0.35).
- Zaangażowanie, b = −0.28. Wyższe zaangażowanie wiąże się z niższą intencją odejścia także przy tej samej satysfakcji.
- Wsparcie przełożonego, b = −0.10, p = .140. Wsparcie korelowało z intencją odejścia (r = −.34), ale po uwzględnieniu satysfakcji i zaangażowania jego unikalny związek był nieistotny. Być może wsparcie wiąże się z intencją za pośrednictwem satysfakcji – to jednak hipoteza do osobnego sprawdzenia (zob. analiza mediacji krok po kroku), a nie wniosek z tego modelu.
- Staż i branża. Każdy rok pracy w firmie wiąże się z intencją niższą średnio o 0.04 punktu (10 lat – o 0.41 punktu), a w handlu intencja była o 0.51 punktu wyższa niż w produkcji; różnica między usługami a produkcją była nieistotna.
β dla branży to różnica w odchyleniach standardowych intencji (zmiennych zero-jedynkowych nie standaryzowano). Pełną diagnostykę modelu pokazujemy w poradniku o regresji wielorakiej; tutaj wartości VIF wynosiły od 1.04 do 1.50, a błędy standardowe odporne na heteroskedastyczność (HC3) nie zmieniły żadnego wniosku.
Regresja logistyczna: kto planuje zmienić pracodawcę?
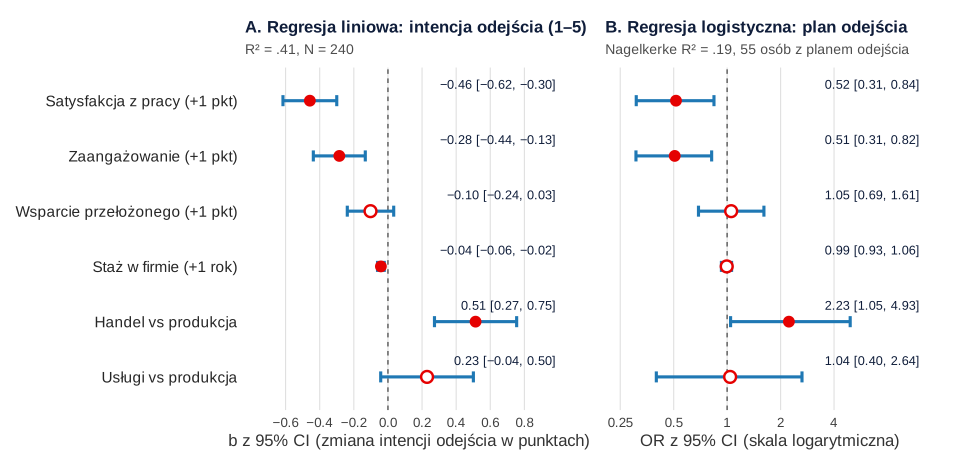
H3 dotyczy odpowiedzi „tak” albo „nie”, więc potrzebujesz regresji logistycznej. Model z tymi samymi predyktorami był istotnie lepszy od modelu bez predyktorów, χ²(6) = 32.76, p < .001, a R² Nagelkerkego wyniosło .19 (Coxa i Snella – .13). Wyniki czytasz jako ilorazy szans (OR):
- Satysfakcja: OR = 0.52, 95% CI [0.31, 0.84], p = .010. Każdy punkt satysfakcji więcej wiąże się z szansami na plan odejścia mniejszymi o 48.5%.
- Zaangażowanie: OR = 0.51, 95% CI [0.31, 0.82], p = .006.
- Handel vs produkcja: OR = 2.23, 95% CI [1.05, 4.93], p = .042 – szanse na plan odejścia były w handlu ok. 2.2 razy większe (plan zgłosiło 30.6% osób z handlu i 18.3% z produkcji). Wsparcie, staż i usługi nie miały istotnego związku z planem.
Ilorazy szans trudno przełożyć na decyzje, dlatego pokaż przewidywane prawdopodobieństwa. Dla pracownika handlu ze stażem 4 lat oraz przeciętnym zaangażowaniem i wsparciem przewidywany odsetek osób planujących odejście wynosi 43.7% przy satysfakcji równej 2, 28.6% przy satysfakcji 3 i 17.1% przy satysfakcji 4 (95% CI odpowiednio [28.5, 60.2], [19.8, 39.3] i [9.1, 29.8]). Szerokie przedziały przypominają, że model opiera się na 55 osobach z planem odejścia.
Ile zdarzeń wystarczy? Popularna reguła mówi o co najmniej 10 zdarzeniach na parametr (EPV); tu EPV = 55/6 = 9.2. Van Smeden i in. (2016) pokazali jednak, że dowody na rzecz reguł EPV są słabe, a problemy małych prób zależą także od całkowitej liczebności próby. Przy kilkudziesięciu zdarzeniach nie dodawaj więc predyktorów „na wszelki wypadek”. Założenia i raportowanie tego modelu omawiamy w poradniku regresja logistyczna: założenia, interpretacja i raportowanie.
Rysunek 1 zestawia oba modele. Ten sam predyktor może dawać różne odpowiedzi dla różnych wyników: staż wiązał się z niższą intencją odejścia mierzoną skalą, ale nie z planem zmiany pracodawcy.
Jak opisać wyniki ankiety w pracy (APA)
Podaj kolejno rzetelność skal, statystyki opisowe i korelacje, a potem wyniki obu modeli z przedziałami ufności:
Tabele wyników przygotujesz według wzorów z haseł tabela regresji liniowej w APA i tabela regresji logistycznej w APA, a ogólne zasady zapisu statystyk znajdziesz w poradniku jak opisać wyniki w stylu APA.
Typ 2: dane wtórne i specyfikacja modelu ekonometrycznego
W pracach z ekonomii i finansów często korzystasz z gotowych zestawień danych. Podstawowym publicznym źródłem danych regionalnych jest Bank Danych Lokalnych GUS. Według opisu na stronie GUS to największa w Polsce baza danych o gospodarce, społeczeństwie i środowisku; pierwsze dane pochodzą z 1995 roku, a wskaźniki opisują m.in. gminy, powiaty, województwa i cały kraj. Dane są pogrupowane w kategorie tematyczne, m.in. rynek pracy, wynagrodzenia i świadczenia społeczne oraz rynek nieruchomości (Główny Urząd Statystyczny, b.d.). Dane są dostępne także przez API, na licencji Creative Commons BY 4.0, która wymaga podania źródła.
Zanim cokolwiek pobierzesz, ustal jednostkę obserwacji i rodzaj danych. Dane przekrojowe to wiele jednostek w jednym okresie (np. powiaty w jednym roku), szeregi czasowe – jedna jednostka w wielu okresach (zob. szereg czasowy), a dane panelowe – wiele jednostek w wielu okresach. Od tego zależą metody: w przekroju martwisz się głównie postacią funkcyjną i heteroskedastycznością, w szeregach czasowych – trendem i autokorelacją reszt.
Specyfikacja to decyzja, które zmienne i w jakiej postaci wchodzą do modelu. Podejmij ją przed estymacją, na podstawie teorii i wcześniejszych badań, i wypisz oczekiwane znaki współczynników zamiast wrzucać do modelu wszystko, co udało się pobrać. W przykładzie (dane symulowane dla 150 powiatów, w tym 24 miast na prawach powiatu) pytamy, z czym wiążą się ceny mieszkań.
| Zmienna | Rola | Oczekiwany znak i uzasadnienie | Rozkład w próbie |
|---|---|---|---|
| Średnia cena 1 m² mieszkania (zł) | objaśniana | — | M = 5 990, SD = 2 054; od 2 700 do 13 090 |
| Przeciętne miesięczne wynagrodzenie brutto (zł) | objaśniająca | + (wyższe dochody, większy popyt na mieszkania) | M = 7 251, SD = 922; od 5 190 do 10 020 |
| Gęstość zaludnienia (os./km²) | objaśniająca | + (mniej wolnych terenów, popyt w aglomeracjach) | Mdn = 96; od 28 do 2 163 |
| Stopa bezrobocia (%) | objaśniająca | − (słabszy rynek pracy, mniejszy popyt) | M = 6.81, SD = 3.10; od 1.5 do 16.6 |
Najprostsza specyfikacja to model liniowy, w którym wszystkie zmienne wchodzą w jednostkach naturalnych, a jego parametry szacuje metoda najmniejszych kwadratów (MNK):
Wszystkie oszacowania mają oczekiwane znaki i są istotne. Wynagrodzenie wyższe o 100 zł wiąże się z ceną wyższą o 128.4 zł za m², każda dodatkowa osoba na km² – z ceną wyższą o 1.47 zł, a każdy punkt procentowy bezrobocia – z ceną niższą o 123 zł; R² = .82. Wysokie R² i istotne współczynniki nie oznaczają jednak, że model jest poprawny.
Weryfikacja modelu ekonometrycznego krok po kroku
Weryfikacja sprawdza, czy model spełnia założenia, od których zależą błędy standardowe, testy i interpretacja. Większość kroków dotyczy reszt modelu, a nie surowych zmiennych; ostatni krok dotyczy tylko szeregów czasowych.
| Krok | Pytanie | Narzędzie w R | Gdy wynik jest zły |
|---|---|---|---|
| 1. Dopasowanie | Czy model wyjaśnia więcej niż sama średnia? | R², skorygowane R², test F (summary()) | Wróć do specyfikacji |
| 2. Istotność i znaki | Czy współczynniki są istotne i mają oczekiwane znaki? | testy t (summary()) | Sprawdź dane, współliniowość i teorię |
| 3. Normalność reszt | Czy reszty mają rozkład zbliżony do normalnego? | test Jarque–Bera (własna funkcja), wykres Q-Q | Przekształć zmienne, sprawdź obserwacje odstające |
| 4. Homoskedastyczność | Czy rozrzut reszt jest stały? | test Breuscha–Pagana (bptest()), wykres reszt | Błędy standardowe HC3, przekształcenie zmiennych |
| 5. Postać funkcyjna | Czy zależności są liniowe? | test RESET (resettest()) | Logarytmy, składnik kwadratowy |
| 6. Współliniowość | Czy predyktory się nie powielają? | VIF (vif()) | Połącz lub usuń zmienne mierzące to samo |
| 7. Autokorelacja (szeregi czasowe) | Czy reszty kolejnych okresów są skorelowane? | test Durbina–Watsona lub Breuscha–Godfreya | Modele dla szeregów czasowych |
Normalność reszt: test Jarque–Bera
Test Jarque–Bera (Jarque i Bera, 1987) łączy dwie miary kształtu rozkładu reszt: skośność S i kurtozę K. Przy rozkładzie normalnym S = 0 i K = 3, a statystyka
ma w przybliżeniu rozkład χ² z dwoma stopniami swobody (kod: przepis 3). W modelu liniowym S = 0.53, K = 4.31, JB = 17.86, p < .001: reszty są prawostronnie skośne i mają grubsze ogony niż rozkład normalny.
Heteroskedastyczność: test Breuscha–Pagana i błędy HC3
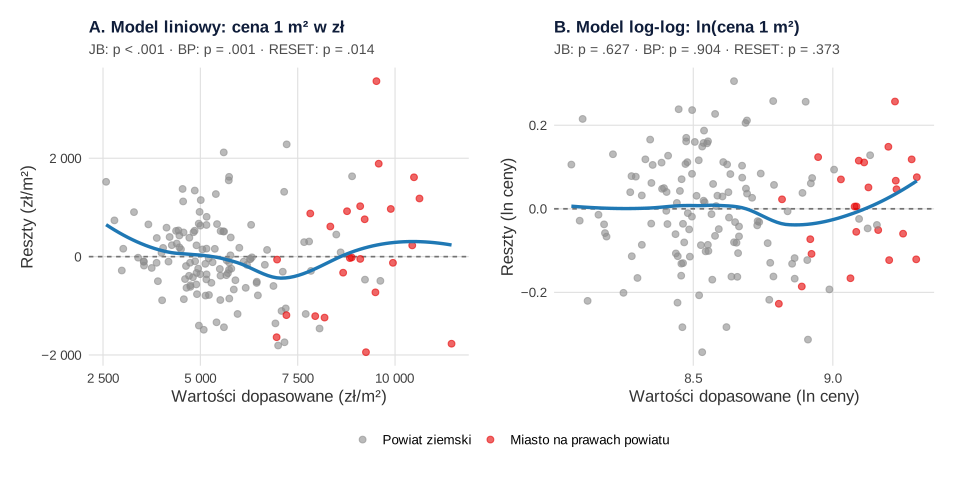
Test Breuscha–Pagana sprawdza, czy wariancja składnika losowego zależy od zmiennych objaśniających; statystykę liczy się prosto z reszt MNK (Breusch i Pagan, 1979), a bptest() domyślnie podaje jej wersję studentyzowaną. W modelu liniowym BP = 15.92, df = 3, p = .001: rozrzut reszt rośnie wraz z poziomem cen (rysunek 2, panel A), czyli występuje heteroskedastyczność.
Heteroskedastyczność nie obciąża współczynników MNK, ale zaburza ich błędy standardowe, a więc testy i przedziały ufności. Long i Ervin (2000) pokazali w symulacjach, że błędy standardowe HC3 działają dobrze nawet przy N = 25, i zalecają je przy N ≤ 250 zawsze, gdy można podejrzewać heteroskedastyczność. Tu HC3 zwiększyło błąd standardowy współczynnika gęstości z 0.20 do 0.29 (o 44.5%), ale wszystkie wartości p pozostały poniżej .001.
Postać funkcyjna: test RESET
Ramsey (1969) zaproponował procedury wykrywania błędów specyfikacji, m.in. pominiętych zmiennych i niewłaściwej postaci funkcyjnej. W popularnej wersji testu RESET do równania dodaje się kwadrat i sześcian wartości dopasowanych i sprawdza testem F, czy poprawiają dopasowanie. W modelu liniowym F(2, 144) = 4.40, p = .014, więc liniowa postać zależności jest wątpliwa.
Współliniowość
Wartości VIF wynosiły od 1.50 do 1.92, a Kim (2019) jako sygnał problemu podaje VIF powyżej 5–10, więc współliniowość nie jest tu kłopotem. Podsumowując: model liniowy dobrze dopasowuje się do danych, ale nie przechodzi trzech testów. Rysunek 2 pokazuje dlaczego.
Model log-log i elastyczność
Te trzy objawy sugerują, że zależności są raczej proporcjonalne niż addytywne: wzrost wynagrodzeń o 500 zł znaczy co innego w powiecie z cenami 3 000 zł i 12 000 zł za m². Do tego gęstość zaludnienia ma rozkład silnie prawostronnie skośny (skośność 2.20; mediana 96 os./km², a w miastach na prawach powiatu 1 163.5 os./km²). Rozwiązaniem jest model log-log, w którym logarytmujesz zmienną objaśnianą i zmienne objaśniające wyrażone w złotych lub osobach:
W takim modelu współczynnik przy zlogarytmowanej zmiennej to elastyczność: o ile procent zmienia się Y, gdy X rośnie o 1%, przy pozostałych zmiennych stałych. Stopę bezrobocia, wyrażoną już w procentach, zostawiamy w poziomach; jej współczynnik to semielastyczność (procentowa zmiana ceny na punkt procentowy bezrobocia).
| Postać modelu | Równanie | Interpretacja współczynnika β |
|---|---|---|
| Liniowa | Y = β0 + βX | Zmiana Y w jednostkach Y na jednostkę X; elastyczność zależy od punktu: β × X/Y |
| Log-lin | ln Y = β0 + βX | Zmiana Y o 100 × (eβ − 1)% na jednostkę X (dla małych β ok. 100β%) |
| Lin-log | Y = β0 + β ln X | Zmiana Y o ok. β/100 jednostek, gdy X rośnie o 1% |
| Log-log | ln Y = β0 + β ln X | Elastyczność: zmiana Y o ok. β% przy wzroście X o 1%; przy wzroście o 10% dokładnie (1.1β − 1) × 100% |
Model log-log przeszedł wszystkie testy: JB = 0.93, p = .627; BP = 0.57, p = .904; RESET F(2, 144) = 0.99, p = .373; VIF ≤ 1.96; błędy standardowe HC3 różniły się od klasycznych najwyżej o 7.4%. Model wyjaśnia 84% zmienności logarytmu ceny, R² = .84, F(3, 146) = 247.91, p < .001. Tego R² nie porównuj z R² = .82 modelu liniowego, bo zmienna objaśniana jest w innej skali.
- Wynagrodzenie: β = 1.45, 95% CI [1.25, 1.65]. Wynagrodzenia wyższe o 1% wiążą się z ceną wyższą średnio o 1.45%, a wyższe o 10% – o 14.8%. Elastyczność powyżej 1 oznacza, że ceny różnią się między powiatami proporcjonalnie bardziej niż wynagrodzenia.
- Gęstość zaludnienia: β = 0.094, 95% CI [0.069, 0.119]. Gęstość wyższa o 10% wiąże się z ceną wyższą o 0.9%, a dwukrotnie wyższa – o 6.7%.
- Bezrobocie: β = −0.017, 95% CI [−0.026, −0.007]. Każdy punkt procentowy bezrobocia więcej wiąże się z ceną niższą o 1.67%, czyli w powiecie o przeciętnej cenie (5 990 zł/m²) o ok. 100 zł/m².
Przedziały ufności obliczono z błędów HC3. W modelu liniowym elastyczność też da się policzyć, ale zależy od punktu – przy średnich wynosiła 1.55 dla wynagrodzeń i 0.07 dla gęstości – dlatego do pytań o reakcje procentowe lepiej nadaje się model log-log.
Interpretacja w języku biznesu
Wnioski z pracy często trafiają do menedżera albo decydenta. Przetłumacz liczby na jednostki decyzji (punkty skali, procenty, złote, prawdopodobieństwa), podaj niepewność i trzymaj się języka związków, a nie skutków.
| Wynik | Dobrze | Źle |
|---|---|---|
| b = −0.46 (satysfakcja a intencja odejścia) | „Pracownicy o satysfakcji wyższej o 1 punkt deklarowali intencję odejścia niższą średnio o 0.46 punktu” | „Podniesienie satysfakcji o 1 punkt zmniejszy rotację o 0.46” |
| OR = 2.23 (handel vs produkcja) | „W handlu szanse na plan zmiany pracodawcy były ok. 2.2 razy większe niż w produkcji” | „Pracownicy handlu 2.2 razy częściej odchodzą z pracy” (OR to nie iloraz prawdopodobieństw, a deklarowany plan to nie odejście) |
| Elastyczność 1.45 (ceny a wynagrodzenia) | „W powiatach o wynagrodzeniach wyższych o 10% ceny 1 m² były średnio o ok. 15% wyższe” | „Wzrost płac o 10% podniesie ceny mieszkań o 15%” |
| −1.67% na punkt procentowy bezrobocia | „Każdy punkt procentowy bezrobocia więcej wiązał się z ceną niższą o ok. 1.7%, czyli ok. 100 zł/m² w przeciętnym powiecie” | „Bezrobocie obniża ceny mieszkań” |
Rekomendacje formułuj warunkowo („wyniki sugerują, że warto monitorować satysfakcję w handlu”), bo badanie przekrojowe nie pokazuje skutków interwencji. Jeśli potrzebujesz pomocy w doborze modelu, sprawdzeniu założeń albo interpretacji, zajrzyj do oferty analiz statystycznych dla studentów – obejmuje ona także modele ekonometryczne i ankiety. Pomoc polega na analizie i jej wyjaśnieniu: wyniki musisz rozumieć i umieć obronić, a korzystanie z konsultacji opisz zgodnie z zasadami swojej uczelni.
Jak opisać model ekonometryczny w pracy
Opis modelu obejmuje specyfikację (zmienne, ich postać, źródło danych, jednostkę i okres), metodę estymacji, wyniki weryfikacji i interpretację współczynników:
W pracach ekonomicznych wyniki estymacji często zestawia się w jednej tabeli z kolumną dla każdego modelu i wynikami testów diagnostycznych pod spodem. Wzór:
Tabela 1
Oszacowania MNK modelu liniowego i log-log średniej ceny 1 m² mieszkania w powiatach
| Zmienna | Model 1: liniowy | Model 2: log-log | ||
|---|---|---|---|---|
| b | SE | b | SE | |
| Stała | −2892.79*** | 854.87 | −4.550*** | 0.970 |
| Wynagrodzenie (zł; w modelu 2 – logarytm) | 1.284*** | 0.100 | 1.447*** | 0.109 |
| Gęstość zaludnienia (os./km²; w modelu 2 – logarytm) | 1.469*** | 0.202 | 0.094*** | 0.013 |
| Stopa bezrobocia (%) | −123.141*** | 32.328 | −0.017*** | 0.005 |
| R² (skorygowane R²) | .82 (.81) | .84 (.83) | ||
| F(3, 146) | 219.55*** | 247.91*** | ||
| Test Jarque–Bera, χ²(2) | 17.86*** | 0.93 | ||
| Test Breuscha–Pagana, χ²(3) | 15.92** | 0.57 | ||
| Test RESET, F(2, 144) | 4.40* | 0.99 | ||
| Największy VIF | 1.92 | 1.96 | ||
Uwaga. N = 150 powiatów. W modelu 2 zlogarytmowano cenę, wynagrodzenie i gęstość zaludnienia; współczynniki przy logarytmach to elastyczności, a współczynnik bezrobocia to semielastyczność. SE – klasyczne błędy standardowe; błędy odporne na heteroskedastyczność (HC3) prowadziły do tych samych wniosków. Dane symulowane.
*p < .05. **p < .01. ***p < .001.
Przykład w R
Kod odtwarza wszystkie liczby z tekstu i tabel. Uruchom przepisy po kolei w jednej sesji R – przepis 2 korzysta z danych z przepisu 1, a przepisy 3 i 4 tworzą własne dane. Rysunki na stronie przedstawiają te same modele narysowane w pakietach ggplot2 i patchwork. W swojej pracy zastąp fragmenty tworzące dane symulowane wczytaniem własnego pliku.
1. Ankieta: dane, rzetelność skal i korelacje
R
library(psych)   # alpha(), fa(), corr.test()

# Dane symulowane: 240 pracowników z trzech branż. Skale Likerta 1–5: satysfakcja z pracy
# (5 pozycji, sat4 sformułowana odwrotnie), zaangażowanie w pracę (5), wsparcie przełożonego (4),
# intencja odejścia (3); staż w firmie (lata) i pytanie „Czy w ciągu 12 miesięcy planujesz
# zmienić pracodawcę?” (nie/tak). W swojej pracy zamiast tego fragmentu wczytaj plik z danymi.
set.seed(3151)
n <- 240
likert <- function(lat, lad, prog) findInterval(lad * lat + rnorm(length(lat), sd = sqrt(1 - lad^2)), prog) + 1
pozycje <- function(lat, lad, prog, przes = 0) {
  sapply(seq_along(lad), function(i) likert(lat, lad[i], prog + rep_len(przes, length(lad))[i]))
}
branza <- factor(sample(c("produkcja", "handel", "usługi"), n, replace = TRUE, prob = c(0.36, 0.38, 0.26)),
                 levels = c("produkcja", "handel", "usługi"))
staz <- pmin(round(rgamma(n, shape = 1.6, scale = 4)), 30)
wsp_l <- rnorm(n)
sat_l <- 0.50 * wsp_l + rnorm(n, sd = sqrt(0.75))
zaa_l <- as.numeric(scale(0.25 * wsp_l + 0.45 * sat_l + rnorm(n, sd = 0.8)))
int_l <- as.numeric(scale(-0.45 * sat_l - 0.20 * zaa_l - 0.10 * wsp_l - 0.05 * (staz - 6) +
                            0.45 * (branza == "handel") + 0.20 * (branza == "usługi") + rnorm(n, sd = 0.75)))
S <- pozycje(sat_l, c(.80, .78, .75, .70, .80), c(-1.6, -0.7, 0.3, 1.3), c(0, .1, -.1, 0, .2))
S[, 4] <- 6 - S[, 4]                                    # pozycja sformułowana odwrotnie
Z <- pozycje(zaa_l, c(.78, .80, .75, .72, .78), c(-1.8, -0.9, 0.1, 1.2), c(0, .1, -.1, .1, 0))
W <- pozycje(wsp_l, c(.80, .78, .74, .76), c(-1.5, -0.6, 0.4, 1.4))
I <- pozycje(int_l, c(.85, .82, .80), c(-0.9, -0.1, 0.7, 1.5))
colnames(S) <- paste0("sat", 1:5); colnames(Z) <- paste0("zaa", 1:5)
colnames(W) <- paste0("wsp", 1:4); colnames(I) <- paste0("int", 1:3)
ankieta <- data.frame(id = 1:n, branza, staz, S, Z, W, I)
ankieta$plan <- factor(rbinom(n, 1, plogis(-1.05 + 1.35 * int_l - 0.04 * (staz - 6))),
                       levels = 0:1, labels = c("nie", "tak"))

# Krok 1: odwróć pozycję sformułowaną negatywnie (skala 1–5: nowa wartość = 6 − stara)
ankieta$sat4 <- 6 - ankieta$sat4

# Krok 2: rzetelność skal – alfa Cronbacha i omega z modelu jednoczynnikowego
skale <- list(satysfakcja = paste0("sat", 1:5), zaangazowanie = paste0("zaa", 1:5),
              wsparcie = paste0("wsp", 1:4), intencja = paste0("int", 1:3))
omega_t <- function(x) {
  f <- fa(x, nfactors = 1, fm = "ml")
  l <- f$loadings[, 1]
  sum(l)^2 / (sum(l)^2 + sum(f$uniquenesses))
}
round(t(sapply(skale, function(p) c(pozycje = length(p), alfa = alpha(ankieta[p])$total$raw_alpha,
                                     omega = omega_t(ankieta[p])))), 2)

# Krok 3: wyniki skal (średnia z pozycji) i statystyki opisowe
for (s in names(skale)) ankieta[[s]] <- rowMeans(ankieta[skale[[s]]])
zm <- c("satysfakcja", "zaangazowanie", "wsparcie", "intencja", "staz")
round(sapply(ankieta[zm], function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2)
table(ankieta$branza)
table(ankieta$plan)
round(100 * prop.table(table(ankieta$plan)), 1)

# Krok 4: korelacje Pearsona i wartości p (bez korekty)
kor <- corr.test(ankieta[zm], adjust = "none")
round(kor$r, 2)
round(kor$p, 3)
Wynik w R
              pozycje alfa omega
satysfakcja         5 0.86  0.86
zaangazowanie       5 0.85  0.85
wsparcie            4 0.86  0.86
intencja            3 0.85  0.85
    satysfakcja zaangazowanie wsparcie intencja  staz
M          3.06          3.31     3.02     2.67  6.60
SD         0.80          0.76     0.90     1.04  5.33
min        1.00          1.00     1.00     1.00  0.00
max        5.00          5.00     5.00     5.00 30.00

produkcja    handel    usługi
       82        98        60

nie tak
185  55

 nie  tak
77.1 22.9
              satysfakcja zaangazowanie wsparcie intencja  staz
satysfakcja          1.00          0.42     0.51    -0.51  0.11
zaangazowanie        0.42          1.00     0.35    -0.41  0.09
wsparcie             0.51          0.35     1.00    -0.34  0.04
intencja            -0.51         -0.41    -0.34     1.00 -0.30
staz                 0.11          0.09     0.04    -0.30  1.00
              satysfakcja zaangazowanie wsparcie intencja  staz
satysfakcja         0.000         0.000    0.000        0 0.088
zaangazowanie       0.000         0.000    0.000        0 0.174
wsparcie            0.000         0.000    0.000        0 0.561
intencja            0.000         0.000    0.000        0 0.000
staz                0.088         0.174    0.561        0 0.000
2. Regresja hierarchiczna i regresja logistyczna
R
library(car)          # vif()
library(effectsize)   # standardize_parameters()
library(lmtest)       # coeftest()
library(sandwich)     # vcovHC() – odporne błędy standardowe

# Regresja hierarchiczna intencji odejścia (1–5): krok 1 – zmienne kontrolne (staż, branża),
# krok 2 – satysfakcja, zaangażowanie i wsparcie przełożonego. Kategoria odniesienia: produkcja.
m1 <- lm(intencja ~ staz + branza, data = ankieta)
m2 <- update(m1, . ~ . + satysfakcja + zaangazowanie + wsparcie)
summary(m1)
summary(m2)
round(confint(m2), 2)
anova(m1, m2)                                              # test F zmiany R²
round(summary(m2)$r.squared - summary(m1)$r.squared, 3)    # ΔR²
standardize_parameters(m2)                                 # β
vif(m2)
coeftest(m2, vcov. = vcovHC(m2, type = "HC3"))             # sprawdzenie z błędami HC3

# Regresja logistyczna: plan zmiany pracodawcy w ciągu 12 miesięcy (tak = 1)
g1 <- glm(plan ~ satysfakcja + zaangazowanie + wsparcie + staz + branza, family = binomial, data = ankieta)
summary(g1)
round(exp(cbind(OR = coef(g1), confint(g1))), 2)           # ilorazy szans z 95% CI (profilowe)
g0 <- glm(plan ~ 1, family = binomial, data = ankieta)
anova(g0, g1, test = "LRT")                                # test ilorazu wiarygodności modelu
r2_cs <- 1 - exp((g1$deviance - g1$null.deviance) / nrow(ankieta))
round(c(R2_CoxSnell = r2_cs, R2_Nagelkerke = r2_cs / (1 - exp(-g1$null.deviance / nrow(ankieta)))), 3)
zdarzenia <- sum(ankieta$plan == "tak")
c(zdarzenia = zdarzenia, parametry = length(coef(g1)) - 1, EPV = round(zdarzenia / (length(coef(g1)) - 1), 1))

# Przewidywane prawdopodobieństwo planu odejścia: handel, staż 4 lata,
# przeciętne zaangażowanie i wsparcie, satysfakcja 2, 3 lub 4 punkty
nowi <- data.frame(satysfakcja = c(2, 3, 4), zaangazowanie = mean(ankieta$zaangazowanie),
                   wsparcie = mean(ankieta$wsparcie), staz = 4, branza = "handel")
pr <- predict(g1, nowi, type = "link", se.fit = TRUE)
round(data.frame(satysfakcja = nowi$satysfakcja, p = plogis(pr$fit),
                 dolna = plogis(pr$fit - 1.96 * pr$se.fit), gorna = plogis(pr$fit + 1.96 * pr$se.fit)), 3)
Wynik w R
Loading required package: carData

Attaching package: ‘car’

The following object is masked from ‘package:psych’:

    logit


Attaching package: ‘effectsize’

The following object is masked from ‘package:psych’:

    phi

Loading required package: zoo

Attaching package: ‘zoo’

The following objects are masked from ‘package:base’:

    as.Date, as.Date.numeric


Call:
lm(formula = intencja ~ staz + branza, data = ankieta)

Residuals:
     Min       1Q   Median       3Q      Max
-1.99621 -0.72996 -0.01063  0.69486  2.16324

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept)   2.79053    0.13886  20.096  < 2e-16 ***
staz         -0.05315    0.01194  -4.450 1.32e-05 ***
branzahandel  0.47144    0.14693   3.209  0.00152 **
branzausługi  0.13773    0.16513   0.834  0.40507
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.9718 on 236 degrees of freedom
Multiple R-squared:  0.1324,	Adjusted R-squared:  0.1213
F-statistic:    12 on 3 and 236 DF,  p-value: 2.431e-07


Call:
lm(formula = intencja ~ staz + branza + satysfakcja + zaangazowanie +
    wsparcie, data = ankieta)

Residuals:
     Min       1Q   Median       3Q      Max
-1.86811 -0.57661 -0.04426  0.54039  2.01384

Coefficients:
               Estimate Std. Error t value Pr(>|t|)
(Intercept)    5.321085   0.277188  19.197  < 2e-16 ***
staz          -0.041188   0.009987  -4.124 5.18e-05 ***
branzahandel   0.513715   0.122234   4.203 3.76e-05 ***
branzausługi   0.229249   0.137862   1.663 0.097679 .
satysfakcja   -0.457640   0.080000  -5.721 3.24e-08 ***
zaangazowanie -0.284974   0.077296  -3.687 0.000283 ***
wsparcie      -0.102157   0.069021  -1.480 0.140200
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.8066 on 233 degrees of freedom
Multiple R-squared:  0.4099,	Adjusted R-squared:  0.3947
F-statistic: 26.97 on 6 and 233 DF,  p-value: < 2.2e-16

              2.5 % 97.5 %
(Intercept)    4.77   5.87
staz          -0.06  -0.02
branzahandel   0.27   0.75
branzausługi  -0.04   0.50
satysfakcja   -0.62  -0.30
zaangazowanie -0.44  -0.13
wsparcie      -0.24   0.03
Analysis of Variance Table

Model 1: intencja ~ staz + branza
Model 2: intencja ~ staz + branza + satysfakcja + zaangazowanie + wsparcie
  Res.Df    RSS Df Sum of Sq      F    Pr(>F)
1    236 222.88
2    233 151.59  3    71.293 36.527 < 2.2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
[1] 0.278
# Standardization method: refit

Parameter       | Std. Coef. |         95% CI
---------------------------------------------
(Intercept)     |      -0.26 | [-0.43, -0.09]
staz            |      -0.21 | [-0.31, -0.11]
branza [handel] |       0.50 | [ 0.26,  0.73]
branza [usługi] |       0.22 | [-0.04,  0.48]
satysfakcja     |      -0.35 | [-0.47, -0.23]
zaangazowanie   |      -0.21 | [-0.32, -0.10]
wsparcie        |      -0.09 | [-0.21,  0.03]
                  GVIF Df GVIF^(1/(2*Df))
staz          1.039098  1        1.019362
branza        1.036505  2        1.009004
satysfakcja   1.497509  1        1.223727
zaangazowanie 1.263361  1        1.123993
wsparcie      1.404051  1        1.184927

t test of coefficients:

                Estimate Std. Error t value  Pr(>|t|)
(Intercept)    5.3210852  0.2440211 21.8058 < 2.2e-16 ***
staz          -0.0411877  0.0086256 -4.7750 3.176e-06 ***
branzahandel   0.5137152  0.1197410  4.2902 2.617e-05 ***
branzausługi   0.2292485  0.1342974  1.7070 0.0891503 .
satysfakcja   -0.4576399  0.0804327 -5.6897 3.801e-08 ***
zaangazowanie -0.2849743  0.0755566 -3.7717 0.0002057 ***
wsparcie      -0.1021567  0.0681645 -1.4987 0.1353106
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1


Call:
glm(formula = plan ~ satysfakcja + zaangazowanie + wsparcie +
    staz + branza, family = binomial, data = ankieta)

Coefficients:
               Estimate Std. Error z value Pr(>|z|)
(Intercept)    2.389421   0.857765   2.786  0.00534 **
satysfakcja   -0.663255   0.255751  -2.593  0.00950 **
zaangazowanie -0.679924   0.248890  -2.732  0.00630 **
wsparcie       0.052264   0.215336   0.243  0.80823
staz          -0.005535   0.033331  -0.166  0.86811
branzahandel   0.800616   0.393581   2.034  0.04193 *
branzausługi   0.038568   0.477599   0.081  0.93564
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 258.37  on 239  degrees of freedom
Residual deviance: 225.61  on 233  degrees of freedom
AIC: 239.61

Number of Fisher Scoring iterations: 4

Waiting for profiling to be done...
                 OR 2.5 % 97.5 %
(Intercept)   10.91  2.08  61.13
satysfakcja    0.52  0.31   0.84
zaangazowanie  0.51  0.31   0.82
wsparcie       1.05  0.69   1.61
staz           0.99  0.93   1.06
branzahandel   2.23  1.05   4.93
branzausługi   1.04  0.40   2.64
Analysis of Deviance Table

Model 1: plan ~ 1
Model 2: plan ~ satysfakcja + zaangazowanie + wsparcie + staz + branza
  Resid. Df Resid. Dev Df Deviance  Pr(>Chi)
1       239     258.37
2       233     225.61  6   32.755 1.169e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
  R2_CoxSnell R2_Nagelkerke
        0.128         0.194
zdarzenia parametry       EPV
     55.0       6.0       9.2
  satysfakcja     p dolna gorna
1           2 0.437 0.285 0.602
2           3 0.286 0.198 0.393
3           4 0.171 0.091 0.298
3. Model ekonometryczny: MNK, weryfikacja i model log-log
R
library(lmtest)     # bptest(), resettest(), coeftest(), coefci()
library(sandwich)   # vcovHC()
library(car)        # vif()

# Dane symulowane: przekrój 150 powiatów, wzorowany na wskaźnikach regionalnych.
# cena_m2 – średnia cena 1 m² mieszkania (zł), wynagrodzenie – przeciętne miesięczne
# wynagrodzenie brutto (zł), gestosc – gęstość zaludnienia (os./km²),
# bezrobocie – stopa bezrobocia (%), miasto – miasto na prawach powiatu (0/1)
set.seed(3142)
n <- 150
miasto <- rbinom(n, 1, 0.15)
ln_gest <- ifelse(miasto == 1, rnorm(n, 7.2, 0.5), rnorm(n, 4.45, 0.6))
gestosc <- round(exp(ln_gest))
ln_wyn <- log(7000) + 0.06 * (ln_gest - 4.45) + rnorm(n, 0, 0.10)
wynagrodzenie <- round(exp(ln_wyn), -1)
bezrobocie <- round(pmax(1.5, 7.5 - 0.9 * (ln_gest - 4.45) - 8 * (ln_wyn - log(7000)) + rnorm(n, 0, 2.5)), 1)
ln_cena <- log(5200) + 1.4 * (log(wynagrodzenie) - log(7000)) + 0.12 * (log(gestosc) - 4.45) -
  0.015 * (bezrobocie - 7.5) + rnorm(n, 0, 0.12)
powiaty <- data.frame(cena_m2 = round(exp(ln_cena), -1), wynagrodzenie, gestosc, bezrobocie, miasto)
summary(powiaty[1:4])
table(powiaty$miasto)

# Test Jarque–Bera policzony samodzielnie: JB = n/6 × [S² + (K − 3)²/4], rozkład χ² z 2 df
jarque_bera <- function(e) {
  n <- length(e)
  e <- e - mean(e)
  S <- mean(e^3) / mean(e^2)^1.5     # skośność reszt
  K <- mean(e^4) / mean(e^2)^2       # kurtoza reszt (rozkład normalny: 3)
  JB <- n / 6 * (S^2 + (K - 3)^2 / 4)
  round(c(S = S, K = K, JB = JB, p = pchisq(JB, df = 2, lower.tail = FALSE)), 4)
}

# Model 1: liniowy (wszystkie zmienne w poziomach), estymacja MNK i weryfikacja
m_lin <- lm(cena_m2 ~ wynagrodzenie + gestosc + bezrobocie, data = powiaty)
summary(m_lin)
jarque_bera(resid(m_lin))
bptest(m_lin)                     # Breusch–Pagan (wersja studentyzowana, domyślna w lmtest)
resettest(m_lin)                  # RESET Ramseya: kwadraty i sześciany wartości dopasowanych
vif(m_lin)
coeftest(m_lin, vcov. = vcovHC(m_lin, type = "HC3"))
# W modelu liniowym elastyczność zależy od punktu – tu liczona przy średnich: b × średnia X / średnia Y
sr <- colMeans(powiaty)
round(coef(m_lin)[-1] * sr[c("wynagrodzenie", "gestosc", "bezrobocie")] / sr["cena_m2"], 3)

# Model 2: log-log (logarytmy ceny, wynagrodzenia i gęstości; bezrobocie w punktach procentowych)
m_log <- lm(log(cena_m2) ~ log(wynagrodzenie) + log(gestosc) + bezrobocie, data = powiaty)
summary(m_log)
jarque_bera(resid(m_log))
bptest(m_log)
resettest(m_log)
vif(m_log)
coeftest(m_log, vcov. = vcovHC(m_log, type = "HC3"))
round(coefci(m_log, vcov. = vcovHC(m_log, type = "HC3")), 3)

# Interpretacja w procentach: +10% wynagrodzenia, +10% gęstości, +1 punkt procentowy bezrobocia
b <- coef(m_log)
round(c(wynagrodzenie_10proc = 100 * (1.1^b[[2]] - 1), gestosc_10proc = 100 * (1.1^b[[3]] - 1),
        bezrobocie_1pp = 100 * (exp(b[[4]]) - 1)), 2)
Wynik w R
    cena_m2      wynagrodzenie      gestosc         bezrobocie
 Min.   : 2700   Min.   : 5190   Min.   :  28.0   Min.   : 1.500
 1st Qu.: 4615   1st Qu.: 6692   1st Qu.:  56.5   1st Qu.: 4.425
 Median : 5530   Median : 7100   Median :  96.0   Median : 6.900
 Mean   : 5990   Mean   : 7251   Mean   : 279.8   Mean   : 6.807
 3rd Qu.: 6722   3rd Qu.: 7840   3rd Qu.: 172.2   3rd Qu.: 8.875
 Max.   :13090   Max.   :10020   Max.   :2163.0   Max.   :16.600

  0   1
126  24

Call:
lm(formula = cena_m2 ~ wynagrodzenie + gestosc + bezrobocie,
    data = powiaty)

Residuals:
    Min      1Q  Median      3Q     Max
-1943.2  -497.6   -86.3   512.3  3568.3

Coefficients:
                Estimate Std. Error t value Pr(>|t|)
(Intercept)   -2.893e+03  8.549e+02  -3.384 0.000918 ***
wynagrodzenie  1.284e+00  9.964e-02  12.886  < 2e-16 ***
gestosc        1.469e+00  2.024e-01   7.258 2.15e-11 ***
bezrobocie    -1.231e+02  3.233e+01  -3.809 0.000205 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 883.7 on 146 degrees of freedom
Multiple R-squared:  0.8186,	Adjusted R-squared:  0.8148
F-statistic: 219.6 on 3 and 146 DF,  p-value: < 2.2e-16

      S       K      JB       p
 0.5318  4.3140 17.8618  0.0001

	studentized Breusch-Pagan test

data:  m_lin
BP = 15.919, df = 3, p-value = 0.001178


	RESET test

data:  m_lin
RESET = 4.3959, df1 = 2, df2 = 144, p-value = 0.01402

wynagrodzenie       gestosc    bezrobocie
     1.609345      1.502946      1.916328

t test of coefficients:

                 Estimate  Std. Error t value  Pr(>|t|)
(Intercept)   -2.8928e+03  7.7323e+02 -3.7412 0.0002626 ***
wynagrodzenie  1.2840e+00  9.9572e-02 12.8948 < 2.2e-16 ***
gestosc        1.4695e+00  2.9247e-01  5.0242 1.456e-06 ***
bezrobocie    -1.2314e+02  3.0533e+01 -4.0330 8.843e-05 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

wynagrodzenie       gestosc    bezrobocie
        1.554         0.069        -0.140

Call:
lm(formula = log(cena_m2) ~ log(wynagrodzenie) + log(gestosc) +
    bezrobocie, data = powiaty)

Residuals:
     Min       1Q   Median       3Q      Max
-0.34327 -0.08633  0.00554  0.09147  0.30560

Coefficients:
                    Estimate Std. Error t value Pr(>|t|)
(Intercept)        -4.550156   0.969930  -4.691 6.19e-06 ***
log(wynagrodzenie)  1.447361   0.108876  13.294  < 2e-16 ***
log(gestosc)        0.094015   0.012506   7.518 5.19e-12 ***
bezrobocie         -0.016839   0.004803  -3.506 0.000605 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.1299 on 146 degrees of freedom
Multiple R-squared:  0.8359,	Adjusted R-squared:  0.8325
F-statistic: 247.9 on 3 and 146 DF,  p-value: < 2.2e-16

      S       K      JB       p
-0.1191  2.6960  0.9322  0.6274

	studentized Breusch-Pagan test

data:  m_log
BP = 0.5662, df = 3, p-value = 0.9041


	RESET test

data:  m_log
RESET = 0.99189, df1 = 2, df2 = 144, p-value = 0.3734

log(wynagrodzenie)       log(gestosc)         bezrobocie
          1.643852           1.711936           1.957173

t test of coefficients:

                     Estimate Std. Error t value  Pr(>|t|)
(Intercept)        -4.5501562  0.8979036 -5.0675 1.201e-06 ***
log(wynagrodzenie)  1.4473610  0.1017159 14.2294 < 2.2e-16 ***
log(gestosc)        0.0940153  0.0126499  7.4321 8.308e-12 ***
bezrobocie         -0.0168389  0.0048693 -3.4582 0.0007129 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

                    2.5 % 97.5 %
(Intercept)        -6.325 -2.776
log(wynagrodzenie)  1.246  1.648
log(gestosc)        0.069  0.119
bezrobocie         -0.026 -0.007
wynagrodzenie_10proc       gestosc_10proc       bezrobocie_1pp
               14.79                 0.90                -1.67
4. Symulacje: za dużo zmiennych i regresja pozorna
R
# Dwie symulacje do sekcji o błędach (10 000 powtórzeń każda)
set.seed(3133)

# 1) Za dużo zmiennych na małej próbie: n = 20 obserwacji, k = 8 predyktorów
#    całkowicie niezwiązanych ze zmienną zależną
nadmiar <- replicate(10000, {
  X <- matrix(rnorm(20 * 8), nrow = 20)
  y <- rnorm(20)
  s <- summary(lm(y ~ X))
  c(R2 = s$r.squared, R2_skor = s$adj.r.squared,
    F_istotny = unname(pf(s$fstatistic[1], 8, 11, lower.tail = FALSE) < .05),
    min_jeden_t_istotny = any(coef(s)[-1, 4] < .05))
})
round(rowMeans(nadmiar), 3)
round(8 / 19, 3)                                   # oczekiwane R² bez żadnego związku: k / (n − 1)
round(quantile(nadmiar["R2", ], c(.10, .50, .90)), 3)

# 2) Regresja pozorna: dwa niezależne szeregi z trendem stochastycznym
#    (błądzenia losowe), 25 obserwacji rocznych
pozorna <- replicate(10000, {
  x <- cumsum(rnorm(25))
  y <- cumsum(rnorm(25))
  s <- summary(lm(y ~ x))
  c(p = coef(s)[2, 4], R2 = s$r.squared)
})
round(c(odsetek_p_ponizej_05 = mean(pozorna["p", ] < .05), mediana_R2 = median(pozorna["R2", ])), 3)
Wynik w R
                 R2             R2_skor           F_istotny min_jeden_t_istotny
              0.418              -0.005               0.045               0.255
[1] 0.421
  10%   50%   90%
0.222 0.412 0.620
odsetek_p_ponizej_05           mediana_R2
               0.519                0.168
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- psych (wersja 2.6.5): Revelle, W. (2026). psych: Procedures for psychological, psychometric, and personality research [R package]. Northwestern University. https://CRAN.R-project.org/package=psych
- car (wersja 3.1.5): Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage. https://www.john-fox.ca/Companion/
- effectsize (wersja 1.0.2): Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- lmtest (wersja 0.9.40): Zeileis, A., & Hothorn, T. (2002). Diagnostic checking in regression relationships. R News, 2(3), 7–10. https://CRAN.R-project.org/doc/Rnews/
- sandwich (wersja 3.1.1): Zeileis, A., Köll, S., & Graham, N. (2020). Various versatile variances: An object-oriented implementation of clustered covariances in R. Journal of Statistical Software, 95(1), 1–36. https://doi.org/10.18637/jss.v095.i01
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Wnioski przyczynowe z danych przekrojowych. „Wyższe wynagrodzenia podnoszą ceny mieszkań” albo „satysfakcja zmniejsza rotację” to interpretacje, których model z jednego pomiaru nie uzasadnia (zob. schemat przekrojowy). Pisz o związkach, a mechanizmy omawiaj w dyskusji jako możliwe wyjaśnienia.
- Pomijanie endogeniczności. Zmienna objaśniająca jest endogeniczna, gdy jest skorelowana ze składnikiem losowym – np. przez pominiętą zmienną (atrakcyjność miejsca może wiązać się i z płacami, i z cenami), równoczesność albo błąd pomiaru. Antonakis i in. (2010) pokazują, że endogeniczność odbiera oszacowaniom interpretację przyczynową; w ich przeglądzie 110 artykułów o przywództwie z czołowych czasopism badacze nie uwzględniali od 66% do 90% warunków, od których zależy trafność takich wniosków. Metody, które się z tym mierzą (np. zmienne instrumentalne, panele z efektami stałymi), opisuje hasło ekonometria. Jeśli ich nie stosujesz, nazwij problem w ograniczeniach badania.
- Za dużo zmiennych na małej próbie. W symulacji (10 000 prób po 20 obserwacji i 8 zmiennych objaśniających niezwiązanych z Y) średnie R² wyniosło .42 – niemal dokładnie tyle, ile przewiduje wzór k/(n − 1) = 8/19 = .42 – a w 25.5% prób co najmniej jeden współczynnik był „istotny”. Skorygowane R² (średnio −.005) i test F całego modelu (istotny w 4.5% prób) nie dały się oszukać (zob. R² skorygowane). Green (1991) znalazł pewne poparcie dla reguły N ≥ 50 + 8m przy teście całego modelu, co przy 8 predyktorach daje 114 obserwacji, ale reguła zakłada efekt średniej wielkości.
- Regresja szeregów czasowych z trendem. Dwa niezależne szeregi z trendem stochastycznym (błądzenia losowe, 25 lat) dały w symulacji „istotny” związek w 51.9% prób, przy medianie R² = .17. Przy danych rocznych sprawdź więc trendy i autokorelację reszt.
- Dobór zmiennych metodą krokową. Algorytm wybiera zmienne według przypadkowych cech próby. Zmienne ustal przed analizą na podstawie teorii (zob. metoda krokowa).
Gdy analiza jest gotowa, zobacz, jak może wyglądać przykładowy rozdział wyników z komentarzem i jakie pytania z metodologii i statystyki padają na obronie. Podobny przewodnik dla studentów pedagogiki znajdziesz we wpisie statystyka w pracy z pedagogiki.
Najczęstsze pytania
Jakie analizy statystyczne wybrać do pracy magisterskiej z zarządzania?
Zależy od danych. Przy ankiecie wśród pracowników lub klientów zwykle potrzebujesz rzetelności skal (α i ω), statystyk opisowych, korelacji, regresji wielorakiej ze zmiennymi kontrolnymi, a dla odpowiedzi tak/nie – regresji logistycznej. Przy danych wtórnych, np. z Banku Danych Lokalnych GUS, budujesz model ekonometryczny szacowany MNK i weryfikujesz go testami diagnostycznymi.
Jak przeprowadzić weryfikację modelu ekonometrycznego w pracy licencjackiej?
Sprawdź dopasowanie (R², test F), istotność i znaki współczynników (testy t), normalność reszt (test Jarque–Bera), homoskedastyczność (test Breuscha–Pagana), postać funkcyjną (test RESET) i współliniowość (VIF), a przy szeregach czasowych także autokorelację reszt. Gdy model nie przechodzi testów, popraw specyfikację, np. zlogarytmuj zmienne, albo użyj błędów standardowych HC3.
Jak interpretować współczynnik w modelu log-log?
W modelu log-log współczynnik przy zlogarytmowanej zmiennej to elastyczność: mówi, o ile procent zmienia się zmienna objaśniana, gdy zmienna objaśniająca rośnie o 1%, przy pozostałych zmiennych stałych. Przykładowo elastyczność 1.45 oznacza, że wynagrodzenia wyższe o 10% wiążą się z cenami wyższymi o ok. 14.8%.
Ile obserwacji potrzeba do modelu ekonometrycznego?
Nie ma jednej liczby, ale kilka zmiennych objaśniających przy kilkunastu obserwacjach to przepis na przypadkowe wyniki. W symulacji z 20 obserwacjami i 8 zmiennymi niezwiązanymi z Y średnie R² wynosiło .42, a w co czwartej próbie jakiś współczynnik był „istotny”. Green (1991) proponował dla testu całego modelu regułę N ≥ 50 + 8m, zakładającą efekt średniej wielkości.
Czy z regresji na danych przekrojowych można wnioskować o przyczynach?
Zwykle nie. Model z jednego pomiaru pokazuje związki, które mogą wynikać z pominiętych zmiennych, odwrotnej przyczynowości albo błędu pomiaru, czyli z endogeniczności. W pracy pisz, że zmienna „wiąże się” z wynikiem, a nie że „wpływa” na wynik, i opisz to ograniczenie w dyskusji.
Skąd wziąć dane do modelu ekonometrycznego w pracy?
Podstawowym publicznym źródłem danych regionalnych jest Bank Danych Lokalnych GUS z danymi dla gmin, powiatów, województw i całego kraju, pogrupowanymi m.in. w kategorie rynek pracy, wynagrodzenia i rynek nieruchomości. Inne źródła to sprawozdania finansowe firm i dane udostępnione przez organizację, w której piszesz pracę. Zawsze podaj źródło, jednostkę obserwacji i okres.
Powiązane hasła
Przeczytaj też
Regresja wieloraka krok po kroku
Model i hipotezy, przygotowanie danych, założenia i diagnostyka, ΔR², interpretacja b, β i sr², kod R, SPSS i opis APA – na jednym przykładzie.
Czytaj →PoradnikRegresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →PoradnikStatystyka w pracy z pedagogiki
Ankiety wśród nauczycieli i rodziców: skala Likerta, chi-kwadrat i test Fishera, testy rangowe z korektą Holma, procenty w tabelach i uczniowie w klasach.
Czytaj →Masz ankietę albo dane do modelu ekonometrycznego?
Pomożemy dobrać i wykonać analizę, sprawdzić założenia modelu i omówić wyniki tak, żebyś rozumiał(a) każdą liczbę w swoim rozdziale.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Antonakis, J., Bendahan, S., Jacquart, P., & Lalive, R. (2010). On making causal claims: A review and recommendations. The Leadership Quarterly, 21(6), 1086–1120. https://doi.org/10.1016/j.leaqua.2010.10.010 ● Otwarty dostęp: pełny tekst
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Dunn, T. J., Baguley, T., & Brunsden, V. (2014). From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation. British Journal of Psychology, 105(3), 399–412. https://doi.org/10.1111/bjop.12046 ● Otwarty dostęp: pełny tekst
- Główny Urząd Statystyczny. (b.d.). Bank Danych Lokalnych. Pobrano 16 października 2026 z https://bdl.stat.gov.pl/bdl/start ● Otwarty dostęp
- Green, S. B. (1991). How many subjects does it take to do a regression analysis. Multivariate Behavioral Research, 26(3), 499–510. https://doi.org/10.1207/s15327906mbr2603_7
- Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review, 55(2), 163–172. https://doi.org/10.2307/1403192
- Kim, J. H. (2019). Multicollinearity and misleading statistical results. Korean Journal of Anesthesiology, 72(6), 558–569. https://doi.org/10.4097/kja.19087 ● Otwarty dostęp
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- MacCallum, R. C., Zhang, S., Preacher, K. J., & Rucker, D. D. (2002). On the practice of dichotomization of quantitative variables. Psychological Methods, 7(1), 19–40. https://doi.org/10.1037/1082-989X.7.1.19 ● Otwarty dostęp: pełny tekst
- Podsakoff, P. M., MacKenzie, S. B., Lee, J.-Y., & Podsakoff, N. P. (2003). Common method biases in behavioral research: A critical review of the literature and recommended remedies. Journal of Applied Psychology, 88(5), 879–903. https://doi.org/10.1037/0021-9010.88.5.879
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
- Spector, P. E., & Brannick, M. T. (2011). Methodological urban legends: The misuse of statistical control variables. Organizational Research Methods, 14(2), 287–305. https://doi.org/10.1177/1094428110369842
- Stantcheva, S. (2023). How to run surveys: A guide to creating your own identifying variation and revealing the invisible. Annual Review of Economics, 15(1), 205–234. https://doi.org/10.1146/annurev-economics-091622-010157 ● Otwarty dostęp
- van Smeden, M., de Groot, J. A. H., Moons, K. G. M., Collins, G. S., Altman, D. G., Eijkemans, M. J. C., & Reitsma, J. B. (2016). No rationale for 1 variable per 10 events criterion for binary logistic regression analysis. BMC Medical Research Methodology, 16(1), Article 163. https://doi.org/10.1186/s12874-016-0267-3 ● Otwarty dostęp
Cytowania BibTeX
@article{antonakis2010making, author={Antonakis, John and Bendahan, Samuel and Jacquart, Philippe and Lalive, Rafael}, title={{On making causal claims: A review and recommendations}}, journal={The Leadership Quarterly}, year={2010}, volume={21}, number={6}, pages={1086--1120}, doi={10.1016/j.leaqua.2010.10.010}}@article{breusch1979simple, author={Breusch, T. S. and Pagan, A. R.}, title={{A simple test for heteroscedasticity and random coefficient variation}}, journal={Econometrica}, year={1979}, volume={47}, number={5}, pages={1287--1294}, doi={10.2307/1911963}}@article{dunn2014alpha, author={Dunn, Thomas J. and Baguley, Thom and Brunsden, Vivienne}, title={{From alpha to omega: A practical solution to the pervasive problem of internal consistency estimation}}, journal={British Journal of Psychology}, year={2014}, volume={105}, number={3}, pages={399--412}, doi={10.1111/bjop.12046}}@misc{gusndbdl, author={{Główny Urząd Statystyczny}}, title={{Bank Danych Lokalnych}}, url={https://bdl.stat.gov.pl/bdl/start}}@article{green1991how, author={Green, Samuel B.}, title={{How many subjects does it take to do a regression analysis}}, journal={Multivariate Behavioral Research}, year={1991}, volume={26}, number={3}, pages={499--510}, doi={10.1207/s15327906mbr2603_7}}@article{jarque1987test, author={Jarque, Carlos M. and Bera, Anil K.}, title={{A test for normality of observations and regression residuals}}, journal={International Statistical Review}, year={1987}, volume={55}, number={2}, pages={163--172}, doi={10.2307/1403192}}@article{kim2019multicollinearity, author={Kim, Jong Hae}, title={{Multicollinearity and misleading statistical results}}, journal={Korean Journal of Anesthesiology}, year={2019}, volume={72}, number={6}, pages={558--569}, doi={10.4097/kja.19087}}@article{long2000using, author={Long, J. Scott and Ervin, Laurie H.}, title={{Using heteroscedasticity consistent standard errors in the linear regression model}}, journal={The American Statistician}, year={2000}, volume={54}, number={3}, pages={217--224}, doi={10.1080/00031305.2000.10474549}}@article{maccallum2002practice, author={MacCallum, Robert C. and Zhang, Shaobo and Preacher, Kristopher J. and Rucker, Derek D.}, title={{On the practice of dichotomization of quantitative variables}}, journal={Psychological Methods}, year={2002}, volume={7}, number={1}, pages={19--40}, doi={10.1037/1082-989x.7.1.19}}@article{podsakoff2003common, author={Podsakoff, Philip M. and MacKenzie, Scott B. and Lee, Jeong-Yeon and Podsakoff, Nathan P.}, title={{Common method biases in behavioral research: A critical review of the literature and recommended remedies}}, journal={Journal of Applied Psychology}, year={2003}, volume={88}, number={5}, pages={879--903}, doi={10.1037/0021-9010.88.5.879}}@article{ramsey1969tests, author={Ramsey, J. B.}, title={{Tests for specification errors in classical linear least-squares regression analysis}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1969}, volume={31}, number={2}, pages={350--371}, doi={10.1111/j.2517-6161.1969.tb00796.x}}@article{spector2011methodological, author={Spector, Paul E. and Brannick, Michael T.}, title={{Methodological urban legends: The misuse of statistical control variables}}, journal={Organizational Research Methods}, year={2011}, volume={14}, number={2}, pages={287--305}, doi={10.1177/1094428110369842}}@article{stantcheva2023how, author={Stantcheva, Stefanie}, title={{How to run surveys: A guide to creating your own identifying variation and revealing the invisible}}, journal={Annual Review of Economics}, year={2023}, volume={15}, number={1}, pages={205--234}, doi={10.1146/annurev-economics-091622-010157}}@article{vansmeden2016no, author={van Smeden, Maarten and de Groot, Joris A. H. and Moons, Karel G. M. and Collins, Gary S. and Altman, Douglas G. and Eijkemans, Marinus J. C. and Reitsma, Johannes B.}, title={{No rationale for 1 variable per 10 events criterion for binary logistic regression analysis}}, journal={BMC Medical Research Methodology}, year={2016}, volume={16}, number={1}, eid={163}, doi={10.1186/s12874-016-0267-3}}