Segmentacja respondentów: dwie rodziny metod
Segmentacja respondentów to podział badanych na grupy o podobnym wzorcu wyników, np. pracowników o różnych profilach motywacji albo pacjentów z różnymi zestawami objawów. Korelacja czy regresja pytają o związki między zmiennymi. Segmentacja pyta, jakie typowe konfiguracje wyników występują w próbie i jak często.
Najczęściej używa się dwóch metod. Analiza skupień metodą k-średnich (ang. k-means) dzieli osoby na k grup tak, by suma kwadratów odległości od środków grup była jak najmniejsza. Jej podstawy opisujemy w haśle analiza skupień. Analiza profili latentnych (LPA, ang. latent profile analysis) zakłada, że próba jest mieszaniną kilku podpopulacji, czyli klas zmiennej ukrytej, i daje każdej osobie prawdopodobieństwo przynależności do każdego profilu. To jeden ze sposobów modelowania niejawnej heterogeniczności.
Obie metody zawsze coś znajdą. W danych symulowanych bez żadnych grup k-średnich podzieliło 400 osób na cztery skupienia, a ANOVA dla każdej zmiennej segmentującej dała p < .001. Dlatego poradnik dotyczy głównie decyzji i kontroli: wyboru zmiennych, liczby skupień, stabilności i walidacji. Wszystkie liczby pochodzą z kodu R zamieszczonego niżej.
Przykład: profile motywacji do pracy
Przykład (dane symulowane): 406 pracowników wypełniło kwestionariusz motywacji do pracy oparty na teorii autodeterminacji. Wskaźnikami segmentacji jest pięć skal (średnie z pozycji, 1–7): amotywacja, regulacja zewnętrzna (dla nagród albo z obawy przed karą), introjekowana (z poczucia winy albo dla poczucia własnej wartości), identyfikowana (bo praca jest osobiście ważna) i motywacja wewnętrzna (bo sama praca daje satysfakcję). Zaangażowanie w pracę (1–7) i intencję odejścia (1–5) zostawiamy do walidacji zewnętrznej.
Ponieważ dane są symulowane, znamy prawdę: w populacji są cztery profile – autonomiczni (35%), silnie zmotywowani na wszystkie sposoby (25%), kontrolowani (25%) i zdemotywowani (15%). Możemy więc sprawdzić, jak blisko prawdy dochodzą obie metody. Plik do przećwiczenia analizy: segmentacja-respondentow-dane.csv (kolumna profil_prawdziwy istnieje tylko w danych symulowanych).
Krok 1. Przygotuj dane: zmienne, braki, odstające i skale
Zmienne. Wybieraj je na podstawie teorii, a nie dlatego, że akurat są w ankiecie. Każda zmienna bez struktury grupowej rozmywa skupienia, a zmienne silnie skorelowane dostają większą wagę: u nas regulacja identyfikowana i motywacja wewnętrzna korelują na poziomie r = .82, więc wymiar „motywacji autonomicznej” liczy się w odległości prawie podwójnie. Zmiennych do walidacji nie włączaj do segmentacji.
Braki danych. Dwie osoby z 406 (0.5%) pominęły jedną skalę. Funkcja kmeans() przy brakach zwraca błąd, a Mclust() usuwa niepełne wiersze bez ostrzeżenia (w kodzie funkcji jest na.omit()), więc sprawdzaj liczebność w wyniku. Przy tak małym odsetku usunięcie niepełnych przypadków jest rozsądne, przy większym zaplanuj postępowanie z góry (zob. braki danych MCAR, MAR i MNAR oraz imputacja wielokrotna w R).
Nieuważne odpowiedzi. Cztery osoby zaznaczyły „7” przy wszystkich pozycjach, czyli jednocześnie maksymalną amotywację i maksymalną motywację wewnętrzną. To typowy straightlining (zob. nieuważne odpowiedzi w ankietach online). Usunęliśmy je według reguły zapisanej przed analizą. Gdy zostały w danych, BIC wybrał model z pięcioma profilami, a piąty profil tworzyły dokładnie te cztery osoby.
Wartości odstające. Odległość Mahalanobisa mierzy dystans od jednego środka danych, a segmentacja zakłada, że środków jest kilka. Klasyczna odległość z progiem χ²(5) = 20.52 (p = .001) oznaczyła tylko cztery osoby z samymi „7”. Odporna odległość MCD75, dobra przy jednej populacji (zob. wartości odstające – jak je wykryć), oznaczyła 41 osób, w tym 36 z 60 członków najmniej licznego profilu zdemotywowanych. W danych z kilkoma podgrupami osoba z rzadkiego profilu wygląda jak obserwacja odstająca. Usuwaj więc tylko błędy i nieuważne odpowiedzi, a nietypowość oceniaj w ramach rozwiązania: po odległości od środka własnego skupienia i niskim prawdopodobieństwie przynależności.
Standaryzacja. k-średnich liczy odległość euklidesową, więc zmienna o większej wariancji mocniej wpływa na podział. Przelicz więc wskaźniki na wyniki z (zob. standaryzacja zmiennej). U nas skale mają ten sam zakres, a SD od 1.20 do 1.50, więc podziały na danych surowych i standaryzowanych były prawie zgodne (ARI = .981; skorygowany indeks Randa: 1 to identyczne podziały, 0 – zgodność przypadkowa). Modele LPA z osobną wariancją każdej zmiennej (np. EEI, VVI, EEE, VVV) nie zależą od jednostek: model EEE dał na obu wersjach danych ten sam podział (ARI = 1.000). Wyniki z są względne, więc w tabeli końcowej podaj też średnie w jednostkach skali. Jeśli interesuje Cię sam kształt profilu, a nie jego poziom, rozważ ipsatyzację.
Krok 2. k-średnich w R: wiele startów i wybór liczby skupień
Algorytm k-średnich zaczyna od losowych środków skupień i może utknąć w minimum lokalnym. Przy k = 4 każdy ze 100 pojedynczych startów (nstart = 1) dał tę samą najmniejszą sumę kwadratów wewnątrz skupień (WSS = 575.0), ale przy k = 5 – tylko 65 ze 100. Ustaw więc nstart = 50 lub więcej oraz ziarno losowania i podaj je w opisie metody. Pakiet NbClust (wersja 3.0.1) wywołuje kmeans() z jednym startem, a w SPSS wynik może zależeć od kolejności wierszy (IBM, b.d.).
Liczba skupień to najważniejsza decyzja. Żadne kryterium nie rozstrzyga jej samo, więc porównaj kilka i zapisz z góry, które będą decydujące (zob. plan analizy statystycznej i prerejestracja).
- Łokieć. WSS maleje z każdym skupieniem; szukasz miejsca, po którym spadek wyraźnie słabnie. U nas WSS spada z 1995.0 do 575.0 przy k = 4, a potem tylko do 528.2.
- Sylwetka. Porównuje odległość osoby od własnego skupienia z odległością od najbliższego innego. Najwyższa średnia była przy k = 2 (.405), a k = 4 zajęło drugie miejsce (.373). Dwa skupienia oddzieliły 93 osoby o niskiej motywacji autonomicznej (60 zdemotywowanych i 33 kontrolowanych) od reszty – sylwetka często premiuje taki zgrubny podział.
- Statystyka luki. Tibshirani i in. (2001) porównują spadek rozproszenia wewnątrz skupień ze spadkiem w danych odniesienia bez skupień. Wybierasz najmniejsze k, dla którego Gap(k) ≥ Gap(k + 1) − SE(k + 1). Gap(4) = 0.996, a Gap(5) − SE = 0.984 − 0.020 = 0.964, więc reguła wskazała 4. W
clusGap()ustawd.power = 2– tak liczą autorzy metody, a domyślna wartość w pakiecie cluster to 1. W przeciwieństwie do łokcia i sylwetki statystyka luki może wskazać k = 1, czyli brak skupień. - NbClust. Pakiet liczy 30 wskaźników i proponuje liczbę skupień według „reguły większości” (Charrad i in., 2014). W wariancie
index = "all"cztery skupienia wskazało 11 wskaźników, dwa i trzy – po 5, a jedno, siedem i osiem – po jednym; 2 wskaźniki są graficzne. „Większość” to więc 11 z 24 powiązanych ze sobą wskaźników – traktuj NbClust jako przegląd, nie rozstrzygnięcie.
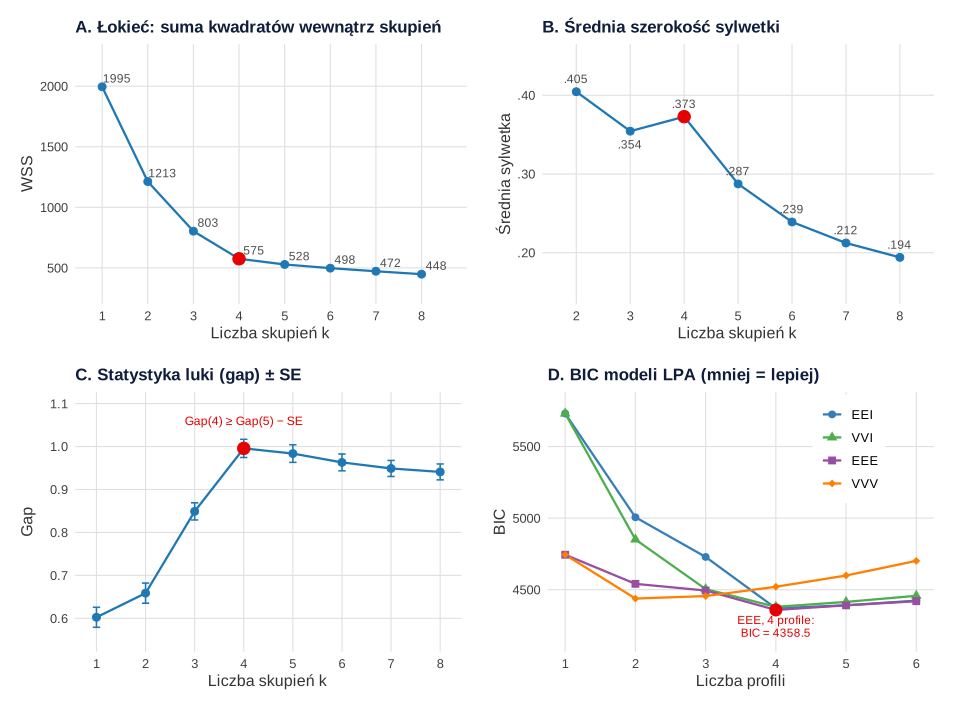
Łokieć, statystyka luki i NbClust wskazały cztery skupienia, a sylwetka – dwa. Rozstrzygają więc stabilność, interpretowalność i zgodność z drugą metodą. Pamiętaj, że moc analizy skupień zależy przede wszystkim od separacji grup: Dalmaijer i in. (2022) zalecają stosować tę metodę, gdy spodziewasz się wyraźnie różnych podgrup, i planować 20–30 osób na podgrupę.
Krok 3. Sprawdź stabilność skupień bootstrapem
Stabilne skupienie nie znika, gdy dane trochę się zmienią. Hennig (2007) proponuje sprawdzać to dla każdego skupienia osobno: wylosuj z powtórzeniami próbę tej samej wielkości i powtórz analizę, a potem dla każdego skupienia wyjściowego znajdź najbardziej podobne skupienie w nowym rozwiązaniu i zapisz współczynnik Jaccarda – liczbę osób wspólnych podzieloną przez liczbę osób w którymkolwiek z dwóch skupień (licząc osoby obecne w obu zbiorach). Wynik uśrednij z wielu powtórzeń. Pojedynczą wartość nie większą niż .50 autor traktuje jako rozpad skupienia, a wartość powyżej około .75 – jako dobre odtworzenie. Zwykle wystarcza 50 powtórzeń, my użyliśmy 200 (przepis 4).
| Liczba skupień | Liczebności skupień | Średni Jaccard | Rozpad (Jaccard ≤ .50) |
|---|---|---|---|
| 2 | 93, 307 | .82, .92 | w żadnej próbie |
| 3 | 194, 69, 137 | .92, .96, .93 | w żadnej próbie |
| 4 | 112, 96, 127, 65 | .97, .97, .98, .98 | w żadnej próbie |
| 5 | 64, 75, 80, 95, 86 | .96, .80, .91, .96, .91 | 9% prób dla skupienia 75-osobowego |
| 6 | 76, 55, 86, 80, 60, 43 | .77, .65, .88, .89, .83, .50 | 64% prób dla skupienia 43-osobowego, 12% dla 55-osobowego |
Wszystkie cztery skupienia były bardzo stabilne, przy pięciu jedno spadło do .80, a przy sześciu dwa nie miały stałej postaci. Stabilność nie dowodzi jednak istnienia skupień: Hennig (2007) zauważa, że mało elastyczna metoda potrafi dawać stabilne, a bezsensowne skupienia. Niska stabilność to sygnał ostrzegawczy, wysoka – tylko warunek konieczny.
Środki czterech skupień w jednostkach z pozwalają je nazwać: zdemotywowani (n = 65), silnie zmotywowani (n = 112), autonomiczni (n = 127) i kontrolowani (n = 96). Profile omawiamy przy LPA (Rysunek 2), bo oba rozwiązania prawie się pokrywają.
Kontrola: co metody „znajdują” w danych bez skupień
Najprostszy test procedury to uruchomienie jej na danych bez grup. Wylosowaliśmy 400 osób z jednego wielowymiarowego rozkładu normalnego o tej samej macierzy korelacji co nasze dane i powtórzyliśmy kluczowe kroki.
| Kryterium | Dane z czterema profilami | Dane bez skupień |
|---|---|---|
| Najwyższa średnia sylwetka | k = 2 (.405) | k = 2 (.292) |
| Statystyka luki (reguła Tibshiraniego i in.) | k = 4 | k = 1 |
| Stabilność czterech skupień (średni Jaccard) | .97–.98 | .56–.75 |
| Najmniejszy BIC, model EEE | 4 profile | 1 profil |
| Najmniejszy BIC, model EEI (bez korelacji wewnątrz profili) | 4 profile | 6 profili (górna granica sprawdzanego zakresu) |
W danych bez skupień k-średnich i tak utworzyło cztery grupy, a ANOVA dla każdej zmiennej segmentującej dała F(3, 396) od 116.49 do 238.71, p < .001. To skutek działania algorytmu, który z definicji maksymalizuje różnice między skupieniami. Dokumentacja SPSS zastrzega, że testy F w procedurze K-Means są tylko opisowe, a ich prawdopodobieństw nie należy interpretować (IBM, b.d.). Testy na zmiennych, z których powstały segmenty, nie weryfikują żadnej hipotezy. To samo dotyczy MANOVA i analizy dyskryminacyjnej na tych samych zmiennych.
„Grup nie ma” potrafiły powiedzieć statystyka luki i BIC w modelu EEE. Sylwetka tego nie potrafi, bo dla k = 1 nie jest określona. BIC modelu EEI, czyli klasycznej LPA bez korelacji wewnątrz profili, malał aż do sześciu profili: model „wyjaśniał” korelacje zmiennych dodatkowymi klasami. Lubke i Neale (2006) pokazali, że gdy współzmienność wynika z ciągłych czynników, a dopasowuje się wyłącznie modele klas, mogą powstać nadmiarowe klasy.
Krok 4. Analiza profili latentnych w pakiecie mclust
LPA to model mieszaniny rozkładów normalnych: każdy profil ma własne średnie, a model zakłada określoną strukturę wariancji i kowariancji wewnątrz profili. Parametry szacuje się metodą największej wiarygodności (algorytmem EM). W R najwygodniej użyć pakietu mclust (Scrucca i in., 2016), który nazywa modele trzema literami dotyczącymi objętości, kształtu i orientacji skupień: E – cecha równa w profilach, V – zmienna, I – zerowe kowariancje. W LPA porównuje się zwykle cztery specyfikacje.
| Model | Wariancje wskaźników | Kowariancje wewnątrz profili | Parametry przy 5 wskaźnikach i 4 profilach |
|---|---|---|---|
| EEI | równe we wszystkich profilach | zerowe (lokalna niezależność; klasyczna LPA) | 28 |
| VVI | różne w profilach | zerowe | 43 |
| EEE | równe we wszystkich profilach | równe we wszystkich profilach | 38 |
| VVV | różne w profilach | różne w profilach | 83 |
Znak BIC. mclust liczy BIC jako 2·logL − k·ln(n) i wybiera wartość największą (Scrucca i in., 2016). W większości artykułów BIC to −2·logL + k·ln(n), a lepszy model ma wartość mniejszą. W tabelach stosuj tę drugą konwencję i napisz o tym w nocie.
Maksima lokalne. mclust startuje algorytm EM od podziałów z hierarchicznego grupowania opartego na modelu, co często daje dobre punkty startowe, ale nie gwarantuje najlepszego rozwiązania (Scrucca i in., 2016). Na 50 losowych startów (hcRandomPairs()) 29 osiągnęło ten sam logarytm wiarygodności co start domyślny (logL = −2065.43), a 21 utknęło w gorszych rozwiązaniach (od −2092.7 do −2312.2). Najlepsza wartość logL powinna powtarzać się w wielu startach.
Krok 5. Ile profili? BIC, BLRT, entropia i najmniejszy profil
Nylund i in. (2007) porównali w symulacjach kryteria wyboru liczby klas: spośród kryteriów informacyjnych najlepiej działał BIC, a bootstrapowy test ilorazu wiarygodności (BLRT) był bardzo spójnym wskaźnikiem liczby klas. Tein i in. (2013) dodają, że moc wszystkich metod zależy od separacji profili, a AIC i entropia słabo wskazywały liczbę klas w każdych warunkach. Decyzję opieraj więc na BIC i BLRT, a entropię i wielkość najmniejszego profilu traktuj jako opis rozwiązania.
Najpierw wybierz specyfikację. Najmniejszy BIC miał model EEE z czterema profilami (4358.54), przed EEI (4370.05) i VVI (4380.07), także z czterema. W bogatym w parametry modelu VVV BIC wskazał dwa profile (4438.19). Trzy specyfikacje zgodnie wskazały więc cztery profile (Rysunek 1D). Wybraliśmy EEE, bo poza najlepszym BIC dopuszcza korelacje wewnątrz profili: regulacja identyfikowana koreluje w nim z motywacją wewnętrzną na poziomie r = .33, a zewnętrzna z introjekowaną – r = .24. Potem ustal liczbę profili w wybranym modelu (Tabela 1).
Tabela 1
Dopasowanie modeli profili latentnych (EEE) z jednym do sześciu profili (N = 400)
| Liczba profili | logL | Parametry | AIC | BIC | SABIC | Entropia | Najmniejszy profil, n (%) | BLRT p |
|---|---|---|---|---|---|---|---|---|
| 1 | −2312.15 | 20 | 4664.31 | 4744.13 | 4680.67 | — | 400 (100.0) | — |
| 2 | −2192.53 | 26 | 4437.06 | 4540.84 | 4458.34 | .973 | 64 (16.0) | .001 |
| 3 | −2151.18 | 32 | 4366.37 | 4494.09 | 4392.55 | .886 | 62 (15.5) | .001 |
| 4a | −2065.43 | 38 | 4206.87 | 4358.54 | 4237.97 | .903 | 62 (15.5) | .001 |
| 5 | −2063.60 | 44 | 4215.19 | 4390.82 | 4251.20 | .827 | 26 (6.5) | .797 |
| 6 | −2060.14 | 50 | 4220.27 | 4419.85 | 4261.19 | .802 | 16 (4.0) | — |
Uwaga. Model EEE: równe wariancje i kowariancje wewnątrz profili; wskaźniki standaryzowane. logL – logarytm wiarygodności; AIC, BIC i SABIC (BIC skorygowane o liczebność próby) w konwencji „mniej = lepiej”. BLRT – bootstrapowy test ilorazu wiarygodności modelu z k profilami względem modelu z k − 1 profilami (999 prób; p = .001 to najmniejsza możliwa wartość); modelu z sześcioma profilami nie testowano. Dane symulowane.
a Model wybrany.
BIC był najmniejszy przy czterech profilach, podobnie jak ICL – wariant BIC z karą za nakładanie się profili (4408.43). BLRT porównuje model z k profilami z modelem z k − 1. Drugi, trzeci i czwarty profil istotnie poprawiły dopasowanie (p = .001), a piąty – nie (LRTS = 3.67, p = .797). Funkcja mclustBootstrapLRT() testuje kolejne liczby profili dla jednego, ustalonego modelu kowariancji.
Entropia wyniosła .903 przy czterech profilach, ale .973 przy dwóch, więc wybór według entropii dałby zbyt prosty model. Najmniejszy profil liczył 62 osoby (15.5%), a przy pięciu i sześciu profilach – 26 (6.5%) i 16 osób (4.0%). Bardzo małe profile są szacowane mało precyzyjnie. Nie ma dla nich uniwersalnego progu: sprawdź, czy taki profil jest stabilny i sensowny teoretycznie i czy nie tworzą go nieuważni respondenci.
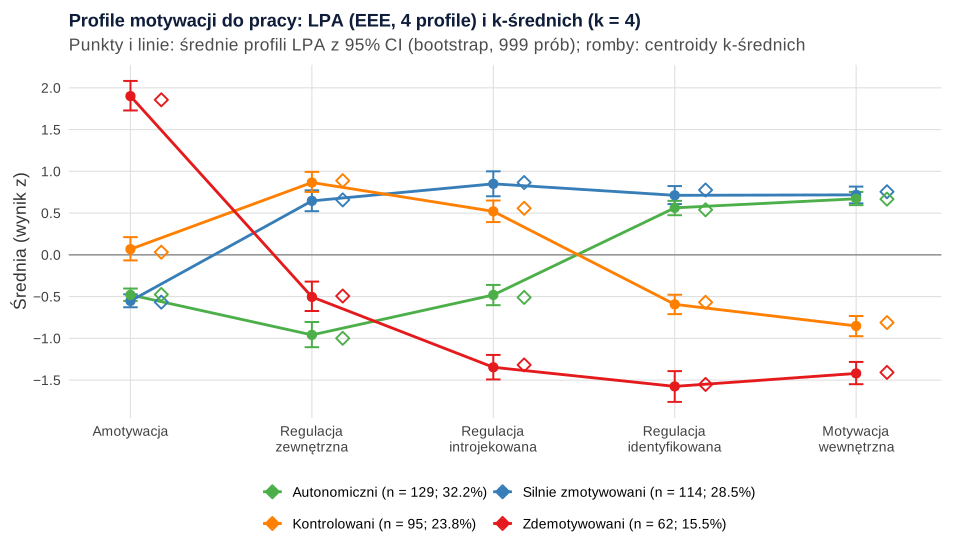
Autonomiczni (n = 129; 32.2%) mają wysoką regulację identyfikowaną i motywację wewnętrzną (0.56 i 0.67 SD powyżej średniej) przy niskiej regulacji zewnętrznej (−0.96). Silnie zmotywowani (n = 114; 28.5%) mają wysokie wyniki we wszystkich formach motywacji (od 0.65 do 0.85). Kontrolowani (n = 95; 23.8%) działają głównie pod presją: regulacja zewnętrzna 0.87, motywacja wewnętrzna −0.85. Zdemotywowani (n = 62; 15.5%) mają amotywację 1.90 SD powyżej średniej i najniższe pozostałe wyniki. Średnie w jednostkach skali są w tabeli 2.
Krok 6. Prawdopodobieństwa przynależności i entropia
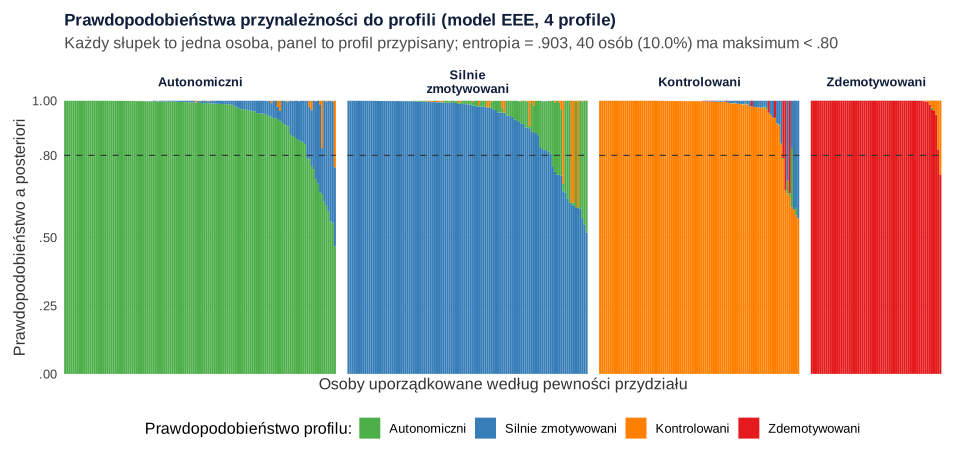
Każda osoba ma w LPA cztery prawdopodobieństwa a posteriori, które sumują się do 1. Do dalszych analiz zwykle przypisuje się ją do profilu z największym prawdopodobieństwem (przydział modalny). Pewność przydziału opisuje entropia względna:
gdzie pik to prawdopodobieństwo, że osoba i należy do profilu k, a K to liczba profili. Wartości bliskie 1 oznaczają pewny przydział. mclust nie podaje entropii, ale policzysz ją jednym wierszem kodu. Drugą miarą są średnie prawdopodobieństwa w grupach przydzielonych do każdego profilu – na przekątnej powinny być wysokie.
| Przydział modalny | Autonomiczni | Silnie zmotywowani | Kontrolowani | Zdemotywowani |
|---|---|---|---|---|
| Autonomiczni (n = 129) | .942 | .054 | .005 | .000 |
| Silnie zmotywowani (n = 114) | .065 | .920 | .016 | .000 |
| Kontrolowani (n = 95) | .004 | .026 | .960 | .011 |
| Zdemotywowani (n = 62) | .000 | .000 | .009 | .990 |
Entropia wyniosła .903. Najsłabiej rozróżniamy autonomicznych i silnie zmotywowanych, którzy różnią się głównie poziomem motywacji kontrolowanej. Mediana największego prawdopodobieństwa wynosi .997, ale 40 osób (10.0%) ma największe prawdopodobieństwo poniżej .80 (Rysunek 3). Przydział modalny traktuje je tak, jakby ich profil był pewny – stąd błąd klasyfikacji, który osłabia różnice w zmiennych zewnętrznych (krok 7).
k-średnich czy LPA? Kiedy którą metodę wybrać
U nas obie metody dały prawie ten sam podział: 392 z 400 osób (98.0%) trafiło do odpowiadających sobie segmentów (ARI = .950), a prawdziwe profile obie odtworzyły podobnie (ARI = .790 dla k-średnich i .777 dla LPA). Różnice pojawiają się, gdy profile mają różne wariancje, zmienne korelują wewnątrz profili albo grupy się nakładają. Steinley i Brusco (2011) pokazali, że modele mieszanin działały najlepiej, gdy struktura kowariancji i liczba skupień były znane; gdy nie były, pogarszały się wyniki i modeli mieszanin, i k-średnich.
| Cecha | k-średnich | LPA (np. mclust) |
|---|---|---|
| Podstawa | Minimalizacja sumy kwadratów odległości od środków skupień | Model mieszaniny rozkładów normalnych z określoną strukturą wariancji i kowariancji |
| Kształt grup | Najlepiej radzi sobie z grupami „kulistymi” o podobnym rozproszeniu | Dopuszcza różne wariancje i korelacje wewnątrz profili (zależnie od modelu) |
| Przynależność | Przydział sztywny | Prawdopodobieństwa a posteriori, entropia |
| Liczba grup | Łokieć, sylwetka, statystyka luki, stabilność | BIC, BLRT, ICL, stabilność |
| Jednostki zmiennych | Wynik zależy od skal – standaryzuj | Modele z osobnymi wariancjami zmiennych nie zależą od skal |
| Główne ryzyka | Minima lokalne, wartości odstające, dobór i ważenie zmiennych | Maksima lokalne, nadmiarowe profile przy nienormalności lub nieuwzględnionych korelacjach |
| Zmienne zewnętrzne | Analiza po przydziale | Także podejścia trzykrokowe z poprawką na błąd klasyfikacji |
Wybierz k-średnich, gdy potrzebujesz szybkiej, opisowej segmentacji dużej próby zmiennych ilościowych. Wybierz LPA, gdy chcesz porównywać modele formalnymi kryteriami, opisać niepewność przydziału i włączać predyktory lub wyniki do analizy. Pamiętaj o dwóch ograniczeniach modeli mieszanin. Bauer i Curran (2003) pokazali w modelach mieszanin wzrostu, że przy nienormalnym rozkładzie model może wskazać kilka klas, choć w populacji jest jedna grupa (zob. jak sprawdzić normalność rozkładu). A jeśli korelacje zmiennych wynikają z ciągłego czynnika, model klas może je „wyjaśnić” nadmiarowymi klasami (Lubke i Neale, 2006). Gdy profile różnią się tylko poziomem („niski”, „średni”, „wysoki”), porównaj LPA z modelem czynnikowym (zob. analiza czynnikowa EFA i CFA).
Krok 7. Walidacja zewnętrzna: czy segmenty coś znaczą?
Segmenty mają wartość, gdy różnią się w zmiennych, których nie użyto do ich utworzenia, i to tak, jak przewiduje teoria. Zapisz te przewidywania przed analizą. Spodziewaliśmy się najwyższego zaangażowania w profilach z wysoką motywacją autonomiczną i najwyższej intencji odejścia u zdemotywowanych.
Tabela 2
Średnie (odchylenia standardowe) wskaźników motywacji i zmiennych walidacyjnych w czterech profilach
| Zmienna | Autonomiczni (n = 129) | Silnie zmotywowani (n = 114) | Kontrolowani (n = 95) | Zdemotywowani (n = 62) | F Welcha | η² |
|---|---|---|---|---|---|---|
| Wskaźniki segmentacji | ||||||
| Amotywacja | 1.75 (0.52) | 1.63 (0.49) | 2.43 (0.76) | 4.66 (0.83) | — | — |
| Regulacja zewnętrzna | 2.99 (0.74) | 5.08 (0.66) | 5.33 (0.72) | 3.59 (0.88) | — | — |
| Regulacja introjekowana | 3.77 (0.71) | 5.42 (0.74) | 5.00 (0.70) | 2.75 (0.74) | — | — |
| Regulacja identyfikowana | 5.63 (0.63) | 5.91 (0.63) | 4.13 (0.69) | 2.82 (0.90) | — | — |
| Motywacja wewnętrzna | 5.56 (0.63) | 5.67 (0.65) | 3.30 (0.79) | 2.43 (0.78) | — | — |
| Zmienne walidacyjne | ||||||
| Zaangażowanie w pracę | 5.09 (0.88) | 5.44 (0.93) | 4.00 (0.89) | 3.00 (0.88) | 126.67 | .49 |
| Intencja odejścia | 2.10 (0.72) | 2.38 (0.81) | 2.97 (0.84) | 3.71 (0.80) | 68.95 | .34 |
Uwaga. N = 400. Skale motywacji i zaangażowania 1–7, intencja odejścia 1–5. Przydział do profilu o największym prawdopodobieństwie a posteriori (model EEE). Dla wskaźników segmentacji nie podajemy testów, bo różnice między profilami wytworzyła sama metoda. F Welcha: df = 3 i 192.92 (zaangażowanie) oraz 3 i 189.62 (intencja odejścia), oba p < .001; wszystkie porównania par z poprawką Holma p ≤ .006. Dane symulowane.
Profile różniły się zaangażowaniem, ANOVA Welcha F(3, 192.92) = 126.67, p < .001, η² = .49, i intencją odejścia, F(3, 189.62) = 68.95, p < .001, η² = .34. Wszystkie porównania par z poprawką Holma były istotne (p ≤ .006). Zgodnie z przewidywaniami najwyższe zaangażowanie mieli silnie zmotywowani (M = 5.44) i autonomiczni (M = 5.09), a najwyższą intencję odejścia – zdemotywowani (M = 3.71). Te testy są uprawnione, bo dotyczą zmiennych spoza segmentacji (zob. ANOVA krok po kroku, testy post hoc i eta kwadrat).
Błąd klasyfikacji osłabia te różnice. Ponieważ znamy prawdziwe profile, widzimy, o ile: η² dla zaangażowania wyniosło .516 przy prawdziwej przynależności i .489 przy przydziale modalnym, a dla intencji odejścia – .355 i .340. Różnica jest mała, bo entropia jest wysoka. Vermunt (2010) przypomina, że klasyczne podejście trzykrokowe (model, przydział, osobna analiza) zaniża związki przynależności z kowariantami, i opisuje dwie poprawki: ważoną (BCH) i opartą na największej wiarygodności. Stosuj je, gdy entropia jest niższa, a profile się nakładają – także wtedy, gdy predyktory przynależności analizujesz wielomianową regresją logistyczną.
Inne formy walidacji to replikacja na drugiej próbie lub połówkach zbioru, zgodność dwóch metod i stabilność.
Jak opisać segmentację w artykule (APA)
Spurk i in. (2020) przejrzeli 46 badań z LPA w psychologii pracy i kariery i sformułowali zalecenia dobrej praktyki. Ferguson i in. (2020) opisują procedurę w sześciu krokach: przegląd danych, iteracyjna ocena modeli, dopasowanie i interpretowalność, analiza wzorców profili, analiza kowariantów i prezentacja wyników. Recenzent będzie szukał w artykule następujących elementów (zob. najczęstsze zarzuty recenzentów do statystyki):
- zmienne segmentujące z uzasadnieniem, standaryzacja i postępowanie z brakami, nieuważnymi odpowiedziami i wartościami odstającymi (z liczbą wykluczonych osób);
- ustawienia: dla k-średnich odległość, liczba startów i ziarno, dla LPA porównane specyfikacje kowariancji i powtarzalność najlepszego logL;
- tabela dopasowania kolejnych modeli (logL, parametry, AIC, BIC, SABIC, entropia, BLRT, najmniejszy profil) z informacją o konwencji BIC;
- uzasadnienie wyboru: kryteria statystyczne, stabilność i interpretowalność;
- profile: liczebności, średnie w jednostkach skali i na skali z, wykres;
- jakość klasyfikacji: entropia i średnie prawdopodobieństwa przynależności;
- walidacja zewnętrzna z wielkościami efektu i opisem, jak uwzględniono błąd klasyfikacji;
- program, wersje pakietów i udostępniony kod (zob. pakiet replikacyjny).
Wzór opisu LPA (metoda i wyniki):
Wzór opisu analizy k-średnich:
Układy tabel znajdziesz we wpisie tabele APA – wzory i przykłady, a zasady zapisu statystyk – w poradniku jak opisać wyniki w stylu APA. Przykładowy raport z analizy skupień k-średnich, z doborem liczby skupień i profilami segmentów, pokazujemy w ofercie analiz statystycznych dla badaczy. Możemy też sprawdzić Twoją segmentację przed wysłaniem artykułu – wyniki musisz jednak rozumieć i umieć ich bronić, a pomoc ujawnić zgodnie z zasadami czasopisma.
Segmentacja w R – pełny kod
Sześć przepisów odtwarza całą analizę, od danych symulowanych po walidację. Uruchamiaj je po kolei w jednej sesji R, bo kolejne przepisy korzystają z obiektów utworzonych wcześniej. Wszystkie liczby w tekście, tabelach i na rysunkach pochodzą z tego kodu; rysunki i kilka liczb pomocniczych (np. przedziały ufności średnich profili) liczy osobny skrypt na tych samych obiektach.
1. Dane symulowane (plik CSV)
R
# Dane symulowane: 406 pracowników, pięć skal motywacji do pracy (średnie z pozycji, 1–7)
# oraz dwie zmienne do walidacji zewnętrznej, których nie używamy do segmentacji
library(MASS)
set.seed(40)
n  <- c("Autonomiczni" = 140, "Kontrolowani" = 100, "Silnie zmotywowani" = 100, "Zdemotywowani" = 60)
mu <- rbind(c(1.7, 3.0, 3.9, 5.7, 5.6),   # kolejno: amotywacja, regulacja zewnętrzna, introjekowana,
            c(2.6, 5.3, 5.1, 4.2, 3.4),   # identyfikowana i motywacja wewnętrzna
            c(1.6, 5.1, 5.4, 5.9, 5.7),
            c(4.6, 3.7, 2.6, 2.8, 2.4))
sdp <- rbind(c(.6, .8, .8, .7, .7), c(.8, .7, .7, .8, .8), c(.6, .7, .7, .6, .6), c(.9, .9, .8, .8, .8))
R <- diag(5); R[2, 3] <- R[3, 2] <- .25; R[4, 5] <- R[5, 4] <- .30   # korelacje wewnątrz profili
X <- do.call(rbind, lapply(1:4, function(k) mvrnorm(n[k], mu[k, ], diag(sdp[k, ]) %*% R %*% diag(sdp[k, ]))))
X <- pmin(pmax(round(X, 2), 1), 7)
colnames(X) <- c("amotyw", "zewn", "introj", "ident", "wewn")
profil_prawdziwy <- rep(names(n), n)                  # znany tylko dlatego, że dane są symulowane
m_zaang <- c(5.2, 3.9, 5.4, 2.9); m_odej <- c(2.0, 3.0, 2.2, 3.8); names(m_zaang) <- names(m_odej) <- names(n)
zaang <- pmin(pmax(round(rnorm(400, m_zaang[profil_prawdziwy], .9), 2), 1), 7)   # zaangażowanie w pracę (1–7)
odej  <- pmin(pmax(round(rnorm(400, m_odej[profil_prawdziwy], .8), 2), 1), 5)    # intencja odejścia (1–5)
dane <- data.frame(profil_prawdziwy, X, zaang, odej)

# cztery osoby zaznaczyły „7” przy wszystkich pozycjach, dwie pominęły jedną skalę
same_7 <- data.frame(profil_prawdziwy = NA, amotyw = 7, zewn = 7, introj = 7, ident = 7, wewn = 7,
                     zaang = round(runif(4, 3, 6), 2), odej = round(runif(4, 1, 4), 2))
braki <- data.frame(profil_prawdziwy = c("Autonomiczni", "Silnie zmotywowani"), amotyw = c(2.10, 1.80),
                    zewn = c(NA, 4.60), introj = c(4.20, 5.10), ident = c(5.50, 6.00), wewn = c(5.10, NA),
                    zaang = c(4.80, 5.20), odej = c(2.40, 1.90))
dane <- rbind(dane, same_7, braki)
dane <- dane[sample(nrow(dane)), ]                    # losowa kolejność wierszy
dane <- data.frame(id = seq_len(nrow(dane)), dane, row.names = NULL)
write.csv(dane, "segmentacja-respondentow-dane.csv", row.names = FALSE, na = "")
str(read.csv("segmentacja-respondentow-dane.csv"))    # kontrola zapisanego pliku
Wynik w R
'data.frame':	406 obs. of  9 variables:
 $ id              : int  1 2 3 4 5 6 7 8 9 10 ...
 $ profil_prawdziwy: chr  "Silnie zmotywowani" "Autonomiczni" "Silnie zmotywowani" "Silnie zmotywowani" ...
 $ amotyw          : num  1.11 1 2.95 2.29 3.51 3.3 1.56 2.14 2.09 3.41 ...
 $ zewn            : num  5.02 1.86 4.25 6.14 4.65 5.46 3.97 5.24 4.51 4.79 ...
 $ introj          : num  5.88 3.26 5.46 4.82 5.15 5.5 3.93 5.48 5.19 5.92 ...
 $ ident           : num  7 5.23 4.79 6.19 4.04 3.79 5.79 4.74 4.01 3.8 ...
 $ wewn            : num  5.39 5.54 4.5 6.07 1.42 2.37 5.51 1.92 3.14 2.78 ...
 $ zaang           : num  4.69 3.37 6.63 6.76 3.47 4.69 5.37 5.34 3.7 3.87 ...
 $ odej            : num  2.08 2.92 1.71 1 2.87 3.35 2.35 1.96 3.45 2.98 ...
2. Przygotowanie danych: braki, straightlining, odległość Mahalanobisa i standaryzacja
R
suppressPackageStartupMessages({library(robustbase); library(cluster); library(NbClust); library(mclust)})
dane <- read.csv("segmentacja-respondentow-dane.csv")
wsk  <- c("amotyw", "zewn", "introj", "ident", "wewn")      # wskaźniki segmentacji
c(N = nrow(dane), z_brakami = sum(!complete.cases(dane[, wsk])))
dane <- dane[complete.cases(dane[, wsk]), ]                  # kmeans() nie przyjmie braków
same_7 <- apply(dane[, wsk], 1, function(v) all(v == 7))     # „7” przy wszystkich pozycjach
sum(same_7)

# odległość Mahalanobisa od JEDNEGO środka danych: klasyczna i odporna (MCD75)
X    <- as.matrix(dane[, wsk])
prog <- qchisq(.999, df = length(wsk))                        # χ²(5) dla p = .001
D2_klas <- mahalanobis(X, colMeans(X), cov(X))
mcd     <- covMcd(X, alpha = .75)
D2_mcd  <- mahalanobis(X, mcd$center, mcd$cov)
round(prog, 2)
table(klasyczna = D2_klas > prog, same_7)
table(MCD75 = D2_mcd > prog, profil = dane$profil_prawdziwy, useNA = "ifany")  # profil znany z symulacji

an <- dane[!same_7, ]                                         # próba analityczna
z  <- scale(an[, wsk])                                        # standaryzacja: wyniki z
nrow(an)
round(rbind(M = colMeans(an[, wsk]), SD = apply(an[, wsk], 2, sd)), 2)
round(cor(an[, wsk]), 2)
Wynik w R
        N z_brakami
      406         2
[1] 4
[1] 20.52
         same_7
klasyczna FALSE TRUE
    FALSE   400    0
    TRUE      0    4
       profil
MCD75       Autonomiczni Kontrolowani Silnie zmotywowani Zdemotywowani
  FALSE   0          140           99                100            24
  TRUE    4            0            1                  0            36
[1] 400
   amotyw zewn introj ident wewn
M    2.33 4.24   4.37  4.92 4.57
SD   1.22 1.27   1.20  1.32 1.50
       amotyw  zewn introj ident  wewn
amotyw   1.00 -0.11  -0.43 -0.67 -0.65
zewn    -0.11  1.00   0.61 -0.03 -0.13
introj  -0.43  0.61   1.00  0.35  0.24
ident   -0.67 -0.03   0.35  1.00  0.82
wewn    -0.65 -0.13   0.24  0.82  1.00
3. k-średnich: starty, łokieć, sylwetka, statystyka luki i NbClust
R
# jeden start algorytmu to loteria: po 100 prób z nstart = 1
for (k in 4:5) {
  wss_1 <- sapply(1:100, function(s) { set.seed(s); kmeans(z, centers = k, nstart = 1)$tot.withinss })
  cat("k =", k, ": najmniejsze WSS =", round(min(wss_1), 1), "osiągnięte w", sum(wss_1 - min(wss_1) < .05), "na 100 startów\n")
}

# łokieć (WSS) i średnia sylwetka dla k = 1–8, po 50 startów
set.seed(2026)
kryteria <- t(sapply(1:8, function(k) {
  km <- kmeans(z, centers = k, nstart = 50, iter.max = 100)
  syl <- if (k > 1) mean(silhouette(km$cluster, dist(z))[, "sil_width"]) else NA
  c(k = k, WSS = km$tot.withinss, sylwetka = syl)
}))
round(kryteria, 3)

# statystyka luki (gap): 100 zbiorów odniesienia; d.power = 2 jak u Tibshiraniego i in. (2001)
set.seed(2026)
luka <- clusGap(z, FUNcluster = function(x, k) kmeans(x, k, nstart = 25, iter.max = 100),
                K.max = 8, B = 100, d.power = 2, verbose = FALSE)
round(luka$Tab[, c("gap", "SE.sim")], 3)
maxSE(luka$Tab[, "gap"], luka$Tab[, "SE.sim"], method = "Tibs2001SEmax")   # najmniejsze k z Gap(k) ≥ Gap(k+1) − SE

# NbClust: 26 wskaźników i „reguła większości” (pakiet liczy kmeans() z jednym startem)
set.seed(2026)
invisible(capture.output(nb <- NbClust(z, distance = "euclidean", min.nc = 2, max.nc = 8,
                                       method = "kmeans", index = "all")))
table(nb$Best.nc["Number_clusters", ])                        # 0 = dwa wskaźniki graficzne

# rozwiązanie z czterema skupieniami i nazwy segmentów według położenia na skali z
set.seed(2026)
km4 <- kmeans(z, centers = 4, nstart = 50, iter.max = 100)
nazwij <- function(m) ifelse(m[, "amotyw"] > 1, "Zdemotywowani",
                      ifelse(m[, "wewn"] < 0, "Kontrolowani",
                      ifelse(m[, "zewn"] > 0, "Silnie zmotywowani", "Autonomiczni")))
segment_km <- nazwij(km4$centers)
data.frame(segment = segment_km, n = km4$size, round(km4$centers, 2))
Wynik w R
k = 4 : najmniejsze WSS = 575 osiągnięte w 100 na 100 startów
k = 5 : najmniejsze WSS = 528.2 osiągnięte w 65 na 100 startów
     k      WSS sylwetka
[1,] 1 1995.000       NA
[2,] 2 1212.563    0.405
[3,] 3  802.876    0.354
[4,] 4  575.034    0.373
[5,] 5  528.152    0.287
[6,] 6  497.772    0.239
[7,] 7  472.057    0.212
[8,] 8  447.870    0.194
       gap SE.sim
[1,] 0.602  0.023
[2,] 0.659  0.023
[3,] 0.849  0.020
[4,] 0.996  0.021
[5,] 0.984  0.020
[6,] 0.963  0.020
[7,] 0.949  0.019
[8,] 0.941  0.018
[1] 4

 0  1  2  3  4  7  8
 2  1  5  5 11  1  1
             segment   n amotyw  zewn introj ident  wewn
1      Zdemotywowani  65   1.86 -0.49  -1.32 -1.55 -1.41
2 Silnie zmotywowani 112  -0.57  0.66   0.87  0.78  0.76
3       Autonomiczni 127  -0.47 -1.00  -0.51  0.54  0.67
4       Kontrolowani  96   0.03  0.89   0.56 -0.57 -0.81
4. Stabilność skupień (bootstrap) i kontrola na danych bez skupień
R
# stabilność każdego skupienia: średni maksymalny współczynnik Jaccarda w próbach bootstrapowych (Hennig, 2007)
stabilnosc <- function(z, k, B = 200) {
  ref <- kmeans(z, k, nstart = 50, iter.max = 100)$cluster
  jac <- matrix(NA, B, k)
  for (b in 1:B) {
    idx  <- sample(nrow(z), replace = TRUE)
    nowe <- kmeans(z[idx, ], k, nstart = 25, iter.max = 100)$cluster
    u <- unique(idx); nowe_u <- nowe[match(u, idx)]          # osoby z próby wyjściowej obecne w losowaniu
    for (c in 1:k) {
      C <- u[ref[u] == c]
      jac[b, c] <- max(sapply(unique(nowe_u), function(d) {
        D <- u[nowe_u == d]; length(intersect(C, D)) / length(union(C, D)) }))
    }
  }
  rbind(n = tabulate(ref, k), Jaccard = colMeans(jac), rozpad = colMeans(jac <= .5))
}
set.seed(2026)
for (k in 2:6) { cat("k =", k, "\n"); print(round(stabilnosc(z, k), 2)) }

# kontrola: dane bez skupień (rozkład normalny, ta sama macierz korelacji, N = 400)
library(MASS)
set.seed(2026)
z0  <- scale(mvrnorm(400, mu = rep(0, 5), Sigma = cor(an[, wsk])))
colnames(z0) <- wsk
km0 <- kmeans(z0, centers = 4, nstart = 50, iter.max = 100)
anova0 <- sapply(wsk, function(v) summary(aov(z0[, v] ~ factor(km0$cluster)))[[1]][1, c("F value", "Pr(>F)")])
round(matrix(unlist(anova0), 2, dimnames = list(c("F", "p"), wsk)), 4)       # „istotne różnice” bez grup
round(sapply(2:6, function(k) mean(silhouette(kmeans(z0, k, nstart = 50)$cluster, dist(z0))[, "sil_width"])), 3)
luka0 <- clusGap(z0, FUNcluster = function(x, k) kmeans(x, k, nstart = 25, iter.max = 100),
                 K.max = 8, B = 100, d.power = 2, verbose = FALSE)
maxSE(luka0$Tab[, "gap"], luka0$Tab[, "SE.sim"], method = "Tibs2001SEmax")
round(stabilnosc(z0, 4), 2)
bic0 <- mclustBIC(z0, G = 1:6, modelNames = c("EEI", "VVI", "EEE", "VVV"), verbose = FALSE)
round(-cbind(EEI = bic0[, "EEI"], EEE = bic0[, "EEE"]), 1)    # BIC w konwencji „mniej = lepiej”
Wynik w R
k = 2
         [,1]   [,2]
n       93.00 307.00
Jaccard  0.82   0.92
rozpad   0.00   0.00
k = 3
          [,1]  [,2]   [,3]
n       194.00 69.00 137.00
Jaccard   0.92  0.96   0.93
rozpad    0.00  0.00   0.00
k = 4
          [,1]  [,2]   [,3]  [,4]
n       112.00 96.00 127.00 65.00
Jaccard   0.97  0.97   0.98  0.98
rozpad    0.00  0.00   0.00  0.00
k = 5
         [,1]  [,2]  [,3]  [,4]  [,5]
n       64.00 75.00 80.00 95.00 86.00
Jaccard  0.96  0.80  0.91  0.96  0.91
rozpad   0.00  0.09  0.00  0.00  0.00
k = 6
         [,1]  [,2]  [,3]  [,4]  [,5]  [,6]
n       76.00 55.00 86.00 80.00 60.00 43.00
Jaccard  0.77  0.65  0.88  0.89  0.83  0.50
rozpad   0.08  0.12  0.00  0.01  0.06  0.64
    amotyw     zewn   introj    ident     wewn
F 152.0515 116.4933 128.5116 238.7071 232.2316
p   0.0000   0.0000   0.0000   0.0000   0.0000
[1] 0.292 0.256 0.247 0.228 0.220
[1] 1
          [,1]  [,2]   [,3]  [,4]
n       137.00 94.00 125.00 44.00
Jaccard   0.72  0.75   0.69  0.56
rozpad    0.11  0.23   0.27  0.49
     EEI    EEE
1 5730.7 4714.1
2 5318.5 4748.9
3 5179.7 4760.6
4 5111.2 4784.3
5 5034.2 4816.1
6 5005.0 4829.8
5. Analiza profili latentnych w mclust: BIC, BLRT, starty, entropia i prawdopodobieństwa
R
# cztery typowe specyfikacje LPA, od 1 do 6 profili; mclust podaje BIC = 2LL − k·ln(n), więc większy = lepszy
modele <- c("EEI", "VVI", "EEE", "VVV")
bic <- mclustBIC(z, G = 1:6, modelNames = modele, verbose = FALSE)
round(-sapply(modele, function(m) bic[, m]), 2)              # konwencja artykułów: mniej = lepiej

entropia <- function(p) 1 - sum(-p * log(pmax(p, 1e-300))) / (nrow(p) * log(ncol(p)))
dopasowanie <- t(sapply(1:6, function(g) {
  f <- Mclust(z, G = g, modelNames = "EEE", verbose = FALSE)
  LL <- f$loglik; k <- f$df; n <- f$n
  c(G = g, LL = LL, parametry = k, AIC = -2 * LL + 2 * k, BIC = -2 * LL + k * log(n),
    SABIC = -2 * LL + k * log((n + 2) / 24), ICL = -unname(f$icl),
    entropia = if (g > 1) entropia(f$z) else NA, min_n = min(tabulate(f$classification, g)))
}))
round(dopasowanie, 3)

# bootstrapowy test ilorazu wiarygodności (BLRT): k − 1 vs k profili w modelu EEE
set.seed(2026)
blrt <- mclustBootstrapLRT(z, modelName = "EEE", nboot = 999, maxG = 4, verbose = FALSE)
blrt

# model końcowy i kontrola maksimów lokalnych: 50 losowych startów algorytmu EM
lpa <- Mclust(z, G = 4, modelNames = "EEE", verbose = FALSE)
ll  <- sapply(1:50, function(s) Mclust(z, G = 4, modelNames = "EEE", verbose = FALSE,
              initialization = list(hcPairs = hcRandomPairs(z, seed = s)))$loglik)
round(lpa$loglik, 2); table(round(ll, 1))

# profile, jakość klasyfikacji i zgodność z k-średnich
profil <- nazwij(t(lpa$parameters$mean))
data.frame(profil, n = tabulate(lpa$classification), proporcja = round(lpa$parameters$pro, 3),
           round(t(lpa$parameters$mean), 2))
round(entropia(lpa$z), 3)
P <- t(sapply(1:4, function(k) colMeans(lpa$z[lpa$classification == k, ])))   # średnie prawdopodobieństwa a posteriori
dimnames(P) <- list(przydzial = profil, profil = profil); round(P, 3)
c(max_ponizej_80 = sum(apply(lpa$z, 1, max) < .80), mediana_max = round(median(apply(lpa$z, 1, max)), 3))
table(LPA = profil[lpa$classification], k_srednich = segment_km[km4$cluster])
round(c(ARI_LPA_km = adjustedRandIndex(lpa$classification, km4$cluster),
        ARI_LPA_prawda = adjustedRandIndex(lpa$classification, an$profil_prawdziwy),
        ARI_km_prawda = adjustedRandIndex(km4$cluster, an$profil_prawdziwy)), 3)

# LPA nie zależy od skali zmiennych, k-średnich – tak
set.seed(2026)
round(c(LPA_surowe_vs_z = adjustedRandIndex(Mclust(an[, wsk], G = 4, modelNames = "EEE", verbose = FALSE)$classification,
                                            lpa$classification),
        km_surowe_vs_z  = adjustedRandIndex(kmeans(an[, wsk], 4, nstart = 50, iter.max = 100)$cluster, km4$cluster)), 3)

# co by się stało, gdyby cztery osoby z samymi „7” zostały w danych?
f404 <- Mclust(scale(dane[, wsk]), G = 1:6, modelNames = modele, verbose = FALSE)
paste0(f404$modelName, ", G = ", f404$G); table(profil = f404$classification, same_7)
Wynik w R
      EEI     VVI     EEE     VVV
1 5730.66 5730.66 4744.13 4744.13
2 5005.91 4850.68 4540.84 4438.19
3 4728.78 4504.10 4494.09 4455.55
4 4370.05 4380.07 4358.54 4520.62
5 4391.21 4414.83 4390.82 4599.15
6 4423.53 4457.60 4419.85 4701.44
     G        LL parametry      AIC      BIC    SABIC      ICL entropia min_n
[1,] 1 -2312.153        20 4664.305 4744.135 4680.673 4744.135       NA   400
[2,] 2 -2192.530        26 4437.060 4540.838 4458.338 4546.959    0.973    64
[3,] 3 -2151.183        32 4366.365 4494.092 4392.554 4540.774    0.886    62
[4,] 4 -2065.434        38 4206.868 4358.544 4237.967 4408.432    0.903    62
[5,] 5 -2063.597        44 4215.194 4390.818 4251.203 4504.822    0.827    26
[6,] 6 -2060.137        50 4220.273 4419.846 4261.193 4565.295    0.802    16
-------------------------------------------------------------
Bootstrap sequential LRT for the number of mixture components
-------------------------------------------------------------
Model        = EEE
Replications = 999
               LRTS bootstrap p-value
1 vs 2   239.245728             0.001
2 vs 3    82.694189             0.001
3 vs 4   171.497051             0.001
4 vs 5     3.674721             0.797
[1] -2065.43

-2312.2 -2312.1 -2207.7 -2148.8 -2148.7 -2105.2 -2094.1 -2092.7 -2065.4
      9       6       1       1       1       1       1       1      29
              profil   n proporcja amotyw  zewn introj ident  wewn
1 Silnie zmotywowani 114     0.286  -0.55  0.65   0.85  0.71  0.72
2       Autonomiczni 129     0.323  -0.48 -0.96  -0.48  0.56  0.67
3       Kontrolowani  95     0.235   0.07  0.87   0.52 -0.59 -0.85
4      Zdemotywowani  62     0.156   1.90 -0.50  -1.35 -1.58 -1.42
[1] 0.903
                    profil
przydzial            Silnie zmotywowani Autonomiczni Kontrolowani Zdemotywowani
  Silnie zmotywowani              0.920        0.065        0.016         0.000
  Autonomiczni                    0.054        0.942        0.005         0.000
  Kontrolowani                    0.026        0.004        0.960         0.011
  Zdemotywowani                   0.000        0.000        0.009         0.990
max_ponizej_80    mediana_max
        40.000          0.997
                    k_srednich
LPA                  Autonomiczni Kontrolowani Silnie zmotywowani Zdemotywowani
  Autonomiczni                127            1                  1             0
  Kontrolowani                  0           92                  0             3
  Silnie zmotywowani            0            3                111             0
  Zdemotywowani                 0            0                  0            62
    ARI_LPA_km ARI_LPA_prawda  ARI_km_prawda
         0.950          0.777          0.790
LPA_surowe_vs_z  km_surowe_vs_z
          1.000           0.981
[1] "EEE, G = 5"
      same_7
profil FALSE TRUE
     1   114    0
     2   129    0
     3    95    0
     4    62    0
     5     0    4
6. Walidacja zewnętrzna profili
R
# walidacja zewnętrzna: zmienne, których nie użyto do segmentacji
kolejnosc <- c("Autonomiczni", "Silnie zmotywowani", "Kontrolowani", "Zdemotywowani")
an$profil <- factor(profil[lpa$classification], levels = kolejnosc)
aggregate(cbind(amotyw, zewn, introj, ident, wewn) ~ profil, data = an, FUN = function(x) round(mean(x), 2))
eta2 <- function(y, g) { a <- anova(lm(y ~ g)); a[1, 2] / sum(a[, 2]) }
for (y in c("zaang", "odej")) {
  cat("\n==", y, "\n")
  print(round(rbind(M = tapply(an[[y]], an$profil, mean), SD = tapply(an[[y]], an$profil, sd)), 2))
  print(oneway.test(an[[y]] ~ an$profil))                    # ANOVA Welcha
  print(pairwise.t.test(an[[y]], an$profil, pool.sd = FALSE, p.adjust.method = "holm"))
  print(round(c(eta2_LPA = eta2(an[[y]], an$profil),
                eta2_prawdziwe = eta2(an[[y]], factor(an$profil_prawdziwy))), 3))   # wpływ błędu klasyfikacji
}
Wynik w R
              profil amotyw zewn introj ident wewn
1       Autonomiczni   1.75 2.99   3.77  5.63 5.56
2 Silnie zmotywowani   1.63 5.08   5.42  5.91 5.67
3       Kontrolowani   2.43 5.33   5.00  4.13 3.30
4      Zdemotywowani   4.66 3.59   2.75  2.82 2.43

== zaang
   Autonomiczni Silnie zmotywowani Kontrolowani Zdemotywowani
M          5.09               5.44         4.00          3.00
SD         0.88               0.93         0.89          0.88

	One-way analysis of means (not assuming equal variances)

data:  an[[y]] and an$profil
F = 126.67, num df = 3.00, denom df = 192.92, p-value < 2.2e-16


	Pairwise comparisons using t tests with non-pooled SD

data:  an[[y]] and an$profil

                   Autonomiczni Silnie zmotywowani Kontrolowani
Silnie zmotywowani 0.0033       -                  -
Kontrolowani       2.3e-16      < 2e-16            -
Zdemotywowani      < 2e-16      < 2e-16            3.1e-10

P value adjustment method: holm
      eta2_LPA eta2_prawdziwe
         0.489          0.516

== odej
   Autonomiczni Silnie zmotywowani Kontrolowani Zdemotywowani
M          2.10               2.38         2.97          3.71
SD         0.72               0.81         0.84          0.80

	One-way analysis of means (not assuming equal variances)

data:  an[[y]] and an$profil
F = 68.949, num df = 3.00, denom df = 189.62, p-value < 2.2e-16


	Pairwise comparisons using t tests with non-pooled SD

data:  an[[y]] and an$profil

                   Autonomiczni Silnie zmotywowani Kontrolowani
Silnie zmotywowani 0.0058       -                  -
Kontrolowani       4.0e-13      1.4e-06            -
Zdemotywowani      < 2e-16      < 2e-16            3.5e-07

P value adjustment method: holm
      eta2_LPA eta2_prawdziwe
         0.340          0.355
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- mclust (wersja 6.1.2): Scrucca, L., Fraley, C., Murphy, T. B., & Raftery, A. E. (2023). Model-based clustering, classification, and density estimation using mclust in R. Chapman and Hall/CRC. https://doi.org/10.1201/9781003277965
- cluster (wersja 2.1.8.2): Maechler, M., Rousseeuw, P., Struyf, A., Hubert, M., & Hornik, K. (2026). cluster: Cluster analysis basics and extensions (R package version 2.1.8.2) [Computer software]. https://CRAN.R-project.org/package=cluster
- NbClust (wersja 3.0.1): Charrad, M., Ghazzali, N., Boiteau, V., & Niknafs, A. (2014). NbClust: An R package for determining the relevant number of clusters in a data set. Journal of Statistical Software, 61(6), 1–36. https://doi.org/10.18637/jss.v061.i06
- robustbase (wersja 0.99-7): Maechler, M., Rousseeuw, P., Croux, C., Todorov, V., Ruckstuhl, A., Salibian-Barrera, M., Verbeke, T., Koller, M., Conceicao, E. L., & Anna di Palma, M. (2026). robustbase: Basic robust statistics [R package]. http://robustbase.r-forge.r-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://www.stats.ox.ac.uk/pub/MASS4/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Segmentacja w SPSS: K-Means Cluster i TwoStep Cluster
Podręcznik IBM SPSS Statistics Base 31 opisuje trzy procedury analizy skupień: TwoStep, hierarchiczną i k-średnich (IBM, b.d.). Analizy profili latentnych w nim nie ma, więc LPA wykonasz w R. Etykiety podajemy w angielskiej wersji programu (zob. IBM SPSS Statistics).
- K-Means Cluster: Analyze → Classify → K-Means Cluster… Procedura liczy prostą odległość euklidesową, więc najpierw zapisz wyniki z. Podaj liczbę skupień i metodę Iterate and classify. W oknie Save zaznacz Cluster membership i Distance from cluster center, a w Options wybierz postępowanie z brakami (Exclude cases listwise albo pairwise). Testy F w tabeli ANOVA są tylko opisowe. Domyślny wybór początkowych środków zależy od kolejności przypadków, dlatego IBM radzi porównać rozwiązania przy różnej, losowej kolejności wierszy – to odpowiednik wielu startów.
- TwoStep Cluster: Analyze → Classify → TwoStep Cluster… Przyjmuje zmienne ilościowe i jakościowe, a liczbę skupień może wybrać sama (Determine automatically) według BIC albo AIC. Odległość Log-likelihood zakłada niezależność zmiennych, normalność zmiennych ciągłych i rozkład wielomianowy jakościowych; według wewnętrznych testów IBM procedura jest dość odporna na naruszenia tych założeń. Wynik może zależeć od kolejności przypadków. Opcja Evaluation fields opisuje skupienia zmiennymi, których nie użyto do ich utworzenia.
Najczęstsze błędy
- Testy na zmiennych segmentujących jako „potwierdzenie” segmentów. W danych bez skupień ANOVA dała F do 238.71 i p < .001.
- Jedno kryterium liczby skupień. Sylwetka wskazała dwa skupienia, a łokieć, statystyka luki, NbClust i BIC – cztery.
- Jeden start algorytmu. Przy k = 5 aż 35 ze 100 pojedynczych startów k-średnich skończyło się gorszym podziałem, a 21 z 50 losowych startów EM – gorszym logL.
- Usuwanie „odstających” odległością od jednego środka danych. Odporna odległość MCD oznaczyła 36 z 60 osób z najmniej licznego profilu.
- Wybór liczby profili według entropii. Była wyższa dla dwóch profili (.973) niż dla czterech (.903); słabo wskazuje liczbę klas (Tein i in., 2013).
- Klasyczna LPA (EEI) bez porównania z modelami z kowariancjami. W danych bez skupień jej BIC malał aż do sześciu profili.
- Przydział modalny bez słowa o błędzie klasyfikacji. Zaniża związki z innymi zmiennymi (Vermunt, 2010).
- Profile jako naturalne typy ludzi. Segmenty opisują układ danych w próbie; ich istnienie w populacji wymaga replikacji.
Najczęstsze pytania
Czym analiza profili latentnych różni się od analizy skupień k-średnich?
k-średnich dzieli osoby sztywno, minimalizując sumę kwadratów odległości od środków skupień, i najlepiej działa przy podobnych, „kulistych” grupach. Analiza profili latentnych (LPA) to model mieszaniny rozkładów normalnych: daje każdej osobie prawdopodobieństwa przynależności, dopuszcza różne wariancje i korelacje wewnątrz profili i pozwala porównywać modele kryterium BIC i testem BLRT. W przykładzie z tego poradnika obie metody przypisały do odpowiadających sobie segmentów 392 z 400 osób.
Ile profili wybrać w analizie profili latentnych (LPA)?
Porównaj modele z kolejną liczbą profili i kilkoma strukturami kowariancji. Decyzję opieraj głównie na BIC (w konwencji „mniej = lepiej”) i bootstrapowym teście ilorazu wiarygodności (BLRT), które najlepiej wypadły w symulacjach Nylund i in. (2007), a dodatkowo na interpretowalności i wielkości najmniejszego profilu. W przykładzie BIC był najmniejszy dla czterech profili (4358.54), a BLRT nie poparł piątego (p = .797).
Jak zrobić analizę profili latentnych w R?
Najprościej pakietem mclust: mclustBIC(z, G = 1:6, modelNames = c("EEI", "VVI", "EEE", "VVV")) porówna modele, Mclust() oszacuje wybrany, a mclustBootstrapLRT() wykona test BLRT. Entropię policzysz sam z macierzy prawdopodobieństw $z. Pamiętaj, że mclust podaje BIC ze znakiem przeciwnym niż większość artykułów (większy = lepszy).
Co oznacza entropia w analizie profili latentnych?
Entropia (od 0 do 1) mówi, jak pewnie model przypisuje osoby do profili: wartości bliskie 1 oznaczają mało przypadków niejednoznacznych. Nie używaj jej do wyboru liczby profili – w symulacjach słabo wskazywała liczbę klas (Tein i in., 2013), a w przykładzie z tego poradnika była wyższa dla dwóch profili (.973) niż dla czterech (.903). Niska entropia to sygnał, by zmienne zewnętrzne analizować metodami trzykrokowymi z poprawką na błąd klasyfikacji.
Czy ANOVA na zmiennych użytych do segmentacji potwierdza trafność segmentów?
Nie. Algorytm sam maksymalizuje różnice między skupieniami w tych zmiennych, więc testy zawsze wyjdą istotne – w danych bez żadnych grup ANOVA dała w przykładzie F do 238.71 i p < .001. Dokumentacja SPSS zaznacza, że testy F w procedurze K-Means są tylko opisowe. Trafność segmentów sprawdzaj na zmiennych, których nie użyto do segmentacji, oraz przez stabilność i replikację.
Czy analizę profili latentnych można zrobić w SPSS?
Podręcznik IBM SPSS Statistics Base 31 opisuje trzy procedury analizy skupień: TwoStep, hierarchiczną i K-Means, ale nie zawiera analizy profili latentnych. TwoStep sam wybiera liczbę skupień według BIC albo AIC, lecz nie porównuje struktur kowariancji i nie ma testu BLRT. LPA wykonasz w R, np. w pakiecie mclust.
Powiązane hasła
Przeczytaj też
Wartości odstające: jak je wykryć i co z nimi zrobić
Reguły ustalone z góry, MAD zamiast ±3 SD, Mahalanobis i MCD, odległość Cooka, winsoryzacja, test Yuena, analiza wrażliwości i opis APA – z kodem R.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA: jak dobrać metodę i uniknąć błędów
EFA i CFA w praktyce: liczba czynników, metoda ekstrakcji, rotacja, ładunki, walidacja oraz najczęstsze błędy w analizie czynnikowej.
Czytaj →PoradnikZarzuty recenzentów do statystyki
Piętnaście typowych uwag recenzentów do analiz – jak brzmią, skąd się biorą i jak im zapobiec, z symulacjami w R i listą kontrolną przed wysłaniem.
Czytaj →Segmentujesz respondentów do artykułu?
Pomożemy dobrać metodę, porównać rozwiązania k-średnich i LPA, sprawdzić stabilność profili oraz przygotować tabele i opis wyników do publikacji.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Bauer, D. J., & Curran, P. J. (2003). Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes. Psychological Methods, 8(3), 338–363. https://doi.org/10.1037/1082-989X.8.3.338
- Charrad, M., Ghazzali, N., Boiteau, V., & Niknafs, A. (2014). NbClust: An R package for determining the relevant number of clusters in a data set. Journal of Statistical Software, 61(6), 1–36. https://doi.org/10.18637/jss.v061.i06 ● Otwarty dostęp
- Dalmaijer, E. S., Nord, C. L., & Astle, D. E. (2022). Statistical power for cluster analysis. BMC Bioinformatics, 23(1), Article 205. https://doi.org/10.1186/s12859-022-04675-1 ● Otwarty dostęp
- Ferguson, S. L., Moore, E. W. G., & Hull, D. M. (2020). Finding latent groups in observed data: A primer on latent profile analysis in Mplus for applied researchers. International Journal of Behavioral Development, 44(5), 458–468. https://doi.org/10.1177/0165025419881721
- Hennig, C. (2007). Cluster-wise assessment of cluster stability. Computational Statistics & Data Analysis, 52(1), 258–271. https://doi.org/10.1016/j.csda.2006.11.025
- IBM. (b.d.). IBM SPSS Statistics Base 31. Pobrano 16 października 2026 z https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Base.pdf ● Otwarty dostęp
- Lubke, G., & Neale, M. C. (2006). Distinguishing between latent classes and continuous factors: Resolution by maximum likelihood? Multivariate Behavioral Research, 41(4), 499–532. https://doi.org/10.1207/s15327906mbr4104_4
- Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling: A Multidisciplinary Journal, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
- Scrucca, L., Fop, M., Murphy, T. B., & Raftery, A. E. (2016). mclust 5: Clustering, classification and density estimation using Gaussian finite mixture models. The R Journal, 8(1), 289–317. https://doi.org/10.32614/RJ-2016-021 ● Otwarty dostęp
- Spurk, D., Hirschi, A., Wang, M., Valero, D., & Kauffeld, S. (2020). Latent profile analysis: A review and “how to” guide of its application within vocational behavior research. Journal of Vocational Behavior, 120, Article 103445. https://doi.org/10.1016/j.jvb.2020.103445 ● Otwarty dostęp
- Steinley, D., & Brusco, M. J. (2011). Evaluating mixture modeling for clustering: Recommendations and cautions. Psychological Methods, 16(1), 63–79. https://doi.org/10.1037/a0022673
- Tein, J.-Y., Coxe, S., & Cham, H. (2013). Statistical power to detect the correct number of classes in latent profile analysis. Structural Equation Modeling: A Multidisciplinary Journal, 20(4), 640–657. https://doi.org/10.1080/10705511.2013.824781 ● Otwarty dostęp: pełny tekst
- Tibshirani, R., Walther, G., & Hastie, T. (2001). Estimating the number of clusters in a data set via the gap statistic. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 63(2), 411–423. https://doi.org/10.1111/1467-9868.00293
- Vermunt, J. K. (2010). Latent class modeling with covariates: Two improved three-step approaches. Political Analysis, 18(4), 450–469. https://doi.org/10.1093/pan/mpq025
Cytowania BibTeX
@article{bauer2003distributional, author={Bauer, Daniel J. and Curran, Patrick J.}, title={{Distributional assumptions of growth mixture models: Implications for overextraction of latent trajectory classes}}, journal={Psychological Methods}, year={2003}, volume={8}, number={3}, pages={338--363}, doi={10.1037/1082-989x.8.3.338}}@article{charrad2014nbclust, author={Charrad, Malika and Ghazzali, Nadia and Boiteau, Véronique and Niknafs, Azam}, title={{NbClust: An R package for determining the relevant number of clusters in a data set}}, journal={Journal of Statistical Software}, year={2014}, volume={61}, number={6}, pages={1--36}, doi={10.18637/jss.v061.i06}}@article{dalmaijer2022statistical, author={Dalmaijer, Edwin S. and Nord, Camilla L. and Astle, Duncan E.}, title={{Statistical power for cluster analysis}}, journal={BMC Bioinformatics}, year={2022}, volume={23}, number={1}, eid={205}, doi={10.1186/s12859-022-04675-1}}@article{ferguson2020finding, author={Ferguson, Sarah L. and Moore, E. Whitney G. and Hull, Darrell M.}, title={{Finding latent groups in observed data: A primer on latent profile analysis in Mplus for applied researchers}}, journal={International Journal of Behavioral Development}, year={2020}, volume={44}, number={5}, pages={458--468}, doi={10.1177/0165025419881721}}@article{hennig2007cluster, author={Hennig, Christian}, title={{Cluster-wise assessment of cluster stability}}, journal={Computational Statistics \& Data Analysis}, year={2007}, volume={52}, number={1}, pages={258--271}, doi={10.1016/j.csda.2006.11.025}}@misc{ibmspssbase31, author={{IBM}}, title={{IBM SPSS Statistics Base 31}}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/pdf/IBM_SPSS_Statistics_Base.pdf}}@article{lubke2006distinguishing, author={Lubke, Gitta and Neale, Michael C.}, title={{Distinguishing between latent classes and continuous factors: Resolution by maximum likelihood?}}, journal={Multivariate Behavioral Research}, year={2006}, volume={41}, number={4}, pages={499--532}, doi={10.1207/s15327906mbr4104_4}}@article{nylund2007deciding, author={Nylund, Karen L. and Asparouhov, Tihomir and Muthén, Bengt O.}, title={{Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2007}, volume={14}, number={4}, pages={535--569}, doi={10.1080/10705510701575396}}@article{scrucca2016mclust, author={Scrucca, Luca and Fop, Michael and Murphy, T. Brendan and Raftery, Adrian E.}, title={{mclust 5: Clustering, classification and density estimation using Gaussian finite mixture models}}, journal={The R Journal}, year={2016}, volume={8}, number={1}, pages={289--317}, doi={10.32614/rj-2016-021}}@article{spurk2020latent, author={Spurk, Daniel and Hirschi, Andreas and Wang, Mo and Valero, Domingo and Kauffeld, Simone}, title={{Latent profile analysis: A review and “how to” guide of its application within vocational behavior research}}, journal={Journal of Vocational Behavior}, year={2020}, volume={120}, eid={103445}, doi={10.1016/j.jvb.2020.103445}}@article{steinley2011evaluating, author={Steinley, Douglas and Brusco, Michael J.}, title={{Evaluating mixture modeling for clustering: Recommendations and cautions}}, journal={Psychological Methods}, year={2011}, volume={16}, number={1}, pages={63--79}, doi={10.1037/a0022673}}@article{tein2013statistical, author={Tein, Jenn-Yun and Coxe, Stefany and Cham, Heining}, title={{Statistical power to detect the correct number of classes in latent profile analysis}}, journal={Structural Equation Modeling: A Multidisciplinary Journal}, year={2013}, volume={20}, number={4}, pages={640--657}, doi={10.1080/10705511.2013.824781}}@article{tibshirani2001estimating, author={Tibshirani, Robert and Walther, Guenther and Hastie, Trevor}, title={{Estimating the number of clusters in a data set via the gap statistic}}, journal={Journal of the Royal Statistical Society: Series B (Statistical Methodology)}, year={2001}, volume={63}, number={2}, pages={411--423}, doi={10.1111/1467-9868.00293}}@article{vermunt2010latent, author={Vermunt, Jeroen K.}, title={{Latent class modeling with covariates: Two improved three-step approaches}}, journal={Political Analysis}, year={2010}, volume={18}, number={4}, pages={450--469}, doi={10.1093/pan/mpq025}}