Co to jest kowariancja?
Kowariancja (ang. covariance) mierzy, czy dwie zmienne odchylają się od swoich średnich w tym samym kierunku. Jest dodatnia, gdy osoby z wynikiem powyżej średniej w jednej zmiennej mają zwykle wynik powyżej średniej także w drugiej. Jest ujemna, gdy wynikom powyżej średniej w jednej zmiennej towarzyszą wyniki poniżej średniej w drugiej. Wartość bliska zera oznacza brak liniowej współzmienności.
Kowariancja to „surowy” odpowiednik korelacji: niesie tę samą informację o kierunku związku, ale wyraża ją w jednostkach obu zmiennych naraz, np. w godzinach × punktach. Dlatego trudno ocenić, czy kowariancja równa 2.57 jest duża, a łatwo – czy korelacja równa .75 jest silna. Szczególnym przypadkiem kowariancji jest wariancja: to kowariancja zmiennej z samą sobą.
Wzór na kowariancję
- xi − x̄ i yi − ȳ – odchylenia wyniku osoby od średniej w każdej zmiennej,
- iloczyn odchyleń – dodatni, gdy osoba leży po tej samej stronie obu średnich, ujemny, gdy po przeciwnych,
- n − 1 – mianownik dla próby; kowariancję w populacji liczy się z mianownikiem N.
Kowariancja to więc niemal średnia iloczynów odchyleń – w próbie sumę dzieli się przez n − 1, a nie przez n. Duże odchylenia w obu zmiennych dają duże iloczyny, dlatego najwięcej do kowariancji wnoszą osoby skrajne – i dlatego jest ona, podobnie jak r Pearsona, wrażliwa na obserwacje odstające.
Przykład krok po kroku: sen i uwaga
Ośmioro studentów podało, ile godzin śpi przeciętnie w ciągu doby, i rozwiązało test uwagi (0–20 punktów). Średnie wynoszą 7 godzin i 12 punktów. Tabela pokazuje obliczenia:
| Osoba | Sen (h) | Uwaga (pkt) | x − x̄ | y − ȳ | Iloczyn |
|---|---|---|---|---|---|
| 1 | 5.0 | 8 | −2.0 | −4 | 8.0 |
| 2 | 5.5 | 11 | −1.5 | −1 | 1.5 |
| 3 | 6.5 | 13 | −0.5 | 1 | −0.5 |
| 4 | 6.5 | 10 | −0.5 | −2 | 1.0 |
| 5 | 7.5 | 11 | 0.5 | −1 | −0.5 |
| 6 | 7.5 | 15 | 0.5 | 3 | 1.5 |
| 7 | 8.0 | 14 | 1.0 | 2 | 2.0 |
| 8 | 9.5 | 14 | 2.5 | 2 | 5.0 |
| Suma | 0 | 0 | 18.0 |
Sześć iloczynów jest dodatnich, a dwa – osób 3 i 5 – ujemne: osoba 3 śpi krócej niż przeciętnie, a ma wynik powyżej średniej. Najwięcej wnoszą osoby 1 i 8, które leżą najdalej od średnich w obu zmiennych. Rysunek 1 pokazuje te iloczyny jako prostokąty.
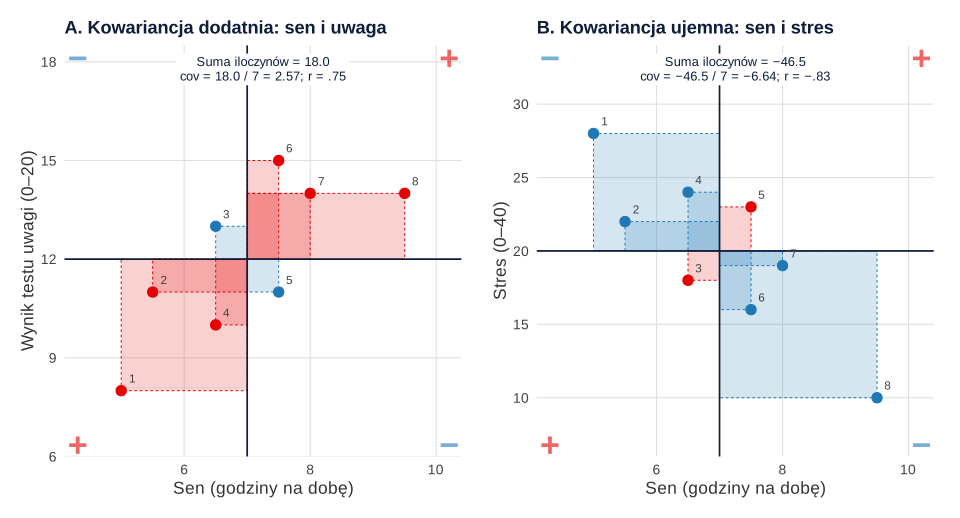
W panelu B ci sami studenci mają też wynik w skali stresu (0–40). Tu przeważają prostokąty niebieskie: osoby, które śpią dłużej, zgłaszają zwykle mniejszy stres. Suma iloczynów wynosi −46.5, a kowariancja −46.5 / 7 = −6.64.
Problem jednostek: od kowariancji do korelacji
Gdyby sen zapisać w minutach, a nie w godzinach, kowariancja wzrosłaby 60 razy – do 154.29 – choć związek snu z uwagą się nie zmienił. Z tego powodu wielkości kowariancji nie da się porównywać między parami zmiennych mierzonych na różnych skalach. Rozwiązaniem jest standaryzacja: podzielenie kowariancji przez iloczyn odchyleń standardowych obu zmiennych.
Wynik nie zależy od jednostek: dla snu w minutach r również wynosi .75. To samo daje kowariancja zmiennych przekształconych na wyniki z, bo po standaryzacji obie zmienne mają odchylenie standardowe równe 1. Ujęcie korelacji jako standaryzowanej kowariancji to jeden z 13 zapisów współczynnika Pearsona, które zebrali Rodgers i Nicewander (1988); szczegóły znajdziesz w haśle korelacja Pearsona. W przykładzie r(6) = .75, 95% CI [.09, .95], p = .033 – przy ośmiu osobach przedział ufności jest bardzo szeroki.
Macierz kowariancji i jej zastosowania
Gdy zmiennych jest więcej, kowariancje zbiera się w macierzy kowariancji: na przekątnej leżą wariancje, a poza nią kowariancje każdej pary. Macierz jest symetryczna, bo cov(X, Y) = cov(Y, X). Dla trzech zmiennych z przykładu:
| Sen | Uwaga | Stres | |
|---|---|---|---|
| Sen | 2.071 | 2.571 | −6.643 |
| Uwaga | .747 | 5.714 | −11.571 |
| Stres | −.835 | −.875 | 30.571 |
Pogrubione liczby to wariancje, nad przekątną są kowariancje, a pod nią – dla porównania – odpowiadające im korelacje. Macierz kowariancji to punkt wyjścia wielu metod:
- Modelowanie równań strukturalnych i CFA. SEM i konfirmacyjna analiza czynnikowa szacują parametry tak, by macierz kowariancji odtworzona z modelu była jak najbliższa macierzy z próby. Miary dopasowania opisują różnicę między nimi, a jej szczegóły pokazują reszty standaryzowane. Wytyczne raportowania takich analiz zebrali Schreiber i in. (2006), a standardy APA dla badań ilościowych mają osobny moduł dla SEM (Appelbaum i in., 2018). W pracy warto zamieścić macierz korelacji z odchyleniami standardowymi albo macierz kowariancji – wtedy inni mogą odtworzyć model.
- Odległość Mahalanobisa. Ocenia, jak nietypowe jest połączenie wyników osoby, i korzysta z odwrotności macierzy kowariancji – dzięki temu bierze pod uwagę, że zmienne są ze sobą powiązane (zob. odległość Mahalanobisa).
- Wariancja sumy wyników. Var(X + Y) = Var(X) + Var(Y) + 2 Cov(X, Y). Fisher (1919) zauważył, że gdy działają dwie niezależne przyczyny zmienności, ich wariancje się sumują. Gdy zmienne kowariują, do sumy dochodzi składnik 2 Cov(X, Y). W skali kwestionariuszowej wariancja wyniku ogólnego to suma wariancji pozycji i podwojonych kowariancji między nimi; na tej zależności opiera się alfa Cronbacha.
- Analiza głównych składowych i analiza czynnikowa rozkładają macierz kowariancji albo korelacji (zob. PCA).
Nie myl kowariancji z kowariantem w ANCOVA. Kowariant (zmienna towarzysząca) to zmienna kontrolowana w modelu, np. wynik pretestu, a nie miara współzmienności.
Jak raportować kowariancję
W tekście wyników zwykle podaje się korelację, a nie kowariancję. Kowariancje pojawiają się w tabelach dla analiz wielozmiennowych (SEM, CFA) i w materiałach uzupełniających. Wzór zdania i noty do tabeli:
Zasady zapisu korelacji i gotowy wzór tabeli znajdziesz w hasłach korelacja i tabela korelacji w APA.
Kowariancja w R
Kod odtwarza tabelę iloczynów odchyleń, liczy kowariancję funkcją cov(), pokazuje problem jednostek, standaryzację do r, macierz kowariancji, wzór na wariancję sumy i odległość Mahalanobisa. Liczby w tekście i na rysunku 1 pochodzą z tego kodu (funkcje bazowe R).
Kowariancja krok po kroku i macierz kowariancji
R
# Dane przykładowe: 8 studentów – sen (godziny na dobę), wynik testu uwagi (0–20) i stres (0–40)
dane <- data.frame(osoba = 1:8,
                   sen   = c(5.0, 5.5, 6.5, 6.5, 7.5, 7.5, 8.0, 9.5),
                   uwaga = c(8, 11, 13, 10, 11, 15, 14, 14),
                   stres = c(28, 22, 18, 24, 23, 16, 19, 10))

# 1. Kowariancja krok po kroku: odchylenia od średnich i ich iloczyny
dane$dx <- dane$sen - mean(dane$sen)
dane$dy <- dane$uwaga - mean(dane$uwaga)
dane$iloczyn <- dane$dx * dane$dy
dane[, c("osoba", "sen", "uwaga", "dx", "dy", "iloczyn")]
sum(dane$iloczyn)                                   # suma iloczynów odchyleń
sum(dane$iloczyn) / (nrow(dane) - 1)                # kowariancja z próby (mianownik n − 1)
cov(dane$sen, dane$uwaga)                           # to samo funkcją cov()

# 2. Problem jednostek: sen w minutach zamiast w godzinach
cov(dane$sen * 60, dane$uwaga)                      # kowariancja rośnie 60 razy
c(godziny = cor(dane$sen, dane$uwaga), minuty = cor(dane$sen * 60, dane$uwaga))   # r bez zmian

# 3. Standaryzacja: r = cov / (SD_x × SD_y) = kowariancja wyników z
cov(dane$sen, dane$uwaga) / (sd(dane$sen) * sd(dane$uwaga))
cov(scale(dane$sen), scale(dane$uwaga))
cor.test(dane$sen, dane$uwaga)                      # r z 95% CI i testem (n = 8)

# 4. Macierz kowariancji i macierz korelacji
S <- cov(dane[, c("sen", "uwaga", "stres")])
round(S, 3)
round(cov2cor(S), 3)

# 5. Wariancja sumy: Var(X + Y) = Var(X) + Var(Y) + 2 Cov(X, Y)
c(bezposrednio = var(dane$uwaga + dane$stres),
  ze_wzoru = var(dane$uwaga) + var(dane$stres) + 2 * cov(dane$uwaga, dane$stres))

# 6. Odległość Mahalanobisa: jak nietypowe jest połączenie wyników osoby (używa odwrotności S)
round(mahalanobis(dane[, c("sen", "uwaga", "stres")], colMeans(dane[, c("sen", "uwaga", "stres")]), S), 2)
Wynik w R
  osoba sen uwaga   dx dy iloczyn
1     1 5.0     8 -2.0 -4     8.0
2     2 5.5    11 -1.5 -1     1.5
3     3 6.5    13 -0.5  1    -0.5
4     4 6.5    10 -0.5 -2     1.0
5     5 7.5    11  0.5 -1    -0.5
6     6 7.5    15  0.5  3     1.5
7     7 8.0    14  1.0  2     2.0
8     8 9.5    14  2.5  2     5.0
[1] 18
[1] 2.571429
[1] 2.571429
[1] 154.2857
  godziny    minuty
0.7474093 0.7474093
[1] 0.7474093
          [,1]
[1,] 0.7474093

	Pearson's product-moment correlation

data:  dane$sen and dane$uwaga
t = 2.7557, df = 6, p-value = 0.03304
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.09029052 0.95113782
sample estimates:
      cor
0.7474093

         sen   uwaga   stres
sen    2.071   2.571  -6.643
uwaga  2.571   5.714 -11.571
stres -6.643 -11.571  30.571
         sen  uwaga  stres
sen    1.000  0.747 -0.835
uwaga  0.747  1.000 -0.875
stres -0.835 -0.875  1.000
bezposrednio     ze_wzoru
    13.14286     13.14286
[1] 2.88 1.95 1.60 0.94 2.41 2.48 2.82 5.92
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe); rysunek przygotowano w pakietach ggplot2 i patchwork.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Ocenianie siły związku po wielkości kowariancji. Kowariancja 154.29 i 2.57 opisują w przykładzie dokładnie ten sam związek – o sile mówi dopiero r.
- Porównywanie kowariancji par zmiennych mierzonych na różnych skalach – najpierw je wystandaryzuj.
- Utożsamianie zerowej kowariancji z niezależnością. Kowariancja wykrywa tylko współzmienność liniową; zależność w kształcie litery U może dać wartość bliską zera.
- Mieszanie mianowników n − 1 i N. Funkcja
cov()w R i procedury SPSS liczą kowariancję z próby (n − 1), a niektóre funkcje arkuszy kalkulacyjnych – kowariancję populacyjną (N). Przy małych próbach różnica jest wyraźna. - Kowariancja liczona bez obejrzenia danych. Jedna skrajna osoba może zdominować sumę iloczynów; sprawdź wykres rozrzutu.
- Mylenie kowariancji z kowariantem w analizie kowariancji (ANCOVA).
Najczęstsze pytania
Co to jest kowariancja?
Kowariancja mierzy, czy dwie zmienne odchylają się od swoich średnich w tym samym kierunku. Jest dodatnia, gdy wynikom powyżej średniej w jednej zmiennej towarzyszą zwykle wyniki powyżej średniej w drugiej, ujemna – gdy wyniki idą w przeciwnych kierunkach, a bliska zera – gdy nie ma liniowej współzmienności.
Jak obliczyć kowariancję?
Od każdego wyniku odejmij średnią jego zmiennej, pomnóż odchylenia obu zmiennych dla każdej osoby, zsumuj iloczyny i podziel przez n − 1. W przykładzie ośmiu studentów suma iloczynów wyniosła 18.0, więc kowariancja = 18.0 / 7 = 2.57. W R: cov(x, y).
Czym się różni kowariancja od korelacji?
Kowariancja zależy od jednostek obu zmiennych – po zamianie godzin na minuty wzrasta 60 razy, choć związek się nie zmienia. Korelacja to kowariancja podzielona przez iloczyn odchyleń standardowych, więc nie ma jednostek, mieści się między −1 a +1 i pozwala porównywać siłę różnych związków. Zob. korelacja.
Co to jest macierz kowariancji?
To tabela, w której na przekątnej leżą wariancje zmiennych, a poza nią kowariancje wszystkich par. Macierz jest symetryczna. Korzystają z niej m.in. modele SEM i konfirmacyjna analiza czynnikowa, analiza głównych składowych i odległość Mahalanobisa.
Czy kowariancja może być większa niż 1?
Tak. Kowariancja nie ma górnej granicy – jej wartość zależy od jednostek i rozproszenia zmiennych. Ograniczona do przedziału od −1 do +1 jest dopiero korelacja, czyli kowariancja wystandaryzowana.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Modelowanie równań strukturalnych (SEM)
Model pomiarowy i strukturalny, rodzaje modeli SEM, CB-SEM czy PLS-SEM, symulacja w R i etapy analizy od teorii do raportu.
Czytaj →PoradnikAlfa Cronbacha – rzetelność skali
Założenia alfy, analiza pozycji, „alfa po usunięciu pozycji” bez pułapek, tau-równoważność i omega McDonalda – z danymi i kodem R.
Czytaj →PoradnikAnaliza czynnikowa EFA i CFA
EFA czy CFA, analiza równoległa, rotacja oblimin a varimax, przejście od EFA do CFA na nowej próbie, WLSMV i opis APA – z danymi i kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. https://doi.org/10.1037/amp0000191 ● Otwarty dostęp
- Fisher, R. A. (1919). The correlation between relatives on the supposition of Mendelian inheritance. Transactions of the Royal Society of Edinburgh, 52(2), 399–433. https://doi.org/10.1017/S0080456800012163
- Rodgers, J. L., & Nicewander, W. A. (1988). Thirteen ways to look at the correlation coefficient. The American Statistician, 42(1), 59–66. https://doi.org/10.1080/00031305.1988.10475524
- Schreiber, J. B., Nora, A., Stage, F. K., Barlow, E. A., & King, J. (2006). Reporting structural equation modeling and confirmatory factor analysis results: A review. The Journal of Educational Research, 99(6), 323–338. https://doi.org/10.3200/joer.99.6.323-338
Cytowania BibTeX
@article{appelbaum2018journal, author={Appelbaum, Mark and Cooper, Harris and Kline, Rex B. and Mayo-Wilson, Evan and Nezu, Arthur M. and Rao, Stephen M.}, title={{Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report}}, journal={American Psychologist}, year={2018}, volume={73}, number={1}, pages={3--25}, doi={10.1037/amp0000191}}@article{fisher1919correlation, author={Fisher, R. A.}, title={{The correlation between relatives on the supposition of Mendelian inheritance}}, journal={Transactions of the Royal Society of Edinburgh}, year={1919}, volume={52}, number={2}, pages={399--433}, doi={10.1017/s0080456800012163}}@article{rodgers1988thirteen, author={Rodgers, Joseph Lee and Nicewander, W. Alan}, title={{Thirteen ways to look at the correlation coefficient}}, journal={The American Statistician}, year={1988}, volume={42}, number={1}, pages={59--66}, doi={10.1080/00031305.1988.10475524}}@article{schreiber2006reporting, author={Schreiber, James B. and Nora, Amaury and Stage, Frances K. and Barlow, Elizabeth A. and King, Jamie}, title={{Reporting structural equation modeling and confirmatory factor analysis results: A review}}, journal={The Journal of Educational Research}, year={2006}, volume={99}, number={6}, pages={323--338}, doi={10.3200/joer.99.6.323-338}}