Co to jest analiza skupień?
Analiza skupień (ang. cluster analysis, klasteryzacja) to grupa metod, które dzielą obserwacje – najczęściej osoby – na grupy zwane skupieniami tak, by osoby w jednym skupieniu były do siebie podobne, a osoby z różnych skupień jak najbardziej się różniły. Przynależność do grup nie jest znana z góry: metoda sama szuka struktury w danych, dlatego zalicza się ją do metod eksploracyjnych i do narzędzi data miningu (uczenie bez nadzoru). Klasycznym wprowadzeniem do tych metod jest podręcznik Kaufmana i Rousseeuwa (1990), a przeglądem – podręcznik Everitta i in. (2011).
W psychologii analizę skupień stosuje się do tworzenia typologii i profili: studentów o różnych wzorcach motywacji, pacjentów z różnymi zestawami objawów, konsumentów o odmiennych postawach. Warto odróżnić ją od dwóch pokrewnych metod. Analiza głównych składowych i analiza czynnikowa grupują zmienne, a analiza skupień – osoby. Z kolei analiza dyskryminacyjna zakłada, że grupy są znane, i szuka zmiennych, które je najlepiej rozróżniają.
Metoda k-średnich a metody hierarchiczne
Najczęściej używane są dwie rodziny metod:
- Metoda k-średnich (ang. k-means). Ustalasz liczbę skupień k. Algorytm losuje k punktów startowych, przypisuje każdą osobę do najbliższego środka skupienia (centroidu), przelicza centroidy jako średnie i powtarza te kroki, aż przydział przestanie się zmieniać. Minimalizuje w ten sposób sumę kwadratów odległości osób od centroidów (WSS, ang. within-cluster sum of squares).
- Metody hierarchiczne aglomeracyjne. Na początku każda osoba tworzy osobne skupienie; w kolejnych krokach łączy się dwa najbliższe skupienia, aż powstanie jedno. Wynik ilustruje dendrogram, który „przecina się” na wybranej wysokości. Najpopularniejsza jest metoda Warda, która łączy skupienia dające najmniejszy przyrost sumy kwadratów wewnątrz skupień.
| Cecha | k-średnich | Hierarchiczna (np. Warda) |
|---|---|---|
| Liczba skupień | Trzeba podać z góry | Wybierasz po fakcie, na podstawie dendrogramu |
| Duże próby | Szybka | Wolniejsza, wymaga macierzy odległości wszystkich par osób |
| Stabilność | Wynik zależy od punktów startowych – uruchom wiele startów | Wynik jednoznaczny, ale raz połączonych skupień nie da się już rozdzielić |
| Wrażliwość | Na obserwacje odstające i skale zmiennych | Zależy od wybranej miary odległości i sposobu łączenia |
W praktyce obie metody się uzupełniają: metodą Warda możesz wstępnie ocenić liczbę skupień, a metodą k-średnich dopracować podział. Zgodność obu rozwiązań jest jednym z argumentów, że skupienia nie są artefaktem algorytmu.
Standaryzacja i wybór zmiennych
Analiza skupień opiera się na odległościach między osobami, najczęściej euklidesowych. Odległość zależy od jednostek: zmienna o dużej wariancji zdominuje wynik. W naszym przykładzie wariancja lęku egzaminacyjnego (skala 20–80) była 102.9 razy większa niż wariancja motywacji (skala 1–7). Dlatego przed analizą wykonaj standaryzację zmiennych do wyników z (średnia 0, odchylenie standardowe 1). W symulacji znamy prawdziwe profile, więc mogliśmy to sprawdzić: na danych standaryzowanych zgodność podziału z prawdziwymi profilami wyniosła ARI = .847, a na surowych – tylko .441, bo różnice w motywacji „zginęły” w szumie lęku.
Równie ważny jest dobór zmiennych. Do analizy włącz tylko te, które mają znaczenie dla pytania badawczego. Każda dodatkowa zmienna bez struktury grupowej rozmywa skupienia, a kilka silnie skorelowanych zmiennych mierzących to samo dostaje w odległości podwójną wagę.
Ile skupień? Metoda łokcia i sylwetka
Liczba skupień to najważniejsza i najtrudniejsza decyzja. Najczęściej łączy się dwa kryteria:
- Metoda łokcia – wykres sumy kwadratów wewnątrz skupień (WSS) dla kolejnych k. WSS zawsze maleje, gdy dodajesz skupienia; szukasz miejsca, po którym spadek wyraźnie słabnie.
- Średnia szerokość sylwetki (ang. silhouette). Dla każdej osoby porównuje się średnią odległość od jej skupienia (a) ze średnią odległością od najbliższego innego skupienia (b).
Sylwetka przyjmuje wartości od −1 do 1. Wartości bliskie 1 oznaczają osobę dobrze dopasowaną do swojego skupienia, bliskie 0 – osobę na granicy dwóch skupień, a ujemne – osobę bliższą innemu skupieniu. Wybierasz k z najwyższą średnią sylwetką.
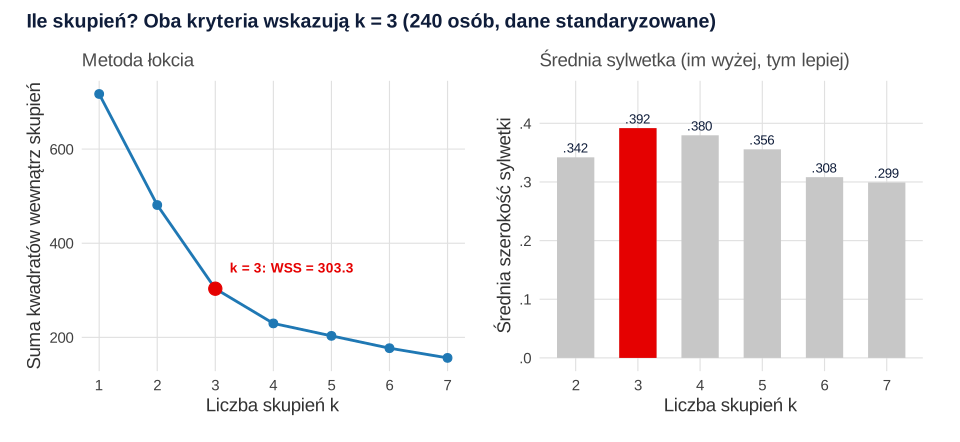
W przykładzie WSS spada z 717.0 (jedno skupienie) do 481.1, 303.3 i 229.6, a dalej już niewiele. Najwyższą średnią sylwetkę ma rozwiązanie z trzema skupieniami (.392), choć rozwiązanie z czterema jest niewiele gorsze (.380). W takiej sytuacji decyduje też interpretowalność: czy dodatkowe skupienie wnosi nowy, sensowny profil, czy tylko dzieli istniejący na pół.
Przykład: profile studentów na trzech skalach
240 studentów wypełniło skale motywacji do nauki (1–7), prokrastynacji (16–64) i lęku egzaminacyjnego (20–80) (dane symulowane). Po standaryzacji przeprowadziliśmy analizę metodą k-średnich z 25 losowymi startami i wybraliśmy trzy skupienia. Średnie w jednostkach skal przedstawia tabela.
| Skupienie | n | Motywacja (1–7) | Prokrastynacja (16–64) | Lęk (20–80) |
|---|---|---|---|---|
| Zaangażowani | 100 | 5.85 | 27.62 | 33.84 |
| Zalęknieni | 80 | 5.47 | 29.51 | 61.07 |
| Zniechęceni | 60 | 3.00 | 35.56 | 40.48 |
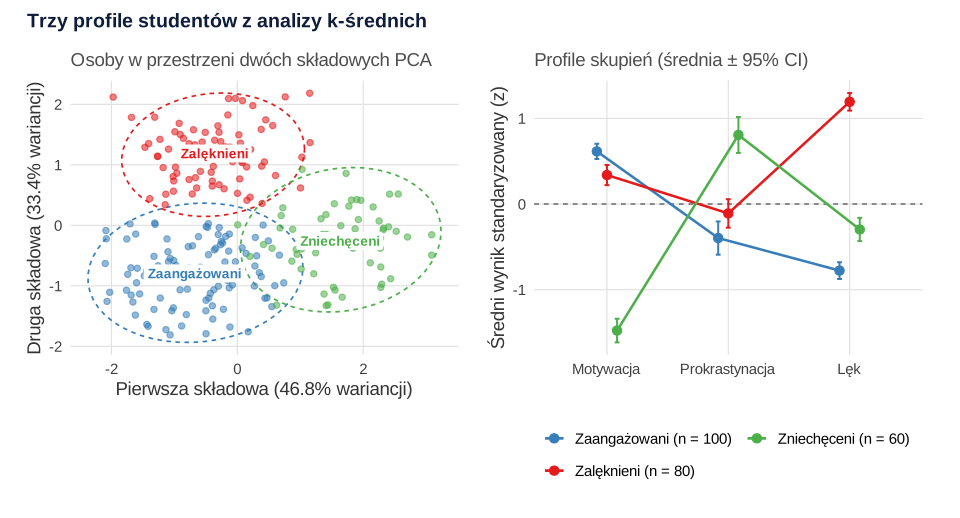
Profile łatwo nazwać. Zaangażowani (n = 100) mają wysoką motywację i niski lęk. Zalęknieni (n = 80) są równie zmotywowani, ale ich lęk egzaminacyjny jest o 1.19 odchylenia standardowego wyższy od średniej. Zniechęceni (n = 60) mają motywację o 1.48 odchylenia standardowego niższą od średniej i najwyższą prokrastynację. Wykres PCA pokazuje, że skupienia są wyraźne, ale częściowo zachodzą na siebie – zgodnie ze średnią sylwetką .392; ujemną sylwetkę miały tylko 2 osoby (0.8%).
Wynik sprawdziliśmy na dwa sposoby. Metoda Warda przypisała do odpowiadających sobie skupień 229 z 240 osób (95.4%; ARI = .870). Skorygowany indeks Randa (ARI) mierzy zgodność dwóch podziałów: 1 oznacza zgodność pełną, 0 – zgodność na poziomie przypadku. Następnie powtórzyliśmy analizę na 200 próbach bootstrapowych: średnia zgodność z rozwiązaniem wyjściowym wyniosła ARI = .971, a najniższa – .773. Rozwiązanie jest więc stabilne, a nie przypadkowe.
Liczebność próby i separacja skupień
Analiza skupień zawsze zwróci jakiś podział – także w danych, w których żadnych grup nie ma. Dalmaijer i in. (2022) pokazali w symulacjach, że moc analizy skupień zależy przede wszystkim od separacji podgrup, czyli od tego, jak bardzo się różnią, a nie od zwiększania liczebności ponad wystarczające N. Autorzy zalecają stosować tę metodę tylko wtedy, gdy oczekuje się dużej separacji, planować 20–30 osób na podgrupę i rozważyć klasteryzację rozmytą lub modele mieszanin. W naszym przykładzie najmniejsze skupienie liczy 60 osób, a profile różnią się o ponad jedno odchylenie standardowe na kluczowych skalach.
Ważna jest też przejrzystość. Clatworthy i in. (2005) przejrzeli 59 artykułów z 18 czasopism psychologii zdrowia i stwierdzili, że tylko 27% spełniało wszystkie pięć kryteriów rzetelnego raportowania analizy skupień. Opisz więc w pracy zmienne, standaryzację, miarę odległości, metodę, kryteria wyboru k i sprawdzenie trafności rozwiązania.
Jak opisać analizę skupień w pracy (APA)
Jeśli skupienia mają potem służyć jako zmienna grupująca w dalszych analizach, opisz to w rozdziale metodologicznym razem z innymi decyzjami analitycznymi (zob. statystyka do pracy magisterskiej).
Analiza skupień w R
Kod tworzy zbiór z przykładu (dane symulowane), standaryzuje zmienne, porównuje rozwiązania od jednego do siedmiu skupień, wykonuje analizę k-średnich i metodą Warda oraz sprawdza zgodność i stabilność podziału. Liczby w tekście i na rysunkach pochodzą z tego kodu. W R potrzebujesz tylko pakietu cluster (funkcje kmeans() i hclust() są w podstawowej instalacji).
k-średnich, metoda Warda, sylwetka i stabilność
R
library(cluster)   # silhouette()

# Dane symulowane: 240 studentów, trzy skale w różnych jednostkach, trzy profile
set.seed(46)
profil <- data.frame(n = c(100, 80, 60),                  # zaangażowani, zalęknieni, zniechęceni
                     motywacja = c(5.9, 5.5, 3.0),        # motywacja do nauki, 1–7
                     prokrastynacja = c(27, 29, 36),      # skala prokrastynacji, 16–64
                     lek = c(35, 60, 40))                 # lęk egzaminacyjny, 20–80
dane <- do.call(rbind, lapply(1:3, function(g) data.frame(
  motywacja      = rnorm(profil$n[g], profil$motywacja[g], 0.6),
  prokrastynacja = rnorm(profil$n[g], profil$prokrastynacja[g], 6),
  lek            = rnorm(profil$n[g], profil$lek[g], 8))))
dane <- round(data.frame(motywacja = pmin(pmax(dane$motywacja, 1), 7),
                         prokrastynacja = pmin(pmax(dane$prokrastynacja, 16), 64),
                         lek = pmin(pmax(dane$lek, 20), 80)), 2)
prawdziwy <- rep(1:3, profil$n)                            # znany tylko w symulacji
round(sapply(dane, function(x) c(M = mean(x), SD = sd(x))), 2)

# 1. Standaryzacja (z = (x - M) / SD)
z <- scale(dane)

# 2. Wybór liczby skupień: suma kwadratów wewnątrz skupień (WSS) i średnia sylwetka
set.seed(1)
wybor <- t(sapply(1:7, function(k) {
  km <- kmeans(z, centers = k, nstart = 25)
  sylw <- if (k > 1) mean(silhouette(km$cluster, dist(z))[, "sil_width"]) else NA
  c(k = k, WSS = km$tot.withinss, sylwetka = sylw)
}))
round(wybor, 3)

# 3. k-średnich dla k = 3: liczebności i średnie skupień w jednostkach skal
set.seed(1)
km <- kmeans(z, centers = 3, nstart = 25)
table(km$cluster)
round(aggregate(dane, by = list(skupienie = km$cluster), FUN = mean), 2)

# 4. Porównanie z metodą hierarchiczną Warda
ward <- cutree(hclust(dist(z), method = "ward.D2"), k = 3)
table(kmeans = km$cluster, ward = ward)

# 5. Zgodność podziałów: skorygowany indeks Randa (ARI)
ari <- function(a, b) {
  tab <- table(a, b); s <- function(x) sum(choose(x, 2))
  oczek <- s(rowSums(tab)) * s(colSums(tab)) / choose(sum(tab), 2)
  (s(tab) - oczek) / (0.5 * (s(rowSums(tab)) + s(colSums(tab))) - oczek)
}
round(c(ward = ari(km$cluster, ward), prawdziwe_profile = ari(km$cluster, prawdziwy)), 3)

# 6. Bez standaryzacji: zgodność z prawdziwymi profilami
set.seed(1)
km_surowe <- kmeans(dane, centers = 3, nstart = 25)
round(ari(km_surowe$cluster, prawdziwy), 3)

# 7. Stabilność: k-średnich na 200 próbach bootstrapowych
set.seed(2)
stabilnosc <- replicate(200, {
  b <- kmeans(z[sample(nrow(z), replace = TRUE), ], centers = 3, nstart = 10)
  przydzial <- apply(z, 1, function(x) which.min(colSums((t(b$centers) - x)^2)))
  ari(km$cluster, przydzial)
})
round(c(srednia = mean(stabilnosc), min = min(stabilnosc)), 3)
Wynik w R
   motywacja prokrastynacja   lek
M       5.01          30.23 44.58
SD      1.36           6.59 13.81
     k     WSS sylwetka
[1,] 1 717.000       NA
[2,] 2 481.108    0.342
[3,] 3 303.342    0.392
[4,] 4 229.620    0.380
[5,] 5 203.133    0.356
[6,] 6 176.988    0.308
[7,] 7 156.331    0.299

  1   2   3
 60  80 100
  skupienie motywacja prokrastynacja   lek
1         1      3.00          35.56 40.48
2         2      5.47          29.51 61.07
3         3      5.85          27.62 33.84
      ward
kmeans  1  2  3
     1  4  0 56
     2  2 75  3
     3 98  0  2
             ward prawdziwe_profile
            0.870             0.847
[1] 0.441
srednia     min
  0.971   0.773
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- cluster (wersja 2.1.8.2): Maechler, M., Rousseeuw, P., Struyf, A., Hubert, M., & Hornik, K. (2026). cluster: Cluster analysis basics and extensions (R package version 2.1.8.2) [Computer software]. https://CRAN.R-project.org/package=cluster
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Brak standaryzacji – zmienna o największej wariancji decyduje o podziale; w przykładzie zgodność z prawdziwymi profilami spadła z .847 do .441.
- Jeden start metody k-średnich – wynik zależy od losowych punktów startowych; ustaw wiele startów (np.
nstart = 25) i ziarno losowania. - Wybór k „na oko” albo pod hipotezę – pokaż kryteria (łokieć, sylwetka) i uzasadnij decyzję interpretacją.
- Testowanie różnic między skupieniami w zmiennych, na których je utworzono – ANOVA czy MANOVA „potwierdzą” różnice zawsze, bo algorytm sam je zmaksymalizował. Trafność sprawdzaj na zmiennych spoza analizy.
- Traktowanie skupień jak naturalnych typów – podział jest opisem danych, a nie dowodem, że w populacji istnieją odrębne kategorie ludzi.
- Za mała separacja lub za mało osób – metoda wtedy „znajduje” grupy w szumie (Dalmaijer i in., 2022).
- Niepełny opis procedury – częsty problem w publikacjach (Clatworthy i in., 2005).
Najczęstsze pytania
Co to jest analiza skupień?
To grupa metod, które dzielą osoby na grupy (skupienia) podobne wewnątrz i różne między sobą, gdy przynależność do grup nie jest znana. W psychologii służy do tworzenia profili, np. studentów o różnych wzorcach motywacji i lęku. Najpopularniejsze metody to k-średnich i hierarchiczna metoda Warda.
Czym różni się metoda k-średnich od metody hierarchicznej?
W metodzie k-średnich podajesz liczbę skupień z góry, a algorytm przesuwa osoby między skupieniami, minimalizując sumę kwadratów odległości od centroidów. Metoda hierarchiczna łączy osoby krok po kroku w coraz większe skupienia, a liczbę skupień wybierasz po fakcie z dendrogramu. Zgodność obu rozwiązań wzmacnia wnioski.
Jak wybrać liczbę skupień?
Połącz kilka kryteriów: metodę łokcia (wykres sumy kwadratów wewnątrz skupień), średnią szerokość sylwetki i interpretowalność profili. W przykładzie najwyższą sylwetkę (.392) miało rozwiązanie z trzema skupieniami, a po k = 3 spadek sumy kwadratów wyraźnie słabł.
Czy przed analizą skupień trzeba standaryzować zmienne?
Tak, gdy zmienne mają różne jednostki lub rozproszenie. Odległości zależą od skali, więc zmienna o największej wariancji zdominuje podział. W przykładzie zgodność podziału z prawdziwymi profilami wyniosła ARI = .847 po standaryzacji i tylko .441 bez niej.
Ile osób potrzeba do analizy skupień?
Według symulacji Dalmaijera i in. (2022) moc analizy skupień zależy głównie od separacji grup, a nie od samej liczebności; autorzy zalecają 20–30 osób na podgrupę i stosowanie metody tylko wtedy, gdy oczekuje się wyraźnie odmiennych grup.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Statystyka do pracy magisterskiej: od planu do raportu
Kompletny proces analizy statystycznej do pracy magisterskiej: plan, przygotowanie danych, psychometria, modele, interpretacja i materiały do obrony.
Czytaj →PoradnikAnaliza ankiety do pracy licencjackiej i magisterskiej
Analiza ankiety do pracy dyplomowej: przygotowanie bazy, kodowanie pytań, skale, testy, modele i raport wyników do licencjatu lub magisterki.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Clatworthy, J., Buick, D., Hankins, M., Weinman, J., & Horne, R. (2005). The use and reporting of cluster analysis in health psychology: A review. British Journal of Health Psychology, 10(3), 329–358. https://doi.org/10.1348/135910705X25697
- Dalmaijer, E. S., Nord, C. L., & Astle, D. E. (2022). Statistical power for cluster analysis. BMC Bioinformatics, 23(1), Article 205. https://doi.org/10.1186/s12859-022-04675-1 ● Otwarty dostęp
- Everitt, B. S., Landau, S., Leese, M., & Stahl, D. (2011). Cluster analysis (5th ed.). Wiley. https://doi.org/10.1002/9780470977811
- Kaufman, L., & Rousseeuw, P. J. (1990). Finding groups in data: An introduction to cluster analysis. Wiley. https://doi.org/10.1002/9780470316801
Cytowania BibTeX
@article{clatworthy2005use, author={Clatworthy, Jane and Buick, Deanna and Hankins, Matthew and Weinman, John and Horne, Robert}, title={{The use and reporting of cluster analysis in health psychology: A review}}, journal={British Journal of Health Psychology}, year={2005}, volume={10}, number={3}, pages={329--358}, doi={10.1348/135910705x25697}}@article{dalmaijer2022statistical, author={Dalmaijer, Edwin S. and Nord, Camilla L. and Astle, Duncan E.}, title={{Statistical power for cluster analysis}}, journal={BMC Bioinformatics}, year={2022}, volume={23}, number={1}, eid={205}, doi={10.1186/s12859-022-04675-1}}@book{everitt2011cluster, author={Everitt, Brian S. and Landau, Sabine and Leese, Morven and Stahl, Daniel}, title={{Cluster analysis (5th ed.)}}, year={2011}, publisher={Wiley}, doi={10.1002/9780470977811}}@book{kaufman1990finding, author={Kaufman, Leonard and Rousseeuw, Peter J.}, title={{Finding groups in data: An introduction to cluster analysis}}, year={1990}, publisher={Wiley}, doi={10.1002/9780470316801}}