Kim byli twórcy taksonomii wrocławskiej?
Taksonomia wrocławska to metoda porządkowania obiektów opisanych wieloma cechami, ogłoszona w 1951 r. przez pięciu matematyków: K. Florka, J. Łukaszewicza, Juliana Perkala, Hugona Steinhausa i S. Zubrzyckiego. Ukazała się po francusku w Colloquium Mathematicum (Florek i in., 1951) i po polsku w Przeglądzie Antropologicznym pod tytułem „Taksonomia wrocławska” (Dudek, 2007). Jej podstawą jest dendryt: łamana bez zamkniętych pętli, która łączy wszystkie obiekty i ma najmniejszą łączną długość – dziś mówimy o minimalnym drzewie rozpinającym (Gower i Ross, 1969).
Hugo Steinhaus (1887–1972) przed wojną pracował we Lwowie, gdzie w 1928 r. założył ze Stefanem Banachem czasopismo Studia Mathematica. W 1945 r. przyjechał do Wrocławia, aby organizować wydział matematyki, fizyki i chemii, i pozostał tam do śmierci (Steinhaus, 1973). Jego drogę i metodę k-średnich z 1956 r. opisujemy w haśle o Hugonie Steinhausie.
Julian Perkal (1913–1965) urodził się w Łodzi i studiował matematykę w Warszawie u Karola Borsuka. Wojnę przetrwał w Związku Radzieckim, a jego rodziców Niemcy zamordowali w 1943 r. W 1946 r. został starszym asystentem w katedrze Steinhausa we Wrocławiu, w 1950 r. obronił doktorat o objętości pni drzew, a od 1960 r. kierował Katedrą Zastosowań Matematyki. Był inicjatorem i pierwszym prezesem Polskiego Towarzystwa Biometrycznego (1961–1964). Zmarł we wrześniu 1965 r. we Wrocławiu (Domański, 2014).
O K. Florku, J. Łukaszewiczu i S. Zubrzyckim cytowane źródła mówią tylko, że współtworzyli metodę, więc nie podajemy szczegółów ich biografii.
Najważniejsze pomysły
- Dendryt (1951). Gower i Ross (1969) opisują pracę z 1951 r. jako matematyczne omówienie najkrótszego drzewa w służbie taksonomii, czyli opisu pokrewieństwa gatunków. Według Domańskiego (2014) metoda wyrosła z antropologicznego porządkowania wykopanych czaszek.
- Budowa w etapach. Punktem wyjścia jest macierz odległości. W pierwszym etapie każdy obiekt łączy się z najbliższym sąsiadem, co daje skupienia pierwszego rzędu. W drugim każde skupienie łączy się najkrótszym odcinkiem z najbliższym innym skupieniem, aż powstanie jeden spójny dendryt (Dudek, 2007).
- Podział na grupy. Dendryt dzieli się przez usunięcie ustalonej liczby najdłuższych odcinków, odcinków dłuższych od progu albo w miejscach „naturalnych”, gdzie kolejne długości wyraźnie skaczą (Dudek, 2007).
- Kontynuacja tradycji Czekanowskiego. Według Gowera i Rossa (1969) taka taksonomia ma w Polsce tradycję sięgającą diagramu Jana Czekanowskiego z 1909 r.; jako poprzedniczkę wskazuje go też Domański (2014).
Ciekawostka
Najkrótsze drzewo wymyślano wielokrotnie, za każdym razem do czego innego. Otakar Borůvka opisał skuteczne rozwiązanie już w 1926 r. i zilustrował je w czasopiśmie elektrotechnicznym, przy oszczędnym projektowaniu sieci elektrycznych (Nešetřil, 1997). Wrocławianie doszli do niego przez taksonomię, J. B. Kruskal ogłosił swój algorytm w 1956 r., a R. C. Prim w 1957 r. szukał najkrótszej linii telefonicznej łączącej 49 miast (Gower i Ross, 1969).
Gower i Ross (1969) piszą, że algorytmy najkrótszego drzewa są często odkrywane na nowo, bo zastosowania są bardzo różne, i przyznają, że pracy Borůvki, napisanej po czesku, sami nie czytali. Nešetřil (1997) dodaje, że „borůvka” to po czesku borówka, a składowe drzewa porównuje do borówek w lesie, których w każdym kroku ubywa co najmniej o połowę.
Przykład na historycznych danych
Bierzemy przykład Gowera i Rossa (1969, tabela 1, s. 60): uogólnione odległości (Mahalanobisa) między 10 populacjami ryjówek białozębych z wysp Scilly, Wysp Normandzkich i przylądka Gris-Nez we Francji, policzone z dziesięciu pomiarów czaszek. Dane Delany’ego i Healy’ego z 1966 r. wpisaliśmy ręcznie z poprawką Gowera i Rossa (Alderney–Cap Gris Nez = 3.77, nie 2.77). Dendryt zbudowaliśmy etapami opisanymi przez Dudka (2007), bez specjalnych pakietów.
Etap 1 dał 8 odcinków i dwa skupienia pierwszego rzędu: pięć populacji ze Scilly razem z Sark i Jersey oraz Alderney, Guernsey i Cap Gris Nez. Etap 2 dodał jeden odcinek: St Martin’s–Guernsey o długości 8.20. Cały dendryt ma 9 odcinków o łącznej długości 28.12. Z Tresco łączy się pięć populacji, w tym Sark (2.93) i Jersey (3.30) – obie leżą bliżej Tresco niż siebie nawzajem (3.37), co zauważyli już Gower i Ross. Długości odcinków dendrytu są identyczne z wysokościami połączeń w analizie skupień metodą pojedynczego wiązania (hclust(method = "single")).
Usunięcie najdłuższego odcinka (8.20) daje dwie grupy, a dwóch najdłuższych – trzy, z Jersey osobno. Metoda Warda łączy natomiast Sark z Jersey. Na płaskiej mapie z klasycznego skalowania wielowymiarowego (dwa wymiary oddają 89.0% zmienności – podobnie jak 89% u Gowera i Rossa) Sark i Jersey leżą tuż obok siebie (0.42), choć w tabeli dzieli je 3.37.
Na rysunku
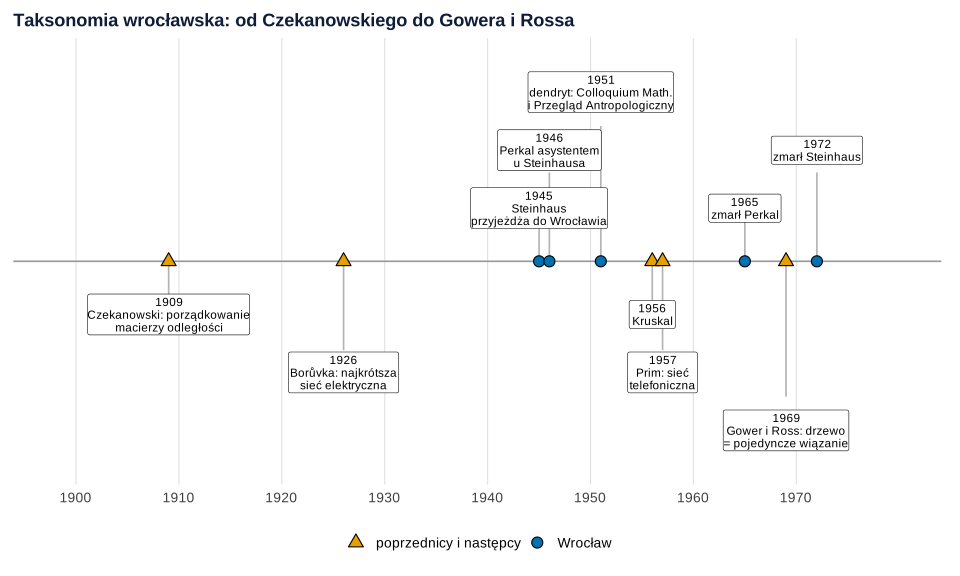
Co widać. Dendryt powstał pięć lat przed algorytmem Kruskala, ale ćwierć wieku po Borůvce.
Na co uważać. Oś zawiera tylko daty z cytowanych źródeł, dlatego brakuje na niej trzech współautorów.
Podpis do pracy:
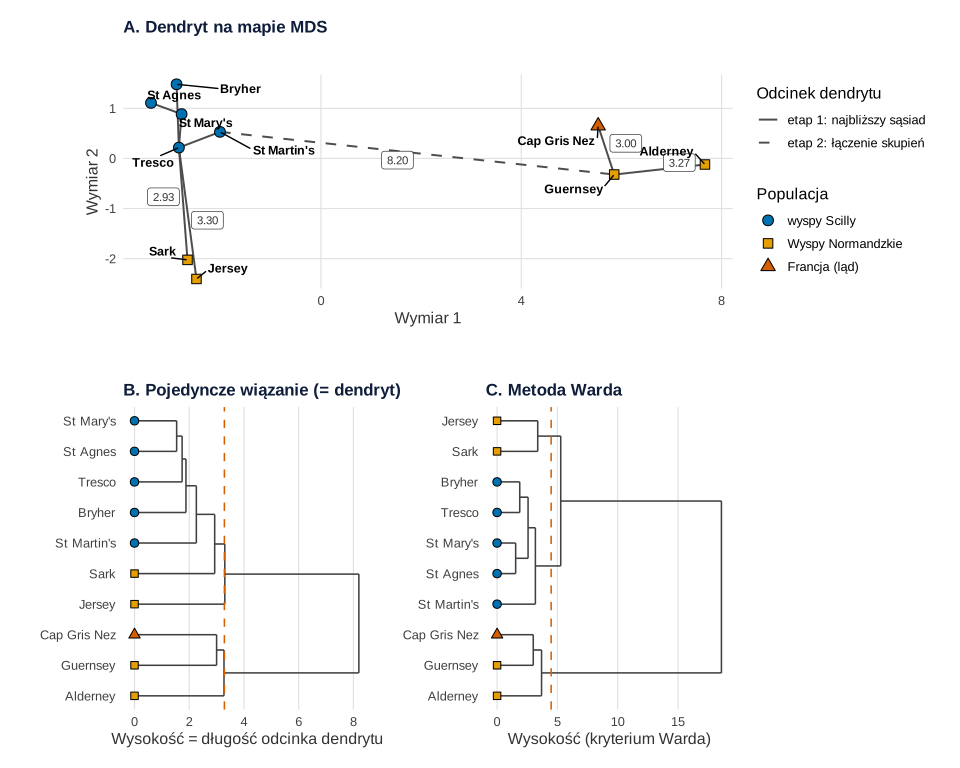
Co widać. Dendryt (A) to gwiazda wokół Tresco i jeden długi most do grupy Guernsey. Wysokości w panelu B to długości jego odcinków. Metoda Warda (C) tworzy parę Sark–Jersey, której dendryt nie ma.
Na co uważać. Mapa w panelu A jest tylko tłem: na płaszczyźnie Sark i Jersey wyglądają na sąsiadów, choć ich odległość w danych (3.37) jest większa niż odległość każdej z nich od Tresco. Wysokości Warda nie są odległościami z tabeli.
Podpis do pracy:
Gdzie spotkasz dendryt w swojej pracy
- Pojedyncze wiązanie w analizie skupień. Wybierając w programie metodę najbliższego sąsiada, liczysz w istocie dendryt i tniesz go na grupy – zob. dendrogram i wpis analiza skupień krok po kroku.
- Sprawdzanie map. Drzewo na wykresie PCA albo MDS pokazuje, które punkty tylko na płaszczyźnie wydają się bliskie (Gower i Ross, 1969).
- Wybór odległości. Dendryt zależy wyłącznie od kolejności odległości: każde przekształcenie, które jej nie zmienia, daje to samo drzewo (Gower i Ross, 1969). Zmiana miary – standaryzacja, odległość Gowera dla zmiennych mieszanych – może zmienić wszystko.
Spory, mity i trudne strony
- Efekt łańcucha. Pojedyncze wiązanie, a więc i dendryt, tworzy długie skupienia, w których obiekty z różnych grup bywają bliżej siebie niż obiekty z tej samej grupy; dlatego metoda jest często nielubiana. Gower i Ross (1969) odpowiadają, że ciąg form pośrednich też jest informacją.
- Czy metoda jest zapomniana? Według Dudka (2007) trochę tak, bo przypomina metodę najbliższego sąsiada, ale przy danych symbolicznych (np. przedziałach) daje inne, czasem lepsze podziały.
- Pisownia nazwisk. W części literatury drugi autor figuruje jako „Łukasiewicz” (Nešetřil, 1997; Dudek, 2007), a Gower i Ross (1969) podają inicjał Perkala jako H.; Crossref: J. Łukaszewicz i J. Perkal.
Dendryt wrocławski w R
Kod rysuje oś czasu, wpisuje tabelę odległości między 10 populacjami ryjówek z pracy Gowera i Rossa (1969), buduje dendryt etapami taksonomii wrocławskiej (najbliższy sąsiad, potem łączenie skupień), sprawdza, że jego odcinki są wysokościami pojedynczego wiązania, dzieli go na grupy i porównuje z metodą Warda, a na końcu rysuje dendryt na mapie MDS i oba dendrogramy. Rysunki na stronie powstały z tych samych obiektów p_os i p_metoda z krojem i tłem serwisu; dane, geometrie i skale są identyczne.
odcinki dendrytu z etapem budowy, łączna długość, zgodność z pojedynczym wiązaniem, podział na 2 i 3 grupy (dendryt, pojedyncze wiązanie, Ward), najbliżsi sąsiedzi Sarku i Jersey oraz jakość mapy MDS.
Kod R rysunków 1 i 2
# Taksonomia wrocławska: oś czasu i dendryt (najkrótsze drzewo) zbudowany krok po kroku
# na odległościach między 10 populacjami ryjówek (dane Delany’ego i Healy’ego z 1966 r.; tabela 1 w: Gower i Ross, 1969, s. 60)
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(ggrepel)})
oi <- c(niebieski = "#0072B2", pomaranczowy = "#E69F00", cynober = "#D55E00", zielony = "#009E73",
        fiolet = "#CC79A7", szary = "grey45")  # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), plot.title = element_text(face = "bold"))

# 1. Oś czasu: górny pas – Wrocław, dolny – poprzednicy i następcy
#    (lata według: Steinhaus 1973, Domański 2014, Florek i in. 1951, Dudek 2007, Nešetřil 1997, Gower i Ross 1969)
zdarzenia <- data.frame(
  rok = c(1945, 1946, 1951, 1965, 1972, 1909, 1926, 1956, 1957, 1969),
  opis = c("Steinhaus\nprzyjeżdża do Wrocławia", "Perkal asystentem\nu Steinhausa", "dendryt: Colloquium Math.\ni Przegląd Antropologiczny",
           "zmarł Perkal", "zmarł Steinhaus", "Czekanowski: porządkowanie\nmacierzy odległości",
           "Borůvka: najkrótsza\nsieć elektryczna", "Kruskal", "Prim: sieć\ntelefoniczna", "Gower i Ross: drzewo\n= pojedyncze wiązanie"),
  pas = rep(c("Wrocław", "poprzednicy i następcy"), each = 5))
zdarzenia$y <- c(1.1, 2.3, 3.5, 1.1, 2.3, -1.1, -2.3, -1.1, -2.3, -3.5)  # wysokość etykiet, żeby się nie nakładały
p_os <- ggplot(zdarzenia, aes(rok, 0)) +
  geom_hline(yintercept = 0, colour = "grey60") +
  geom_segment(aes(xend = rok, yend = y * 0.8), colour = "grey70") +
  geom_point(aes(shape = pas, fill = pas), size = 3.5) +
  geom_label(aes(y = y, label = paste0(rok, "\n", opis)), size = 3.1, lineheight = 0.9, linewidth = 0.2) +
  scale_shape_manual(values = c("Wrocław" = 21, "poprzednicy i następcy" = 24), name = NULL) +
  scale_fill_manual(values = c("Wrocław" = oi[["niebieski"]], "poprzednicy i następcy" = oi[["pomaranczowy"]]), name = NULL) +
  scale_x_continuous(breaks = seq(1900, 1970, 10), limits = c(1898, 1980)) + scale_y_continuous(limits = c(-4.2, 4.2)) +
  labs(title = "Taksonomia wrocławska: od Czekanowskiego do Gowera i Rossa", x = NULL, y = NULL) +
  motyw + theme(axis.text.y = element_blank(), panel.grid.major.y = element_blank(), legend.position = "bottom")

# 2. Dane: odległości uogólnione między średnimi 10 populacji ryjówek białozębych z wysp Scilly i Normandzkich
#    (pomiary czaszek; dane Delany’ego i Healy’ego z 1966 r.), przepisane z tabeli 1 w pracy Gowera i Rossa (1969, s. 60),
#    z ich poprawką (Alderney–Cap Gris Nez = 3.77, w oryginale wydrukowano 2.77).
nazwy <- c("Tresco", "Bryher", "St Agnes", "St Martin's", "St Mary's", "Sark", "Jersey", "Alderney", "Guernsey", "Cap Gris Nez")
region <- c(rep("wyspy Scilly", 5), rep("Wyspy Normandzkie", 4), "Francja (ląd)")
dolny_trojkat <- c(1.88, 2.33, 2.26, 1.74, 2.93, 3.30, 10.73, 8.83, 8.57,   # kolumna Tresco
                   2.54, 2.97, 2.05, 4.00, 4.52, 10.89, 9.09, 8.78,          # Bryher
                   3.22, 1.54, 4.01, 4.10, 11.28, 9.66, 9.21,                # St Agnes
                   2.68, 4.51, 3.46, 10.01, 8.20, 8.24,                      # St Martin's
                   3.84, 3.56, 10.54, 9.04, 8.64,                            # St Mary's
                   3.37, 10.99, 9.00, 8.74,                                  # Sark
                   10.44, 8.96, 9.07,                                        # Jersey
                   3.27, 3.77,                                               # Alderney
                   3.00)                                                     # Guernsey
d <- structure(dolny_trojkat, Size = 10L, Labels = nazwy, Diag = FALSE, Upper = FALSE, class = "dist")
D <- as.matrix(d)

# 3. Dendryt metodą taksonomii wrocławskiej (opis etapów: Dudek, 2007)
#    Etap 1: każdy obiekt łączymy z najbliższym sąsiadem -> skupienia pierwszego rzędu.
#    Etap 2: każde skupienie łączymy najkrótszym odcinkiem z najbliższym innym skupieniem; powtarzamy do spójności.
skupienie <- seq_along(nazwy)            # na starcie każdy obiekt jest osobnym skupieniem
dendryt <- data.frame(od = character(), do = character(), dlugosc = numeric(), etap = integer())
etap <- 0
while (length(unique(skupienie)) > 1) {
  etap <- etap + 1
  nowe <- NULL
  for (s in unique(skupienie)) {
    w <- which(skupienie == s); poza <- which(skupienie != s)
    pod <- D[w, poza, drop = FALSE]
    k <- which(pod == min(pod), arr.ind = TRUE)[1, ]
    para <- sort(c(w[k[1]], poza[k[2]]))
    nowe <- rbind(nowe, data.frame(i = para[1], j = para[2], dlugosc = min(pod)))
  }
  nowe <- unique(nowe)                   # dwa skupienia mogą wskazać ten sam odcinek
  for (r in seq_len(nrow(nowe))) {
    a <- skupienie[nowe$i[r]]; b <- skupienie[nowe$j[r]]
    if (a != b) {                        # łączymy tylko różne skupienia (bez cykli)
      skupienie[skupienie == b] <- a
      dendryt <- rbind(dendryt, data.frame(od = nazwy[nowe$i[r]], do = nazwy[nowe$j[r]], dlugosc = nowe$dlugosc[r], etap = etap))
    }
  }
}
dendryt <- dendryt[order(dendryt$dlugosc), ]
rownames(dendryt) <- NULL
dendryt
c(liczba_odcinkow = nrow(dendryt), dlugosc_dendrytu = sum(dendryt$dlugosc))

# Sprawdzenie (Gower i Ross, 1969): odcinki dendrytu = wysokości połączeń w pojedynczym wiązaniu
hc_poj <- hclust(d, method = "single")
all.equal(sort(dendryt$dlugosc), sort(hc_poj$height))

# Etap 3: podział dendrytu – usuwamy najdłuższe odcinki (k - 1 odcinków daje k grup)
podziel <- function(dendryt, k) {
  zostaja <- dendryt[order(dendryt$dlugosc)[seq_len(nrow(dendryt) - (k - 1))], ]
  grupa <- setNames(seq_along(nazwy), nazwy)
  for (r in seq_len(nrow(zostaja))) grupa[grupa == grupa[zostaja$do[r]]] <- grupa[zostaja$od[r]]
  as.integer(factor(grupa, levels = unique(grupa)))
}
grupy <- data.frame(populacja = nazwy, dendryt_k2 = podziel(dendryt, 2), dendryt_k3 = podziel(dendryt, 3),
                    pojedyncze_k3 = cutree(hc_poj, 3), ward_k3 = cutree(hclust(d, method = "ward.D2"), 3))
grupy
# Najbliższy sąsiad Sarku i Jersey
sapply(c("Sark", "Jersey"), function(x) { o <- sort(D[x, setdiff(nazwy, x)])[1:2]; paste(names(o), formatC(o, format = "f", digits = 2), collapse = "; ") })

# 4. Rysunek: dendryt na mapie z klasycznego skalowania wielowymiarowego (2 wymiary)
mds <- cmdscale(d, k = 2, eig = TRUE)
formatC(mds$GOF[1], format = "f", digits = 3)   # jaka część zmienności odległości mieści się w dwóch wymiarach
na_mapie <- as.matrix(dist(mds$points))   # odległości na płaskiej mapie (w tabeli: 3.37, 2.93, 3.30)
formatC(c(Sark_Jersey = na_mapie["Sark", "Jersey"], Tresco_Sark = na_mapie["Tresco", "Sark"],
          Tresco_Jersey = na_mapie["Tresco", "Jersey"]), format = "f", digits = 2)
wsp <- data.frame(populacja = nazwy, region = factor(region, levels = c("wyspy Scilly", "Wyspy Normandzkie", "Francja (ląd)")),
                  x = mds$points[, 1], y = mds$points[, 2])
odc <- cbind(dendryt, x = wsp$x[match(dendryt$od, nazwy)], y = wsp$y[match(dendryt$od, nazwy)],
             xend = wsp$x[match(dendryt$do, nazwy)], yend = wsp$y[match(dendryt$do, nazwy)])
odc$rodzaj <- ifelse(odc$etap == 1, "etap 1: najbliższy sąsiad", "etap 2: łączenie skupień")
kol_reg <- c("wyspy Scilly" = oi[["niebieski"]], "Wyspy Normandzkie" = oi[["pomaranczowy"]], "Francja (ląd)" = oi[["cynober"]])
ksz_reg <- c("wyspy Scilly" = 21, "Wyspy Normandzkie" = 22, "Francja (ląd)" = 24)
rysuj_mape <- function(punkty, odcinki, tytul, etykiety_odcinkow) {
  ggplot() +
    geom_segment(data = odcinki, aes(x, y, xend = xend, yend = yend, linetype = rodzaj), colour = "grey30", linewidth = 0.7) +
    geom_label_repel(data = etykiety_odcinkow, aes((x + xend) / 2, (y + yend) / 2, label = formatC(dlugosc, format = "f", digits = 2)),
                     size = 3, label.size = 0, fill = "white", colour = "grey20", seed = 2, box.padding = 0.1,
                     min.segment.length = 0.1, segment.colour = "grey60") +
    geom_point(data = punkty, aes(x, y, fill = region, shape = region), size = 3.4) +
    geom_text_repel(data = punkty, aes(x, y, label = populacja), size = 3.3, seed = 1, box.padding = 0.5,
                    min.segment.length = 0.2, fontface = "bold") +
    scale_linetype_manual(values = c("etap 1: najbliższy sąsiad" = "solid", "etap 2: łączenie skupień" = "dashed"),
                          name = "Odcinek dendrytu", drop = FALSE) +
    scale_fill_manual(values = kol_reg, name = "Populacja", drop = FALSE) +
    scale_shape_manual(values = ksz_reg, name = "Populacja", drop = FALSE) +
    coord_equal() + labs(title = tytul, x = "Wymiar 1", y = "Wymiar 2") + motyw + theme(legend.position = "right")
}
odc$rodzaj <- factor(odc$rodzaj, levels = c("etap 1: najbliższy sąsiad", "etap 2: łączenie skupień"))
# liczby przy odcinkach dłuższych niż 2.5 (krótsze odczytasz z dendrogramu w panelu B)
pA <- rysuj_mape(wsp, odc, "A. Dendryt na mapie MDS", subset(odc, dlugosc > 2.5))

# Dendrogram poziomy z obiektu hclust (rysowany ręcznie w ggplot2)
segmenty_dendrogramu <- function(h) {
  poz_liscia <- setNames(seq_along(h$order), h$labels[h$order])
  poz <- numeric(nrow(h$merge)); seg <- NULL
  wsp_dziecka <- function(m) if (m < 0) c(poz_liscia[[h$labels[-m]]], 0) else c(poz[m], h$height[m])
  for (i in seq_len(nrow(h$merge))) {
    a <- wsp_dziecka(h$merge[i, 1]); b <- wsp_dziecka(h$merge[i, 2]); hi <- h$height[i]
    seg <- rbind(seg, c(a[2], a[1], hi, a[1]), c(b[2], b[1], hi, b[1]), c(hi, a[1], hi, b[1]))
    poz[i] <- mean(c(a[1], b[1]))
  }
  list(seg = setNames(as.data.frame(seg), c("x", "y", "xend", "yend")),
       liscie = data.frame(populacja = names(poz_liscia), y = unname(poz_liscia)))
}
rysuj_dendrogram <- function(h, tytul, ciecie, os_x) {
  s <- segmenty_dendrogramu(h)
  s$liscie$region <- factor(region[match(s$liscie$populacja, nazwy)], levels = levels(wsp$region))
  ggplot() +
    geom_segment(data = s$seg, aes(x, y, xend = xend, yend = yend), colour = "grey25") +
    geom_vline(xintercept = ciecie, linetype = "dashed", colour = oi[["cynober"]]) +
    geom_point(data = s$liscie, aes(0, y, fill = region, shape = region), size = 2.6) +
    scale_fill_manual(values = kol_reg, guide = "none") + scale_shape_manual(values = ksz_reg, guide = "none") +
    scale_y_continuous(breaks = s$liscie$y, labels = s$liscie$populacja) +
    labs(title = tytul, x = os_x, y = NULL) + motyw + theme(panel.grid.major.y = element_blank())
}
hc_ward <- hclust(d, method = "ward.D2")
pB <- rysuj_dendrogram(hc_poj, "B. Pojedyncze wiązanie (= dendryt)", ciecie = mean(sort(hc_poj$height, decreasing = TRUE)[2:3]),
                       os_x = "Wysokość = długość odcinka dendrytu")
pC <- rysuj_dendrogram(hc_ward, "C. Metoda Warda", ciecie = mean(sort(hc_ward$height, decreasing = TRUE)[2:3]),
                       os_x = "Wysokość (kryterium Warda)")
p_metoda <- pA / (pB | pC) + plot_layout(heights = c(1, 1.1))
p_os
p_metoda
Wynik w R
           od           do dlugosc etap
1    St Agnes    St Mary's    1.54    1
2      Tresco    St Mary's    1.74    1
3      Tresco       Bryher    1.88    1
4      Tresco  St Martin's    2.26    1
5      Tresco         Sark    2.93    1
6    Guernsey Cap Gris Nez    3.00    1
7    Alderney     Guernsey    3.27    1
8      Tresco       Jersey    3.30    1
9 St Martin's     Guernsey    8.20    2
 liczba_odcinkow dlugosc_dendrytu
            9.00            28.12
[1] TRUE
                populacja dendryt_k2 dendryt_k3 pojedyncze_k3 ward_k3
Tresco             Tresco          1          1             1       1
Bryher             Bryher          1          1             1       1
St Agnes         St Agnes          1          1             1       1
St Martin's   St Martin's          1          1             1       1
St Mary's       St Mary's          1          1             1       1
Sark                 Sark          1          1             1       2
Jersey             Jersey          1          2             2       2
Alderney         Alderney          2          3             3       3
Guernsey         Guernsey          2          3             3       3
Cap Gris Nez Cap Gris Nez          2          3             3       3
                      Sark                     Jersey
"Tresco 2.93; Jersey 3.37"   "Tresco 3.30; Sark 3.37"
[1] "0.890"
  Sark_Jersey   Tresco_Sark Tresco_Jersey
       "0.42"        "2.25"        "2.65"
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (dendrogramy – funkcja hclust(), skalowanie – cmdscale() z pakietu stats; rysunki – pakiety ggplot2, ggrepel i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Co to jest taksonomia wrocławska?
Metoda porządkowania obiektów opisanych wieloma cechami, ogłoszona w 1951 r. we Wrocławiu. Obiekty łączy się dendrytem – drzewem o najmniejszej łącznej długości odcinków – a grupy powstają po usunięciu jego najdłuższych odcinków. Bywa nazywana metodą dendrytową.
Kto stworzył dendryt wrocławski?
Pięciu matematyków: K. Florek, J. Łukaszewicz, Julian Perkal, Hugo Steinhaus i S. Zubrzycki. Opisali go w 1951 r. po francusku w Colloquium Mathematicum i po polsku w Przeglądzie Antropologicznym pod tytułem „Taksonomia wrocławska”.
Czym dendryt różni się od dendrogramu?
Dendryt łączy same obiekty odcinkami o długości równej odległościom z danych i nie ma węzłów pośrednich. Dendrogram to drzewo kolejnych połączeń grup: jego rozgałęzienia nie są obiektami, a wysokość połączenia mówi, przy jakiej odległości grupy się łączą.
Czy metoda dendrytowa to to samo co pojedyncze wiązanie?
Daje te same grupy. Gower i Ross (1969) pokazali, że skupienia pojedynczego wiązania przy progu d powstają z najkrótszego drzewa po usunięciu odcinków dłuższych niż d, więc wysokości dendrogramu są długościami odcinków dendrytu.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Domański, C. (2014). Julian Perkal – pioneer of new statistical methods in science. Acta Universitatis Lodziensis. Folia Oeconomica, 27–30. https://czasopisma.uni.lodz.pl/foe/article/download/202/146/1716 ● Otwarty dostęp
- Dudek, A. (2007). Metoda taksonomii wrocławskiej w klasyfikacji obiektów symbolicznych. Prace Naukowe Akademii Ekonomicznej we Wrocławiu, 169–177. https://dbc.wroc.pl/Content/141514/Dudek_Metoda_taksonomii_wroclawskiej.pdf ● Otwarty dostęp
- Florek, K., Łukaszewicz, J., Perkal, J., Steinhaus, H., & Zubrzycki, S. (1951). Sur la liaison et la division des points d’un ensemble fini. Colloquium Mathematicum, 2(3–4), 282–285. https://doi.org/10.4064/cm-2-3-4-282-285
- Gower, J. C., & Ross, G. J. S. (1969). Minimum spanning trees and single linkage cluster analysis. Applied Statistics, 18(1), 54–64. https://doi.org/10.2307/2346439 ● Otwarty dostęp: pełny tekst
- Nešetřil, J. (1997). A few remarks on the history of MST-problem. Archivum Mathematicum, 33(1–2), 15–22. http://dml.cz/dmlcz/107593 ● Otwarty dostęp
- Steinhaus, H. (1973). Autobiografia. Wiadomości Matematyczne, 17(01), 3–11. https://doi.org/10.14708/wm.v17i01.3107
Cytowania BibTeX
@article{domanski2014julian, author={Domański, Czesław}, title={{Julian Perkal – pioneer of new statistical methods in science}}, journal={Acta Universitatis Lodziensis. Folia Oeconomica}, year={2014}, number={3(302)}, pages={27--30}, url={https://czasopisma.uni.lodz.pl/foe/article/download/202/146/1716}}@article{dudek2007metoda, author={Dudek, Andrzej}, title={{Metoda taksonomii wrocławskiej w klasyfikacji obiektów symbolicznych}}, journal={Prace Naukowe Akademii Ekonomicznej we Wrocławiu}, year={2007}, number={1169}, pages={169--177}, url={https://dbc.wroc.pl/Content/141514/Dudek_Metoda_taksonomii_wroclawskiej.pdf}}@article{florek1951liaison, author={Florek, K. and Łukaszewicz, J. and Perkal, J. and Steinhaus, Hugo and Zubrzycki, S.}, title={{Sur la liaison et la division des points d’un ensemble fini}}, journal={Colloquium Mathematicum}, year={1951}, volume={2}, number={3–4}, pages={282--285}, doi={10.4064/cm-2-3-4-282-285}}@article{gower1969minimum, author={Gower, J. C. and Ross, G. J. S.}, title={{Minimum spanning trees and single linkage cluster analysis}}, journal={Applied Statistics}, year={1969}, volume={18}, number={1}, pages={54--64}, doi={10.2307/2346439}}@article{nesetril1997few, author={Nešetřil, Jaroslav}, title={{A few remarks on the history of MST-problem}}, journal={Archivum Mathematicum}, year={1997}, volume={33}, number={1–2}, pages={15--22}, url={http://dml.cz/dmlcz/107593}}@article{steinhaus1973autobiografia, author={Steinhaus, Hugo}, title={{Autobiografia}}, journal={Wiadomości Matematyczne}, year={1973}, volume={17}, number={01}, pages={3--11}, doi={10.14708/wm.v17i01.3107}}