Co to jest dendrogram?
Dendrogram to drzewo pokazujące kolejne połączenia w hierarchicznej analizie skupień. Liście na dole to obiekty (osoby, klasy, zmienne), a każde poziome ramię – połączenie dwóch grup na wysokości odpowiadającej ich niepodobieństwu. Ward (1963) opisał procedurę, która w każdym kroku łączy tę parę grup, której połączenie daje najlepszą wartość wybranej przez badacza funkcji celu, aż zostanie jedna grupa; daje to pełną hierarchię z oceną straty na każdym etapie. Dendrogram jest obrazem tej hierarchii.
Jak czytać dendrogram
- Wysokość połączenia – im wyżej łączą się gałęzie, tym bardziej różne grupy połączono. W pojedynczym, pełnym i średnim wiązaniu to odległość między grupami; w metodzie Warda – miara przyrostu zmienności wewnątrz skupień, a nie odległość z danych.
- Duży skok wysokości – naturalne miejsce cięcia drzewa.
- Linia cięcia – pozioma linia; liczba przeciętych gałęzi to liczba skupień.
- Odległość kofenetyczna – wysokość, na której dwa obiekty po raz pierwszy trafiają do wspólnej grupy. Jej korelacja z odległościami w danych (korelacja kofenetyczna) mówi, jak wiernie drzewo oddaje dane.
Przykład
Symulowano średnie wyniki z matematyki i czytania (w jednostkach z) dla 12 klas z trzech grup po cztery. Środki grup ustawiono ręcznie tak, by skupienia były wyraźne; ziarno (746) ustalono raz i nie zmieniano. Drzewo zbudowano metodą Warda na odległościach euklidesowych. Murtagh i Legendre (2014) pokazali, że programy implementują metodę Warda różnie – w R kryterium Warda realizuje opcja ward.D2. Przejście z trzech do dwóch skupień wymagało połączenia na wysokości 7.59, a z czterech do trzech – tylko 2.50. Cięcie na wysokości 5 dało trzy skupienia po cztery klasy, zgodne z grupami z symulacji. Korelacja kofenetyczna wyniosła .900 dla Warda i .899 dla pojedynczego wiązania – przy wyraźnych grupach metody się zgadzają.
Na rysunku
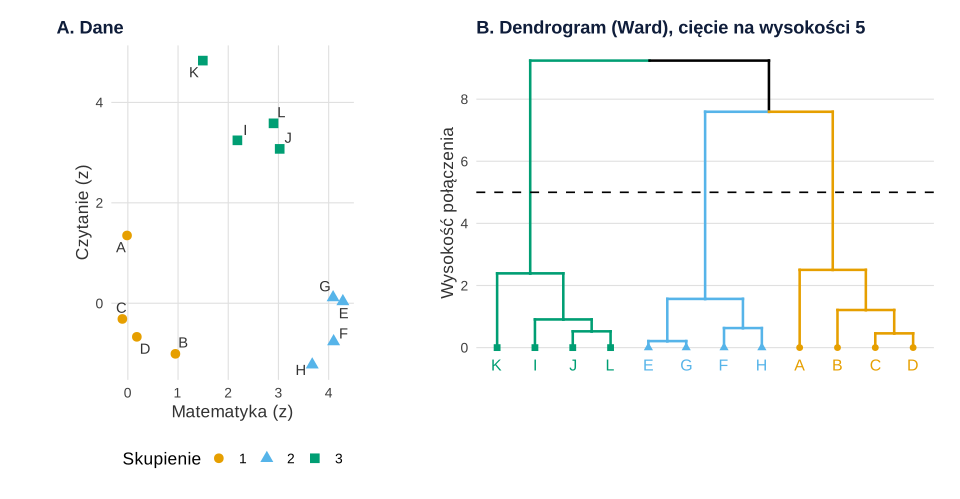
set.seed(746)).Co widać. Trzy gałęzie łączą się nisko, a między sobą dopiero wysoko – to duży skok, w którym przecina je linia cięcia. Klasa A dołącza do klas B, C i D na wysokości 2.50, a jej odległość euklidesowa od B to 2.55; skupienia są tym, co widać na wykresie rozrzutu w panelu A.
Na co uważać. Drzewo powstanie także wtedy, gdy w danych nie ma skupień, a miejsce cięcia wybiera badacz. Sprawdź je innymi kryteriami, np. wskaźnikiem sylwetki. Przy dwóch zmiennych wystarczy wykres rozrzutu; dendrogram przydaje się przy wielu.
Podpis do pracy:
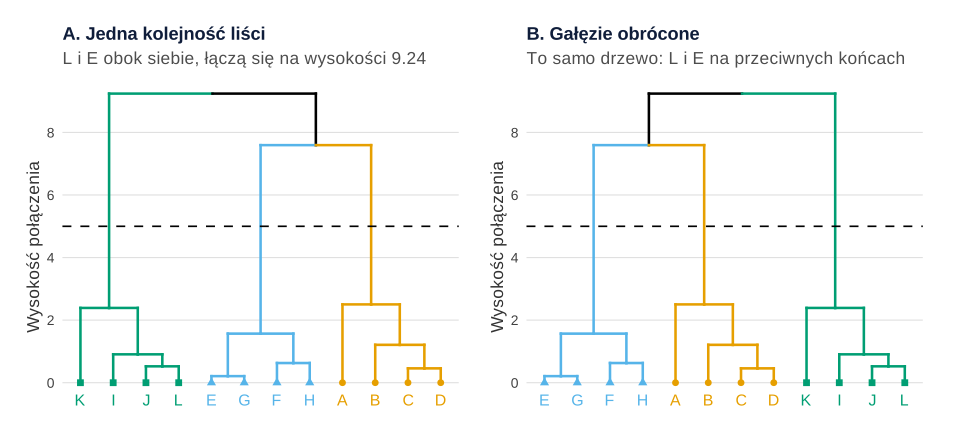
set.seed(746)).Co widać. W panelu A klasy L i E stoją obok siebie, a łączą się dopiero na samej górze, na wysokości 9.24, choć ich odległość euklidesowa wynosi 3.81. W panelu B po obróceniu gałęzi L i E są na przeciwnych końcach, a wysokości się nie zmieniły.
Na co uważać. Sąsiedztwo liści w poziomie nic nie znaczy – o podobieństwie dwóch obiektów mówi tylko wysokość ich wspólnego połączenia. Każde z 11 połączeń można obrócić niezależnie.
Podpis do pracy:
Jak opisać w pracy
Na co uważać
- Wysokości Warda jako odległości. W metodzie Warda wysokość nie jest odległością między obiektami (L i E: 9.24 wobec 3.81).
- Brak standaryzacji. Zmienna o największej wariancji zdominuje odległości; przy zmiennych różnego typu rozważ odległość Gowera.
- Metoda wybrana po obejrzeniu drzew. Sposób łączenia ustal z góry. Jak różnią się drzewa Warda i pojedynczego wiązania na mniej wyraźnych danych, pokazuje wpis Analiza skupień krok po kroku.
- Setki liści. Przy dużych próbach pokaż górne poziomy drzewa albo profile skupień.
Dendrogram porządkuje też wiersze i kolumny mapy cieplnej korelacji, tak by zmienne podobne stały obok siebie.
Dendrogram w R
Kod symuluje dane, buduje drzewo funkcją hclust(), tnie je funkcją cutree(), liczy korelację kofenetyczną i odległości kofenetyczne, a następnie rysuje rysunki 1 i 2 (pakiet dendextend przygotowuje drzewo do ggplot2 i obraca gałęzie funkcją rotate()). Szybki dendrogram daje bazowe plot(hw) z abline(h = 5). Rysunki na stronie powstały z tych samych obiektów p1 i p2 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Rysunki 1 i 2: dendrogram Warda, cięcie i obrót gałęzi
R
# Dendrogram: 12 klas szkolnych opisanych dwiema zmiennymi (dane symulowane), metoda Warda
suppressPackageStartupMessages({library(ggplot2); library(patchwork); library(dendextend); library(ggrepel)})
set.seed(746)                                      # 3 grupy po 4 klasy; środki ustawione ręcznie
srodki <- cbind(c(0, 4, 2), c(0, 0, 3.5))
grupa <- rep(1:3, each = 4)
X <- srodki[grupa, ] + matrix(rnorm(24, sd = 0.7), ncol = 2)
dimnames(X) <- list(LETTERS[1:12], c("matematyka", "czytanie"))   # średnie wyniki klas (z)
d <- dist(X)                                       # odległości euklidesowe
hw <- hclust(d, method = "ward.D2")
round(rev(hw$height)[1:4], 2)                      # wysokości czterech ostatnich połączeń
ciecie <- 5                                        # linia cięcia między 2.50 a 7.59 → 3 skupienia
skup <- cutree(hw, h = ciecie)
skup
# korelacja kofenetyczna: jak wiernie drzewo oddaje odległości (Ward vs pojedyncze wiązanie)
round(c(ward = cor(d, cophenetic(hw)), pojedyncze = cor(d, cophenetic(hclust(d, method = "single")))), 3)
koph <- as.matrix(cophenetic(hw)); odl <- as.matrix(d)
round(rbind(kofenetyczna = c(A_B = koph["A", "B"], L_E = koph["L", "E"]),
            euklidesowa = c(A_B = odl["A", "B"], L_E = odl["L", "E"])), 2)
kol <- c("#E69F00", "#56B4E9", "#009E73"); ksz <- c(16, 17, 15)   # Okabe–Ito + kształty
dend <- as.dendrogram(hw)
w_kol <- skup[labels(dend)]                        # skupienie każdego liścia w kolejności rysowania
dend <- dend |> color_branches(k = 3, col = kol[unique(w_kol)]) |>
  set("labels_col", kol[w_kol]) |> set("leaves_pch", ksz[w_kol]) |> set("leaves_col", kol[w_kol]) |>
  set("leaves_cex", 2) |> set("branches_lwd", 0.9)
obrocony <- rotate(dend, c(labels(dend[[2]]), labels(dend[[1]])))   # to samo drzewo, gałęzie zamienione
labels(dend); labels(obrocony)
rysuj_drzewo <- function(dd, tytul, podtytul = NULL) {
  g <- as.ggdend(dd)                                # odcinki, liście i podpisy jako ramki danych
  ggplot(g, labels = FALSE) + geom_hline(yintercept = ciecie, linetype = "dashed") +
    geom_text(data = g$labels, aes(x, -0.55, label = label, colour = I(col)), size = 4.2) +
    scale_y_continuous(breaks = seq(0, 10, 2)) + labs(title = tytul, subtitle = podtytul, y = "Wysokość połączenia") +
    theme_minimal(base_size = 13) +
    theme(axis.text.x = element_blank(), axis.title.x = element_blank(), panel.grid.major.x = element_blank(),
          panel.grid.minor = element_blank())
}
dane <- data.frame(X, klasa = rownames(X), skup = factor(skup))
pA <- ggplot(dane, aes(matematyka, czytanie, colour = skup, shape = skup)) + geom_point(size = 3) +
  geom_text_repel(aes(label = klasa), show.legend = FALSE, colour = "grey20", seed = 746) +
  scale_colour_manual(values = kol) + scale_shape_manual(values = ksz) + coord_equal() +
  labs(title = "A. Dane", x = "Matematyka (z)", y = "Czytanie (z)", colour = "Skupienie", shape = "Skupienie") +
  theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank(), legend.position = "bottom")
p1 <- pA + rysuj_drzewo(dend, "B. Dendrogram (Ward), cięcie na wysokości 5") + plot_layout(widths = c(1, 1.3))
h_le <- sprintf("%.2f", koph["L", "E"])
p2 <- rysuj_drzewo(dend, "A. Jedna kolejność liści", paste("L i E obok siebie, łączą się na wysokości", h_le)) +
  rysuj_drzewo(obrocony, "B. Gałęzie obrócone", "To samo drzewo: L i E na przeciwnych końcach")
p1
p2
Wynik w R
[1] 9.24 7.59 2.50 2.39
A B C D E F G H I J K L
1 1 1 1 2 2 2 2 3 3 3 3
      ward pojedyncze
     0.900      0.899
              A_B  L_E
kofenetyczna 2.50 9.24
euklidesowa  2.55 3.81
 [1] "K" "I" "J" "L" "E" "G" "F" "H" "A" "B" "C" "D"
 [1] "E" "G" "F" "H" "A" "B" "C" "D" "K" "I" "J" "L"
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje bazowe dist(), hclust(), cutree(), cophenetic(); rysunki – pakiety ggplot2, patchwork, dendextend i ggrepel). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- dendextend (wersja 1.19.1): Galili, T. (2015). dendextend: An R package for visualizing, adjusting and comparing trees of hierarchical clustering. Bioinformatics, 31(22), 3718–3720. https://doi.org/10.1093/bioinformatics/btv428
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- ggrepel (wersja 0.9.8): Slowikowski, K. (2026). ggrepel: Automatically position non-overlapping text labels with 'ggplot2' [R package]. https://doi.org/10.32614/CRAN.package.ggrepel
Najczęstsze pytania
Gdzie przeciąć dendrogram?
Zwykle tam, gdzie wysokości kolejnych połączeń wyraźnie skaczą – przecięcie w tym miejscu oddziela grupy łączone dopiero dużym kosztem. Decyzję warto potwierdzić innymi kryteriami, np. wskaźnikiem sylwetki, i zapisać z góry, jak rozstrzygniesz niezgodność.
Co to jest korelacja kofenetyczna?
To korelacja między odległościami obiektów w danych a wysokościami, na których te obiekty łączą się na dendrogramie. Wartość bliska 1 oznacza, że drzewo wiernie oddaje odległości; nie mówi jednak, który podział na skupienia jest najlepszy.
Czy kolejność obiektów na dendrogramie ma znaczenie?
Nie. Gałęzie każdego połączenia można obrócić bez zmiany drzewa, więc dwa obiekty stojące obok siebie mogą łączyć się dopiero na samej górze. O podobieństwie mówi tylko wysokość wspólnego połączenia.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analiza skupień krok po kroku
Ward i dendrogram, k-średnich, sylwetka i statystyka luki, stabilność w podpróbach, kontrola na danych bez skupień i opis APA – na jednym przykładzie w R.
Czytaj →PoradnikAnaliza skupień w SPSS krok po kroku
Hierarchical Cluster, K-Means i TwoStep od pliku .sav po opis APA: standaryzacja, metoda Warda, przegląd aglomeracji, Final Cluster Centers i opisowe testy F.
Czytaj →PoradnikKorelacje na wykresie
Mapa cieplna w dobrej kolejności, korekta zamiast gwiazdek, ggpairs ujawniający próg i sufit oraz korelacje z przedziałami ufności – pięć rysunków z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Murtagh, F., & Legendre, P. (2014). Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion? Journal of Classification, 31(3), 274–295. https://doi.org/10.1007/s00357-014-9161-z ● Otwarty dostęp: pełny tekst
- Ward, J. H. (1963). Hierarchical grouping to optimize an objective function. Journal of the American Statistical Association, 58(301), 236–244. https://doi.org/10.1080/01621459.1963.10500845
Cytowania BibTeX
@article{murtagh2014ward, author={Murtagh, Fionn and Legendre, Pierre}, title={{Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion?}}, journal={Journal of Classification}, year={2014}, volume={31}, number={3}, pages={274--295}, doi={10.1007/s00357-014-9161-z}}@article{ward1963hierarchical, author={Ward, Joe H.}, title={{Hierarchical grouping to optimize an objective function}}, journal={Journal of the American Statistical Association}, year={1963}, volume={58}, number={301}, pages={236--244}, doi={10.1080/01621459.1963.10500845}}