Trzy procedury analizy skupień w SPSS
Analiza skupień dzieli osoby na grupy podobnych do siebie profili. Czym różni się od analizy czynnikowej, jak dobrać zmienne, ile skupień wybrać i jak sprawdzić stabilność, omawia wpis analiza skupień krok po kroku (w R). Tutaj zajmujemy się tylko SPSS: oknami procedur, tabelami wydruku i tym, co z nich przepisać do pracy. Ogólne zasady czytania wydruku są we wpisie jak czytać wyniki z SPSS.
W menu Analyze → Classify są trzy procedury (IBM Corp., b.d.-b, b.d.-c, b.d.-d):
- Hierarchical Cluster – łączy osoby krok po kroku, od pojedynczych przypadków do jednego skupienia; wiele metod łączenia i miar odległości.
- K-Means Cluster – dzieli osoby na z góry podaną liczbę skupień; tylko zmienne ilościowe i odległość euklidesowa.
- TwoStep Cluster – zmienne ilościowe i jakościowe; liczbę skupień może dobrać sam według BIC albo AIC.
Ścieżki menu, nazwy okien, opcji i tabel sprawdziliśmy w dokumentacji IBM SPSS Statistics 31 i podajemy po angielsku. Polska dokumentacja nazywa te procedury „Klaster hierarchiczny”, „Klaster K-średnich” i „Klaster „TwoStep”” (ścieżka Analizuj → Klasyfikuj). Etykiety w polskim interfejsie programu mogą brzmieć inaczej. Według dokumentacji procedury wymagają opcji Statistics Base (IBM Corp., b.d.-b, b.d.-c).
Przykład, pliki i standaryzacja
Liczby pochodzą z jednego zbioru symulowanego: 150 studentów opisano czterema zmiennymi w różnych jednostkach: czas nauki (godziny tygodniowo), prokrastynacja (1–5), zaangażowanie w studia (1–7) i sen (godziny na dobę). Średnia ocen posłuży do walidacji zewnętrznej. Dane wylosowano z trzech profili. Ziarno (set.seed(25)) wybraliśmy spośród 30 sprawdzonych tak, by sylwetka wskazała trzy skupienia, a metoda Warda i k-średnich dały ten sam podział; przy innych ziarnach sylwetka często wskazywała dwa.
Pobierz plik .sav z etykietami zmiennych albo ten sam zbiór w pliku CSV (format opisuje hasło plik .sav). Etykiety i braki danych ustawisz według wpisu przygotowanie danych w SPSS.
Najpierw standaryzacja. Odległość euklidesowa sumuje kwadraty różnic, więc dominuje zmienna o największej wariancji. W surowych danych czas nauki odpowiada za 91.1% sumy wariancji, a po standaryzacji każda zmienna ma 25%. Dokumentacja K-Means radzi standaryzować zmienne o różnych skalach, na przykład w procedurze Descriptives (IBM Corp., b.d.-c). W Analyze → Descriptive Statistics → Descriptives zaznacz Save standardized values as variables. SPSS doda zmienne z wynikami z z literą Z przed nazwą: Znauka, Zprokrastynacja i tak dalej (IBM Corp., b.d.-a). Tych samych zmiennych Z użyj w obu procedurach poniżej. Wcześniej sprawdź obserwacje odstające (hasło obserwacja odstająca), bo pojedyncza skrajna osoba potrafi utworzyć osobne skupienie.
Bez standaryzacji k-średnich podzieliło osoby niemal wyłącznie według czasu nauki (średnio 4.7, 12.4 i 20.4 godziny w skupieniach) – zob. tabelę krzyżową w przepisie 4.
Krok 1: Hierarchical Cluster i metoda Warda
- Analyze → Classify → Hierarchical Cluster (IBM Corp., b.d.-b). Przenieś cztery zmienne Z na listę zmiennych; grupujesz przypadki (osoby), nie zmienne.
- Method. W Cluster Method wybierz Ward's method, a w Measure → Interval – Squared Euclidean distance. Command Syntax Reference podaje, że przy metodzie Warda zwykle używa się kwadratu odległości euklidesowej (IBM Corp., b.d.-a). Bez wcześniejszych wyników z wybierz tu Transform Values → Z scores (IBM Corp., b.d.-b) – dla zmiennych, nie przypadków.
- Statistics. Zostaw Agglomeration schedule i w Cluster Membership wybierz Range of solutions od 2 do 5.
- Plots: Dendrogram (wykres sopelkowy przy 150 osobach jest nieczytelny). Save: przynależność dla jednego rozwiązania (3 skupienia). Kliknij OK albo Paste.
Liczby w tabelach policzono w R tymi samymi metodami co SPSS. Dokumentacja HTML opisuje treść tabel, a nie ich nagłówki, więc nie odtwarzamy wyglądu wydruku.
Przegląd aglomeracji (Agglomeration Schedule) pokazuje, które przypadki lub skupienia łączą się na każdym etapie i w jakiej odległości (IBM Corp., b.d.-b). Przy 150 osobach jest 149 etapów; skupienie nosi numer najmniejszego przypadku. Do pracy liczy się koniec tabeli:
| Etap | Łączone skupienia | Przyrost sumy kwadratów | Suma kwadratów wewnątrz skupień | Liczba skupień po etapie | Następny etap |
|---|---|---|---|---|---|
| 144 | 3 i 20 | 12.93 | 175.75 | 6 | 146 |
| 145 | 12 i 16 | 13.44 | 189.19 | 5 | 147 |
| 146 | 3 i 7 | 19.99 | 209.17 | 4 | 149 |
| 147 | 2 i 12 | 22.17 | 231.35 | 3 | 148 |
| 148 | 1 i 2 | 121.76 | 353.10 | 2 | 149 |
| 149 | 1 i 3 | 242.90 | 596.00 | 1 | 0 |
Jak czytać? Metoda Warda na każdym etapie łączy te dwa skupienia, których połączenie najmniej zwiększa sumę kwadratów odchyleń od średnich skupień. Do etapu 147 przyrosty są małe (najwyżej 22.17), a połączenie z etapu 148 kosztuje 121.76 – ponad pięć razy więcej. Zatrzymujemy się przed skokiem: trzy skupienia (43, 53 i 54 osoby). Przy czterech pojawiłaby się grupa 20 osób.
Uwaga na kolumnę współczynników. Murtagh i Legendre (2014) pokazują, że programy implementują metodę Warda różnie, także z różnym zapisem kryterium łączenia. Dlatego wartości z kolumny współczynników w SPSS mogą mieć inną skalę niż nasza kolumna przyrostów. Na przykład hclust() w R podaje wysokości równe dwukrotności przyrostu sumy kwadratów, a dokumentacja HTML nie podaje wzoru SPSS. Interpretuj skoki, nie same wartości. Dendrogram SPSS jest skalowany odległościami łączenia (IBM Corp., b.d.-a): skok widać jako długie pionowe odcinki przed ostatnimi połączeniami.
Krok 2: K-Means Cluster
K-średnich „dopracowuje” rozwiązanie Warda: osoba zmienia skupienie, jeśli bliżej jej do innego środka. Steinley (2006) w przeglądzie badań nad tą metodą omawia między innymi wybór punktów startowych i przygotowanie zmiennych.
- Analyze → Classify → K-Means Cluster (IBM Corp., b.d.-c). Te same zmienne Z, Number of Clusters = 3, metoda Iterate and classify.
- Iterate. Podnieś Maximum Iterations, na przykład do 20, jak w studium przypadku IBM (IBM Corp., b.d.-e). Domyślny limit w składni to 10 iteracji (IBM Corp., b.d.-a). Zatrzymanie na limicie może dać niestabilne rozwiązanie (IBM Corp., b.d.-e). Use running means zostaw wyłączone – środki są wtedy przeliczane po przypisaniu wszystkich osób (IBM Corp., b.d.-c).
- Save. Zaznacz Cluster membership i Distance from cluster center. SPSS doda zmienne
QCL_1(numer skupienia) iQCL_2(odległość od środka) (IBM Corp., b.d.-a). - Options. Zaznacz Initial cluster centers i ANOVA table. Braki: Exclude cases listwise.
Punkty startowe i kolejność wierszy. Domyślny sposób wybierania środków startowych zależy od kolejności przypadków, a IBM radzi powtórzyć analizę przy różnych kolejnościach (IBM Corp., b.d.-c). Algorytmu SPSS nie odtwarzamy, ale mechanizm widać w R: 20 uruchomień po przetasowaniu wierszy, start od trzech pierwszych osób. Wynik: 10 razy suma kwadratów wewnątrz skupień 231.35, 9 razy 231.47 (dwie osoby w innym skupieniu), raz 318.89, czyli wyraźnie gorsze rozwiązanie. Wybierz rozwiązanie z najmniejszą sumą kwadratów albo podaj środki startowe sam – ze średnich wyników z w skupieniach Warda (podkomenda /INITIAL, przepis 1). Tu daje to od razu najlepsze rozwiązanie, identyczne z podziałem Warda.
Tabele. Studium przypadku IBM pokazuje: Initial Cluster Centers, Iteration History, Final Cluster Centers, Distances between Final Cluster Centers, ANOVA i Number of Cases in each Cluster (IBM Corp., b.d.-e). Iteration History pokazuje przesunięcia środków w kolejnych iteracjach – u nas przy starcie od trzech pierwszych osób w trzeciej iteracji spadły do zera.
Najważniejsza jest tabela Final Cluster Centers: średnie zmiennych w każdym skupieniu (IBM Corp., b.d.-e). Na zmiennych Z czytasz ją jak profil: 0 to średnia próby, +1 – jedno odchylenie standardowe powyżej. Dodaj średnie w jednostkach pierwotnych. Numeracja skupień w SPSS może być inna niż nasza.
| Zmienna | 1 – wycofani | 2 – zrywowi | 3 – systematyczni |
|---|---|---|---|
| Znauka | −0.71 (6.8 godz.) | −0.38 (8.9 godz.) | 0.94 (17.3 godz.) |
| Zprokrastynacja | 0.31 (3.29) | 0.83 (3.84) | −1.07 (1.83) |
| Zzaangazowanie | −1.31 (2.61) | 0.20 (4.71) | 0.85 (5.61) |
| Zsen | 0.66 (7.8 godz.) | −0.91 (6.3 godz.) | 0.37 (7.5 godz.) |
| Liczba osób (Number of Cases) | 43 | 53 | 54 |
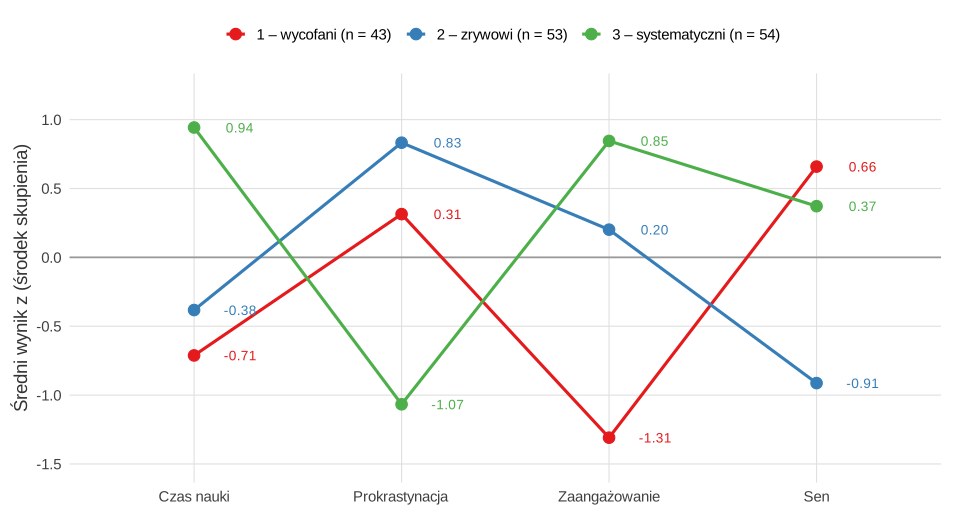
Distances between Final Cluster Centers: najbliżej siebie są wycofani i zrywowi (2.27), najdalej wycofani i systematyczni (3.06). Zapisana odległość od środka (średnio 1.18, najwyżej 2.31) wskazuje osoby słabo pasujące do skupienia.
Krok 3: tabela ANOVA – tylko opisowo
Tabela ANOVA podaje dla każdej zmiennej jednowymiarowy test F: średni kwadrat między skupieniami, średni kwadrat błędu, stopnie swobody, F i istotność. U nas: zaangażowanie F = 242.94, prokrastynacja 161.61, czas nauki 79.76, sen 65.66, wszystkie przy df = 2 i 147 oraz p < .001.
Tych p nie wolno interpretować. Dokumentacja IBM pisze to wprost: „The F tests are only descriptive and the resulting probabilities should not be interpreted” (IBM Corp., b.d.-c). Command Syntax Reference dodaje, że te testy nie powinny służyć do sprawdzania hipotezy zerowej o braku różnic między skupieniami (IBM Corp., b.d.-a). Procedura sama układa grupy tak, żeby się różniły, więc statystyki są „oportunistyczne”; ich względna wielkość pokazuje tylko, które zmienne najmocniej rozdzielają skupienia (IBM Corp., b.d.-c) – u nas zaangażowanie.
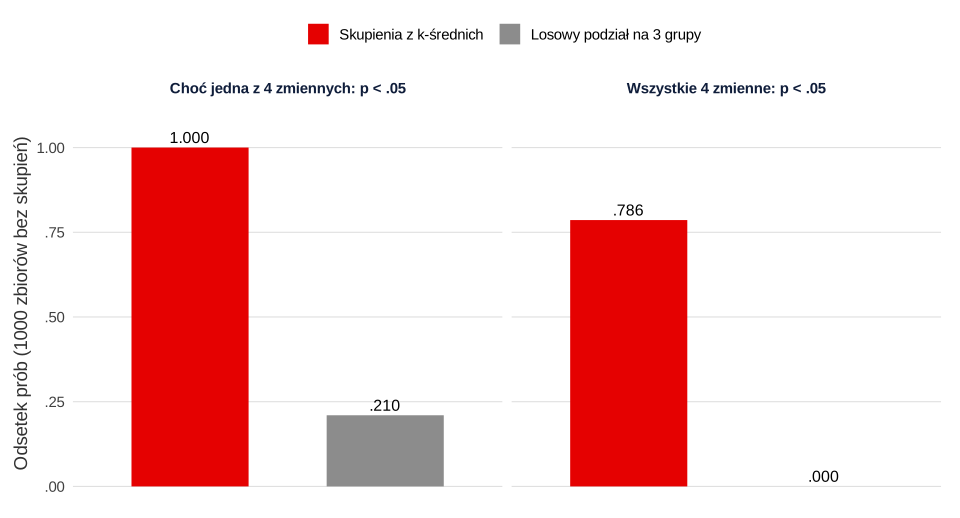
Symulacja z rysunku 2 pokazuje to na danych, w których nie ma żadnych skupień. Gdy grupy utworzyło k-średnich, co najmniej jedna zmienna dawała p < .05 w 100% prób, a wszystkie cztery naraz w 78.6%. Przy losowym podziale te odsetki wynosiły 21.0% i 0%. Istotne F nie dowodzi więc, że skupienia istnieją. Więcej mówią sylwetka i stabilność (wpis o analizie skupień w R) oraz walidacja zewnętrzna.
TwoStep Cluster i sylwetka w Model Summary
Analyze → Classify → TwoStep Cluster przydaje się, gdy masz zmienne jakościowe albo dużą próbę (IBM Corp., b.d.-d). Najważniejsze ustawienia według dokumentacji:
- Distance Measure: domyślnie Log-likelihood (zakłada niezależne zmienne, normalne ilościowe i wielomianowe jakościowe; według IBM procedura jest dość odporna na naruszenia) albo Euclidean – tylko dla zmiennych ilościowych (IBM Corp., b.d.-a, b.d.-d).
- Number of Clusters: Determine automatically z maksimum (domyślnie 15) albo Specify fixed. Program porównuje rozwiązania od 1 do maksimum według BIC (domyślnie) albo AIC (IBM Corp., b.d.-a).
- Options: zmienne ilościowe z listy To be Standardized algorytm standaryzuje sam; zmienne Z przenieś do Assumed Standardized (IBM Corp., b.d.-d). Jest też obsługa szumu (noise handling) dla obserwacji odstających.
- Output: Evaluation fields (zmienne spoza grupowania) i Create cluster membership variable (zmienna
tsc_n) (IBM Corp., b.d.-d).
Wynik także tu może zależeć od kolejności przypadków (IBM Corp., b.d.-d). Wyniki ogląda się w Model Viewer. Widok Model Summary podaje algorytm, liczbę zmiennych, liczbę skupień i sylwetkę spójności i separacji. Pasek z oceną poor, fair albo good opiera się według dokumentacji na słownych kategoriach siły struktury skupień z klasycznego podręcznika analizy skupień. Widok Clusters pokazuje wielkość skupień i profile, a Predictor Importance – względną ważność zmiennych (IBM Corp., b.d.-d).
Uwaga: SPSS liczy tę sylwetkę względem środków skupień: średnia z (B − A)/max(A, B), gdzie A to odległość osoby od środka jej skupienia, a B – od najbliższego innego środka (IBM Corp., b.d.-d). Klasyczna sylwetka Rousseeuwa (1987) z R (hasło wskaźnik sylwetki) używa średnich odległości od osób skupienia. To dwie różne liczby:
| Liczba skupień | Sylwetka Rousseeuwa (R) | Sylwetka wobec środków (wzór z dokumentacji SPSS) |
|---|---|---|
| 2 | .375 | .512 |
| 3 | .392 | .529 |
| 4 | .325 | .478 |
| 5 | .258 | .411 |
| 6 | .219 | .368 |
Obie wersje wskazują trzy skupienia, ale wersja „środkowa” jest o 0.14–0.15 wyższa. Nie porównuj więc sylwetki z Model Summary z wynikami z R; w pracy napisz, którą wersję podajesz. W danych bez skupień sylwetka Rousseeuwa dla k = 3 wynosiła średnio .191. Samego algorytmu TwoStep nie odtwarzamy w R, więc nie podajemy jego liczb.
Walidacja zewnętrzna: czy skupienia coś znaczą
Skupienia sprawdź na zmiennej, której nie użyto do grupowania, najlepiej z hipotezą postawioną przed analizą. U nas to średnia ocen. Zmienną QCL_1 wstaw jako czynnik w ANOVA w SPSS. Średnie ocen: wycofani 3.56 (SD = 0.38), zrywowi 3.71 (0.44), systematyczni 4.31 (0.34); F(2, 147) = 53.13, p < .001, η² = .42. Według testu Tukeya systematyczni mieli wyższą średnią niż wycofani (różnica 0.75, 95% CI [0.56, 0.94], p < .001) i niż zrywowi (0.60, 95% CI [0.43, 0.78], p < .001). Wycofani i zrywowi nie różnili się istotnie (0.15, 95% CI [−0.04, 0.34], p = .153). Skupienia wciąż są jednak wynikiem eksploracji. IBM zaleca traktować rozwiązanie jako wstępne i potwierdzić je na niezależnej próbie (IBM Corp., b.d.-b).
Do przypisywania nowych osób do gotowych skupień służy analiza dyskryminacyjna (wpis analiza dyskryminacyjna w SPSS); trafność klasyfikacji na tych samych zmiennych będzie jednak zawyżona.
Jak opisać analizę skupień w pracy
W Metodzie podaj zmienne, standaryzację, metodę, miarę odległości, sposób wyboru liczby skupień i sprawdzenie stabilności; w Wynikach – liczebności, profile i walidację zewnętrzną. Wzór do dostosowania:
Profile pokaż w tabeli średnich (w jednostkach pierwotnych i z) z liczebnościami. Zdania do ANOVA na zmiennej zewnętrznej przygotuje generator opisu wyników APA. Jak podać wersję SPSS w Metodzie, opisuje hasło IBM SPSS Statistics.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według opisu poleceń DESCRIPTIVES, CLUSTER i QUICK CLUSTER w Command Syntax Reference (IBM Corp., b.d.-a), ale nie uruchamialiśmy jej w SPSS. Przepisy 2–5 w R tworzą pliki do pobrania i liczą wszystkie liczby z tekstu: standaryzację, przegląd aglomeracji metody Warda, k-średnich algorytmem przeliczającym środki po przypisaniu wszystkich osób (jak domyślne KMEANS(NOUPDATE) w SPSS), dwie wersje sylwetki, symulację testów F w danych bez skupień i walidację zewnętrzną. Ziarna: set.seed(25) dla danych (wybrane spośród 30, patrz wyżej), pozostałe ustawione bez sprawdzania wyników.
1. Składnia SPSS: wyniki z, metoda Warda i k-średnich
SPSS
* Składnia zgodna z opisem poleceń w Command Syntax Reference; nie była uruchamiana w SPSS.
* 1. Wyniki z (nowe zmienne Znauka, Zprokrastynacja, Zzaangazowanie, Zsen).
DESCRIPTIVES VARIABLES=nauka prokrastynacja zaangazowanie sen
  /SAVE.

* 2. Hierarchiczna: metoda Warda, kwadrat odległości euklidesowej.
CLUSTER Znauka Zprokrastynacja Zzaangazowanie Zsen
  /MEASURE=SEUCLID
  /METHOD=WARD
  /PRINT=SCHEDULE CLUSTER(2,5)
  /PLOT=DENDROGRAM
  /SAVE=CLUSTER(3).

* 3. K-średnich ze środkami startowymi ze średnich skupień Warda (skupienie po skupieniu).
QUICK CLUSTER Znauka Zprokrastynacja Zzaangazowanie Zsen
  /MISSING=LISTWISE
  /CRITERIA=CLUSTER(3) MXITER(20) CONVERGE(0)
  /METHOD=KMEANS(NOUPDATE)
  /INITIAL=(-0.71  0.31 -1.31  0.66
            -0.38  0.83  0.20 -0.91
             0.94 -1.07  0.85  0.37)
  /SAVE=CLUSTER DISTANCE
  /PRINT=INITIAL ANOVA DISTANCE.
2. Dane, pliki .sav i CSV oraz standaryzacja
R
# Analiza skupień w SPSS: dane symulowane i standaryzacja (wyniki z)
# 150 studentów; cztery zmienne do grupowania w różnych jednostkach:
# nauka (godz. tygodniowo), prokrastynacja (1–5), zaangazowanie (1–7), sen (godz. na dobę).
# Średnia ocen NIE wchodzi do grupowania – posłuży do walidacji zewnętrznej.
suppressPackageStartupMessages(library(haven))
set.seed(25)   # ziarno wybrane spośród 30 sprawdzonych (patrz tekst)
n  <- c(55, 50, 45)                                  # trzy profile (znane tylko w symulacji)
mu <- rbind(c(18, 2.0, 5.6, 7.4),                    # systematyczni
            c( 9, 3.9, 4.6, 6.4),                    # zrywowi
            c( 6, 3.3, 2.8, 7.6))                    # wycofani
sdv <- c(4.5, 0.6, 0.8, 0.7)
X <- do.call(rbind, lapply(1:3, function(k) sapply(1:4, function(j) rnorm(n[k], mu[k, j], sdv[j]))))
X[, 1] <- pmin(pmax(round(X[, 1]), 0), 40)
X[, 2] <- pmin(pmax(round(X[, 2], 2), 1), 5)
X[, 3] <- pmin(pmax(round(X[, 3], 2), 1), 7)
X[, 4] <- pmin(pmax(round(X[, 4], 1), 4), 10)
profil <- rep(1:3, n)
ocena <- round(pmin(pmax(rnorm(150, c(4.3, 3.7, 3.6)[profil], 0.4), 2), 5), 2)
o <- sample(150)                                     # losowa kolejność wierszy
dane <- data.frame(id = 1:150, nauka = X[o, 1], prokrastynacja = X[o, 2],
                   zaangazowanie = X[o, 3], sen = X[o, 4], srednia_ocen = ocena[o])

# Plik .sav z etykietami zmiennych oraz ten sam zbiór w CSV
sav <- dane
etyk <- c(id = "Numer osoby", nauka = "Czas nauki (godz. tygodniowo)",
          prokrastynacja = "Prokrastynacja (1–5)", zaangazowanie = "Zaangażowanie w studia (1–7)",
          sen = "Sen (godz. na dobę)", srednia_ocen = "Średnia ocen (2–5)")
for (v in names(etyk)) sav[[v]] <- labelled(sav[[v]], label = etyk[[v]])
write_sav(sav, "analiza-skupien-spss-dane.sav")
write.csv(dane, "analiza-skupien-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

zm <- c("nauka", "prokrastynacja", "zaangazowanie", "sen")
cat("Statystyki opisowe zmiennych do grupowania:\n")
print(round(sapply(dane[zm], function(x) c(M = mean(x), SD = sd(x), min = min(x), max = max(x))), 2))

# Wyniki z: (x - M) / SD – to samo robi Descriptives z opcją zapisu standaryzowanych wartości
z <- scale(dane[zm])
colnames(z) <- paste0("Z", zm)
cat("\nPo standaryzacji: średnie i SD\n")
print(round(rbind(M = colMeans(z), SD = apply(z, 2, sd)), 2))

# Ile „waży” każda zmienna w kwadracie odległości euklidesowej? Udział wariancji
cat("\nUdział zmiennej w sumie wariancji: surowe dane vs wyniki z\n")
print(round(rbind(surowe = apply(dane[zm], 2, var) / sum(apply(dane[zm], 2, var)),
                  z = apply(z, 2, var) / sum(apply(z, 2, var))), 3))
Wynik:
Statystyki opisowe zmiennych do grupowania:
    nauka prokrastynacja zaangazowanie  sen
M   11.31           2.96          4.43 7.18
SD   6.37           1.06          1.39 0.96
min  0.00           1.00          1.00 4.80
max 29.00           5.00          7.00 9.50

Po standaryzacji: średnie i SD
   Znauka Zprokrastynacja Zzaangazowanie Zsen
M       0               0              0    0
SD      1               1              1    1

Udział zmiennej w sumie wariancji: surowe dane vs wyniki z
       nauka prokrastynacja zaangazowanie   sen
surowe 0.911          0.025         0.043 0.021
z      0.250          0.250         0.250 0.250
3. Metoda Warda i przegląd aglomeracji
R
# Hierarchical Cluster: metoda Warda, kwadrat odległości euklidesowej, wyniki z
dane <- read.csv("analiza-skupien-spss-dane.csv")
zm <- c("nauka", "prokrastynacja", "zaangazowanie", "sen")
z <- scale(dane[zm])
d2 <- dist(z)^2                                   # squared Euclidean distance
hw <- hclust(d2, method = "ward.D")               # Ward na kwadratach odległości
hw2 <- hclust(dist(z), method = "ward.D2")        # kontrolnie: ward.D2 na zwykłych odległościach
cat("Te same połączenia w ward.D (kwadraty) i ward.D2:", identical(hw$merge, hw2$merge), "\n")

# Przegląd aglomeracji: skupienie nazywamy numerem jego najmniejszego przypadku,
# przyrost sumy kwadratów wewnątrz skupień (kryterium Warda) i suma narastająco
N <- nrow(z); lab <- numeric(0); etap_skup <- integer(0); czlonkowie <- list()
nazwa <- function(m) if (m < 0) -m else min(czlonkowie[[m]])
etap_pow <- function(m) if (m < 0) 0L else m
ess <- function(idx) sum(scale(z[idx, , drop = FALSE], scale = FALSE)^2)
wiersze <- vector("list", N - 1)
for (s in 1:(N - 1)) {
  a <- hw$merge[s, 1]; b <- hw$merge[s, 2]
  ia <- if (a < 0) -a else czlonkowie[[a]]; ib <- if (b < 0) -b else czlonkowie[[b]]
  czlonkowie[[s]] <- c(ia, ib)
  przyrost <- ess(c(ia, ib)) - ess(ia) - ess(ib)
  k1 <- min(nazwa(a), nazwa(b)); k2 <- max(nazwa(a), nazwa(b))
  e1 <- if (nazwa(a) == k1) etap_pow(a) else etap_pow(b); e2 <- if (nazwa(a) == k1) etap_pow(b) else etap_pow(a)
  wiersze[[s]] <- data.frame(etap = s, skupienie_1 = k1, skupienie_2 = k2, przyrost_SS = przyrost,
                             wysokosc_R = hw$height[s], etap_pow_1 = e1, etap_pow_2 = e2)
}
plan <- do.call(rbind, wiersze)
plan$SS_narastajaco <- cumsum(plan$przyrost_SS)
plan$nastepny <- sapply(seq_len(N - 1), function(s) {
  w <- which(hw$merge == s, arr.ind = TRUE); if (length(w)) w[1, "row"] else 0 })
cat("Wysokość w R = 2 × przyrost SS:", isTRUE(all.equal(plan$wysokosc_R, 2 * plan$przyrost_SS)), "\n\n")
cat("Pierwsze 3 i ostatnie 8 etapów:\n")
pokaz <- plan[c(1:3, (N - 8):(N - 1)), c("etap", "skupienie_1", "skupienie_2", "przyrost_SS",
                                        "SS_narastajaco", "etap_pow_1", "etap_pow_2", "nastepny")]
pokaz$przyrost_SS <- round(pokaz$przyrost_SS, 3); pokaz$SS_narastajaco <- round(pokaz$SS_narastajaco, 3)
print(pokaz, row.names = FALSE)
cat("Całkowita suma kwadratów wyników z = (N - 1) × 4 =", (N - 1) * 4, "\n")

# Przynależność dla zakresu rozwiązań 2–5 (liczebności)
for (k in 2:5) { cat("\nk =", k, ": "); print(as.vector(table(cutree(hw, k)))) }
dane$ward3 <- cutree(hw, 3)
cat("\nŚrednie wyników z w trzech skupieniach Warda:\n")
print(round(aggregate(as.data.frame(z), list(skupienie = dane$ward3), mean), 2))
Wynik:
Te same połączenia w ward.D (kwadraty) i ward.D2: TRUE
Wysokość w R = 2 × przyrost SS: TRUE

Pierwsze 3 i ostatnie 8 etapów:
 etap skupienie_1 skupienie_2 przyrost_SS SS_narastajaco etap_pow_1 etap_pow_2 nastepny
    1           4          50       0.016          0.016          0          0       57
    2         113         147       0.029          0.045          0          0       68
    3          41          44       0.040          0.086          0          0       51
  142           5           9      10.756        151.108        121        137      143
  143           1           5      11.710        162.818        140        142      148
  144           3          20      12.927        175.745        138        136      146
  145          12          16      13.441        189.186        139        135      147
  146           3           7      19.988        209.174        144        141      149
  147           2          12      22.173        231.347        133        145      148
  148           1           2     121.755        353.103        143        147      149
  149           1           3     242.897        596.000        148        146        0
Całkowita suma kwadratów wyników z = (N - 1) × 4 = 596

k = 2 : [1] 96 54

k = 3 : [1] 43 53 54

k = 4 : [1] 43 20 54 33

k = 5 : [1] 43 20 32 22 33

Średnie wyników z w trzech skupieniach Warda:
  skupienie nauka prokrastynacja zaangazowanie   sen
1         1 -0.71           0.31         -1.31  0.66
2         2 -0.38           0.83          0.20 -0.91
3         3  0.94          -1.07          0.85  0.37
4. K-średnich jak w K-Means Cluster
R
# K-Means Cluster: k = 3 na wynikach z, wsadowa aktualizacja środków (jak KMEANS(NOUPDATE))
dane <- read.csv("analiza-skupien-spss-dane.csv")
zm <- c("nauka", "prokrastynacja", "zaangazowanie", "sen")
z <- scale(dane[zm]); colnames(z) <- paste0("Z", zm)
ward3 <- cutree(hclust(dist(z)^2, method = "ward.D"), 3)

# Algorytm Lloyda/Forgy'ego: przypisz wszystkie osoby, potem przelicz środki (do 20 iteracji)
lloyd <- function(z, start, maxit = 20) {
  srodki <- as.matrix(start); historia <- NULL
  for (it in 1:maxit) {
    odl <- sapply(1:nrow(srodki), function(k) colSums((t(z) - srodki[k, ])^2))
    skup <- max.col(-odl)
    nowe <- t(sapply(1:nrow(srodki), function(k) colMeans(z[skup == k, , drop = FALSE])))
    zmiana <- sqrt(rowSums((nowe - srodki)^2))
    historia <- rbind(historia, c(iteracja = it, setNames(zmiana, paste0("skupienie_", seq_along(zmiana)))))
    srodki <- nowe
    if (max(zmiana) == 0) break
  }
  list(skup = skup, srodki = srodki, historia = historia)
}
# Środki startowe: trzy pierwsze osoby w pliku (SPSS wybiera je inaczej – tego nie odtwarzamy)
wss <- function(sk) sum(sapply(unique(sk), function(k) sum(scale(z[sk == k, ], scale = FALSE)^2)))
wyn1 <- lloyd(z, z[1:3, ])
cat("Start z trzech pierwszych osób – historia iteracji (przesunięcie środków w jednostkach z):\n")
print(round(wyn1$historia, 3))
cat("Suma kwadratów wewnątrz skupień:", round(wss(wyn1$skup), 2), "\n")

# Start ze średnich skupień Warda (własne środki startowe)
start_ward <- t(sapply(1:3, function(k) colMeans(z[ward3 == k, ])))
wyn <- lloyd(z, start_ward)
cat("\nStart ze średnich Warda – historia iteracji:\n"); print(round(wyn$historia, 3))
cat("Suma kwadratów wewnątrz skupień:", round(wss(wyn$skup), 2), "\n")
cat("Ten sam podział co Ward:", all(wyn$skup == ward3), "\n")
cat("Środki startowe do /INITIAL (zaokrąglone, skupienie po skupieniu):\n"); print(round(start_ward, 2))
cat("Ten sam podział przy starcie z zaokrąglonych środków:", all(lloyd(z, round(start_ward, 2))$skup == ward3), "\n")
skup <- wyn$skup; srodki <- wyn$srodki

# Czy wynik zależy od kolejności wierszy? 20 losowych kolejności, start = trzy pierwsze osoby
set.seed(543)
proby <- replicate(20, { o <- sample(nrow(z)); w <- lloyd(z[o, ], z[o[1:3], ])
  sk <- integer(nrow(z)); sk[o] <- w$skup; round(wss(sk), 2) })
cat("\nSuma kwadratów wewnątrz skupień w 20 kolejnościach wierszy:\n"); print(table(proby))

# Kontrolnie: kmeans() w R (domyślnie Hartigan–Wong) z 50 losowymi startami
set.seed(2543)
km <- kmeans(z, centers = 3, nstart = 50)
cat("\nkmeans(nstart = 50): suma kwadratów =", round(km$tot.withinss, 2), "\n"); print(table(lloyd = skup, kmeans = km$cluster))

cat("\nFinal Cluster Centers (wyniki z):\n"); print(round(t(srodki), 2))
cat("\nTe same środki w jednostkach pierwotnych:\n")
print(round(t(aggregate(dane[zm], list(skupienie = skup), mean)[, -1]), 2))
cat("\nDistances between Final Cluster Centers:\n"); print(round(as.matrix(dist(srodki)), 3))
cat("\nNumber of Cases in each Cluster:\n"); print(table(skup))

# ANOVA: dla każdej zmiennej średni kwadrat skupień i błędu, F, p (tylko opisowo!)
cat("\nANOVA:\n")
an <- t(sapply(colnames(z), function(v) {
  a <- anova(lm(z[, v] ~ factor(skup)))
  c(MS_skupienia = a[1, "Mean Sq"], df1 = a[1, "Df"], MS_blad = a[2, "Mean Sq"], df2 = a[2, "Df"],
    F = a[1, "F value"], p = a[1, "Pr(>F)"])
}))
an <- as.data.frame(round(an, 3)); an$p <- format.pval(an$p, digits = 3, eps = .001)
print(an)

# Odległość każdej osoby od środka jej skupienia (to, co zapisuje opcja Save)
odl_wlasna <- sqrt(rowSums((z - srodki[skup, ])^2))
cat("\nOdległość od środka skupienia: M =", round(mean(odl_wlasna), 3), " max =", round(max(odl_wlasna), 3), "\n")

# Bez standaryzacji: k-średnich na surowych zmiennych
km_surowe <- kmeans(dane[zm], centers = 3, nstart = 50)
cat("\nPodział na surowych danych a podział na wynikach z:\n"); print(table(surowe = km_surowe$cluster, z = skup))
cat("Średni czas nauki w skupieniach z surowych danych:", round(tapply(dane$nauka, km_surowe$cluster, mean), 1), "\n")
Wynik:
Start z trzech pierwszych osób – historia iteracji (przesunięcie środków w jednostkach z):
     iteracja skupienie_1 skupienie_2 skupienie_3
[1,]        1       1.094       0.663       0.506
[2,]        2       0.402       0.287       0.041
[3,]        3       0.000       0.000       0.000
Suma kwadratów wewnątrz skupień: 231.47

Start ze średnich Warda – historia iteracji:
     iteracja skupienie_1 skupienie_2 skupienie_3
[1,]        1           0           0           0
Suma kwadratów wewnątrz skupień: 231.35
Ten sam podział co Ward: TRUE
Środki startowe do /INITIAL (zaokrąglone, skupienie po skupieniu):
     Znauka Zprokrastynacja Zzaangazowanie  Zsen
[1,]  -0.71            0.31          -1.31  0.66
[2,]  -0.38            0.83           0.20 -0.91
[3,]   0.94           -1.07           0.85  0.37
Ten sam podział przy starcie z zaokrąglonych środków: TRUE

Suma kwadratów wewnątrz skupień w 20 kolejnościach wierszy:
proby
231.35 231.47 318.89
    10      9      1

kmeans(nstart = 50): suma kwadratów = 231.35
     kmeans
lloyd  1  2  3
    1 43  0  0
    2  0 53  0
    3  0  0 54

Final Cluster Centers (wyniki z):
                 [,1]  [,2]  [,3]
Znauka          -0.71 -0.38  0.94
Zprokrastynacja  0.31  0.83 -1.07
Zzaangazowanie  -1.31  0.20  0.85
Zsen             0.66 -0.91  0.37

Te same środki w jednostkach pierwotnych:
               [,1] [,2]  [,3]
nauka          6.77 8.87 17.31
prokrastynacja 3.29 3.84  1.83
zaangazowanie  2.61 4.71  5.61
sen            7.81 6.30  7.53

Distances between Final Cluster Centers:
      1     2     3
1 0.000 2.265 3.061
2 2.265 0.000 2.725
3 3.061 2.725 0.000

Number of Cases in each Cluster:
skup
 1  2  3
43 53 54

ANOVA:
                MS_skupienia df1 MS_blad df2       F      p
Znauka                38.770   2   0.486 147  79.755 <0.001
Zprokrastynacja       51.210   2   0.317 147 161.612 <0.001
Zzaangazowanie        57.196   2   0.235 147 242.944 <0.001
Zsen                  35.150   2   0.535 147  65.655 <0.001

Odległość od środka skupienia: M = 1.181  max = 2.306

Podział na surowych danych a podział na wynikach z:
      z
surowe  1  2  3
     1 27 27  1
     2  0  2 30
     3 16 24 23
Średni czas nauki w skupieniach z surowych danych: 4.7 20.4 12.4
5. Sylwetka, testy F bez skupień i walidacja zewnętrzna
R
# Sylwetka (dwie wersje), testy F w danych bez skupień i walidacja zewnętrzna
suppressPackageStartupMessages(library(cluster))
dane <- read.csv("analiza-skupien-spss-dane.csv")
zm <- c("nauka", "prokrastynacja", "zaangazowanie", "sen")
z <- scale(dane[zm]); D <- dist(z)

# Sylwetka „środkowa” jak w opisie Model Summary SPSS: A = odległość od środka własnego skupienia,
# B = odległość od najbliższego innego środka; średnia z (B - A) / max(A, B)
sylwetka_srodki <- function(z, sk) {
  C <- t(sapply(sort(unique(sk)), function(k) colMeans(z[sk == k, , drop = FALSE])))
  odl <- sapply(1:nrow(C), function(k) sqrt(colSums((t(z) - C[k, ])^2)))
  A <- odl[cbind(1:nrow(z), sk)]; odl[cbind(1:nrow(z), sk)] <- Inf; B <- apply(odl, 1, min)
  mean((B - A) / pmax(A, B))
}
set.seed(5431)
cat("Średnia sylwetka dla k = 2–6 (k-średnich, 50 startów):\n")
tab <- t(sapply(2:6, function(k) { sk <- kmeans(z, k, nstart = 50)$cluster
  c(k = k, Rousseeuw = mean(silhouette(sk, D)[, "sil_width"]), srodki_SPSS = sylwetka_srodki(z, sk)) }))
print(round(tab, 3))

# Dane bez żadnych skupień: 150 osób z jednej populacji (4 niezależne zmienne normalne)
set.seed(5432)
jedna_proba <- function() {
  x <- matrix(rnorm(150 * 4), ncol = 4)
  sk_km <- kmeans(x, 3, nstart = 20)$cluster              # podział z k-średnich
  sk_los <- sample(rep(1:3, 50))                          # podział losowy
  p <- function(sk) apply(x, 2, function(v) anova(lm(v ~ factor(sk)))[1, "Pr(>F)"])
  c(km_wszystkie = all(p(sk_km) < .05), los_wszystkie = all(p(sk_los) < .05),
    km_ktorakolwiek = any(p(sk_km) < .05), los_ktorakolwiek = any(p(sk_los) < .05),
    sylwetka_km = mean(silhouette(sk_km, dist(x))[, "sil_width"]))
}
sym <- replicate(1000, jedna_proba())
cat("\nDane bez skupień, 1000 powtórzeń: odsetek prób z p < .05 w tabeli ANOVA\n")
print(round(rowMeans(sym[1:4, ]), 3))
cat("Średnia sylwetka k-średnich w danych bez skupień: M =", round(mean(sym[5, ]), 3),
    " zakres", round(range(sym[5, ]), 3), "\n")

# Walidacja zewnętrzna: średnia ocen (nie użyta do grupowania) w trzech skupieniach
sk <- cutree(hclust(D^2, method = "ward.D"), 3)
dane$skupienie <- factor(sk, labels = c("wycofani", "zrywowi", "systematyczni"))
cat("\nŚrednia ocen w skupieniach:\n")
print(round(do.call(rbind, tapply(dane$srednia_ocen, dane$skupienie, function(x) c(M = mean(x), SD = sd(x), n = length(x)))), 2))
a <- anova(lm(srednia_ocen ~ skupienie, data = dane)); print(a)
cat("eta^2 =", round(a[1, "Sum Sq"] / sum(a[, "Sum Sq"]), 3), "\n")
print(TukeyHSD(aov(srednia_ocen ~ skupienie, data = dane)), digits = 3)
Wynik:
Średnia sylwetka dla k = 2–6 (k-średnich, 50 startów):
     k Rousseeuw srodki_SPSS
[1,] 2     0.375       0.512
[2,] 3     0.392       0.529
[3,] 4     0.325       0.478
[4,] 5     0.258       0.411
[5,] 6     0.219       0.368

Dane bez skupień, 1000 powtórzeń: odsetek prób z p < .05 w tabeli ANOVA
    km_wszystkie    los_wszystkie  km_ktorakolwiek los_ktorakolwiek
           0.786            0.000            1.000            0.210
Średnia sylwetka k-średnich w danych bez skupień: M = 0.191  zakres 0.166 0.225

Średnia ocen w skupieniach:
                 M   SD  n
wycofani      3.56 0.38 43
zrywowi       3.71 0.44 53
systematyczni 4.31 0.34 54
Analysis of Variance Table

Response: srednia_ocen
           Df Sum Sq Mean Sq F value    Pr(>F)
skupienie   2 16.087  8.0437  53.131 < 2.2e-16 ***
Residuals 147 22.255  0.1514
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
eta^2 = 0.42
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = srednia_ocen ~ skupienie, data = dane)

$skupienie
                        diff     lwr   upr p adj
zrywowi-wycofani       0.149 -0.0402 0.338 0.153
systematyczni-wycofani 0.753  0.5649 0.942 0.000
systematyczni-zrywowi  0.604  0.4262 0.782 0.000
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- cluster (wersja 2.1.8.2): Maechler, M., Rousseeuw, P., Struyf, A., Hubert, M., & Hornik, K. (2026). cluster: Cluster analysis basics and extensions (R package version 2.1.8.2) [Computer software]. https://CRAN.R-project.org/package=cluster
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy i lista kontrolna
- Brak standaryzacji zmiennych w różnych jednostkach.
- „Skupienia różnią się istotnie na wszystkich zmiennych” jako dowód trafności – błąd koła.
- Jedno uruchomienie K-Means bez sprawdzenia innej kolejności wierszy albo innych środków startowych.
- Za niski limit iteracji.
- Metoda Warda ze zwykłą odległością euklidesową zamiast kwadratu, bez uzasadnienia.
- Porównywanie współczynników aglomeracji albo sylwetki między SPSS a R, jakby były liczone tak samo.
- Nazwy skupień jako fakt, a nie etykieta badacza.
Lista kontrolna przed oddaniem rozdziału: (1) uzasadniony wybór zmiennych i ich standaryzacja; (2) metoda, miara odległości i wersja SPSS w Metodzie; (3) liczba skupień uzasadniona kilkoma wskazówkami, nie jedną; (4) stabilność: inna kolejność wierszy albo inna metoda dają podobny podział; (5) liczebności i tabela profili; (6) walidacja na zmiennej spoza grupowania; (7) brak interpretacji p z tabeli ANOVA w K-Means.
Porównanie k-średnich z LPA: segmentacja respondentów. Dane mieszane poza TwoStep: odległość Gowera.
Najczęstsze pytania
Gdzie w SPSS jest analiza skupień?
W menu Analyze → Classify są trzy procedury: Hierarchical Cluster, K-Means Cluster i TwoStep Cluster (w polskiej dokumentacji: Analizuj → Klasyfikuj → Klaster hierarchiczny, Klaster K-średnich i Klaster „TwoStep”). Dokumentacja IBM podaje, że wymagają opcji Statistics Base. Etykiety w polskim interfejsie mogą brzmieć inaczej niż w dokumentacji.
Czy w analizie skupień w SPSS trzeba standaryzować zmienne?
Tak, jeśli zmienne mają różne jednostki. K-Means Cluster liczy zwykłą odległość euklidesową i sam nie standaryzuje, dlatego IBM radzi najpierw zapisać wyniki z w procedurze Descriptives. Hierarchical Cluster ma standaryzację w oknie Method (Transform Values), a TwoStep – w Options. W przykładzie bez standaryzacji czas nauki odpowiadał za 91% sumy wariancji i sam wyznaczał skupienia.
Czy istotne F w tabeli ANOVA w K-Means oznacza, że skupienia są prawdziwe?
Nie. Procedura sama tworzy grupy, które różnią się na tych zmiennych, więc F musi wyjść duże. Dokumentacja IBM pisze, że testy F są tylko opisowe, a wynikających z nich prawdopodobieństw nie należy interpretować. W symulacji na danych bez żadnych skupień co najmniej jedna zmienna dawała p < .05 w 100% prób. Tabela mówi tylko, które zmienne najmocniej rozdzielają skupienia.
Dlaczego SPSS i R dają w analizie skupień różne liczby?
Najczęstsze przyczyny to inne punkty startowe k-średnich (SPSS wybiera je algorytmem zależnym od kolejności przypadków), inna skala współczynnika łączenia w metodzie Warda, bo programy implementują ją różnie (Murtagh i Legendre, 2014), oraz inna wersja sylwetki. TwoStep w Model Summary liczy sylwetkę względem środków skupień, a R – względem średnich odległości od obiektów. Sam podział powinien być podobny – porównaj tabelę krzyżową przynależności.
Jak wybrać liczbę skupień w SPSS?
Połącz kilka wskazówek: duży skok współczynnika w przeglądzie aglomeracji metody Warda, dendrogram, sylwetkę z Model Summary w TwoStep (albo policzoną w R), liczebność najmniejszego skupienia i interpretowalność profili. TwoStep potrafi wybrać liczbę skupień sam według BIC lub AIC, ale to też tylko jedno kryterium. Szersze omówienie wskaźników jest we wpisie o analizie skupień w R.
Powiązane hasła
Przeczytaj też
Analiza skupień krok po kroku
Ward i dendrogram, k-średnich, sylwetka i statystyka luki, stabilność w podpróbach, kontrola na danych bez skupień i opis APA – na jednym przykładzie w R.
Czytaj →PoradnikSegmentacja respondentów: k-średnich i LPA
Przygotowanie danych, liczba skupień, stabilność, profile latentne w mclust (BIC, entropia, BLRT), walidacja zewnętrzna i opis APA – z kodem R.
Czytaj →PoradnikAnaliza dyskryminacyjna w SPSS krok po kroku
Discriminant od pliku .sav po opis APA: test M Boxa, Eigenvalues, lambda Wilksa, macierz struktury, centroidy, a priori i trafność z walidacji krzyżowej.
Czytaj →Robisz analizę skupień w SPSS do pracy?
Sprawdzimy dobór i standaryzację zmiennych, liczbę skupień, stabilność rozwiązania i opis profili oraz wyjaśnimy wyniki tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- IBM Corp. (b.d.-a). CLUSTER, QUICK CLUSTER, TWOSTEP CLUSTER and DESCRIPTIVES (Command Syntax Reference). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_cluster.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Hierarchical Cluster Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_clus.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). K-Means Cluster Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_quic.html ● Otwarty dostęp
- IBM Corp. (b.d.-d). TwoStep Cluster Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_twostep_main.html ● Otwarty dostęp
- IBM Corp. (b.d.-e). Using K-Means to Classify Customers. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/kmeans_telco_intro.html ● Otwarty dostęp
- Murtagh, F., & Legendre, P. (2014). Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion? Journal of Classification, 31(3), 274–295. https://doi.org/10.1007/s00357-014-9161-z ● Otwarty dostęp: pełny tekst
- Rousseeuw, P. J. (1987). Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65. https://doi.org/10.1016/0377-0427(87)90125-7 ● Otwarty dostęp
- Steinley, D. (2006). K-means clustering: A half-century synthesis. British Journal of Mathematical and Statistical Psychology, 59(1), 1–34. https://doi.org/10.1348/000711005x48266
Cytowania BibTeX
@misc{ibmnd31clusterskladnia, author={{IBM Corp.}}, title={{CLUSTER, QUICK CLUSTER, TWOSTEP CLUSTER and DESCRIPTIVES (Command Syntax Reference)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_cluster.html}}@misc{ibmnd31hierarchicalcluster, author={{IBM Corp.}}, title={{Hierarchical Cluster Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_clus.html}}@misc{ibmnd31kmeanscluster, author={{IBM Corp.}}, title={{K-Means Cluster Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_quic.html}}@misc{ibmnd31twostepcluster, author={{IBM Corp.}}, title={{TwoStep Cluster Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-d}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_twostep_main.html}}@misc{ibmnd31kmeansstudium, author={{IBM Corp.}}, title={{Using K-Means to Classify Customers}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-e}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/kmeans_telco_intro.html}}@article{murtagh2014ward, author={Murtagh, Fionn and Legendre, Pierre}, title={{Ward’s hierarchical agglomerative clustering method: Which algorithms implement Ward’s criterion?}}, journal={Journal of Classification}, year={2014}, volume={31}, number={3}, pages={274--295}, doi={10.1007/s00357-014-9161-z}}@article{rousseeuw1987silhouettes, author={Rousseeuw, Peter J.}, title={{Silhouettes: A graphical aid to the interpretation and validation of cluster analysis}}, journal={Journal of Computational and Applied Mathematics}, year={1987}, volume={20}, pages={53--65}, doi={10.1016/0377-0427(87)90125-7}}@article{steinley2006kmeans, author={Steinley, Douglas}, title={{K-means clustering: A half-century synthesis}}, journal={British Journal of Mathematical and Statistical Psychology}, year={2006}, volume={59}, number={1}, pages={1--34}, doi={10.1348/000711005x48266}}