Kiedy analiza dyskryminacyjna w SPSS
Analiza dyskryminacyjna szuka kombinacji zmiennych ilościowych, które najlepiej odróżniają z góry znane grupy, i na tej podstawie przypisuje osoby do grup. Teorię i przykład w R omawia hasło w słowniku, a tutaj zajmujemy się tylko SPSS. Ogólne zasady czytania wydruku są we wpisie jak czytać wyniki z SPSS.
Zanim klikniesz, ustal, o co pytasz. Jeśli chcesz wiedzieć, na jakich wymiarach różnią się grupy, to opisowa analiza dyskryminacyjna. Sherry (2006) przedstawia ją jako alternatywę dla serii porównań grup i omawia na przykładzie wydruku SPSS. Jeśli chcesz przewidywać przynależność do grupy, liczy się trafność klasyfikacji, ale sprawdzona na danych, których model „nie widział” (Boedeker i Kearns, 2019). Grupy muszą być znane przed analizą. Jeśli dopiero chcesz je odkryć, potrzebujesz analizy skupień, w SPSS opisanej we wpisie analiza skupień w SPSS.
Ścieżki menu, nazwy okien, opcji i tabel sprawdziliśmy w dokumentacji IBM SPSS Statistics 31 (IBM Corp., b.d.-a, b.d.-b, b.d.-c) i podajemy je po angielsku. Polska dokumentacja podaje ścieżkę Analizuj → Klasyfikuj → Dyskryminanta (IBM Corp., b.d.-a). Etykiety w polskim interfejsie programu mogą brzmieć inaczej.
Przykład i pliki do pobrania
Wszystkie liczby pochodzą z jednego zbioru symulowanego. Mamy 160 osób po pierwszym roku studiów w trzech grupach: 90 kontynuuje studia, 40 zmieniło kierunek, a 30 zrezygnowało. Na początku roku zmierzono cztery predyktory: zainteresowanie kierunkiem i poczucie przynależności (skale 1–5), średnią ocen z pierwszego semestru (2–5) oraz liczbę godzin pracy zarobkowej w tygodniu. Czym różnią się te grupy i jak trafnie da się przewidzieć status po roku?
Pobierz plik .sav z etykietami zmiennych i wartości albo ten sam zbiór w pliku CSV (format opisuje hasło plik .sav). Jeden wiersz to jedna osoba. Zmienna status ma kody 1–3 z etykietami. SPSS wymaga, żeby zmienna grupująca miała niewiele kategorii zakodowanych liczbami całkowitymi (IBM Corp., b.d.-a). Jeśli grupy masz zapisane tekstem, przekoduj je najpierw według wpisu przygotowanie danych w SPSS.
Okna procedury krok po kroku
- Analyze → Classify → Discriminant (IBM Corp., b.d.-a).
- Okno główne. Zmienną
statusprzenieś do pola zmiennej grupującej i kliknij Define Range: minimum 1, maksimum 3. Przypadki spoza zakresu nie biorą udziału w wyznaczaniu funkcji, ale SPSS i tak je klasyfikuje (IBM Corp., b.d.-a). Cztery predyktory przenieś na listę Independents. - Metoda. Zostaw Enter independents together, czyli wszystkie predyktory naraz. Druga możliwość, Use stepwise method, uaktywnia okno Stepwise Method z kryteriami doboru zmiennych (IBM Corp., b.d.-a). O tym, dlaczego jej nie polecamy, piszemy niżej.
- Statistics. Zaznacz Means, Univariate ANOVAs i Box's M. W grupie Function Coefficients możesz dodać Unstandardized (wzór funkcji) i Fisher's (funkcje klasyfikacyjne – osoba trafia do grupy z najwyższą wartością). W grupie Matrices przyda się Within-groups correlation (IBM Corp., b.d.-a).
- Okno klasyfikacji (w dokumentacji: Classification). W Prior Probabilities wybierz All groups equal albo Compute from group sizes (o wyborze – w kroku 4). W Display zaznacz Summary table i Leave-one-out classification. Zostaw macierz Within-groups. W Plots możesz zaznaczyć Combined-groups i Territorial map; mapa nie powstaje, gdy jest tylko jedna funkcja (IBM Corp., b.d.-a).
- Okno Save (opcjonalnie): przewidywana grupa, wyniki funkcji i prawdopodobieństwa przynależności zapisane jako nowe zmienne (IBM Corp., b.d.-a).
- Kliknij OK albo Paste, żeby zapisać składnię.
Wyniki pokazujemy w tabelach o układzie tabel SPSS. Liczby policzono w R tymi samymi metodami co SPSS; układ tabeli jak w SPSS. Nazwy i zawartość tabel pochodzą z dokumentacji (IBM Corp., b.d.-b, b.d.-c), a nagłówki kolumn odtworzyliśmy z typowego wydruku. Pogrubiono liczby do pracy. Znak funkcji jest umowny: w Twoim wydruku kolumna może mieć przeciwne znaki.
Krok 1: średnie, testy jednowymiarowe i test M Boxa
Tabela Tests of Equality of Group Means to zwykła jednoczynnikowa ANOVA dla każdego predyktora osobno (IBM Corp., b.d.-a). Jednowymiarowa lambda Wilksa to tu stosunek zmienności wewnątrzgrupowej do całkowitej, więc im mniejsza, tym silniej zmienna różnicuje grupy.
| Wilks' Lambda | F | df1 | df2 | Sig. | |
|---|---|---|---|---|---|
| zainteresowanie | .709 | 32.234 | 2 | 157 | < .001 |
| przynaleznosc | .874 | 11.354 | 2 | 157 | < .001 |
| srednia | .849 | 13.966 | 2 | 157 | < .001 |
| praca | .853 | 13.535 | 2 | 157 | < .001 |
Grupy różnią się na każdym predyktorze. Najsilniej różnicuje zainteresowanie kierunkiem: średnio 3.85 u kontynuujących, 2.93 u zmieniających kierunek i 3.15 u rezygnujących.
Analiza zakłada jednakowe macierze wariancji–kowariancji w grupach (IBM Corp., b.d.-a). Sprawdza to test M Boxa, a obok niego SPSS pokazuje tabelę Log Determinants. Duże różnice logarytmów wyznaczników sugerują różne macierze kowariancji (IBM Corp., b.d.-b).
| status | Rank | Log Determinant |
|---|---|---|
| kontynuuje | 4 | .338 |
| zmienił kierunek | 4 | −.024 |
| zrezygnował | 4 | .055 |
| Pooled within-groups | 4 | .344 |
| Box's M | 23.262 | |
| F (df1, df2) | 1.108 (20, 30180.822) | |
| Sig. | .332 | |
p = .332, więc test nie wskazuje na różne macierze kowariancji. Dokumentacja IBM ostrzega, że test Boxa jest wrażliwy na odejścia od wielowymiarowej normalności (IBM Corp., b.d.-a). Gdy wyjdzie istotny, studium przypadku IBM radzi powtórzyć klasyfikację z macierzami osobnymi dla grup (Separate-groups) i sprawdzić, czy wyniki wyraźnie się zmieniają (IBM Corp., b.d.-b). Sprawdź też wielowymiarowe obserwacje odstające (odległość Mahalanobisa).
Krok 2: Eigenvalues i Wilks' Lambda
Przy trzech grupach i czterech predyktorach SPSS wyznacza dwie funkcje dyskryminacyjne (liczba grup minus jeden). Tabela Eigenvalues podaje dla każdej funkcji wartość własną, procent wariancji, procent skumulowany i korelację kanoniczną. Tabela Wilks' Lambda testuje, czy średnie funkcji w grupach są równe (IBM Corp., b.d.-b, b.d.-c).
| Function | Eigenvalue | % of Variance | Cumulative % | Canonical Correlation |
|---|---|---|---|---|
| 1 | .434 | 58.4 | 58.4 | .550 |
| 2 | .309 | 41.6 | 100.0 | .486 |
| Test of Function(s) | Wilks' Lambda | Chi-square | df | Sig. |
|---|---|---|---|---|
| 1 through 2 | .533 | 97.956 | 8 | < .001 |
| 2 | .764 | 41.903 | 3 | < .001 |
Wiersz „1 through 2” sprawdza obie funkcje razem i odpowiada na pytanie, czy grupy w ogóle się różnią. To ta sama lambda Wilksa, którą dałaby MANOVA z grupą jako czynnikiem i czterema zmiennymi jako zależnymi. Szerzej o tym związku piszą wpisy MANOVA krok po kroku i MANOVA w SPSS. Wiersz „2” testuje, czy po usunięciu pierwszej funkcji coś jeszcze różnicuje grupy. Tu tak, więc interpretujemy obie funkcje (58.4% i 41.6% zmienności międzygrupowej).
Krok 3: współczynniki, Structure Matrix i centroidy
Do interpretacji służą trzy tabele z domyślnego wydruku (IBM Corp., b.d.-c). Standardized Canonical Discriminant Function Coefficients to wagi predyktorów po standaryzacji, porównywalne mimo różnych skal (IBM Corp., b.d.-b). Structure Matrix to wewnątrzgrupowe korelacje predyktorów z funkcjami. Gwiazdka oznacza funkcję, z którą zmienna koreluje najsilniej, a zmienne są posortowane według tych korelacji (IBM Corp., b.d.-b).
| Standaryzowane: Function 1 | Standaryzowane: Function 2 | Structure: Function 1 | Structure: Function 2 | |
|---|---|---|---|---|
| zainteresowanie | .935 | .527 | .959* | .192 |
| praca | −.230 | .415 | −.322 | .642* |
| przynaleznosc | −.067 | −.593 | .296 | −.587* |
| srednia | .121 | −.484 | .406 | −.587* |
Przynależność ma w funkcji 1 współczynnik standaryzowany −.07, ale korelację strukturalną .30. Współczynnik pokazuje wkład zmiennej przy kontroli pozostałych, a korelacja – co funkcja „mierzy”. Przy skorelowanych predyktorach współczynniki bywają niestabilne, więc funkcję opisuj głównie z macierzy struktury. Uwaga: SPSS liczy korelacje w obrębie grup. Zwykła korelacja w całej próbie da inne liczby (w kodzie pokazujemy obie).
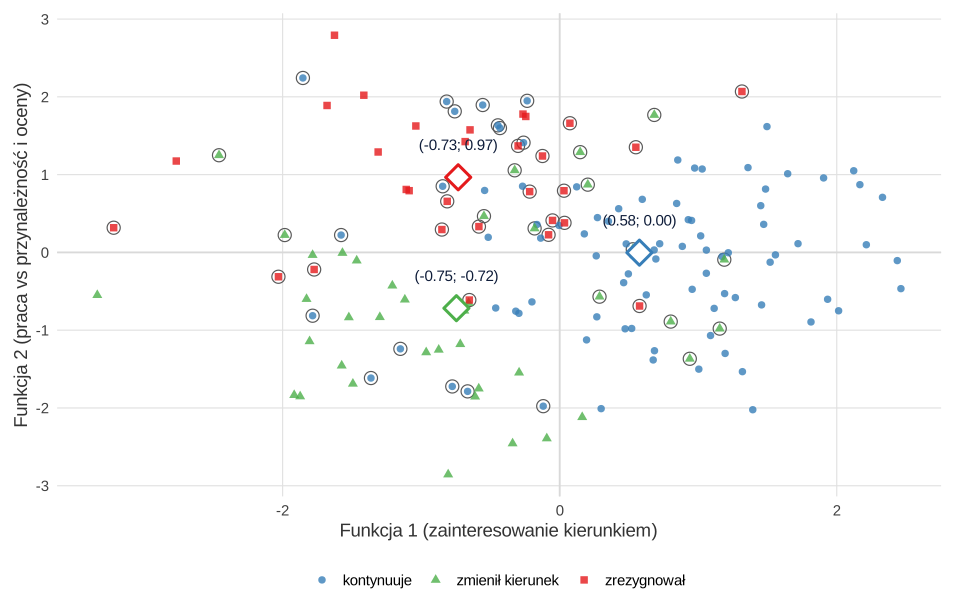
| status | Function 1 | Function 2 |
|---|---|---|
| kontynuuje | .576 | −.003 |
| zmienił kierunek | −.745 | −.717 |
| zrezygnował | −.733 | .966 |
Centroidy to średnie wyniki grup na funkcjach. Razem z macierzą struktury dają opis. Funkcja 1 to głównie zainteresowanie kierunkiem (.96). Odróżnia kontynuujących (0.58) od obu pozostałych grup (−0.75 i −0.73). Funkcja 2 przeciwstawia pracę zarobkową (.64) poczuciu przynależności i ocenom (−.59). Odróżnia rezygnujących (0.97) od osób, które zmieniły kierunek (−0.72). Wniosek w języku pracy: kierunek zmieniają osoby, które straciły zainteresowanie nim, ale mają dobre oceny i czują się częścią grupy. Rezygnują częściej osoby dużo pracujące, słabiej związane z uczelnią i z niższą średnią.
Krok 4: Classification Results i walidacja krzyżowa
Tabela klasyfikacji krzyżuje grupę prawdziwą (wiersze) z przewidywaną (kolumny), czyli jest macierzą pomyłek. Opcja Summary table daje klasyfikację na tej samej próbie, na której wyznaczono funkcje. Opcja Leave-one-out classification dodaje część Cross-validated: każdą osobę klasyfikują funkcje wyznaczone bez niej (IBM Corp., b.d.-a, b.d.-b). To walidacja krzyżowa typu „zostaw jedną obserwację”.
Najpierw prawdopodobieństwa a priori. All groups equal (domyślnie) traktuje grupy jednakowo. Compute from group sizes ustawia je według udziałów grup w próbie, tu .562, .250 i .188 (tabela Prior Probabilities for Groups). A priori wpływają tylko na klasyfikację, nie na funkcje i ich testy (IBM Corp., b.d.-c). Boedeker i Kearns (2019) wymieniają ich wybór wśród decyzji do podjęcia przed analizą. Liczebności z próby wybierz, gdy odzwierciedlają częstości w populacji; gdy grupy dobrano po równo albo zależy Ci na wykrywaniu małej grupy – równe.
| status | kontynuuje | zmienił kierunek | zrezygnował | % poprawnych | |
|---|---|---|---|---|---|
| Ta sama próba | kontynuuje | 73 | 8 | 9 | 81.1 |
| zmienił kierunek | 12 | 27 | 1 | 67.5 | |
| zrezygnował | 12 | 3 | 15 | 50.0 | |
| Cross-validated | kontynuuje | 73 | 8 | 9 | 81.1 |
| zmienił kierunek | 12 | 26 | 2 | 65.0 | |
| zrezygnował | 14 | 4 | 12 | 40.0 |
Na tej samej próbie poprawnie sklasyfikowano 71.9% osób, a w walidacji krzyżowej 69.4%. Do pracy przepisz tę drugą liczbę. Porównaj ją z punktem odniesienia. Model bez predyktorów, który każdą osobę przypisuje do najliczniejszej grupy, trafia w 56.2% (IBM Corp., b.d.-b). Losowe przypisanie zgodne z proporcjami grup trafia w 41.4% (suma kwadratów udziałów). Indeks I Huberty’ego, omawiany przez Boedekera i Kearnsa (2019), mierzy poprawę względem przypadku. Względem 56.2% wynosi .30, czyli model usuwa 30% błędów, które popełniłaby reguła „wszyscy kontynuują”.
Zwróć uwagę na rezygnujących: przy a priori z liczebności poprawnie rozpoznano tylko 40%. Przy równych a priori te same funkcje dają w walidacji krzyżowej 66.9% trafień ogółem, ale 63.3% wśród rezygnujących i 68.9% wśród kontynuujących. Który wariant lepszy, zależy od celu, a nie od wyższego procentu.
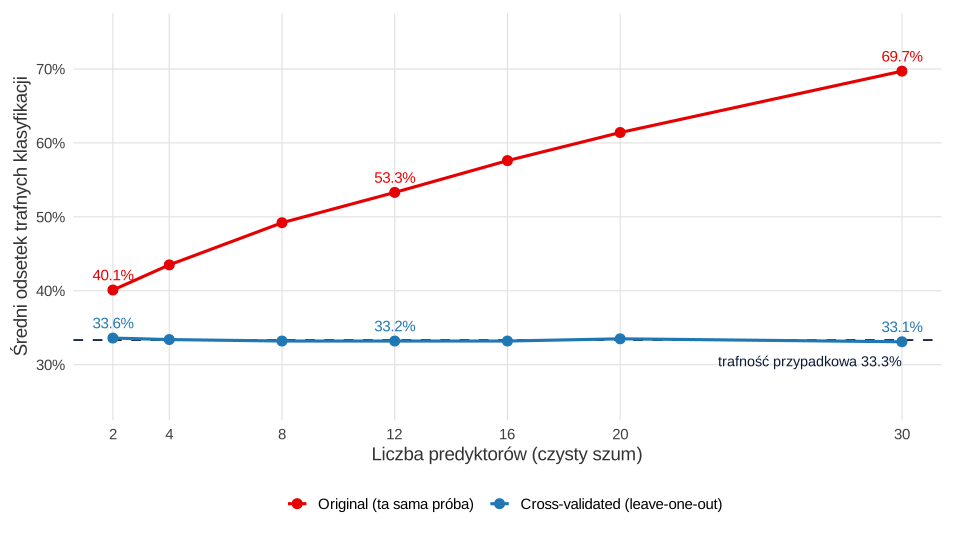
Dlaczego klasyfikacja na tej samej próbie jest zawyżona? Funkcje dopasowały się także do szumu (przeuczenie). W symulacji z rysunku 2 grupy nie różnią się niczym, a trafność na tej samej próbie i tak rośnie z liczbą predyktorów. Dokumentacja IBM dodaje, że nawet walidacja krzyżowa bywa bardziej optymistyczna niż sprawdzenie na odłożonej części danych (IBM Corp., b.d.-b). Jeśli model ma służyć do przewidywania, przeczytaj wpis modele predykcyjne: walidacja i kalibracja.
Kiedy wybrać regresję logistyczną i dlaczego nie metoda krokowa
Analiza dyskryminacyjna i regresja logistyczna rozwiązują podobne zadanie. Press i Wilson (1978) pokazują, że przy normalnych rozkładach z jednakowymi macierzami kowariancji lepsza jest analiza dyskryminacyjna. Gdy jednak choć jeden predyktor jest jakościowy, normalność jest wykluczona i autorzy preferują regresję logistyczną. Predyktory kategorialne, wyraźnie skośne zmienne i pytanie o szanse prowadzą więc do regresji logistycznej. Przy trzech i więcej grupach jest to wielomianowa regresja logistyczna. Analiza dyskryminacyjna zostaje dobrym wyborem, gdy predyktory są ilościowe, a interesują Cię wymiary różnicujące grupy.
Opcja Use stepwise method kusi, bo „sama wybiera zmienne”. Thompson (1995) wskazuje trzy problemy metod krokowych, także w analizie dyskryminacyjnej. Programy używają błędnych stopni swobody, więc łatwo o fałszywą istotność. Procedura nie znajduje najlepszego zestawu zmiennych danej wielkości. Wyniki wykorzystują błąd losowy próby i słabo się replikują. Studium przypadku IBM także zaleca opierać wybór predyktorów na wiedzy, jeśli ją masz (IBM Corp., b.d.-b). Więcej w haśle metoda krokowa.
Zapis wyników w stylu APA
Podaj liczebności grup, sprawdzenie założeń, testy funkcji z odsetkiem wariancji i korelacją kanoniczną, opis funkcji z macierzy struktury, centroidy oraz trafność z walidacji krzyżowej z punktem odniesienia. Wzór do dostosowania:
Średnie i odchylenia standardowe predyktorów w grupach pokaż w tabeli. Zdania do innych analiz przygotuje generator opisu wyników APA.
Składnia SPSS i kod R
Przepis 1 to składnia do wklejenia w edytorze składni SPSS. Napisaliśmy ją według wykresu składni DISCRIMINANT i podkomend STATISTICS, PRIORS, CLASSIFY i PLOT w Command Syntax Reference (IBM Corp., b.d.-c), ale nie uruchamialiśmy jej w SPSS. Przepis 2 w R tworzy pliki do pobrania i liczy liczby z tabel: testy jednowymiarowe, logarytmy wyznaczników i test M Boxa z przybliżeniem F, wartości własne i lambdę Wilksa (ręcznie, z macierzy SSCP), współczynniki standaryzowane, macierz struktury i centroidy (funkcja lda() z pakietu MASS) oraz klasyfikację na tej samej próbie i z walidacją krzyżową (CV = TRUE). Przepis 3 to symulacja z rysunku 2. Parametry danych ustawiliśmy ręcznie, a ziaren 544 i 5440 nie dobieraliśmy pod wynik.
1. Składnia SPSS: DISCRIMINANT
SPSS
* Składnia zgodna z opisem DISCRIMINANT w Command Syntax Reference; nie była uruchamiana w SPSS.
DISCRIMINANT GROUPS=status(1,3)
  /VARIABLES=zainteresowanie przynaleznosc srednia praca
  /METHOD=DIRECT
  /PRIORS=SIZE
  /STATISTICS=MEAN STDDEV UNIVF BOXM RAW CORR TABLE CROSSVALID
  /PLOT=COMBINED MAP
  /CLASSIFY=NONMISSING POOLED.
2. Te same liczby w R i pliki .sav oraz CSV
R
# Analiza dyskryminacyjna w SPSS: liczby do tabel procedury Discriminant (dane symulowane)
# 160 studentów po pierwszym roku: status 1 = kontynuuje (90), 2 = zmienił kierunek (40), 3 = zrezygnował (30).
# Predyktory: zainteresowanie kierunkiem (1–5), przynależność (1–5), średnia ocen (2–5), praca zarobkowa (godz./tydz.).
suppressPackageStartupMessages({ library(MASS); library(haven); library(heplots) })
set.seed(544)
n <- c(90, 40, 30)
status <- rep(1:3, times = n)
srednie <- rbind(c(3.9, 3.6, 3.9,  8),           # kontynuuje
                 c(2.9, 3.5, 3.8,  9),           # zmienił kierunek
                 c(3.3, 2.9, 3.4, 16))           # zrezygnował
SD <- c(0.7, 0.7, 0.45, 7)
R <- matrix(c(1, .35, .30, -.10,
              .35, 1, .25, -.15,
              .30, .25, 1, -.25,
              -.10, -.15, -.25, 1), 4)            # korelacje wewnątrzgrupowe
X <- srednie[status, ] + mvrnorm(sum(n), rep(0, 4), diag(SD) %*% R %*% diag(SD))
X[, 1:2] <- round(pmin(5, pmax(1, X[, 1:2])), 2)
X[, 3] <- round(pmin(5, pmax(2, X[, 3])), 2)
X[, 4] <- round(pmax(0, X[, 4]))
dane <- data.frame(id = seq_along(status), status = status, zainteresowanie = X[, 1],
                   przynaleznosc = X[, 2], srednia = X[, 3], praca = X[, 4])

# Plik .sav z etykietami zmiennych i wartości oraz ten sam zbiór w CSV
sav <- dane
sav$id <- labelled(sav$id, label = "Numer osoby")
sav$status <- labelled(sav$status, labels = c("kontynuuje" = 1, "zmienił kierunek" = 2, "zrezygnował" = 3),
                       label = "Status po pierwszym roku")
sav$zainteresowanie <- labelled(sav$zainteresowanie, label = "Zainteresowanie kierunkiem (1–5)")
sav$przynaleznosc <- labelled(sav$przynaleznosc, label = "Poczucie przynależności (1–5)")
sav$srednia <- labelled(sav$srednia, label = "Średnia ocen (2–5)")
sav$praca <- labelled(sav$praca, label = "Praca zarobkowa (godz. tygodniowo)")
write_sav(sav, "analiza-dyskryminacyjna-spss-dane.sav")
write.csv(dane, "analiza-dyskryminacyjna-spss-dane.csv", row.names = FALSE, fileEncoding = "UTF-8")

d <- dane
d$gr <- factor(d$status, levels = 1:3, labels = c("kontynuuje", "zmiana", "rezygnacja"))
zm <- c("zainteresowanie", "przynaleznosc", "srednia", "praca")
X <- as.matrix(d[, zm]); N <- nrow(X); g <- nlevels(d$gr); p <- length(zm)
ni <- as.vector(table(d$gr))

# 1. Group Statistics: średnie i SD w grupach
print(round(rbind(sapply(split(as.data.frame(X), d$gr), colMeans) |> t(), Total = colMeans(X)), 2))
print(round(rbind(sapply(split(as.data.frame(X), d$gr), function(x) apply(x, 2, sd)) |> t(), Total = apply(X, 2, sd)), 2))

# 2. Tests of Equality of Group Means: jednowymiarowa lambda Wilksa i F
T  <- crossprod(scale(X, scale = FALSE))                                  # SSCP ogółem
W  <- Reduce(`+`, lapply(split(as.data.frame(X), d$gr), function(x) crossprod(scale(as.matrix(x), scale = FALSE))))
B  <- T - W                                                               # SSCP międzygrupowa
lam1 <- diag(W) / diag(T); F1 <- (diag(B) / (g - 1)) / (diag(W) / (N - g))
print(data.frame(Wilks = round(lam1, 3), F = round(F1, 3), df1 = g - 1, df2 = N - g,
                 Sig = round(pf(F1, g - 1, N - g, lower.tail = FALSE), 4)))

# 3. Log Determinants i Box's M z przybliżeniem F
S  <- lapply(split(as.data.frame(X), d$gr), cov); Sp <- W / (N - g)
print(round(c(sapply(S, function(s) log(det(s))), Pooled = log(det(Sp))), 3))
M  <- (N - g) * log(det(Sp)) - sum((ni - 1) * sapply(S, function(s) log(det(s))))
c1 <- (sum(1 / (ni - 1)) - 1 / (N - g)) * (2 * p^2 + 3 * p - 1) / (6 * (p + 1) * (g - 1))
c2 <- (sum(1 / (ni - 1)^2) - 1 / (N - g)^2) * (p - 1) * (p + 2) / (6 * (g - 1))
df1 <- (g - 1) * p * (p + 1) / 2; df2 <- (df1 + 2) / (c2 - c1^2)
Fb <- M / (df1 / (1 - c1 - df1 / df2))
print(round(c(M = M, F = Fb, df1 = df1, df2 = df2, Sig = pf(Fb, df1, df2, lower.tail = FALSE)), 4))
print(boxM(X, d$gr))                                                      # kontrolnie: wersja chi-kwadrat

# 4. Eigenvalues i Wilks' Lambda (z wartości własnych W^-1 B)
ew <- Re(eigen(solve(W) %*% B)$values)[1:min(g - 1, p)]
print(data.frame(Function = seq_along(ew), Eigenvalue = round(ew, 3), Pct = round(100 * ew / sum(ew), 1),
                 Cum = round(100 * cumsum(ew) / sum(ew), 1), CanCorr = round(sqrt(ew / (1 + ew)), 3)))
for (k in seq_along(ew)) {
  L <- prod(1 / (1 + ew[k:length(ew)])); chi <- -(N - 1 - (p + g) / 2) * log(L); df <- (p - k + 1) * (g - k)
  cat(sprintf("Test of Function(s) %d through %d: Wilks = %.3f  Chi-square = %.3f  df = %d  Sig = %.4g\n",
              k, length(ew), L, chi, df, pchisq(chi, df, lower.tail = FALSE)))
}

# 5. lda(): współczynniki standaryzowane, macierz struktury, centroidy
fit <- lda(gr ~ zainteresowanie + przynaleznosc + srednia + praca, data = d, prior = ni / N)
std <- fit$scaling * sqrt(diag(Sp))                                       # Standardized Canonical Coefficients
cat("Kontrolnie, wartości własne z lda():", round(fit$svd^2 * (g - 1) / (N - g), 3), "\n")
print(round(std, 3))
oceny <- scale(X, center = colMeans(X), scale = FALSE) %*% fit$scaling   # wyniki funkcji (średnia ogólna = 0)
Rw <- cov2cor(Sp)
print(round(Rw %*% std, 3))                                               # Structure Matrix
print(round(cor(cbind(X, oceny))[1:p, p + 1:2], 3))                       # kontrolnie: korelacje całkowite (inne!)
print(round(apply(oceny, 2, function(s) tapply(s, d$gr, mean)), 3))      # Functions at Group Centroids

# 6. Classification Results: a priori z liczebności (SIZE), na tej samej próbie i leave-one-out
tab <- function(pred) { t <- table(d$gr, pred); cbind(t, Pct = round(100 * diag(t) / rowSums(t), 1)) }
pred_orig <- predict(fit)$class
pred_cv   <- lda(gr ~ zainteresowanie + przynaleznosc + srednia + praca, data = d, prior = ni / N, CV = TRUE)$class
cat("\nPrior Probabilities for Groups:", round(ni / N, 3), "\n")
cat("Original:\n"); print(tab(pred_orig)); cat("Trafność:", round(100 * mean(pred_orig == d$gr), 1), "%\n")
cat("Cross-validated:\n"); print(tab(pred_cv)); cat("Trafność:", round(100 * mean(pred_cv == d$gr), 1), "%\n")

# 7. A priori równe (All groups equal): w SPSS funkcje się nie zmieniają, zmienia się tylko klasyfikacja;
#    lda() przy innych a priori obraca osie, ale klasyfikacja na obu funkcjach jest ta sama
fit_eq <- lda(gr ~ zainteresowanie + przynaleznosc + srednia + praca, data = d, prior = rep(1 / 3, 3))
cv_eq  <- lda(gr ~ zainteresowanie + przynaleznosc + srednia + praca, data = d, prior = rep(1 / 3, 3), CV = TRUE)$class
cat("\nRówne a priori, Original:\n"); print(tab(predict(fit_eq)$class))
cat("Równe a priori, Cross-validated:\n"); print(tab(cv_eq)); cat("Trafność:", round(100 * mean(cv_eq == d$gr), 1), "%\n")

# 8. Punkt odniesienia: trafność „przez przypadek” i indeks I Huberty'ego
pr <- ni / N
cat(sprintf("\nNajliczniejsza grupa: %.1f%%  Kryterium proporcjonalne: %.1f%%\n", 100 * max(pr), 100 * sum(pr^2)))
huberty <- function(traf, e) (traf - e) / (1 - e)
cat(sprintf("I Huberty'ego (CV, a priori SIZE, względem najliczniejszej grupy): %.3f\n", huberty(mean(pred_cv == d$gr), max(pr))))
cat(sprintf("I Huberty'ego (CV, a priori równe, względem 1/3): %.3f\n", huberty(mean(cv_eq == d$gr), 1 / 3)))
Wynik:
           zainteresowanie przynaleznosc srednia praca
kontynuuje            3.85          3.60    3.93  8.94
zmiana                2.93          3.62    3.88  8.72
rezygnacja            3.15          2.88    3.45 15.70
Total                 3.49          3.47    3.83 10.16
           zainteresowanie przynaleznosc srednia praca
kontynuuje            0.64          0.82    0.40  6.76
zmiana                0.69          0.66    0.44  6.53
rezygnacja            0.65          0.63    0.54  5.43
Total                 0.77          0.79    0.47  6.97
                Wilks      F df1 df2 Sig
zainteresowanie 0.709 32.234   2 157   0
przynaleznosc   0.874 11.354   2 157   0
srednia         0.849 13.966   2 157   0
praca           0.853 13.535   2 157   0
kontynuuje     zmiana rezygnacja     Pooled
     0.338     -0.024      0.055      0.344
         M          F        df1        df2        Sig
   23.2622     1.1082    20.0000 30180.8220     0.3318

 Box's M-test for Homogeneity of Covariance Matrices

data:  X by d$gr
Chi-Sq (approx.) = 22.1788, df = 20, p-value = 0.3309

  Function Eigenvalue  Pct   Cum CanCorr
1        1      0.434 58.4  58.4   0.550
2        2      0.309 41.6 100.0   0.486
Test of Function(s) 1 through 2: Wilks = 0.533  Chi-square = 97.956  df = 8  Sig = 1.117e-17
Test of Function(s) 2 through 2: Wilks = 0.764  Chi-square = 41.903  df = 3  Sig = 4.207e-09
Kontrolnie, wartości własne z lda(): 0.434 0.309
                   LD1    LD2
zainteresowanie  0.935  0.527
przynaleznosc   -0.067 -0.593
srednia          0.121 -0.484
praca           -0.230  0.415
                   LD1    LD2
zainteresowanie  0.959  0.192
przynaleznosc    0.296 -0.587
srednia          0.406 -0.587
praca           -0.322  0.642
                   LD1    LD2
zainteresowanie  0.967  0.185
przynaleznosc    0.331 -0.628
srednia          0.448 -0.619
praca           -0.356  0.679
              LD1    LD2
kontynuuje  0.576 -0.003
zmiana     -0.745 -0.717
rezygnacja -0.733  0.966

Prior Probabilities for Groups: 0.562 0.25 0.188
Original:
           kontynuuje zmiana rezygnacja  Pct
kontynuuje         73      8          9 81.1
zmiana             12     27          1 67.5
rezygnacja         12      3         15 50.0
Trafność: 71.9 %
Cross-validated:
           kontynuuje zmiana rezygnacja  Pct
kontynuuje         73      8          9 81.1
zmiana             12     26          2 65.0
rezygnacja         14      4         12 40.0
Trafność: 69.4 %

Równe a priori, Original:
           kontynuuje zmiana rezygnacja  Pct
kontynuuje         63     13         14 70.0
zmiana              7     26          7 65.0
rezygnacja          5      3         22 73.3
Równe a priori, Cross-validated:
           kontynuuje zmiana rezygnacja  Pct
kontynuuje         62     13         15 68.9
zmiana              7     26          7 65.0
rezygnacja          7      4         19 63.3
Trafność: 66.9 %

Najliczniejsza grupa: 56.2%  Kryterium proporcjonalne: 41.4%
I Huberty'ego (CV, a priori SIZE, względem najliczniejszej grupy): 0.300
I Huberty'ego (CV, a priori równe, względem 1/3): 0.503
3. Symulacja: optymizm klasyfikacji na tej samej próbie
R
# Jak bardzo trafność klasyfikacji na tej samej próbie jest zawyżona? Symulacja (parametry ustawione ręcznie)
# 3 grupy po 30 osób, predyktory to czysty szum (grupy nie różnią się niczym), a priori równe.
# Prawdziwa trafność każdej reguły wynosi więc 33.3%.
suppressPackageStartupMessages(library(MASS))
set.seed(5440)
gr <- factor(rep(1:3, each = 30))
jedna_proba <- function(p) {
  X <- matrix(rnorm(90 * p), ncol = p)
  orig <- predict(lda(X, gr, prior = rep(1 / 3, 3)))$class
  cv   <- lda(X, gr, prior = rep(1 / 3, 3), CV = TRUE)$class
  c(Original = mean(orig == gr), Cross_validated = mean(cv == gr))
}
liczba_predyktorow <- c(2, 4, 8, 12, 16, 20, 30)
wyniki <- t(sapply(liczba_predyktorow, function(p) rowMeans(replicate(500, jedna_proba(p)))))
wyniki <- data.frame(predyktory = liczba_predyktorow, round(100 * wyniki, 1))
print(wyniki, row.names = FALSE)
Wynik:
 predyktory Original Cross_validated
          2     40.1            33.6
          4     43.5            33.4
          8     49.2            33.2
         12     53.3            33.2
         16     57.6            33.2
         20     61.4            33.5
         30     69.7            33.1
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite. Składni SPSS nie uruchamiano. W pracy podaj wersję SPSS lub R, której faktycznie użyłeś.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- haven (wersja 2.5.5): Wickham, H., Miller, E., & Smith, D. (2025). haven: Import and export 'SPSS', 'Stata' and 'SAS' files [R package]. https://doi.org/10.32614/CRAN.package.haven
- heplots (wersja 1.8.1): Friendly, M., Fox, J., & Monette, G. (2025). heplots: Visualizing tests in multivariate linear models [R package]. https://CRAN.R-project.org/package=heplots
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Typowe błędy i lista kontrolna
- Trafność „Original” zamiast „Cross-validated” – pierwsza jest zawyżona, zwłaszcza przy wielu predyktorach i małych grupach.
- Brak punktu odniesienia – 70% trafień brzmi dobrze, dopóki nie okaże się, że najliczniejsza grupa to 65% próby.
- A priori dobrane po fakcie, bo dały wyższy procent.
- Opis funkcji tylko ze współczynników standaryzowanych, gdy predyktory są skorelowane – sprawdź macierz struktury.
- Metoda krokowa jako sposób na „wybranie najważniejszych zmiennych” (Thompson, 1995).
- Predyktory jakościowe wpisane jak liczby – wtedy lepsza jest regresja logistyczna (Press i Wilson, 1978).
Lista kontrolna: (1) grupy znane z góry i rozłączne; (2) liczebności grup i predyktory w Metodzie; (3) test M Boxa; (4) lambda Wilksa z χ², df i p; (5) odsetek wariancji i korelacja kanoniczna; (6) opis funkcji z macierzy struktury i centroidów; (7) trafność z walidacji krzyżowej z punktem odniesienia i a priori; (8) wersja SPSS.
Najczęstsze pytania
Gdzie w SPSS jest analiza dyskryminacyjna?
W menu Analyze → Classify → Discriminant (w polskiej dokumentacji: Analizuj → Klasyfikuj → Dyskryminanta). Zmienna grupująca musi mieć kody całkowite – zakres podajesz przyciskiem Define Range. Predyktory przenosisz na listę Independents i zostawiasz metodę Enter independents together. Box’s M zaznaczysz w oknie Statistics, a leave-one-out w oknie klasyfikacji.
Którą trafność klasyfikacji podać w pracy?
Trafność z części Cross-validated (leave-one-out), w której każdą osobę klasyfikują funkcje wyznaczone bez niej. Klasyfikacja na tej samej próbie jest zawyżona: w naszej symulacji przy 30 bezużytecznych predyktorach dawała średnio 69.7% trafień zamiast 33.3%. Obok podaj punkt odniesienia, np. trafność przypisania wszystkich do najliczniejszej grupy.
Co wybrać w Prior Probabilities: All groups equal czy Compute from group sizes?
Compute from group sizes, gdy liczebności grup w próbie odpowiadają częstościom w populacji, a celem jest jak najwięcej trafień ogółem. All groups equal, gdy grupy dobrano po równo albo zależy Ci na rozpoznawaniu małej grupy. A priori zmieniają tylko klasyfikację – funkcje i ich testy są te same. Wybór uzasadnij przed analizą, a nie według wyższego procentu.
Jak interpretować Structure Matrix i Standardized Coefficients w SPSS?
Macierz struktury to korelacje predyktorów z funkcjami liczone w obrębie grup: mówi, co funkcja „mierzy”, a gwiazdka wskazuje funkcję, z którą zmienna koreluje najsilniej. Współczynniki standaryzowane pokazują wkład zmiennej przy kontroli pozostałych i przy skorelowanych predyktorach bywają niestabilne. Funkcję opisuj głównie z macierzy struktury, a położenie grup – z centroidów.
Analiza dyskryminacyjna czy regresja logistyczna?
Gdy predyktory są ilościowe i w przybliżeniu normalne, a macierze kowariancji podobne, analiza dyskryminacyjna działa dobrze i dodatkowo pokazuje wymiary różnicujące grupy. Gdy choć jeden predyktor jest jakościowy, Press i Wilson (1978) preferują regresję logistyczną. Przy trzech i więcej grupach jest to wielomianowa regresja logistyczna.
Powiązane hasła
Przeczytaj też
MANOVA w SPSS krok po kroku
GLM Multivariate od pliku .sav po opis APA: test M Boxa, Levene, Pillai czy Wilks, Tests of Between-Subjects Effects z korektą Holma i składnia do wklejenia.
Czytaj →PoradnikRegresja logistyczna w SPSS
Binary Logistic krok po kroku: kategoria odniesienia, Hosmer–Lemeshow, pseudo-R², tabela klasyfikacji, Exp(B) z przedziałami ufności i zapis APA.
Czytaj →PoradnikAnaliza skupień w SPSS krok po kroku
Hierarchical Cluster, K-Means i TwoStep od pliku .sav po opis APA: standaryzacja, metoda Warda, przegląd aglomeracji, Final Cluster Centers i opisowe testy F.
Czytaj →Masz grupy i chcesz sprawdzić, co je różni?
Sprawdzimy, czy analiza dyskryminacyjna czy regresja logistyczna lepiej odpowiada na Twoje pytanie, ustawimy a priori i walidację klasyfikacji oraz przygotujemy opis wyników i wyjaśnimy je tak, żebyś umiał(a) samodzielnie je przedstawić i obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Boedeker, P., & Kearns, N. T. (2019). Linear discriminant analysis for prediction of group membership: A user-friendly primer. Advances in Methods and Practices in Psychological Science, 2(3), 250–263. https://doi.org/10.1177/2515245919849378
- IBM Corp. (b.d.-a). Discriminant Analysis. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_disc.html ● Otwarty dostęp
- IBM Corp. (b.d.-b). Using Discriminant Analysis to Assess Credit Risk. IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/discrim_bankloan_intro.html ● Otwarty dostęp
- IBM Corp. (b.d.-c). DISCRIMINANT (Command Syntax Reference). IBM SPSS Statistics 31.0.0 documentation. https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_discriminant.html ● Otwarty dostęp
- Press, S. J., & Wilson, S. (1978). Choosing between logistic regression and discriminant analysis. Journal of the American Statistical Association, 73(364), 699–705. https://doi.org/10.1080/01621459.1978.10480080
- Sherry, A. (2006). Discriminant analysis in counseling psychology research. The Counseling Psychologist, 34(5), 661–683. https://doi.org/10.1177/0011000006287103
- Thompson, B. (1995). Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial. Educational and Psychological Measurement, 55(4), 525–534. https://doi.org/10.1177/0013164495055004001
Cytowania BibTeX
@article{boedeker2019linear, author={Boedeker, Peter and Kearns, Nathan T.}, title={{Linear discriminant analysis for prediction of group membership: A user-friendly primer}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={3}, pages={250--263}, doi={10.1177/2515245919849378}}@misc{ibmnd31discriminant, author={{IBM Corp.}}, title={{Discriminant Analysis}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-a}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_mainhelp_ddita/spss/base/idh_disc.html}}@misc{ibmnd31discriminantstudium, author={{IBM Corp.}}, title={{Using Discriminant Analysis to Assess Credit Risk}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-b}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_casestudies_project_ddita/spss/tutorials/discrim_bankloan_intro.html}}@misc{ibmnd31discriminantskladnia, author={{IBM Corp.}}, title={{DISCRIMINANT (Command Syntax Reference)}}, howpublished={IBM SPSS Statistics 31.0.0 documentation}, year={b.d.-c}, publisher={IBM}, url={https://www.ibm.com/docs/en/SSLVMB_31.0.0/statistics_reference_project_ddita/spss/base/syn_discriminant.html}}@article{press1978choosing, author={Press, S. James and Wilson, Sandra}, title={{Choosing between logistic regression and discriminant analysis}}, journal={Journal of the American Statistical Association}, year={1978}, volume={73}, number={364}, pages={699--705}, doi={10.1080/01621459.1978.10480080}}@article{sherry2006discriminant, author={Sherry, Alissa}, title={{Discriminant analysis in counseling psychology research}}, journal={The Counseling Psychologist}, year={2006}, volume={34}, number={5}, pages={661--683}, doi={10.1177/0011000006287103}}@article{thompson1995stepwise, author={Thompson, Bruce}, title={{Stepwise regression and stepwise discriminant analysis need not apply here: A guidelines editorial}}, journal={Educational and Psychological Measurement}, year={1995}, volume={55}, number={4}, pages={525--534}, doi={10.1177/0013164495055004001}}