Co to jest korelacja kanoniczna?
Korelacja kanoniczna (ang. canonical correlation analysis, CCA) to metoda badania związku między dwoma zestawami zmiennych, np. trzema cechami warunków pracy i dwoma wskaźnikami samopoczucia. Zaproponował ją Hotelling (1936). Z każdego zestawu tworzy się ważoną sumę zmiennych, czyli zmienną kanoniczną, tak by korelacja Pearsona między obiema sumami była jak największa. Ta korelacja to pierwsza korelacja kanoniczna Rc. Kolejne pary są nieskorelowane z poprzednimi, a par jest tyle, ile zmiennych liczy mniejszy zestaw.
Sherry i Henson (2005) przedstawiają CCA jako najogólniejszy przypadek ogólnego modelu liniowego. Regresja wieloraka to korelacja kanoniczna z jedną zmienną w drugim zestawie, a MANOVA – z zestawem zmiennych zero-jedynkowych kodujących grupy.
Jak czytać wynik
- Test wymiarów. Lambda Wilksa sprawdza najpierw wszystkie korelacje kanoniczne razem, potem od drugiej do ostatniej i tak dalej. Program podaje przybliżenie χ² Bartletta albo F Rao.
- Ładunki kanoniczne (współczynniki struktury) to korelacje zmiennych z ich zmienną kanoniczną. Do interpretacji są pewniejsze niż wagi standaryzowane, które przy skorelowanych zmiennych bywają niestabilne.
- Redundancja (Stewart i Love, 1968) mówi, jaką część wariancji jednego zestawu wyjaśnia zmienna kanoniczna drugiego. Bywa dużo mniejsza niż Rc². Nie myl jej z analizą redundancji w PLS-SEM.
Przykład
W danych symulowanych 200 pracowników zmierzono wsparcie, autonomię i obciążenie pracą oraz satysfakcję i wypalenie. Pierwsza korelacja kanoniczna wyniosła Rc = .43, Λ = .797, χ²(6) = 44.50, p < .001, a druga Rc = .13, χ²(2) = 3.51, p = .173. Interpretujemy więc jedną parę. Najwyższe ładunki miały autonomia (.85) i wsparcie (.65) oraz satysfakcja (.82) i wypalenie (−.68). Redundancja wyniosła .107: przez pierwszą parę warunki pracy wyjaśniają około 11% wariancji samopoczucia.
Na rysunku
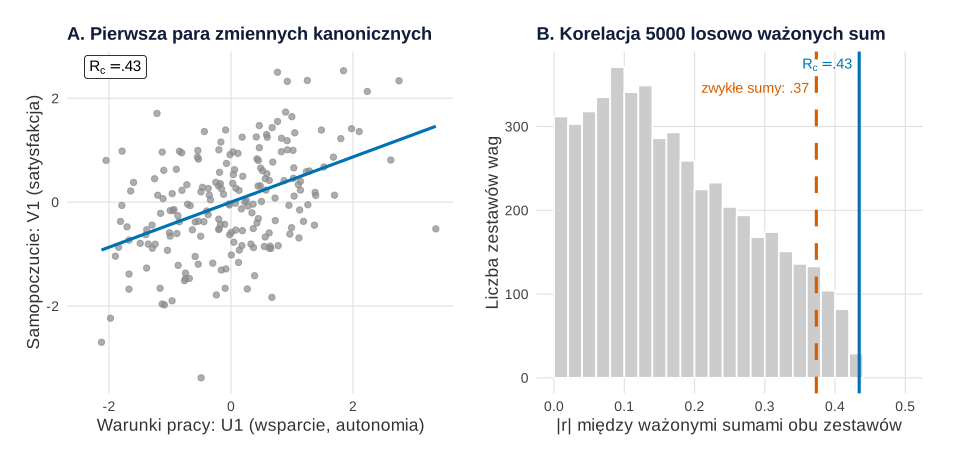
cancor, pakiety ggplot2 i patchwork (dane symulowane, set.seed(4541)).Co widać. Panel A to zwykły wykres rozrzutu, tyle że na osiach są zmienne kanoniczne: ważona suma warunków pracy (U1) i ważona suma samopoczucia (V1). Ich korelacja to pierwsza korelacja kanoniczna, Rc = .43. Panel B pokazuje, skąd bierze się to „kanoniczne”. Wylosowaliśmy 5000 zestawów wag dla obu zestawów zmiennych i za każdym razem policzyliśmy korelację ważonych sum. Mediana wyniosła .15, a największa z 5000 wartości .432. Żadna nie przekroczyła Rc = .434, bo CCA znajduje wagi, które dają najwyższą możliwą korelację. Zwykłe sumy (wsparcie + autonomia − obciążenie oraz satysfakcja − wypalenie) dały .37, czyli mniej niż optimum. Wszystkie trzy pary dla innych danych i ich ładunki pokazuje wpis Korelacja kanoniczna krok po kroku.
Na co uważać. To, że Rc jest maksimum, ma swoją cenę. Wagi dopasowują się do tej konkretnej próby, więc w nowej próbie korelacja tych samych sum będzie zwykle niższa. Wykres nie pokazuje też, które zmienne niosą związek. Do tego służą ładunki: obciążenie pracą ma ładunek tylko −.21. Chmura w panelu A jest szeroka – przy Rc2 = .19 pierwsza para dzieli mniej niż piątą część wariancji, a redundancja jest jeszcze mniejsza.
Podpis do pracy:
Kod rysunku używa tego samego ziarna i tych samych danych co przykład (set.seed(4541), ustalone raz); losowe wagi pochodzą z tego samego strumienia liczb losowych. Ręcznie ustalono liczbę zestawów wag (5000) i znaki „zwykłych sum” (obciążenie i wypalenie z minusem). Rysunek na stronie powstał z tego samego obiektu p1 z motywem serwisu (krój, siatka); dane, geometrie i skale są identyczne.
Kod R rysunku
# Rysunek 1. Pierwsza para zmiennych kanonicznych (A) i R_c jako maksimum korelacji
# po wszystkich ważonych sumach obu zestawów (B); dane z przykładu w haśle (200 osób, dane symulowane)
suppressPackageStartupMessages({library(ggplot2); library(patchwork)})
kol <- c(niebieski = "#0072B2", pomaranczowy = "#D55E00", szary = "grey55")   # Okabe–Ito
motyw <- theme_minimal(base_size = 13) + theme(panel.grid.minor = element_blank())
set.seed(4541)                                    # to samo ziarno i te same dane co w przykładzie
n <- 200
f <- rnorm(n)                                     # wspólny czynnik obu zestawów
X <- data.frame(wsparcie = 0.6 * f + rnorm(n), autonomia = 0.5 * f + rnorm(n),
                obciazenie = -0.3 * f + rnorm(n))
Y <- data.frame(satysfakcja = 0.6 * f + rnorm(n), wypalenie = -0.5 * f + rnorm(n))
Xs <- scale(X); Ys <- scale(Y)
cc <- cancor(Xs, Ys)
U <- Xs %*% cc$xcoef[, 1]; V <- Ys %*% cc$ycoef[, 1]
s <- sign(c(cor(Y$satysfakcja, V))); U <- s * U; V <- s * V      # kierunek dla czytelności
pary <- data.frame(U = scale(U)[, 1], V = scale(V)[, 1])

# 5000 losowych wag dla obu zestawów: korelacja ważonych sum nigdy nie przekracza R_c
los <- replicate(5000, abs(cor(Xs %*% rnorm(3), Ys %*% rnorm(2))))
proste <- abs(cor(Xs %*% c(1, 1, -1), Ys %*% c(1, -1)))           # zwykłe sumy (z odwróceniem znaku)
round(c(Rc1 = cc$cor[1], Rc1_kwadrat = cc$cor[1]^2, max_losowych = max(los), mediana_losowych = median(los),
        proste_sumy = proste), 3)
round(c(r_U_V = cor(pary$U, pary$V)), 3)                                # = pierwsza korelacja kanoniczna

bez0 <- function(x) sub("^0", "", sprintf("%.2f", x))                 # .43 zamiast 0.43
etyk_rc <- paste0("R[c] == '", bez0(cc$cor[1]), "'")
pA <- ggplot(pary, aes(U, V)) +
  geom_point(colour = kol[["szary"]], alpha = 0.7, size = 1.8) +
  geom_smooth(method = "lm", formula = y ~ x, se = FALSE, colour = kol[["niebieski"]], linewidth = 1.1) +
  annotate("label", x = -2.4, y = 2.6, hjust = 0, size = 4,
           label = etyk_rc, parse = TRUE) +
  labs(title = "A. Pierwsza para zmiennych kanonicznych",
       x = "Warunki pracy: U1 (wsparcie, autonomia)", y = "Samopoczucie: V1 (satysfakcja)") + motyw
pB <- ggplot(data.frame(r = los), aes(r)) +
  geom_histogram(binwidth = 0.02, boundary = 0, fill = "grey80", colour = "white") +
  geom_vline(xintercept = cc$cor[1], colour = kol[["niebieski"]], linewidth = 1.1) +
  geom_vline(xintercept = proste, colour = kol[["pomaranczowy"]], linewidth = 1.1, linetype = "dashed") +
  annotate("text", x = cc$cor[1] - 0.01, y = Inf, vjust = 1.5, hjust = 1, size = 3.8,
           label = etyk_rc, parse = TRUE, colour = kol[["niebieski"]]) +
  annotate("text", x = proste - 0.01, y = Inf, vjust = 4, hjust = 1, size = 3.8,
           label = paste("zwykłe sumy:", bez0(proste)), colour = kol[["pomaranczowy"]]) +
  scale_x_continuous(limits = c(0, 0.5)) +
  labs(title = "B. Korelacja 5000 losowo ważonych sum",
       x = "|r| między ważonymi sumami obu zestawów", y = "Liczba zestawów wag") + motyw
p1 <- pA + pB
p1
Wynik w R
             Rc1      Rc1_kwadrat     max_losowych mediana_losowych
           0.434            0.189            0.432            0.152
     proste_sumy
           0.373
r_U_V
0.434
Jak opisać w pracy
Na co uważać
- Liczebność. Wagi i ładunki dopasowują się do próby. Przy małym n i wielu zmiennych wynik słabo się replikuje.
- Znak jest umowny. Interpretuj układ znaków ładunków, a nie sam znak.
- To nie PCA. PCA streszcza jeden zestaw zmiennych, a CCA szuka powiązań między dwoma. Pełną procedurę z tabelą APA pokazuje wpis Korelacja kanoniczna krok po kroku.
Korelacja kanoniczna w R
Kod liczy korelacje kanoniczne funkcją cancor, testuje kolejne wymiary lambdą Wilksa z przybliżeniem χ² Bartletta, a ładunki i redundancję oblicza ręcznie.
Testy wymiarów, ładunki i redundancja
R
set.seed(4541)
n <- 200
f <- rnorm(n)                                   # wspólny czynnik obu zestawów
X <- data.frame(wsparcie = 0.6 * f + rnorm(n), autonomia = 0.5 * f + rnorm(n),
                obciazenie = -0.3 * f + rnorm(n))       # zestaw 1: warunki pracy
Y <- data.frame(satysfakcja = 0.6 * f + rnorm(n), wypalenie = -0.5 * f + rnorm(n))  # zestaw 2
cc <- cancor(scale(X), scale(Y))
rc <- cc$cor; p <- ncol(X); q <- ncol(Y); k <- length(rc)
# lambda Wilksa dla korelacji od i-tej do ostatniej, przybliżenie chi-kwadrat Bartletta
test <- t(sapply(1:k, function(i) {
  L <- prod(1 - rc[i:k]^2)
  chi <- -(n - 1 - (p + q + 1) / 2) * log(L)
  df <- (p - i + 1) * (q - i + 1)
  c(Rc = rc[i], Wilks = L, chi2 = chi, df = df, p = pchisq(chi, df, lower.tail = FALSE))
}))
print(signif(test, 3))
U <- scale(X) %*% cc$xcoef[, 1]; V <- scale(Y) %*% cc$ycoef[, 1]
s <- sign(c(cor(Y$satysfakcja, V))); U <- s * U; V <- s * V   # kierunek dla czytelności
ladunki <- rbind(cor(X, U), cor(Y, V))                     # ładunki (współczynniki struktury)
print(round(ladunki, 2))
cat("redundancja Y przez X (1. para):", round(mean(cor(Y, V)^2) * rc[1]^2, 3), "\n")
Wynik w R
        Rc Wilks  chi2 df        p
[1,] 0.434 0.797 44.50  6 5.87e-08
[2,] 0.133 0.982  3.51  2 1.73e-01
             [,1]
wsparcie     0.65
autonomia    0.85
obciazenie  -0.21
satysfakcja  0.82
wypalenie   -0.68
redundancja Y przez X (1. para): 0.107
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (przykład bez dodatkowych pakietów; rysunek 1 – pakiety ggplot2 i patchwork). W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Ile par zmiennych kanonicznych interpretować?
Tyle, ile jest istotnych w sekwencyjnym teście lambdy Wilksa i ma sensowną wielkość. Zwykle jedną lub dwie. Bardzo małe korelacje kanoniczne, nawet istotne przy dużym n, pomiń.
Czym różnią się wagi kanoniczne od ładunków kanonicznych?
Wagi to współczynniki w ważonej sumie i zależą od korelacji między zmiennymi w zestawie. Ładunki to korelacje zmiennej ze zmienną kanoniczną. Do opisu treści pary używaj głównie ładunków.
Czy wysoka korelacja kanoniczna oznacza, że zestawy mają dużo wspólnej wariancji?
Niekoniecznie. Rc dotyczy tylko dwóch ważonych sum. Wspólną wariancję całych zestawów opisuje redundancja Stewarta i Love’a, która bywa wyraźnie mniejsza niż Rc².
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Korelacja kanoniczna krok po kroku
Testy kolejnych par (Wilks, Bartlett, F Rao), wagi a ładunki z supresją, redundancja, liczebność próby i tabela APA – z danymi i kodem R.
Czytaj →PoradnikMANOVA krok po kroku
Założenia, odległość Mahalanobisa i test M Boxa, ślad Pillaia z η²p, analizy następcze z korektą Holma i opis APA – na danych do pobrania z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hotelling, H. (1936). Relations between two sets of variates. Biometrika, 28(3–4), 321–377. https://doi.org/10.1093/biomet/28.3-4.321
- Sherry, A., & Henson, R. K. (2005). Conducting and interpreting canonical correlation analysis in personality research: A user-friendly primer. Journal of Personality Assessment, 84(1), 37–48. https://doi.org/10.1207/s15327752jpa8401_09 ● Otwarty dostęp
- Stewart, D., & Love, W. (1968). A general canonical correlation index. Psychological Bulletin, 70(3, Pt. 1), 160–163. https://doi.org/10.1037/h0026143
Cytowania BibTeX
@article{hotelling1936relations, author={Hotelling, Harold}, title={{Relations between two sets of variates}}, journal={Biometrika}, year={1936}, volume={28}, number={3–4}, pages={321--377}, doi={10.1093/biomet/28.3-4.321}}@article{sherry2005conducting, author={Sherry, Alissa and Henson, Robin K.}, title={{Conducting and interpreting canonical correlation analysis in personality research: A user-friendly primer}}, journal={Journal of Personality Assessment}, year={2005}, volume={84}, number={1}, pages={37--48}, doi={10.1207/s15327752jpa8401_09}}@article{stewart1968general, author={Stewart, Douglas and Love, William}, title={{A general canonical correlation index}}, journal={Psychological Bulletin}, year={1968}, volume={70}, number={3, Pt. 1}, pages={160--163}, doi={10.1037/h0026143}}