Co to jest T² Hotellinga?
T² Hotellinga (ang. Hotelling’s T-squared) to wielowymiarowe uogólnienie testu t dla prób niezależnych. Sprawdza, czy dwie grupy różnią się wektorem średnich kilku zmiennych zależnych naraz, z uwzględnieniem korelacji między nimi. Statystykę zaproponował Hotelling (1931). Istnieją też wersje dla jednej próby i dla pomiarów zależnych (różnice par).
Jak się ją liczy
Dla p zmiennych i grup o liczebnościach n1 i n2:
T² = [n1n2 / (n1 + n2)] · d′S−1d, F = T² · (n1 + n2 − p − 1) / [p(n1 + n2 − 2)]
Tu d to wektor różnic średnich, a S – połączona macierz kowariancji. Środkowa część wzoru to kwadrat odległości Mahalanobisa między centroidami grup. F ma p i n1 + n2 − p − 1 stopni swobody. Przy dwóch grupach MANOVA daje ten sam wynik niezależnie od statystyki (Pillai, Wilks, Hotelling–Lawley). Założenia to wielowymiarowa normalność i równe macierze kowariancji, sprawdzane np. testem M Boxa.
Przykład
W symulacji porównano 30 osób po treningu relaksacyjnym i 30 z grupy kontrolnej na dwóch podskalach lęku skorelowanych na poziomie około .60. Osobne testy t były nieistotne: lęk somatyczny t(58) = −1.53, p = .132, lęk poznawczy t(58) = 1.33, p = .188. Test T² wykrył różnicę profilu: T² = 11.81, F(2, 57) = 5.80, p = .005. Grupa treningowa miała niższy lęk somatyczny przy podobnym lub nieco wyższym poznawczym – a przy silnej dodatniej korelacji podskal taki układ jest nietypowy.
Na rysunku
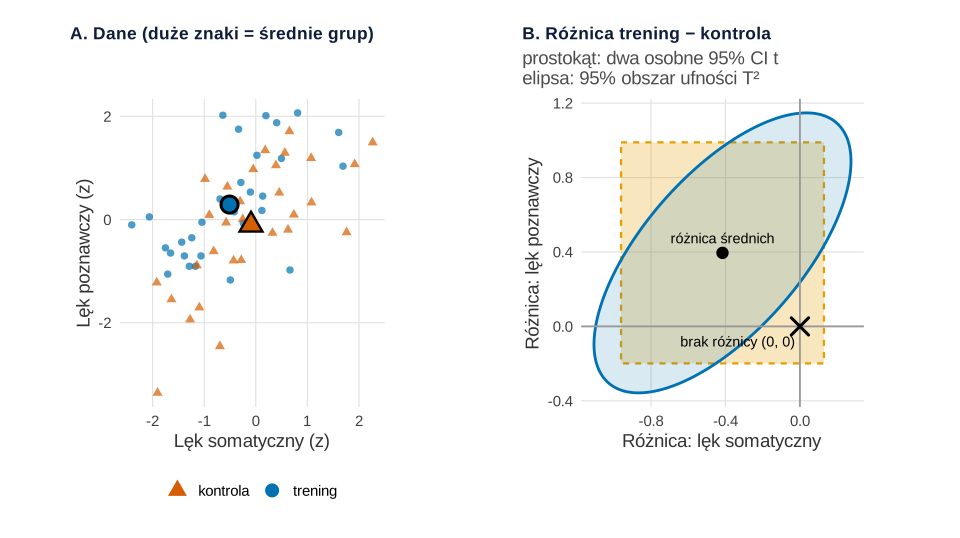
set.seed(4570)).Co widać. W panelu A grupy prawie się pokrywają. Panel B pokazuje tę samą różnicę dwa razy. Prostokąt to dwa osobne 95% przedziały t: dla lęku somatycznego od −0.96 do 0.13, dla poznawczego od −0.20 do 0.99. Oba obejmują zero, więc punkt „brak różnicy” leży w prostokącie. Elipsa to 95% obszar ufności T²: zbiór różnic, których test by nie odrzucił. Jest pochylona, bo podskale korelują dodatnio, a zatem błędy oszacowania obu różnic też idą w parze. Wynik „niżej na jednej, wyżej na drugiej” jest przy takiej korelacji mało prawdopodobny, więc zero wypada poza elipsą: T² = 11.81 przy wartości krytycznej 6.43.
Na co uważać. Elipsa nie mówi, która podskala różnicuje grupy, tylko że różni się ich łączny profil. Przy ujemnej korelacji podskal pochylenie byłoby odwrotne i nietypowa stałaby się zgodna zmiana obu wyników. Obszar ufności zakłada wielowymiarową normalność i równe macierze kowariancji grup; przy dwóch zmiennych da się go narysować, przy trzech i więcej zostaje sama liczba.
Podpis do pracy:
Kod losuje te same dane co przykład, z tym samym ziarnem set.seed(4570), ustalonym raz. Średnie grup (−0.35 i 0.15 wobec 0 i 0) oraz korelację podskal .60 ustawiono ręcznie. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Dane dwóch grup (A) i 95% obszar ufności różnicy wektorów średnich (B):
# zero leży wewnątrz „prostokąta” z osobnych przedziałów t, ale poza elipsą T² Hotellinga
suppressPackageStartupMessages(library(MASS))
library(ggplot2)
library(patchwork)

kol <- c(trening = "#0072B2", kontrola = "#D55E00", elipsa = "#0072B2", prostokat = "#E69F00")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        panel.grid.minor = element_blank(), panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        legend.position = "bottom", plot.background = element_rect(fill = "white", colour = NA))

# Dane jak w przykładzie (średnie i korelacja .60 ustawione ręcznie)
set.seed(4570)
n1 <- n2 <- 30; S <- matrix(c(1, .6, .6, 1), 2)
trening  <- mvrnorm(n1, mu = c(-0.35, 0.15), Sigma = S)   # lęk somatyczny, poznawczy (z)
kontrola <- mvrnorm(n2, mu = c(0, 0), Sigma = S)
d  <- colMeans(trening) - colMeans(kontrola)
Sp <- ((n1 - 1) * cov(trening) + (n2 - 1) * cov(kontrola)) / (n1 + n2 - 2)
p <- 2; df2 <- n1 + n2 - p - 1; k <- n1 * n2 / (n1 + n2)
T2 <- k * drop(t(d) %*% solve(Sp) %*% d)
T2_kryt <- p * (n1 + n2 - 2) / df2 * qf(.95, p, df2)       # granica 95% obszaru ufności
cat("T2 =", round(T2, 2), " T2 krytyczne (alfa = .05) =", round(T2_kryt, 2), "\n")

# Elipsa: wszystkie różnice delta, dla których k (d - delta)' Sp^-1 (d - delta) <= T2_kryt
kat <- seq(0, 2 * pi, length.out = 200)
elipsa <- t(d + sqrt(T2_kryt / k) * t(chol(Sp)) %*% rbind(cos(kat), sin(kat)))
elipsa <- data.frame(x = elipsa[, 1], y = elipsa[, 2])
# Osobne 95% przedziały t dla każdej podskali
ci <- sapply(1:2, function(j) t.test(trening[, j], kontrola[, j], var.equal = TRUE)$conf.int)
print(round(rbind(roznica = d, dolna = ci[1, ], gorna = ci[2, ]), 2))

dane <- rbind(data.frame(grupa = "trening", somatyczny = trening[, 1], poznawczy = trening[, 2]),
              data.frame(grupa = "kontrola", somatyczny = kontrola[, 1], poznawczy = kontrola[, 2]))
srednie <- aggregate(cbind(somatyczny, poznawczy) ~ grupa, dane, mean)
pA <- ggplot(dane, aes(somatyczny, poznawczy, colour = grupa, shape = grupa)) +
  geom_point(size = 2.2, alpha = 0.7) +
  geom_point(data = srednie, size = 6, stroke = 1.6, colour = "black", show.legend = FALSE) +
  geom_point(data = srednie, size = 4.5) +
  scale_colour_manual(values = kol[c("kontrola", "trening")], name = NULL) +
  scale_shape_manual(values = c(kontrola = 17, trening = 16), name = NULL) +
  coord_equal() +
  labs(title = "A. Dane (duże znaki = średnie grup)", x = "Lęk somatyczny (z)", y = "Lęk poznawczy (z)") + motyw

pB <- ggplot() +
  annotate("rect", xmin = ci[1, 1], xmax = ci[2, 1], ymin = ci[1, 2], ymax = ci[2, 2],
           fill = kol[["prostokat"]], alpha = 0.25, colour = kol[["prostokat"]], linetype = "22", linewidth = 0.8) +
  geom_polygon(data = elipsa, aes(x, y), fill = kol[["elipsa"]], alpha = 0.15, colour = kol[["elipsa"]], linewidth = 1) +
  geom_hline(yintercept = 0, colour = "grey60") + geom_vline(xintercept = 0, colour = "grey60") +
  annotate("point", x = 0, y = 0, shape = 4, size = 5, stroke = 1.6) +
  annotate("text", x = -0.03, y = -0.08, label = "brak różnicy (0, 0)", hjust = 1, size = 3.8) +
  annotate("point", x = d[1], y = d[2], size = 3.5) +
  annotate("text", x = d[1], y = d[2] + 0.08, label = "różnica średnich", size = 3.8) +
  coord_equal() +
  labs(title = "B. Różnica trening − kontrola",
       subtitle = "prostokąt: dwa osobne 95% CI t\nelipsa: 95% obszar ufności T²", x = "Różnica: lęk somatyczny", y = "Różnica: lęk poznawczy") + motyw
p1 <- pA + pB + plot_layout(widths = c(1, 1.1))
p1
Wynik w R
T2 = 11.81  T2 krytyczne (alfa = .05) = 6.43
         [,1]  [,2]
roznica -0.42  0.40
dolna   -0.96 -0.20
gorna    0.13  0.99
Jak opisać w pracy
Na co uważać
- Nie jako „bramka”. Huberty i Morris (1989) krytykują poprzedzanie serii testów jednowymiarowych analizą wielowymiarową jako ochronę przed błędem I rodzaju. Wybierz T², gdy pytasz o łączny profil.
- Kierunek. T² reaguje na różnicę w dowolnym kierunku. Gdy spodziewasz się przewagi jednej grupy na wszystkich zmiennych, O’Brien (1984) pokazał testy skierowane na taką alternatywę.
- Interpretacja. Istotny wynik nie mówi, które zmienne różnicują grupy – pomaga analiza dyskryminacyjna. Dalsze kroki opisuje wpis MANOVA krok po kroku.
T² Hotellinga w R
Kod liczy T² ręcznie z połączonej macierzy kowariancji, zamienia go na F, porównuje z MANOVA dla dwóch grup i z osobnymi testami t.
T² Hotellinga a osobne testy t
R
suppressPackageStartupMessages(library(MASS))
fp <- function(x) sub("^0\\.", ".", sprintf("%.3f", x))   # p w zapisie APA
set.seed(4570)
n1 <- n2 <- 30; S <- matrix(c(1, .6, .6, 1), 2)       # dwie skorelowane podskale lęku
trening  <- mvrnorm(n1, mu = c(-0.35, 0.15), Sigma = S) # lęk somatyczny, poznawczy (z)
kontrola <- mvrnorm(n2, mu = c(0, 0), Sigma = S)
d  <- colMeans(trening) - colMeans(kontrola)
Sp <- ((n1 - 1) * cov(trening) + (n2 - 1) * cov(kontrola)) / (n1 + n2 - 2)
T2 <- (n1 * n2 / (n1 + n2)) * drop(t(d) %*% solve(Sp) %*% d)
p  <- 2; df2 <- n1 + n2 - p - 1
F  <- T2 * df2 / (p * (n1 + n2 - 2))
cat("T2 =", round(T2, 2), " F(", p, ",", df2, ") =", round(F, 2),
    " p =", fp(pf(F, p, df2, lower.tail = FALSE)), "\n")
# to samo przez MANOVA (dla dwóch grup wszystkie statystyki dają ten sam F)
Y <- rbind(trening, kontrola); g <- factor(rep(c("trening", "kontrola"), c(n1, n2)))
st <- summary(manova(Y ~ g), test = "Hotelling-Lawley")$stats[1, ]
cat("MANOVA: F(", st[4], ",", st[5], ") =", round(st[3], 2), " p =", fp(st[6]), "\n")
# osobne testy t
for (j in 1:2) { tt <- t.test(trening[, j], kontrola[, j], var.equal = TRUE)
  cat(c("somatyczny", "poznawczy")[j], ": t =", round(tt$statistic, 2), " p =", fp(tt$p.value), "\n") }
cat("D2 Mahalanobisa =", round(drop(t(d) %*% solve(Sp) %*% d), 2), "\n")
Wynik w R
T2 = 11.81  F( 2 , 57 ) = 5.8  p = .005
MANOVA: F( 2 , 57 ) = 5.8  p = .005
somatyczny : t = -1.53  p = .132
poznawczy : t = 1.33  p = .188
D2 Mahalanobisa = 0.79
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (pakiet MASS); rysunek – pakiety ggplot2 4.0.2 i patchwork 1.3.2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3-65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Czy T² Hotellinga to to samo co MANOVA?
Dla dwóch grup tak: wszystkie statystyki MANOVA dają wtedy ten sam F i to samo p co T². Przy trzech i więcej grupach potrzebna jest MANOVA.
Dlaczego T² Hotellinga jest istotny, a osobne testy t nie?
Bo T² uwzględnia korelacje zmiennych. Układ różnic nietypowy przy danej korelacji, np. niższy wynik na jednej podskali i wyższy na drugiej, daje dużą odległość Mahalanobisa, choć każda różnica osobno jest mała.
Jakie założenia ma test T² Hotellinga?
Niezależne obserwacje, wielowymiarowy rozkład normalny w grupach i równe macierze kowariancji. Przy równych liczebnościach test jest dość odporny na różne macierze; sprawdź je testem M Boxa i obejrzyj odchylenia standardowe.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Hotelling, H. (1931). The generalization of Student’s ratio. The Annals of Mathematical Statistics, 2(3), 360–378. https://doi.org/10.1214/aoms/1177732979 ● Otwarty dostęp
- Huberty, C. J., & Morris, J. D. (1989). Multivariate analysis versus multiple univariate analyses. Psychological Bulletin, 105(2), 302–308. https://doi.org/10.1037/0033-2909.105.2.302
- O’Brien, P. C. (1984). Procedures for comparing samples with multiple endpoints. Biometrics, 40(4), 1079–1087. https://doi.org/10.2307/2531158
Cytowania BibTeX
@article{hotelling1931generalization, author={Hotelling, Harold}, title={{The generalization of Student’s ratio}}, journal={The Annals of Mathematical Statistics}, year={1931}, volume={2}, number={3}, pages={360--378}, doi={10.1214/aoms/1177732979}}@article{huberty1989multivariate, author={Huberty, Carl J. and Morris, John D.}, title={{Multivariate analysis versus multiple univariate analyses}}, journal={Psychological Bulletin}, year={1989}, volume={105}, number={2}, pages={302--308}, doi={10.1037/0033-2909.105.2.302}}@article{obrien1984procedures, author={O'Brien, Peter C.}, title={{Procedures for comparing samples with multiple endpoints}}, journal={Biometrics}, year={1984}, volume={40}, number={4}, pages={1079--1087}, doi={10.2307/2531158}}