Co to jest analiza dyskryminacyjna?
Analiza dyskryminacyjna (ang. discriminant analysis), w najczęstszej wersji liniowa (LDA, ang. linear discriminant analysis), szuka takich liniowych kombinacji zmiennych – funkcji dyskryminacyjnych – które najlepiej rozróżniają z góry znane grupy. Jej początki sięgają klasycznego artykułu Fishera (1936) o wykorzystaniu wielu pomiarów jednocześnie do rozwiązywania problemów klasyfikacyjnych.
W polskojęzycznym omówieniu Radkiewicz (2010) wskazuje dwa zastosowania funkcji dyskryminacyjnej: wyjaśnianie różnic między grupami (dyskryminacja) i przypisywanie obserwacji do grup (klasyfikacja). Sherry (2006) przedstawia opisową analizę dyskryminacyjną jako alternatywę dla serii porównań grup w badaniach psychologicznych, a Boedeker i Kearns (2019) – jej predykcyjne zastosowanie: przewidywanie przynależności grupowej z oceną trafności klasyfikacji. W psychologii klinicznej pytanie może brzmieć: które objawy najlepiej odróżniają osoby z depresją, z zaburzeniem lękowym uogólnionym (GAD) i bez zaburzeń?
Analiza dyskryminacyjna różni się od analizy skupień tym, że grupy są znane. Od analizy głównych składowych różni ją cel: PCA szuka kombinacji zmiennych o największej wariancji ogółem, a analiza dyskryminacyjna – kombinacji, które najbardziej różnicują grupy.
Funkcja dyskryminacyjna i jej ocena
Funkcja dyskryminacyjna to ważona suma predyktorów:
Wagi dobiera się tak, by stosunek wariancji międzygrupowej do wewnątrzgrupowej wyniku D był jak największy. Przy g grupach i p predyktorach można wyznaczyć najwyżej min(g − 1, p) funkcji: przy trzech grupach – dwie. Każdą funkcję opisują:
- wartość własna – stosunek zmienności międzygrupowej do wewnątrzgrupowej na danej funkcji i jej odsetek w sumie wartości własnych („wariancja międzygrupowa wyjaśniona” przez funkcję);
- korelacja kanoniczna rc – związek funkcji z przynależnością do grupy;
- lambda Wilksa (Λ) z testem χ² – sprawdza, czy funkcje (od k-tej do ostatniej) różnicują grupy istotnie; Λ bliska 0 oznacza silne różnicowanie.
Do interpretacji służą dwa rodzaje współczynników. Standaryzowane współczynniki funkcji pokazują wkład zmiennej przy kontroli pozostałych, ale przy skorelowanych predyktorach bywają niestabilne. Współczynniki struktury to korelacje predyktorów z funkcją – mówią, co funkcja „mierzy”.
Założenia analizy dyskryminacyjnej
- Wielowymiarowy rozkład normalny predyktorów w każdej grupie; analiza jest dość odporna na umiarkowane odstępstwa przy podobnych liczebnościach grup.
- Jednorodność macierzy kowariancji w grupach – wielowymiarowy odpowiednik homogeniczności wariancji, sprawdzany testem M Boxa; test jest bardzo czuły w dużych próbach. Przy wyraźnie różnych macierzach rozważ kwadratową analizę dyskryminacyjną.
- Brak silnej współliniowości predyktorów.
- Brak wielowymiarowych obserwacji odstających – sprawdzisz je odległością Mahalanobisa.
- Wystarczające liczebności – najmniejsza grupa powinna być wyraźnie większa niż liczba predyktorów.
Przykład: depresja, GAD i grupa kontrolna
Trzy grupy po 60 osób – z rozpoznaniem depresji, z rozpoznaniem GAD i bez zaburzeń – wypełniły cztery kwestionariusze: ruminacji, zamartwiania się, anhedonii i pobudzenia somatycznego (dane symulowane). Średnie w grupach przedstawia tabela.
| Grupa | Ruminacja | Zamartwianie | Anhedonia | Pobudzenie |
|---|---|---|---|---|
| Kontrolna | 40.42 | 41.05 | 20.18 | 21.98 |
| Depresja | 56.12 | 51.00 | 30.47 | 25.12 |
| GAD | 49.82 | 63.55 | 23.25 | 32.82 |
Test M Boxa nie wskazał na różnice macierzy kowariancji, χ²(20) = 10.72, p = .953. Obie funkcje dyskryminacyjne okazały się istotne. Dla funkcji 1–2: Λ = .197, χ²(8) = 285.04, p < .001; dla samej funkcji 2: Λ = .521, χ²(3) = 114.30, p < .001. Pierwsza funkcja wyjaśnia 64.2% wariancji międzygrupowej (wartość własna 1.65, rc = .79), druga – 35.8% (wartość własna 0.92, rc = .69).
| Predyktor | Standaryzowany współczynnik LD1 | Standaryzowany współczynnik LD2 | Struktura LD1 | Struktura LD2 |
|---|---|---|---|---|
| Ruminacja | 0.44 | 0.45 | .13 | .76 |
| Zamartwianie | −0.76 | 0.42 | −.55 | .76 |
| Anhedonia | 0.67 | 0.46 | .36 | .76 |
| Pobudzenie | −0.59 | −0.02 | −.48 | .46 |
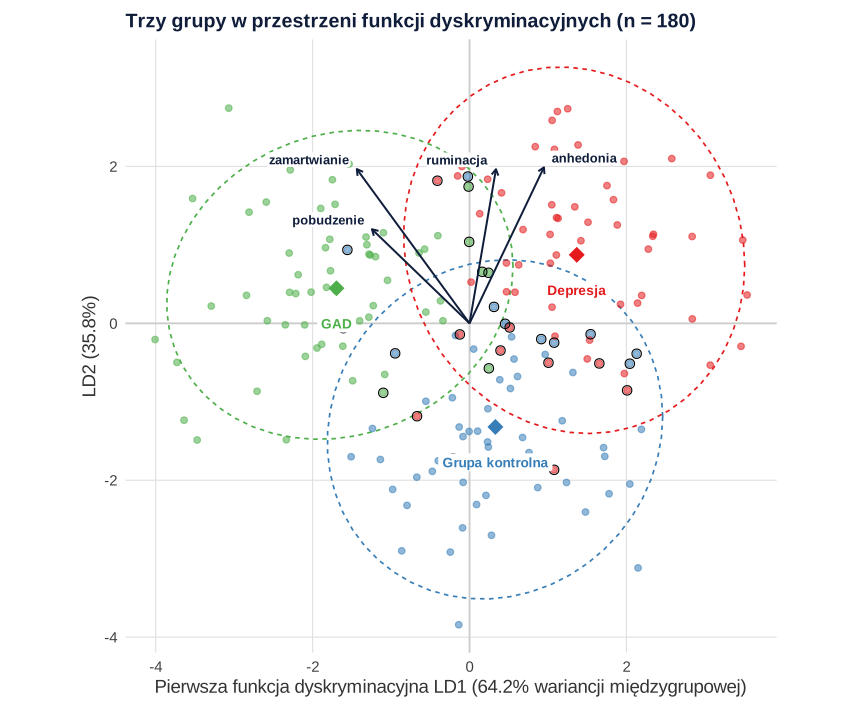
Interpretacja wynika ze współczynników struktury i centroidów. Pierwsza funkcja przeciwstawia anhedonię (.36) i – słabiej – ruminację (.13) zamartwianiu się (−.55) i pobudzeniu (−.48): odróżnia depresję (centroid 1.37) od GAD (−1.70), a grupa kontrolna leży pośrodku (0.33). Druga funkcja koreluje dodatnio ze wszystkimi predyktorami (.46–.76) – to ogólne nasilenie objawów, które odróżnia obie grupy kliniczne (0.87 i 0.45) od grupy kontrolnej (−1.32).
Klasyfikacja i macierz pomyłek
Każdą osobę można przypisać do grupy o najwyższym prawdopodobieństwie a posteriori, które łączy wyniki funkcji z prawdopodobieństwami a priori – tu równymi, po 1/3. Boedeker i Kearns (2019) omawiają w tym kontekście wybór prawdopodobieństw a priori i walidację krzyżową jako elementy oceny klasyfikacji. Klasyfikacja na tej samej próbie, na której oszacowano funkcje, jest zbyt optymistyczna: tu dała 86.7% trafień. W walidacji krzyżowej typu „zostaw jedną obserwację” (ang. leave-one-out) każdą osobę klasyfikuje się funkcjami oszacowanymi bez niej.
| Prawdziwa grupa | Przewidziana: kontrolna | Przewidziana: depresja | Przewidziana: GAD | Trafność |
|---|---|---|---|---|
| Kontrolna | 49 | 8 | 3 | 81.7% |
| Depresja | 8 | 51 | 1 | 85.0% |
| GAD | 3 | 4 | 53 | 88.3% |
W tej macierzy pomyłek poprawnie sklasyfikowano 153 ze 180 osób, czyli 85.0%, wobec 33.3% oczekiwanych przy losowym przydziale. Indeks I Huberty’ego – jedna z miar oceny klasyfikacji omawianych przez Boedekera i Kearnsa (2019) – mierzy poprawę względem przypadku i wynosi tu .775. Najczęstszy błąd to mylenie grupy kontrolnej z depresją – na rysunku te osoby leżą między centroidami.
Analiza dyskryminacyjna a regresja logistyczna i MANOVA
| Metoda | Pytanie | Rola zmiennych | Najważniejsze założenia |
|---|---|---|---|
| Analiza dyskryminacyjna | Które kombinacje zmiennych różnicują grupy i jak dobrze klasyfikują? | Grupa przewidywana z ilościowych predyktorów | Normalność wielowymiarowa, równe macierze kowariancji |
| Regresja logistyczna (wielomianowa) | Jak predyktory zmieniają szanse przynależności do grupy? | Grupa przewidywana z predyktorów dowolnego typu | Brak założeń o rozkładzie predyktorów |
| MANOVA | Czy grupy różnią się zestawem zmiennych zależnych? | Grupa jako czynnik, zmienne ilościowe jako zależne | Te same co w analizie dyskryminacyjnej |
Regresja logistyczna jest bardziej elastyczna: przyjmuje predyktory kategorialne i nie wymaga normalności. Gdy założenia LDA są spełnione, obie metody klasyfikują zwykle podobnie – w naszym przykładzie wielomianowa regresja logistyczna dała w walidacji krzyżowej 83.9% trafień wobec 85.0% dla LDA.
Z MANOVA analiza dyskryminacyjna dzieli rachunek: w przykładzie MANOVA daje tę samą lambdę Wilksa, Λ = .197, F(8, 348) = 54.49, p < .001. MANOVA odpowiada jednak tylko na pytanie, czy grupy się różnią, a analiza dyskryminacyjna pokazuje, na jakich wymiarach. Warne (2014) wskazuje opisową analizę dyskryminacyjną jako właściwą procedurę post hoc po istotnej MANOVA – choć w publikacjach stosowaną rzadko.
Jak opisać analizę dyskryminacyjną w pracy (APA)
Gdy analiza ma przede wszystkim przewidywać przynależność do grup, dołącz macierz pomyłek z walidacji krzyżowej. Szerzej o raportowaniu modeli klasyfikacyjnych piszemy we wpisie regresja logistyczna: założenia, interpretacja i raportowanie.
Analiza dyskryminacyjna w R
Kod tworzy zbiór z przykładu (dane symulowane) i wykonuje liniową analizę dyskryminacyjną funkcją lda() z pakietu MASS: liczy odsetek wariancji międzygrupowej, testy lambdy Wilksa dla funkcji, współczynniki standaryzowane i struktury, centroidy grup oraz klasyfikację na tej samej próbie i w walidacji krzyżowej. Funkcja lda() nie podaje testów istotności funkcji, dlatego lambdę Wilksa i test χ² Bartletta liczymy z wartości własnych. Test M Boxa (heplots::boxM()), MANOVA i porównanie z regresją wielomianową wykonano osobnym skryptem.
Funkcje dyskryminacyjne i klasyfikacja
R
library(MASS)      # lda()

# Dane symulowane: 3 grupy po 60 osób, 4 kwestionariusze
set.seed(48)
srednie <- rbind(kontrolna = c(ruminacja = 40, zamartwianie = 42, anhedonia = 20, pobudzenie = 22),
                 depresja  = c(56, 52, 31, 25),
                 GAD       = c(50, 63, 23, 33))
R <- matrix(.35, 4, 4); diag(R) <- 1                       # korelacje wewnątrzgrupowe
SD <- c(9, 9, 5, 6)
dane <- do.call(rbind, lapply(rownames(srednie), function(g) data.frame(
  grupa = g, mvrnorm(60, mu = srednie[g, ], Sigma = diag(SD) %*% R %*% diag(SD)))))
dane$grupa <- factor(dane$grupa, levels = rownames(srednie))
dane[, -1] <- round(dane[, -1])
aggregate(. ~ grupa, data = dane, FUN = function(x) round(mean(x), 2))

# 1. Liniowa analiza dyskryminacyjna (prawdopodobieństwa a priori równe)
lda1 <- lda(grupa ~ ., data = dane, prior = rep(1 / 3, 3))
lda1$svd^2 / sum(lda1$svd^2)                          # odsetek wariancji międzygrupowej (LD1, LD2)

# 2. Istotność funkcji: lambda Wilksa z testem chi-kwadrat Bartletta
N <- nrow(dane); p <- 4; g <- 3
wl <- lda1$svd^2 * (g - 1) / (N - g)                  # wartości własne
rc <- sqrt(wl / (1 + wl))                             # korelacje kanoniczne
for (k in 1:2) {
  L  <- prod(1 / (1 + wl[k:2]))
  chi <- -(N - 1 - (p + g) / 2) * log(L)
  df <- (p - k + 1) * (g - k)
  print(round(c(funkcje_od = k, wartosc_wlasna = wl[k], r_kan = rc[k], lambda = L, chi2 = chi, df = df,
                p = pchisq(chi, df, lower.tail = FALSE)), 4))
}

# 3. Standaryzowane współczynniki i współczynniki struktury (korelacje wewnątrzgrupowe)
X <- as.matrix(dane[, -1])
Sw <- Reduce(`+`, lapply(split(as.data.frame(X), dane$grupa), function(x) cov(x) * (nrow(x) - 1))) / (N - g)
round(lda1$scaling * sqrt(diag(Sw)), 3)
wyniki <- predict(lda1)$x
wsr <- function(M) M - apply(M, 2, function(k) ave(k, dane$grupa))     # odjęcie średnich grup
round(cor(wsr(X), wsr(wyniki)), 3)
round(aggregate(wyniki, by = list(grupa = dane$grupa), FUN = mean)[, -1], 3)   # centroidy grup

# 4. Klasyfikacja: na tej samej próbie i w walidacji krzyżowej (leave-one-out)
table(prawdziwa = dane$grupa, przewidziana = predict(lda1)$class)
cv <- lda(grupa ~ ., data = dane, prior = rep(1 / 3, 3), CV = TRUE)
tab_cv <- table(prawdziwa = dane$grupa, przewidziana = cv$class)
tab_cv
trafnosc <- sum(diag(tab_cv)) / N
round(c(trafnosc = trafnosc, I_Hubertyego = (trafnosc - 1 / 3) / (1 - 1 / 3)), 3)
Wynik w R
      grupa ruminacja zamartwianie anhedonia pobudzenie
1 kontrolna     40.42        41.05     20.18      21.98
2  depresja     56.12        51.00     30.47      25.12
3       GAD     49.82        63.55     23.25      32.82
[1] 0.6419021 0.3580979
    funkcje_od wartosc_wlasna          r_kan         lambda           chi2
        1.0000         1.6456         0.7887         0.1971       285.0425
            df              p
        8.0000         0.0000
    funkcje_od wartosc_wlasna          r_kan         lambda           chi2
        2.0000         0.9180         0.6918         0.5214       114.3012
            df              p
        3.0000         0.0000
                LD1    LD2
ruminacja     0.440  0.447
zamartwianie -0.758  0.421
anhedonia     0.668  0.458
pobudzenie   -0.586 -0.015
                LD1   LD2
ruminacja     0.130 0.756
zamartwianie -0.553 0.756
anhedonia     0.365 0.765
pobudzenie   -0.478 0.461
     LD1    LD2
1  0.329 -1.321
2  1.367  0.874
3 -1.696  0.447
           przewidziana
prawdziwa   kontrolna depresja GAD
  kontrolna        49        8   3
  depresja          6       53   1
  GAD               2        4  54
           przewidziana
prawdziwa   kontrolna depresja GAD
  kontrolna        49        8   3
  depresja          8       51   1
  GAD               3        4  53
    trafnosc I_Hubertyego
       0.850        0.775
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 oraz skryptu z testem M Boxa (heplots) i regresją wielomianową (nnet); rysunek przygotowano w pakiecie ggplot2. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- MASS (wersja 7.3.65): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer.
- heplots (wersja 1.8.1): Friendly, M., Fox, J., & Monette, G. (2025). heplots: Visualizing tests in multivariate linear models (R package version 1.8.1) [Computer software]. https://CRAN.R-project.org/package=heplots
- nnet (wersja 7.3.20): Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4th ed.). Springer.
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Raportowanie trafności klasyfikacji na tej samej próbie – jest zawyżona; podawaj wynik walidacji krzyżowej (tu 85.0% zamiast 86.7%).
- Interpretowanie tylko standaryzowanych współczynników – przy skorelowanych predyktorach mogą mieć nawet przeciwny znak niż korelacja zmiennej z funkcją; zawsze dodaj współczynniki struktury.
- Pominięcie oceny względem przypadku – 85% trafień znaczy co innego przy trzech równych grupach i przy jednej grupie obejmującej 90% próby.
- Zbyt wiele predyktorów przy małych grupach – funkcje dopasowują się do szumu i źle klasyfikują nowe osoby.
- Seria osobnych ANOVA zamiast analizy wielowymiarowej – osobne testy pomijają korelacje między zmiennymi; Sherry (2006) proponuje opisową analizę dyskryminacyjną właśnie jako alternatywę dla takich porównań.
- Utożsamianie funkcji z przyczynami przynależności do grupy – funkcje opisują różnice, a nie mechanizmy ich powstania.
Najczęstsze pytania
Co to jest analiza dyskryminacyjna?
To metoda, która szuka liniowych kombinacji zmiennych najlepiej odróżniających znane grupy, np. osoby z depresją, z GAD i bez zaburzeń. Służy do opisu różnic między grupami (które zmienne je różnicują) i do klasyfikacji – przypisywania osób do grup na podstawie ich wyników.
Jak interpretować funkcje dyskryminacyjne?
Sprawdź, czy funkcja jest istotna (lambda Wilksa), ile wariancji międzygrupowej wyjaśnia i które grupy rozdziela (centroidy). Jej znaczenie odczytasz ze współczynników struktury, czyli korelacji predyktorów z funkcją. W przykładzie pierwsza funkcja (64.2%) odróżniała depresję od GAD, a druga (35.8%) – grupy kliniczne od kontrolnej.
Co oznacza lambda Wilksa w analizie dyskryminacyjnej?
Lambda Wilksa to odsetek zmienności wyników funkcji, który nie wynika z różnic między grupami. Przyjmuje wartości od 0 do 1: im bliżej 0, tym silniej funkcje różnicują grupy. Towarzyszy jej test χ², np. Λ = .197, χ²(8) = 285.04, p < .001.
Czym różni się analiza dyskryminacyjna od regresji logistycznej?
Obie przewidują przynależność do grupy, ale analiza dyskryminacyjna zakłada normalność wielowymiarową i równe macierze kowariancji w grupach, a regresja logistyczna nie stawia wymagań co do rozkładu predyktorów i przyjmuje predyktory kategorialne. Przy spełnionych założeniach klasyfikują podobnie: w przykładzie 85.0% wobec 83.9% trafień.
Jaka jest różnica między analizą dyskryminacyjną a MANOVA?
Rachunek jest wspólny (ta sama lambda Wilksa), ale pytania inne. MANOVA sprawdza, czy grupy różnią się zestawem zmiennych zależnych, a analiza dyskryminacyjna pokazuje, na jakich wymiarach i jak dobrze zmienne rozdzielają grupy. Dlatego opisową analizę dyskryminacyjną stosuje się jako procedurę następczą po istotnej MANOVA.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Regresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →PoradnikJak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Boedeker, P., & Kearns, N. T. (2019). Linear discriminant analysis for prediction of group membership: A user-friendly primer. Advances in Methods and Practices in Psychological Science, 2(3), 250–263. https://doi.org/10.1177/2515245919849378
- Fisher, R. A. (1936). The use of multiple measurements in taxonomic problems. Annals of Eugenics, 7(2), 179–188. https://doi.org/10.1111/j.1469-1809.1936.tb02137.x ● Otwarty dostęp
- Radkiewicz, P. (2010). Analiza dyskryminacyjna. Podstawowe założenia i zastosowania w badaniach społecznych. Psychologia Społeczna, 5(2–3), 142–161. https://www.ceeol.com/search/article-detail?id=229292 ● Otwarty dostęp
- Sherry, A. (2006). Discriminant analysis in counseling psychology research. The Counseling Psychologist, 34(5), 661–683. https://doi.org/10.1177/0011000006287103
- Warne, R. T. (2014). A primer on multivariate analysis of variance (MANOVA) for behavioral scientists. Practical Assessment, Research, and Evaluation, 19, Article 17. https://doi.org/10.7275/sm63-7h70 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{boedeker2019linear, author={Boedeker, Peter and Kearns, Nathan T.}, title={{Linear discriminant analysis for prediction of group membership: A user-friendly primer}}, journal={Advances in Methods and Practices in Psychological Science}, year={2019}, volume={2}, number={3}, pages={250--263}, doi={10.1177/2515245919849378}}@article{fisher1936use, author={Fisher, Ronald A.}, title={{The use of multiple measurements in taxonomic problems}}, journal={Annals of Eugenics}, year={1936}, volume={7}, number={2}, pages={179--188}, doi={10.1111/j.1469-1809.1936.tb02137.x}}@article{radkiewicz2010analiza, author={Radkiewicz, Piotr}, title={{Analiza dyskryminacyjna. Podstawowe założenia i zastosowania w badaniach społecznych}}, journal={Psychologia Społeczna}, year={2010}, volume={5}, number={2–3}, pages={142--161}, url={https://www.ceeol.com/search/article-detail?id=229292}}@article{sherry2006discriminant, author={Sherry, Alissa}, title={{Discriminant analysis in counseling psychology research}}, journal={The Counseling Psychologist}, year={2006}, volume={34}, number={5}, pages={661--683}, doi={10.1177/0011000006287103}}@article{warne2014primer, author={Warne, Russell T.}, title={{A primer on multivariate analysis of variance (MANOVA) for behavioral scientists}}, journal={Practical Assessment, Research, and Evaluation}, year={2014}, volume={19}, eid={17}, doi={10.7275/sm63-7h70}}