Co to jest analiza przeżycia?
Analiza przeżycia (ang. survival analysis), nazywana też analizą czasu do zdarzenia (ang. time-to-event analysis), to zestaw metod, w których zmienną wynikową jest czas, jaki upływa do wystąpienia zdarzenia. Nazwa pochodzi z medycyny, gdzie zdarzeniem był zgon, ale zdarzenie może być dowolne: nawrót depresji, rezygnacja z terapii, powrót do nałogu, pierwsza próba samobójcza, ukończenie studiów. Willett i Singer (1993) pokazują, jak tymi metodami odpowiadać na typowe pytania psychologii klinicznej o początek zaburzenia, ustąpienie objawów, nawrót i powrót do zdrowia. Dane do takiej analizy pochodzą zwykle z obserwacji rozciągniętej w czasie, czyli z badania w schemacie podłużnym.
Dlaczego nie wystarczy zwykła regresja liniowa albo test t dla czasu do zdarzenia? Clark i in. (2003) wskazują dwa powody: czasy do zdarzenia mają zwykle rozkład silnie skośny, a co ważniejsze – dane są ucięte (cenzurowane): u części osób zdarzenie nie wystąpiło do końca obserwacji, więc ich prawdziwego czasu nie znamy. Z kolei regresja logistyczna sprawdziłaby tylko, czy zdarzenie wystąpiło, a pominęłaby, kiedy do niego doszło.
Obserwacje ucięte (cenzurowane)
Obserwacja jest ucięta prawostronnie, gdy wiemy tylko tyle, że do pewnego momentu zdarzenie nie wystąpiło. Dzieje się tak z dwóch powodów: badanie się kończy (np. po 52 tygodniach) albo osoba wycofuje się wcześniej – przeprowadza się, przestaje odbierać telefon. Takich osób nie wolno usuwać, bo do chwili ucięcia dostarczają cennej informacji, ani traktować jak osób, u których doszło do zdarzenia.
Metody analizy przeżycia wykorzystują tę częściową informację, ale przyjmują ważne założenie: ucięcie obserwacji musi być niezależne od czasu do zdarzenia. Takie założenie leży u podstaw estymatora Kaplana i Meiera (1958). Jeśli z badania wycofują się głównie osoby, u których właśnie zaczyna się nawrót, wyniki będą zbyt optymistyczne – to ten sam problem co przy brakach danych zależnych od nieznanej wartości (zob. braki danych MCAR, MAR i MNAR).
Funkcja przeżycia, hazard i estymator Kaplana–Meiera
Funkcja przeżycia S(t) to prawdopodobieństwo, że zdarzenie nie wystąpi przed czasem t (u nas: odsetek osób bez nawrotu po t tygodniach). Hazard h(t) to chwilowe tempo występowania zdarzenia u osób, u których jeszcze do niego nie doszło. Kaplan i Meier (1958) zaproponowali nieparametryczny estymator iloczynowy (ang. product-limit) odsetka osób „przeżywających” dłużej niż t przy danych niekompletnych:
- ti – kolejne czasy, w których wystąpiło zdarzenie;
- di – liczba zdarzeń w czasie ti;
- ni – liczba osób „w ryzyku” tuż przed ti: bez zdarzenia i z obserwacją jeszcze nieuciętą.
Krzywa Kaplana–Meiera spada schodkowo przy każdym zdarzeniu, a osoby ucięte po prostu znikają z mianownika. Zamiast średniej podaje się zwykle medianę czasu do zdarzenia: moment, w którym krzywa przecina 0.5.
Przykład: czas do nawrotu depresji
160 osób, które ukończyły skuteczną terapię depresji, obserwowano przez 52 tygodnie (dane symulowane). Połowa uczestniczyła w comiesięcznych sesjach podtrzymujących, połowa – nie. Nawrót wystąpił u 56 z 80 osób bez sesji i u 42 z 80 osób z sesjami. Obserwacje 62 osób (38.8%) były ucięte: 43 osoby dotrwały do 52. tygodnia bez nawrotu, a 19 wycofało się wcześniej z innych powodów.
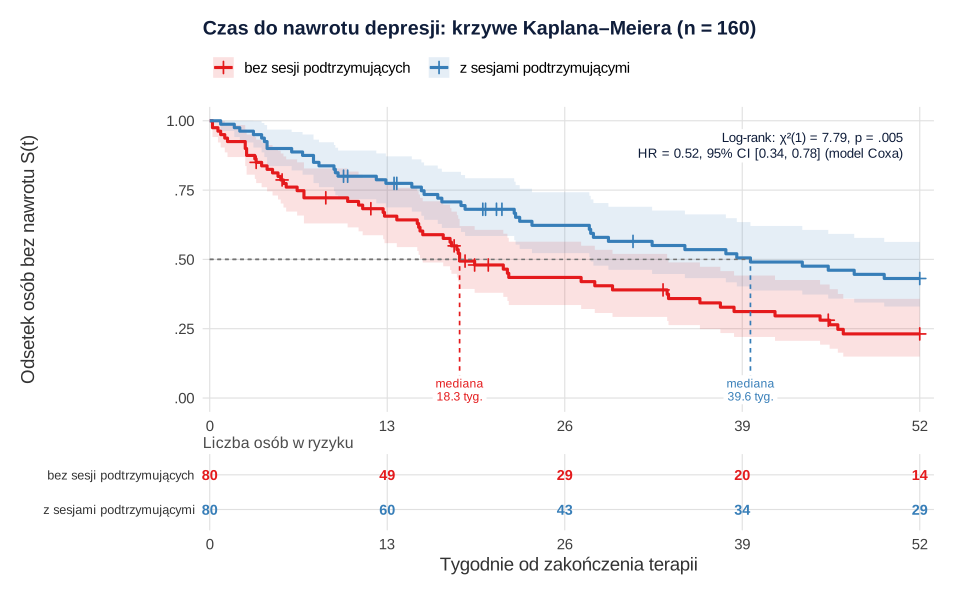
Krzywa grupy bez sesji podtrzymujących opada szybciej. Mediana czasu do nawrotu wyniosła w niej 18.3 tygodnia (95% CI [15.6, 33.6]), a w grupie z sesjami – 39.6 tygodnia (dolna granica 95% CI: 27.9 tygodnia; górnej nie osiągnięto w okresie obserwacji). Po pół roku bez nawrotu było 43.5% osób bez sesji (95% CI [33.5, 56.4]) i 62.3% osób z sesjami (95% CI [52.3, 74.2]), a po roku – odpowiednio 23.1% (95% CI [14.9, 35.8]) i 43.1% (95% CI [33.0, 56.3]).
Test log-rank: porównanie krzywych
Test log-rank sprawdza hipotezę zerową, że krzywe przeżycia w grupach są takie same. W każdym momencie zdarzenia porównuje liczbę zdarzeń obserwowanych (O) w grupie z liczbą oczekiwaną (E), gdyby hazard był wspólny, i sumuje te różnice w statystykę o rozkładzie χ². W przykładzie w grupie bez sesji zaobserwowano 56 nawrotów przy 42.37 oczekiwanych, a w grupie z sesjami – 42 przy 55.63 oczekiwanych. Różnica jest istotna: χ²(1) = 7.79, p = .005.
Test log-rank ma największą moc, gdy hazardy są proporcjonalne. Jeśli krzywe się przecinają, może nie wykryć nawet dużych różnic, dlatego zawsze patrz na wykres.
Regresja Coxa i iloraz hazardów
Test log-rank nie pozwala kontrolować innych zmiennych ani nie mówi, jak duży jest efekt. Do tego służy model proporcjonalnych hazardów Coxa (1972): funkcja hazardu jest w nim iloczynem nieznanej funkcji czasu i funkcji zmiennych objaśniających.
Hazard bazowy h0(t) może mieć dowolny kształt – nie trzeba go szacować, bo współczynniki wyznacza się z wiarygodności warunkowej. Wynik interpretuje się przez iloraz hazardów (HR): HR = 1 oznacza brak efektu, HR < 1 – niższe tempo zdarzeń, HR > 1 – wyższe. W przykładzie, przy kontroli liczby wcześniejszych epizodów depresji:
| Predyktor | β | HR | 95% CI dla HR | z | p |
|---|---|---|---|---|---|
| Sesje podtrzymujące (tak vs nie) | −0.66 | 0.52 | [0.34, 0.78] | −3.17 | .002 |
| Liczba wcześniejszych epizodów | 0.21 | 1.24 | [1.06, 1.45] | 2.65 | .008 |
U osób z sesjami podtrzymującymi hazard nawrotu był w każdym momencie mniej więcej o połowę niższy (HR = 0.52), a każdy wcześniejszy epizod zwiększał go o około 24% (HR = 1.24). Iloraz hazardów to nie to samo co iloraz szans ani stosunek odsetków osób z nawrotem: opisuje tempo zdarzeń w czasie, a nie skumulowane ryzyko na koniec obserwacji. Wniosek przyczynowy uzasadnia dopiero losowy przydział do grup.
Kluczowe założenie modelu Coxa to proporcjonalność hazardów: stosunek hazardów w grupach jest stały w czasie. Sprawdza się je testem opartym na resztach Schoenfelda (w R: cox.zph()). W przykładzie założenie nie zostało naruszone: dla grupy p = .696, dla liczby epizodów p = .309, test globalny χ²(2) = 1.38, p = .503.
Gdy czas mierzy się w szerokich przedziałach – tygodniach terapii, semestrach, kolejnych falach badania – lepiej sprawdza się dyskretna analiza przeżycia, którą Willett i Singer (1993) opisują na przykładach depresji, myśli samobójczych i nawrotów używania kokainy.
Jak opisać analizę przeżycia w pracy (APA)
Do opisu dołącz wykres Kaplana–Meiera z liczbą osób w ryzyku – czytelnik od razu zobaczy, ile osób zostało w obserwacji. Więcej o wyborze metody do pytania badawczego przeczytasz we wpisie jak dobrać test statystyczny do hipotezy.
Analiza przeżycia w R
Kod tworzy zbiór z przykładu (dane symulowane) i w pakiecie survival wyznacza krzywe Kaplana–Meiera, wykonuje test log-rank, dopasowuje model Coxa i sprawdza proporcjonalność hazardów. Liczby w tekście i na rysunku pochodzą z tego kodu; rysunek wykonano w ggplot2 bezpośrednio z obiektu survfit. W R obiekt Surv(czas, nawrot) łączy czas obserwacji ze wskaźnikiem zdarzenia (1 = nawrót, 0 = obserwacja ucięta).
Kaplan–Meier, log-rank i regresja Coxa
R
library(survival)

# Dane symulowane: 160 osób po skutecznej terapii depresji, obserwacja przez 52 tygodnie
set.seed(47)
n <- 160
grupa    <- factor(rep(c("bez sesji podtrzymujących", "z sesjami podtrzymującymi"), each = n / 2),
                   levels = c("bez sesji podtrzymujących", "z sesjami podtrzymującymi"))
epizody  <- rpois(n, 1.5)                                  # liczba wcześniejszych epizodów depresji
hazard   <- 0.018 * exp(log(0.5) * (grupa == "z sesjami podtrzymującymi") + log(1.25) * epizody)
t_nawrot <- rexp(n, rate = hazard)                         # czas do nawrotu (tygodnie)
t_odejscie <- rexp(n, rate = 0.004)                        # wycofanie z badania z innych powodów
czas   <- round(pmin(t_nawrot, t_odejscie, 52), 1)
nawrot <- as.numeric(t_nawrot <= pmin(t_odejscie, 52))     # 1 = nawrót, 0 = obserwacja ucięta
dane <- data.frame(czas, nawrot, grupa, epizody)
table(dane$grupa, nawrot = dane$nawrot)

# 1. Krzywe Kaplana–Meiera: mediana czasu do nawrotu i odsetek bez nawrotu po 26 i 52 tygodniach
km <- survfit(Surv(czas, nawrot) ~ grupa, data = dane)
print(km)
summary(km, times = c(26, 52))

# 2. Test log-rank: obserwowane (O) i oczekiwane (E) nawroty, statystyka chi-kwadrat
lr <- survdiff(Surv(czas, nawrot) ~ grupa, data = dane)
round(cbind(N = lr$n, O = lr$obs, E = lr$exp), 2)
round(c(chi2 = lr$chisq, df = 1, p = pchisq(lr$chisq, df = 1, lower.tail = FALSE)), 4)

# 3. Regresja Coxa: iloraz hazardów (HR) z kontrolą liczby epizodów
cox <- coxph(Surv(czas, nawrot) ~ grupa + epizody, data = dane)
summary(cox)

# 4. Założenie proporcjonalnych hazardów (reszty Schoenfelda)
cox.zph(cox)
Wynik w R
                           nawrot
                             0  1
  bez sesji podtrzymujących 24 56
  z sesjami podtrzymującymi 38 42
Call: survfit(formula = Surv(czas, nawrot) ~ grupa, data = dane)

                                 n events median 0.95LCL 0.95UCL
grupa=bez sesji podtrzymujących 80     56   18.3    15.6    33.6
grupa=z sesjami podtrzymującymi 80     42   39.6    27.9      NA
Call: survfit(formula = Surv(czas, nawrot) ~ grupa, data = dane)

                grupa=bez sesji podtrzymujących
 time n.risk n.event survival std.err lower 95% CI upper 95% CI
   26     29      43    0.435  0.0576        0.335        0.564
   52     14      13    0.231  0.0515        0.149        0.358

                grupa=z sesjami podtrzymującymi
 time n.risk n.event survival std.err lower 95% CI upper 95% CI
   26     43      29    0.623  0.0557        0.523        0.742
   52     29      13    0.431  0.0587        0.330        0.563

                                 N  O     E
grupa=bez sesji podtrzymujących 80 56 42.37
grupa=z sesjami podtrzymującymi 80 42 55.63
  chi2     df      p
7.7943 1.0000 0.0052
Call:
coxph(formula = Surv(czas, nawrot) ~ grupa + epizody, data = dane)

  n= 160, number of events= 98

                                   coef exp(coef) se(coef)      z Pr(>|z|)
grupaz sesjami podtrzymującymi -0.66218   0.51573  0.20898 -3.169  0.00153 **
epizody                         0.21424   1.23892  0.08078  2.652  0.00800 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

                               exp(coef) exp(-coef) lower .95 upper .95
grupaz sesjami podtrzymującymi    0.5157     1.9390    0.3424    0.7768
epizody                           1.2389     0.8072    1.0575    1.4515

Concordance= 0.619  (se = 0.029 )
Likelihood ratio test= 14.42  on 2 df,   p=7e-04
Wald test            = 14.33  on 2 df,   p=8e-04
Score (logrank) test = 14.55  on 2 df,   p=7e-04

        chisq df    p
grupa   0.152  1 0.70
epizody 1.035  1 0.31
GLOBAL  1.375  2 0.50
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3; rysunek przygotowano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R (R package version 3.8-6) [Computer software]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots (R package version 1.3.2) [Computer software]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze błędy
- Usuwanie obserwacji uciętych albo traktowanie ich jak zdarzeń – zawyża lub zaniża odsetek zdarzeń i skraca czasy.
- Porównywanie średnich czasów testem t lub testem Manna-Whitneya – te testy nie uwzględniają ucięcia obserwacji (Clark i in., 2003).
- Podawanie średniego czasu przeżycia zamiast mediany – przy uciętych danych średnia jest zaniżona, a rozkład czasu zwykle silnie skośny.
- Pominięcie sprawdzenia proporcjonalności hazardów w modelu Coxa – gdy krzywe się przecinają, jeden HR źle opisuje efekt.
- Interpretowanie HR jak ryzyka względnego – „HR = 0.52” nie znaczy, że nawrót wystąpi u o połowę mniejszej liczby osób na koniec obserwacji.
- Ignorowanie powodów wycofania z badania – jeśli odchodzą głównie osoby bliskie zdarzenia, założenie niezależnego ucięcia nie jest spełnione.
Najczęstsze pytania
Co to jest analiza przeżycia?
To metody analizy czasu do wystąpienia zdarzenia, np. nawrotu depresji, rezygnacji z terapii czy ukończenia studiów. Ich wyróżnikiem jest uwzględnianie obserwacji uciętych, czyli osób, u których zdarzenie nie wystąpiło do końca obserwacji albo które wycofały się z badania. Najczęściej stosuje się krzywe Kaplana–Meiera, test log-rank i regresję Coxa.
Co to jest obserwacja ucięta (cenzurowana)?
To obserwacja, o której wiemy tylko, że do pewnego momentu zdarzenie nie wystąpiło – bo badanie się skończyło albo osoba się wycofała. Takich osób nie wolno usuwać ani traktować jak zdarzeń. Metody analizy przeżycia zakładają, że ucięcie jest niezależne od czasu do zdarzenia.
Jak interpretować iloraz hazardów (HR)?
HR porównuje tempo występowania zdarzenia w dwóch grupach w każdym momencie obserwacji. HR = 1 oznacza brak różnicy, HR < 1 – wolniejsze tempo zdarzeń, HR > 1 – szybsze. W przykładzie HR = 0.52, 95% CI [0.34, 0.78]: przy sesjach podtrzymujących hazard nawrotu był mniej więcej o połowę niższy.
Czym różni się test log-rank od regresji Coxa?
Test log-rank porównuje całe krzywe przeżycia grup i daje wartość p, ale nie miarę efektu ani kontrolę innych zmiennych. Regresja Coxa szacuje ilorazy hazardów dla wielu predyktorów jednocześnie, np. grupy i liczby wcześniejszych epizodów, przy założeniu proporcjonalnych hazardów.
Dlaczego nie można porównać średnich czasów testem t?
Bo u części osób nie znamy prawdziwego czasu do zdarzenia – obserwacja została ucięta. Usunięcie takich osób albo wpisanie im czasu końca badania zniekształca wyniki. Rozkład czasu do zdarzenia jest też zwykle silnie skośny, dlatego podaje się medianę z krzywej Kaplana–Meiera.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Jak dobrać test statystyczny do hipotezy?
Skala pomiaru, liczba grup i układ badania: tabela doboru testów, trzy przykłady, założenia, skala Likerta, kod R i checklista przed analizą.
Czytaj →PoradnikRegresja logistyczna: założenia, interpretacja i raportowanie modelu
Regresja logistyczna w praktyce: założenia, iloraz szans, diagnostyka, kalibracja, AUC oraz zasady rzetelnego raportowania modelu.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Clark, T. G., Bradburn, M. J., Love, S. B., & Altman, D. G. (2003). Survival analysis part I: Basic concepts and first analyses. British Journal of Cancer, 89(2), 232–238. https://doi.org/10.1038/sj.bjc.6601118 ● Otwarty dostęp
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Willett, J. B., & Singer, J. D. (1993). Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence. Journal of Consulting and Clinical Psychology, 61(6), 952–965. https://doi.org/10.1037/0022-006X.61.6.952
Cytowania BibTeX
@article{clark2003survival, author={Clark, T. G. and Bradburn, M. J. and Love, S. B. and Altman, D. G.}, title={{Survival analysis part I: Basic concepts and first analyses}}, journal={British Journal of Cancer}, year={2003}, volume={89}, number={2}, pages={232--238}, doi={10.1038/sj.bjc.6601118}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{willett1993investigating, author={Willett, John B. and Singer, Judith D.}, title={{Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence}}, journal={Journal of Consulting and Clinical Psychology}, year={1993}, volume={61}, number={6}, pages={952--965}, doi={10.1037/0022-006x.61.6.952}}