Przykład: centrum dystrybucyjne i 1800 przyjętych
Fikcyjny operator logistyczny ma centrum dystrybucyjne z trzema magazynami: Północ, Centrum i Południe. Pracownicy fizyczni kompletują i pakują zamówienia na zmianie dziennej albo nocnej, zatrudnieni na umowę o pracę albo przez agencję pracy tymczasowej. Dział personalny pyta: kto odchodzi, kiedy odchodzi i czy to jego decyzja, czy firmy?
Mamy 1800 osób przyjętych od 2 stycznia 2023 do 30 września 2026. Dane kadrowe pobrano 31 października 2026. Znamy magazyn, zmianę, formę zatrudnienia, wiek, datę przyjęcia, staż i wynik: nadal pracuje, odeszła sama albo została zwolniona (wypowiedzenie lub nieprzedłużenie umowy przez firmę). Każdy zaczyna od trzymiesięcznego okresu próbnego, a w agencji – od pierwszego trzymiesięcznego kontraktu.
Wynikiem jest czas do zdarzenia, więc to zadanie dla analizy przeżycia. Względem wpisu o odejściach klientów (churn) dochodzą dwa wykluczające się typy odejścia i okres próbny. Procedurę ogólną znajdziesz we wpisie Kaplan–Meier i model Coxa krok po kroku, a okna SPSS – w poradniku Kaplan–Meier i regresja Coxa w SPSS.
Dane są fikcyjne i wiemy, co w nich ukryliśmy. Miesięczne ryzyko odejścia dobrowolnego ustawiliśmy ręcznie na 4.5% w 1. miesiącu, 3.5% w 2., 7% w 3. (koniec okresu próbnego), 3% w miesiącach 4–6, 2% w miesiącach 7–12 i 1.2% później. Ryzyko zwolnienia to 1% w miesiącach 1–2, 6% w 3. i 0.5% później. Odejścia dobrowolne mnożą: zmiana nocna (× 1.5), agencja (× 1.4), magazyn Południe (× 1.35) i każde 10 lat wieku (× 0.8); zwolnienia – tylko agencja (× 2). Udziały grup (40% na nocnej zmianie; agencja z prawdopodobieństwem 35% na dziennej i 50% na nocnej) i wiek (średnio 33 lata) też ustaliliśmy ręcznie, tak by skok w 3. miesiącu był wyraźny. Ziarno 641 ustalono raz i nie zmieniano go. Dane pobierzesz jako rotacja-pracownicy-magazynu.csv.
Rysunek 1: oś czasu, cenzurowanie i dwa typy odejścia
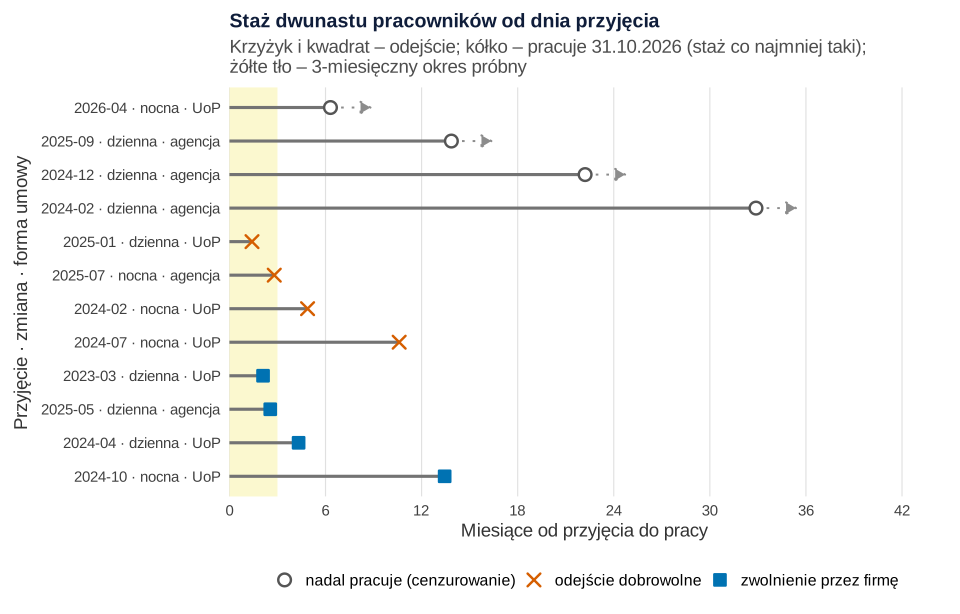
set.seed(641)).Co widać. Każdy odcinek to jedna osoba liczona od dnia przyjęcia. Wybraliśmy regułą po cztery osoby z każdego wyniku (staż najbliższy 20., 40., 60. i 80. percentylowi w grupie). Kółko oznacza, że 31 października 2026 osoba wciąż pracuje: wiemy tylko, że jej staż wyniesie co najmniej tyle. To obserwacja cenzurowana. W całych danych 806 osób (44.8%) odeszło samych, 276 (15.3%) zwolniono, a 718 (39.9%) wciąż pracuje.
Jak może zmylić. Prosty odsetek odchodzących (55.6% na zmianie dziennej, 66.7% na nocnej) miesza osoby przyjęte trzy lata temu z przyjętymi w sierpniu. Mediany stażu odchodzących (3.3 miesiąca) i pracujących (18.4) też nie są „typowym stażem”. Estymator Kaplana i Meiera (1958) wykorzystuje obie informacje, jeśli cenzurowanie nie wiąże się z ryzykiem odejścia. Tu wynika ono tylko z daty pobrania danych.
Podpis do pracy:
Rysunek 2: kto zostaje dłużej – krzywe Kaplana–Meiera
Krzywa Kaplana–Meiera pokazuje, jaki odsetek przyjętych wciąż pracuje po t miesiącach. Na razie liczymy każde odejście, bez względu na typ.
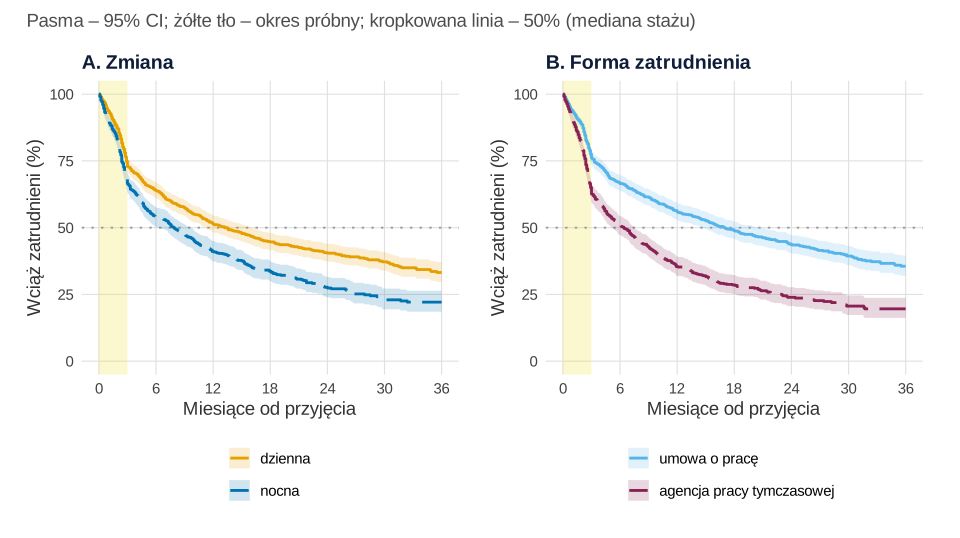
set.seed(641)).Co widać. Najszybciej krzywe spadają w okresie próbnym. Po roku pracuje 51.3%, 95% CI [48.3, 54.6], osób ze zmiany dziennej i 41.1%, 95% CI [37.5, 45.0], z nocnej. Mediana stażu to 13.2 miesiąca, 95% CI [11.2, 16.1], na dziennej i 7.8 miesiąca, 95% CI [6.3, 9.7], na nocnej. Różnica między formami zatrudnienia jest większa: mediana 16.9 miesiąca przy umowie o pracę i 6.4 miesiąca w agencji. Test log-rank: dla zmiany χ²(1) = 27.6, p < .001; dla formy zatrudnienia χ²(1) = 77.0, p < .001.
Jak może zmylić. Na nocnej zmianie przez agencję pracuje 49.0% osób, na dziennej – 39.0%. Panel A miesza więc efekt zmiany z efektem umowy; rozdziela je dopiero model z rysunku 5. Krzywa sumuje też dwa różne zjawiska: odejścia na własne życzenie i zwolnienia.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: kiedy odchodzą – skok na końcu okresu próbnego
Krzywa mówi, ilu zostało. Hazard mówi, kiedy odchodzą: ile odejść przypada na 100 osobomiesięcy przepracowanych w danym miesiącu stażu. Liczymy go osobno dla każdego typu odejścia, z tym samym mianownikiem. Willett i Singer (1993) pokazują, że takie spojrzenie okres po okresie odpowiada wprost na pytanie „kiedy?”.
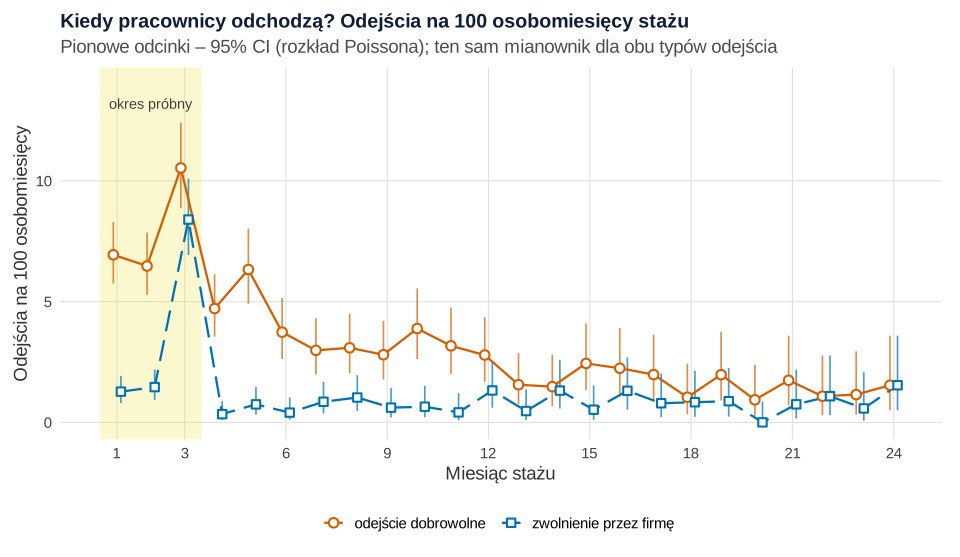
set.seed(641)).Co widać. W 3. miesiącu, gdy kończy się okres próbny, odejścia razem skaczą z 7.9 do 18.9 na 100 osobomiesięcy. Rosną oba typy: zwolnienia z 1.5 do 8.4, 95% CI [6.9, 10.1], bo firma nie przedłuża części umów, a odejścia dobrowolne z 6.5 do 10.5, 95% CI [8.9, 12.4], bo część osób czeka do końca próbnej umowy. W 4. miesiącu zwolnień prawie nie ma (0.3). Po roku hazard łączny spada do około 3–4.
Jak może zmylić. Malejący hazard nie znaczy, że każdy pracownik z czasem się przywiązuje. Najpierw odchodzą osoby najmniej dopasowane do pracy. Przedziały po 18. miesiącu są szerokie, bo w ryzyku jest coraz mniej osób.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: ryzyka konkurencyjne – kto odszedł którą drogą
Zwolniona osoba nie może już odejść sama. To ryzyko konkurencyjne. Częsta pomyłka to 1 − Kaplan–Meier dla odejść dobrowolnych ze zwolnionymi jako „cenzurowanymi” – krzywa dla świata, w którym nikt nie jest zwalniany. Odsetek, który rzeczywiście odszedł daną drogą, daje funkcja skumulowanej częstości (CIF, estymator Aalena–Johansena). Dopełnienie Kaplana–Meiera zawyża tę częstość (Austin i in., 2016).
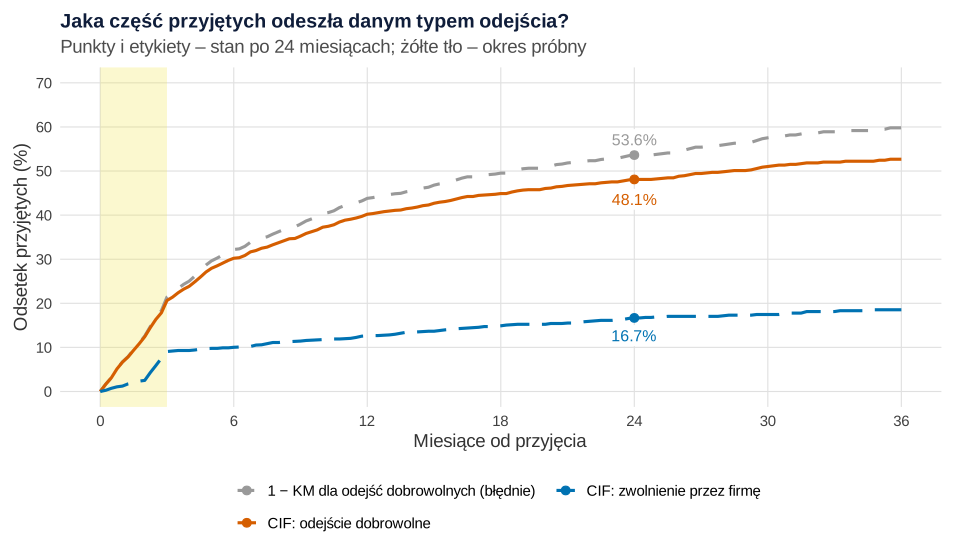
set.seed(641)).Co widać. W pierwszym roku stażu 40.2%, 95% CI [37.9, 42.6], przyjętych odchodzi samych, a 12.6% zostaje zwolnionych. Po dwóch latach to 48.1% i 16.7%. Naiwna krzywa pokazuje 53.6% odejść dobrowolnych po 24 miesiącach, czyli o 5.5 punktu procentowego za dużo. Po 12 miesiącach na zmianie nocnej sama odeszła prawie połowa osób (48.2% wobec 34.8% na dziennej), a zwolniono ich mniej (10.7% wobec 13.9%).
Jak może zmylić. Im częstsze zdarzenie konkurujące, tym większy błąd naiwnej krzywej. Szczegóły i model Fine’a–Graya opisuje wpis Ryzyka konkurencyjne: Fine–Gray i CIF.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: model Coxa – jeden HR czy dwa?
Model Coxa ocenia kilka zmiennych naraz (Cox, 1972). Każda dostaje iloraz hazardów (HR): ile razy szybciej (HR > 1) albo wolniej (HR < 1) odchodzą osoby z daną cechą przy tych samych pozostałych zmiennych. Dopasowujemy trzy modele z tymi samymi zmiennymi: dla wszystkich odejść i osobno dla każdego typu. Dwa ostatnie to modele hazardów przyczynowo-specyficznych: drugi typ odejścia kończy obserwację jak cenzurowanie.
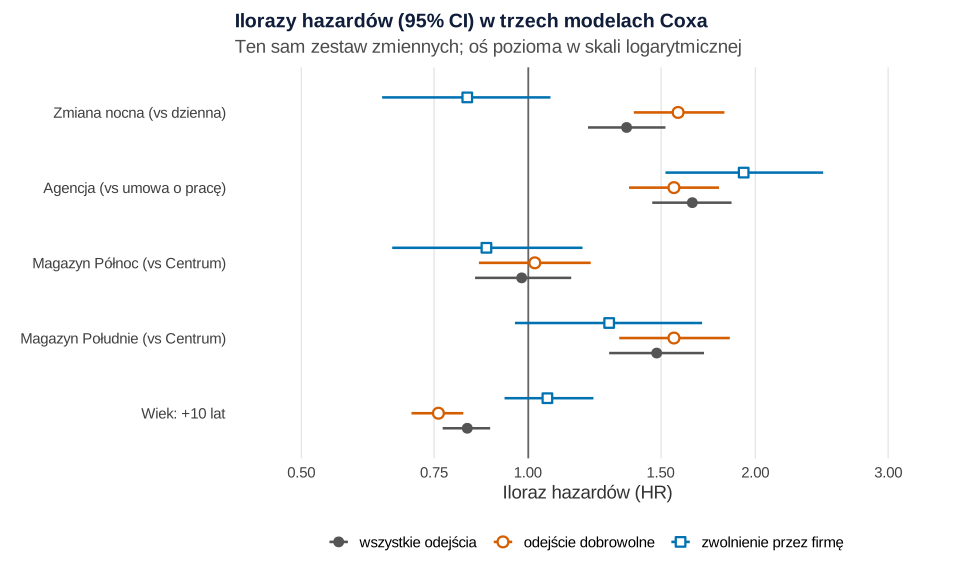
set.seed(641)).Co widać. W modelu wszystkich odejść zmiana nocna ma HR = 1.35, 95% CI [1.20, 1.52]. Ta liczba to średnia dwóch różnych historii. Osoby z nocnej zmiany same odchodzą szybciej (HR = 1.58, 95% CI [1.38, 1.82]), ale nie są częściej zwalniane (HR = 0.83, 95% CI [0.64, 1.07], p = .143). Agencja wiąże się z szybszymi odejściami obu typów (HR = 1.56 i 1.93). Wiek wiąże się tylko z odejściami dobrowolnymi (HR = 0.76 na każde 10 lat). Magazyn Południe ma HR = 1.56 dla odejść dobrowolnych, 95% CI [1.32, 1.85].
Jak może zmylić. HR = 1.58 to szybsze tempo odejść, a nie o 58 punktów procentowych więcej odejść – ile osób odejdzie, pokazuje CIF. Dlatego Latouche i in. (2013) zalecają raportować razem hazardy wszystkich typów zdarzenia i funkcje CIF. Model zakłada też stały HR w czasie. Test oparty na resztach Schoenfelda nie wykazał tu naruszeń (globalnie χ²(5) = 2.23, p = .816), choć nieistotny test nie dowodzi proporcjonalności. Skok w 3. miesiącu siedzi w hazardzie bazowym. To związek, nie przyczyna.
Podpis do pracy:
Zdanie do Wyników:
Pułapka: roczny wskaźnik rotacji to nie krzywa
W raportach kadrowych króluje wskaźnik rotacji: odejścia w roku podzielone przez średnie zatrudnienie. Zależy on od tego, ilu nowych pracowników jest w zespole. W krótkiej symulacji (przepis 6) dwa magazyny po 400 etatów mają identyczne ryzyko odejścia w każdym miesiącu stażu. Magazyn A działa od lat, magazyn B otwarto 1 stycznia.
| Magazyn | Średnie zatrudnienie | Odejścia w roku | W tym ze stażem do roku | Wskaźnik rotacji (%) |
|---|---|---|---|---|
| A: działa od lat | 400 | 137 | 58 | 34.2 |
| B: otwarty w tym roku | 400 | 213 | 213 | 53.2 |
Ta sama „szybkość odchodzenia” daje 34.2% i 53.2%, a nowo przyjęta osoba w obu magazynach ma 38.4% szans odejścia przed upływem roku – tej liczby nie pokazuje żaden z wskaźników. Wskaźnik roczny opisuje koszt (ilu ludzi zastąpić), ale nie mówi, kiedy ludzie odchodzą, i myli przy porównaniu magazynów o różnym stażu załogi.
Co z tym zrobić w firmie
- Okres próbny: najważniejszy moment. Rozmowa podsumowująca w 2. miesiącu i wcześniejsza decyzja o umowie mogą zmniejszyć odejścia „na koniec próby”. Metaanaliza Bauera i in. (2007) pokazuje, że jasność roli, poczucie skuteczności i akceptacja w zespole pośredniczą w związku wdrożenia nowej osoby z odejściami.
- Zmiana nocna: problemem są odejścia dobrowolne, nie zwolnienia. Działania (dodatek, grafik, transport) kieruj do osób, które odchodzą same.
- Agencja: wysokie ryzyko obu typów odejścia. Policz, czy szybsze przejście na umowę o pracę po okresie próbnym nie byłoby tańsze niż ciągła rekrutacja.
- Magazyn Południe: sprawdź warunki lokalne (dojazd, konkurencja o pracowników).
- Skuteczność działań sprawdzaj porównaniem z grupą kontrolną, np. metodą z wpisu efekt szkolenia pracowników – różnica w różnicach, a nie samym modelem Coxa. Gdy dochodzą dane ankietowe z zespołów, zajrzyj do wpisu o badaniu zaangażowania pracowników.
Predyktorów odejść jest wiele, a siła ich związku zależy od kontekstu (Griffeth i in., 2000), więc model z jednej firmy nie przenosi się automatycznie na inną. Zobacz też Statystyka w pracy z zarządzania i ekonomii i Statystyka w pracy z logistyki.
Jak opisać w pracy
Do Wyników dołącz tabelę z liczbami czytelnymi bez wykresu (pole pod krzywą, czyli RMST, możesz dodać jako przeciętną liczbę przepracowanych miesięcy):
| Zmiana | n | Pracuje po 12 mies. (%) | Mediana stażu (mies.) | Odeszli sami do 12 mies. (%) | Zwolnieni do 12 mies. (%) |
|---|---|---|---|---|---|
| Dzienna | 1073 | 51.3 | 13.2 [11.2, 16.1] | 34.8 | 13.9 |
| Nocna | 727 | 41.1 | 7.8 [6.3, 9.7] | 48.2 | 10.7 |
Układ rozdziałów: Jak napisać pracę z zarządzania i ekonomii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu, pięć rysunków i tabelę z pułapki o wskaźniku rotacji. Uruchom przepisy 1–5 po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw. Przepisy 6 i 7 są samodzielne. Przepisy 1–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 i 6 – każdy zaczyna się od własnego set.seed(641). Ziarno 641 ustalono raz i nie zmieniano go. Pozostałe przepisy nie losują, więc skopiowane z przepisem 1 dadzą te same liczby co na stronie. Ręcznie ustalono: liczbę przyjętych (1800), udziały magazynów, zmian i agencji, rozkład wieku, miesięczne ryzyka obu typów odejścia i ich mnożniki (przepis 1) oraz liczbę etatów (400) i 4 lata rozruchu magazynu A (przepis 6). Dwunastu pracowników na rysunku 1 wybrano regułą (percentyle stażu), bez losowania. Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w kilka sekund.
1. Dane, proste odsetki i oś czasu: Rysunek 1
R
# Rysunek 1. Fikcyjne centrum dystrybucyjne: dane pracowników magazynu i oś czasu z cenzurowaniem
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii; sprawdzenie w przepisie 7) i prosty motyw
kol_typ <- c("odejście dobrowolne" = "#D55E00", "zwolnienie przez firmę" = "#0072B2",
             "nadal pracuje (cenzurowanie)" = "#555555")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# 1800 osób przyjętych do pracy fizycznej w trzech magazynach od 2 stycznia 2023 do 30 września 2026;
# dane kadrowe pobrano 31 października 2026. Każdy zaczyna od 3-miesięcznego okresu próbnego
# (w agencji – od pierwszego 3-miesięcznego kontraktu). Udziały grup, miesięczne ryzyka obu typów
# odejścia i mnożniki ustalono ręcznie, tak by skok w 3. miesiącu i różnice zmian były wyraźne.
set.seed(641)                                     # ziarno ustalone raz, bez dobierania pod wynik
n <- 1800
lokalizacja <- sample(c("Północ", "Centrum", "Południe"), n, replace = TRUE, prob = c(0.35, 0.35, 0.30))
zmiana <- sample(c("dzienna", "nocna"), n, replace = TRUE, prob = c(0.6, 0.4))
umowa <- ifelse(runif(n) < 0.35 + 0.15 * (zmiana == "nocna"), "agencja pracy tymczasowej", "umowa o pracę")
wiek <- round(pmin(pmax(rnorm(n, 33, 9), 19), 62))
przyjecie <- as.Date("2023-01-02") + sample(0:1367, n, replace = TRUE)
pobranie <- as.Date("2026-10-31")
obserwowane <- as.numeric(pobranie - przyjecie) / 30.44     # miesiące obserwacji do dnia pobrania

# Miesięczne ryzyka (intensywności) w k-tym miesiącu stażu dla pracownika odniesienia:
# zmiana dzienna, umowa o pracę, magazyn Centrum, 33 lata
h_dobr <- function(k) ifelse(k == 1, 0.045, ifelse(k == 2, 0.035, ifelse(k == 3, 0.070,
                      ifelse(k <= 6, 0.030, ifelse(k <= 12, 0.020, 0.012)))))
h_zwol <- function(k) ifelse(k <= 2, 0.010, ifelse(k == 3, 0.060, 0.005))   # 3. miesiąc = koniec okresu próbnego
m_dobr <- 1.5^(zmiana == "nocna") * 1.4^(umowa != "umowa o pracę") * 1.35^(lokalizacja == "Południe") *
  0.8^((wiek - 33) / 10)
m_zwol <- 2.0^(umowa != "umowa o pracę")          # zmiana, magazyn i wiek nie zmieniają ryzyka zwolnienia
czas <- rep(Inf, n); typ <- rep(0L, n)
for (k in 1:46) {
  a <- h_dobr(k) * m_dobr; b <- h_zwol(k) * m_zwol
  zdarzenie <- is.infinite(czas) & runif(n) < 1 - exp(-(a + b))
  czas[zdarzenie] <- k - 1 + runif(sum(zdarzenie))              # dzień odejścia w obrębie miesiąca
  typ[zdarzenie] <- ifelse(runif(sum(zdarzenie)) < (a / (a + b))[zdarzenie], 1L, 2L)
}
pracownicy <- data.frame(id = sprintf("P%04d", 1:n), lokalizacja, zmiana, umowa, wiek,
                         przyjecie = format(przyjecie),
                         staz_mies = round(pmin(czas, obserwowane), 2),             # obserwowany staż
                         status = ifelse(czas <= obserwowane, typ, 0L))             # 0 – pracuje, 1 – sam odszedł, 2 – zwolniony
pracownicy$status_opis <- factor(pracownicy$status, 0:2, names(kol_typ)[c(3, 1, 2)])
write.csv(pracownicy[, 1:8], "rotacja-pracownicy-magazynu.csv", row.names = FALSE)

# Ile odejść każdego typu, ilu wciąż pracuje i jak mylą proste odsetki
addmargins(table(pracownicy$zmiana, pracownicy$status_opis))
round(100 * prop.table(table(pracownicy$status_opis)), 1)
round(100 * prop.table(table(pracownicy$zmiana, pracownicy$umowa), 1), 1)          # % agencji na każdej zmianie
round(100 * tapply(pracownicy$status > 0, pracownicy$zmiana, mean), 1)     # % odejść wśród wszystkich przyjętych
with(subset(pracownicy, status > 0), round(median(staz_mies), 1))           # mediana stażu tylko odchodzących
round(median(pracownicy$staz_mies[pracownicy$status == 0]), 1)              # mediana stażu wciąż pracujących

# Oś czasu 12 pracowników: po 4 z każdego wyniku – osoby ze stażem najbliższym 20., 40., 60. i 80. percentylowi
# stażu w swojej grupie (wybór regułą, bez losowania)
wybor <- unlist(lapply(0:2, function(s) {
  ktorzy <- which(pracownicy$status == s); st <- pracownicy$staz_mies[ktorzy]
  ktorzy[sapply(quantile(st, c(0.2, 0.4, 0.6, 0.8)), function(q) which.min(abs(st - q)))]
}))
os <- pracownicy[wybor, ]
os <- os[order(os$status, os$staz_mies), ]
os$etykieta <- sprintf("%s · %s · %s", substr(os$przyjecie, 1, 7), os$zmiana,
                       ifelse(os$umowa == "umowa o pracę", "UoP", "agencja"))
os$y <- factor(os$id, levels = rev(os$id))
os[, c("id", "etykieta", "staz_mies", "status_opis")]

p1 <- ggplot(os, aes(y = y)) +
  annotate("rect", xmin = 0, xmax = 3, ymin = -Inf, ymax = Inf, fill = "#F0E442", alpha = 0.25) +
  geom_segment(aes(x = 0, xend = staz_mies, yend = y), colour = "grey45", linewidth = 1.1) +
  geom_segment(data = subset(os, status == 0), aes(x = staz_mies, xend = staz_mies + 2.5, yend = y),
               colour = "grey55", linewidth = 0.7, linetype = "dotted",
               arrow = arrow(length = unit(0.12, "inches"), type = "closed")) +
  geom_point(aes(x = staz_mies, colour = status_opis, shape = status_opis, fill = status_opis), size = 3.6, stroke = 1.3) +
  scale_colour_manual(values = kol_typ, name = NULL) +
  scale_fill_manual(values = c(kol_typ[1:2], "nadal pracuje (cenzurowanie)" = "white"), name = NULL) +
  scale_shape_manual(values = c("odejście dobrowolne" = 4, "zwolnienie przez firmę" = 22,
                                "nadal pracuje (cenzurowanie)" = 21), name = NULL) +
  scale_y_discrete(labels = setNames(os$etykieta, os$id)) +
  scale_x_continuous(breaks = seq(0, 42, 6), limits = c(0, 44), expand = expansion(mult = c(0, 0.01))) +
  labs(title = "Staż dwunastu pracowników od dnia przyjęcia",
       subtitle = "Krzyżyk i kwadrat – odejście; kółko – pracuje 31.10.2026 (staż co najmniej taki);\nżółte tło – 3-miesięczny okres próbny",
       x = "Miesiące od przyjęcia do pracy", y = "Przyjęcie · zmiana · forma umowy") +
  motyw + theme(panel.grid.major.y = element_blank(), legend.text = element_text(size = rel(0.85)))
p1   # zapis: ggsave("rotacja-os-czasu-dwa-typy-odejsc.svg", p1, width = 10, height = 6.4)
Wynik w R
          nadal pracuje (cenzurowanie) odejście dobrowolne
  dzienna                          476                 415
  nocna                            242                 391
  Sum                              718                 806

          zwolnienie przez firmę  Sum
  dzienna                    182 1073
  nocna                       94  727
  Sum                        276 1800

nadal pracuje (cenzurowanie)          odejście dobrowolne
                        39.9                         44.8
      zwolnienie przez firmę
                        15.3

          agencja pracy tymczasowej umowa o pracę
  dzienna                        39            61
  nocna                          49            51
dzienna   nocna
   55.6    66.7
[1] 3.3
[1] 18.4
        id                    etykieta staz_mies                  status_opis
286  P0286       2026-04 · nocna · UoP      6.31 nadal pracuje (cenzurowanie)
690  P0690 2025-09 · dzienna · agencja     13.86 nadal pracuje (cenzurowanie)
914  P0914 2024-12 · dzienna · agencja     22.21 nadal pracuje (cenzurowanie)
24   P0024 2024-02 · dzienna · agencja     32.88 nadal pracuje (cenzurowanie)
827  P0827     2025-01 · dzienna · UoP      1.41          odejście dobrowolne
77   P0077   2025-07 · nocna · agencja      2.80          odejście dobrowolne
336  P0336       2024-02 · nocna · UoP      4.88          odejście dobrowolne
1765 P1765       2024-07 · nocna · UoP     10.60          odejście dobrowolne
1520 P1520     2023-03 · dzienna · UoP      2.10       zwolnienie przez firmę
997  P0997 2025-05 · dzienna · agencja      2.55       zwolnienie przez firmę
269  P0269     2024-04 · dzienna · UoP      4.32       zwolnienie przez firmę
405  P0405       2024-10 · nocna · UoP     13.44       zwolnienie przez firmę
2. Krzywe Kaplana–Meiera i test log-rank: Rysunek 2
R
# Rysunek 2. Krzywe Kaplana–Meiera: odsetek wciąż zatrudnionych według zmiany i formy umowy
# (wymaga obiektów z przepisu 1: pracownicy, motyw)
library(survival)
library(patchwork)

pracownicy$odszedl <- as.integer(pracownicy$status > 0)    # każde odejście, bez względu na typ
km_zm <- survfit(Surv(staz_mies, odszedl) ~ zmiana, data = pracownicy)
km_um <- survfit(Surv(staz_mies, odszedl) ~ umowa, data = pracownicy)
km_zm                                                      # mediany stażu z 95% CI
km_um
summary(km_zm, times = c(3, 6, 12, 24))[c("strata", "time", "n.risk", "surv", "lower", "upper")] |>
  as.data.frame() |> transform(surv = round(100 * surv, 1), lower = round(100 * lower, 1), upper = round(100 * upper, 1))
summary(km_um, times = c(3, 12, 24))[c("strata", "time", "n.risk", "surv", "lower", "upper")] |>
  as.data.frame() |> transform(surv = round(100 * surv, 1), lower = round(100 * lower, 1), upper = round(100 * upper, 1))
survdiff(Surv(staz_mies, odszedl) ~ zmiana, data = pracownicy)  # test log-rank
survdiff(Surv(staz_mies, odszedl) ~ umowa, data = pracownicy)

do_ramki <- function(km, nazwy) {                          # krzywa i pasmo CI w siatce co 0.1 miesiąca
  siatka <- seq(0, 36, 0.1)
  s <- summary(km, times = siatka, extend = TRUE)
  d <- data.frame(t = s$time, S = s$surv, lo = s$lower, hi = s$upper, grupa = sub(".*=", "", as.character(s$strata)))
  d$grupa <- factor(d$grupa, levels = nazwy); d
}
wykres_km <- function(d, kolory, tytul) {
  ggplot(d, aes(t, 100 * S, colour = grupa, fill = grupa, linetype = grupa)) +
    annotate("rect", xmin = 0, xmax = 3, ymin = -Inf, ymax = Inf, fill = "#F0E442", alpha = 0.25) +
    geom_hline(yintercept = 50, colour = "grey60", linetype = "dotted") +
    geom_ribbon(aes(ymin = 100 * lo, ymax = 100 * hi), alpha = 0.18, colour = NA) +
    geom_step(linewidth = 1) +
    scale_colour_manual(values = kolory, name = NULL) + scale_fill_manual(values = kolory, name = NULL) +
    scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
    scale_x_continuous(breaks = seq(0, 36, 6)) + scale_y_continuous(limits = c(0, 100), breaks = seq(0, 100, 25)) +
    labs(title = tytul, x = "Miesiące od przyjęcia", y = "Wciąż zatrudnieni (%)") +
    guides(colour = guide_legend(nrow = 2), fill = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
    motyw
}
p2 <- wykres_km(do_ramki(km_zm, c("dzienna", "nocna")), c(dzienna = "#E69F00", nocna = "#0072B2"), "A. Zmiana") +
  wykres_km(do_ramki(km_um, c("umowa o pracę", "agencja pracy tymczasowej")),
            c("umowa o pracę" = "#56B4E9", "agencja pracy tymczasowej" = "#882255"), "B. Forma zatrudnienia") +
  plot_annotation(subtitle = "Pasma – 95% CI; żółte tło – okres próbny; kropkowana linia – 50% (mediana stażu)",
                  theme = motyw)
p2   # zapis: ggsave("rotacja-kaplan-meier-zmiana-umowa.svg", p2, width = 10, height = 5.6)
Wynik w R
Call: survfit(formula = Surv(staz_mies, odszedl) ~ zmiana, data = pracownicy)

                  n events median 0.95LCL 0.95UCL
zmiana=dzienna 1073    597  13.17   11.23    16.1
zmiana=nocna    727    485   7.84    6.32     9.7
Call: survfit(formula = Surv(staz_mies, odszedl) ~ umowa, data = pracownicy)

                                   n events median 0.95LCL 0.95UCL
umowa=agencja pracy tymczasowej  774    536   6.37    5.11    7.51
umowa=umowa o pracę             1026    546  16.93   14.48   20.81
          strata time n.risk surv lower upper
1 zmiana=dzienna    3    751 72.9  70.3  75.6
2 zmiana=dzienna    6    610 63.8  61.0  66.8
3 zmiana=dzienna   12    423 51.3  48.3  54.6
4 zmiana=dzienna   24    219 40.4  37.3  43.9
5   zmiana=nocna    3    460 66.5  63.1  70.0
6   zmiana=nocna    6    353 53.8  50.2  57.6
7   zmiana=nocna   12    234 41.1  37.5  45.0
8   zmiana=nocna   24     93 27.4  23.9  31.5
                           strata time n.risk surv lower upper
1 umowa=agencja pracy tymczasowej    3    462 62.6  59.2  66.1
2 umowa=agencja pracy tymczasowej   12    206 35.4  32.0  39.2
3 umowa=agencja pracy tymczasowej   24     82 23.9  20.6  27.7
4             umowa=umowa o pracę    3    749 76.1  73.5  78.8
5             umowa=umowa o pracę   12    451 55.9  52.8  59.2
6             umowa=umowa o pracę   24    230 43.5  40.2  47.1
Call:
survdiff(formula = Surv(staz_mies, odszedl) ~ zmiana, data = pracownicy)

                  N Observed Expected (O-E)^2/E (O-E)^2/V
zmiana=dzienna 1073      597      680      10.2      27.6
zmiana=nocna    727      485      402      17.3      27.6

 Chisq= 27.6  on 1 degrees of freedom, p= 1e-07
Call:
survdiff(formula = Surv(staz_mies, odszedl) ~ umowa, data = pracownicy)

                                   N Observed Expected (O-E)^2/E (O-E)^2/V
umowa=agencja pracy tymczasowej  774      536      398      48.1        77
umowa=umowa o pracę             1026      546      684      28.0        77

 Chisq= 77  on 1 degrees of freedom, p= <2e-16
3. Hazard w kolejnych miesiącach stażu: Rysunek 3
R
# Rysunek 3. Miesięczny hazard odejść dobrowolnych i zwolnień – skok na końcu okresu próbnego
# (wymaga obiektów z przepisu 1: pracownicy, kol_typ, motyw)
miesiace <- 1:24
hazard <- do.call(rbind, lapply(miesiace, function(k) {
  ekspozycja <- pmax(0, pmin(pracownicy$staz_mies, k) - (k - 1))        # osobomiesiące przepracowane w k-tym miesiącu
  w_miesiacu <- pracownicy$staz_mies > k - 1 & pracownicy$staz_mies <= k
  do.call(rbind, lapply(1:2, function(s) {
    d <- sum(w_miesiacu & pracownicy$status == s)                        # odejścia danego typu w k-tym miesiącu
    E <- sum(ekspozycja)
    data.frame(k = k, typ = names(kol_typ)[s], w_ryzyku = sum(pracownicy$staz_mies > k - 1), odejscia = d,
               osobomies = round(E, 1), h = 100 * d / E,                 # odejścia na 100 osobomiesięcy
               dol = 100 * qchisq(0.025, 2 * d) / 2 / E, gora = 100 * qchisq(0.975, 2 * (d + 1)) / 2 / E)
  }))
}))
hazard$typ <- factor(hazard$typ, levels = names(kol_typ)[1:2])
format(subset(hazard, k <= 7 | k %in% c(12, 24)), digits = 3)
# Hazard łączny w 2. i 3. miesiącu: ile razy rośnie na końcu okresu próbnego?
laczny <- aggregate(cbind(odejscia, osobomies) ~ k, data = hazard, FUN = sum)
laczny$osobomies <- laczny$osobomies / 2                                 # ekspozycja policzona dwa razy (dla dwóch typów)
laczny$h <- round(100 * laczny$odejscia / laczny$osobomies, 2)
laczny[laczny$k %in% c(1:6, 12, 24), ]

p3 <- ggplot(hazard, aes(k, h, colour = typ, shape = typ, linetype = typ)) +
  annotate("rect", xmin = 0.5, xmax = 3.5, ymin = -Inf, ymax = Inf, fill = "#F0E442", alpha = 0.25) +
  annotate("text", x = 2, y = 13.2, label = "okres próbny", size = 3.8, colour = "grey25") +
  geom_errorbar(aes(ymin = dol, ymax = gora), width = 0, linewidth = 0.6, alpha = 0.7, linetype = "solid",
                position = position_dodge(width = 0.45)) +
  geom_line(linewidth = 0.8, position = position_dodge(width = 0.45)) +
  geom_point(size = 2.6, fill = "white", stroke = 1.1, position = position_dodge(width = 0.45)) +
  scale_colour_manual(values = kol_typ[1:2], name = NULL) +
  scale_shape_manual(values = c(21, 22), name = NULL) + scale_linetype_manual(values = c("solid", "longdash"), name = NULL) +
  scale_x_continuous(breaks = c(1, 3, 6, 9, 12, 15, 18, 21, 24)) +
  coord_cartesian(ylim = c(0, 14)) +
  labs(title = "Kiedy pracownicy odchodzą? Odejścia na 100 osobomiesięcy stażu",
       subtitle = "Pionowe odcinki – 95% CI (rozkład Poissona); ten sam mianownik dla obu typów odejścia",
       x = "Miesiąc stażu", y = "Odejścia na 100 osobomiesięcy") +
  motyw
p3   # zapis: ggsave("rotacja-hazard-okres-probny.svg", p3, width = 10, height = 5.8)
Wynik w R
    k                    typ w_ryzyku odejscia osobomies      h    dol   gora
1   1    odejście dobrowolne     1800      120      1730  6.938 5.7526  8.297
2   1 zwolnienie przez firmę     1800       22      1730  1.272 0.7972  1.926
3   2    odejście dobrowolne     1658      102      1575  6.475 5.2798  7.861
4   2 zwolnienie przez firmę     1658       23      1575  1.460 0.9256  2.191
5   3    odejście dobrowolne     1492      143      1357 10.536 8.8801 12.411
6   3 zwolnienie przez firmę     1492      114      1357  8.399 6.9285 10.090
7   4    odejście dobrowolne     1209       55      1167  4.714 3.5511  6.136
8   4 zwolnienie przez firmę     1209        4      1167  0.343 0.0934  0.878
9   5    odejście dobrowolne     1128       68      1074  6.330 4.9152  8.024
10  5 zwolnienie przez firmę     1128        8      1074  0.745 0.3215  1.467
11  6    odejście dobrowolne     1021       37       991  3.734 2.6294  5.147
12  6 zwolnienie przez firmę     1021        4       991  0.404 0.1100  1.034
13  7    odejście dobrowolne      962       28       939  2.983 1.9819  4.311
14  7 zwolnienie przez firmę      962        8       939  0.852 0.3679  1.679
23 12    odejście dobrowolne      699       19       682  2.788 1.6784  4.354
24 12 zwolnienie przez firmę      699        9       682  1.321 0.6038  2.507
47 24    odejście dobrowolne      339        5       325  1.537 0.4990  3.586
48 24 zwolnienie przez firmę      339        5       325  1.537 0.4990  3.586
    k odejscia osobomies     h
1   1      142    1729.5  8.21
2   2      125    1575.2  7.94
3   3      257    1357.2 18.94
4   4       59    1166.8  5.06
5   5       76    1074.3  7.07
6   6       41     990.8  4.14
12 12       28     681.5  4.11
24 24       10     325.4  3.07
4. Ryzyka konkurencyjne – CIF i błędne 1 − KM: Rysunek 4
R
# Rysunek 4. Ryzyka konkurencyjne: skumulowana częstość (CIF, Aalen–Johansen) a naiwne 1 − Kaplan–Meier
# (wymaga obiektów z przepisu 1: pracownicy, kol_typ, motyw)
library(survival)

pracownicy$wynik <- factor(pracownicy$status, 0:2, c("pracuje", "dobrowolne", "zwolnienie"))  # pierwszy poziom = cenzurowanie
aj <- survfit(Surv(staz_mies, wynik) ~ 1, data = pracownicy)            # estymator Aalena–Johansena
naiwny <- survfit(Surv(staz_mies, status == 1) ~ 1, data = pracownicy)   # zwolnienia potraktowane jak cenzurowanie
s_aj <- summary(aj, times = c(3, 12, 24))
cif <- data.frame(miesiac = s_aj$time, round(100 * s_aj$pstate[, 2:3], 1),
                  dol_dobr = round(100 * s_aj$lower[, 2], 1), gora_dobr = round(100 * s_aj$upper[, 2], 1),
                  naiwne_1_minus_KM = round(100 * (1 - summary(naiwny, times = c(3, 12, 24))$surv), 1))
cif
# CIF po 12 miesiącach według zmiany (każdy typ odejścia osobno)
aj_zm <- survfit(Surv(staz_mies, wynik) ~ zmiana, data = pracownicy)
s_zm <- summary(aj_zm, times = 12)
data.frame(zmiana = s_zm$strata, round(100 * s_zm$pstate[, 2:3], 1))

# Dane do wykresu: krzywe w siatce co 0.25 miesiąca
siatka <- seq(0, 36, 0.25)
s <- summary(aj, times = siatka, extend = TRUE)
r <- data.frame(t = rep(siatka, 3),
                p = 100 * c(s$pstate[, 2], s$pstate[, 3], 1 - summary(naiwny, times = siatka, extend = TRUE)$surv),
                krzywa = factor(rep(c("CIF: odejście dobrowolne", "CIF: zwolnienie przez firmę",
                                      "1 − KM dla odejść dobrowolnych (błędnie)"), each = length(siatka)),
                                levels = c("1 − KM dla odejść dobrowolnych (błędnie)", "CIF: odejście dobrowolne",
                                           "CIF: zwolnienie przez firmę")))
kol_cif <- c("1 − KM dla odejść dobrowolnych (błędnie)" = "#999999", "CIF: odejście dobrowolne" = kol_typ[[1]],
             "CIF: zwolnienie przez firmę" = kol_typ[[2]])
etyk <- subset(r, t == 24)
p4 <- ggplot(r, aes(t, p, colour = krzywa, linetype = krzywa)) +
  annotate("rect", xmin = 0, xmax = 3, ymin = -Inf, ymax = Inf, fill = "#F0E442", alpha = 0.25) +
  geom_line(linewidth = 1.1) +
  geom_point(data = etyk, size = 2.6) +
  geom_label(data = etyk, aes(y = p + c(-4.5, -4, 3.5), label = sprintf("%.1f%%", p)), size = 4.2, fill = "white",
             linewidth = 0, show.legend = FALSE) +
  scale_colour_manual(values = kol_cif, name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid", "longdash"), name = NULL) +
  scale_x_continuous(breaks = seq(0, 36, 6)) + scale_y_continuous(limits = c(0, 70), breaks = seq(0, 70, 10)) +
  guides(colour = guide_legend(nrow = 2), linetype = guide_legend(nrow = 2)) +
  labs(title = "Jaka część przyjętych odeszła danym typem odejścia?",
       subtitle = "Punkty i etykiety – stan po 24 miesiącach; żółte tło – okres próbny",
       x = "Miesiące od przyjęcia", y = "Odsetek przyjętych (%)") +
  motyw
p4   # zapis: ggsave("rotacja-cif-dwa-typy-odejsc.svg", p4, width = 10, height = 5.8)
Wynik w R
  miesiac dobrowolne zwolnienie dol_dobr gora_dobr naiwne_1_minus_KM
1       3       20.6        9.1     18.8      22.6              21.4
2      12       40.2       12.6     37.9      42.6              43.8
3      24       48.1       16.7     45.6      50.7              53.6
          zmiana dobrowolne zwolnienie
1 zmiana=dzienna       34.8       13.9
2   zmiana=nocna       48.2       10.7
5. Trzy modele Coxa i test proporcjonalności: Rysunek 5
R
# Rysunek 5. Model Coxa: wszystkie odejścia razem i osobno dla każdego typu (hazardy przyczynowo-specyficzne)
# (wymaga obiektów z przepisu 1: pracownicy, kol_typ, motyw)
library(survival)

pracownicy$zmiana <- factor(pracownicy$zmiana, c("dzienna", "nocna"))
pracownicy$umowa <- factor(pracownicy$umowa, c("umowa o pracę", "agencja pracy tymczasowej"))
pracownicy$lokalizacja <- factor(pracownicy$lokalizacja, c("Centrum", "Północ", "Południe"))
pracownicy$wiek10 <- pracownicy$wiek / 10                               # HR na każde 10 lat
wzor <- ~ zmiana + umowa + lokalizacja + wiek10
modele <- list("wszystkie odejścia" = coxph(update(wzor, Surv(staz_mies, status > 0) ~ .), data = pracownicy),
               "odejście dobrowolne" = coxph(update(wzor, Surv(staz_mies, status == 1) ~ .), data = pracownicy),
               "zwolnienie przez firmę" = coxph(update(wzor, Surv(staz_mies, status == 2) ~ .), data = pracownicy))
nazwy <- c(zmiananocna = "Zmiana nocna (vs dzienna)", "umowaagencja pracy tymczasowej" = "Agencja (vs umowa o pracę)",
           "lokalizacjaPółnoc" = "Magazyn Północ (vs Centrum)", "lokalizacjaPołudnie" = "Magazyn Południe (vs Centrum)",
           wiek10 = "Wiek: +10 lat")
hr <- do.call(rbind, lapply(names(modele), function(m) {
  s <- summary(modele[[m]])
  data.frame(model = m, zmienna = nazwy[rownames(s$conf.int)], HR = round(s$conf.int[, 1], 2),
             dol = round(s$conf.int[, 3], 2), gora = round(s$conf.int[, 4], 2),
             p = ifelse(s$coefficients[, 5] < .001, "< .001", sprintf("%.3f", s$coefficients[, 5])), zdarzenia = modele[[m]]$nevent, row.names = NULL)
}))
hr
# Proporcjonalność hazardów w modelu odejść dobrowolnych (reszty Schoenfelda)
round(cox.zph(modele[["odejście dobrowolne"]])$table, 3)

hr$model <- factor(hr$model, names(modele))
hr$zmienna <- factor(hr$zmienna, rev(nazwy))
p5 <- ggplot(hr, aes(HR, zmienna, colour = model, shape = model)) +
  geom_vline(xintercept = 1, colour = "grey40") +
  geom_errorbar(aes(xmin = dol, xmax = gora), width = 0, orientation = "y", linewidth = 0.9, position = position_dodge(width = 0.6)) +
  geom_point(size = 3, fill = "white", stroke = 1.2, position = position_dodge(width = 0.6)) +
  scale_colour_manual(values = c("wszystkie odejścia" = "#555555", kol_typ[1:2]), name = NULL) +
  scale_shape_manual(values = c(16, 21, 22), name = NULL) +
  scale_x_log10(breaks = c(0.5, 0.75, 1, 1.5, 2, 3), limits = c(0.45, 3.2)) +
  labs(title = "Ilorazy hazardów (95% CI) w trzech modelach Coxa",
       subtitle = "Ten sam zestaw zmiennych; oś pozioma w skali logarytmicznej",
       x = "Iloraz hazardów (HR)", y = NULL) +
  motyw + theme(panel.grid.major.y = element_blank())
p5   # zapis: ggsave("rotacja-cox-ilorazy-hazardow.svg", p5, width = 10, height = 6)
Wynik w R
                    model                       zmienna   HR  dol gora      p
1      wszystkie odejścia     Zmiana nocna (vs dzienna) 1.35 1.20 1.52 < .001
2      wszystkie odejścia    Agencja (vs umowa o pracę) 1.65 1.46 1.86 < .001
3      wszystkie odejścia   Magazyn Północ (vs Centrum) 0.98 0.85 1.14  0.790
4      wszystkie odejścia Magazyn Południe (vs Centrum) 1.48 1.28 1.71 < .001
5      wszystkie odejścia                 Wiek: +10 lat 0.83 0.77 0.89 < .001
6     odejście dobrowolne     Zmiana nocna (vs dzienna) 1.58 1.38 1.82 < .001
7     odejście dobrowolne    Agencja (vs umowa o pracę) 1.56 1.36 1.79 < .001
8     odejście dobrowolne   Magazyn Północ (vs Centrum) 1.02 0.86 1.21  0.844
9     odejście dobrowolne Magazyn Południe (vs Centrum) 1.56 1.32 1.85 < .001
10    odejście dobrowolne                 Wiek: +10 lat 0.76 0.70 0.82 < .001
11 zwolnienie przez firmę     Zmiana nocna (vs dzienna) 0.83 0.64 1.07  0.143
12 zwolnienie przez firmę    Agencja (vs umowa o pracę) 1.93 1.52 2.46 < .001
13 zwolnienie przez firmę   Magazyn Północ (vs Centrum) 0.88 0.66 1.18  0.397
14 zwolnienie przez firmę Magazyn Południe (vs Centrum) 1.28 0.96 1.70  0.088
15 zwolnienie przez firmę                 Wiek: +10 lat 1.06 0.93 1.22  0.372
   zdarzenia
1       1082
2       1082
3       1082
4       1082
5       1082
6        806
7        806
8        806
9        806
10       806
11       276
12       276
13       276
14       276
15       276
            chisq df     p
zmiana      0.925  1 0.336
umowa       0.130  1 0.718
lokalizacja 0.200  2 0.905
wiek10      1.011  1 0.315
GLOBAL      2.232  5 0.816
6. Pułapka rocznego wskaźnika rotacji (symulacja)
R
# Pułapka: roczny wskaźnik rotacji zależy od struktury stażu, a nie tylko od tego, jak szybko ludzie odchodzą.
# Dwa fikcyjne magazyny z identycznym ryzykiem odejścia w każdym miesiącu stażu (jak pracownik odniesienia
# z przepisu 1) i 400 etatami: A działa od lat, B otwarto 1 stycznia i wszyscy są w nim nowi.
set.seed(641)
h_razem <- function(k) {                                  # ryzyko obu typów odejścia razem (miesięcznie)
  dobr <- ifelse(k == 1, 0.045, ifelse(k == 2, 0.035, ifelse(k == 3, 0.070,
                 ifelse(k <= 6, 0.030, ifelse(k <= 12, 0.020, 0.012)))))
  zwol <- ifelse(k <= 2, 0.010, ifelse(k == 3, 0.060, 0.005))
  dobr + zwol
}
symuluj <- function(staz, miesiecy, etaty = 400) {      # staz = staż osób w 1. miesiącu symulacji
  wynik <- data.frame(miesiac = 1:miesiecy, zatrudnieni = NA, odejscia = NA, nowi_odejscia = NA)
  for (m in 1:miesiecy) {
    odchodzi <- runif(length(staz)) < 1 - exp(-h_razem(staz))
    wynik[m, 2:4] <- c(length(staz), sum(odchodzi), sum(odchodzi & staz <= 12))
    staz <- c(staz[!odchodzi] + 1, rep(1, max(0, etaty - sum(!odchodzi))))   # odchodzących zastępują nowi
  }
  wynik
}
A <- symuluj(sample(1:60, 400, replace = TRUE), 60)[49:60, ]   # 4 lata rozruchu, analizujemy 5. rok
B <- symuluj(rep(1, 400), 12)                                   # pierwszy rok nowego magazynu
rok <- function(w) with(w, c(srednie_zatrudnienie = round(mean(zatrudnieni)), odejscia = sum(odejscia),
                             w_tym_ze_stazem_do_roku = sum(nowi_odejscia),
                             wskaznik_rotacji_proc = round(100 * sum(odejscia) / mean(zatrudnieni), 1)))
rbind("A: magazyn działający od lat" = rok(A), "B: nowy magazyn" = rok(B))
# Prawdopodobieństwo odejścia w pierwszym roku stażu – takie samo w obu magazynach (z definicji ryzyka)
round(100 * (1 - exp(-sum(h_razem(1:12)))), 1)
Wynik w R
                             srednie_zatrudnienie odejscia
A: magazyn działający od lat                  400      137
B: nowy magazyn                               400      213
                             w_tym_ze_stazem_do_roku wskaznik_rotacji_proc
A: magazyn działający od lat                      58                  34.2
B: nowy magazyn                                  213                  53.2
[1] 38.4
7. Czy paleta jest czytelna przy zaburzeniach widzenia barw?
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("odejście dobrowolne – zwolnienie" = c("#D55E00", "#0072B2"),
             "zmiana dzienna – nocna" = c("#E69F00", "#0072B2"),
             "umowa o pracę – agencja" = c("#56B4E9", "#882255"),
             "wszystkie odejścia – dobrowolne" = c("#555555", "#D55E00"),
             "1 − KM – CIF dobrowolne" = c("#999999", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
odejście dobrowolne – zwolnienie           114.6        108.3       91.9
zmiana dzienna – nocna                     120.2        121.5      109.3
umowa o pracę – agencja                     76.0         49.8       49.1
wszystkie odejścia – dobrowolne             78.7         66.4       55.0
1 − KM – CIF dobrowolne                     77.2         62.9       56.0
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, hazard na 100 osobomiesięcy z przedziałami Poissona i symulacja wskaźnika rotacji – bazowy R (pakiety stats i base); estymator Kaplana–Meiera i Aalena–Johansena (survfit()), test log-rank (survdiff()), model Coxa (coxph()) i test proporcjonalności (cox.zph()) – pakiet survival. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- survival (wersja 3.8.6): Therneau, T. M. (2026). A package for survival analysis in R [R package]. https://CRAN.R-project.org/package=survival
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Usuwanie osób, które wciąż pracują, albo liczenie ich jako „zostały” (rysunek 1).
- Jedno „odejście” zamiast dwóch. HR = 1.35 dla nocnej zmiany ukrywał, że rosną tylko odejścia dobrowolne (rysunek 5).
- 1 − Kaplan–Meier dla jednego typu odejścia. Zawyża częstość: 53.6% zamiast 48.1% po dwóch latach (rysunek 4).
- Zmienne z przyszłości. „Liczba nadgodzin w całym okresie pracy” rośnie ze stażem i pozornie chroni. Bierz to, co znasz na starcie, albo zmienne zależne od czasu.
- Inne wyjścia. Przeniesienie do innego działu czy emerytura to nie rotacja; zakoduj je jako cenzurowanie albo trzeci typ zdarzenia i napisz to w Metodzie.
Najczęstsze pytania
Jak policzyć rotację pracowników analizą przeżycia?
Dla każdej osoby zapisz staż od dnia przyjęcia i to, czy zatrudnienie się skończyło. Osoby wciąż pracujące to obserwacje cenzurowane: nie usuwaj ich. Potem narysuj krzywe Kaplana–Meiera (odsetek wciąż zatrudnionych), hazard w kolejnych miesiącach stażu i dopasuj model Coxa. W przykładzie mediana stażu wyniosła 13.2 miesiąca na zmianie dziennej i 7.8 na nocnej.
Czym różni się wskaźnik rotacji od krzywej Kaplana–Meiera?
Wskaźnik rotacji to odejścia w roku podzielone przez średnie zatrudnienie i zależy od struktury stażu załogi. W symulacji dwa magazyny z tym samym ryzykiem odejścia miały wskaźnik 34.2% i 53.2%, bo jeden był nowy. Krzywa Kaplana–Meiera liczona od dnia przyjęcia pokazuje, jaka część nowych osób zostaje po t miesiącach i kiedy odchodzą.
Jak w analizie przeżycia uwzględnić odejścia dobrowolne i zwolnienia?
To ryzyka konkurencyjne: zwolniona osoba nie może już odejść sama. Częstość każdego typu licz funkcją skumulowanej częstości (CIF, estymator Aalena–Johansena), a nie 1 − Kaplan–Meier, który ją zawyża (w przykładzie 53.6% zamiast 48.1% po dwóch latach). Związki ze zmiennymi oceniaj osobnymi modelami Coxa dla każdego typu odejścia.
Dlaczego pracownicy odchodzą na końcu okresu próbnego?
Na końcu okresu próbnego firma decyduje o dalszej umowie, a pracownik może łatwo odejść. W fikcyjnym przykładzie w 3. miesiącu stażu zwolnienia wzrosły z 1.5 do 8.4, a odejścia dobrowolne z 6.5 do 10.5 na 100 osobomiesięcy. Taki skok widać dopiero na wykresie hazardu w czasie – krzywa przeżycia i roczny wskaźnik rotacji go ukrywają.
Czy model Coxa pokaże, co powoduje odejścia pracowników?
Nie wprost. HR opisuje, jak szybko odchodzą osoby z daną cechą przy tych samych pozostałych zmiennych, ale osoby wybierające np. nocną zmianę różnią się od innych. Skutek działań kadrowych (dodatku, wdrożenia, szkolenia) sprawdź porównaniem z grupą kontrolną, np. metodą różnicy w różnicach.
Powiązane hasła
Przeczytaj też
Churn jako analiza przeżycia
Aplikacja z abonamentem, 2400 klientów: cenzurowanie, Kaplan–Meier według planu, hazard w czasie i model Coxa z okresami – pięć rysunków z kodem R.
Czytaj →PoradnikRyzyka konkurencyjne: Fine–Gray i CIF
Dlaczego 1 − Kaplan–Meier zawyża ryzyko, CIF, hazard przyczynowo-specyficzny a Fine–Gray, przykład w R (survival), tabela i opis APA.
Czytaj →PoradnikZaangażowanie pracowników: model wielopoziomowy
Ankieta w 40 zespołach: ICC, styl lidera, ranking zespołów z modelu zamiast średnich i błąd ekologiczny – z kodem R.
Czytaj →PoradnikOpóźnienia płatności faktur w analizie przeżycia
Hurtownia, 20 tys. faktur: cenzurowanie, Kaplan–Meier, Cox z klientem jako klastrem, windykacja jako CIF i prognoza wpływów.
Czytaj →Analizujesz rotację pracowników do pracy z zarządzania?
Pomożemy zakodować staż, cenzurowanie i typy odejścia, narysować krzywe i hazard, dobrać modele Coxa i CIF oraz opisać wyniki – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Austin, P. C., Lee, D. S., & Fine, J. P. (2016). Introduction to the analysis of survival data in the presence of competing risks. Circulation, 133(6), 601–609. https://doi.org/10.1161/circulationaha.115.017719 ● Otwarty dostęp: pełny tekst
- Bauer, T. N., Bodner, T., Erdogan, B., Truxillo, D. M., & Tucker, J. S. (2007). Newcomer adjustment during organizational socialization: A meta-analytic review of antecedents, outcomes, and methods. Journal of Applied Psychology, 92(3), 707–721. https://doi.org/10.1037/0021-9010.92.3.707
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Griffeth, R. W., Hom, P. W., & Gaertner, S. (2000). A meta-analysis of antecedents and correlates of employee turnover: Update, moderator tests, and research implications for the next millennium. Journal of Management, 26(3), 463–488. https://doi.org/10.1177/014920630002600305
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457–481. https://doi.org/10.1080/01621459.1958.10501452
- Latouche, A., Allignol, A., Beyersmann, J., Labopin, M., & Fine, J. P. (2013). A competing risks analysis should report results on all cause-specific hazards and cumulative incidence functions. Journal of Clinical Epidemiology, 66(6), 648–653. https://doi.org/10.1016/j.jclinepi.2012.09.017 ● Otwarty dostęp: pełny tekst
- Willett, J. B., & Singer, J. D. (1993). Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence. Journal of Consulting and Clinical Psychology, 61(6), 952–965. https://doi.org/10.1037/0022-006X.61.6.952
Cytowania BibTeX
@article{austin2016introduction, author={Austin, Peter C. and Lee, Douglas S. and Fine, Jason P.}, title={{Introduction to the analysis of survival data in the presence of competing risks}}, journal={Circulation}, year={2016}, volume={133}, number={6}, pages={601--609}, doi={10.1161/circulationaha.115.017719}}@article{bauer2007newcomer, author={Bauer, Talya N. and Bodner, Todd and Erdogan, Berrin and Truxillo, Donald M. and Tucker, Jennifer S.}, title={{Newcomer adjustment during organizational socialization: A meta-analytic review of antecedents, outcomes, and methods}}, journal={Journal of Applied Psychology}, year={2007}, volume={92}, number={3}, pages={707--721}, doi={10.1037/0021-9010.92.3.707}}@article{cox1972regression, author={Cox, D. R.}, title={{Regression models and life-tables}}, journal={Journal of the Royal Statistical Society: Series B (Methodological)}, year={1972}, volume={34}, number={2}, pages={187--202}, doi={10.1111/j.2517-6161.1972.tb00899.x}}@article{griffeth2000metaanalysis, author={Griffeth, Rodger W. and Hom, Peter W. and Gaertner, Stefan}, title={{A meta-analysis of antecedents and correlates of employee turnover: Update, moderator tests, and research implications for the next millennium}}, journal={Journal of Management}, year={2000}, volume={26}, number={3}, pages={463--488}, doi={10.1177/014920630002600305}}@article{kaplan1958nonparametric, author={Kaplan, E. L. and Meier, Paul}, title={{Nonparametric estimation from incomplete observations}}, journal={Journal of the American Statistical Association}, year={1958}, volume={53}, number={282}, pages={457--481}, doi={10.1080/01621459.1958.10501452}}@article{latouche2013competing, author={Latouche, Aurélien and Allignol, Arthur and Beyersmann, Jan and Labopin, Myriam and Fine, Jason P.}, title={{A competing risks analysis should report results on all cause-specific hazards and cumulative incidence functions}}, journal={Journal of Clinical Epidemiology}, year={2013}, volume={66}, number={6}, pages={648--653}, doi={10.1016/j.jclinepi.2012.09.017}}@article{willett1993investigating, author={Willett, John B. and Singer, Judith D.}, title={{Investigating onset, cessation, relapse, and recovery: Why you should, and how you can, use discrete-time survival analysis to examine event occurrence}}, journal={Journal of Consulting and Clinical Psychology}, year={1993}, volume={61}, number={6}, pages={952--965}, doi={10.1037/0022-006x.61.6.952}}