Przykład: szkolenie sprzedażowe w 20 z 60 salonów
Fikcyjna grupa dealerska ma 60 salonów samochodowych. Na początku drugiego roku doradcy handlowi z 20 salonów idą na dwudniowe szkolenie sprzedażowe. Salony wybiera dyrektor sprzedaży, a największą szansę mają te, które dobrze zamknęły IV kwartał – szkolenie ma być nagrodą dla najlepszych. Rok później zarząd pyta: ile aut więcej sprzedają salony dzięki szkoleniu i czy szkolenie się opłaciło?
Mamy liczbę sprzedanych aut w każdym salonie w każdym z 24 miesięcy: 12 przed szkoleniem i 12 po nim. To typowy schemat quasi-eksperymentalny: jest grupa porównawcza, ale nie ma losowego przydziału. Metaanaliza szkoleń w organizacjach pokazuje, że szkolenia przeciętnie działają, a ich skuteczność zależy od metody i od tego, co mierzymy (Arthur i in., 2003). To nie mówi jednak, ile dało to szkolenie w tych salonach. Potrzebujemy odpowiedzi na pytanie: ile sprzedałyby przeszkolone salony bez szkolenia (model potencjalnych wyników)?
Dane są fikcyjne i znamy prawdę: szkolenie dodaje każdemu przeszkolonemu salonowi 2 auta miesięcznie. Ręcznie ustaliliśmy stały poziom sprzedaży salonów (średnio 30 aut, SD = 4), sezon ze szczytem w czerwcu, wzrost rynku o 0.08 auta miesięcznie, przejściowe „dobre i złe passy” salonów (SD = 4, autokorelacja 0.5) i szum. Siła, z jaką dyrektor premiuje wynik IV kwartału, też jest ustawiona ręcznie. Po pierwszym uruchomieniu zwiększyliśmy udział przejściowych pass i siłę wyboru, żeby skutki wyboru były wyraźne. Ziarna 645 nie zmienialiśmy. Dane pobierzesz jako szkolenie-salony-sprzedaz-miesieczna.csv.
Dwie najprostsze odpowiedzi mylą. Porównanie „przed i po” w przeszkolonych salonach (IV kwartał wobec roku po szkoleniu) daje 3.87 auta. Porównanie przeszkolonych z nieprzeszkolonymi po szkoleniu daje 6.05. Prawda to 2. Pierwsza odpowiedź miesza efekt szkolenia z sezonem i wzrostem rynku, druga – z tym, że do szkolenia trafiły lepsze salony (błąd selekcji).
Rysunek 1: różnica w różnicach w tabeli 2 × 2
Różnica w różnicach (DiD, difference-in-differences) łączy obie naiwne odpowiedzi. Bierze zmianę w przeszkolonych salonach i odejmuje od niej zmianę w salonach bez szkolenia. Ta druga zmiana mówi, ile „samo z siebie” dał rynek i sezon. Pełną logikę metody na innym przykładzie opisuje wpis quasi-eksperyment i różnica w różnicach.
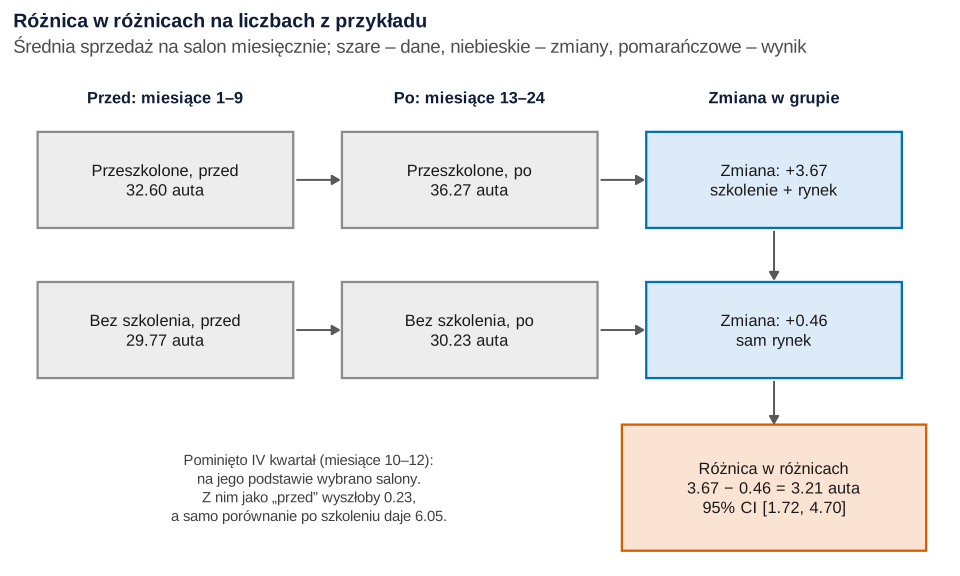
set.seed(645)).Co widać. Przeszkolone salony sprzedawały w miesiącach 1–9 średnio 32.60 auta, a po szkoleniu 36.27 – wzrost o 3.67. Salony bez szkolenia: 29.77 i 30.23, wzrost o 0.46. Różnica w różnicach to 3.67 − 0.46 = 3.21 auta miesięcznie, 95% przedział ufności [1.72, 4.70]. Przedział zawiera prawdziwe 2.
Jak może zmylić. Zwróć uwagę, co jest „przed”. Wzięliśmy miesiące 1–9 i pominęliśmy IV kwartał, bo na jego podstawie wybierano salony. Gdyby „przed” był IV kwartał, DiD dałby 0.23 auta, prawie zero. Dlaczego – pokazuje rysunek 2. DiD działa, gdy bez szkolenia obie grupy zmieniałyby się tak samo (założenie równoległych trendów). Różnicy poziomów nie musi być zero: przeszkolone salony mogą sprzedawać więcej.
Podpis do pracy:
Rysunek 2: kwartał, który zdecydował o wyborze
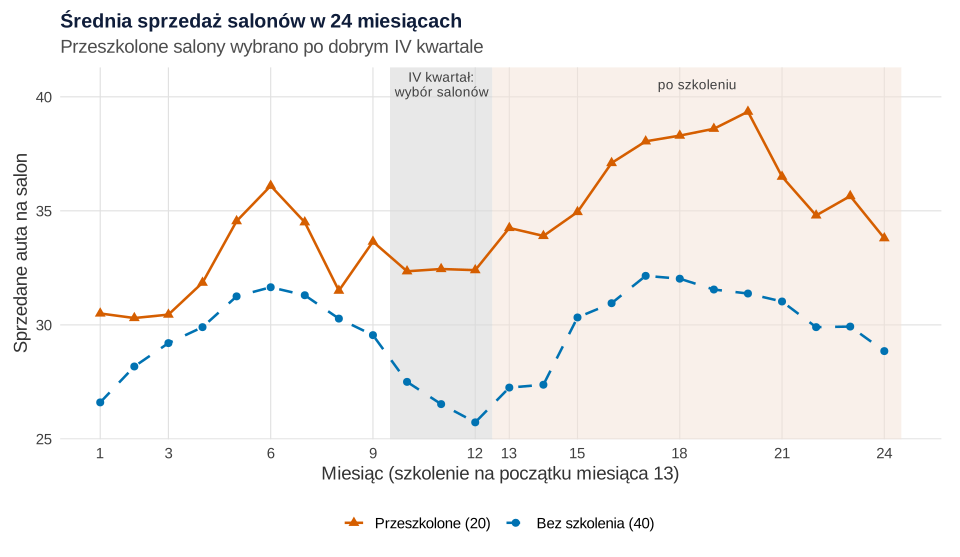
set.seed(645)).Co widać. Przez pierwsze dziewięć miesięcy obie linie biegną mniej więcej równolegle: przeszkolone salony sprzedają średnio o 2.83 auta więcej. W IV kwartale ta przewaga rośnie do 5.82. Nie dlatego, że salony nagle stały się lepsze – dyrektor wybrał salony, którym akurat dobrze poszło. Część tej passy była przypadkowa i w kolejnych miesiącach znika. To regresja do średniej: po nietypowo dobrych wynikach przychodzą zwykle wyniki bliższe przeciętnej. Barnett i in. (2005) podkreślają, że efekt jest najsilniejszy, gdy analizujemy podgrupę wybraną na podstawie wyniku wyjściowego – dokładnie tak jak tutaj.
Jak może zmylić. Spadek po dobrej passie i efekt szkolenia działają w przeciwnych kierunkach. Kto bierze IV kwartał za punkt wyjścia, porównuje szczyt passy z normalnym rokiem. Wtedy szkolenie „nie działa” (DiD = 0.23). Z kolei w porównaniu „przed i po” w samych przeszkolonych salonach regresja do średniej odejmuje, a sezon i wzrost rynku dodają. W naszym generatorze sezon i rynek dodają 2.57 auta, a regresja do średniej odejmuje przeciętnie 1.71. Błędy częściowo się znoszą – przypadkiem. Więcej o tym zjawisku w badaniach przed–po: regresja do średniej w badaniu przed–po.
Podpis do pracy:
Zdanie do Metody:
Rysunek 3: miesiąc po miesiącu – sprawdzenie okresu przed
Wykres średnich to za mało, bo nie ma na nim niepewności. Ten sam pomysł liczy regresja z efektami stałymi salonu i miesiąca: zamiast jednego współczynnika „szkolenie × po” dajemy osobny współczynnik dla każdego miesiąca. To model zdarzeń (event study). Zero to średnia różnica grup z miesięcy 1–9.
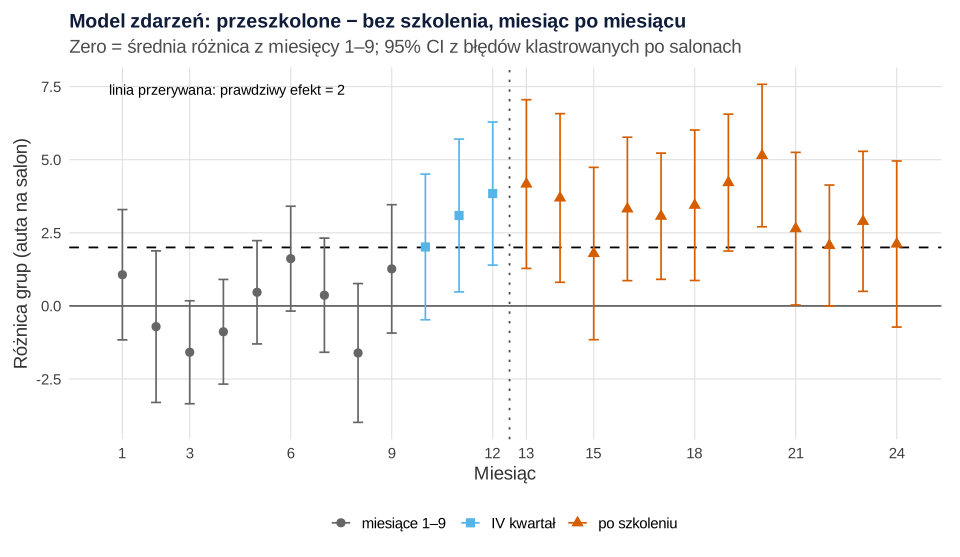
set.seed(645)).Co widać. W miesiącach 1–9 współczynniki krążą wokół zera (od −1.61 do 1.62). Test łączny nie wskazuje różnic między nimi: F = 1.57, p = .153. W IV kwartale różnica skacze średnio o 2.98 auta (p = .003) – to ślad wyboru salonów. Po szkoleniu współczynniki leżą średnio na 3.21. W miesiącach 13–14 są wyższe (4.17 i 3.69), bo część dobrej passy z IV kwartału jeszcze trwa.
Jak może zmylić. Brak istotnych różnic przed szkoleniem nie dowodzi równoległych trendów. Roth (2022) pokazuje, że takie testy często mają małą moc, a wybieranie analizy zależnie od ich wyniku może zwiększyć obciążenie i zawęzić przedziały ponad miarę. Pokaż cały wykres, nie tylko p.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: sześć sposobów liczenia w 1000 symulacjach
Jedne dane mogą mieć szczęście albo pecha. Dlatego wygenerowaliśmy 1000 nowych grup dealerskich z tymi samymi parametrami i w każdej policzyliśmy efekt szkolenia sześcioma sposobami. Szósty to dopasowanie: każdemu przeszkolonemu salonowi przypisujemy salon bez szkolenia o najbliższej średniej sprzedaży z miesięcy 1–9, a potem liczymy DiD na parach. Tak często robi się w pracach, żeby grupy „wyglądały podobnie” (zob. propensity score: dopasowanie i ważenie).
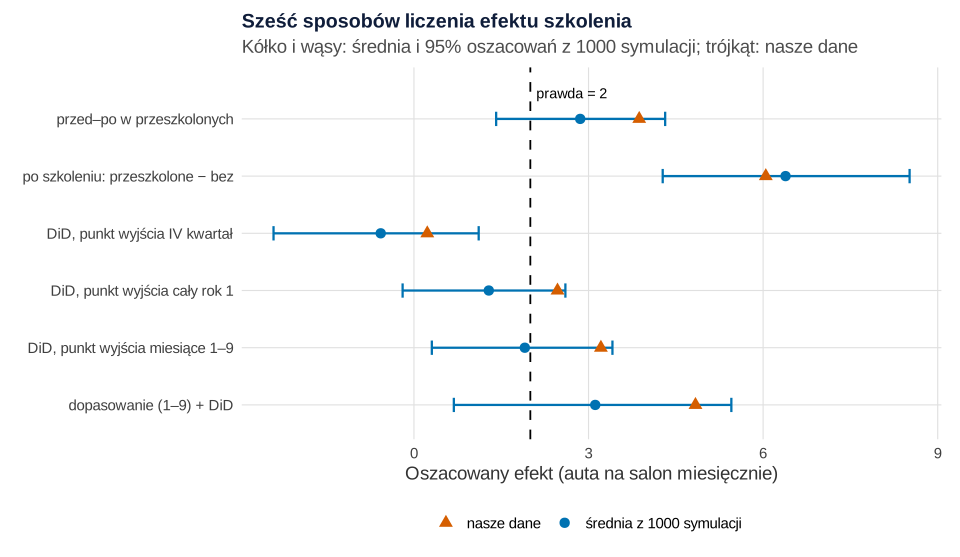
set.seed(645)).Co widać. Porównanie po szkoleniu zawyża efekt średnio o 4.39 auta (wynik 6.39 przy prawdzie 2), bo do szkolenia trafiły lepsze salony. DiD z IV kwartałem jako „przed” zaniża o 2.57 (średnio −0.57). Cały rok 1 jako „przed” zaniża mniej (1.29). DiD z miesiącami 1–9 trafia prawie dokładnie: średnio 1.91, obciążenie −0.09 (błąd Monte Carlo 0.03). „Przed i po” daje średnio 2.86 – blisko, ale tylko dlatego, że dwa błędy częściowo się znoszą. W naszych danych DiD z miesiącami 1–9 dał 3.21, czyli więcej niż średnia z symulacji. Pojedyncze dane mają swój rozrzut: 95% oszacowań tą metodą leży między 0.31 a 3.41.
Dopasowanie pogarsza wynik. Po dopasowaniu grupy różniły się przed szkoleniem tylko o 0.27 auta. Mimo to DiD po dopasowaniu dał 4.84, a w symulacjach był zawyżony średnio o 1.12 i miał większy rozrzut (SD 1.22 wobec 0.83). Mechanizm opisują Daw i Hatfield (2018): gdy przydział do interwencji wiąże się z poziomem wyniku, dopasowanie na poziomie sprzed interwencji wprowadza regresję do średniej. Dobrany „bliźniak” to zwykle słabszy salon w chwilowo dobrej formie, który potem wraca do swojej średniej. Do 20 przeszkolonych salonów dobrano zaledwie 10 różnych salonów kontrolnych.
Jak może zmylić. Symulacja mówi tylko o świecie, który zbudowaliśmy: wybór na podstawie jednego kwartału, passy wygasające w kilka miesięcy, równoległe trendy poza tym. Gdyby dyrektor wybierał salony o rosnącym trendzie, DiD bez dopasowania byłby obciążony, a dopasowanie mogłoby pomóc (Daw i Hatfield, 2018).
Podpis do pracy:
Rysunek 5: błędy standardowe klastrowane po salonach
Regresja na danych salon × miesiąc ma 60 × 24 = 1440 wierszy, ale tylko 60 salonów. Sprzedaż tego samego salonu w kolejnych miesiącach jest powiązana: dobra passa trwa kilka miesięcy. Zwykłe błędy standardowe traktują każdy wiersz jak niezależną obserwację i przeceniają precyzję. W naszych danych błąd standardowy odporny na klastrowanie po salonach jest 1.47 raza większy (0.75 wobec 0.51). Żeby zobaczyć skutki, zrobiliśmy 1000 „szkoleń placebo”: 20 losowo wybranych salonów, zerowy efekt.
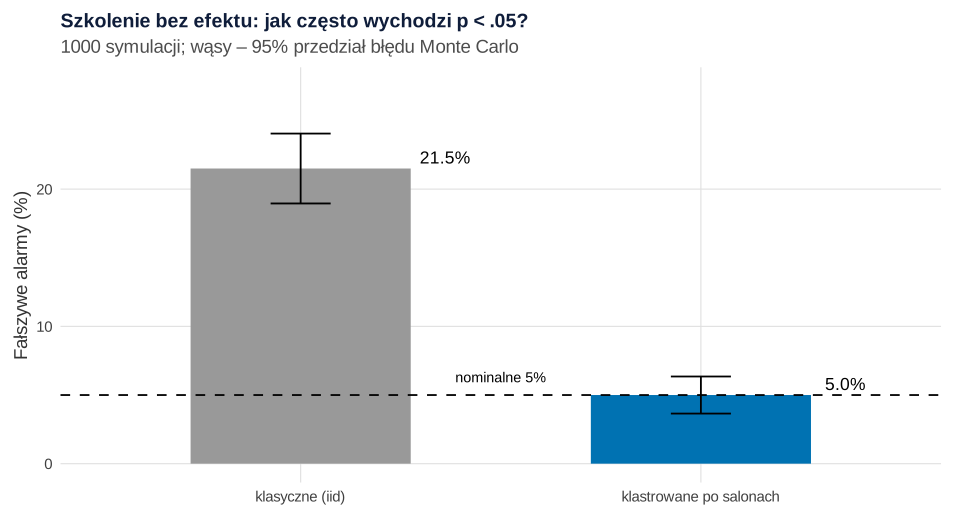
set.seed(6450)).Co widać. Przy zwykłych błędach szkolenie bez żadnego efektu wychodzi „istotne” w 21.5% powtórzeń (błąd MC 1.3 pp) zamiast w 5%. Przy błędach klastrowanych po salonach – w 5.0% (błąd MC 0.7 pp). Bertrand i in. (2004) opisali to samo zjawisko w danych z wielu lat: przy fikcyjnych interwencjach nawet do 45% wyników wychodziło istotnych na poziomie 5%.
Jak może zmylić. Klastrowanie pomaga, gdy klastrów jest dużo. Przy kilku–kilkunastu salonach albo regionach także te błędy bywają za małe. Cameron i Miller (2015) omawiają komplikacje przy małej liczbie klastrów. Klastruj na poziomie, na którym przydzielano szkolenie – tu salon, a nie doradca czy miesiąc.
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w firmie
- Policz pieniądze z właściwego oszacowania. Przy marży 5 tys. zł na aucie i koszcie szkolenia 40 tys. zł na salon (800 tys. zł razem; parametry ustalone ręcznie) DiD z miesiącami 1–9 daje 3855 tys. zł dodatkowej marży w roku, a dolna granica przedziału – 2064 tys. zł. Prawdziwy efekt to 2400 tys. zł. DiD z IV kwartałem jako punktem wyjścia dałby 275 tys. zł i wniosek „szkolenie się nie zwraca” – błędny.
- Następną edycję wylosuj. Jeśli szkolenie ma objąć wszystkie salony, ustal losowo kolejność fal: najpierw 20 salonów, potem reszta. Losowanie całych salonów opisuje wpis randomizacja klastrowa. Wtedy nagroda dla najlepszych nie miesza się z oceną.
- Zapisz z góry, jak wybierasz salony, i zbieraj dane miesięczne z dłuższego okresu przed szkoleniem. Okres, na podstawie którego wybierano, trzeba potem pominąć.
- Patrz szerzej niż sprzedaż. Reakcję, wiedzę i zachowanie doradców ocenia ewaluacja w modelu Kirkpatricka, a to, czy szkolenie zatrzymuje ludzi w firmie – rotacja pracowników jako analiza przeżycia.
Tę samą logikę stosuje się do oceny otwarcia nowego lokalu (kanibalizacja – różnica w różnicach), a gdy interwencję dostaje tylko jedna jednostka – syntetyczna kontrola. Gdy szkolenia startują w różnych miesiącach w różnych salonach, prosta regresja z efektami stałymi może dać mylący średni efekt. Nowsze metody dla takich danych porządkują Roth i in. (2023).
Jak opisać w pracy
W Metodzie opisz, jak wybrano salony do szkolenia, jaki okres przyjęto jako „przed” i dlaczego, model i sposób liczenia błędów standardowych. W Wynikach podaj tabelę 2 × 2, oszacowanie z przedziałem i wykres modelu zdarzeń. W Dyskusji nazwij zagrożenia: inne zmiany w przeszkolonych salonach w tym samym czasie, przenoszenie wiedzy do salonów bez szkolenia, możliwe różnice w trendach. Więcej wskazówek: statystyka w pracy z zarządzania i ekonomii i jak napisać pracę z zarządzania i ekonomii.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy generator, dane, paletę i motyw, przepis 2 – tabelę 2 × 2 i proste odpowiedzi, przepis 3 – model z błędami klastrowanymi używany na grafice z przepisu 6. Przepisy 2–6 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1, 4 i 5; każdy zaczyna od własnego ziarna: set.seed(645) w przepisach 1 i 4, set.seed(6450) w przepisie 5. Ziarna ustalono raz i nie zmieniano ich. Ręcznie ustalono: poziom salonów (średnio 30 aut, SD = 4), sezon (amplituda 2.5 auta, szczyt w czerwcu), wzrost rynku (0.08 auta na miesiąc), przejściowe passy (AR(1), φ = 0.5, SD = 4), szum (SD = 1.5), siłę premiowania wyniku IV kwartału (2), liczbę przeszkolonych salonów (20) i efekt szkolenia (+2 auta) (przepis 1); marżę 5 tys. zł na aucie i koszt szkolenia 40 tys. zł na salon (przepis 3); po 1000 powtórzeń (przepisy 4 i 5). Udział pass, ich autokorelację, rozrzut poziomów i siłę wyboru zmieniono po pierwszym uruchomieniu, żeby skutki wyboru salonów były wyraźne. Cały kod liczy się w kilkanaście sekund.
1. Dane: 60 salonów, 24 miesiące, wybór do szkolenia
R
# Przepis 1. Fikcyjna grupa dealerska: miesięczna sprzedaż samochodów w 60 salonach, szkolenie w 20 z nich
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("Przeszkolone (20)" = "#D55E00", "Bez szkolenia (40)" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Generator danych. Parametry ustalono ręcznie: stały poziom salonu (średnio 30 aut, SD 4), sezon
# (szczyt w czerwcu), wzrost rynku 0.08 auta na miesiąc, przejściowe „dobre i złe passy” salonu
# (AR(1), phi = 0.5, SD 4), szum miesięczny (SD 1.5). Szkolenie od miesiąca 13 daje +2 auta miesięcznie.
# Dyrektor wybiera 20 salonów losowo, ale z wagą rosnącą z wynikiem IV kwartału (miesiące 10–12):
# salony po dobrym kwartale mają większą szansę – tak jak „nagroda dla najlepszych”.
generuj <- function(n = 60, efekt = 2, phi = 0.5, sd_passa = 4, sila_wyboru = 2) {
  mies <- 1:24
  rynek <- 2.5 * sin(2 * pi * (mies - 3) / 12) + 0.08 * mies
  poziom <- rnorm(n, 30, 4)
  passa <- matrix(0, n, 24); passa[, 1] <- rnorm(n, 0, sd_passa)
  for (t in 2:24) passa[, t] <- phi * passa[, t - 1] + rnorm(n, 0, sd_passa * sqrt(1 - phi^2))
  y0 <- outer(poziom, rep(1, 24)) + outer(rep(1, n), rynek) + passa + matrix(rnorm(n * 24, 0, 1.5), n)
  q4 <- rowMeans(y0[, 10:12])
  wybrane <- sample(n, 20, prob = exp(sila_wyboru * (q4 - mean(q4)) / sd(q4)))
  szkolenie <- seq_len(n) %in% wybrane
  y <- round(y0 + outer(szkolenie, mies >= 13) * efekt)   # liczba sprzedanych aut w miesiącu
  list(y = y, szkolenie = szkolenie)
}

set.seed(645)                                            # ziarno ustalone raz, bez dobierania pod wynik
g <- generuj()
Y <- g$y; szk <- g$szkolenie
salony <- data.frame(salon = rep(sprintf("S%02d", 1:60), each = 24), miesiac = rep(1:24, 60),
                     szkolenie = rep(as.integer(szk), each = 24), sprzedaz = as.vector(t(Y)))
salony$po <- as.integer(salony$miesiac >= 13)
write.csv(salony, "szkolenie-salony-sprzedaz-miesieczna.csv", row.names = FALSE)

cat("Salony:", nrow(Y), " miesiące:", ncol(Y), " przeszkolone:", sum(szk), "\n")
cat("Średnia sprzedaż (auta na miesiąc)      przeszkolone  bez szkolenia\n")
okresy <- list("miesiące 1–9" = 1:9, "IV kwartał (10–12)" = 10:12, "po szkoleniu (13–24)" = 13:24)
for (o in names(okresy)) cat(sprintf("%-26s %12.2f %14.2f\n", o, mean(Y[szk, okresy[[o]]]), mean(Y[!szk, okresy[[o]]])))
cat("Prawdziwy efekt szkolenia: +2 auta miesięcznie w każdym przeszkolonym salonie (miesiące 13–24)\n")
Wynik w R
Salony: 60  miesiące: 24  przeszkolone: 20
Średnia sprzedaż (auta na miesiąc)      przeszkolone  bez szkolenia
miesiące 1–9                   32.60          29.77
IV kwartał (10–12)             32.40          26.58
po szkoleniu (13–24)            36.27          30.23
Prawdziwy efekt szkolenia: +2 auta miesięcznie w każdym przeszkolonym salonie (miesiące 13–24)
2. Trendy, tabela 2 × 2 i proste odpowiedzi: Rysunek 2
R
# Przepis 2. Trendy obu grup, tabela 2 × 2 i pięć odpowiedzi na pytanie „ile dało szkolenie?”: Rysunek 2
# (korzysta z Y, szk, kol i motyw z przepisu 1)
library(ggplot2)

sr <- function(grupa, mies) mean(Y[grupa, mies])          # średnia sprzedaż grupy salonów w wybranych miesiącach
przed <- 1:9; q4 <- 10:12; po <- 13:24; caly_rok1 <- 1:12

odp <- c("przed–po w przeszkolonych (IV kw. → po)"   = sr(szk, po) - sr(szk, q4),
         "po szkoleniu: przeszkolone − bez szkolenia" = sr(szk, po) - sr(!szk, po),
         "DiD, punkt wyjścia IV kwartał"              = (sr(szk, po) - sr(szk, q4)) - (sr(!szk, po) - sr(!szk, q4)),
         "DiD, punkt wyjścia cały rok 1"              = (sr(szk, po) - sr(szk, caly_rok1)) - (sr(!szk, po) - sr(!szk, caly_rok1)),
         "DiD, punkt wyjścia miesiące 1–9"            = (sr(szk, po) - sr(szk, przed)) - (sr(!szk, po) - sr(!szk, przed)))
cat("Ile dało szkolenie? (auta na salon miesięcznie; prawda = 2)\n")
cat(paste0("  ", format(names(odp)), sprintf(" %6.2f", odp)), sep = "\n")

cat("\nTabela 2 × 2 (miesiące 1–9 i 13–24):\n")
tab <- matrix(c(sr(szk, przed), sr(szk, po), sr(!szk, przed), sr(!szk, po)), 2, byrow = TRUE,
              dimnames = list(c("przeszkolone", "bez szkolenia"), c("przed (1–9)", "po (13–24)")))
print(round(cbind(tab, zmiana = tab[, 2] - tab[, 1]), 2))
cat("Różnica grup w IV kwartale:", round(sr(szk, q4) - sr(!szk, q4), 2),
    " w miesiącach 1–9:", round(sr(szk, przed) - sr(!szk, przed), 2), "\n")

# Dopasowanie (krótko): każdemu przeszkolonemu salonowi najbliższy salon bez szkolenia
# pod względem średniej z miesięcy 1–9 (najbliższy sąsiad, ze zwracaniem), potem DiD na parach
x <- rowMeans(Y[, przed]); kontrola <- which(!szk)
para <- sapply(which(szk), function(i) kontrola[which.min(abs(x[kontrola] - x[i]))])
did_dop <- mean(rowMeans(Y[szk, po]) - x[szk]) - mean(rowMeans(Y[para, po]) - x[para])
cat("\nDopasowanie na miesiącach 1–9: różnica grup przed", round(mean(x[szk]) - mean(x[para]), 2),
    " DiD po dopasowaniu", round(did_dop, 2), " różnych salonów kontrolnych:", length(unique(para)), "\n")

# Rysunek 2: średnia miesięczna sprzedaż w obu grupach
trend <- data.frame(miesiac = rep(1:24, 2), grupa = factor(rep(names(kol), each = 24), levels = names(kol)),
                    sprzedaz = c(colMeans(Y[szk, ]), colMeans(Y[!szk, ])))
p2 <- ggplot(trend, aes(miesiac, sprzedaz, colour = grupa, shape = grupa, linetype = grupa)) +
  annotate("rect", xmin = 9.5, xmax = 12.5, ymin = -Inf, ymax = Inf, fill = "grey85", alpha = 0.6) +
  annotate("rect", xmin = 12.5, xmax = 24.5, ymin = -Inf, ymax = Inf, fill = "#F5E3D6", alpha = 0.5) +
  annotate("text", x = 11, y = max(trend$sprzedaz) + 1.2, label = "IV kwartał:\nwybór salonów", size = 3.6, colour = "grey25", lineheight = 0.9) +
  annotate("text", x = 18.5, y = max(trend$sprzedaz) + 1.2, label = "po szkoleniu", size = 3.6, colour = "grey25") +
  geom_line(linewidth = 0.9) + geom_point(size = 2.4) +
  scale_colour_manual(values = kol, name = NULL) + scale_shape_manual(values = c(17, 16), name = NULL) +
  scale_linetype_manual(values = c("solid", "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(1, 3, 6, 9, 12, 13, 15, 18, 21, 24)) +
  labs(title = "Średnia sprzedaż salonów w 24 miesiącach",
       subtitle = "Przeszkolone salony wybrano po dobrym IV kwartale",
       x = "Miesiąc (szkolenie na początku miesiąca 13)", y = "Sprzedane auta na salon") + motyw
p2   # zapis: ggsave("szkolenie-salony-trendy.svg", p2, width = 10, height = 5.8)
Wynik w R
Ile dało szkolenie? (auta na salon miesięcznie; prawda = 2)
  przed–po w przeszkolonych (IV kw. → po)      3.87
  po szkoleniu: przeszkolone − bez szkolenia   6.05
  DiD, punkt wyjścia IV kwartał                0.23
  DiD, punkt wyjścia cały rok 1                2.47
  DiD, punkt wyjścia miesiące 1–9              3.21

Tabela 2 × 2 (miesiące 1–9 i 13–24):
              przed (1–9) po (13–24) zmiana
przeszkolone        32.60      36.27   3.67
bez szkolenia       29.77      30.23   0.46
Różnica grup w IV kwartale: 5.82  w miesiącach 1–9: 2.83

Dopasowanie na miesiącach 1–9: różnica grup przed 0.27  DiD po dopasowaniu 4.84  różnych salonów kontrolnych: 10
3. Regresja z efektami stałymi i model zdarzeń: Rysunek 3
R
# Przepis 3. Regresja z efektami stałymi, błędy klastrowane po salonach i model zdarzeń: Rysunek 3
# (korzysta z Y, szk i motyw z przepisu 1 oraz odp z przepisu 2)
library(ggplot2); library(fixest)

dl <- data.frame(salon = rep(1:60, each = 24), miesiac = rep(1:24, 60),
                 szkolenie = rep(as.integer(szk), each = 24), sprzedaz = as.vector(t(Y)))
dl$po <- as.integer(dl$miesiac >= 13)
bez_q4 <- subset(dl, !(miesiac %in% 10:12))             # IV kwartał (podstawa wyboru) poza punktem wyjścia

# DiD jako regresja: efekty stałe salonu i miesiąca + szkolenie × po
m_zwykle <- feols(sprzedaz ~ szkolenie:po | salon + miesiac, data = bez_q4, vcov = "iid")
m_klastr <- feols(sprzedaz ~ szkolenie:po | salon + miesiac, data = bez_q4, vcov = ~salon)
pz <- function(p) if (p < .001) "p < .001" else sub("0\\.", ".", sprintf("p = %.3f", p))   # zapis APA
pokaz <- function(m, opis) { ci <- confint(m)
  cat(sprintf("%-28s b = %.2f  SE = %.2f  95%% CI [%.2f, %.2f]  %s\n", opis, coef(m), se(m), ci[1, 1], ci[1, 2], pz(pvalue(m)))) }
pokaz(m_zwykle, "Błędy klasyczne (iid):"); pokaz(m_klastr, "Błędy klastrowane (salon):")
cat("Iloraz SE klastrowany / klasyczny:", round(se(m_klastr) / se(m_zwykle), 2), "\n")

# Czy szkolenie się opłaciło? Ręczne parametry: marża 5 tys. zł na aucie, koszt 40 tys. zł na salon
marza <- 5; koszt <- 40 * 20
zysk <- function(b) b * 12 * 20 * marza                  # 20 salonów × 12 miesięcy, tys. zł
cat("Koszt szkolenia:", koszt, "tys. zł. Dodatkowa marża w roku (tys. zł): DiD (1–9)", round(zysk(coef(m_klastr))),
    "[", round(zysk(confint(m_klastr)[1, 1])), "–", round(zysk(confint(m_klastr)[1, 2])), "]",
    "| DiD (IV kw.)", round(zysk(odp[3])), "| prawda", zysk(2), "\n")

# Model zdarzeń: osobny współczynnik dla każdego miesiąca (technicznie odniesienie = miesiąc 9),
# potem przesunięcie tak, by średnia miesięcy 1–9 była zerem (kontrast liniowy z pełną macierzą kowariancji)
m_zd <- feols(sprzedaz ~ i(miesiac, szkolenie, ref = 9) | salon + miesiac, data = dl, vcov = ~salon)
bp <- append(coef(m_zd), 0, after = 8)                   # 24 współczynniki, miesiąc 9 = 0
Vp <- matrix(0, 24, 24); Vp[-9, -9] <- vcov(m_zd)
C <- diag(24) - outer(rep(1, 24), as.numeric(1:24 <= 9)) / 9   # b − średnia(b z miesięcy 1–9)
zd <- data.frame(miesiac = 1:24, b = as.vector(C %*% bp), se = sqrt(diag(C %*% Vp %*% t(C))))
zd$lo <- zd$b - 1.96 * zd$se; zd$hi <- zd$b + 1.96 * zd$se
zd$okres <- cut(zd$miesiac, c(0, 9, 12, 24), labels = c("miesiące 1–9", "IV kwartał", "po szkoleniu"))
cat("\nModel zdarzeń (odniesienie: średnia miesięcy 1–9), współczynniki:\n")
print(round(setNames(zd$b, zd$miesiac), 2))
cat("Średnio: IV kwartał", round(mean(zd$b[zd$okres == "IV kwartał"]), 2),
    " po szkoleniu", round(mean(zd$b[zd$miesiac >= 13]), 2), "\n")
ws <- wald(m_zd, keep = paste0("miesiac::", 1:8, ":"), print = FALSE)
cat("Test łączny: miesiące 1–9 równe sobie (8 ograniczeń) F =", round(ws$stat, 2), "", pz(ws$p), "\n")
L <- rbind(colMeans(C[10:12, ]))                          # średni współczynnik IV kwartału
z4 <- as.numeric(L %*% bp) / sqrt(as.numeric(L %*% Vp %*% t(L)))
cat("IV kwartał vs miesiące 1–9: różnica", round(as.numeric(L %*% bp), 2), " z =", round(z4, 2),
    "", pz(2 * pnorm(-abs(z4))), "\n")

ksz <- c("miesiące 1–9" = 16, "IV kwartał" = 15, "po szkoleniu" = 17)
kk <- c("miesiące 1–9" = "grey40", "IV kwartał" = "#56B4E9", "po szkoleniu" = "#D55E00")
p3 <- ggplot(zd, aes(miesiac, b, colour = okres, shape = okres)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_hline(yintercept = 2, linetype = "dashed", colour = "black") +
  annotate("text", x = 0.6, y = 7.4, label = "linia przerywana: prawdziwy efekt = 2", hjust = 0, size = 3.8) +
  geom_vline(xintercept = 12.5, linetype = "dotted", colour = "grey30") +
  geom_errorbar(aes(ymin = lo, ymax = hi), width = 0.3, linewidth = 0.6) + geom_point(size = 2.8) +
  scale_colour_manual(values = kk, name = NULL) + scale_shape_manual(values = ksz, name = NULL) +
  scale_x_continuous(breaks = c(1, 3, 6, 9, 12, 13, 15, 18, 21, 24)) +
  labs(title = "Model zdarzeń: przeszkolone − bez szkolenia, miesiąc po miesiącu",
       subtitle = "Zero = średnia różnica z miesięcy 1–9; 95% CI z błędów klastrowanych po salonach",
       x = "Miesiąc", y = "Różnica grup (auta na salon)") + motyw
p3   # zapis: ggsave("szkolenie-salony-model-zdarzen.svg", p3, width = 10, height = 5.8)
Wynik w R
Błędy klasyczne (iid):     b = 3.21  SE = 0.51  95% CI [2.22, 4.21]  p < .001
Błędy klastrowane (salon): b = 3.21  SE = 0.75  95% CI [1.72, 4.70]  p < .001
Iloraz SE klastrowany / klasyczny: 1.47
Koszt szkolenia: 800 tys. zł. Dodatkowa marża w roku (tys. zł): DiD (1–9) 3855 [ 2064 – 5646 ] | DiD (IV kw.) 275 | prawda 2400

Model zdarzeń (odniesienie: średnia miesięcy 1–9), współczynniki:
    1     2     3     4     5     6     7     8     9    10    11    12    13
 1.07 -0.71 -1.58 -0.88  0.47  1.62  0.37 -1.61  1.27  2.02  3.09  3.84  4.17
   14    15    16    17    18    19    20    21    22    23    24
 3.69  1.79  3.32  3.07  3.44  4.22  5.14  2.64  2.07  2.89  2.12
Średnio: IV kwartał 2.98  po szkoleniu 3.21
Test łączny: miesiące 1–9 równe sobie (8 ograniczeń) F = 1.57  p = .153
IV kwartał vs miesiące 1–9: różnica 2.98  z = 2.92  p = .003
4. 1000 symulacji: sześć sposobów liczenia: Rysunek 4
R
# Przepis 4. 1000 symulowanych grup dealerskich: które porównanie trafia w prawdziwy efekt? Rysunek 4
# (korzysta z generuj(), odp, did_dop i motyw z przepisów 1–2)
library(ggplot2)

szacuj <- function(g) {
  Y <- g$y; s <- g$szkolenie
  sr <- function(grupa, m) mean(Y[grupa, m])
  dd <- function(m0) (sr(s, 13:24) - sr(s, m0)) - (sr(!s, 13:24) - sr(!s, m0))
  x <- rowMeans(Y[, 1:9]); k <- which(!s)
  para <- sapply(which(s), function(i) k[which.min(abs(x[k] - x[i]))])
  c(sr(s, 13:24) - sr(s, 10:12), sr(s, 13:24) - sr(!s, 13:24), dd(10:12), dd(1:12), dd(1:9),
    mean(rowMeans(Y[s, 13:24]) - x[s]) - mean(rowMeans(Y[para, 13:24]) - x[para]))
}
metody <- c("przed–po w przeszkolonych", "po szkoleniu: przeszkolone − bez", "DiD, punkt wyjścia IV kwartał",
            "DiD, punkt wyjścia cały rok 1", "DiD, punkt wyjścia miesiące 1–9", "dopasowanie (1–9) + DiD")

set.seed(645)                                            # to samo ziarno; 1000 nowych grup dealerskich
R <- 1000
sym <- t(replicate(R, szacuj(generuj())))
wyn <- data.frame(metoda = factor(metody, levels = rev(metody)), srednia = colMeans(sym),
                  obciazenie = colMeans(sym) - 2, blad_mc = apply(sym, 2, sd) / sqrt(R),
                  sd = apply(sym, 2, sd), q025 = apply(sym, 2, quantile, 0.025), q975 = apply(sym, 2, quantile, 0.975),
                  nasze = c(odp, did_dop))
cat("Prawdziwy efekt = 2;", R, "powtórzeń\n")
cat(sprintf("%-34s %7s %10s %7s %5s %15s %6s\n", "metoda", "średnia", "obciążenie", "błąd MC", "SD", "95% oszacowań", "nasze"))
with(wyn, cat(sprintf("%-34s %7.2f %10.2f %7.3f %5.2f  [%5.2f, %5.2f] %6.2f\n",
                      metody, srednia, obciazenie, blad_mc, sd, q025, q975, nasze), sep = ""))

# Skąd błąd porównania „przed–po”? Sezon i wzrost rynku (z generatora) dodają, regresja do średniej odejmuje
rynek <- 2.5 * sin(2 * pi * ((1:24) - 3) / 12) + 0.08 * (1:24)
zmiana_rynku <- mean(rynek[13:24]) - mean(rynek[10:12])
cat("\nPrzed–po: sezon i rynek dodają", round(zmiana_rynku, 2), " regresja do średniej odejmuje średnio",
    round(2 + zmiana_rynku - wyn$srednia[1], 2), "\n")

p4 <- ggplot(wyn, aes(y = metoda)) +
  geom_vline(xintercept = 2, linetype = "dashed") +
  annotate("text", x = 2.1, y = 6.45, label = "prawda = 2", hjust = 0, size = 3.8) +
  geom_errorbar(aes(xmin = q025, xmax = q975), orientation = "y", width = 0.25, colour = "#0072B2", linewidth = 0.8) +
  geom_point(aes(x = srednia, shape = "średnia z 1000 symulacji"), colour = "#0072B2", size = 3.2) +
  geom_point(aes(x = nasze, shape = "nasze dane"), colour = "#D55E00", size = 3.2) +
  scale_shape_manual(values = c("średnia z 1000 symulacji" = 16, "nasze dane" = 17), name = NULL) +
  scale_y_discrete(expand = expansion(add = c(0.6, 0.9))) +
  labs(title = "Sześć sposobów liczenia efektu szkolenia",
       subtitle = "Kółko i wąsy: średnia i 95% oszacowań z 1000 symulacji; trójkąt: nasze dane",
       x = "Oszacowany efekt (auta na salon miesięcznie)", y = NULL) + motyw
p4   # zapis: ggsave("szkolenie-salony-symulacja.svg", p4, width = 10, height = 5.8)
Wynik w R
Prawdziwy efekt = 2; 1000 powtórzeń
metoda                             średnia obciążenie błąd MC    SD  95% oszacowań  nasze
przed–po w przeszkolonych           2.86       0.86   0.024  0.75  [ 1.41,  4.32]   3.87
po szkoleniu: przeszkolone − bez    6.39       4.39   0.033  1.04  [ 4.27,  8.52]   6.05
DiD, punkt wyjścia IV kwartał      -0.57      -2.57   0.028  0.88  [-2.41,  1.11]   0.23
DiD, punkt wyjścia cały rok 1       1.29      -0.71   0.023  0.74  [-0.19,  2.60]   2.47
DiD, punkt wyjścia miesiące 1–9    1.91      -0.09   0.026  0.83  [ 0.31,  3.41]   3.21
dopasowanie (1–9) + DiD             3.12       1.12   0.039  1.22  [ 0.69,  5.45]   4.84

Przed–po: sezon i rynek dodają 2.57  regresja do średniej odejmuje średnio 1.71
5. Szkolenia placebo i błędy standardowe: Rysunek 5
R
# Przepis 5. Fałszywe alarmy przy błędach klasycznych i klastrowanych: 1000 szkoleń „placebo”. Rysunek 5
# (korzysta z generuj() i motyw z przepisu 1)
library(ggplot2); library(fixest)

set.seed(6450)                                           # osobne ziarno dla symulacji placebo
R <- 1000
odrzuc <- t(replicate(R, {
  g <- generuj(efekt = 0, sila_wyboru = 0)               # szkolenie nic nie daje, salony wybrane czysto losowo
  d <- data.frame(salon = rep(1:60, each = 24), miesiac = rep(1:24, 60),
                  sp = as.vector(t(g$y)), sz_po = as.vector(t(outer(g$szkolenie, 1:24 >= 13))))
  m <- feols(sp ~ sz_po | salon + miesiac, data = d, vcov = "iid")
  c(klasyczne = pvalue(m) < .05, klastrowane = pvalue(summary(m, vcov = ~salon)) < .05)
}))
wsk <- data.frame(bledy = factor(c("klasyczne (iid)", "klastrowane po salonach"), levels = c("klasyczne (iid)", "klastrowane po salonach")),
                  odsetek = colMeans(odrzuc))
wsk$mc <- sqrt(wsk$odsetek * (1 - wsk$odsetek) / R)
cat("Odsetek „istotnych” efektów szkolenia placebo (p < .05),", R, "powtórzeń:\n")
print(transform(wsk, odsetek = round(100 * odsetek, 1), mc = round(100 * mc, 1)), row.names = FALSE)

p5 <- ggplot(wsk, aes(bledy, 100 * odsetek, fill = bledy)) +
  geom_col(width = 0.55) +
  geom_errorbar(aes(ymin = 100 * (odsetek - 1.96 * mc), ymax = 100 * (odsetek + 1.96 * mc)), width = 0.15) +
  geom_hline(yintercept = 5, linetype = "dashed") +
  annotate("text", x = 1.5, y = 6.3, label = "nominalne 5%", size = 3.8) +
  geom_text(aes(x = as.numeric(bledy) + 0.36, label = sprintf("%.1f%%", 100 * odsetek)), vjust = -0.4, size = 4.6) +
  scale_fill_manual(values = c("klasyczne (iid)" = "grey60", "klastrowane po salonach" = "#0072B2"), guide = "none") +
  scale_y_continuous(limits = c(0, max(100 * wsk$odsetek) + 6)) +
  labs(title = "Szkolenie bez efektu: jak często wychodzi p < .05?",
       subtitle = "1000 symulacji; wąsy – 95% przedział błędu Monte Carlo",
       x = NULL, y = "Fałszywe alarmy (%)") + motyw
p5   # zapis: ggsave("szkolenie-salony-placebo.svg", p5, width = 10, height = 5.4)
Wynik w R
Odsetek „istotnych” efektów szkolenia placebo (p < .05), 1000 powtórzeń:
                   bledy odsetek  mc
         klasyczne (iid)    21.5 1.3
 klastrowane po salonach     5.0 0.7
6. Grafika tabeli 2 × 2: Rysunek 1
R
# Przepis 6. Grafika: tabela 2 × 2 różnicy w różnicach z liczbami z przykładu (Rysunek 1)
# (korzysta z tab, odp, m_klastr i motyw z przepisów 1–3)
library(ggplot2)

f <- function(x) formatC(x, format = "f", digits = 2)
ci <- confint(m_klastr)
karty <- data.frame(
  x = c(1, 2, 1, 2, 3, 3, 3),
  y = c(3, 3, 2, 2, 3, 2, 0.95),
  rodzaj = c("dane", "dane", "dane", "dane", "zmiana", "zmiana", "wynik"),
  tekst = c(paste0("Przeszkolone, przed\n", f(tab[1, 1]), " auta"), paste0("Przeszkolone, po\n", f(tab[1, 2]), " auta"),
            paste0("Bez szkolenia, przed\n", f(tab[2, 1]), " auta"), paste0("Bez szkolenia, po\n", f(tab[2, 2]), " auta"),
            paste0("Zmiana: +", f(tab[1, 2] - tab[1, 1]), "\nszkolenie + rynek"),
            paste0("Zmiana: +", f(tab[2, 2] - tab[2, 1]), "\nsam rynek"),
            paste0("Różnica w różnicach\n", f(tab[1, 2] - tab[1, 1]), " − ", f(tab[2, 2] - tab[2, 1]), " = ",
                   f(odp[5]), " auta\n95% CI [", f(ci[1, 1]), ", ", f(ci[1, 2]), "]")))
karty$w <- ifelse(karty$rodzaj == "wynik", 0.5, 0.42); karty$h <- ifelse(karty$rodzaj == "wynik", 0.42, 0.32)
wyp <- c(dane = "grey93", zmiana = "#DCEBF7", wynik = "#FBE3D3")
ram <- c(dane = "grey55", zmiana = "#0072B2", wynik = "#D55E00")
strzalki <- data.frame(x = c(1.43, 1.43, 2.43, 2.43, 3, 3), xend = c(1.57, 1.57, 2.57, 2.57, 3, 3),
                       y = c(3, 2, 3, 2, 2.66, 1.66), yend = c(3, 2, 3, 2, 2.34, 1.38))
uwaga <- paste0("Pominięto IV kwartał (miesiące 10–12):\nna jego podstawie wybrano salony.\n",
                "Z nim jako „przed” wyszłoby ", f(odp[3]), ",\na samo porównanie po szkoleniu daje ", f(odp[2]), ".")
p1 <- ggplot(karty) +
  geom_rect(aes(xmin = x - w, xmax = x + w, ymin = y - h, ymax = y + h, fill = rodzaj, colour = rodzaj), linewidth = 0.8) +
  geom_text(aes(x = x, y = y, label = tekst), size = 4.3, colour = "grey10", lineheight = 1.0) +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = yend),
               arrow = arrow(length = unit(0.22, "cm"), type = "closed"), colour = "grey35", linewidth = 0.7) +
  annotate("text", x = c(1, 2, 3), y = 3.55, label = c("Przed: miesiące 1–9", "Po: miesiące 13–24", "Zmiana w grupie"),
           fontface = "bold", size = 4.3, colour = "#0f1d3a") +
  annotate("text", x = 1.47, y = 0.95, label = uwaga, size = 3.9, colour = "grey25", lineheight = 1.05) +
  scale_fill_manual(values = wyp, guide = "none") + scale_colour_manual(values = ram, guide = "none") +
  coord_cartesian(xlim = c(0.5, 3.55), ylim = c(0.45, 3.75), expand = FALSE) +
  labs(title = "Różnica w różnicach na liczbach z przykładu",
       subtitle = "Średnia sprzedaż na salon miesięcznie; szare – dane, niebieskie – zmiany, pomarańczowe – wynik") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("szkolenie-salony-schemat-2x2.svg", p1, width = 10, height = 6)
7. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 7. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("przeszkolone – bez szkolenia" = c("#D55E00", "#0072B2"), "IV kwartał – po szkoleniu" = c("#56B4E9", "#D55E00"),
             "miesiące 1–9 – IV kwartał" = c("grey40", "#56B4E9"), "klasyczne – klastrowane" = c("grey60", "#0072B2"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  k <- rgb(t(col2rgb(k)), maxColorValue = 255)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
hex <- function(k) rgb(t(col2rgb(k)), maxColorValue = 255)
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(hex(k))),
                                   protanopia = roznica(protan(hex(k)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
przeszkolone – bez szkolenia               114.6        108.3       91.9
IV kwartał – po szkoleniu                  113.6        101.1       89.0
miesiące 1–9 – IV kwartał                   45.4         45.3       43.4
klasyczne – klastrowane                     44.9         48.9       40.6
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych i obliczenia średnich – pakiet stats wbudowany w R. Regresję z efektami stałymi, błędy klastrowane i testy Walda policzono pakietem fixest. Rysunki wykonano w pakiecie ggplot2 i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- fixest (wersja 0.14.2): Bergé, L. R., Butts, K., & McDermott, G. (2026). Fast and user-friendly econometrics estimations: The R package fixest. arXiv preprint arXiv:2601.21749. https://doi.org/10.48550/arXiv.2601.21749
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Porównanie „przed i po” bez grupy porównawczej. Miesza szkolenie z sezonem, rynkiem i regresją do średniej. W przykładzie błędy częściowo się znosiły – to przypadek, nie zaleta.
- Okres wyboru jako punkt wyjścia. Jeśli salony wybrano po dobrym kwartale, ten kwartał zaniża efekt (tu 0.23 zamiast 2).
- Dopasowanie na wyniku sprzed szkolenia. Wygląda porządnie, a może wprowadzić regresję do średniej (tu +1.12 średnio). Dopasowuj z uzasadnieniem, nie odruchowo.
- Zwykłe błędy standardowe. 1440 wierszy to nie 1440 niezależnych obserwacji. Bez klastrowania fałszywe alarmy zdarzały się w 21.5% przypadków.
- „Trendy równoległe, bo p > .05”. Test okresu przed ma małą moc. Pokaż wykres i uzasadnij założenie wiedzą o firmie.
- Przenikanie. Doradcy z przeszkolonych salonów rozmawiają z kolegami z innych salonów. Jeśli grupa porównawcza też się uczy, DiD zaniża efekt.
Najczęstsze pytania
Jak zmierzyć efekt szkolenia pracowników bez grupy kontrolnej?
Bez grupy porównawczej opiszesz tylko zmianę, nie efekt: porównanie „przed i po” miesza szkolenie z sezonem, sytuacją na rynku i regresją do średniej. W przykładzie dało 3.87 auta przy prawdziwym efekcie 2. Szukaj jednostek bez szkolenia (salonów, oddziałów, zespołów) z danymi z tych samych miesięcy i policz różnicę w różnicach.
Czym jest różnica w różnicach w ocenie szkolenia?
To zmiana wyniku w jednostkach przeszkolonych minus zmiana w jednostkach bez szkolenia w tym samym czasie. Druga zmiana szacuje, co stałoby się bez szkolenia. W przykładzie: 3.67 − 0.46 = 3.21 auta miesięcznie. Metoda zakłada, że bez szkolenia obie grupy zmieniałyby się równolegle; poziomy mogą się różnić.
Dlaczego wybór najlepszych oddziałów do szkolenia psuje ocenę efektu?
Najlepsze w danym kwartale są częściowo dzięki przypadkowi, a przypadkowa passa potem mija – to regresja do średniej. Jeśli ten kwartał jest punktem wyjścia, spadek po passie maskuje efekt szkolenia: w przykładzie DiD dał 0.23 zamiast 2. Pomija się okres wyboru albo – lepiej – losuje kolejność szkoleń.
Czy dopasowanie oddziałów poprawia różnicę w różnicach?
Nie zawsze. Gdy do szkolenia trafiają jednostki o wyższym poziomie wyniku, dopasowanie na wyniku sprzed szkolenia dobiera słabsze jednostki w chwilowo dobrej formie i wprowadza regresję do średniej (Daw i Hatfield, 2018). W symulacji DiD po dopasowaniu był zawyżony średnio o 1.12 auta i miał większy rozrzut niż bez dopasowania.
Dlaczego w różnicy w różnicach trzeba klastrować błędy standardowe?
Bo wyniki tej samej jednostki w kolejnych miesiącach są skorelowane, a szkolenie przydziela się całym jednostkom. W symulacji 1000 szkoleń bez efektu zwykłe błędy dawały p < .05 w 21.5% przypadków, a błędy klastrowane po salonach w 5.0%. Klastruj na poziomie przydziału interwencji.
Powiązane hasła
Przeczytaj też
Quasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikKanibalizacja nowego lokalu – DiD
Sieć pizzerii i nowy lokal: różnica w różnicach według odległości, event study, efekt nowości i bilans netto sieci – pięć rysunków z kodem R.
Czytaj →PoradnikEwaluacja szkolenia w modelu Kirkpatricka
Cztery poziomy jako cztery pomiary: narzędzie, termin, schemat i analiza, krytyka modelu oraz korelacje między poziomami – z przykładem 120 osób w R.
Czytaj →Oceniasz szkolenie lub program w firmie?
Pomożemy dobrać grupę porównawczą i okres odniesienia, policzyć różnicę w różnicach z modelem zdarzeń i błędami klastrowanymi oraz opisać wynik i jego ograniczenia tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Arthur, W., Bennett, W., Edens, P. S., & Bell, S. T. (2003). Effectiveness of training in organizations: A meta-analysis of design and evaluation features. Journal of Applied Psychology, 88(2), 234–245. https://doi.org/10.1037/0021-9010.88.2.234
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215–220. https://doi.org/10.1093/ije/dyh299 ● Otwarty dostęp
- Bertrand, M., Duflo, E., & Mullainathan, S. (2004). How much should we trust differences-in-differences estimates? The Quarterly Journal of Economics, 119(1), 249–275. https://doi.org/10.1162/003355304772839588 ● Otwarty dostęp: pełny tekst
- Cameron, A. C., & Miller, D. L. (2015). A practitioner’s guide to cluster-robust inference. Journal of Human Resources, 50(2), 317–372. https://doi.org/10.3368/jhr.50.2.317
- Daw, J. R., & Hatfield, L. A. (2018). Matching and regression to the mean in difference-in-differences analysis. Health Services Research, 53(6), 4138–4156. https://doi.org/10.1111/1475-6773.12993 ● Otwarty dostęp
- Roth, J. (2022). Pretest with caution: Event-study estimates after testing for parallel trends. American Economic Review: Insights, 4(3), 305–322. https://doi.org/10.1257/aeri.20210236
- Roth, J., Sant’Anna, P. H. C., Bilinski, A., & Poe, J. (2023). What’s trending in difference-in-differences? A synthesis of the recent econometrics literature. Journal of Econometrics, 235(2), 2218–2244. https://doi.org/10.1016/j.jeconom.2023.03.008 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{arthur2003effectiveness, author={Arthur, Winfred and Bennett, Winston and Edens, Pamela S. and Bell, Suzanne T.}, title={{Effectiveness of training in organizations: A meta-analysis of design and evaluation features}}, journal={Journal of Applied Psychology}, year={2003}, volume={88}, number={2}, pages={234--245}, doi={10.1037/0021-9010.88.2.234}}@article{barnett2005regression, author={Barnett, Adrian G. and van der Pols, Jolieke C. and Dobson, Annette J.}, title={{Regression to the mean: What it is and how to deal with it}}, journal={International Journal of Epidemiology}, year={2005}, volume={34}, number={1}, pages={215--220}, doi={10.1093/ije/dyh299}}@article{bertrand2004how, author={Bertrand, Marianne and Duflo, Esther and Mullainathan, Sendhil}, title={{How much should we trust differences-in-differences estimates?}}, journal={The Quarterly Journal of Economics}, year={2004}, volume={119}, number={1}, pages={249--275}, doi={10.1162/003355304772839588}}@article{cameron2015practitioner, author={Cameron, A. Colin and Miller, Douglas L.}, title={{A practitioner’s guide to cluster-robust inference}}, journal={Journal of Human Resources}, year={2015}, volume={50}, number={2}, pages={317--372}, doi={10.3368/jhr.50.2.317}}@article{daw2018matching, author={Daw, Jamie R. and Hatfield, Laura A.}, title={{Matching and regression to the mean in difference-in-differences analysis}}, journal={Health Services Research}, year={2018}, volume={53}, number={6}, pages={4138--4156}, doi={10.1111/1475-6773.12993}}@article{roth2022pretest, author={Roth, Jonathan}, title={{Pretest with caution: Event-study estimates after testing for parallel trends}}, journal={American Economic Review: Insights}, year={2022}, volume={4}, number={3}, pages={305--322}, doi={10.1257/aeri.20210236}}@article{roth2023whats, author={Roth, Jonathan and Sant’Anna, Pedro H. C. and Bilinski, Alyssa and Poe, John}, title={{What’s trending in difference-in-differences? A synthesis of the recent econometrics literature}}, journal={Journal of Econometrics}, year={2023}, volume={235}, number={2}, pages={2218--2244}, doi={10.1016/j.jeconom.2023.03.008}}