Przykład: sieć sklepów sportowych i kampania w regionie H
Fikcyjna sieć sklepów sportowych działa w 16 regionach, oznaczonych literami od A do P. Od 53. tygodnia przez 10 tygodni prowadzi kampanię (billboardy, radio, reklama lokalna) tylko w regionie H. Zarząd pyta: ile dodatkowej sprzedaży dała kampania i czy się zwróciła?
Mamy tygodniową sprzedaż w każdym regionie, przeliczoną na 100 tys. mieszkańców (tys. zł), żeby duże i małe regiony dało się porównać. Jest 52 tygodnie przed kampanią i 10 tygodni kampanii. Region nie był wylosowany, więc nie jest to test A/B, tylko schemat quasi-eksperymentalny z jedną jednostką „leczoną”. Do takich sytuacji służy metoda syntetycznej kontroli (Abadie i Gardeazabal, 2003; Abadie i in., 2010).
Dane są fikcyjne i znamy prawdę. Ręcznie ustaliliśmy dla każdego regionu poziom sprzedaży, siłę sezonu, tempo wzrostu i wrażliwość na wspólne wahania (pogoda, terminy wypłat). Region H zbudowaliśmy jako mieszankę regionów C (.45), F (.30) i M (.25), więc da się go odtworzyć z innych regionów. Rośnie przy tym szybciej niż przeciętny region. Prawdziwy efekt kampanii narasta od 1.57 do 3.97 tys. zł tygodniowo, średnio 3.39. Ręcznie ustaliliśmy też liczbę mieszkańców H (1.8 mln), koszt kampanii (400 tys. zł) i marżę (35%). Ziarno 616 ustalono raz i nie zmieniano go. Dane pobierzesz jako kampania-region-sprzedaz-tygodniowa.csv.
Najprostsze porównanie myli najbardziej. W 10 tygodniach przed kampanią region H sprzedawał średnio 36.98, a w 10 tygodniach kampanii 50.66. Różnica 13.68 jest cztery razy większa od prawdziwego efektu, bo kampania wypadła w czasie wiosennego wzrostu sprzedaży, czyli sezonowości. Potrzebujemy odpowiedzi na pytanie kontrfaktyczne: ile sprzedałby region H w tych samych tygodniach bez kampanii (model potencjalnych wyników)?
Rysunek 1: metoda w sześciu krokach
Pomysł jest prosty. Region H porównujemy nie z jednym regionem i nie ze średnią wszystkich, tylko z „bliźniakiem” złożonym z kilku regionów bez kampanii. Udziały regionów w bliźniaku (wagi) dobieramy tak, by przed kampanią sprzedaż bliźniaka szła krok w krok ze sprzedażą H.
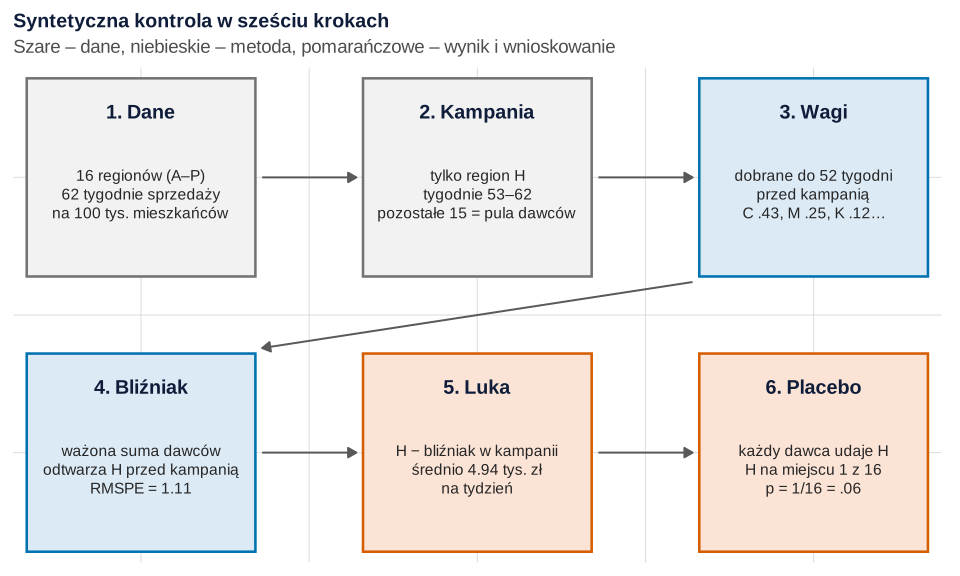
set.seed(616)).Co widać. Kroki 1–2 to dane, 3–4 – budowa bliźniaka, 5–6 – wynik i jego sprawdzenie. Bliźniak to średnia ważona:
Y to sprzedaż regionu w tygodniu t, a w – waga regionu. Wagi szukamy tak, by błąd przed kampanią był najmniejszy. Mierzy go RMSPE, czyli pierwiastek ze średniego kwadratu różnicy H − bliźniak (to samo co RMSE z hasła o miarach błędu prognozy). Pakiet Synth nie jest potrzebny. Wagi liczy funkcja optim, a warunki „nieujemne i suma 1” zapewnia przekształcenie softmax: wj = exp(aj) / Σ exp(ak).
Jak może zmylić. Schemat wygląda jak przepis, który zawsze działa. Tak nie jest. Abadie (2021) opisuje warunki, w których metoda daje wiarygodne oszacowania, i sytuacje, w których zawodzi. Najważniejsze z nich sprawdzamy na kolejnych rysunkach.
Podpis do pracy:
Rysunek 2: region H i jego syntetyczny bliźniak
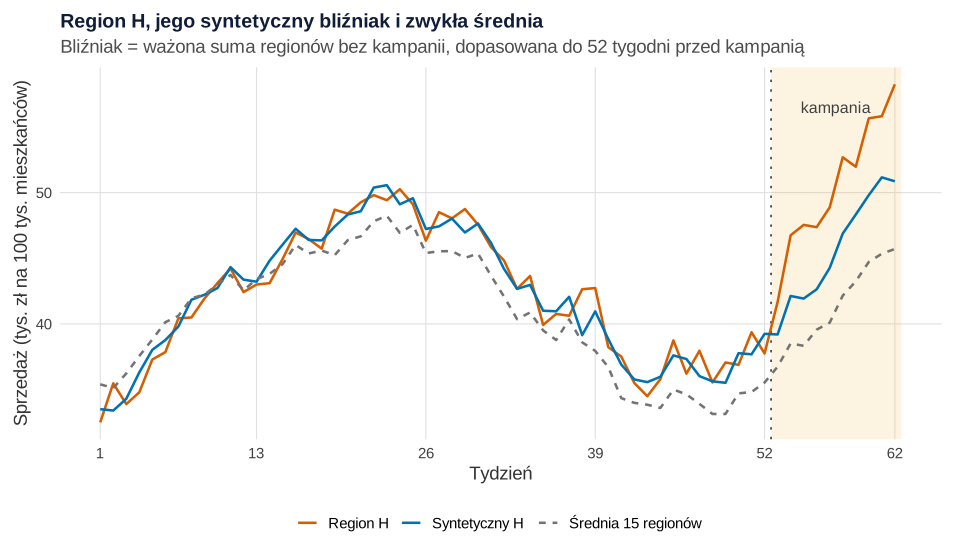
set.seed(616)).Co widać. Przed kampanią bliźniak (niebieski) idzie razem z regionem H (pomarańczowy): RMSPE = 1.11 tys. zł. Zwykła średnia 15 regionów myli się ponad dwa razy bardziej (RMSPE = 2.34). Region H rośnie szybciej: w pierwszych 13 tygodniach był średnio 1.03 poniżej średniej regionów, a w tygodniach 40–52 już 2.59 powyżej. W okresie kampanii H sprzedaje średnio 50.66, a bliźniak 45.72. Ta różnica, czyli luka, wynosi średnio 4.94 tys. zł tygodniowo (+10.8%).
Sprawdzian „na sucho”. Wagi policzyliśmy jeszcze raz tylko z tygodni 1–44. Bliźniak przewidział tygodnie 45–52, kiedy kampanii jeszcze nie było, ze średnią luką 0.39 i RMSPE = 1.41. Taki test na okresie bez interwencji warto pokazać w pracy: jeśli bliźniak już wtedy się rozjeżdża, nie ufaj mu po kampanii.
Jak może zmylić. Prawdziwy efekt wynosił średnio 3.39, a luka 4.94. Jedna realizacja danych ma swój błąd: tygodniowy szum regionów przenosi się na bliźniaka. Ile wynosi ten błąd przeciętnie, pokazuje symulacja na rysunku 5. Wykres nie pokazuje też niepewności wag. Dobre dopasowanie przed kampanią jest warunkiem koniecznym, ale nie dowodem, że po kampanii bliźniak dalej odtwarza H.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 3: z czego zbudowany jest bliźniak
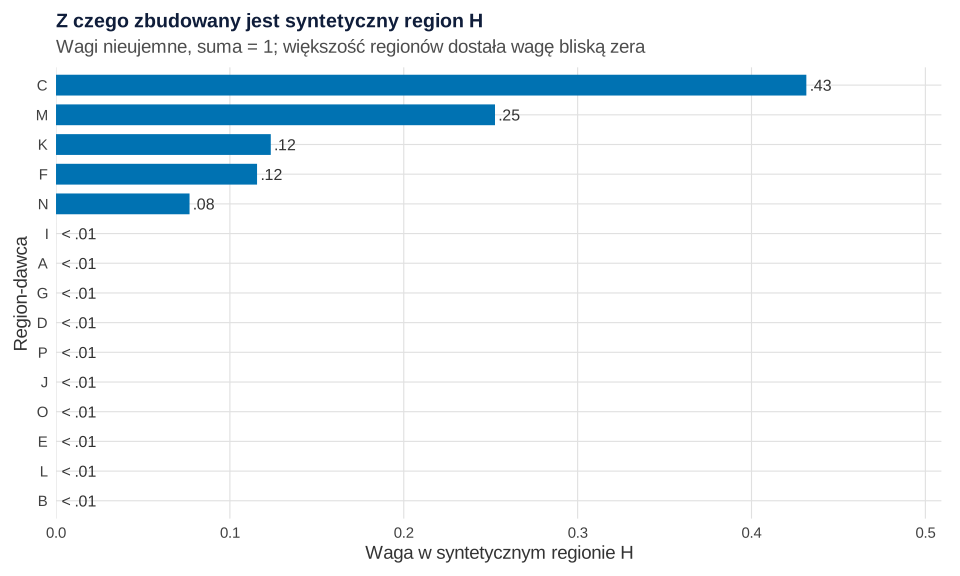
optim (pakiet stats) i pakiet ggplot2 (dane fikcyjne, set.seed(616)).Co widać. Bliźniak to w 43% region C, w 25% region M, a resztę dają K, F i N. Dziesięć regionów ma wagi poniżej .01. Wagi są nieujemne i sumują się do 1, więc bliźniak nie wychodzi poza zakres danych regionów i od razu wiadomo, z czego się składa. Abadie i in. (2015) podkreślają, że metoda daje systematyczny sposób wyboru jednostek porównawczych i pozwala na wnioskowanie ilościowe nawet przy niewielu porównywanych jednostkach. W danych schowaliśmy C, F i M. Metoda trafiła C (.43 przy prawdziwych .45) i M (.25 przy .25), ale część wagi F (.30) przeniosła na K i N.
Jak może zmylić. Wagi to nie podobieństwo regionów „w ogóle”, tylko najlepsze dopasowanie przebiegu sprzedaży. Region z wagą zero może być bardzo podobny do H, tylko jego wkład dublują inne. Przy wielu dawcach i krótkim okresie przed interwencją łatwo o przeuczenie: wagi dopasowują szum. Dlatego sprawdzian „na sucho” z rysunku 2 jest tak przydatny.
Podpis do pracy:
Zdanie do Metody:
Rysunek 4: testy placebo
Czy luka 4.94 to dużo? Przy jednym regionie z kampanią nie ma zwykłego błędu standardowego. Abadie i in. (2010) zaproponowali w zamian testy placebo. Każdy z 15 regionów po kolei udaje, że to on miał kampanię. Budujemy mu bliźniaka z 14 pozostałych (bez H) i liczymy jego lukę. Potem porównujemy iloraz błędu po kampanii i przed nią. Duża luka przy dobrym dopasowaniu przed kampanią daje duży iloraz.
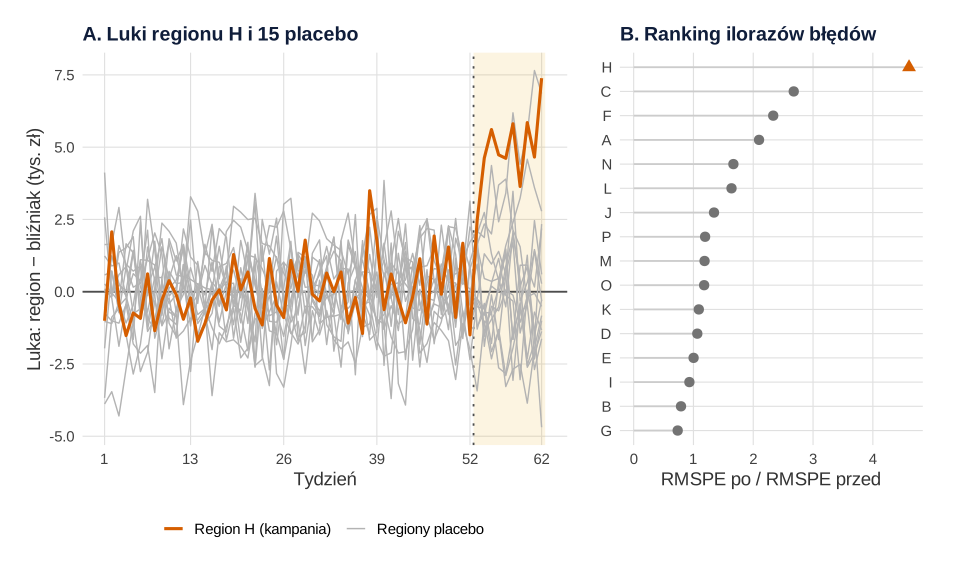
set.seed(616)).Co widać. Iloraz dla H wynosi 4.61 i jest najwyższy z 16. Następne są C (2.68) i F (2.33). Gdyby kampania nic nie dała, H mógłby z równym prawdopodobieństwem zająć każde z 16 miejsc. Szansa na pierwsze to 1/16, więc p = 1/16 ≈ .06. To logika testu permutacyjnego.
Jak może zmylić. Przy 16 regionach p nie może spaść poniżej .06, nawet przy ogromnym efekcie. Nie pisz więc „efekt nieistotny”, tylko podaj miejsce w rankingu. Druga pułapka to region C. Jego średnia luka placebo to 4.48, prawie tyle co H. C rośnie najszybciej ze wszystkich regionów, więc żadna średnia ważona innych go nie dogoni. To wada dopasowania, nie efekt. Region H, który leży „pośrodku” innych regionów, takiego problemu nie ma.
Podpis do pracy:
Zdanie do Wyników:
Rysunek 5: syntetyczna kontrola a różnica w różnicach
Najczęstsza alternatywa to różnica w różnicach (DiD). Bierze zmianę w H i odejmuje zmianę średniej 15 regionów, czyli daje wszystkim regionom równe wagi i zakłada równoległe trendy. Porównaliśmy trzy metody na naszych danych i na 300 nowych zbiorach danych z tymi samymi parametrami.
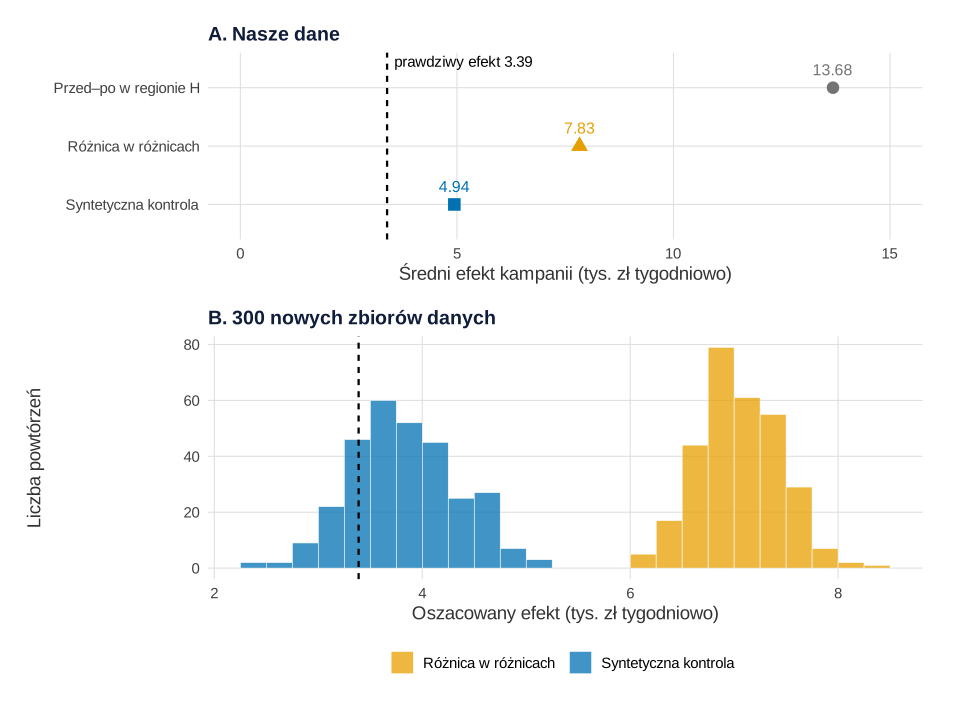
set.seed(616)).Co widać. W naszych danych DiD daje 7.83, czyli ponad dwa razy więcej niż prawda (3.39). Ta sama wartość wychodzi z regresji z efektami stałymi regionu i tygodnia. Powód widać na rysunku 2: H rósł szybciej niż średnia, więc trendy nie były równoległe i DiD przypisał kampanii także własny wzrost regionu. W 300 nowych zbiorach DiD dawał średnio 7.05 (obciążenie 3.66, błąd MC 0.02), a syntetyczna kontrola 3.83 (obciążenie 0.44, błąd MC 0.03; SD 0.51). Syntetyczna kontrola była bliżej prawdy w 100% powtórzeń. Porównanie „przed–po” myliło się średnio o 6.34.
Jak może zmylić. To wynik dla danych, w których H da się złożyć z innych regionów. Gdy trendy są naprawdę równoległe, DiD działa dobrze i jest prostszy. Syntetyczna kontrola też ma małe obciążenie (0.44), bo bliźniak dopasowuje się trochę do szumu. Łączenie obu podejść proponują Arkhangelsky i in. (2021): ich syntetyczna różnica w różnicach miała w badaniach teoretycznych i empirycznych lepszą odporność niż każda z metod osobno. Zasady projektowania DiD opisują Wing i in. (2018). Gdy porównania nie ma wcale, zostaje przerwany szereg czasowy (zob. też regresja segmentowa i przerwany szereg czasowy).
Podpis do pracy:
Zdanie do Metody:
Co z tym zrobić w marketingu
- Policz pieniądze, nie tylko procenty. Luka 4.94 tys. zł tygodniowo na 100 tys. mieszkańców to w regionie H (1.8 mln mieszkańców) 889 tys. zł dodatkowej sprzedaży w 10 tygodni. Przy marży 35% daje to 311 tys. zł wobec 400 tys. zł kosztu. Kampania podniosła sprzedaż, ale w tym okresie się nie zwróciła. Prawdziwy efekt był mniejszy, więc wniosek tym bardziej się utrzymuje.
- Zaplanuj wybór regionu przed kampanią. Jeśli możesz, wylosuj regiony z kampanią i bez niej. To losowanie całych grup, opisane we wpisie randomizacja klastrowa. Syntetyczna kontrola to plan B, gdy region wybrał zarząd.
- Chroń pulę dawców. Nie zmieniaj w tym czasie cen ani promocji w regionach C, M, K, F i N. Każda zmiana u dawcy psuje bliźniaka.
- Mierz dłużej niż kampanię. Dodaj kilka tygodni po jej końcu, żeby zobaczyć, czy sprzedaż wraca do bliźniaka, czy efekt trwa.
- Porównaj z innymi źródłami. Długookresowy udział kanałów szacuje marketing mix modeling, podział konwersji na kanały – atrybucja łańcuchem Markowa, a zmianę świadomości marki – badanie brand lift.
Inne tematy do pracy z marketingu zbiera wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Metodzie opisz pulę dawców i powód wykluczeń, okres dopasowania, sposób doboru wag i wnioskowanie. W Wynikach podaj wagi, dopasowanie przed interwencją, lukę i miejsce w teście placebo. W Dyskusji nazwij zagrożenia trafności wewnętrznej: inne zdarzenia w regionie H w tym samym czasie i przenikanie kampanii do sąsiednich regionów.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy dane, paletę i motyw, przepis 2 – funkcję wagi_sc() i bliźniaka, przepis 3 – tabelę placebo używaną na grafice z przepisu 5. Przepisy 2–5 kończą się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Wagi liczy bazowe R (optim), bez pakietu Synth. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują tylko przepisy 1 i 4; każdy zaczyna od własnego set.seed(616). Ziarno 616 ustalono raz i nie zmieniano go. Ręcznie ustalono: poziom sprzedaży, siłę sezonu, tempo wzrostu i wrażliwość na wspólne wahania każdego regionu, skład regionu H (C .45, F .30, M .25), kształt efektu kampanii (narasta do ok. 4 tys. zł), szum tygodniowy (SD = 1) i wspólne wahania (AR(1), φ = 0.8) (przepis 1); okres sprawdzianu (tygodnie 45–52), liczbę mieszkańców H (1.8 mln), koszt kampanii (400 tys. zł) i marżę 35% (przepis 2); 300 powtórzeń (przepis 4). Przepis 1 zapisuje dane do pliku CSV w katalogu roboczym. Cały kod liczy się w około pół minuty, głównie przez symulację w przepisie 4.
1. Dane: 16 regionów, 62 tygodnie, prawdziwy efekt
R
# Przepis 1. Fikcyjna sieć sklepów sportowych: tygodniowa sprzedaż w 16 regionach (A–P), kampania w regionie H
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("Region H" = "#D55E00", "Syntetyczny H" = "#0072B2", "Średnia 15 regionów" = "grey45")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry regionów ustalono ręcznie: poziom sprzedaży, siła sezonu, tempo wzrostu i wrażliwość na wspólne
# wahania (pogoda, wypłaty). Region H ma parametry będące mieszanką regionów C, F i M – dlatego da się go
# odtworzyć z innych regionów – i rośnie szybciej niż przeciętny region.
regiony <- LETTERS[1:16]
poziom  <- c(38, 44, 41, 35, 47, 36, 42, 0, 39, 45, 33, 40, 37, 46, 43, 34)
sezon   <- c(0.8, 1.2, 1.3, 0.7, 1.0, 0.9, 1.1, 0, 0.6, 1.4, 0.9, 1.0, 1.2, 0.8, 1.1, 1.0)
wzrost  <- c(0.2, 0.5, 2.6, -0.3, 0.4, 1.8, 0.0, 0, 0.6, 0.3, -0.2, 0.1, 2.2, 0.7, 0.4, -0.1)
wspolny <- c(0.9, 1.1, 1.2, 0.7, 1.0, 1.4, 0.8, 0, 1.3, 0.6, 1.0, 0.9, 0.8, 1.2, 1.1, 0.7)
w_prawdziwe <- c(C = 0.45, F = 0.30, M = 0.25)           # z jakich regionów „zbudowano” region H
for (v in c("poziom", "sezon", "wzrost", "wspolny")) {
  x <- get(v); x[8] <- sum(w_prawdziwe * x[match(names(w_prawdziwe), regiony)]); assign(v, x)
}

tyg <- 1:62                                              # 52 tygodnie przed kampanią + 10 tygodni kampanii
kampania <- tyg >= 53
efekt_prawdziwy <- ifelse(kampania, 4 * (1 - exp(-(tyg - 52) / 2)), 0)   # efekt narasta do ok. 4 tys. zł

set.seed(616)                                            # ziarno ustalone raz, bez dobierania pod wynik
wahania <- as.numeric(arima.sim(list(ar = 0.8), n = 62, sd = 0.8))      # wspólne tygodniowe wahania
sprzedaz <- data.frame(region = rep(regiony, each = 62), tydzien = rep(tyg, 16))
sprzedaz$y <- with(sprzedaz, {
  i <- match(region, regiony)
  poziom[i] + sezon[i] * 6 * sin(2 * pi * (tydzien - 8) / 52) + wzrost[i] * 4 * tydzien / 52 +
    wspolny[i] * wahania[tydzien] + rnorm(length(i), 0, 1.0)
})
sprzedaz$y <- round(sprzedaz$y + ifelse(sprzedaz$region == "H", efekt_prawdziwy[sprzedaz$tydzien], 0), 2)
sprzedaz$kampania <- as.integer(sprzedaz$region == "H" & sprzedaz$tydzien >= 53)
write.csv(sprzedaz, "kampania-region-sprzedaz-tygodniowa.csv", row.names = FALSE)

# Macierz: wiersze = tygodnie, kolumny = regiony
Y <- matrix(sprzedaz$y, nrow = 62, dimnames = list(NULL, regiony))
przed <- 1:52; po <- 53:62
cat("Średnia sprzedaż przed kampanią (tys. zł tygodniowo na 100 tys. mieszkańców):\n")
print(round(colMeans(Y[przed, ]), 1))
cat("\nPrawdziwy efekt kampanii w tygodniach 53–62:", round(efekt_prawdziwy[po], 2), "\n")
cat("Średni prawdziwy efekt:", round(mean(efekt_prawdziwy[po]), 2), "\n")
cat("Region H: średnia w 10 ostatnich tygodniach przed kampanią", round(mean(Y[43:52, "H"]), 2),
    "i w 10 tygodniach kampanii", round(mean(Y[po, "H"]), 2), "\n")
Wynik w R
Średnia sprzedaż przed kampanią (tys. zł tygodniowo na 100 tys. mieszkańców):
   A    B    C    D    E    F    G    H    I    J    K    L    M    N    O    P
38.2 44.6 45.5 33.5 47.3 38.5 41.2 42.0 39.1 45.2 32.0 39.8 41.1 46.5 43.0 33.5

Prawdziwy efekt kampanii w tygodniach 53–62: 1.57 2.53 3.11 3.46 3.67 3.8 3.88 3.93 3.96 3.97
Średni prawdziwy efekt: 3.39
Region H: średnia w 10 ostatnich tygodniach przed kampanią 36.98 i w 10 tygodniach kampanii 50.66
2. Wagi, bliźniak i luka: Rysunki 2 i 3
R
# Przepis 2. Wagi syntetycznego regionu H (optim + softmax), dopasowanie przed kampanią, luka po kampanii
# (korzysta z Y, przed, po, kol i motyw z przepisu 1)
library(ggplot2)

# Wagi nieujemne i sumujące się do 1: w = exp(a) / sum(exp(a)); szukamy a minimalizującego błąd przed kampanią
wagi_sc <- function(y1, Y0) {
  blad <- function(a) { w <- exp(a - max(a)) / sum(exp(a - max(a))); sqrt(mean((y1 - Y0 %*% w)^2)) }
  f <- optim(rep(0, ncol(Y0)), blad, method = "BFGS",            # start: równe wagi; bez losowania
             control = list(maxit = 2000, reltol = 1e-12))
  w <- exp(f$par - max(f$par)); w <- w / sum(w); names(w) <- colnames(Y0); w
}
rmspe <- function(e) sqrt(mean(e^2))

dawcy <- setdiff(colnames(Y), "H")
w <- wagi_sc(Y[przed, "H"], Y[przed, dawcy])
cat("Wagi regionów-dawców (posortowane):\n"); print(round(sort(w, decreasing = TRUE), 3))
cat("Regiony z wagą ≥ .01:", sum(w >= 0.01), " suma wag:", round(sum(w), 3), "\n")

synt <- as.numeric(Y[, dawcy] %*% w)                     # syntetyczny region H we wszystkich 62 tygodniach
srednia <- rowMeans(Y[, dawcy])                          # zwykła średnia 15 regionów (równe wagi)
luka <- Y[, "H"] - synt
cat("\nRMSPE przed kampanią: syntetyczny H", round(rmspe(luka[przed]), 2),
    "| średnia 15 regionów", round(rmspe(Y[przed, "H"] - srednia[przed]), 2), "\n")
cat("Średnia luka w 10 tygodniach kampanii:", round(mean(luka[po]), 2), "tys. zł tygodniowo na 100 tys. mieszkańców\n")
cat("Luka tydzień po tygodniu:", round(luka[po], 2), "\n")
cat("Średnio region H vs bliźniak w kampanii:", round(mean(Y[po, "H"]), 2), "vs", round(mean(synt[po]), 2),
    "→ wzrost o", round(100 * mean(luka[po]) / mean(synt[po]), 1), "%\n")

# Sprawdzian „na sucho”: wagi tylko z tygodni 1–44, a tygodnie 45–52 (jeszcze bez kampanii) jako test
w44 <- wagi_sc(Y[1:44, "H"], Y[1:44, dawcy])
luka44 <- Y[45:52, "H"] - Y[45:52, dawcy] %*% w44
cat("\nWagi z tygodni 1–44 ≥ .01:"); print(round(sort(w44[w44 >= 0.01], decreasing = TRUE), 3))
cat("Tygodnie 45–52 (bez kampanii): średnia luka", round(mean(luka44), 2), " RMSPE", round(rmspe(luka44), 2), "\n")

# Wydatek i przychód z kampanii (ręczne parametry: 1.8 mln mieszkańców, koszt 400 tys. zł, marża 35%)
dodatkowa <- sum(luka[po]) * 18                          # tys. zł w regionie H (18 × 100 tys. mieszkańców)
cat("\nDodatkowa sprzedaż w 10 tygodniach:", round(dodatkowa), "tys. zł; marża 35%:", round(0.35 * dodatkowa),
    "tys. zł wobec kosztu 400 tys. zł\n")

trajektorie <- rbind(data.frame(tydzien = 1:62, y = Y[, "H"], seria = "Region H"),
                     data.frame(tydzien = 1:62, y = synt, seria = "Syntetyczny H"),
                     data.frame(tydzien = 1:62, y = srednia, seria = "Średnia 15 regionów"))
trajektorie$seria <- factor(trajektorie$seria, names(kol))
p2 <- ggplot(trajektorie, aes(tydzien, y, colour = seria, linetype = seria)) +
  annotate("rect", xmin = 52.5, xmax = 62.5, ymin = -Inf, ymax = Inf, fill = "#E69F00", alpha = 0.12) +
  annotate("text", x = 57.5, y = 56.5, label = "kampania", colour = "grey25", size = 4.2) +
  geom_vline(xintercept = 52.5, linetype = "dotted", colour = "grey30") +
  geom_line(linewidth = 0.9) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("solid", "solid", "22"), name = NULL) +
  scale_x_continuous(breaks = c(1, 13, 26, 39, 52, 62)) +
  labs(x = "Tydzień", y = "Sprzedaż (tys. zł na 100 tys. mieszkańców)",
       title = "Region H, jego syntetyczny bliźniak i zwykła średnia",
       subtitle = "Bliźniak = ważona suma regionów bez kampanii, dopasowana do 52 tygodni przed kampanią") + motyw
p2   # zapis: ggsave("kampania-region-trajektorie.svg", p2, width = 10, height = 5.8)

wagi_df <- data.frame(region = names(w), waga = as.numeric(w))
wagi_df$region <- factor(wagi_df$region, wagi_df$region[order(wagi_df$waga)])
wagi_df$etykieta <- ifelse(wagi_df$waga >= 0.01, sub("^0\\.", ".", sprintf("%.2f", wagi_df$waga)), "< .01")
p3 <- ggplot(wagi_df, aes(waga, region)) +
  geom_col(aes(fill = waga >= 0.01), width = 0.7) +
  geom_text(aes(label = etykieta), hjust = -0.15, size = 4.2, colour = "grey20") +
  scale_fill_manual(values = c(`TRUE` = "#0072B2", `FALSE` = "grey75"), guide = "none") +
  scale_x_continuous(limits = c(0, max(w) * 1.18), expand = c(0, 0)) +
  labs(x = "Waga w syntetycznym regionie H", y = "Region-dawca",
       title = "Z czego zbudowany jest syntetyczny region H",
       subtitle = "Wagi nieujemne, suma = 1; większość regionów dostała wagę bliską zera") + motyw
p3   # zapis: ggsave("kampania-region-wagi.svg", p3, width = 10, height = 6)
Wynik w R
Wagi regionów-dawców (posortowane):
    C     M     K     F     N     I     A     G     D     P     J     O     E
0.432 0.252 0.124 0.116 0.077 0.000 0.000 0.000 0.000 0.000 0.000 0.000 0.000
    L     B
0.000 0.000
Regiony z wagą ≥ .01: 5  suma wag: 1

RMSPE przed kampanią: syntetyczny H 1.11 | średnia 15 regionów 2.34
Średnia luka w 10 tygodniach kampanii: 4.94 tys. zł tygodniowo na 100 tys. mieszkańców
Luka tydzień po tygodniu: 2.47 4.62 5.61 4.74 4.61 5.81 3.64 5.85 4.66 7.39
Średnio region H vs bliźniak w kampanii: 50.66 vs 45.72 → wzrost o 10.8 %

Wagi z tygodni 1–44 ≥ .01:    C     M     K     N     F
0.403 0.334 0.140 0.081 0.042
Tygodnie 45–52 (bez kampanii): średnia luka 0.39  RMSPE 1.41

Dodatkowa sprzedaż w 10 tygodniach: 889 tys. zł; marża 35%: 311 tys. zł wobec kosztu 400 tys. zł
3. Testy placebo: Rysunek 4
R
# Przepis 3. Testy placebo: każdy region po kolei udaje, że to on miał kampanię
# (korzysta z Y, przed, po, motyw z przepisu 1 oraz wagi_sc(), rmspe(), dawcy, luka z przepisu 2)
library(ggplot2)
library(patchwork)

placebo <- lapply(dawcy, function(j) {
  pula <- setdiff(dawcy, j)                              # region H nie wchodzi do puli – miał kampanię
  wj <- wagi_sc(Y[przed, j], Y[przed, pula])
  Y[, j] - as.numeric(Y[, pula] %*% wj)
})
names(placebo) <- dawcy
luki <- cbind(H = luka, do.call(cbind, placebo))

wsk <- data.frame(region = colnames(luki),
                  rmspe_przed = apply(luki[przed, ], 2, rmspe), rmspe_po = apply(luki[po, ], 2, rmspe),
                  luka_po = colMeans(luki[po, ]))
wsk$iloraz <- wsk$rmspe_po / wsk$rmspe_przed
wsk <- wsk[order(-wsk$iloraz), ]
wsk$miejsce <- seq_len(nrow(wsk))
print(transform(wsk, rmspe_przed = round(rmspe_przed, 2), rmspe_po = round(rmspe_po, 2),
                luka_po = round(luka_po, 2), iloraz = round(iloraz, 2)), row.names = FALSE)
cat("\nMiejsce regionu H:", wsk$miejsce[wsk$region == "H"], "na", nrow(wsk),
    " p =", wsk$miejsce[wsk$region == "H"], "/", nrow(wsk), "=",
    round(wsk$miejsce[wsk$region == "H"] / nrow(wsk), 3), "\n")
cat("Średnie luki placebo w tygodniach kampanii: od", round(min(wsk$luka_po[wsk$region != "H"]), 2),
    "do", round(max(wsk$luka_po[wsk$region != "H"]), 2), "\n")
cat("Największa luka placebo w pojedynczym tygodniu kampanii:", round(max(abs(luki[po, -1])), 2), "\n")

dl <- data.frame(tydzien = rep(1:62, ncol(luki)), luka = as.vector(luki),
                 region = rep(colnames(luki), each = 62))
dl$typ <- ifelse(dl$region == "H", "Region H (kampania)", "Regiony placebo")
pa <- ggplot(dl, aes(tydzien, luka, group = region, colour = typ, linewidth = typ)) +
  annotate("rect", xmin = 52.5, xmax = 62.5, ymin = -Inf, ymax = Inf, fill = "#E69F00", alpha = 0.12) +
  geom_hline(yintercept = 0, colour = "grey30") +
  geom_vline(xintercept = 52.5, linetype = "dotted", colour = "grey30") +
  geom_line(data = subset(dl, region != "H")) + geom_line(data = subset(dl, region == "H")) +
  scale_colour_manual(values = c("Region H (kampania)" = "#D55E00", "Regiony placebo" = "grey70"), name = NULL) +
  scale_linewidth_manual(values = c("Region H (kampania)" = 1.1, "Regiony placebo" = 0.5), name = NULL) +
  scale_x_continuous(breaks = c(1, 13, 26, 39, 52, 62)) +
  labs(x = "Tydzień", y = "Luka: region − bliźniak (tys. zł)", title = "A. Luki regionu H i 15 placebo") + motyw
wsk$region <- factor(wsk$region, rev(wsk$region))
pb <- ggplot(wsk, aes(iloraz, region)) +
  geom_segment(aes(x = 0, xend = iloraz, yend = region), colour = "grey80") +
  geom_point(aes(colour = region == "H", shape = region == "H"), size = 3.2) +
  scale_colour_manual(values = c(`TRUE` = "#D55E00", `FALSE` = "grey45"), guide = "none") +
  scale_shape_manual(values = c(`TRUE` = 17, `FALSE` = 16), guide = "none") +
  labs(x = "RMSPE po / RMSPE przed", y = NULL, title = "B. Ranking ilorazów błędów") + motyw
p4 <- pa + pb + plot_layout(widths = c(1.6, 1)) & theme(legend.position = "bottom")
p4   # zapis: ggsave("kampania-region-placebo.svg", p4, width = 10, height = 6)
Wynik w R
 region rmspe_przed rmspe_po luka_po iloraz miejsce
      H        1.11     5.10    4.94   4.61       1
      C        1.82     4.88    4.48   2.68       2
      F        1.16     2.72    2.47   2.33       3
      A        0.89     1.87   -0.90   2.10       4
      N        1.40     2.33    1.99   1.67       5
      L        0.94     1.54   -0.06   1.64       6
      J        1.67     2.24   -1.94   1.34       7
      P        1.12     1.33    0.05   1.19       8
      M        1.28     1.52   -1.00   1.19       9
      O        1.05     1.24    0.42   1.18      10
      K        1.90     2.07   -1.84   1.09      11
      D        1.40     1.49   -0.38   1.06      12
      E        1.64     1.65   -1.17   1.00      13
      I        1.23     1.15    0.78   0.93      14
      B        1.36     1.07   -0.27   0.79      15
      G        1.12     0.83   -0.30   0.74      16

Miejsce regionu H: 1 na 16  p = 1 / 16 = 0.062
Średnie luki placebo w tygodniach kampanii: od -1.94 do 4.48
Największa luka placebo w pojedynczym tygodniu kampanii: 7.65
4. Przed–po, DiD i syntetyczna kontrola; 300 powtórzeń: Rysunek 5
R
# Przepis 4. Syntetyczna kontrola a „przed–po” i różnica w różnicach (DiD); 300 powtórzeń danych
# (korzysta z Y, przed, po, parametrów regionów, efekt_prawdziwy, motyw z przepisu 1 oraz wagi_sc(), dawcy, luka z przepisu 2)
library(ggplot2)
library(patchwork)

szacunki <- function(Y) {
  m <- rowMeans(Y[, dawcy])
  w <- wagi_sc(Y[przed, "H"], Y[przed, dawcy])
  c(przed_po = mean(Y[po, "H"]) - mean(Y[43:52, "H"]),             # 10 tygodni kampanii vs 10 tygodni przed
    did = (mean(Y[po, "H"]) - mean(Y[przed, "H"])) - (mean(m[po]) - mean(m[przed])),
    sc = mean(Y[po, "H"] - Y[po, dawcy] %*% w))
}
jedna <- szacunki(Y)
cat("Jedna realizacja danych (prawdziwy średni efekt", round(mean(efekt_prawdziwy[po]), 2), "):\n")
print(round(jedna, 2))

# DiD jako regresja z efektami stałymi regionu i tygodnia daje to samo oszacowanie
dd <- data.frame(y = as.vector(Y), region = rep(colnames(Y), each = 62), tydzien = factor(rep(1:62, 16)))
dd$kampania <- as.integer(dd$region == "H" & as.integer(dd$tydzien) >= 53)
cat("DiD z regresji (efekty stałe regionu i tygodnia):",
    round(coef(lm(y ~ kampania + region + tydzien, data = dd))["kampania"], 2), "\n")
roznica_H_sr <- Y[, "H"] - rowMeans(Y[, dawcy])         # równoległe trendy = stała różnica przed kampanią
cat("Różnica H − średnia 15 regionów: tygodnie 1–13", round(mean(roznica_H_sr[1:13]), 2),
    "| tygodnie 40–52", round(mean(roznica_H_sr[40:52]), 2), "\n")

# 300 nowych realizacji danych z tymi samymi parametrami regionów i tym samym prawdziwym efektem
set.seed(616)
nowe_dane <- function() {
  wah <- as.numeric(arima.sim(list(ar = 0.8), n = 62, sd = 0.8))
  Yb <- sapply(1:16, function(i) poziom[i] + sezon[i] * 6 * sin(2 * pi * (1:62 - 8) / 52) +
                 wzrost[i] * 4 * (1:62) / 52 + wspolny[i] * wah + rnorm(62, 0, 1.0))
  Yb[, 8] <- Yb[, 8] + efekt_prawdziwy; colnames(Yb) <- LETTERS[1:16]; Yb
}
sym <- t(replicate(300, szacunki(nowe_dane())))
prawda <- mean(efekt_prawdziwy[po])
podsum <- data.frame(metoda = colnames(sym), srednia = colMeans(sym), obciazenie = colMeans(sym) - prawda,
                     sd = apply(sym, 2, sd), blad_mc = apply(sym, 2, sd) / sqrt(300),
                     rmse = sqrt(colMeans((sym - prawda)^2)))
print(transform(podsum, srednia = round(srednia, 2), obciazenie = round(obciazenie, 2), sd = round(sd, 2),
                blad_mc = round(blad_mc, 3), rmse = round(rmse, 2)), row.names = FALSE)
cat("Odsetek powtórzeń, w których SC jest bliżej prawdy niż DiD:",
    round(100 * mean(abs(sym[, "sc"] - prawda) < abs(sym[, "did"] - prawda)), 1), "%\n")

nazwy <- c(przed_po = "Przed–po w regionie H", did = "Różnica w różnicach", sc = "Syntetyczna kontrola")
kol_m <- c("Przed–po w regionie H" = "grey45", "Różnica w różnicach" = "#E69F00", "Syntetyczna kontrola" = "#0072B2")
ja <- data.frame(metoda = factor(nazwy[names(jedna)], rev(nazwy)), szac = jedna)
pa <- ggplot(ja, aes(szac, metoda, colour = metoda, shape = metoda)) +
  geom_point(size = 4) + geom_text(aes(label = sprintf("%.2f", szac)), vjust = -1.1, size = 4.2, show.legend = FALSE) +
  geom_vline(xintercept = prawda, linetype = "22", colour = "black", linewidth = 0.8) +
  annotate("text", x = prawda, y = 3.45, label = sprintf("prawdziwy efekt %.2f", prawda), hjust = -0.05, colour = "black", size = 4) +
  scale_colour_manual(values = kol_m, guide = "none") + scale_shape_manual(values = c(15, 17, 16), guide = "none") +
  scale_x_continuous(limits = c(0, 15)) +
  labs(x = "Średni efekt kampanii (tys. zł tygodniowo)", y = NULL, title = "A. Nasze dane") + motyw
sl <- data.frame(metoda = factor(rep(nazwy[c("did", "sc")], each = 300), nazwy[c("did", "sc")]),
                 szac = c(sym[, "did"], sym[, "sc"]))
pb <- ggplot(sl, aes(szac, fill = metoda)) +
  geom_histogram(binwidth = 0.25, boundary = 0, alpha = 0.75, position = "identity", colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = prawda, linetype = "22", colour = "black", linewidth = 0.8) +
  scale_fill_manual(values = kol_m[c("Różnica w różnicach", "Syntetyczna kontrola")], name = NULL) +
  labs(x = "Oszacowany efekt (tys. zł tygodniowo)", y = "Liczba powtórzeń", title = "B. 300 nowych zbiorów danych") +
  motyw
p5 <- pa / pb + plot_layout(heights = c(1, 1.3))
p5   # zapis: ggsave("kampania-region-did-a-sc.svg", p5, width = 10, height = 7.4)
Wynik w R
Jedna realizacja danych (prawdziwy średni efekt 3.39 ):
przed_po      did       sc
   13.68     7.83     4.94
DiD z regresji (efekty stałe regionu i tygodnia): 7.83
Różnica H − średnia 15 regionów: tygodnie 1–13 -1.03 | tygodnie 40–52 2.59
   metoda srednia obciazenie   sd blad_mc rmse
 przed_po    9.73       6.34 1.40   0.081 6.49
      did    7.05       3.66 0.39   0.022 3.68
       sc    3.83       0.44 0.51   0.030 0.67
Odsetek powtórzeń, w których SC jest bliżej prawdy niż DiD: 100 %
5. Grafika „sześć kroków”: Rysunek 1
R
# Przepis 5. Grafika: syntetyczna kontrola w sześciu krokach (prostokąty i tekst w ggplot2)
# (korzysta z w, luka, wsk, przed, po, rmspe() z przepisów 2–3)
library(ggplot2)

f2 <- function(x) sprintf("%.2f", x)
bz <- function(x) sub("^0\\.", ".", sprintf("%.2f", x))
top <- sort(w[w >= 0.01], decreasing = TRUE)
miejsce_H <- wsk$miejsce[wsk$region == "H"]
karty <- data.frame(
  x = c(1, 2, 3, 1, 2, 3), y = c(2, 2, 2, 1, 1, 1),
  tytul = c("1. Dane", "2. Kampania", "3. Wagi", "4. Bliźniak", "5. Luka", "6. Placebo"),
  tekst = c("16 regionów (A–P)\n62 tygodnie sprzedaży\nna 100 tys. mieszkańców",
            "tylko region H\ntygodnie 53–62\npozostałe 15 = pula dawców",
            paste0("dobrane do 52 tygodni\nprzed kampanią\n",
                   paste(paste(names(top)[1:3], bz(top[1:3])), collapse = ", "), "…"),
            paste0("ważona suma dawców\nodtwarza H przed kampanią\nRMSPE = ", f2(rmspe(luka[przed]))),
            paste0("H − bliźniak w kampanii\nśrednio ", f2(mean(luka[po])), " tys. zł\nna tydzień"),
            paste0("każdy dawca udaje H\nH na miejscu ", miejsce_H, " z ", nrow(wsk), "\np = ",
                   miejsce_H, "/", nrow(wsk), " = ", bz(miejsce_H / nrow(wsk)))),
  rola = c("dane", "dane", "metoda", "metoda", "wynik", "wynik"))
wypelnienie <- c(dane = "#F2F2F2", metoda = "#DCEAF5", wynik = "#FBE3D6")
ramka <- c(dane = "grey45", metoda = "#0072B2", wynik = "#D55E00")
strzalki <- data.frame(x = c(1.36, 2.36, 2.64, 1.36), xend = c(1.64, 2.64, 1.36, 1.64),
                       y = c(2, 2, 1.62, 1), yend = c(2, 2, 1.38, 1))
strzalki <- rbind(strzalki, data.frame(x = 2.36, xend = 2.64, y = 1, yend = 1))
p1 <- ggplot(karty) +
  geom_rect(aes(xmin = x - 0.34, xmax = x + 0.34, ymin = y - 0.36, ymax = y + 0.36, fill = rola, colour = rola),
            linewidth = 0.9) +
  geom_text(aes(x = x, y = y + 0.24, label = tytul), fontface = "bold", size = 5.2, colour = "#0f1d3a") +
  geom_text(aes(x = x, y = y - 0.06, label = tekst), size = 4.1, colour = "grey15", lineheight = 1.0) +
  geom_segment(data = strzalki, aes(x = x, xend = xend, y = y, yend = yend),
               arrow = arrow(length = unit(0.25, "cm"), type = "closed"), colour = "grey35", linewidth = 0.7) +
  scale_fill_manual(values = wypelnienie, guide = "none") + scale_colour_manual(values = ramka, guide = "none") +
  coord_cartesian(xlim = c(0.62, 3.38), ylim = c(0.6, 2.4), expand = FALSE) +
  labs(title = "Syntetyczna kontrola w sześciu krokach",
       subtitle = "Szare – dane, niebieskie – metoda, pomarańczowe – wynik i wnioskowanie") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid = element_blank())
p1   # zapis: ggsave("kampania-region-schemat.svg", p1, width = 10, height = 6)
6. Sprawdzenie palety (deuteranopia i protanopia)
R
# Przepis 6. Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("Region H – Syntetyczny H" = c("#D55E00", "#0072B2"), "Region H – średnia" = c("#D55E00", "grey45"),
             "Syntetyczny H – średnia" = c("#0072B2", "grey45"), "DiD – syntetyczna kontrola" = c("#E69F00", "#0072B2"),
             "Region H – placebo" = c("#D55E00", "grey70"), "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  k <- rgb(t(col2rgb(k)), maxColorValue = 255)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(rgb(t(col2rgb(k)), maxColorValue = 255))),
                                   protanopia = roznica(protan(rgb(t(col2rgb(k)), maxColorValue = 255)))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
Region H – Syntetyczny H                   114.6        108.3       91.9
Region H – średnia                          76.9         63.4       53.8
Syntetyczny H – średnia                     41.5         45.1       38.2
DiD – syntetyczna kontrola                 120.2        121.5      109.3
Region H – placebo                          78.9         64.4       59.5
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, optymalizacja wag (optim()) i regresja DiD (lm()) – pakiet stats wbudowany w R. Rysunki wykonano w pakiecie ggplot2, panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Złe dopasowanie przed kampanią. Jeśli bliźniak nie odtwarza przeszłości, nie ufaj mu po kampanii. Podaj RMSPE i pokaż rysunek 2, a nie samą lukę.
- Region „na krawędzi”. Regionu, który rośnie najszybciej albo sprzedaje najwięcej, nie złoży żadna średnia ważona innych (jak placebo regionu C). Wtedy metoda daje obciążony wynik.
- Skażeni dawcy. Klienci z sąsiedniego regionu słyszą to samo radio. Jeśli kampania podnosi sprzedaż u dawcy, bliźniak rośnie i efekt maleje. Wyklucz regiony sąsiednie albo sprawdź wynik bez nich.
- Szukanie ładnego wyniku. Pulę dawców, okres dopasowania i miarę wyniku ustal przed analizą. Zmienianie ich, aż luka urośnie, to ukryte wielokrotne porównania.
- Za mało regionów. Przy 16 regionach najmniejsze możliwe p to .06. Gdy regionów jest kilka, testy placebo prawie nic nie mówią – rozważ grupę kontrolną z losowania.
- Luka to nie cały zysk. Kampania mogła tylko przesunąć zakupy w czasie. Sprawdź tygodnie po jej końcu.
Najczęstsze pytania
Kiedy stosować metodę syntetycznej kontroli w marketingu?
Gdy kampanię, zmianę ceny albo otwarcie sklepu wprowadzono w jednym lub kilku regionach, nie losowo, a masz dla wielu regionów długi szereg wyniku sprzed zmiany. W przykładzie było 15 regionów bez kampanii i 52 tygodnie przed nią. Jeśli możesz losować regiony, lepszy jest eksperyment z losowaniem całych regionów.
Jak policzyć wagi syntetycznej kontroli bez pakietu Synth?
W bazowym R funkcją optim: wagi zapisz jako softmax parametrów (w = exp(a) / Σ exp(a)), żeby były nieujemne i sumowały się do 1, i minimalizuj RMSPE w okresie przed interwencją. W przykładzie wyszły wagi C .43, M .25, K .12, F .12 i N .08; pozostałe regiony dostały mniej niż .01.
Jak sprawdzić istotność efektu w syntetycznej kontroli?
Testami placebo: każdy region bez interwencji po kolei traktujesz jak objęty nią i porównujesz ilorazy RMSPE po i przed. p to miejsce regionu badanego podzielone przez liczbę regionów. W przykładzie region H był pierwszy z 16 (iloraz 4.61), czyli p = 1/16 ≈ .06 – mniej przy 16 regionach się nie da.
Kiedy różnica w różnicach zawyża efekt kampanii regionalnej, a syntetyczna kontrola nie?
DiD porównuje region ze średnią grupy porównawczej i zakłada równoległe trendy. Syntetyczna kontrola dobiera wagi regionów do przebiegu wyniku przed interwencją. W przykładzie region H rósł szybciej niż średnia, więc DiD dał 7.83 przy prawdziwym efekcie 3.39, a w 300 symulacjach był średnio obciążony o 3.66 wobec 0.44 dla syntetycznej kontroli.
Co zrobić, gdy syntetyczna kontrola słabo pasuje przed interwencją?
Nie interpretuj luki po interwencji. Sprawdź, czy region badany nie jest skrajny (najszybszy wzrost, najwyższa sprzedaż), czy pula dawców nie jest skażona i czy okres przed interwencją nie jest za krótki. Pomaga też sprawdzian na ostatnich tygodniach przed interwencją: w przykładzie wagi z tygodni 1–44 przewidziały tygodnie 45–52 ze średnią różnicą 0.39.
Powiązane hasła
Przeczytaj też
Quasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikMarketing mix modeling (MMM)
Producent soków, 156 tygodni i dwa kanały reklamy: adstock, nasycenie, rozkład sprzedaży, ROI z bootstrapem blokowym i pułapki – sześć rysunków z kodem R.
Czytaj →PoradnikAtrybucja kanałów: łańcuch Markowa
Ścieżki klientów biura podróży, graf przejść, efekt usunięcia i porównanie z ostatnim kliknięciem oraz z prawdziwym wpływem – z kodem R.
Czytaj →PoradnikGeo-eksperyment – plan testu w regionach
40 regionów, pary z historii sprzedaży, losowanie w parach, analiza z poziomem sprzed testu i krzywe mocy – sześć rysunków z kodem R.
Czytaj →PoradnikWspółpraca z twórcą a sprzedaż
Kontrfakt z modelu ARIMA, efekt skumulowany ze ścieżek prognozy, placebo i kody rabatowe – na fikcyjnej marce plecaków, z kodem R.
Czytaj →Oceniasz kampanię bez grupy kontrolnej?
Pomożemy dobrać pulę porównawczą, policzyć syntetyczną kontrolę i testy placebo oraz opisać wynik i jego ograniczenia tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Abadie, A. (2021). Using synthetic controls: Feasibility, data requirements, and methodological aspects. Journal of Economic Literature, 59(2), 391–425. https://doi.org/10.1257/jel.20191450 ● Otwarty dostęp: pełny tekst
- Abadie, A., & Gardeazabal, J. (2003). The economic costs of conflict: A case study of the Basque Country. American Economic Review, 93(1), 113–132. https://doi.org/10.1257/000282803321455188
- Abadie, A., Diamond, A., & Hainmueller, J. (2010). Synthetic control methods for comparative case studies: Estimating the effect of California's tobacco control program. Journal of the American Statistical Association, 105(490), 493–505. https://doi.org/10.1198/jasa.2009.ap08746 ● Otwarty dostęp: pełny tekst
- Abadie, A., Diamond, A., & Hainmueller, J. (2015). Comparative politics and the synthetic control method. American Journal of Political Science, 59(2), 495–510. https://doi.org/10.1111/ajps.12116 ● Otwarty dostęp: pełny tekst
- Arkhangelsky, D., Athey, S., Hirshberg, D. A., Imbens, G. W., & Wager, S. (2021). Synthetic difference-in-differences. American Economic Review, 111(12), 4088–4118. https://doi.org/10.1257/aer.20190159 ● Otwarty dostęp: pełny tekst
- Wing, C., Simon, K., & Bello-Gomez, R. A. (2018). Designing difference in difference studies: Best practices for public health policy research. Annual Review of Public Health, 39(1), 453–469. https://doi.org/10.1146/annurev-publhealth-040617-013507 ● Otwarty dostęp
Cytowania BibTeX
@article{abadie2021using, author={Abadie, Alberto}, title={{Using synthetic controls: Feasibility, data requirements, and methodological aspects}}, journal={Journal of Economic Literature}, year={2021}, volume={59}, number={2}, pages={391--425}, doi={10.1257/jel.20191450}}@article{abadie2003economic, author={Abadie, Alberto and Gardeazabal, Javier}, title={{The economic costs of conflict: A case study of the Basque Country}}, journal={American Economic Review}, year={2003}, volume={93}, number={1}, pages={113--132}, doi={10.1257/000282803321455188}}@article{abadie2010synthetic, author={Abadie, Alberto and Diamond, Alexis and Hainmueller, Jens}, title={{Synthetic control methods for comparative case studies: Estimating the effect of California's tobacco control program}}, journal={Journal of the American Statistical Association}, year={2010}, volume={105}, number={490}, pages={493--505}, doi={10.1198/jasa.2009.ap08746}}@article{abadie2015comparative, author={Abadie, Alberto and Diamond, Alexis and Hainmueller, Jens}, title={{Comparative politics and the synthetic control method}}, journal={American Journal of Political Science}, year={2015}, volume={59}, number={2}, pages={495--510}, doi={10.1111/ajps.12116}}@article{arkhangelsky2021synthetic, author={Arkhangelsky, Dmitry and Athey, Susan and Hirshberg, David A. and Imbens, Guido W. and Wager, Stefan}, title={{Synthetic difference-in-differences}}, journal={American Economic Review}, year={2021}, volume={111}, number={12}, pages={4088--4118}, doi={10.1257/aer.20190159}}@article{wing2018designing, author={Wing, Coady and Simon, Kosali and Bello-Gomez, Ricardo A.}, title={{Designing difference in difference studies: Best practices for public health policy research}}, journal={Annual Review of Public Health}, year={2018}, volume={39}, number={1}, pages={453--469}, doi={10.1146/annurev-publhealth-040617-013507}}