nlme::gls z AR(1)) i sezonowość, a gdy w tym samym czasie mogło zmienić się coś jeszcze, dodaj szereg kontrolny. Datę i kształt efektu ustal z góry. Punkt załamania wybrany z danych wymaga kalibracji, np. bootstrapem, bo zwykłe p jest wtedy zbyt optymistyczne.Regresja segmentowa a przerwany szereg czasowy
Regresja segmentowa (ang. segmented regression) to model, w którym zależność wyniku od predyktora zmienia się w określonym punkcie. Predyktorem bywa wiek, dawka albo wynik testu przesiewowego. Najczęściej jest nim jednak czas, a punktem załamania – moment wprowadzenia programu, ustawy albo nowej procedury. Taki schemat nazywa się przerwanym szeregiem czasowym (ITS). Wagner i in. (2002) opisują go jako najsilniejszy schemat quasi-eksperymentalny do oceny podłużnych efektów interwencji, a regresję segmentową jako skuteczną metodę szacowania tych efektów.
Definicję schematu i podstawowy model znajdziesz w słowniku, a ARIMA, dekompozycję i prognozę kontrfaktyczną omawia wpis szeregi czasowe i ARIMA w praktyce. Tu zajmujemy się decyzjami, które zostają badaczowi po wyborze schematu. Jak zakodować czas i co wtedy znaczą współczynniki? Jak uwzględnić autokorelację reszt w nlme::gls i sezonowość parą funkcji trygonometrycznych? Co daje szereg kontrolny? Wreszcie: co zrobić, gdy punkt załamania nie jest znany. Ogólne pojęcie punktu załamania, także poza czasem, opisuje hasło regresja segmentowa (punkt załamania).
Model: trzy zmienne czasu i co znaczą współczynniki
Model segmentowy dla jednego szeregu ma trzy zmienne opisujące czas. czas numeruje okresy od 1. po ma wartość 0 przed interwencją i 1 od pierwszego okresu z interwencją. czas_po liczy okresy z interwencją. Do tego dochodzą zmienne sezonowe i błąd, który może być autokorelowany:
| Parametr | Co oznacza | Na co uważać |
|---|---|---|
| β1 | nachylenie przed interwencją (zmiana na okres) | wymaga wielu punktów przed interwencją |
| β2 | zmiana poziomu względem przedłużonego trendu | znaczenie zależy od tego, czy czas_po zaczyna się od 0 czy od 1 |
| β3 | zmiana nachylenia po interwencji | nachylenie po interwencji to β1 + β3, nie samo β3 |
| β2 + h·β3 | efekt w h-tym okresie interwencji | przedział ufności licz z macierzy kowariancji, nie z dwóch osobnych CI |
W naszym kodowaniu czas_po ma wartość 1 w pierwszym miesiącu programu, więc efekt w tym miesiącu to β2 + β3. Gdy licznik zaczyna się od 0, β2 jest od razu efektem w pierwszym miesiącu. Obie wersje są poprawne, ale trzeba napisać, której użyto. Lopez Bernal i in. (2016) zalecają, by kształt wpływu (skok, zmianę nachylenia, opóźnienie) określić przed analizą. Jeśli program wdrażano stopniowo, okres przejściowy wyłącz z analizy albo zakoduj osobno, zamiast udawać, że skok nastąpił w jednym miesiącu.
Przykład: program racjonalnej antybiotykoterapii
Szpital A od lipca 2022 prowadzi program ograniczania antybiotyków o szerokim spektrum. Wynikiem jest miesięczny odsetek pacjentów oddziałów zachowawczych, którzy otrzymali taki antybiotyk. Mamy 72 miesiące (2019–2024): 42 przed programem i 30 w jego trakcie. Odsetek rośnie zimą, w sezonie infekcji. Szpital B programu nie wprowadził i posłuży jako szereg kontrolny. Dane są symulowane (set.seed(2393)), a plik możesz pobrać jako CSV (144 wiersze: szpital, rok, miesiac, czas, po, czas_po, odsetek).
Średnia w szpitalu A spadła z 35.72% do 30.77%. Takie porównanie średnich niewiele mówi, bo miesza efekt programu z trendem i ze składem miesięcy w obu okresach. Dlatego dopasowujemy model segmentowy.
Autokorelacja: MNK a gls z AR(1)
Zwykła regresja metodą najmniejszych kwadratów daje zmianę poziomu −4.33 punktu procentowego (SE = 0.59) i zmianę nachylenia −0.145 na miesiąc (SE = 0.030). Jej reszty są jednak skorelowane: r = .47 przy opóźnieniu 1. Kolejne miesiące nie są niezależnymi obserwacjami, więc błędy standardowe MNK są zaniżone (zob. szereg czasowy).
Ten sam model dopasowujemy uogólnioną metodą najmniejszych kwadratów (GLS) z błędem AR(1): gls(..., correlation = corAR1(form = ~ czas)). Domyślną metodą estymacji jest REML (zob. REML a ML). Turner i in. (2021) porównali w symulacji metody analizy ITS. Wszystkie dawały nieobciążone oszacowania zmiany poziomu i nachylenia, ale zaniżały autokorelację. Przedziały ufności były więc zwykle za wąskie, a REML szacował autokorelację najlepiej. Huitema i McKean (1991) pokazali wcześniej, że w krótkich szeregach estymatory autokorelacji są obciążone, a rzeczywisty odsetek błędów I rodzaju odbiega od nominalnego.
| Parametr | b | SE (GLS AR(1)) | SE (MNK) | 95% CI | p |
|---|---|---|---|---|---|
| Trend przed programem (na miesiąc) | 0.059 | 0.030 | 0.015 | [−0.001, 0.118] | .054 |
| Zmiana poziomu | −4.456 | 0.945 | 0.586 | [−6.343, −2.569] | < .001 |
| Zmiana nachylenia (na miesiąc) | −0.156 | 0.061 | 0.030 | [−0.277, −0.035] | .012 |
Oszacowane φ wynosi .60. Błąd standardowy zmiany nachylenia wzrósł dwukrotnie, a znormalizowane reszty modelu GLS nie są już autokorelowane (−.05 przy opóźnieniu 1). Test Durbina–Watsona nie wystarczy do decyzji, czy uwzględniać autokorelację. W symulacji Turnera i in. (2021) słabo ją wykrywał, z wyjątkiem długich szeregów i silnej autokorelacji. Bezpieczniej z góry założyć model z AR(1) i sprawdzić ACF reszt.
Sezonowość i efekt po h miesiącach
W przykładzie sezonowość opisuje jedna para sinus–cosinus o okresie 12 miesięcy. To tylko dwa parametry zamiast jedenastu zmiennych miesięcy, co ma znaczenie przy krótkim szeregu. Wystarcza, gdy wzorzec roczny ma jeden szczyt i jedną dolinę. Gdy profil jest nieregularny, użyj zmiennych miesięcy jak we wpisie o ARIMA albo dodaj drugą parę (okres 6 miesięcy). Nie wygładzaj szeregu średnią ruchomą przed regresją. Wygładzanie rozmywa skok w chwili interwencji i samo wprowadza autokorelację.
Najbardziej zrozumiały dla czytelnika jest efekt w wybranym horyzoncie, czyli różnica między przewidywaniem modelu a przedłużonym trendem:
- w pierwszym miesiącu programu: −4.61 pp, 95% CI [−6.47, −2.75];
- po 12 miesiącach: −6.33 pp, 95% CI [−8.42, −4.23];
- po 30 miesiącach: −9.14 pp, 95% CI [−12.81, −5.46].
Przedział rośnie z horyzontem, bo efekt dalej od interwencji zależy bardziej od ekstrapolacji trendu. Gdy wynik jest liczbą zdarzeń, a nie odsetkiem, ten sam model zapisuje się jako regresję Poissona z offsetem liczby pacjentów.
Szereg kontrolny: co jeszcze zmieniło się w lipcu 2022
Pojedynczy szereg nie odróżni programu od innych zdarzeń z tego samego miesiąca. Lopez Bernal i in. (2018) wskazują, że podstawowy ITS nie wyklucza zakłócenia przez współwystępujące interwencje. Szereg kontrolny daje drugie porównanie: interwencja–kontrola obok przed–po. W przykładzie w lipcu 2022 weszły też nowe wytyczne krajowe, obowiązujące w obu szpitalach. Model segmentowy dla szpitala B, który programu nie miał, pokazuje spadek poziomu o 1.45 pp, SE = 0.67, p = .034. Część „efektu” z poprzedniej sekcji nie jest więc efektem programu.
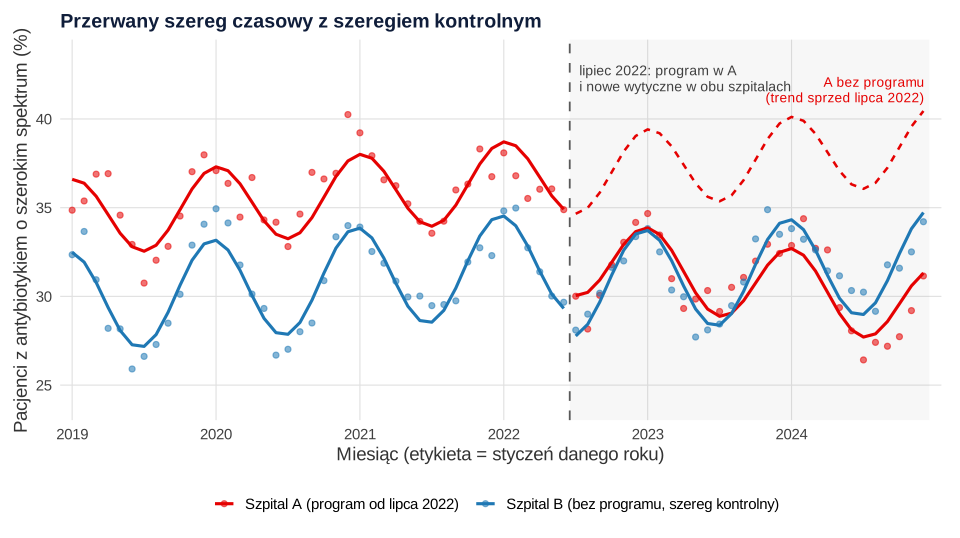
Oba szeregi łączymy w jednym modelu. Każdy szpital ma własny poziom, trend, zmianę poziomu i zmianę nachylenia, a efekt programu to interakcje szpitala A z po i z czas_po. Błąd AR(1) działa w obrębie szpitala (corAR1(form = ~ czas | szpital)), a varIdent pozwala na różne wariancje reszt. Względem szpitala B zmiana poziomu wynosi −3.08 pp, 95% CI [−5.38, −0.77], p = .009. Zmiana nachylenia to −0.160 na miesiąc, 95% CI [−0.305, −0.015], p = .031. Po 12 miesiącach efekt wynosi −5.00 pp, 95% CI [−7.54, −2.46], zamiast −6.33 pp z pojedynczego szeregu.
To logika różnicy w różnicach, rozszerzona o trendy. Szereg kontrolny działa tylko wtedy, gdy bez programu oba szpitale zmieniałyby się podobnie. Przed lipcem 2022 różnica nachyleń wynosiła 0.004 na miesiąc, p = .909, ale brak istotnej różnicy nie dowodzi równoległości. Lopez Bernal i in. (2018) przypominają, że źle dobrana kontrola może wprowadzić nowe obciążenie, np. gdy program w A przyciąga pacjentów z B. Dlatego kontrolę wybiera się a priori, z listą zdarzeń, które ma wykluczyć.
Gdy punkt załamania nie jest znany
Czasem data zmiany jest nieostra. Ustawa weszła w styczniu, ale szpitale wdrażały ją przez kwartał, albo pytanie brzmi, kiedy zaczął się spadek. Najprostsza metoda to przeszukanie siatki. Dla każdego kandydata k (tu od stycznia 2020 do stycznia 2024, co najmniej 12 miesięcy od każdego końca) dopasowujesz model segmentowy metodą ML i liczysz statystykę ilorazu wiarygodności (LR) wobec modelu bez załamania. Najlepszy punkt to maksimum profilu. Muggeo (2003) pokazał, jak traktować punkt załamania jako parametr modelu i szacować go z innymi parametrami. W R robi to pakiet segmented, ale siatka z gls pozwala zachować błąd AR(1).
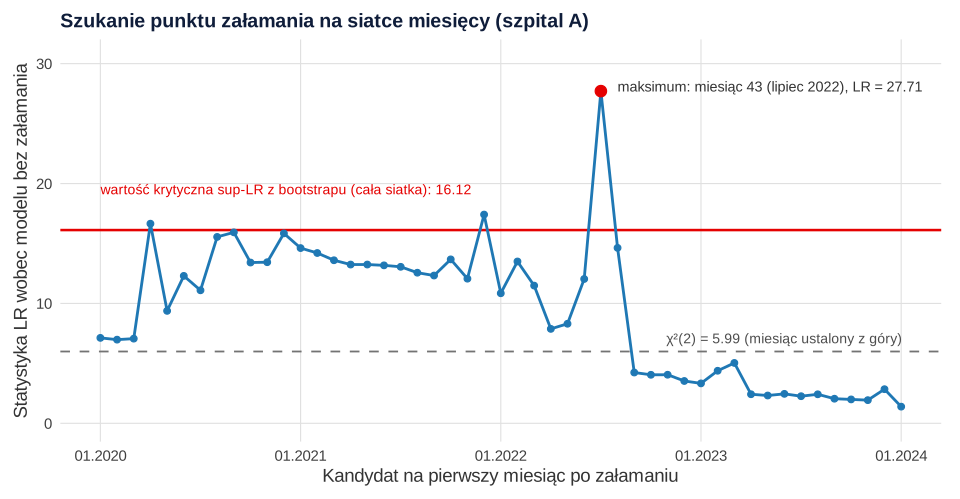
Maksimum przypada na lipiec 2022, LR = 27.71. Gdyby potraktować ten miesiąc jak ustalony z góry, test χ²(2) dałby p < .001. To jednak błąd: wybrano największą z 49 statystyk, więc jej rozkład nie jest rozkładem χ². To ten sam mechanizm co problem wielokrotnych porównań. Andrews (1993) opisał testy zmiany strukturalnej z nieznanym punktem zmiany, w których statystyka jest maksimum po kandydatach i ma własny rozkład.
Praktyczne rozwiązanie to bootstrap parametryczny przy H0. Generujesz wiele szeregów z modelu bez załamania, z błędem AR(1), w każdym powtarzasz całe przeszukanie siatki i zapisujesz maksimum LR. Parametr φ bierz z modelu z załamaniem. W modelu bez załamania niewyjaśniony skok zawyża autokorelację (tu .78 zamiast .49), a zawyżone φ w szeregach z bootstrapu zawyżyłoby też wartość krytyczną. W 500 powtórzeniach 95. centyl maksimum LR wyniósł 16.12, a bootstrapowe p = .002. Załamanie istnieje, ale nad progiem leżą też kwiecień 2020 (LR = 16.65) i grudzień 2021 (LR = 17.41). Siatka wskazuje więc lipiec 2022 jako najlepszego kandydata, ale nie daje pewności co do miesiąca.
Te same symulacje pokazują skalę problemu. Bez żadnego załamania test w miesiącu ustalonym z góry dawał p < .05 w 12.8% szeregów. Test „najlepszego” miesiąca z siatki, odczytany z tablic χ², dawał je w 83.6%. Nawet pierwszy wynik przekracza nominalne 5%, co zgadza się z obserwacją, że w krótkich szeregach przedziały bywają za wąskie (Turner i in., 2021). Wniosek dla ITS: datę interwencji i kształt wpływu ustal przed analizą i wpisz do prerejestracji. Szukanie punktu załamania w danych to analiza eksploracyjna, którą raportujesz razem z kalibracją przez bootstrap i zakresem kandydatów.
Jak opisać wyniki
W metodzie podaj okres i częstotliwość pomiarów, datę interwencji i sposób kodowania czasu. Opisz przyjęty z góry kształt wpływu, uwzględnienie sezonowości i strukturę błędu z diagnostyką reszt. Przy szeregu kontrolnym dodaj kryteria jego wyboru. W wynikach pokaż wykres obu szeregów z linią interwencji, zmianę poziomu i nachylenia z 95% CI oraz efekt w wybranym horyzoncie. Analizy wrażliwości (inna struktura błędu, wyłączenie okresu przejściowego, inny szereg kontrolny) omawia wpis analiza wrażliwości w artykule.
Jeśli oceniasz politykę zdrowotną albo program na danych z rejestru i chcesz omówić z kimś wybór modelu i szeregu kontrolnego, możemy pomóc w ramach wsparcia statystycznego dla badaczy. Szerszy kontekst publikowania znajdziesz w przewodniku po doktoracie i publikacjach.
Przykład w R
Trzy przepisy uruchamiasz po kolei w jednej sesji R. Pierwszy tworzy dane i zapisuje plik przerwany-szereg-antybiotyki-dane.csv (możesz go pobrać tutaj). Kolejne korzystają z obiektów dane i A. Wystarczy pakiet nlme (instalowany razem z R) i funkcje podstawowego R. Liczby w tekście, tabelach i na rysunkach pochodzą z tych obliczeń.
1. Regresja segmentowa: MNK i GLS z błędem AR(1)
R
# Dane symulowane: 72 miesiące (2019–2024) w dwóch szpitalach. W szpitalu A od lipca 2022 (miesiąc 43)
# działa program racjonalnej antybiotykoterapii; szpital B go nie wprowadził. Wynik: odsetek pacjentów
# oddziałów zachowawczych, którzy otrzymali antybiotyk o szerokim spektrum (%). Zimą odsetek rośnie.
# W lipcu 2022 w obu szpitalach zaczęły też obowiązywać nowe wytyczne krajowe (zdarzenie wspólne).
library(nlme)
set.seed(2393)
miesiecy <- 72; start <- 43
czas <- 1:miesiecy
sezon <- 2.2 * cos(2 * pi * czas / 12) + 0.8 * sin(2 * pi * czas / 12)   # szczyt zimą
wytyczne <- -1.2 * (czas >= start)                                       # wspólne zdarzenie w obu szpitalach
szum <- function() as.numeric(arima.sim(list(ar = 0.5), n = miesiecy, sd = 0.9))
y_A <- 34 + 0.06 * czas + sezon + wytyczne - 3.0 * (czas >= start) - 0.15 * pmax(0, czas - start + 1) + szum()
y_B <- 30 + 0.05 * czas + sezon + wytyczne + szum()
dane <- data.frame(szpital = rep(c("A", "B"), each = miesiecy),
                   rok = rep(rep(2019:2024, each = 12), 2), miesiac = rep(rep(1:12, 6), 2),
                   czas = rep(czas, 2), odsetek = round(c(y_A, y_B), 2))
dane$po <- as.integer(dane$czas >= start)              # 0 przed programem, 1 od lipca 2022
dane$czas_po <- pmax(0, dane$czas - start + 1)         # 1 w pierwszym miesiącu programu, 2 w drugim…
dane$sin12 <- sin(2 * pi * dane$czas / 12); dane$cos12 <- cos(2 * pi * dane$czas / 12)
write.csv(dane[, c("szpital", "rok", "miesiac", "czas", "po", "czas_po", "odsetek")], "przerwany-szereg-antybiotyki-dane.csv", row.names = FALSE)
A <- subset(dane, szpital == "A")

# Średnie okresów w szpitalu A
round(tapply(A$odsetek, A$po, mean), 2)

# 1. Regresja segmentowa MNK: trend, zmiana poziomu, zmiana nachylenia, sezonowość (para sinus–cosinus)
m_mnk <- lm(odsetek ~ czas + po + czas_po + sin12 + cos12, data = A)
round(summary(m_mnk)$coefficients[2:4, ], 3)
r <- residuals(m_mnk)
round(acf(r, lag.max = 3, plot = FALSE)$acf[2:4], 3)   # autokorelacja reszt przy opóźnieniach 1–3

# 2. Ten sam model z błędem AR(1): nlme::gls (REML)
m_ar1 <- gls(odsetek ~ czas + po + czas_po + sin12 + cos12, data = A, correlation = corAR1(form = ~ czas))
ci <- intervals(m_ar1, which = "coef")$coef[2:4, ]
tab <- data.frame(b = coef(m_ar1)[2:4], SE = sqrt(diag(vcov(m_ar1)))[2:4], dolny = ci[, 1], gorny = ci[, 3],
                  p = summary(m_ar1)$tTable[2:4, 4])
round(tab, 3)
round(c(phi = coef(m_ar1$modelStruct$corStruct, unconstrained = FALSE)), 3)
round(rbind(SE_MNK = summary(m_mnk)$coefficients[3:4, 2], SE_AR1 = tab$SE[2:3]), 3)
round(acf(residuals(m_ar1, type = "normalized"), lag.max = 3, plot = FALSE)$acf[2:4], 3)

# 3. Efekt po h miesiącach programu: zmiana poziomu + h × zmiana nachylenia, z 95% CI
efekt_h <- function(m, h) {
  L <- setNames(rep(0, length(coef(m))), names(coef(m))); L[c("po", "czas_po")] <- c(1, h)
  est <- sum(L * coef(m)); se <- sqrt(drop(t(L) %*% vcov(m) %*% L)); df <- m$dims$N - m$dims$p
  c(h = h, efekt = est, SE = se, dolny = est - qt(.975, df) * se, gorny = est + qt(.975, df) * se)
}
round(rbind(efekt_h(m_ar1, 1), efekt_h(m_ar1, 12), efekt_h(m_ar1, 30)), 3)
Wynik w R
    0     1
35.72 30.77
        Estimate Std. Error t value Pr(>|t|)
czas       0.049      0.015   3.157    0.002
po        -4.334      0.586  -7.399    0.000
czas_po   -0.145      0.030  -4.845    0.000
[1]  0.471  0.136 -0.090
             b    SE  dolny  gorny     p
czas     0.059 0.030 -0.001  0.118 0.054
po      -4.456 0.945 -6.343 -2.569 0.000
czas_po -0.156 0.061 -0.277 -0.035 0.012
phi.Phi
  0.601
          po czas_po
SE_MNK 0.586   0.030
SE_AR1 0.945   0.061
[1] -0.052 -0.035 -0.209
      h  efekt    SE   dolny  gorny
[1,]  1 -4.612 0.933  -6.474 -2.750
[2,] 12 -6.328 1.049  -8.423 -4.233
[3,] 30 -9.136 1.841 -12.812 -5.460
2. Przerwany szereg z szeregiem kontrolnym
R
# Przerwany szereg z szeregiem kontrolnym (szpital B bez programu). Wymaga obiektu dane z przepisu 1.
library(nlme)
dane$szpital <- factor(dane$szpital, levels = c("B", "A"))   # B = szereg kontrolny (kategoria odniesienia)
B <- subset(dane, szpital == "B")

# Szpital B osobno: czy coś zmieniło się w lipcu 2022 także tam, gdzie programu nie było?
m_B <- gls(odsetek ~ czas + po + czas_po + sin12 + cos12, data = B, correlation = corAR1(form = ~ czas))
round(summary(m_B)$tTable[3:4, ], 3)

# Model łączny: osobny trend, poziom i nachylenie dla każdego szpitala, wspólna sezonowość,
# błąd AR(1) w obrębie szpitala i osobna wariancja reszt dla każdego szpitala
m_kontr <- gls(odsetek ~ szpital * (czas + po + czas_po) + sin12 + cos12, data = dane,
               correlation = corAR1(form = ~ czas | szpital), weights = varIdent(form = ~ 1 | szpital))
wsp <- c("szpitalA:po", "szpitalA:czas_po")
ci <- intervals(m_kontr, which = "coef")$coef[wsp, ]
round(data.frame(b = coef(m_kontr)[wsp], SE = sqrt(diag(vcov(m_kontr)))[wsp], dolny = ci[, 1], gorny = ci[, 3],
                 p = summary(m_kontr)$tTable[wsp, 4]), 3)

# Efekt programu po 12 miesiącach względem szeregu kontrolnego (różnica zmian poziomu + 12 × różnica zmian nachylenia)
L <- setNames(rep(0, length(coef(m_kontr))), names(coef(m_kontr))); L[wsp] <- c(1, 12)
est <- sum(L * coef(m_kontr)); se <- sqrt(drop(t(L) %*% vcov(m_kontr) %*% L)); df <- m_kontr$dims$N - m_kontr$dims$p
round(c(efekt_12 = est, SE = se, dolny = est - qt(.975, df) * se, gorny = est + qt(.975, df) * se), 3)

# Równoległe trendy przed programem: różnica nachyleń A − B w miesiącach 1–42
m_przed <- gls(odsetek ~ szpital * czas + sin12 + cos12, data = subset(dane, po == 0),
               correlation = corAR1(form = ~ czas | szpital), weights = varIdent(form = ~ 1 | szpital))
round(summary(m_przed)$tTable["szpitalA:czas", ], 3)
Wynik w R
         Value Std.Error t-value p-value
po      -1.454     0.671  -2.166   0.034
czas_po -0.006     0.040  -0.159   0.874
                      b    SE  dolny  gorny     p
szpitalA:po      -3.075 1.167 -5.383 -0.767 0.009
szpitalA:czas_po -0.160 0.073 -0.305 -0.015 0.031
efekt_12       SE    dolny    gorny
  -4.999    1.283   -7.538   -2.461
    Value Std.Error   t-value   p-value
    0.004     0.035     0.115     0.909
3. Punkt załamania z siatki i bootstrap przy H0
R
# Punkt załamania nieznany: przeszukanie siatki miesięcy w szpitalu A. Wymaga obiektu A z przepisu 1.
library(nlme)
dopasuj <- function(d, k = NULL) {             # k = pierwszy miesiąc po załamaniu; NULL = model bez załamania
  if (!is.null(k)) { d$po <- as.integer(d$czas >= k); d$czas_po <- pmax(0, d$czas - k + 1) }
  wzor <- if (is.null(k)) odsetek ~ czas + sin12 + cos12 else odsetek ~ czas + po + czas_po + sin12 + cos12
  gls(wzor, data = d, correlation = corAR1(form = ~ czas), method = "ML")   # ML, bo porównujemy różne części stałe
}
siatka <- 13:61                                 # co najmniej 12 miesięcy przed i po każdym kandydacie
profil <- function(d) {
  l0 <- logLik(dopasuj(d))
  sapply(siatka, function(k) 2 * (as.numeric(logLik(dopasuj(d, k))) - as.numeric(l0)))   # statystyka LR
}
LR <- profil(A)
k_hat <- siatka[which.max(LR)]
c(najlepszy_k = k_hat, LR_max = round(max(LR), 2), LR_drugi = round(sort(LR, decreasing = TRUE)[2], 2))
siatka[LR >= max(LR) - 3.84]                    # miesiące, których profil nie odrzuca (orientacyjnie)
p_naiwne <- pchisq(max(LR), df = 2, lower.tail = FALSE)   # tak, jakby k było znane z góry – błędnie
signif(p_naiwne, 3)

# Bootstrap parametryczny przy H0 (brak załamania): część stała z modelu bez załamania,
# φ i σ z modelu z najlepszym k (w modelu bez załamania niewyjaśniony skok zawyżyłby φ)
m0 <- dopasuj(A); m_k <- dopasuj(A, k_hat)
phi <- coef(m_k$modelStruct$corStruct, unconstrained = FALSE); sigma <- m_k$sigma
round(c(phi_bez_zalamania = coef(m0$modelStruct$corStruct, unconstrained = FALSE), phi_z_zalamaniem = phi), 3)
set.seed(2391)
B_rep <- 500
sym <- t(replicate(B_rep, {
  d <- A
  d$odsetek <- fitted(m0) + as.numeric(arima.sim(list(ar = phi), n = nrow(A), sd = sigma * sqrt(1 - phi^2)))
  lr <- profil(d)
  c(max = max(lr), staly_43 = lr[siatka == 43])
}))
c(krytyczna_sup_LR = round(unname(quantile(sym[, "max"], .95)), 2),
  p_bootstrap = round((1 + sum(sym[, "max"] >= max(LR))) / (B_rep + 1), 4))
# Odsetek fałszywych alarmów przy H0 (α = .05, krytyczna wartość χ²(2) = 5.99)
round(c(k_znane_z_gory = mean(sym[, "staly_43"] > qchisq(.95, 2)),
        k_wybrane_z_danych = mean(sym[, "max"] > qchisq(.95, 2))), 3)
# Którzy kandydaci przekraczają wartość krytyczną z bootstrapu (miesiąc i LR)?
krytyczna <- unname(quantile(sym[, "max"], .95))
round(rbind(k = siatka, LR = LR)[, LR > krytyczna], 2)
Wynik w R
najlepszy_k      LR_max    LR_drugi
      43.00       27.71       17.41
[1] 43
[1] 9.62e-07
phi_bez_zalamania.Phi  phi_z_zalamaniem.Phi
                0.782                 0.488
krytyczna_sup_LR      p_bootstrap
          16.120            0.002
    k_znane_z_gory k_wybrane_z_danych
             0.128              0.836
    [,1]  [,2]  [,3]
k  16.00 36.00 43.00
LR 16.65 17.41 27.71
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje lm(), arima.sim(), acf() oraz gls() i intervals() z pakietu nlme); rysunki przygotowano w pakiecie ggplot2.
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- nlme (wersja 3.1.168): Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models [R package]. https://doi.org/10.32614/CRAN.package.nlme
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
Najczęstsze błędy
- Porównanie średnich przed i po zamiast zmiany poziomu i nachylenia względem przedłużonego trendu.
- Zwykłe błędy standardowe MNK przy autokorelacji reszt. W przykładzie SE zmiany nachylenia był o połowę za mały.
- Interpretacja β3 jako nachylenia po interwencji. To zmiana nachylenia; nachylenie po interwencji to β1 + β3.
- Pojedynczy szereg, gdy w tym samym czasie zmieniło się coś jeszcze. Szereg kontrolny lub co najmniej opis takich zdarzeń w ograniczeniach.
- Punkt załamania z danych i p z tablic χ². Wynik z siatki wymaga kalibracji (bootstrap lub test typu sup) i opisu jako eksploracyjny.
- Wygładzanie szeregu przed modelem średnią ruchomą. Rozmywa skok i fałszuje błędy standardowe.
Pokrewne schematy oceny interwencji bez losowania, w tym regresję nieciągłą, omawia wpis regresja nieciągła i zmienne instrumentalne. Ogólne zagrożenia trafności opisuje hasło schemat quasi-eksperymentalny, a gładkie, nieliniowe trendy – wpis o splajnach i modelach GAM.
Najczęstsze pytania
Jak zakodować zmienne czasu w regresji segmentowej?
Potrzebujesz trzech zmiennych: czasu liczonego od 1, wskaźnika okresu po interwencji (0 lub 1) i licznika okresów od interwencji. Jeśli licznik ma wartość 1 w pierwszym okresie interwencji, efekt w tym okresie to suma zmiany poziomu i zmiany nachylenia. Jeśli zaczyna się od 0, zmiana poziomu jest od razu efektem w pierwszym okresie. Napisz w metodzie, którą wersję przyjęto.
Czy punkt załamania w szeregu czasowym można wyznaczyć z danych?
Można, ale wtedy wynik jest eksploracyjny. Przeszukanie siatki kandydatów wybiera największą statystykę testu, więc p z tablic χ² jest zbyt małe. W przykładzie bez prawdziwego załamania taki test dawał p < .05 w 83.6% szeregów. Kalibruj go bootstrapem przy H0 albo testem typu sup (Andrews, 1993), a przy ocenie interwencji ustal datę z góry.
Po co szereg kontrolny w przerwanym szeregu czasowym?
Pojedynczy szereg nie odróżni interwencji od innych zdarzeń z tego samego okresu, np. nowych przepisów. Szereg bez interwencji pokazuje, jak zmieniłby się wynik pod wpływem tych zdarzeń (Lopez Bernal i in., 2018). Efektem jest wtedy różnica zmian poziomu i nachylenia między szeregami. Kontrolę dobierz przed analizą i sprawdź podobieństwo trendów przed interwencją.
Czy gls z AR(1) wystarczy przy krótkim przerwanym szeregu czasowym?
Zwykle jest lepszy niż MNK, ale nie rozwiązuje wszystkiego. W symulacji Turnera i in. (2021) wszystkie metody zaniżały autokorelację, więc przedziały ufności bywały za wąskie, a REML wypadał najlepiej. Przy krótkim szeregu traktuj p bliskie .05 ostrożnie, sprawdź ACF reszt i pokaż analizę wrażliwości z inną strukturą błędu.
Czym regresja segmentowa różni się od regresji nieciągłej?
W regresji segmentowej predyktorem jest zwykle czas, a interwencja zaczyna się w znanym momencie dla całej populacji. Porównujesz trend przed i po. W regresji nieciągłej przydział zależy od progu zmiennej, np. wyniku testu, a porównujesz osoby tuż poniżej i tuż powyżej progu. Oba modele mają podobną postać z załamaniem, ale inne założenia.
Powiązane hasła
Przeczytaj też
Szeregi czasowe i ARIMA w praktyce
Trend, sezonowość, ACF i test Ljunga–Boxa, wybór modelu ARIMA w stats::arima, prognoza kontrfaktyczna i regresja segmentowa z kodem R.
Czytaj →PoradnikQuasi-eksperyment i różnica w różnicach (DiD)
Ocena programu bez losowania: równoległe trendy, regresja z interakcją, błędy klastrowane, model zdarzeń, test placebo, zagrożenia trafności i kod R.
Czytaj →PoradnikRegresja nieciągła (RDD) i zmienne instrumentalne
Próg w regule przydziału i zmienna instrumentalna: założenia, lokalna regresja liniowa, testy, 2SLS w R z poprawnym SE i wzór opisu.
Czytaj →Oceniasz program albo zmianę przepisów na danych miesięcznych?
Pomożemy zaplanować przerwany szereg czasowy, dobrać szereg kontrolny, uwzględnić autokorelację i sezonowość oraz opisać zmianę poziomu i nachylenia tak, żebyś mógł(a) samodzielnie obronić wynik przed recenzentem.
Oferta dla badaczyPorozmawiaj o projekcieBibliografia i dalsza literatura naukowa (APA 7)
- Andrews, D. W. K. (1993). Tests for parameter instability and structural change with unknown change point. Econometrica, 61(4), 821–856. https://doi.org/10.2307/2951764
- Huitema, B. E., & McKean, J. W. (1991). Autocorrelation estimation and inference with small samples. Psychological Bulletin, 110(2), 291–304. https://doi.org/10.1037/0033-2909.110.2.291
- Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2016). Interrupted time series regression for the evaluation of public health interventions: A tutorial. International Journal of Epidemiology, 46(1), 348–355. https://doi.org/10.1093/ije/dyw098 ● Otwarty dostęp
- Lopez Bernal, J., Cummins, S., & Gasparrini, A. (2018). The use of controls in interrupted time series studies of public health interventions. International Journal of Epidemiology, 47(6), 2082–2093. https://doi.org/10.1093/ije/dyy135
- Muggeo, V. M. R. (2003). Estimating regression models with unknown break-points. Statistics in Medicine, 22(19), 3055–3071. https://doi.org/10.1002/sim.1545
- Turner, S. L., Forbes, A. B., Karahalios, A., Taljaard, M., & McKenzie, J. E. (2021). Evaluation of statistical methods used in the analysis of interrupted time series studies: A simulation study. BMC Medical Research Methodology, 21(1), Article 181. https://doi.org/10.1186/s12874-021-01364-0 ● Otwarty dostęp
- Wagner, A. K., Soumerai, S. B., Zhang, F., & Ross-Degnan, D. (2002). Segmented regression analysis of interrupted time series studies in medication use research. Journal of Clinical Pharmacy and Therapeutics, 27(4), 299–309. https://doi.org/10.1046/j.1365-2710.2002.00430.x
Cytowania BibTeX
@article{andrews1993tests, author={Andrews, Donald W. K.}, title={{Tests for parameter instability and structural change with unknown change point}}, journal={Econometrica}, year={1993}, volume={61}, number={4}, pages={821--856}, doi={10.2307/2951764}}@article{huitema1991autocorrelation, author={Huitema, Bradley E. and McKean, Joseph W.}, title={{Autocorrelation estimation and inference with small samples}}, journal={Psychological Bulletin}, year={1991}, volume={110}, number={2}, pages={291--304}, doi={10.1037/0033-2909.110.2.291}}@article{lopezbernal2016interrupted, author={Lopez Bernal, James and Cummins, Steven and Gasparrini, Antonio}, title={{Interrupted time series regression for the evaluation of public health interventions: A tutorial}}, journal={International Journal of Epidemiology}, year={2016}, volume={46}, number={1}, pages={348--355}, doi={10.1093/ije/dyw098}}@article{lopezbernal2018use, author={Lopez Bernal, James and Cummins, Steven and Gasparrini, Antonio}, title={{The use of controls in interrupted time series studies of public health interventions}}, journal={International Journal of Epidemiology}, year={2018}, volume={47}, number={6}, pages={2082--2093}, doi={10.1093/ije/dyy135}}@article{muggeo2003estimating, author={Muggeo, Vito M. R.}, title={{Estimating regression models with unknown break-points}}, journal={Statistics in Medicine}, year={2003}, volume={22}, number={19}, pages={3055--3071}, doi={10.1002/sim.1545}}@article{turner2021evaluation, author={Turner, Simon L. and Forbes, Andrew B. and Karahalios, Amalia and Taljaard, Monica and McKenzie, Joanne E.}, title={{Evaluation of statistical methods used in the analysis of interrupted time series studies: A simulation study}}, journal={BMC Medical Research Methodology}, year={2021}, volume={21}, number={1}, eid={181}, doi={10.1186/s12874-021-01364-0}}@article{wagner2002segmented, author={Wagner, A. K. and Soumerai, S. B. and Zhang, F. and Ross-Degnan, D.}, title={{Segmented regression analysis of interrupted time series studies in medication use research}}, journal={Journal of Clinical Pharmacy and Therapeutics}, year={2002}, volume={27}, number={4}, pages={299--309}, doi={10.1046/j.1365-2710.2002.00430.x}}