Przykład: producent soków i trzy lata tygodniowych danych
Fikcyjny producent soków ma dane z 156 tygodni (2023–2025): sprzedaż w tys. zł, wydatki na reklamę w telewizji i w internecie oraz rabaty cenowe. Zarząd pyta: ile sprzedaży dała reklama i czy kolejny milion wydać na TV, czy w internecie?
Odpowiada na to marketing mix modeling (MMM). To regresja wieloraka tygodniowej sprzedaży na wydatki na kanały, promocje, trend i sezon. Dane tworzą szereg czasowy, a reklama działa z opóźnieniem i się nasyca.
Dane są fikcyjne i znamy prawdę. Parametry ustawiliśmy ręcznie: dla TV pamięć λ = 0.6, nasycenie K = 120 i maksymalny efekt β = 150 tys. zł tygodniowo, dla internetu λ = 0.2, K = 20, β = 70, a każdy punkt procentowy rabatu daje 3 tys. zł. Do tego trend, szczyt sprzedaży latem i zakłócenia lekko zależne w czasie. W trzy lata sprzedaż wyniosła 67.38 mln zł, TV kosztowała 5.73 mln zł (57 tygodni kampanii), internet 2.11 mln zł, a rabat był w 22 tygodniach. Prawdziwy ROI to 1.36 zł sprzedaży na złotówkę w TV i 1.85 zł w internecie. Ziarno 617 ustalono raz i nie zmieniano go; parametry danych (także po pierwszych próbach – zob. Kod R) dobraliśmy tak, by obie pułapki były widoczne. Dane pobierzesz jako mmm-sprzedaz-tygodniowa.csv – z prawdziwym wkładem TV i internetu, którego w realnych danych nie ma.
MMM patrzy na tygodnie wszystkich kanałów naraz – inaczej niż atrybucja łańcuchem Markowa (ścieżki klientów) i syntetyczna kontrola (jedna kampania w regionie). Prognozowanie takiego szeregu opisuje wpis prognoza sprzedaży z sezonowością i promocjami.
Rysunek 1: od wydatku do sprzedaży
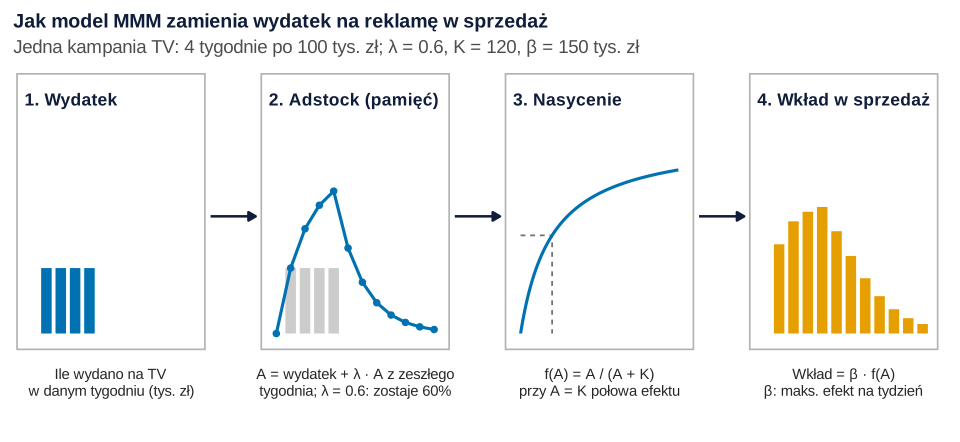
Co widać. Reklama nie działa tylko w tygodniu emisji: część efektu przechodzi na kolejne tygodnie. Tę „pamięć” opisuje adstock:
gdzie xt to wydatek w tygodniu t. Przy λ = 0.6 po tygodniu zostaje 60% efektu, po dwóch 36%. Clarke (1976) po przeglądzie badań ekonometrycznych uznał, że skumulowany efekt reklamy trwa miesiące, a nie lata, i że oszacowanie zależy od tego, czy dane są tygodniowe, czy roczne. Drugi krok to nasycenie: f(A) = A / (A + K). Przy A = K reklama daje połowę maksymalnego efektu β, a każdy kolejny złoty – coraz mniej. Little (1979) zebrał obserwacje, że odpowiedź sprzedaży na reklamę bywa wklęsła albo w kształcie litery S i że sprzedaż rośnie i opada w różnym tempie. W przykładzie z rysunku adstock rośnie do 217.6, wkład w sprzedaż do 96.7 tys. zł w czwartym tygodniu kampanii, a cztery tygodnie po jej końcu to wciąż 28.5 tys. zł.
Jak może zmylić. To jeden z możliwych kształtów: adstock geometryczny (największy efekt od razu) i nasycenie bez progu. Opóźniony szczyt albo krzywa S dadzą inne liczby – wybór kształtu opisz w Metodzie.
Podpis do pracy:
Rysunek 2: sprzedaż, reklama i promocje
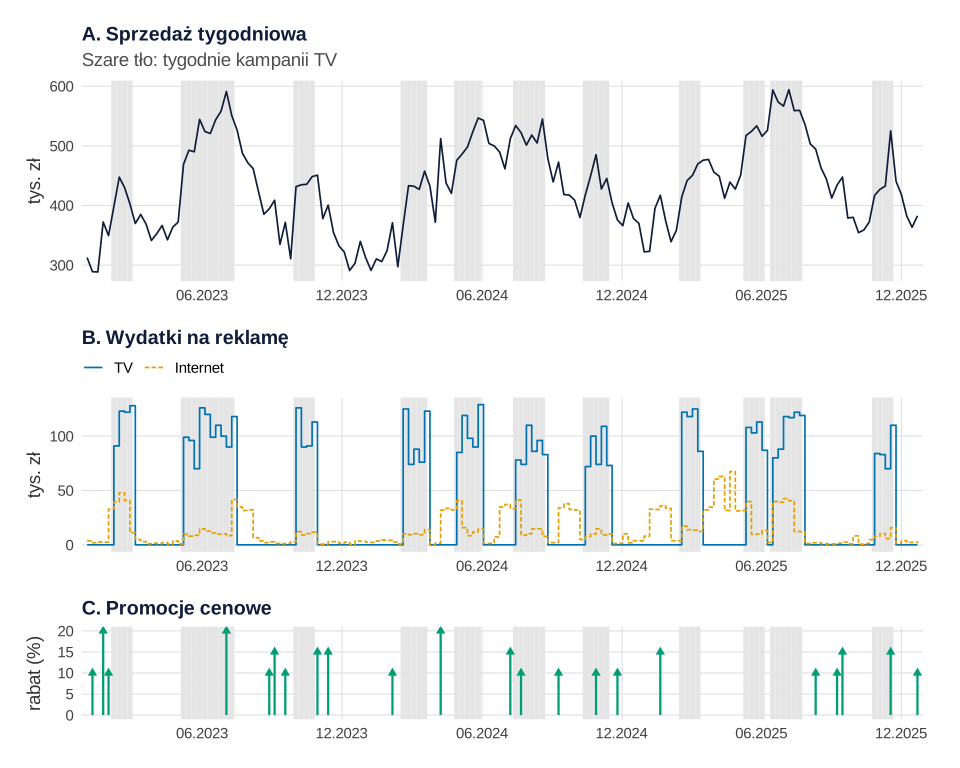
set.seed(617)).Co widać. Kampanie TV często trafiają w wiosnę i lato, gdy sprzedaż i tak rośnie. Sprzedaż koreluje z TV na poziomie r = .56, ale z samym sezonem jeszcze silniej (r = .78), a TV z sezonem r = .26. Prosta korelacja miesza więc efekt reklamy z efektem lata. Dlatego model zawiera sezonowość (dwie pary sinus–cosinus) i trend. Internet ma własne akcje i z TV koreluje tylko r = .19 – to ułatwi rozdzielenie kanałów.
Jak może zmylić. Złotówki to nie kontakt z reklamą. W metaanalizie Sethuramana i in. (2011) elastyczność reklamy była wyższa, gdy reklamę mierzono w punktach ratingowych (GRP), niż w pieniądzach; średnia elastyczność krótkookresowa wyniosła tam .12, a długookresowa .24. Jeśli masz GRP lub wyświetlenia, użyj ich zamiast wydatków.
Podpis do pracy:
Rysunek 3: model i dobór λ oraz K siatką
Model wygląda tak:
Przy ustalonych λ i K to zwykła regresja liniowa. Samych λ i K nie da się jednak oszacować wprost, więc ustalamy z góry siatkę: λ od 0 do 0.9 co 0.1 i sześć wartości K na kanał (TV: 40–400, internet: 5–70). To 60 par dla TV × 60 dla internetu, czyli 3600 regresji. Wybieramy parę z najmniejszym błędem średniokwadratowym (RMSE).
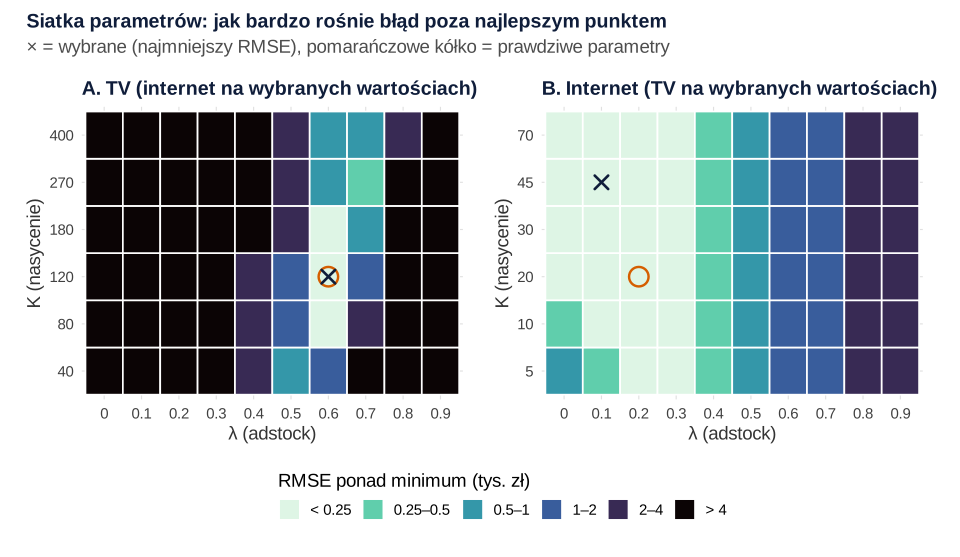
set.seed(617)).Co widać. Dla TV siatka trafiła dokładnie w prawdę: λ = 0.6, K = 120. Tylko 3 z 60 par TV dają RMSE mniej niż 0.25 tys. zł gorszy od najlepszego – minimum jest wyraźne. Dla internetu takich par jest 21: wybrana λ = 0.1 i K = 45 (prawda: 0.2 i 20). Dane prawie nie odróżniają krótkiej pamięci od zerowej. Najlepszy model ma RMSE = 16.25 tys. zł, model z prawdziwymi parametrami 16.29, a R² = .953.
Jak może zmylić. Dobór siatką to dopasowanie do tych samych danych, więc grozi przeuczeniem. Błędy standardowe z lm() nie wiedzą o doborze: βTV = 156.15 (SE = 5.94) wygląda precyzyjnie, ale niepewność λ i K w tym nie ma. Jeśli minimum leży na brzegu siatki, poszerz ją.
Zdanie do Metody:
Rysunek 4: oszacowane a prawdziwe krzywe
| Parametr | Prawda | Oszacowanie |
|---|---|---|
| TV: λ / K / β | 0.6 / 120 / 150.00 | 0.6 / 120 / 156.15 |
| Internet: λ / K / β | 0.2 / 20 / 70.00 | 0.1 / 45 / 76.72 |
| Rabat (tys. zł na 1 pp) | 3.00 | 3.09 |
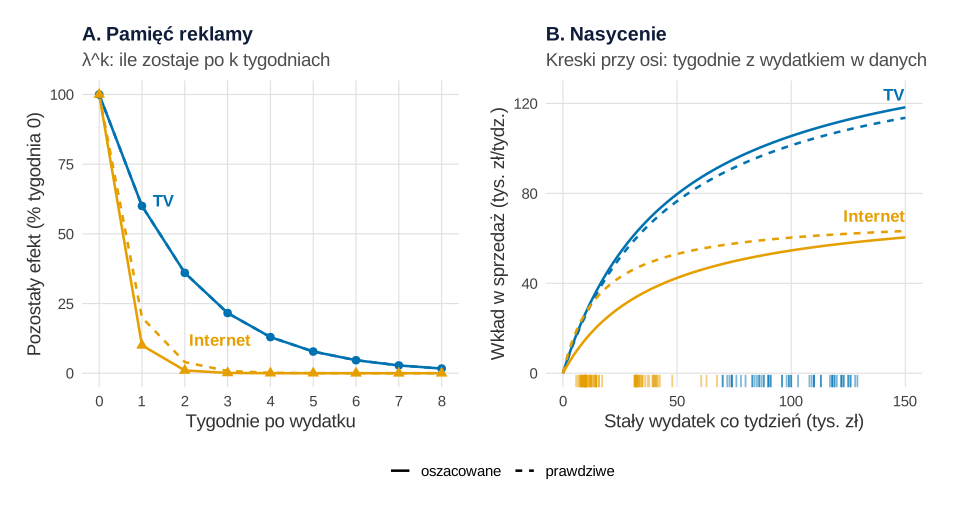
set.seed(617)).Co widać. Krzywe TV prawie się pokrywają: przy typowym tygodniowym wydatku 99 tys. zł model daje 105.2 tys. zł wkładu, a prawda to 101.0. Internetowi model przypisał krótszą pamięć i późniejsze nasycenie: przy typowych 14.6 tys. zł daje 20.7 tys. zł zamiast 33.9. Obie krzywe się spłaszczają.
Jak może zmylić. Krzywa poza zakresem kresek przy osi to ekstrapolacja: TV nigdy nie wydała w tygodniu więcej niż 130 tys. zł, więc przebieg dalej to założenie kształtu, a nie wynik z danych.
Podpis do pracy:
Rysunek 5: ile sprzedaży dał każdy kanał
Wkład kanału w tygodniu to β·f(At). „Baza” to reszta dopasowania: stała, trend i sezon.
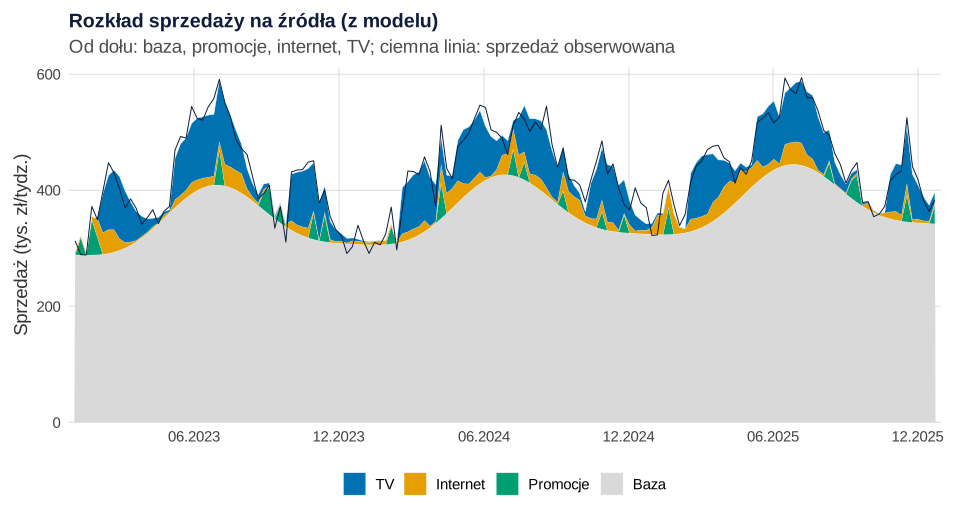
set.seed(617)).Co widać. Przez trzy lata TV dała według modelu 12.0% sprzedaży (8.09 mln zł; prawda: 11.5%), internet 3.7% (2.47 mln zł; prawda: 5.8%), promocje 1.3% (prawda: 1.3%), a baza 83.0% (prawda: 81.4%). Większość sprzedaży sprzedaje się „sama” – typowy obraz w MMM.
Jak może zmylić. Na wykresie warstwowym dobrze widać tylko dolną warstwę i sumę; grubość warstw środkowych trudno ocenić. „Baza” to nie „sprzedaż bez marketingu na zawsze” – reklama z poprzednich lat mogła ją zbudować.
Zdanie do Wyników:
Rysunek 6: ROI z niepewnością i dwie pułapki
ROI to wkład kanału podzielony przez wydatek. Krańcowy ROI mówi, ile sprzedaży da dodatkowy złoty: liczymy go, zwiększając wydatek o 10% w każdym tygodniu. Niepewność daje bootstrap blokowy. Bloki kolejnych obserwacji zachowują zależność w czasie (Künsch, 1989), a tu reszty mają autokorelację .13 (autokorelacja reszt). Losujemy reszty w blokach po 8 tygodni, 300 razy, i w każdej próbie powtarzamy całą siatkę.
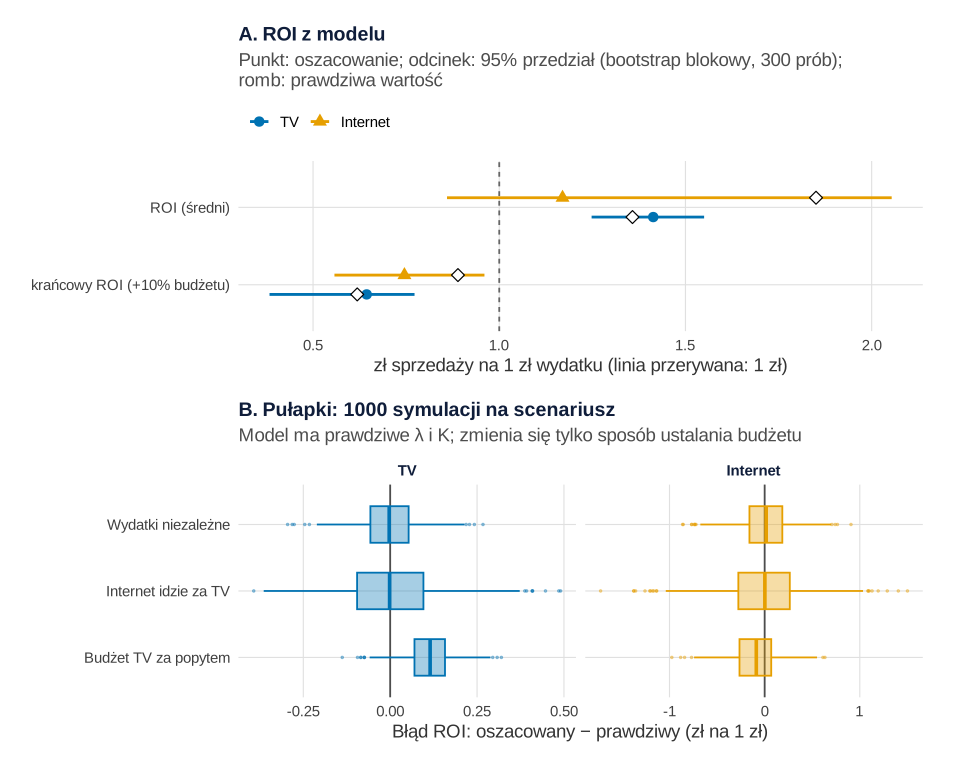
set.seed(617)).Co widać w panelu A. ROI TV wynosi 1.41, 95% CI [1.25, 1.55] (prawda: 1.36), a internetu 1.17, 95% CI [0.86, 2.05] (prawda: 1.85). Przedział internetu jest prawie cztery razy szerszy: λ TV wybrano jako 0.6 w 91.0% prób, a λ internetu od 0 do 0.4 (zero w 38.7%). Ważniejsze dla decyzji: średni ROI TV przekracza 1, a krańcowy wynosi 0.64, 95% CI [0.38, 0.77]. Kolejny złoty na TV przynosi około 64 gr sprzedaży. Dla internetu krańcowy ROI to 0.75 [0.56, 0.96].
Co widać w panelu B. Tu model zna prawdziwe λ i K, a do sprzedaży dochodzi popyt, którego model nie widzi (np. pogoda). Każdy scenariusz powtórzono 1000 razy:
- Wydatki niezależne: średni błąd ROI TV −0.004 (błąd Monte Carlo 0.003), SD = 0.082 – bez obciążenia.
- Internet idzie za TV (internet dostaje ¼ budżetu TV plus drobne kwoty, korelacja przekształconych wydatków r = .86): nadal bez obciążenia, ale SD błędu TV rośnie do 0.144, a internetu z 0.272 do 0.437. To współliniowość: model nie wie, któremu kanałowi przypisać wspólny wzrost. Usuwanie jednego kanału zmienia pytanie (wysoki VIF – co zrobić); Vanhove (2021) przypomina, że współliniowość to nie choroba, którą trzeba leczyć. Pomaga dopiero inna zmienność w danych.
- Budżet TV za popytem (planista dokłada TV, gdy spodziewa się wyższej sprzedaży): ROI TV zawyżony średnio o 0.113 zł (błąd MC 0.002), a ROI internetu zaniżony o 0.093. Popyt jest zmienną zakłócającą – wpływa i na budżet, i na sprzedaż.
Jak może zmylić. Wąski przedział nie chroni przed obciążeniem: w trzecim scenariuszu błąd ma SD = 0.066, a przesunięcie 0.113. Gordon i in. (2019) pokazali, że metody obserwacyjne często nie odtwarzają efektów reklamy zmierzonych w randomizowanych eksperymentach.
Podpis do pracy:
Co z tym zrobić w marketingu
- Nie zwiększaj TV na ślepo. Krańcowy ROI 0.64 to przychód, nie zysk, więc dodatkowy złoty na TV w krótkim okresie się nie zwraca. Lepiej rozłożyć budżet na więcej tygodni niż podnosić szczyty kampanii.
- Zmierz internet eksperymentem. Przedział [0.86, 2.05] nie wystarcza do decyzji. Wyłącz reklamę w losowo wybranych regionach (test A/B na poziomie regionów, analiza różnicy w różnicach) i użyj wyniku do sprawdzenia modelu.
- Planuj kanały w różnych tygodniach. Akcje internetowe poza kampaniami TV dają danym zmienność, z której model rozdzieli kanały.
- Zapisuj, dlaczego zmieniono budżet („dokładamy, bo zapowiadają upały”) – to zmienna do modelu.
- Sprawdzaj model w czasie. Co kwartał porównaj prognozę z wykonaniem (MAE, RMSE, MAPE). Efekt rabatów opłaca się zbadać osobno (elastyczność cenowa), a efekt na świadomość marki – badaniem brand lift.
Inne projekty opisuje wpis statystyka w pracy z marketingu.
Jak opisać w pracy
W Wynikach podaj tabelę wkładów i ROI:
| Kanał | Wydatek (mln zł) | Wkład (mln zł) | Udział w sprzedaży (%) | ROI [95% CI] | Krańcowy ROI [95% CI] |
|---|---|---|---|---|---|
| TV | 5.73 | 8.09 | 12.0 | 1.41 [1.25, 1.55] | 0.64 [0.38, 0.77] |
| Internet | 2.11 | 2.47 | 3.7 | 1.17 [0.86, 2.05] | 0.75 [0.56, 0.96] |
W Dyskusji napisz wprost, że MMM to analiza danych obserwacyjnych: wkład kanału jest oszacowaniem przyczynowym tylko wtedy, gdy budżet nie zależał od czynników, których w modelu brak.
Kod R wszystkich rysunków
Kod odtwarza wszystkie liczby z tekstu i sześć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 definiuje paletę, motyw oraz funkcje adstock() i nasycenie(), przepis 2 tworzy dane, a przepis 3 – model. Przepisy z rysunkami kończą się nazwą wykresu (p1–p6), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p6, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Każdy blok, który losuje (przepisy 2, 6 i 7), zaczyna od własnego set.seed(617); ziarno ustalono raz i nie zmieniano go. Ręcznie ustalono: prawdziwe parametry modelu (λ, K, β obu kanałów, efekt rabatu 3 tys. zł na punkt procentowy, stała 320, trend 0.4 tys. zł na tydzień, amplitudy sezonu 55 i 15, zakłócenia AR(1) z φ = 0.3 i SD = 16), harmonogram kampanii (4 kampanie TV rocznie po 4–6 tygodni i 70–130 tys. zł, 10 akcji internetowych po 30 tys. zł, 8% budżetu TV w internecie, 22 tygodnie rabatu 10–20%), siatkę λ i K, długość bloku (8 tygodni), liczbę prób bootstrapowych (300) i symulacji (1000) oraz scenariusze z przepisu 7 (popyt AR(1) z φ = 0.6, TV × (1 + popyt/25), internet = ¼ budżetu TV). Po pierwszych próbach zmieniliśmy dwie rzeczy, nie zmieniając ziarna: wydatki internetowe dostały własne akcje i spadły prawie do zera poza nimi (wcześniej rosły razem z TV i nigdy nie spadały do zera, więc trudno je było odróżnić od TV i od stałej modelu), a reakcję budżetu TV na popyt wzmocniliśmy z popyt/40 do popyt/25, żeby obciążenie było wyraźne. Przepis 2 zapisuje dane do pliku CSV w katalogu roboczym. Przepis 6 liczy się około 35 sekund, reszta – po kilka sekund.
1. Schemat adstocku i nasycenia: Rysunek 1
R
# Rysunek 1. Schemat MMM: wydatek -> adstock -> nasycenie -> wkład w sprzedaż (grafika z prostokątów, linii i tekstu)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c("Baza" = "#D9D9D9", "Promocje" = "#009E73", "Internet" = "#E69F00", "TV" = "#0072B2")
motyw <- theme_minimal(base_size = 14) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a", hjust = 0), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Dwie funkcje, na których stoi cały model
adstock <- function(x, lambda) as.numeric(stats::filter(x, lambda, method = "recursive"))  # A_t = x_t + λ·A_(t−1)
nasycenie <- function(a, K) a / (a + K)              # 0 przy a = 0, 1/2 przy a = K, dąży do 1

# Jedna 4-tygodniowa kampania TV po 100 tys. zł i jej droga do sprzedaży (λ = 0.6, K = 120, β = 150)
x <- c(0, 100, 100, 100, 100, rep(0, 7)); tyg <- seq_along(x)
a <- adstock(x, 0.6); wklad <- 150 * nasycenie(a, 120)
round(rbind(wydatek = x, adstock = a, wklad = wklad), 1)

# Każde pole ma szerokość 1 (od b do b + 1), a mini-wykres jest przeskalowany do jego wnętrza
pole <- function(b, xx, yy, ymax, xmax = max(xx)) data.frame(x = b + 0.08 + 0.84 * (xx - min(xx)) / (xmax - min(xx)),
                                                              y = 0.18 + 0.62 * yy / ymax)
b0 <- c(0, 1.3, 2.6, 3.9)                                              # lewe krawędzie czterech pól
slupki <- function(b, h, ymax) { d <- pole(b, tyg, h, ymax); w <- 0.84 / length(tyg) * 0.4
  data.frame(xmin = d$x - w, xmax = d$x + w, ymin = 0.18, ymax = d$y) }
k1 <- slupki(b0[1], x, 300); k2 <- slupki(b0[2], x, 300); l2 <- pole(b0[2], tyg, a, 300)
aa <- seq(0, 600, 5); l3 <- pole(b0[3], aa, nasycenie(aa, 120), 1)
pol <- pole(b0[3], c(0, 120, 120), c(0.5, 0.5, 0), 1, xmax = 600)    # linie do punktu „połowa efektu”
k4 <- slupki(b0[4], wklad, 150)
teksty <- data.frame(x = b0 + 0.5, y = 0.07, label = c(
  "Ile wydano na TV\nw danym tygodniu (tys. zł)", "A = wydatek + λ · A z zeszłego\ntygodnia; λ = 0.6: zostaje 60%",
  "f(A) = A / (A + K)\nprzy A = K połowa efektu", "Wkład = β · f(A)\nβ: maks. efekt na tydzień"))
tytuly <- data.frame(x = b0 + 0.04, y = 0.92, label = c("1. Wydatek", "2. Adstock (pamięć)",
                                                         "3. Nasycenie", "4. Wkład w sprzedaż"))
p1 <- ggplot() +
  geom_rect(aes(xmin = b0, xmax = b0 + 1, ymin = 0.13, ymax = 1), fill = "white", colour = "grey70", linewidth = 0.6) +
  geom_rect(data = k1, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax), fill = kol[["TV"]]) +
  geom_rect(data = k2, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax), fill = "grey80") +
  geom_line(data = l2, aes(x, y), colour = kol[["TV"]], linewidth = 1.1) +
  geom_point(data = l2, aes(x, y), colour = kol[["TV"]], size = 1.8) +
  geom_path(data = pol, aes(x, y), colour = "grey45", linetype = "22") +
  geom_line(data = l3, aes(x, y), colour = kol[["TV"]], linewidth = 1.1) +
  geom_rect(data = k4, aes(xmin = xmin, xmax = xmax, ymin = ymin, ymax = ymax), fill = kol[["Internet"]]) +
  annotate("segment", x = b0[1:3] + 1.03, xend = b0[2:4] - 0.03, y = 0.55, yend = 0.55, colour = "#0f1d3a",
           linewidth = 0.9, arrow = arrow(length = unit(0.22, "cm"), type = "closed")) +
  geom_text(data = tytuly, aes(x, y, label = label), hjust = 0, fontface = "bold", size = 4.6, colour = "#0f1d3a") +
  geom_text(data = teksty, aes(x, y, label = label), size = 3.9, lineheight = 0.95, colour = "grey15", vjust = 1) +
  coord_cartesian(xlim = c(-0.02, 4.92), ylim = c(-0.12, 1.02), expand = FALSE) +
  labs(title = "Jak model MMM zamienia wydatek na reklamę w sprzedaż",
       subtitle = "Jedna kampania TV: 4 tygodnie po 100 tys. zł; λ = 0.6, K = 120, β = 150 tys. zł") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("mmm-schemat-wydatek-adstock-nasycenie.svg", p1, width = 10, height = 4.6)
Wynik w R
        [,1]  [,2]  [,3] [,4]  [,5]  [,6] [,7] [,8] [,9] [,10] [,11] [,12]
wydatek    0 100.0 100.0  100 100.0   0.0  0.0  0.0  0.0   0.0   0.0   0.0
adstock    0 100.0 160.0  196 217.6 130.6 78.3 47.0 28.2  16.9  10.2   6.1
wklad      0  68.2  85.7   93  96.7  78.2 59.2 42.2 28.5  18.5  11.7   7.2
2. Dane: Rysunek 2
R
# Rysunek 2. Trzy lata tygodniowych danych fikcyjnego producenta soków: sprzedaż, wydatki na TV i internet, rabaty
# (korzysta z kol, motyw, adstock() i nasycenie() z przepisu 1)
library(ggplot2)
library(patchwork)

set.seed(617)                                     # ziarno ustalone raz, bez dobierania pod wynik
n <- 156                                          # tygodnie od 2 stycznia 2023 do końca 2025
tydzien <- 1:n
data <- seq(as.Date("2023-01-02"), by = "week", length.out = n)
tr <- (tydzien - 1) %% 52 + 1                     # tydzień roku
# TV: co roku 4 kampanie po 4–6 tygodni (zima, wiosna, lato, jesień), 70–130 tys. zł tygodniowo
tv <- numeric(n)
for (rok in 0:2) {
  starty <- rok * 52 + c(sample(6:10, 1), sample(16:20, 1), sample(25:29, 1), sample(40:44, 1))
  for (s in starty) { d <- sample(4:6, 1); tv[s:(s + d - 1)] <- round(runif(d, 70, 130)) }
}
# Internet: 10 własnych akcji po 4 tygodnie (+30 tys. zł), drobne wydatki stałe i 8% budżetu TV w tygodniu kampanii
internet <- numeric(n)
for (s in sample(1:(n - 3), 10)) internet[s:(s + 3)] <- internet[s:(s + 3)] + 30
internet <- round(0.08 * tv + internet + rgamma(n, 2, 2 / 3), 1)
# Promocje cenowe: 22 losowe tygodnie z rabatem 10, 15 albo 20%
rabat <- numeric(n); w <- sample(n, 22); rabat[w] <- sample(c(10, 15, 20), 22, replace = TRUE)

# Prawdziwy model (parametry ustawione ręcznie; znamy je tylko dlatego, że dane są fikcyjne)
prawda <- c(lambda_tv = 0.6, K_tv = 120, beta_tv = 150, lambda_int = 0.2, K_int = 20, beta_int = 70, rabat = 3)
sezon <- 55 * sin(2 * pi * (tr - 14) / 52) + 15 * cos(4 * pi * tr / 52)   # szczyt latem
wklad_tv <- prawda[["beta_tv"]] * nasycenie(adstock(tv, prawda[["lambda_tv"]]), prawda[["K_tv"]])
wklad_int <- prawda[["beta_int"]] * nasycenie(adstock(internet, prawda[["lambda_int"]]), prawda[["K_int"]])
wklad_rabat <- prawda[["rabat"]] * rabat          # 3 tys. zł na każdy punkt procentowy rabatu, bez efektu opóźnionego
baza <- 320 + 0.4 * tydzien + sezon               # trend i sezonowość
szum <- as.numeric(arima.sim(list(ar = 0.3), n, sd = 16))  # zakłócenia lekko zależne w czasie
sprzedaz <- round(baza + wklad_tv + wklad_int + wklad_rabat + szum, 1)
mmm <- data.frame(tydzien, data, sprzedaz_tys_zl = sprzedaz, tv_tys_zl = tv, internet_tys_zl = internet,
                  rabat_proc = rabat, prawdziwy_wklad_tv = round(wklad_tv, 2),
                  prawdziwy_wklad_internet = round(wklad_int, 2))
write.csv(mmm, "mmm-sprzedaz-tygodniowa.csv", row.names = FALSE)

# Opis danych: sumy, tygodnie z kampanią, korelacje i prawdziwy ROI (przychód na 1 zł wydatku)
c(sprzedaz_mln = sum(sprzedaz) / 1000, tv_mln = sum(tv) / 1000, internet_mln = sum(internet) / 1000,
  tygodnie_z_tv = sum(tv > 0), tygodnie_z_rabatem = sum(rabat > 0))
round(cor(cbind(sprzedaz, tv, internet, rabat, sezon)), 2)
prawdziwy_roi <- c(TV = sum(wklad_tv) / sum(tv), Internet = sum(wklad_int) / sum(internet))
round(prawdziwy_roi, 2)
round(100 * c(TV = sum(wklad_tv), Internet = sum(wklad_int), Promocje = sum(wklad_rabat)) / sum(sprzedaz), 1)

# Rysunek: trzy panele z jedną osią czasu; szare tło = tygodnie kampanii TV
kampanie <- data.frame(od = data[tv > 0] - 3.5, do = data[tv > 0] + 3.5)
tlo <- geom_rect(data = kampanie, aes(xmin = od, xmax = do, ymin = -Inf, ymax = Inf), inherit.aes = FALSE,
                 fill = "grey90")
os_x <- scale_x_date(date_breaks = "6 months", date_labels = "%m.%Y", expand = expansion(add = 7))
pa <- ggplot(mmm, aes(data, sprzedaz_tys_zl)) + tlo + geom_line(colour = "#0f1d3a", linewidth = 0.6) + os_x +
  labs(x = NULL, y = "tys. zł", title = "A. Sprzedaż tygodniowa",
       subtitle = "Szare tło: tygodnie kampanii TV") + motyw
media <- rbind(data.frame(data, kanal = "TV", wydatek = tv), data.frame(data, kanal = "Internet", wydatek = internet))
media$kanal <- factor(media$kanal, c("TV", "Internet"))
pb <- ggplot(media, aes(data, wydatek, colour = kanal, linetype = kanal)) + tlo + geom_step(linewidth = 0.6) + os_x +
  scale_colour_manual(values = kol[c("TV", "Internet")], name = NULL) +
  scale_linetype_manual(values = c("solid", "21"), name = NULL) +
  labs(x = NULL, y = "tys. zł", title = "B. Wydatki na reklamę") + motyw +
  theme(legend.position = "top", legend.justification = "left", legend.margin = margin(0, 0, 0, 0))
pc <- ggplot(mmm, aes(data, rabat_proc)) + tlo +
  geom_segment(aes(xend = data, yend = 0), colour = kol[["Promocje"]], linewidth = 0.8) +
  geom_point(data = subset(mmm, rabat_proc > 0), colour = kol[["Promocje"]], shape = 17, size = 2) + os_x +
  labs(x = NULL, y = "rabat (%)", title = "C. Promocje cenowe") + motyw
p2 <- pa / pb / pc + plot_layout(heights = c(1.3, 1, 0.6))
p2   # zapis: ggsave("mmm-dane-sprzedaz-wydatki.svg", p2, width = 10, height = 8)
Wynik w R
      sprzedaz_mln             tv_mln       internet_mln      tygodnie_z_tv
           67.3765             5.7270             2.1118            57.0000
tygodnie_z_rabatem
           22.0000
         sprzedaz    tv internet rabat sezon
sprzedaz     1.00  0.56     0.37  0.06  0.78
tv           0.56  1.00     0.19 -0.15  0.26
internet     0.37  0.19     1.00 -0.05  0.22
rabat        0.06 -0.15    -0.05  1.00 -0.05
sezon        0.78  0.26     0.22 -0.05  1.00
      TV Internet
    1.36     1.85
      TV Internet Promocje
    11.5      5.8      1.3
3. Model i siatka parametrów: Rysunek 3
R
# Rysunek 3. Dobór parametrów adstocku (λ) i nasycenia (K) siatką: dla każdej pary regresja, wybieramy najmniejszy błąd
# (korzysta z kol, motyw, adstock(), nasycenie() z przepisu 1 oraz danych z przepisu 2)
library(ggplot2)
library(patchwork)

# Część modelu bez reklamy: wyraz wolny, trend, sezonowość (dwie pary sinus–cosinus) i rabat
Z <- cbind(wyraz_wolny = 1, trend = tydzien, sin1 = sin(2 * pi * tr / 52), cos1 = cos(2 * pi * tr / 52),
           sin2 = sin(4 * pi * tr / 52), cos2 = cos(4 * pi * tr / 52), rabat = rabat)
# Siatka ustalona przed analizą: λ od 0 do 0.9 co 0.1, K na skali adstocku danego kanału
g_tv <- expand.grid(lambda = round(seq(0, 0.9, 0.1), 1), K = c(40, 80, 120, 180, 270, 400))
g_int <- expand.grid(lambda = round(seq(0, 0.9, 0.1), 1), K = c(5, 10, 20, 30, 45, 70))
F_tv <- sapply(seq_len(nrow(g_tv)), function(i) nasycenie(adstock(tv, g_tv$lambda[i]), g_tv$K[i]))
F_int <- sapply(seq_len(nrow(g_int)), function(j) nasycenie(adstock(internet, g_int$lambda[j]), g_int$K[j]))

# 60 × 60 = 3600 regresji; .lm.fit() to szybka wersja lm() bez tabel
dopasuj <- function(y) {
  bl <- matrix(NA, ncol(F_tv), ncol(F_int))       # błąd średniokwadratowy (RMSE, tys. zł) każdej pary
  for (i in seq_len(ncol(F_tv))) for (j in seq_len(ncol(F_int)))
    bl[i, j] <- sqrt(mean(.lm.fit(cbind(Z, F_tv[, i], F_int[, j]), y)$residuals^2))
  bl
}
rmse <- dopasuj(sprzedaz)
naj <- which(rmse == min(rmse), arr.ind = TRUE)
i_tv <- naj[1, 1]; j_int <- naj[1, 2]
rbind(TV = g_tv[i_tv, ], Internet = g_int[j_int, ])
c(rmse_min = round(min(rmse), 2), rmse_przy_prawdziwych = round(rmse[which(g_tv$lambda == 0.6 & g_tv$K == 120),
                                                                      which(g_int$lambda == 0.2 & g_int$K == 20)], 2))

# Model końcowy z wybranymi parametrami (SE nie uwzględniają doboru λ i K – niepewność daje bootstrap, przepis 6)
X <- cbind(Z[, -1], tv_f = F_tv[, i_tv], internet_f = F_int[, j_int])
model <- lm(sprzedaz ~ X)
round(summary(model)$coefficients, 3)
round(c(R2 = summary(model)$r.squared, autokorelacja_reszt_lag1 = acf(resid(model), plot = FALSE)$acf[2]), 3)

# Rysunek: RMSE wokół minimum w dwóch przekrojach siatki (drugi kanał na wybranych wartościach)
przekroj <- function(g, bl, prawd_l, prawd_K, kanal) {
  d <- data.frame(g, delta = bl - min(rmse), kanal = kanal)
  d$klasa <- cut(d$delta, c(-Inf, 0.25, 0.5, 1, 2, 4, Inf),
                 labels = c("< 0.25", "0.25–0.5", "0.5–1", "1–2", "2–4", "> 4"))
  d$prawda <- d$lambda == prawd_l & d$K == prawd_K
  d
}
d_tv <- przekroj(g_tv, rmse[, j_int], 0.6, 120, "A. TV (internet na wybranych wartościach)")
d_int <- przekroj(g_int, rmse[i_tv, ], 0.2, 20, "B. Internet (TV na wybranych wartościach)")
c(TV = sum(d_tv$delta < 0.25), Internet = sum(d_int$delta < 0.25))   # ile z 60 par jest „prawie tak samo dobrych”
mapa <- function(d, wyb) ggplot(d, aes(factor(lambda), factor(K), fill = klasa)) +
  geom_tile(colour = "white", linewidth = 0.6) +
  geom_point(data = subset(d, prawda), shape = 21, size = 6, stroke = 1.3, colour = "#D55E00", fill = NA,
             show.legend = FALSE) +
  geom_point(data = d[wyb, ], shape = 4, size = 3.8, stroke = 1.4, colour = "#0f1d3a", show.legend = FALSE) +
  scale_fill_viridis_d(option = "mako", direction = -1, drop = FALSE, name = "RMSE ponad minimum (tys. zł)",
                       guide = guide_legend(nrow = 1, title.position = "top")) +
  labs(x = "λ (adstock)", y = "K (nasycenie)", title = unique(d$kanal)) + motyw
p3 <- (mapa(d_tv, i_tv) + mapa(d_int, j_int) + guides(fill = "none")) + plot_layout(guides = "collect") +
  plot_annotation(title = "Siatka parametrów: jak bardzo rośnie błąd poza najlepszym punktem",
                  subtitle = "× = wybrane (najmniejszy RMSE), pomarańczowe kółko = prawdziwe parametry",
                  theme = motyw) &
  theme(legend.position = "bottom")
p3   # zapis: ggsave("mmm-siatka-parametrow.svg", p3, width = 10, height = 5.8)
Wynik w R
         lambda   K
TV          0.6 120
Internet    0.1  45
             rmse_min rmse_przy_prawdziwych
                16.25                 16.29
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  331.752      3.665  90.520    0.000
Xtrend         0.341      0.032  10.695    0.000
Xsin1         -5.181      2.098  -2.470    0.015
Xcos1        -55.549      2.131 -26.073    0.000
Xsin2         -0.575      1.939  -0.297    0.767
Xcos2         13.018      1.901   6.847    0.000
Xrabat         3.088      0.294  10.522    0.000
Xtv_f        156.154      5.936  26.305    0.000
Xinternet_f   76.725      8.904   8.617    0.000
                      R2 autokorelacja_reszt_lag1
                   0.953                    0.134
      TV Internet
       3       21
4. Krzywe oszacowane i prawdziwe: Rysunek 4
R
# Rysunek 4. Oszacowane i prawdziwe krzywe: pamięć reklamy (adstock) i nasycenie
# (korzysta z kol, motyw, nasycenie() z przepisu 1, prawda, tv, internet z przepisu 2 oraz g_tv, g_int, i_tv, j_int, model z przepisu 3)
library(ggplot2)
library(patchwork)

b <- coef(model)
oszac <- c(lambda_tv = g_tv$lambda[i_tv], K_tv = g_tv$K[i_tv], beta_tv = b[["Xtv_f"]],
           lambda_int = g_int$lambda[j_int], K_int = g_int$K[j_int], beta_int = b[["Xinternet_f"]], rabat = b[["Xrabat"]])
round(rbind(prawda, oszacowanie = oszac), 2)

# A. Ile z wydatku „pamięta” rynek po k tygodniach: λ^k
k <- 0:8
pam <- rbind(data.frame(k, kanal = "TV", wersja = "prawdziwe", w = prawda[["lambda_tv"]]^k),
             data.frame(k, kanal = "TV", wersja = "oszacowane", w = oszac[["lambda_tv"]]^k),
             data.frame(k, kanal = "Internet", wersja = "prawdziwe", w = prawda[["lambda_int"]]^k),
             data.frame(k, kanal = "Internet", wersja = "oszacowane", w = oszac[["lambda_int"]]^k))
# B. Wkład tygodniowy przy stałym wydatku s co tydzień: adstock ustala się na s / (1 − λ)
s <- seq(0, 150, 1)
krz <- function(kanal, wersja, l, K, beta) data.frame(s, kanal, wersja, wklad = beta * nasycenie(s / (1 - l), K))
nas <- rbind(krz("TV", "prawdziwe", prawda[["lambda_tv"]], prawda[["K_tv"]], prawda[["beta_tv"]]),
             krz("TV", "oszacowane", oszac[["lambda_tv"]], oszac[["K_tv"]], oszac[["beta_tv"]]),
             krz("Internet", "prawdziwe", prawda[["lambda_int"]], prawda[["K_int"]], prawda[["beta_int"]]),
             krz("Internet", "oszacowane", oszac[["lambda_int"]], oszac[["K_int"]], oszac[["beta_int"]]))
# Wkład przy typowym tygodniowym wydatku (mediana tygodni z wydatkiem > 5 tys. zł)
typowy <- c(TV = median(tv[tv > 5]), Internet = median(internet[internet > 5]))
round(typowy, 1)
round(sapply(split(nas, list(nas$wersja, nas$kanal)), function(d) d$wklad[d$s == round(typowy[[d$kanal[1]]])]), 1)

uklad <- list(scale_colour_manual(values = kol[c("TV", "Internet")], guide = "none"),
              scale_linetype_manual(values = c("prawdziwe" = "22", "oszacowane" = "solid"), name = NULL))
porzadek <- function(x) transform(x, kanal = factor(kanal, c("TV", "Internet")),
                                  wersja = factor(wersja, c("oszacowane", "prawdziwe")))
pam <- porzadek(pam); nas <- porzadek(nas)
# Etykiety kanałów wprost przy liniach (kolor nie jest jedynym nośnikiem informacji)
et_a <- data.frame(k = c(1.25, 2.1), w = c(0.62, 0.12), kanal = factor(c("TV", "Internet"), c("TV", "Internet")))
et_b <- data.frame(s = c(150, 150), wklad = c(124, 70), kanal = factor(c("TV", "Internet"), c("TV", "Internet")))
pa <- ggplot(pam, aes(k, 100 * w, colour = kanal, linetype = wersja)) +
  geom_line(linewidth = 0.9) + geom_point(data = subset(pam, wersja == "oszacowane"), aes(shape = kanal), size = 2.6) +
  geom_text(data = et_a, aes(k, 100 * w, label = kanal, colour = kanal), inherit.aes = FALSE, hjust = 0,
            fontface = "bold", size = 4.4) + uklad +
  scale_shape_manual(values = c(16, 17), guide = "none") + scale_x_continuous(breaks = k) +
  labs(x = "Tygodnie po wydatku", y = "Pozostały efekt (% tygodnia 0)", title = "A. Pamięć reklamy",
       subtitle = "λ^k: ile zostaje po k tygodniach") + motyw
rug <- rbind(data.frame(kanal = "TV", s = tv[tv > 5]), data.frame(kanal = "Internet", s = internet[internet > 5]))
rug$kanal <- factor(rug$kanal, c("TV", "Internet"))
pb <- ggplot(nas, aes(s, wklad, colour = kanal, linetype = wersja)) +
  geom_rug(data = rug, aes(x = s, colour = kanal), inherit.aes = FALSE, sides = "b", alpha = 0.5,
           length = unit(0.04, "npc")) +
  geom_line(linewidth = 0.9) +
  geom_text(data = et_b, aes(s, wklad, label = kanal, colour = kanal), inherit.aes = FALSE, hjust = 1,
            fontface = "bold", size = 4.4) + uklad +
  labs(x = "Stały wydatek co tydzień (tys. zł)", y = "Wkład w sprzedaż (tys. zł/tydz.)", title = "B. Nasycenie",
       subtitle = "Kreski przy osi: tygodnie z wydatkiem w danych") + motyw
p4 <- pa + pb + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p4   # zapis: ggsave("mmm-adstock-i-nasycenie-krzywe.svg", p4, width = 10, height = 5.4)
Wynik w R
            lambda_tv K_tv beta_tv lambda_int K_int beta_int rabat
prawda            0.6  120  150.00        0.2    20    70.00  3.00
oszacowanie       0.6  120  156.15        0.1    45    76.72  3.09
      TV Internet
    99.0     14.6
oszacowane.Internet  prawdziwe.Internet       oszacowane.TV        prawdziwe.TV
               20.7                33.9               105.2               101.0
5. Rozkład sprzedaży: Rysunek 5
R
# Rysunek 5. Rozkład sprzedaży na bazę, promocje, internet i TV (wykres warstwowy z modelu)
# (korzysta z kol, motyw z przepisu 1, danych z przepisu 2 oraz X, model, F_tv, F_int, i_tv, j_int z przepisu 3)
library(ggplot2)

b <- coef(model)
wk <- data.frame(TV = b[["Xtv_f"]] * F_tv[, i_tv], Internet = b[["Xinternet_f"]] * F_int[, j_int],
                 Promocje = b[["Xrabat"]] * rabat)
wk$Baza <- fitted(model) - rowSums(wk)            # wyraz wolny + trend + sezonowość
# Udział kanałów w sprzedaży (%) – z modelu i prawdziwy
udzialy <- rbind(model = 100 * colSums(wk) / sum(sprzedaz),
                 prawda = 100 * c(sum(wklad_tv), sum(wklad_int), sum(wklad_rabat), sum(baza)) / sum(sprzedaz))
round(udzialy, 1)
round(colSums(wk[c("TV", "Internet")]) / 1000, 2)        # wkład w mln zł (3 lata)

warstwy <- data.frame(data = rep(data, 4), kanal = factor(rep(names(kol), each = n), names(kol)),
                      wklad = c(wk$Baza, wk$Promocje, wk$Internet, wk$TV))
p5 <- ggplot(warstwy, aes(data, wklad, fill = kanal)) +
  geom_area(colour = "white", linewidth = 0.15, position = position_stack(reverse = TRUE)) +
  geom_line(data = data.frame(data, sprzedaz), aes(data, sprzedaz), inherit.aes = FALSE,
            colour = "#0f1d3a", linewidth = 0.35) +
  scale_fill_manual(values = kol, name = NULL, breaks = rev(names(kol))) +
  scale_x_date(date_breaks = "6 months", date_labels = "%m.%Y", expand = expansion(add = 7)) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.03))) +
  labs(x = NULL, y = "Sprzedaż (tys. zł/tydz.)", title = "Rozkład sprzedaży na źródła (z modelu)",
       subtitle = "Od dołu: baza, promocje, internet, TV; ciemna linia: sprzedaż obserwowana") + motyw
p5   # zapis: ggsave("mmm-rozklad-sprzedazy-warstwy.svg", p5, width = 10, height = 5.4)
Wynik w R
         TV Internet Promocje Baza
model  12.0      3.7      1.3 83.0
prawda 11.5      5.8      1.3 81.4
      TV Internet
    8.09     2.47
6. ROI, krańcowy ROI i bootstrap blokowy
R
# ROI i krańcowy ROI z niepewnością: bootstrap blokowy reszt z ponownym doborem λ i K w każdej próbie (Rysunek 6A)
# (korzysta z adstock(), nasycenie() z przepisu 1, danych z przepisu 2 oraz Z, X, model, dopasuj(), F_tv, F_int, g_tv, g_int z przepisu 3)

# ROI = wkład kanału / wydatek; krańcowy ROI = dodatkowa sprzedaż z +10% wydatku w każdym tygodniu / dodatkowy wydatek
roi <- function(beta_tv, i, beta_int, j) {
  w_tv <- beta_tv * F_tv[, i]; w_int <- beta_int * F_int[, j]
  w_tv10 <- beta_tv * nasycenie(adstock(1.1 * tv, g_tv$lambda[i]), g_tv$K[i])
  w_int10 <- beta_int * nasycenie(adstock(1.1 * internet, g_int$lambda[j]), g_int$K[j])
  c(ROI_TV = sum(w_tv) / sum(tv), ROI_Internet = sum(w_int) / sum(internet),
    mROI_TV = sum(w_tv10 - w_tv) / (0.1 * sum(tv)), mROI_Internet = sum(w_int10 - w_int) / (0.1 * sum(internet)))
}
b <- coef(model)
roi_model <- roi(b[["Xtv_f"]], i_tv, b[["Xinternet_f"]], j_int)
# Te same miary z prawdziwych parametrów (indeksy prawdziwych λ i K w siatce)
i0 <- which(g_tv$lambda == 0.6 & g_tv$K == 120); j0 <- which(g_int$lambda == 0.2 & g_int$K == 20)
roi_prawda <- roi(prawda[["beta_tv"]], i0, prawda[["beta_int"]], j0)
round(rbind(model = roi_model, prawda = roi_prawda), 2)

# Bootstrap blokowy: reszty modelu losujemy blokami po 8 kolejnych tygodni (zachowuje zależność w czasie),
# dokładamy do dopasowanych wartości i powtarzamy CAŁY dobór siatką – tak niepewność λ i K trafia do przedziału
set.seed(617)
B <- 300; L <- 8
dop <- fitted(model); e <- resid(model)
boot <- t(replicate(B, {
  starty <- sample(1:(n - L + 1), ceiling(n / L), replace = TRUE)
  y_b <- dop + e[as.vector(sapply(starty, function(s) s:(s + L - 1)))[1:n]]
  bl <- dopasuj(y_b); ij <- which(bl == min(bl), arr.ind = TRUE)[1, ]
  cf <- .lm.fit(cbind(Z, F_tv[, ij[1]], F_int[, ij[2]]), y_b)$coefficients
  c(roi(cf[8], ij[1], cf[9], ij[2]), lambda_tv = g_tv$lambda[ij[1]], lambda_int = g_int$lambda[ij[2]])
}))
przedzialy <- data.frame(miara = names(roi_model), oszacowanie = roi_model, prawda = roi_prawda,
                         dolna = apply(boot[, 1:4], 2, quantile, 0.025), gorna = apply(boot[, 1:4], 2, quantile, 0.975))
print(transform(przedzialy, oszacowanie = round(oszacowanie, 2), prawda = round(prawda, 2),
                dolna = round(dolna, 2), gorna = round(gorna, 2)), row.names = FALSE)
round(100 * prop.table(table(lambda_tv = boot[, "lambda_tv"])), 1)       # jak często wybrano dane λ TV
round(100 * prop.table(table(lambda_internet = boot[, "lambda_int"])), 1)
Wynik w R
       ROI_TV ROI_Internet mROI_TV mROI_Internet
model    1.41         1.17    0.64          0.75
prawda   1.36         1.85    0.62          0.89
         miara oszacowanie prawda dolna gorna
        ROI_TV        1.41   1.36  1.25  1.55
  ROI_Internet        1.17   1.85  0.86  2.05
       mROI_TV        0.64   0.62  0.38  0.77
 mROI_Internet        0.75   0.89  0.56  0.96
lambda_tv
 0.5  0.6  0.7
 6.7 91.0  2.3
lambda_internet
   0  0.1  0.2  0.3  0.4
38.7 31.3 17.3 10.3  2.3
7. Symulacja pułapek: Rysunek 6
R
# Rysunek 6. A: ROI z 95% przedziałami z bootstrapu blokowego; B: 1000 symulacji trzech scenariuszy budżetu
# (korzysta z kol, motyw, adstock(), nasycenie() z przepisu 1, danych z przepisu 2, Z z przepisu 3 oraz przedzialy z przepisu 6)
library(ggplot2)
library(patchwork)

# Symulacja: ten sam prawdziwy model, ale do sprzedaży dochodzi popyt, którego model nie widzi (np. pogoda, wydarzenia).
# Model szacujemy z PRAWDZIWYMI λ i K – jedynym źródłem błędu jest sposób, w jaki ustalono budżet.
wklad <- function(x, l, K, beta) beta * nasycenie(adstock(x, l), K)
jedna <- function(scenariusz) {
  popyt <- as.numeric(arima.sim(list(ar = 0.6), n, sd = 13))
  tv_s <- tv; int_s <- internet
  if (scenariusz == "Internet idzie za TV") int_s <- round(0.25 * tv + rgamma(n, 2, 2 / 3), 1)
  if (scenariusz == "Budżet TV za popytem") tv_s <- round(pmax(0, tv * (1 + popyt / 25)))   # więcej TV, gdy popyt wyższy
  w_tv <- wklad(tv_s, 0.6, 120, 150); w_int <- wklad(int_s, 0.2, 20, 70)
  y <- 320 + 0.4 * tydzien + sezon + w_tv + w_int + 3 * rabat + popyt
  f_tv <- nasycenie(adstock(tv_s, 0.6), 120); f_int <- nasycenie(adstock(int_s, 0.2), 20)
  cf <- .lm.fit(cbind(Z, f_tv, f_int), y)$coefficients
  c(TV = (cf[8] * sum(f_tv) - sum(w_tv)) / sum(tv_s),            # błąd ROI = oszacowany − prawdziwy
    Internet = (cf[9] * sum(f_int) - sum(w_int)) / sum(int_s), r_tv_internet = cor(f_tv, f_int))
}
scen <- c("Wydatki niezależne", "Internet idzie za TV", "Budżet TV za popytem")
set.seed(617)
R <- 1000
sym <- do.call(rbind, lapply(scen, function(s) data.frame(scenariusz = s, t(replicate(R, jedna(s))))))
podsum <- aggregate(cbind(TV, Internet, r_tv_internet) ~ scenariusz, sym, function(x) c(sr = mean(x), sd = sd(x)))
podsum <- podsum[match(scen, podsum$scenariusz), ]
print(data.frame(scenariusz = podsum$scenariusz, round(podsum$TV, 3), round(podsum$Internet, 3),
                 r = round(podsum$r_tv_internet[, "sr"], 2)), row.names = FALSE)
round(podsum$TV[, "sd"] / sqrt(R), 3)            # błąd Monte Carlo średniego błędu ROI TV

# Panel A: ROI i krańcowy ROI z modelu (punkty), 95% przedziały z bootstrapu, prawdziwe wartości (romby)
pr <- transform(przedzialy, kanal = factor(ifelse(grepl("TV", miara), "TV", "Internet"), c("TV", "Internet")),
                rodzaj = factor(ifelse(grepl("^mROI", miara), "krańcowy ROI (+10% budżetu)", "ROI (średni)"),
                                c("ROI (średni)", "krańcowy ROI (+10% budżetu)")))
pa <- ggplot(pr, aes(oszacowanie, rodzaj, colour = kanal, shape = kanal, group = kanal)) +
  geom_vline(xintercept = 1, colour = "grey40", linetype = "22") +
  geom_pointrange(aes(xmin = dolna, xmax = gorna), position = position_dodge(0.5), size = 0.7, linewidth = 1) +
  geom_point(aes(x = prawda), position = position_dodge(0.5), shape = 23, size = 3.2, fill = "white",
             colour = "black", show.legend = FALSE) +
  scale_colour_manual(values = kol[c("TV", "Internet")], name = NULL) +
  scale_shape_manual(values = c(16, 17), name = NULL) + scale_y_discrete(limits = rev) +
  labs(x = "zł sprzedaży na 1 zł wydatku (linia przerywana: 1 zł)", y = NULL, title = "A. ROI z modelu",
       subtitle = "Punkt: oszacowanie; odcinek: 95% przedział (bootstrap blokowy, 300 prób);\nromb: prawdziwa wartość") +
  motyw + theme(legend.position = "top", legend.justification = "left")
# Panel B: rozkład błędu oszacowania ROI w 1000 symulacjach każdego scenariusza, osobno dla TV i internetu
sd_long <- rbind(data.frame(scenariusz = sym$scenariusz, kanal = "TV", blad = sym$TV),
                 data.frame(scenariusz = sym$scenariusz, kanal = "Internet", blad = sym$Internet))
sd_long$kanal <- factor(sd_long$kanal, c("TV", "Internet"))
sd_long$scenariusz <- factor(sd_long$scenariusz, rev(scen))
pb <- ggplot(sd_long, aes(blad, scenariusz, fill = kanal, colour = kanal)) +
  geom_vline(xintercept = 0, colour = "grey30") +
  geom_boxplot(alpha = 0.35, outlier.size = 0.6, outlier.alpha = 0.4, width = 0.55, show.legend = FALSE) +
  facet_wrap(~ kanal, scales = "free_x") +
  scale_fill_manual(values = kol[c("TV", "Internet")]) + scale_colour_manual(values = kol[c("TV", "Internet")]) +
  labs(x = "Błąd ROI: oszacowany − prawdziwy (zł na 1 zł)", y = NULL, title = "B. Pułapki: 1000 symulacji na scenariusz",
       subtitle = "Model ma prawdziwe λ i K; zmienia się tylko sposób ustalania budżetu") + motyw
p6 <- pa / pb + plot_layout(heights = c(0.8, 1))
p6   # zapis: ggsave("mmm-roi-bootstrap-i-pulapki.svg", p6, width = 10, height = 8)
Wynik w R
           scenariusz     sr    sd   sr.1  sd.1    r
   Wydatki niezależne -0.004 0.082  0.012 0.272 0.32
 Internet idzie za TV  0.002 0.144 -0.007 0.437 0.86
 Budżet TV za popytem  0.113 0.066 -0.093 0.253 0.29
[1] 0.003 0.005 0.002
8. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("TV – Internet" = c("#0072B2", "#E69F00"), "TV – Promocje" = c("#0072B2", "#009E73"),
             "Internet – Promocje" = c("#E69F00", "#009E73"), "Promocje – Baza" = c("#009E73", "#D9D9D9"),
             "Internet – Baza" = c("#E69F00", "#D9D9D9"), "TV – Baza" = c("#0072B2", "#D9D9D9"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                 widzenie_typowe deuteranopia protanopia
TV – Internet                              120.2        121.5      109.3
TV – Promocje                               70.1         55.4       58.0
Internet – Promocje                         88.7         66.3       51.5
Promocje – Baza                             55.6         32.2       32.3
Internet – Baza                             78.1         74.5       72.7
TV – Baza                                   58.1         62.0       53.4
czerwony – zielony (do unikania)           121.7         21.1       31.6
Bibliografia oprogramowania
Wyniki na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3. Losowanie danych, adstock (stats::filter()), regresje (lm(), .lm.fit()) i autokorelacja reszt (acf()) – pakiet stats z podstawowej instalacji R. Rysunki wykonano w pakiecie ggplot2 (skala kolorów mapy ciepła – pakiet viridisLite), panele złożono pakietem patchwork i zapisano pakietem svglite, a paletę sprawdzono pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- viridisLite (wersja 0.4.3): Garnier, S., Ross, N., Rudis, R., Camargo, P. A., Sciaini, M., & Scherer, C. (2026). viridis(Lite): Colorblind-friendly color maps for R [Computer software]. https://doi.org/10.5281/zenodo.4678326
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Budżet pod oczekiwaną sprzedaż. Model przypisze reklamie zasługi popytu (rysunek 6B); Lewis i Rao (2015) nazywają obciążenie z targetowania reklamy poważnym problemem metod obserwacyjnych, a w ich 25 eksperymentach terenowych mediana szerokości przedziału ufności ROI przekraczała 100 punktów procentowych.
- Kanały zawsze razem. Współliniowe wydatki nie obciążają wyniku, ale go rozmywają (rysunek 6B).
- Brak sezonowości w modelu. Kampanie w szczycie sezonu przejmą efekt lata – korelacja sprzedaży z TV (.56) to nie efekt TV.
- Przedziały z
lm(). Pomijają dobór λ i K oraz autokorelację reszt; użyj bootstrapu blokowego z ponownym doborem. - Wkład poza zakresem danych. Krzywa nasycenia powyżej największego obserwowanego wydatku to założenie, nie wynik.
- Za dużo kanałów. Każdy ma dwa parametry kształtu, a 156 tygodni to mało – łącz drobne kanały.
- Model zamiast eksperymentu. Prawdziwe parametry znamy tylko w symulacji; w realnych danych sprawdź model eksperymentem.
Najczęstsze pytania
Co to jest marketing mix modeling (MMM)?
To regresja zagregowanej sprzedaży (zwykle tygodniowej) na wydatki na kanały marketingowe, promocje, trend i sezonowość. Wydatki wchodzą do modelu po przekształceniu adstockiem i funkcją nasycenia. Wynik to wkład każdego kanału w sprzedaż i zwrot z wydatków (ROI). W odróżnieniu od atrybucji MMM nie potrzebuje danych o ścieżkach pojedynczych klientów.
Co to jest adstock w reklamie?
Adstock opisuje pamięć reklamy: część efektu wydatku przechodzi na kolejne tygodnie. W wersji geometrycznej At = xt + λ·At−1, więc przy λ = 0.6 po tygodniu zostaje 60% efektu, a po dwóch 36%. Clarke (1976) wnioskował z przeglądu badań, że skumulowany efekt reklamy trwa miesiące, a nie lata.
Jak policzyć ROI z reklamy w modelu MMM?
ROI to wkład kanału w sprzedaż podzielony przez wydatek na ten kanał. Do decyzji o budżecie ważniejszy jest krańcowy ROI – ile da dodatkowy złoty. W przykładzie średni ROI TV wyniósł 1.41, a krańcowy 0.64, 95% CI [0.38, 0.77], bo kampanie były już w strefie nasycenia. ROI liczony od sprzedaży przelicz na zysk, uwzględniając marżę.
Jak dobrać parametry adstocku i nasycenia?
Najprościej siatką ustaloną przed analizą: dla każdej kombinacji λ i K dopasuj regresję i wybierz najmniejszy błąd. W przykładzie 3600 regresji trafiło w prawdziwe parametry TV, ale dla internetu 21 z 60 par było prawie równie dobrych. Niepewność doboru uwzględnij, powtarzając całą siatkę w każdej próbie bootstrapu blokowego.
Czy marketing mix modeling pokazuje przyczynowy efekt reklamy?
Tylko przy mocnych założeniach. Jeśli budżet zależał od oczekiwanej sprzedaży, model przypisze reklamie zasługi popytu – w symulacji ROI TV był wtedy zawyżony średnio o 0.113. Gordon i in. (2019) pokazali, że metody obserwacyjne często nie odtwarzają efektów z randomizowanych eksperymentów reklamowych, dlatego wnioski z MMM sprawdzaj eksperymentem.
Powiązane hasła
Przeczytaj też
Atrybucja kanałów: łańcuch Markowa
Ścieżki klientów biura podróży, graf przejść, efekt usunięcia i porównanie z ostatnim kliknięciem oraz z prawdziwym wpływem – z kodem R.
Czytaj →PoradnikKampania w jednym regionie – syntetyczna kontrola
16 regionów i kampania tylko w jednym: wagi bliźniaka, luka, testy placebo i porównanie z DiD – pięć rysunków z kodem R.
Czytaj →PoradnikPrognoza sprzedaży: sezonowość, święta i promocje
Sklep z zabawkami, trzy lata dziennych zamówień: STL, ETS i ARIMA z regresorami, MAE i MAPE na teście, przeciek danych i prognoza z przedziałami w R.
Czytaj →PoradnikCzęstotliwość kontaktu z reklamą
Serwis VOD: krzywa odpowiedzi z GAM, nasycenie i zmęczenie reklamą, pułapka aktywnych użytkowników, losowy limit wyświetleń i zysk – z kodem R.
Czytaj →PoradnikUdział w reklamie a udział w rynku (ESOV)
Osiem marek past do zębów: SOV, SOM i ESOV, regresja zmiany udziału, efekty stałe i symulacja, w której reklama nie działa, a wykres rośnie – z kodem R.
Czytaj →PoradnikPodział budżetu marketingowego
Szkoła programowania i cztery kanały reklamy: krzywe odpowiedzi, programowanie liniowe, krańcowy zwrot, 1000 losowań i pułapka ekstrapolacji – z kodem R.
Czytaj →Analizujesz skuteczność reklamy w pracy z marketingu?
Pomożemy przygotować dane tygodniowe, zbudować model z adstockiem i nasyceniem, policzyć ROI z przedziałami ufności i opisać ograniczenia – tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Clarke, D. G. (1976). Econometric measurement of the duration of advertising effect on sales. Journal of Marketing Research, 13(4), 345–357. https://doi.org/10.1177/002224377601300404
- Gordon, B. R., Zettelmeyer, F., Bhargava, N., & Chapsky, D. (2019). A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook. Marketing Science, 38(2), 193–225. https://doi.org/10.1287/mksc.2018.1135
- Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217–1241. https://doi.org/10.1214/aos/1176347265 ● Otwarty dostęp
- Lewis, R. A., & Rao, J. M. (2015). The unfavorable economics of measuring the returns to advertising. The Quarterly Journal of Economics, 130(4), 1941–1973. https://doi.org/10.1093/qje/qjv023
- Little, J. D. C. (1979). Aggregate advertising models: The state of the art. Operations Research, 27(4), 629–667. https://doi.org/10.1287/opre.27.4.629
- Sethuraman, R., Tellis, G. J., & Briesch, R. A. (2011). How well does advertising work? Generalizations from meta-analysis of brand advertising elasticities. Journal of Marketing Research, 48(3), 457–471. https://doi.org/10.1509/jmkr.48.3.457
- Vanhove, J. (2021). Collinearity isn’t a disease that needs curing. Meta-Psychology, 5. https://doi.org/10.15626/mp.2021.2548 ● Otwarty dostęp
Cytowania BibTeX
@article{clarke1976econometric, author={Clarke, Darral G.}, title={{Econometric measurement of the duration of advertising effect on sales}}, journal={Journal of Marketing Research}, year={1976}, volume={13}, number={4}, pages={345--357}, doi={10.1177/002224377601300404}}@article{gordon2019comparison, author={Gordon, Brett R. and Zettelmeyer, Florian and Bhargava, Neha and Chapsky, Dan}, title={{A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook}}, journal={Marketing Science}, year={2019}, volume={38}, number={2}, pages={193--225}, doi={10.1287/mksc.2018.1135}}@article{kunsch1989jackknife, author={Künsch, Hans R.}, title={{The jackknife and the bootstrap for general stationary observations}}, journal={The Annals of Statistics}, year={1989}, volume={17}, number={3}, pages={1217--1241}, doi={10.1214/aos/1176347265}}@article{lewis2015unfavorable, author={Lewis, Randall A. and Rao, Justin M.}, title={{The unfavorable economics of measuring the returns to advertising}}, journal={The Quarterly Journal of Economics}, year={2015}, volume={130}, number={4}, pages={1941--1973}, doi={10.1093/qje/qjv023}}@article{little1979aggregate, author={Little, John D. C.}, title={{Aggregate advertising models: The state of the art}}, journal={Operations Research}, year={1979}, volume={27}, number={4}, pages={629--667}, doi={10.1287/opre.27.4.629}}@article{sethuraman2011how, author={Sethuraman, Raj and Tellis, Gerard J. and Briesch, Richard A.}, title={{How well does advertising work? Generalizations from meta-analysis of brand advertising elasticities}}, journal={Journal of Marketing Research}, year={2011}, volume={48}, number={3}, pages={457--471}, doi={10.1509/jmkr.48.3.457}}@article{vanhove2021collinearity, author={Vanhove, Jan}, title={{Collinearity isn’t a disease that needs curing}}, journal={Meta-Psychology}, year={2021}, volume={5}, doi={10.15626/mp.2021.2548}}