Przykład: biuro podróży pyta „czy reklama coś zmieniła?”
Fikcyjne biuro podróży przez cztery tygodnie emituje reklamę wideo w aplikacji z krótkimi filmami. Grupa docelowa to 200 000 użytkowników. Dział marketingu pyta: czy po kampanii więcej osób zna markę, bierze ją pod uwagę i planuje u niej rezerwację? Sprzedaż wycieczek pojawi się dopiero za kilka miesięcy, więc efekt mierzy się ankietą. Takie badanie nazywa się brand lift (wzrost wskaźników marki).
Klucz to grupa kontrolna: przed startem platforma losowo odkłada 10% grupy docelowej i nie pokazuje jej reklamy. Po kampanii obie grupy dostają tę samą ankietę z trzema pytaniami „tak/nie”:
- świadomość – „Czy słyszałeś(-aś) o tym biurze podróży?”,
- rozważanie – „Czy wziąłbyś(-ęłabyś) je pod uwagę przy wyborze wyjazdu?”,
- intencja – „Czy planujesz rezerwację w tym biurze w ciągu 3 miesięcy?”.
Dane są fikcyjne, więc znamy prawdziwy efekt. Ręcznie ustaliliśmy przed pierwszym uruchomieniem: u osób, które zobaczyły reklamę, świadomość rośnie o 8 punktów procentowych (pp), rozważanie o 4 pp, a intencja o 1.5 pp. Reklamę widzi tylko część grupy testowej (częściej młodsi i zainteresowani podróżami). Odsetek odpowiedzi na ankietę zależy od wieku: 18% w wieku 18–29, 25% w wieku 30–44 i 32% w wieku 45–64. Ziarno 615 ustalono raz i nie zmieniano go. Jedną rzecz zmieniliśmy po pierwszym uruchomieniu (opis przy rysunku 5). Dane 12 000 zaproszonych osób pobierzesz jako badanie-brand-lift-ankieta.csv.
Rysunek 1: schemat badania
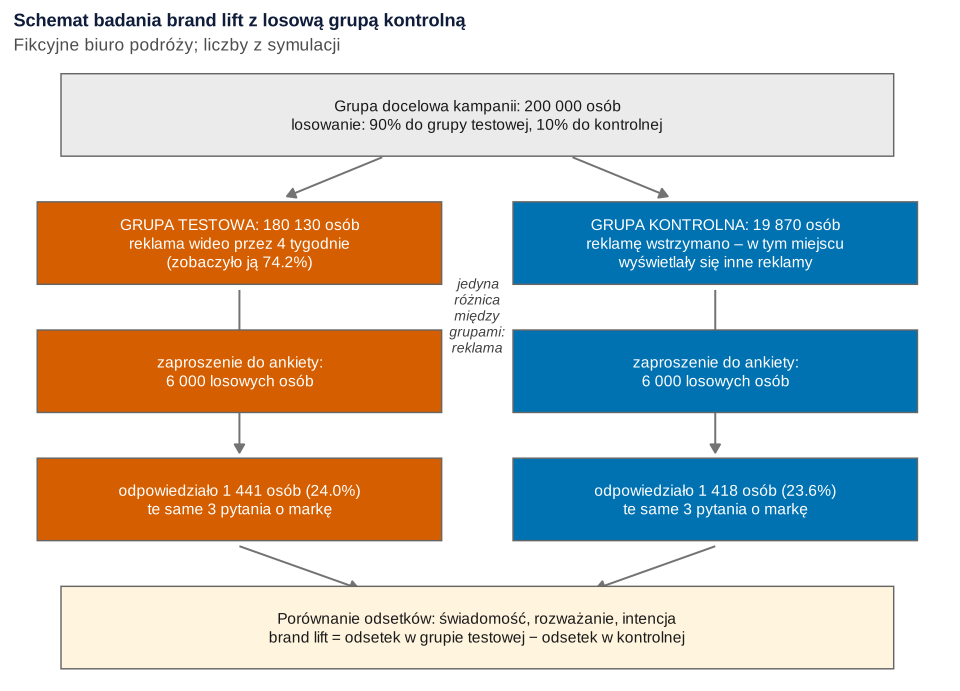
set.seed(615)).Co widać. Randomizacja dzieli 200 000 osób na grupę testową (180 130) i kontrolną (19 870). Reklamę zobaczyło 74.2% grupy testowej. Po kampanii każda grupa dostaje 6000 zaproszeń, a odpowiada 24.0% i 23.6%. Struktura wieku respondentów jest podobna (np. 25.5% i 26.4% osób w wieku 18–29). Grupy różnią się więc tylko reklamą, a różnica odsetków to jej efekt. To ten sam pomysł co test A/B – kontrolowany eksperyment najlepiej pokazuje, czy zmiana wpływa na zachowanie (Kohavi i in., 2009).
Jak może zmylić. Porównujemy osoby przydzielone do grup, a nie te, które reklamę widziały. Jedna czwarta grupy testowej jej nie zobaczyła, więc lift dotyczy „kampanii puszczonej na tę grupę”. To logika analizy ITT. Platformy potrafią też wskazać w grupie kontrolnej osoby, którym reklama zostałaby pokazana. Ta metoda „reklam-duchów” (ang. ghost ads) daje porównanie widzących z ich odpowiednikami i większą precyzję przy niższym koszcie (Johnson i in., 2017).
Podpis do pracy:
Zdanie do Metody:
Rysunek 2: odsetki w obu grupach
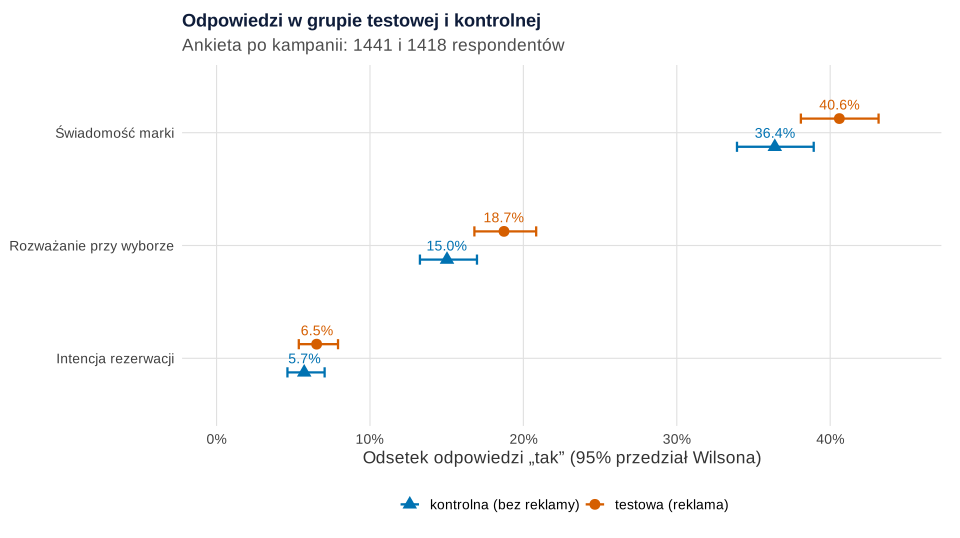
Co widać. Markę zna 40.6% grupy testowej, 95% CI [38.1, 43.2], i 36.4% kontrolnej [33.9, 38.9]. Rozważa ją 18.7% i 15.0%, a rezerwację planuje 6.5% i 5.7%. Przedziały to przedziały ufności dla proporcji metodą Wilsona – lepsze od prostego wzoru p ± 1.96 SE przy małych odsetkach. Jak margines błędu zależy od n, pokazuje wpis sondaż w obrazkach.
Jak może zmylić. Nakładanie się dwóch przedziałów nie rozstrzyga, czy grupy się różnią: przy świadomości przedziały zachodzą na siebie, a różnica jest istotna. Różnicę trzeba policzyć wprost (rysunek 3).
Podpis do pracy:
Rysunek 3: brand lift z przedziałem Newcombe’a
Brand lift to po prostu różnica dwóch odsetków:
Dla świadomości: 585 / 1441 − 516 / 1418 = 40.6% − 36.4% = 4.21 pp, czyli względnie +11.6%. Przedział dla różnicy liczymy metodą Newcombe’a, która łączy przedziały Wilsona obu grup. W porównaniu jedenastu metod dobrze trzymała poziom ufności i łatwo ją policzyć (Newcombe, 1998).
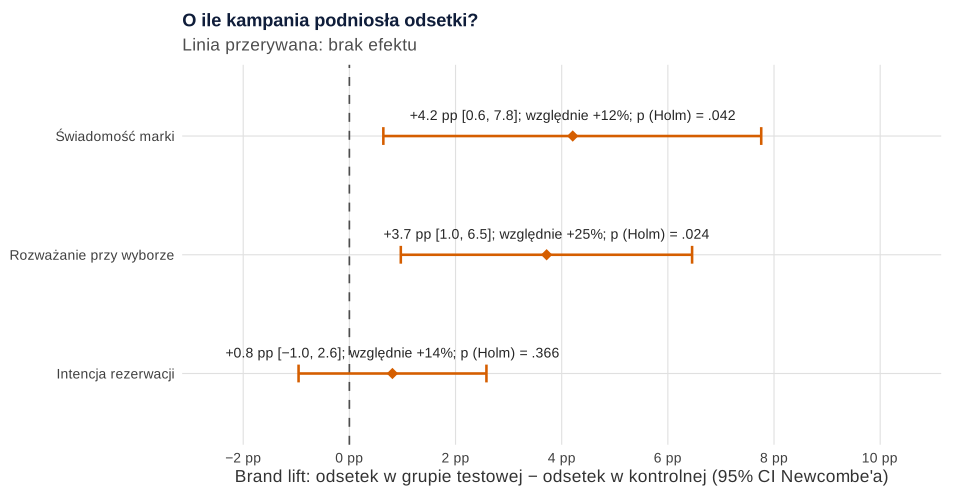
Co widać. Świadomość wzrosła o 4.21 pp, 95% CI [0.64, 7.76], a rozważanie o 3.72 pp [0.97, 6.46]. Lift intencji to 0.81 pp [−0.96, 2.58] – przedział obejmuje zero. Trzy pytania to trzy testy, więc p skorygowaliśmy poprawką Holma: .042, .024 i .366.
Jak może zmylić. Lift względny brzmi lepiej („+25% rozważania!”), ale zależy od poziomu wyjściowego. Podawaj oba. Brak istotności przy intencji nie dowodzi braku efektu: prawdziwy lift intencji w danych wynosi 1.11 pp, tylko próba jest za mała (rysunek 4). Prawdziwe lifty całej grupy testowej to 5.94, 2.97 i 1.11 pp. To efekty u widzących reklamę (8, 4 i 1.5 pp) „rozcieńczone” przez 25.8% osób, które jej nie zobaczyły. Dzieląc lift świadomości przez odsetek widzących wśród respondentów (73.77%), dostajemy szacunek efektu u widzących: 5.70 pp.
Pułapka: „widział vs nie widział”. Kusi, żeby w grupie testowej porównać osoby, które reklamę widziały, z tymi, które jej nie widziały. To już nie jest eksperyment. Platforma częściej pokazuje reklamę młodszym (rzadziej znają markę) i zainteresowanym podróżami (częściej znają). W całej grupie testowej takie porównanie daje 7.37 pp zamiast prawdziwych 8 pp. Tu kierunek błędu jest przypadkowy. W prawdziwych kampaniach reklamy trafiają celowo do osób bardziej skłonnych do zakupu, a obciążenie selekcyjne poważnie podważa metody obserwacyjne (Lewis i Rao, 2015). Na wielkich eksperymentach na Facebooku metody obserwacyjne często nie odtwarzały efektów z eksperymentów (Gordon i in., 2019).
Podpis do pracy:
Zdanie do Wyników:
Rysunek 4: ilu respondentów potrzeba na mały efekt
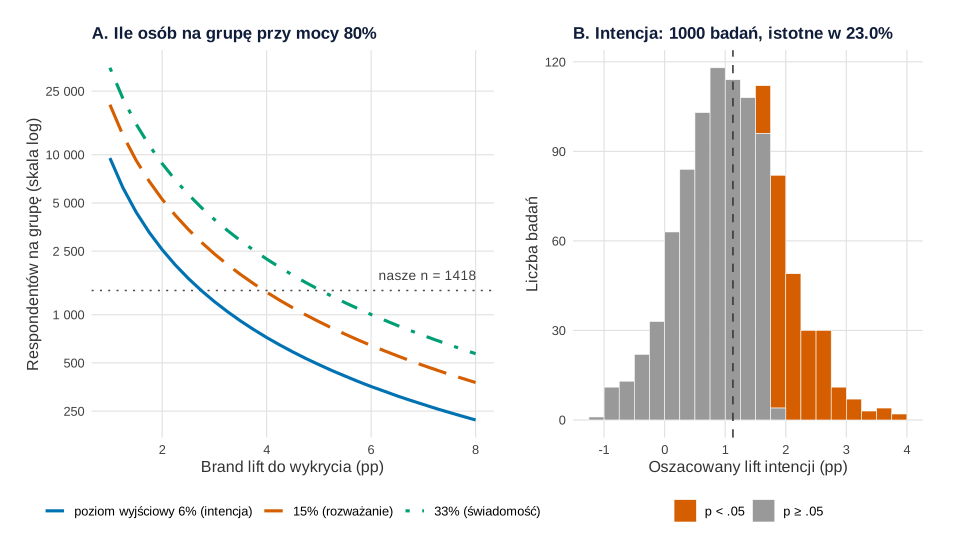
set.seed(615)).Co widać. Panel A: liczba respondentów na grupę potrzebna do wykrycia liftu z mocą 80% (α = .05, test dwustronny, power.prop.test()). Przy intencji na poziomie 6% lift 2 pp wymaga 2554 osób na grupę, a 1 pp – 9540. Przy świadomości około 33% te same różnice wymagają 8806 i 34 970 osób. Wykrycie liftu 1 pp wymaga więc łącznie od kilkunastu do kilkudziesięciu tysięcy ankiet.
Panel B: 1000 powtórzeń naszego badania tym samym schematem (6000 zaproszeń na grupę). Lift świadomości wyszedł istotny w 90.5% badań (błąd Monte Carlo 0.93 pp), rozważania w 55.3% (1.57 pp), a intencji tylko w 23.0% (1.33 pp). Średnia ze wszystkich badań dla intencji (1.13 pp) jest bliska prawdy. Średnia z samych istotnych wyników wynosi jednak 2.22 pp, dwa razy za dużo. Raportowanie tylko „udanych” kampanii zawyża efekty – więcej w mocy testu w obrazkach.
Jak może zmylić. Krzywe zakładają, że lift dotyczy całej grupy. Jeśli reklamę widzi tylko część grupy testowej, efekt w porównaniu grup maleje proporcjonalnie, a potrzebne n rośnie z kwadratem tej różnicy. Mierzenie efektów reklamy jest trudne nawet w eksperymentach na milionach osób, bo wynik na osobę mocno się waha (Lewis i Rao, 2015). Małe efekty to w reklamie norma: w 59 eksperymentach z reklamami politycznymi efekty perswazji były małe niezależnie od kontekstu, nadawcy i odbiorcy (Coppock i in., 2020).
Zdanie do Metody:
Rysunek 5: braki odpowiedzi różne w grupach
Losowanie chroni porównanie tylko do momentu ankiety. Odpowiada co czwarta zaproszona osoba. Jeśli w obu grupach odpowiadają „inni ludzie”, różnica odsetków przestaje mierzyć efekt reklamy – to błąd braku odpowiedzi. Sam niski odsetek odpowiedzi nie przesądza o obciążeniu; liczy się, czy odpowiadanie wiąże się z mierzoną cechą (Groves i Peytcheva, 2008). Zasymulowaliśmy trzy scenariusze, każdy 1000 razy. Wynik liczyliśmy bez wag i z wagami poststratyfikacyjnymi według wieku: strukturę wieku zaproszonych zna platforma.
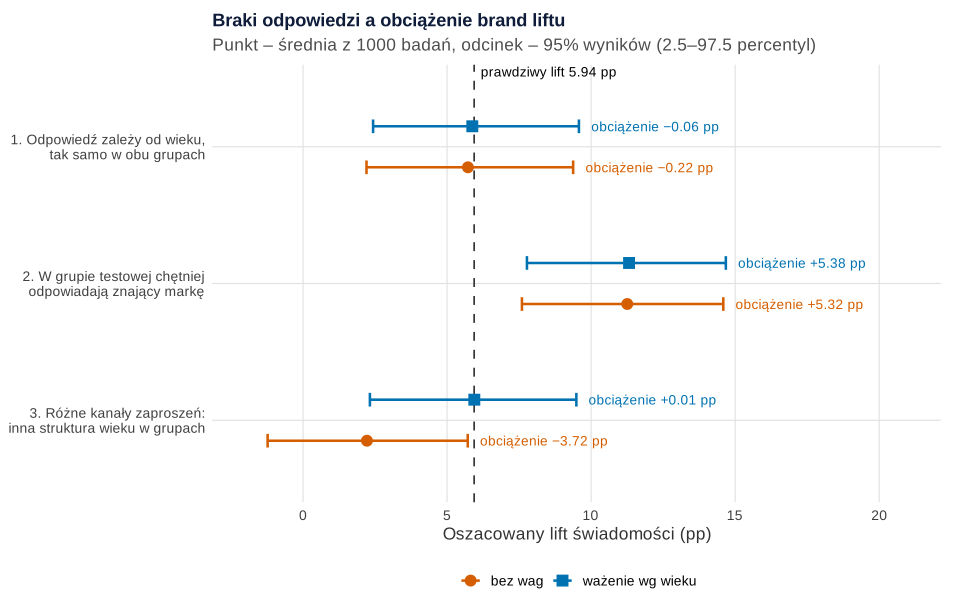
set.seed(615)).Co widać.
- Scenariusz 1 (odpowiedź zależy od wieku, tak samo w obu grupach): obciążenie −0.22 pp bez wag i −0.06 pp z wagami (błąd Monte Carlo 0.06 pp). Nieważony wynik opisuje respondentów, wśród których jest więcej starszych, rzadziej widzących reklamę.
- Scenariusz 2 (w grupie testowej osoby znające markę odpowiadają o 25% chętniej, np. bo zaproszenie pojawia się w miejscu reklamy): średni lift 11.26 pp zamiast 5.94. Ważenie wg wieku nie pomaga (+5.38 pp), bo brak odpowiedzi zależy od samej mierzonej cechy.
- Scenariusz 3 (grupa testowa zapraszana w aplikacji, gdzie chętniej odpowiadają młodsi, kontrolna e-mailem, gdzie chętniej odpowiadają starsi): bez wag lift spada do 2.22 pp (obciążenie −3.72 pp). Ważenie wg wieku przywraca 5.95 pp.
Jak może zmylić. Ważenie naprawia tylko to, co da się opisać zmiennymi ważącymi. Jak budować wagi i ile kosztują one w precyzji, opisuje wpis ważenie danych sondażowych. Mnożnik w scenariuszu 2 zmniejszyliśmy z 1.5 do 1.25 po pierwszym uruchomieniu: przy 1.5 obciążenie (+9.86 pp) przesłaniało pozostałe scenariusze. Wniosek się nie zmienił.
Podpis do pracy:
Co z tym zrobić w marketingu
- Kampania podniosła świadomość i rozważanie. W raporcie podaj lift w pp z przedziałem: świadomość +4.2 pp, prawdopodobnie między +0.6 a +7.8 pp.
- Intencja: „nie wiemy”, a nie „nie działa”. Przy 1418 osobach na grupę prawdziwy lift 1.11 pp wykrywało tylko 23.0% badań. Sprawdź go w danych o rezerwacjach albo w kolejnej kampanii z większą próbą.
- Grupę kontrolną zaplanuj przed startem. Bez niej zostaje porównanie „przed i po”, w którym miesza się sezon wakacyjny i działania konkurencji. Gdy losowanie osób jest niemożliwe, pomaga kampania w jednym regionie i syntetyczna kontrola, a zmianę między falami ocenia badanie trackingowe marki.
- Ten sam kanał i termin ankiety w obu grupach – inaczej grozi scenariusz 3. Wybierz z góry jeden wskaźnik główny i nie zaglądaj codziennie do wyników (pułapki testów A/B).
Jak opisać w pracy
W Metodzie opisz sposób losowania grupy kontrolnej i jej wielkość, czas kampanii, treść pytań, sposób zaproszenia, odsetek odpowiedzi w każdej grupie i metodę przedziałów. Przy planowaniu liczebności pomoże wpis test A/B – plan i analiza. W Wynikach podaj odsetki w grupach, lift w pp z 95% CI i p po korekcie. W Ograniczeniach napisz, że lift dotyczy osób przydzielonych do kampanii, a nie tylko tych, które ją widziały, i że wynik zależy od podobnego braku odpowiedzi w grupach.
Tabela wyników: wskaźnik, odsetek w grupie testowej i kontrolnej (z n), lift w pp z 95% CI, lift względny, p po korekcie. Inne przykłady z marketingu znajdziesz we wpisie statystyka w pracy z marketingu.
Kod R: dane, brand lift, liczebność i braki odpowiedzi
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę, motyw, funkcję symuluj() i dane, z których korzystają kolejne. Wystarczą pakiety ggplot2 i patchwork; odsetki, przedziały i testy liczy bazowy R (prop.test(), power.prop.test(), p.adjust()). Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1 (dane), 4 (1000 badań) i 5 (1000 badań na scenariusz); każdy zaczyna się od własnego set.seed(615). Ziarno 615 ustalono raz i nie zmieniano go. Ręcznie ustalono: 200 000 osób w grupie docelowej, podział 90/10, udziały wieku (.35, .40, .25), odsetki świadomości, rozważania i intencji bez kampanii według wieku, 30% osób zainteresowanych podróżami i ich wyższe odsetki, szansę zobaczenia reklamy (.80, .70, .55 według wieku, +.15 u zainteresowanych), efekt u widzących (8, 4 i 1.5 pp), 6000 zaproszeń na grupę, odsetki odpowiedzi według wieku (.18, .25, .32) i trzy scenariusze braku odpowiedzi; mnożnik w scenariuszu 2 zmniejszono z 1.5 do 1.25 po pierwszym uruchomieniu. Całość liczy się w około 20 sekund.
1. Paleta, dane i liczebności na etapach badania
R
# Fikcyjne biuro podróży: kampania wideo, grupa kontrolna wstrzymana losowo i ankieta po kampanii (dane symulowane)
library(ggplot2)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Parametry ustalone ręcznie (przed pierwszym uruchomieniem)
wieki <- c("18-29", "30-44", "45-64")
udzial_wieku <- c(.35, .40, .25)
p_swiad <- c(.22, .30, .38)        # świadomość marki bez kampanii, wg wieku
p_rozw <- c(.09, .12, .16)         # rozważanie (podzbiór świadomych)
p_int <- c(.035, .045, .055)       # intencja rezerwacji w ciągu 3 miesięcy (podzbiór rozważających)
zaint_bonus <- c(.15, .08, .03)    # o tyle wyżej u osób zainteresowanych podróżami (30% osób)
p_wid <- c(.80, .70, .55)          # szansa, że osoba z grupy testowej zobaczy reklamę, wg wieku
wid_bonus <- .15                   # platforma częściej pokazuje reklamę zainteresowanym
efekt <- c(.08, .04, .015)         # prawdziwy efekt u osób, które widziały reklamę (świadomość, rozważanie, intencja)
p_odp <- c(.18, .25, .32)          # odsetek odpowiedzi na ankietę wg wieku (tak samo w obu grupach)

symuluj <- function(n, grupa) {    # osoby z jednej grupy: wiek, zainteresowanie, ekspozycja i odpowiedzi
  wiek <- sample(1:3, n, replace = TRUE, prob = udzial_wieku)
  zaint <- rbinom(n, 1, .30)
  widzial <- if (grupa == "testowa") rbinom(n, 1, pmin(p_wid[wiek] + wid_bonus * zaint, .95)) else rep(0L, n)
  pS <- p_swiad[wiek] + zaint_bonus[1] * zaint + efekt[1] * widzial
  pR <- p_rozw[wiek] + zaint_bonus[2] * zaint + efekt[2] * widzial
  pI <- p_int[wiek] + zaint_bonus[3] * zaint + efekt[3] * widzial
  swiad <- rbinom(n, 1, pS)                               # lejek: rozważa tylko ktoś, kto zna markę,
  rozw <- swiad * rbinom(n, 1, pR / pS)                   # a planuje rezerwację tylko ktoś, kto rozważa
  intencja <- rozw * rbinom(n, 1, pI / pR)
  data.frame(grupa, wiek = wieki[wiek], zaint, widzial, swiad, rozw, intencja)
}

set.seed(615)                                    # ziarno ustalone raz, bez dobierania pod wynik
N <- 200000                                      # grupa docelowa kampanii
przydzial <- sample(c("testowa", "kontrolna"), N, replace = TRUE, prob = c(.9, .1))
populacja <- rbind(symuluj(sum(przydzial == "testowa"), "testowa"),
                   symuluj(sum(przydzial == "kontrolna"), "kontrolna"))
# Po kampanii: zaproszenie do ankiety dla 6000 losowych osób z każdej grupy
zaproszeni <- do.call(rbind, lapply(c("testowa", "kontrolna"), function(g)
  populacja[sample(which(populacja$grupa == g), 6000), ]))
zaproszeni$odpowiedzial <- rbinom(nrow(zaproszeni), 1, p_odp[match(zaproszeni$wiek, wieki)])
ankieta <- subset(zaproszeni, odpowiedzial == 1)

# Plik do pobrania: bez ukrytego zainteresowania; odpowiedzi tylko u respondentów
csv <- transform(zaproszeni, id = seq_len(nrow(zaproszeni)),
                 widzial = ifelse(grupa == "testowa", widzial, NA),
                 swiad = ifelse(odpowiedzial == 1, swiad, NA), rozw = ifelse(odpowiedzial == 1, rozw, NA),
                 intencja = ifelse(odpowiedzial == 1, intencja, NA))
write.csv(csv[, c("id", "grupa", "wiek", "widzial", "odpowiedzial", "swiad", "rozw", "intencja")],
          "badanie-brand-lift-ankieta.csv", row.names = FALSE, na = "")

# Liczebności na każdym etapie schematu
etapy <- data.frame(
  grupa = c("testowa", "kontrolna"),
  przydzieleni = as.vector(table(factor(przydzial, c("testowa", "kontrolna")))),
  widzialo_reklame_proc = c(round(100 * mean(populacja$widzial[populacja$grupa == "testowa"]), 1), 0),
  zaproszeni = 6000,
  odpowiedzieli = as.vector(table(factor(ankieta$grupa, c("testowa", "kontrolna")))))
etapy$odsetek_odpowiedzi <- round(100 * etapy$odpowiedzieli / etapy$zaproszeni, 1)
etapy
# Struktura wieku respondentów w grupach (%): losowy przydział daje podobne grupy
round(100 * prop.table(table(ankieta$grupa, ankieta$wiek), 1), 1)
Wynik w R
      grupa przydzieleni widzialo_reklame_proc zaproszeni odpowiedzieli
1   testowa       180130                  74.2       6000          1441
2 kontrolna        19870                   0.0       6000          1418
  odsetek_odpowiedzi
1               24.0
2               23.6

            18-29 30-44 45-64
  kontrolna  26.4  40.1  33.6
  testowa    25.5  41.6  32.9
2. Schemat badania: Rysunek 1
R
# Rysunek 1. Schemat badania brand lift: losowanie, ekspozycja, ankieta, porównanie (grafika z prostokątów i tekstu)
# Korzysta z obiektów przepisu 1: etapy, kol, motyw. Niczego nie losuje.
library(ggplot2)

tys <- function(x) format(x, big.mark = " ", scientific = FALSE)
T <- etapy[etapy$grupa == "testowa", ]; K <- etapy[etapy$grupa == "kontrolna", ]
pola <- data.frame(
  x = c(2, 1, 3, 1, 3, 1, 3, 2),
  y = c(5, 3.85, 3.85, 2.7, 2.7, 1.55, 1.55, 0.4),
  typ = c("start", "test", "kontrola", "test", "kontrola", "test", "kontrola", "wynik"),
  tekst = c(sprintf("Grupa docelowa kampanii: %s osób\nlosowanie: 90%% do grupy testowej, 10%% do kontrolnej", tys(N)),
            sprintf("GRUPA TESTOWA: %s osób\nreklama wideo przez 4 tygodnie\n(zobaczyło ją %.1f%%)", tys(T$przydzieleni), T$widzialo_reklame_proc),
            sprintf("GRUPA KONTROLNA: %s osób\nreklamę wstrzymano – w tym miejscu\nwyświetlały się inne reklamy", tys(K$przydzieleni)),
            sprintf("zaproszenie do ankiety:\n%s losowych osób", tys(T$zaproszeni)),
            sprintf("zaproszenie do ankiety:\n%s losowych osób", tys(K$zaproszeni)),
            sprintf("odpowiedziało %s osób (%.1f%%)\nte same 3 pytania o markę", tys(T$odpowiedzieli), T$odsetek_odpowiedzi),
            sprintf("odpowiedziało %s osób (%.1f%%)\nte same 3 pytania o markę", tys(K$odpowiedzieli), K$odsetek_odpowiedzi),
            "Porównanie odsetków: świadomość, rozważanie, intencja\nbrand lift = odsetek w grupie testowej − odsetek w kontrolnej"))
pola$szer <- ifelse(pola$typ %in% c("start", "wynik"), 1.75, 0.85)
strzalki <- data.frame(x = c(1.6, 2.4, 1, 3, 1, 3, 1, 3), y = c(4.62, 4.62, 3.43, 3.43, 2.4, 2.4, 1.13, 1.13),
                       xend = c(1.2, 2.8, 1, 3, 1, 3, 1.5, 2.5), yend = c(4.27, 4.27, 2.98, 2.98, 1.97, 1.97, 0.75, 0.75))

p1 <- ggplot() +
  geom_segment(data = strzalki, aes(x, y, xend = xend, yend = yend), colour = "grey45", linewidth = 0.7,
               arrow = arrow(length = unit(0.25, "cm"), type = "closed")) +
  geom_rect(data = pola, aes(xmin = x - szer, xmax = x + szer, ymin = y - 0.37, ymax = y + 0.37, fill = typ),
            colour = "grey40", linewidth = 0.5) +
  geom_text(data = pola, aes(x, y, label = tekst, colour = typ), size = 4.1, lineheight = 1.0) +
  annotate("text", x = 2, y = 3.2, label = "jedyna\nróżnica\nmiędzy\ngrupami:\nreklama", size = 3.7,
           colour = "grey25", fontface = "italic", lineheight = 0.95) +
  scale_fill_manual(values = c(start = "grey92", test = kol[["cynober"]], kontrola = kol[["niebieski"]],
                               wynik = "#FFF4DD"), guide = "none") +
  scale_colour_manual(values = c(start = "grey10", test = "white", kontrola = "white", wynik = "grey10"),
                      guide = "none") +
  coord_cartesian(xlim = c(0.05, 3.95), ylim = c(-0.05, 5.45), expand = FALSE) +
  labs(title = "Schemat badania brand lift z losową grupą kontrolną",
       subtitle = "Fikcyjne biuro podróży; liczby z symulacji") +
  motyw + theme(axis.text = element_blank(), axis.title = element_blank(), panel.grid.major = element_blank())
p1   # zapis: ggsave("brand-lift-schemat-badania.svg", p1, width = 10, height = 7.2)
3. Odsetki, brand lift i przedziały: Rysunki 2 i 3
R
# Rysunki 2 i 3. Odsetki w grupach (przedziały Wilsona) i brand lift (przedział Newcombe'a)
# Korzysta z obiektów przepisu 1: ankieta, kol, motyw oraz parametrów (udzial_wieku, p_wid, wid_bonus, efekt). Niczego nie losuje.
library(ggplot2)

pytania <- c(swiad = "Świadomość marki", rozw = "Rozważanie przy wyborze", intencja = "Intencja rezerwacji")
wilson <- function(x, n) as.numeric(prop.test(x, n, correct = FALSE)$conf.int)   # przedział Wilsona (score)
wyniki <- do.call(rbind, lapply(names(pytania), function(v) {
  xt <- sum(ankieta[[v]][ankieta$grupa == "testowa"]); nt <- sum(ankieta$grupa == "testowa")
  xk <- sum(ankieta[[v]][ankieta$grupa == "kontrolna"]); nk <- sum(ankieta$grupa == "kontrolna")
  pt <- xt / nt; pk <- xk / nk; ct <- wilson(xt, nt); ck <- wilson(xk, nk)
  d <- pt - pk                                                     # brand lift w punktach procentowych
  data.frame(pytanie = pytania[[v]], x_test = xt, n_test = nt, x_kontr = xk, n_kontr = nk,
             test = 100 * pt, test_od = 100 * ct[1], test_do = 100 * ct[2],
             kontr = 100 * pk, kontr_od = 100 * ck[1], kontr_do = 100 * ck[2],
             lift_pp = 100 * d,                                    # przedział Newcombe'a (metoda 10)
             lift_od = 100 * (d - sqrt((pt - ct[1])^2 + (ck[2] - pk)^2)),
             lift_do = 100 * (d + sqrt((ct[2] - pt)^2 + (pk - ck[1])^2)),
             lift_wzgl_proc = 100 * d / pk,
             p = prop.test(c(xt, xk), c(nt, nk), correct = FALSE)$p.value)
}))
wyniki$p_holm <- p.adjust(wyniki$p, "holm")                        # trzy pytania = trzy testy
print(transform(wyniki[, -(2:5)], test = round(test, 1), test_od = round(test_od, 1), test_do = round(test_do, 1),
                kontr = round(kontr, 1), kontr_od = round(kontr_od, 1), kontr_do = round(kontr_do, 1),
                lift_pp = round(lift_pp, 2), lift_od = round(lift_od, 2), lift_do = round(lift_do, 2),
                lift_wzgl_proc = round(lift_wzgl_proc, 1), p = round(p, 4), p_holm = round(p_holm, 4)), row.names = FALSE)
wyniki[, c("pytanie", "x_test", "n_test", "x_kontr", "n_kontr")]

# Prawdziwy efekt w symulacji: u widzących reklamę 8, 4 i 1.5 pp; w całej grupie testowej rozcieńczony przez osoby bez ekspozycji
szansa_ekspozycji <- sum(outer(udzial_wieku, c(.7, .3)) * cbind(p_wid, pmin(p_wid + wid_bonus, .95)))
round(c(odsetek_widzacych = 100 * szansa_ekspozycji, prawdziwy_lift_pp = 100 * efekt * szansa_ekspozycji), 2)

# Efekt na widzących reklamę: lift / odsetek widzących wśród respondentów grupy testowej
widz <- mean(ankieta$widzial[ankieta$grupa == "testowa"])
round(c(widzialo_wsrod_respondentow = 100 * widz, efekt_na_widzacych_pp = wyniki$lift_pp[1] / widz), 2)
# Pułapka: „widział vs nie widział” w grupie testowej zamiast porównania z losową grupą kontrolną
tst <- subset(ankieta, grupa == "testowa")
naiwnie <- function(d) 100 * c(swiad_widzieli = mean(d$swiad[d$widzial == 1]), swiad_nie_widzieli = mean(d$swiad[d$widzial == 0]),
                               roznica_pp = mean(d$swiad[d$widzial == 1]) - mean(d$swiad[d$widzial == 0]))
round(rbind(respondenci = naiwnie(tst), cala_grupa_testowa = naiwnie(subset(populacja, grupa == "testowa"))), 2)

# Rysunek 2: odsetki z 95% przedziałami Wilsona
dl <- rbind(data.frame(pytanie = wyniki$pytanie, grupa = "testowa (reklama)", p = wyniki$test, od = wyniki$test_od, do = wyniki$test_do),
            data.frame(pytanie = wyniki$pytanie, grupa = "kontrolna (bez reklamy)", p = wyniki$kontr, od = wyniki$kontr_od, do = wyniki$kontr_do))
dl$pytanie <- factor(dl$pytanie, rev(pytania))
p2 <- ggplot(dl, aes(p, pytanie, colour = grupa, shape = grupa)) +
  geom_errorbar(aes(xmin = od, xmax = do), width = 0.18, orientation = "y", linewidth = 0.8, position = position_dodge(width = 0.5)) +
  geom_point(size = 3.4, position = position_dodge(width = 0.5)) +
  geom_text(aes(label = sprintf("%.1f%%", p)), position = position_dodge(width = 0.5), vjust = -0.9, size = 3.7,
            show.legend = FALSE) +
  scale_colour_manual(values = c("testowa (reklama)" = kol[["cynober"]], "kontrolna (bez reklamy)" = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c("testowa (reklama)" = 16, "kontrolna (bez reklamy)" = 17), name = NULL) +
  scale_x_continuous(labels = function(x) paste0(x, "%"), limits = c(0, 45)) +
  labs(x = "Odsetek odpowiedzi „tak” (95% przedział Wilsona)", y = NULL,
       title = "Odpowiedzi w grupie testowej i kontrolnej",
       subtitle = sprintf("Ankieta po kampanii: %d i %d respondentów", wyniki$n_test[1], wyniki$n_kontr[1])) + motyw
p2   # zapis: ggsave("brand-lift-odsetki-w-grupach.svg", p2, width = 10, height = 5.6)

# Rysunek 3: brand lift (różnica w pp) z 95% przedziałem Newcombe'a
wyniki$pyt <- factor(wyniki$pytanie, rev(pytania))
wyniki$etykieta <- sprintf("%+.1f pp [%.1f, %.1f]; względnie %+.0f%%; p (Holm) %s", wyniki$lift_pp, wyniki$lift_od,
                           wyniki$lift_do, wyniki$lift_wzgl_proc,
                           ifelse(wyniki$p_holm < .001, "< .001", sub("^0", "", sprintf("= %.3f", wyniki$p_holm))))
wyniki$etykieta <- gsub("-", "−", sub("= 0\\.", "= .", wyniki$etykieta))
p3 <- ggplot(wyniki, aes(lift_pp, pyt)) +
  geom_vline(xintercept = 0, colour = "grey30", linetype = "dashed") +
  geom_errorbar(aes(xmin = lift_od, xmax = lift_do), width = 0.15, orientation = "y", linewidth = 0.9, colour = kol[["cynober"]]) +
  geom_point(size = 3.6, colour = kol[["cynober"]], shape = 18) +
  geom_text(aes(label = etykieta), vjust = -1.6, size = 3.7, colour = "grey15") +
  scale_x_continuous(limits = c(-2.5, 10.5), breaks = seq(-2, 10, 2), labels = function(x) paste0(sub("-", "−", x), " pp")) +
  labs(x = "Brand lift: odsetek w grupie testowej − odsetek w kontrolnej (95% CI Newcombe'a)", y = NULL,
       title = "O ile kampania podniosła odsetki?",
       subtitle = "Linia przerywana: brak efektu") + motyw
p3   # zapis: ggsave("brand-lift-roznice-odsetkow.svg", p3, width = 10, height = 5.2)
Wynik w R
                 pytanie test test_od test_do kontr kontr_od kontr_do lift_pp
        Świadomość marki 40.6    38.1    43.2  36.4     33.9     38.9    4.21
 Rozważanie przy wyborze 18.7    16.8    20.8  15.0     13.3     17.0    3.72
     Intencja rezerwacji  6.5     5.4     7.9   5.7      4.6      7.0    0.81
 lift_od lift_do lift_wzgl_proc      p p_holm
    0.64    7.76           11.6 0.0208 0.0416
    0.97    6.46           24.7 0.0080 0.0241
   -0.96    2.58           14.2 0.3658 0.3658
                  pytanie x_test n_test x_kontr n_kontr
1        Świadomość marki    585   1441     516    1418
2 Rozważanie przy wyborze    270   1441     213    1418
3     Intencja rezerwacji     94   1441      81    1418
 odsetek_widzacych prawdziwy_lift_pp1 prawdziwy_lift_pp2 prawdziwy_lift_pp3
             74.25               5.94               2.97               1.11
widzialo_wsrod_respondentow       efekt_na_widzacych_pp
                      73.77                        5.70
                   swiad_widzieli swiad_nie_widzieli roznica_pp
respondenci                 42.24              35.98       6.26
cala_grupa_testowa          41.42              34.05       7.37
4. Liczebność próby i 1000 badań: Rysunek 4
R
# Rysunek 4. Liczebność próby dla małego efektu i 1000 powtórzeń tego samego badania
# Korzysta z obiektów przepisu 1: symuluj(), wieki, p_odp, kol, motyw oraz z wyniki (przepis 3).
library(ggplot2)
library(patchwork)

# A. Ilu respondentów na grupę potrzeba (moc 80%, alfa = .05, test dwustronny) dla różnego liftu i poziomu wyjściowego
siatka <- expand.grid(lift_pp = seq(1, 8, by = 0.25), bazowy = c(6, 15, 33))
siatka$n_na_grupe <- mapply(function(d, b) ceiling(power.prop.test(p1 = b / 100, p2 = (b + d) / 100, power = .80)$n),
                            siatka$lift_pp, siatka$bazowy)
subset(siatka, lift_pp %in% c(1, 2, 3, 6))

# B. 1000 powtórzeń badania tym samym schematem (6000 zaproszeń na grupę, odpowiedź zależna od wieku)
set.seed(615)
R <- 1000
sym <- t(replicate(R, {
  z <- rbind(symuluj(6000, "testowa"), symuluj(6000, "kontrolna"))
  a <- z[rbinom(nrow(z), 1, p_odp[match(z$wiek, wieki)]) == 1, ]
  c(sapply(c("swiad", "rozw", "intencja"), function(v) {
    xt <- sum(a[[v]][a$grupa == "testowa"]); nt <- sum(a$grupa == "testowa")
    xk <- sum(a[[v]][a$grupa == "kontrolna"]); nk <- sum(a$grupa == "kontrolna")
    c(lift = 100 * (xt / nt - xk / nk), p = prop.test(c(xt, xk), c(nt, nk), correct = FALSE)$p.value)
  }))
}))
# kolumny sym: lift i p dla kolejnych pytań (swiad, rozw, intencja)
moc <- colMeans(sym[, c(2, 4, 6)] < .05)
round(rbind(moc_proc = 100 * moc, blad_MC_pp = 100 * sqrt(moc * (1 - moc) / R),
            sredni_lift_wszystkie = colMeans(sym[, c(1, 3, 5)]),
            sredni_lift_istotne = c(mean(sym[sym[, 2] < .05, 1]), mean(sym[sym[, 4] < .05, 3]), mean(sym[sym[, 6] < .05, 5]))), 2)

kryt <- data.frame(bazowy = c(6, 15, 33), etykieta = c("poziom wyjściowy 6% (intencja)", "15% (rozważanie)", "33% (świadomość)"))
siatka <- merge(siatka, kryt)
siatka$etykieta <- factor(siatka$etykieta, kryt$etykieta)
nasze_n <- wyniki$n_kontr[1]
pA <- ggplot(siatka, aes(lift_pp, n_na_grupe, colour = etykieta, linetype = etykieta)) +
  geom_hline(yintercept = nasze_n, colour = "grey30", linetype = "dotted") +
  annotate("text", x = 8, y = nasze_n * 1.25, label = sprintf("nasze n = %d", nasze_n), hjust = 1, size = 3.6, colour = "grey25") +
  geom_line(linewidth = 1.1) +
  scale_y_log10(breaks = c(250, 500, 1000, 2500, 5000, 10000, 25000), labels = function(x) format(x, big.mark = " ")) +
  scale_colour_manual(values = unname(kol[c("niebieski", "cynober", "zielony")]), name = NULL) +
  scale_linetype_manual(values = c("solid", "longdash", "dotdash"), name = NULL) +
  labs(x = "Brand lift do wykrycia (pp)", y = "Respondentów na grupę (skala log)",
       title = "A. Ile osób na grupę przy mocy 80%") +
  motyw + theme(legend.direction = "vertical")
dI <- data.frame(lift = sym[, 5], istotny = ifelse(sym[, 6] < .05, "p < .05", "p ≥ .05"))
pB <- ggplot(dI, aes(lift, fill = istotny)) +
  geom_histogram(binwidth = 0.25, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = mean(dI$lift), colour = "grey20", linetype = "dashed") +
  scale_fill_manual(values = c("p < .05" = kol[["cynober"]], "p ≥ .05" = kol[["szary"]]), name = NULL) +
  labs(x = "Oszacowany lift intencji (pp)", y = "Liczba badań",
       title = sprintf("B. Intencja: 1000 badań, istotne w %.1f%%", 100 * moc[3])) + motyw
p4 <- pA + pB + plot_layout(widths = c(1.15, 1))
p4   # zapis: ggsave("brand-lift-liczebnosc-proby.svg", p4, width = 10, height = 5.8)
Wynik w R
   lift_pp bazowy n_na_grupe
1        1      6       9540
5        2      6       2554
9        3      6       1209
21       6      6        356
30       1     15      20559
34       2     15       5274
38       3     15       2402
50       6     15        643
59       1     33      34970
63       2     33       8806
67       3     33       3941
79       6     33       1004
                       [,1]  [,2]  [,3]
moc_proc              90.50 55.30 23.00
blad_MC_pp             0.93  1.57  1.33
sredni_lift_wszystkie  5.76  2.91  1.13
sredni_lift_istotne    6.08  3.87  2.22
5. Braki odpowiedzi i ważenie: Rysunek 5
R
# Rysunek 5. Braki odpowiedzi różne w grupach: kiedy lift jest obciążony i kiedy pomaga ważenie wg wieku
# Korzysta z obiektów przepisu 1: symuluj(), wieki, udzial_wieku, p_wid, wid_bonus, efekt, p_odp, kol, motyw.
library(ggplot2)

prawdziwy <- 100 * efekt[1] * sum(outer(udzial_wieku, c(.7, .3)) * cbind(p_wid, pmin(p_wid + wid_bonus, .95)))
# Trzy scenariusze odpowiedzi na ankietę (ustalone ręcznie)
odp_prob <- function(z, scen) {
  w <- match(z$wiek, wieki); test <- z$grupa == "testowa"
  if (scen == 1) return(p_odp[w])                                    # wiek, tak samo w obu grupach
  if (scen == 2) return(pmin(p_odp[w] * ifelse(test & z$swiad == 1, 1.25, 1), 1))  # w testowej chętniej odpowiadają znający markę
  ifelse(test, c(.30, .25, .15)[w], c(.12, .22, .35)[w])             # testowa: zaproszenie w aplikacji; kontrolna: e-mail
}
odsetek <- function(y, wiek, zapr_wiek, waz) {                       # odsetek bez wag albo z wagami wieku
  if (!waz) return(mean(y))
  cel <- prop.table(table(factor(zapr_wiek, wieki)))                 # struktura wieku zaproszonych (znana z platformy)
  sum(cel * tapply(y, factor(wiek, wieki), mean))                    # ważenie poststratyfikacyjne
}

set.seed(615)
R <- 1000
est <- replicate(R, {
  z <- rbind(symuluj(6000, "testowa"), symuluj(6000, "kontrolna"))
  unlist(lapply(1:3, function(s) {
    a <- z[rbinom(nrow(z), 1, odp_prob(z, s)) == 1, ]
    sapply(c(FALSE, TRUE), function(waz) {
      g <- function(gr) odsetek(a$swiad[a$grupa == gr], a$wiek[a$grupa == gr], z$wiek[z$grupa == gr], waz)
      100 * (g("testowa") - g("kontrolna"))
    })
  }))
})
wyn <- data.frame(scenariusz = rep(1:3, each = 2), wagi = rep(c("bez wag", "ważenie wg wieku"), 3),
                  sredni_lift = rowMeans(est), obciazenie = rowMeans(est) - prawdziwy,
                  blad_MC = apply(est, 1, sd) / sqrt(R),
                  od = apply(est, 1, quantile, .025), do = apply(est, 1, quantile, .975))
round(c(prawdziwy_lift_pp = prawdziwy), 2)
print(transform(wyn, sredni_lift = round(sredni_lift, 2), obciazenie = round(obciazenie, 2), blad_MC = round(blad_MC, 3),
                od = round(od, 2), do = round(do, 2)), row.names = FALSE)

nazwy <- c("1. Odpowiedź zależy od wieku,\ntak samo w obu grupach",
           "2. W grupie testowej chętniej\nodpowiadają znający markę",
           "3. Różne kanały zaproszeń:\ninna struktura wieku w grupach")
wyn$scen <- factor(nazwy[wyn$scenariusz], rev(nazwy))
wyn$etykieta <- sub("-", "−", sprintf("obciążenie %+.2f pp", wyn$obciazenie))
p5 <- ggplot(wyn, aes(sredni_lift, scen, colour = wagi, shape = wagi)) +
  geom_vline(xintercept = prawdziwy, colour = "grey20", linetype = "dashed") +
  geom_errorbar(aes(xmin = od, xmax = do), width = 0.2, orientation = "y", linewidth = 0.9, position = position_dodge(width = 0.6)) +
  geom_point(size = 3.8, position = position_dodge(width = 0.6)) +
  geom_text(aes(x = do, label = etykieta), position = position_dodge(width = 0.6), hjust = -0.1, size = 3.6,
            show.legend = FALSE) +
  annotate("text", x = prawdziwy, y = 3.55, label = sprintf("prawdziwy lift %.2f pp", prawdziwy), hjust = -0.05, size = 3.6) +
  scale_colour_manual(values = c("bez wag" = kol[["cynober"]], "ważenie wg wieku" = kol[["niebieski"]]), name = NULL) +
  scale_shape_manual(values = c("bez wag" = 16, "ważenie wg wieku" = 15), name = NULL) +
  scale_x_continuous(limits = c(-2, 21), breaks = seq(0, 20, 5)) +
  labs(x = "Oszacowany lift świadomości (pp)", y = NULL,
       title = "Braki odpowiedzi a obciążenie brand liftu",
       subtitle = "Punkt – średnia z 1000 badań, odcinek – 95% wyników (2.5–97.5 percentyl)") + motyw
p5   # zapis: ggsave("brand-lift-braki-odpowiedzi.svg", p5, width = 10, height = 6.4)
Wynik w R
prawdziwy_lift_pp
             5.94
 scenariusz             wagi sredni_lift obciazenie blad_MC    od    do
          1          bez wag        5.72      -0.22   0.057  2.20  9.38
          1 ważenie wg wieku        5.88      -0.06   0.058  2.43  9.58
          2          bez wag       11.26       5.32   0.057  7.60 14.59
          2 ważenie wg wieku       11.32       5.38   0.056  7.77 14.68
          3          bez wag        2.22      -3.72   0.055 -1.23  5.72
          3 ważenie wg wieku        5.95       0.01   0.058  2.32  9.49
6. Czy kolory są czytelne przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – niebieski (grupa testowa / kontrolna; bez wag / z wagami)" = c("#D55E00", "#0072B2"),
             "cynober – szary (wynik istotny / nieistotny)" = c("#D55E00", "#999999"),
             "niebieski – zielony – cynober (krzywe liczebności)" = c("#0072B2", "#009E73"),
             "zielony – cynober (krzywe liczebności)" = c("#009E73", "#D55E00"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                    widzenie_typowe
cynober – niebieski (grupa testowa / kontrolna; bez wag / z wagami)           114.6
cynober – szary (wynik istotny / nieistotny)                                   77.2
niebieski – zielony – cynober (krzywe liczebności)                             70.1
zielony – cynober (krzywe liczebności)                                        102.4
czerwony – zielony (do unikania)                                              121.7
                                                                    deuteranopia
cynober – niebieski (grupa testowa / kontrolna; bez wag / z wagami)        108.3
cynober – szary (wynik istotny / nieistotny)                                62.9
niebieski – zielony – cynober (krzywe liczebności)                          55.4
zielony – cynober (krzywe liczebności)                                      53.5
czerwony – zielony (do unikania)                                            21.1
                                                                    protanopia
cynober – niebieski (grupa testowa / kontrolna; bez wag / z wagami)       91.9
cynober – szary (wynik istotny / nieistotny)                              56.0
niebieski – zielony – cynober (krzywe liczebności)                        58.0
zielony – cynober (krzywe liczebności)                                    37.3
czerwony – zielony (do unikania)                                          31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, przedziały Wilsona, test dwóch proporcji, liczebność próby i poprawka Holma – pakiety base i stats). Rysunki wykonano w ggplot2, panele połączono pakietem patchwork; pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Pułapki
- Brak grupy kontrolnej – „po kampanii 40.6% zna markę” nic nie mówi o efekcie, bo bez reklamy znałoby ją 36.4%.
- „Widzieli vs nie widzieli” zamiast porównania grup z losowania – osoby, którym pokazano reklamę, różnią się od pozostałych.
- Tylko lift względny – „+14% intencji” to 0.81 pp z przedziałem obejmującym zero.
- Za mała próba na wskaźnik o niskim poziomie wyjściowym – intencję przy 1418 osobach na grupę wykrywa co czwarte badanie.
- Różny brak odpowiedzi w grupach – inny kanał, termin lub miejsce zaproszenia. Ważenie pomaga tylko przy zmiennych, od których zależy odpowiadanie.
- Wiele wskaźników i podgrup bez korekty – zob. problem wielokrotnych porównań.
Pomoc przy planowaniu i analizie takiego badania: analizy statystyczne dla studentów.
Najczęstsze pytania
Co to jest brand lift?
Brand lift to wzrost wskaźnika marki, np. odsetka osób znających markę, wywołany kampanią. Mierzy się go jako różnicę odsetków między grupą, która mogła zobaczyć reklamę, a losowo wydzieloną grupą kontrolną, zbadanymi po kampanii tą samą ankietą. Podawaj różnicę w punktach procentowych z 95% przedziałem ufności, a lift względny tylko obok niej.
Jak policzyć przedział ufności dla różnicy dwóch odsetków?
Dobrą i prostą metodą jest przedział Newcombe’a, który łączy przedziały Wilsona obu grup (Newcombe, 1998). W przykładzie świadomość marki wyniosła 40.6% i 36.4%, a różnica 4.21 pp miała 95% CI [0.64, 7.76]. W R przedział Wilsona dla każdej grupy daje prop.test(x, n, correct = FALSE), a przedział dla różnicy liczysz z ich granic.
Ilu respondentów potrzeba do badania brand lift?
Zależy od oczekiwanego liftu i poziomu wyjściowego. Przy mocy 80% i α = .05 wykrycie wzrostu z 33% o 6 pp wymaga 1004 osób na grupę, ale wzrost o 2 pp przy poziomie 6% – już 2554, a o 1 pp – 9540. Policzysz to funkcją power.prop.test() w R.
Czy można porównać osoby, które widziały reklamę, z tymi, które jej nie widziały?
Nie jako oszacowanie efektu. Reklamy trafiają do wybranych osób, które różnią się od pozostałych, a obciążenie selekcyjne poważnie podważa metody obserwacyjne (Lewis i Rao, 2015). W przykładzie takie porównanie dało 7.37 pp zamiast prawdziwych 8 pp. Porównuj grupy z losowania; efekt u widzących możesz oszacować, dzieląc lift przez odsetek widzących.
Co zrobić, gdy w grupie testowej i kontrolnej odpowiedział inny odsetek osób?
Porównaj strukturę respondentów ze strukturą zaproszonych w każdej grupie, np. według wieku. Gdy brak odpowiedzi zależy od takich zmiennych, pomaga ważenie poststratyfikacyjne – w symulacji obciążenie spadło z −3.72 do 0.01 pp. Gdy zależy od samej mierzonej cechy, ważenie nie pomoże, dlatego zapraszaj obie grupy tym samym kanałem i w tym samym czasie.
Powiązane hasła
Przeczytaj też
Pułapki testów A/B na obrazkach
Zaglądanie do p, wiele wersji i metryk, efekt nowości i SRM w symulacjach 1000 testów A/A – pięć rysunków z kodem R i lista kontrolna.
Czytaj →PoradnikKampania w jednym regionie – syntetyczna kontrola
16 regionów i kampania tylko w jednym: wagi bliźniaka, luka, testy placebo i porównanie z DiD – pięć rysunków z kodem R.
Czytaj →PoradnikSondaż w obrazkach
Margines błędu a n i odsetek 50%, 1000 sondaży, różnica dwóch odsetków, duża ankieta online z błędem i liczba zaproszeń – sześć rysunków z R.
Czytaj →PoradnikTest wyłączenia reklamy (holdout)
Sklep z odzieżą: przyrost sprzedaży z holdoutu, ITT i CACE, iCPA wobec CPA z panelu, duże zamówienia i wielkość holdoutu – kod R.
Czytaj →Oceniasz kampanię w pracy z marketingu?
Pomożemy zaplanować grupę kontrolną i liczebność ankiety, policzyć brand lift z przedziałami, sprawdzić braki odpowiedzi i opisać wyniki tak, żebyś umiał(a) je obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Coppock, A., Hill, S. J., & Vavreck, L. (2020). The small effects of political advertising are small regardless of context, message, sender, or receiver: Evidence from 59 real-time randomized experiments. Science Advances, 6(36), Article eabc4046. https://doi.org/10.1126/sciadv.abc4046 ● Otwarty dostęp
- Gordon, B. R., Zettelmeyer, F., Bhargava, N., & Chapsky, D. (2019). A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook. Marketing Science, 38(2), 193–225. https://doi.org/10.1287/mksc.2018.1135
- Groves, R. M., & Peytcheva, E. (2008). The impact of nonresponse rates on nonresponse bias: A meta-analysis. Public Opinion Quarterly, 72(2), 167–189. https://doi.org/10.1093/poq/nfn011 ● Otwarty dostęp: pełny tekst
- Johnson, G. A., Lewis, R. A., & Nubbemeyer, E. I. (2017). Ghost ads: Improving the economics of measuring online ad effectiveness. Journal of Marketing Research, 54(6), 867–884. https://doi.org/10.1509/jmr.15.0297 ● Otwarty dostęp: pełny tekst
- Kohavi, R., Longbotham, R., Sommerfield, D., & Henne, R. M. (2009). Controlled experiments on the web: Survey and practical guide. Data Mining and Knowledge Discovery, 18(1), 140–181. https://doi.org/10.1007/s10618-008-0114-1 ● Otwarty dostęp
- Lewis, R. A., & Rao, J. M. (2015). The unfavorable economics of measuring the returns to advertising. The Quarterly Journal of Economics, 130(4), 1941–1973. https://doi.org/10.1093/qje/qjv023
- Newcombe, R. G. (1998). Interval estimation for the difference between independent proportions: Comparison of eleven methods. Statistics in Medicine, 17(8), 873–890. https://doi.org/10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i
Cytowania BibTeX
@article{coppock2020small, author={Coppock, Alexander and Hill, Seth J. and Vavreck, Lynn}, title={{The small effects of political advertising are small regardless of context, message, sender, or receiver: Evidence from 59 real-time randomized experiments}}, journal={Science Advances}, year={2020}, volume={6}, number={36}, eid={eabc4046}, doi={10.1126/sciadv.abc4046}}@article{gordon2019comparison, author={Gordon, Brett R. and Zettelmeyer, Florian and Bhargava, Neha and Chapsky, Dan}, title={{A comparison of approaches to advertising measurement: Evidence from big field experiments at Facebook}}, journal={Marketing Science}, year={2019}, volume={38}, number={2}, pages={193--225}, doi={10.1287/mksc.2018.1135}}@article{groves2008impact, author={Groves, R. M. and Peytcheva, E.}, title={{The impact of nonresponse rates on nonresponse bias: A meta-analysis}}, journal={Public Opinion Quarterly}, year={2008}, volume={72}, number={2}, pages={167--189}, doi={10.1093/poq/nfn011}}@article{johnson2017ghost, author={Johnson, Garrett A. and Lewis, Randall A. and Nubbemeyer, Elmar I.}, title={{Ghost ads: Improving the economics of measuring online ad effectiveness}}, journal={Journal of Marketing Research}, year={2017}, volume={54}, number={6}, pages={867--884}, doi={10.1509/jmr.15.0297}}@article{kohavi2009controlled, author={Kohavi, Ron and Longbotham, Roger and Sommerfield, Dan and Henne, Randal M.}, title={{Controlled experiments on the web: Survey and practical guide}}, journal={Data Mining and Knowledge Discovery}, year={2009}, volume={18}, number={1}, pages={140--181}, doi={10.1007/s10618-008-0114-1}}@article{lewis2015unfavorable, author={Lewis, Randall A. and Rao, Justin M.}, title={{The unfavorable economics of measuring the returns to advertising}}, journal={The Quarterly Journal of Economics}, year={2015}, volume={130}, number={4}, pages={1941--1973}, doi={10.1093/qje/qjv023}}@article{newcombe1998interval, author={Newcombe, Robert G.}, title={{Interval estimation for the difference between independent proportions: Comparison of eleven methods}}, journal={Statistics in Medicine}, year={1998}, volume={17}, number={8}, pages={873--890}, doi={10.1002/(sici)1097-0258(19980430)17:8<873::aid-sim779>3.0.co;2-i}}