Przykład: biuro podróży i nowa strona oferty
Fikcyjne biuro podróży online testuje nową stronę oferty hotelu: wersja B ma większą galerię zdjęć i ramkę „ostatnie wolne pokoje”. Na stronę trafia dziennie 2800 nowych osób, po 1400 na wersję, a rezerwuje około 4% z nich. Metryka główna to odsetek osób z rezerwacją. Plan: cztery pełne tygodnie, czyli 39 200 osób na wersję. Przy takiej liczebności moc wykrycia wzrostu z 4.0% do 4.4% wynosi 79.7% (power.prop.test()). Jak w ogóle zaplanować test A/B, liczyć liczebność i analizować wynik, opisuje wpis test A/B – plan i analiza. Tu zajmujemy się tym, co psuje dobrze zaplanowany test w trakcie: zaglądaniem do wyników, wieloma wersjami i metrykami, efektem nowości i nierównym podziałem ruchu.
Dane są fikcyjne, więc wiemy, jaka jest prawda. W testach A/A obie wersje są identyczne, więc każdy wynik „istotny” to fałszywy alarm, czyli błąd I rodzaju. Parametry ustawiono ręcznie: odsetek rezerwacji 4%, 1400 osób dziennie na wersję, 28 dni, korelacje metryk .4, efekt nowości (+1.0 punktu procentowego na starcie, połowa znika po ok. 3.5 dnia, zostaje +0.3 pp) i błąd zapisu w wersji B (gubi 25% osób, które wychodzą w pierwszych sekundach; takie osoby to 30% ruchu i nigdy nie rezerwują). Liczbę gubionych osób podnieśliśmy z 10% po pierwszym uruchomieniu, bo przy 10% skutek był ledwie widoczny. Ziarno 612 ustalono raz i nie zmieniano go. Dzienne dane z rysunku 3 pobierzesz jako pulapki-testow-a-b-dzienne-rezerwacje.csv.
Pułapka 1: codzienne zaglądanie do wartości p
Zespół zagląda do panelu codziennie i chce zakończyć test, gdy tylko pojawi się p < .05. Sprawdziliśmy to na 1000 testach A/A z planem z przykładu: po każdym dniu test dla dwóch proporcji na danych zebranych do tej pory.
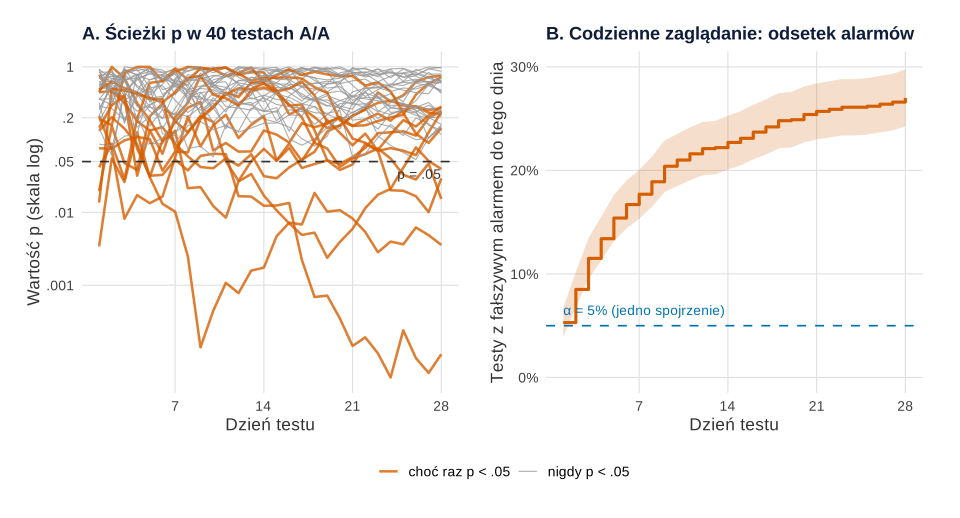
set.seed(612)).Co widać. Panel A: wartość p błądzi. W wielu testach bez żadnego efektu na dzień lub dwa spada poniżej .05 i wraca. Panel B: do końca 28 dni fałszywy alarm pojawił się w 270 z 1000 testów, czyli w 27.0% (błąd Monte Carlo 1.4 punktu procentowego). Jedno spojrzenie po 28 dniach dało 5.2%. Połowa alarmów przyszła do 5. dnia, 177 – w pierwszym tygodniu. Tylko 52 z 270 testów z alarmem miało p < .05 także w dniu 28. To mechanizm opisany przez Armitage’a i in. (1969): powtarzany test na tym samym poziomie istotności częściej daje wynik istotny, niż obiecuje α. Zatrzymanie „na istotności” to forma p-hackingu.
Jak może zmylić. Krzywa w panelu B rośnie najszybciej na początku, gdy danych jest mało. Nie znaczy to, że późne zaglądanie jest bezpieczne – każde dodatkowe spojrzenie dokłada swoje. Panel A pokazuje 40 testów, a nie wszystkie.
Podpis do pracy:
Zdanie do Metody:
Co zamiast: jedno spojrzenie albo granice ustalone z góry
Na tych samych 1000 testach A/A porównaliśmy pięć zasad zatrzymania:
| Zasada | Fałszywe alarmy | Błąd MC |
|---|---|---|
| jedno spojrzenie po 28 dniach | 5.2% | 0.7 pp |
| co tydzień, zwykłe p < .05 | 12.4% | 1.0 pp |
| co tydzień, granice O’Briena–Fleminga | 5.1% | 0.7 pp |
| co tydzień, granice Pococka | 6.4% | 0.8 pp |
| codziennie, zwykłe p < .05 | 27.0% | 1.4 pp |
Nawet cztery tygodniowe spojrzenia ze zwykłym progiem 1.96 dają 12.4% alarmów. Granice sekwencyjne podnoszą próg w każdym spojrzeniu. Wyznacza się je z funkcji wydatkowania alfa, która rozdziela α między kolejne analizy (Lan i DeMets, 1983). Dla czterech spojrzeń typ O’Briena–Fleminga wymaga |z| > 4.333, 2.963, 2.359 i 2.014, a typ Pococka – ok. 2.35–2.37 w każdym tygodniu (te same granice co w przykładzie w haśle). Oba plany utrzymały odsetek alarmów blisko 5%; 6.4% dla Pococka mieści się w niepewności 1000 powtórzeń. Zasady analizy pośredniej opisuje hasło analiza pośrednia i reguły zatrzymania.
Gdy zespół chce patrzeć bez przerwy, potrzebne są metody do ciągłego monitorowania. Johari i in. (2022) pokazują, że zwykłe wartości p tracą wtedy wiarygodność, i proponują „zawsze ważne” wartości p i przedziały ufności. Pokrewną ideę ma sekwencyjny test ilorazu wiarygodności (SPRT). Każdą z tych metod wpisz do planu przed startem.
Pułapka 2: wiele wersji i wiele metryk
Zespół ma jeszcze dwa projekty strony, więc test staje się A/B/C/D. Do tego panel pokazuje pięć metryk: rezerwację, przychód, kliknięcie w ofertę, dodanie do ulubionych i czas na stronie. Każde porównanie nowej wersji z kontrolą w każdej metryce to osobny test. Kontrolowanie tego zbioru testów to problem wielokrotnych porównań.
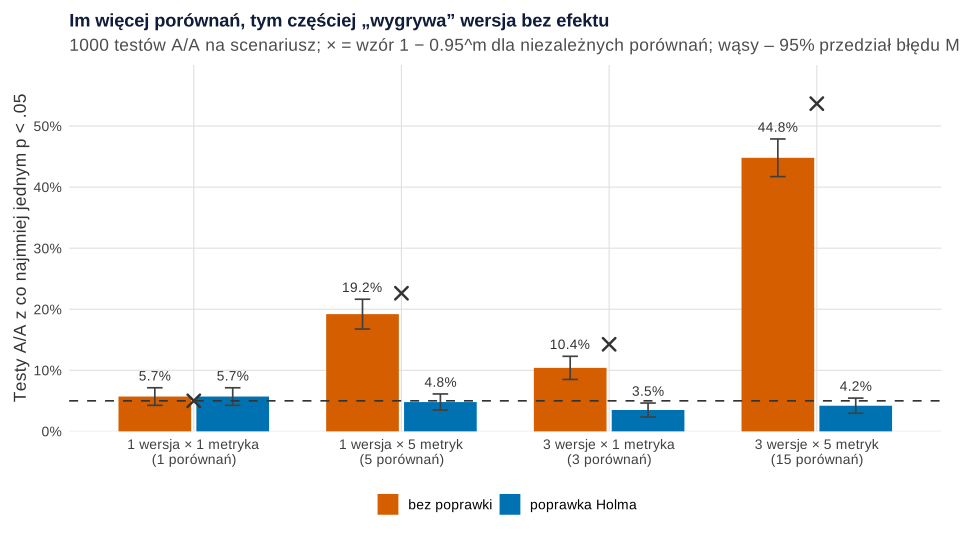
set.seed(612)).Co widać. Przy trzech nowych wersjach i pięciu metrykach (15 porównań) co najmniej jeden wynik p < .05 wyszedł w 44.8% testów A/A. Sama zmiana liczby metryk z 1 na 5 dała 19.2%. Przy wielu porównaniach poprawka Holma (Holm, 1979) sprowadza ten odsetek poniżej 5% (3.5–4.8%). Przy jednym porównaniu poprawki nie ma, a 5.7% to 5% plus losowość 1000 powtórzeń (błąd MC 0.7 pp).
Jak może zmylić. Krzyżyki pokazują wzór 1 − 0.95m dla niezależnych porównań (dla 15 porównań 53.7%). Metryki z jednej strony są skorelowane, a wersje dzielą tę samą kontrolę, więc w symulacji alarmów było mniej. Wzór przeszacowuje ryzyko, ale go nie wymyśla. Statystyki z losowaliśmy wprost z rozkładu normalnego o ustalonych korelacjach (.4 między metrykami, .5 między porównaniami z jedną kontrolą). Przy dziesiątkach tysięcy osób na wersję to dobre przybliżenie.
Podpis do pracy:
Zdanie do Metody:
Więcej obrazów tego samego zjawiska, także procedurę Benjaminiego–Hochberga, pokazuje wpis wielokrotne testy w obrazkach. Ten sam problem dotyczy porównań etapów w lejku konwersji.
Pułapka 3: efekt nowości
Teraz prawdziwy test: wersja B naprawdę jest lepsza, ale część przewagi wynika z ciekawości. Powracający klienci klikają nową galerię, bo jest nowa, a po kilku dniach przestają ją zauważać. Sadeghi i in. (2022) opisują, że efekt w eksperymentach online może w czasie maleć (efekt nowości) albo rosnąć (efekt pierwszeństwa: zaangażowanie rośnie, gdy użytkownicy przyswajają nową funkcję). Tu każdego dnia stronę odwiedza 2500 osób na wersję, nowych i powracających.
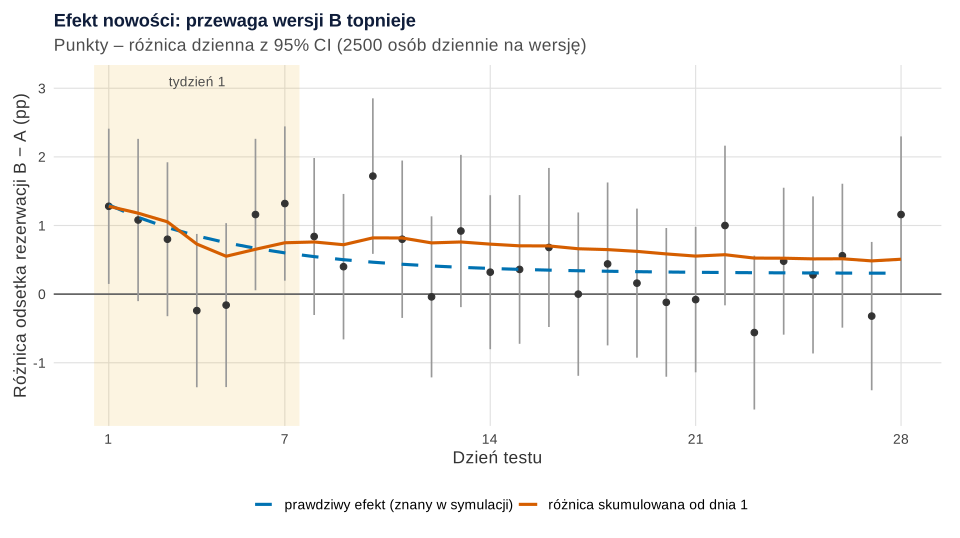
set.seed(612)).Co widać. Dzienne różnice mocno skaczą, ale w pierwszym tygodniu leżą wyżej. Test zatrzymany po 7 dniach dałby +0.75 pp, 95% CI [0.32, 1.18], p < .001. Cały test: +0.51 pp, 95% CI [0.30, 0.72]. Tygodnie 3–4: +0.29 pp, 95% CI [−0.01, 0.59], p = .058. Trwały efekt to +0.3 pp. W 1000 powtórzeniach tego testu średnie oszacowanie wyniosło 0.897 pp po tygodniu, 0.501 pp po 28 dniach i 0.325 pp z tygodni 3–4. Krótki test trzykrotnie przeszacował trwały efekt.
Jak może zmylić. Formalny test zmiany efektu w czasie (regresja logistyczna z interakcją wersja × dzień) dał χ²(1) = 2.96, p = .085, choć wiemy, że efekt maleje. Dzienne dane są zaszumione, a test trendu ma małą moc, więc brak istotności nie wyklucza efektu nowości. Te same osoby wracają w kolejnych dniach, więc dzienne punkty nie są w pełni niezależne. Dlatego patrz na kształt dziennej różnicy i porównaj ostatnie tygodnie z pierwszym.
Podpis do pracy:
Zdanie do Wyników:
Wąskie przedziały przy krótszym teście daje też redukcja wariancji, opisana we wpisie CUPED – krótszy test A/B. Nie chroni ona jednak przed efektem nowości: na niego pomaga tylko dłuższy test albo osobna analiza powracających klientów.
Pułapka 4: nierówny podział ruchu (SRM)
Losowanie działa 50/50, ale w wersji B skrypt pomiarowy ładuje się wolniej. Nie zapisuje części osób, które wychodzą w pierwszych sekundach – a one nigdy nie rezerwują. Wersja B jest w naszych danych naprawdę nieco gorsza: prawdziwa różnica to −0.08 pp. Fabijan i in. (2019) nazywają rozbieżność proporcji grup (ang. sample ratio mismatch, SRM) jednym z najbardziej użytecznych sygnałów problemów z danymi. Wykrywa ją prosty test chi-kwadrat zgodności z planowanym podziałem.
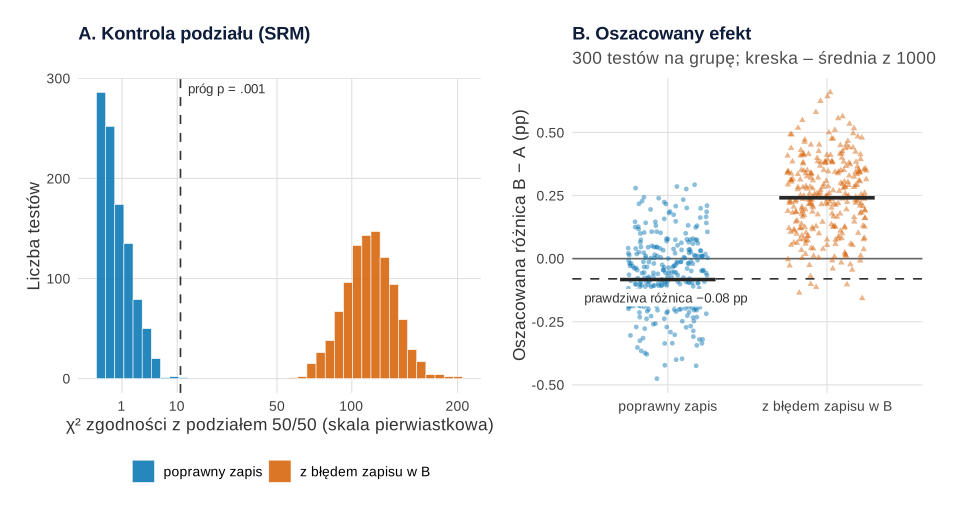
set.seed(612)).Co widać. W pierwszym teście z błędem zapisano 39 310 osób w A i 36 177 w B (47.92% zamiast 50%), χ²(1) = 130.03, p < .001. Rezerwacje: 3.73% w A i 4.08% w B, różnica +0.35 pp, p = .014 – gorsza wersja wygląda na lepszą. Fabijan i in. (2019) ostrzegają właśnie przed tym: zignorowany SRM może sprawić, że gorsza zmiana wyda się lepsza. W 1000 takich testach średnia różnica wyniosła +0.24 pp. W 39.0% testów B wychodziła istotnie lepsza, a w żadnym – istotnie gorsza. Przy poprawnym zapisie średnia wynosiła −0.08 pp, a kontrola podziału dała p < .001 tylko w 0.1% testów.
Jak może zmylić. Zgubienie 7.5% osób z wersji B (25% z 30% osób, które szybko wychodzą) wygląda niewinnie, ale w tym przykładzie odwraca znak wyniku. Problem nie leży w liczbie zgubionych osób, tylko w tym, że gubione są osoby nietypowe. Odwrotnie: gdy SRM nie ma, nie dowodzi to poprawności danych – kontrola podziału łapie tylko błędy, które zmieniają liczebności.
Podpis do pracy:
Zdanie do Wyników:
Kontrolę podziału licz codziennie, bo to awaria, a nie decyzja o wyniku. Przyjmij surowy próg, np. p < .001: test powtarzasz wiele razy, a przy dziesiątkach tysięcy osób wychwytuje nawet drobne nierówności. Kohavi i in. (2020) opisują takie testy wiarygodności jako ostrzeżenie przed naruszonymi założeniami eksperymentu.
Rysunek 5: lista kontrolna testu A/B
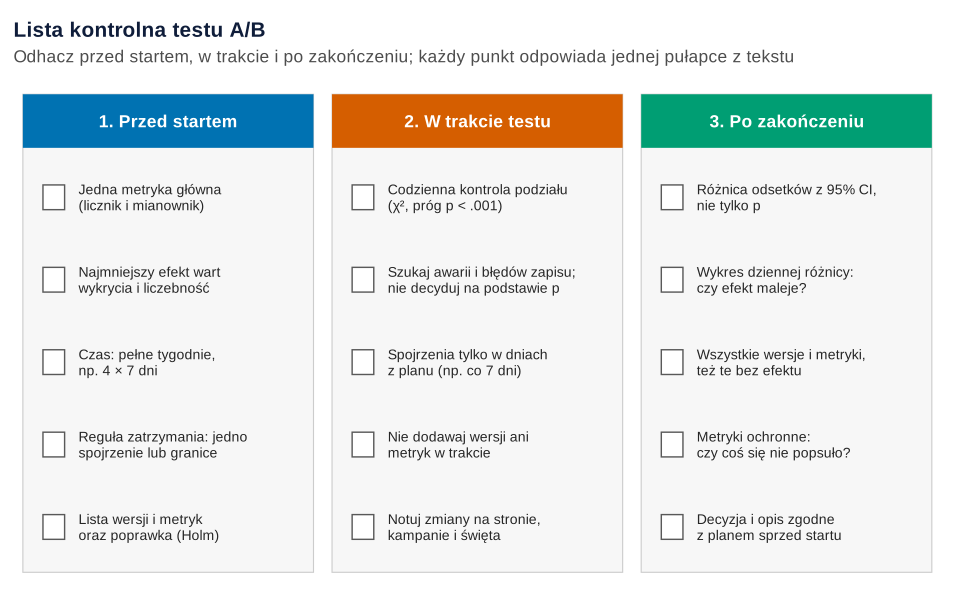
Co widać. Piętnaście punktów w trzech etapach. Każdy odpowiada pułapce z tego wpisu albo z wpisu o planie testu. Pierwsza kolumna to w praktyce plan analizy statystycznej: zapisany z datą, zanim pierwsza osoba zobaczy wersję B.
Jak może zmylić. Lista nie zastąpi liczebności: test zbyt mały pozostanie zbyt mały mimo odhaczonych pól. Nie obejmuje też metryk ilorazowych, np. średniej wartości koszyka – o nich wpis wskaźniki ilorazowe w testach A/B.
Podpis do pracy:
Co z tym zrobić w marketingu
- Panel z wynikami na żywo pokazuj zespołowi jako stan techniczny, bez wartości p, albo z granicami sekwencyjnymi wpisanymi w wykres.
- „Zwycięzca” z jednej z pięciu metryk to hipoteza do kolejnego testu, nie decyzja wdrożeniowa.
- Nowy wygląd strony lub aplikacji testuj co najmniej kilka tygodni i porównaj pierwszy tydzień z ostatnimi. Prognozę zysku licz z ostatnich tygodni, nie z całości.
- Alarm SRM zatrzymuje interpretację. Szukaj przyczyny (skrypt pomiarowy, przekierowania, filtr botów), napraw i powtórz test.
- Wynik istotny przy małym teście bywa przeszacowany – zob. klątwa zwycięzcy. Przed dużym wdrożeniem warto test powtórzyć.
Jak opisać w pracy
W Metodzie podaj regułę zatrzymania (jedno spojrzenie albo plan sekwencyjny z liczbą spojrzeń i funkcją wydatkowania), listę wersji i metryk z poprawką oraz sposób kontroli podziału. W Wynikach najpierw kontrola podziału, potem metryka główna z przedziałem ufności, potem zmienność efektu w czasie. Ogólne przykłady statystyki w pracach z marketingu zebrano we wpisie statystyka w pracy z marketingu.
Kod R: pułapki testów A/B w symulacjach
Kod odtwarza wszystkie liczby z tekstu i pięć rysunków. Uruchom przepisy po kolei w jednej sesji R: przepis 1 tworzy paletę i motyw, z których korzystają kolejne. Testy proporcji, χ² i regresję logistyczną liczy bazowy R; granice sekwencyjne – gsDesign, skorelowane statystyki z – mvtnorm. Każdy przepis z rysunkiem kończy się nazwą wykresu (p1–p5), co wyświetla go w oknie R; do zapisu w pliku SVG użyj ggsave() jak w komentarzu. Rysunki na tej stronie powstały z tych samych obiektów p1–p5, którym podmieniono tylko motyw na motyw serwisu (krój i kolor czcionki, siatka) – dane, geometrie i skale są identyczne.
Losują przepisy 1–4; każdy losujący blok zaczyna się od własnego set.seed(612). Ziarno 612 ustalono raz i nie zmieniano go. Ręcznie ustalono: odsetek rezerwacji 4%, 1400 nowych osób dziennie na wersję, 28 dni, cztery spojrzenia (po każdym tygodniu), korelacje statystyk .4 między metrykami i .5 między porównaniami ze wspólną kontrolą, 2500 odwiedzających dziennie i efekt 0.3 + 1.0 × exp(−(dzień − 1)/5) punktu procentowego w przepisie 3 oraz w przepisie 4: 30% osób szybko wychodzących, 25% z nich gubionych w wersji B (podniesione z 10% po pierwszym uruchomieniu) i wersję B o 2% (względnie) gorszą. Całość liczy się w kilka sekund.
1. Paleta, motyw i 1000 testów A/A z zaglądaniem: Rysunek 1
R
# Rysunek 1. Zaglądanie do wyników: 1000 testów A/A w biurze podróży online (dane symulowane)
library(ggplot2)
library(patchwork)

# Paleta Okabe–Ito (rozróżnialna także przy deuteranopii) i prosty motyw – korzystają z nich kolejne przepisy
kol <- c(niebieski = "#0072B2", cynober = "#D55E00", pomarancz = "#E69F00", zielony = "#009E73",
         fiolet = "#CC79A7", szary = "grey60", ciemny = "grey20")
motyw <- theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a", size = rel(1.0)),
        plot.subtitle = element_text(colour = "grey30"), panel.grid.minor = element_blank(),
        panel.grid.major = element_line(colour = "grey88", linewidth = 0.4),
        strip.text = element_text(face = "bold", colour = "#0f1d3a"), legend.position = "bottom",
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))

# Plan testu (ustalony ręcznie): odsetek rezerwacji 4%, 1400 nowych osób dziennie na wersję, 28 dni (4 pełne tygodnie)
p0 <- 0.04; dziennie <- 1400; dni <- 28
power.prop.test(n = dziennie * dni, p1 = 0.040, p2 = 0.044)$power   # moc dla wzrostu 4.0% → 4.4%

# Test dla dwóch proporcji (statystyka z) na danych skumulowanych do danego dnia
z_dwie_proporcje <- function(xa, na, xb, nb) {
  p <- (xa + xb) / (na + nb)
  (xb / nb - xa / na) / sqrt(p * (1 - p) * (1 / na + 1 / nb))
}

set.seed(612)                                   # ziarno ustalone raz, bez dobierania pod wynik
n_testow <- 1000
Z <- matrix(NA_real_, n_testow, dni)            # wiersz = test A/A, kolumna = dzień
for (i in seq_len(n_testow)) {
  xa <- cumsum(rbinom(dni, dziennie, p0))       # obie wersje mają ten sam odsetek 4%
  xb <- cumsum(rbinom(dni, dziennie, p0))
  n  <- dziennie * seq_len(dni)
  Z[i, ] <- z_dwie_proporcje(xa, n, xb, n)
}

# Granice sekwencyjne dla 4 zaplanowanych spojrzeń (po każdym tygodniu), α = .05 dwustronnie
plan_obf <- gsDesign::gsDesign(k = 4, test.type = 2, alpha = 0.025, sfu = gsDesign::sfLDOF)
plan_poc <- gsDesign::gsDesign(k = 4, test.type = 2, alpha = 0.025, sfu = gsDesign::sfLDPocock)
tygodnie <- c(7, 14, 21, 28)
alarm <- function(kolumny, granica) apply(abs(Z[, kolumny, drop = FALSE]) > rep(granica, each = n_testow), 1, any)
zasady <- list("jedno spojrzenie po 28 dniach" = alarm(28, qnorm(0.975)),
               "co tydzień, zwykłe p < .05" = alarm(tygodnie, rep(qnorm(0.975), 4)),
               "co tydzień, granice O’Briena–Fleminga" = alarm(tygodnie, plan_obf$upper$bound),
               "co tydzień, granice Pococka" = alarm(tygodnie, plan_poc$upper$bound),
               "codziennie, zwykłe p < .05" = alarm(1:dni, rep(qnorm(0.975), dni)))
wyn <- data.frame(zasada = names(zasady), falszywe_alarmy = sapply(zasady, mean))
wyn$blad_mc <- sqrt(wyn$falszywe_alarmy * (1 - wyn$falszywe_alarmy) / n_testow)   # błąd Monte Carlo
print(transform(wyn, falszywe_alarmy = round(100 * falszywe_alarmy, 1), blad_mc = round(100 * blad_mc, 1)),
      row.names = FALSE)
round(rbind(OBF = plan_obf$upper$bound, Pocock = plan_poc$upper$bound), 3)   # granice |z| w tygodniach 1–4

# Kiedy pojawia się pierwszy fałszywy alarm przy codziennym zaglądaniu?
pierwszy <- apply(abs(Z) > qnorm(0.975), 1, function(w) if (any(w)) which(w)[1] else NA)
c(testy_z_alarmem = sum(!is.na(pierwszy)), mediana_dnia = median(pierwszy, na.rm = TRUE),
  w_pierwszym_tygodniu = sum(pierwszy <= 7, na.rm = TRUE),
  istotne_tez_w_dniu_28 = sum(!is.na(pierwszy) & abs(Z[, 28]) > qnorm(0.975)))

# Rysunek: A – ścieżki p dla 40 pierwszych testów; B – skumulowany odsetek testów z alarmem do danego dnia
pokaz <- 1:40
sciezki <- data.frame(test = rep(pokaz, each = dni), dzien = rep(1:dni, length(pokaz)),
                      p = as.vector(t(2 * pnorm(-abs(Z[pokaz, ])))))
sciezki$alarm <- ifelse(sciezki$test %in% pokaz[!is.na(pierwszy[pokaz])], "choć raz p < .05", "nigdy p < .05")
kumul <- data.frame(dzien = 1:dni, odsetek = sapply(1:dni, function(d) mean(!is.na(pierwszy) & pierwszy <= d)))
kumul$se <- sqrt(kumul$odsetek * (1 - kumul$odsetek) / n_testow)
pA <- ggplot(sciezki, aes(dzien, p, group = test, colour = alarm, linewidth = alarm)) +
  geom_line(alpha = 0.8) +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = kol[["ciemny"]]) +
  annotate("text", x = 28, y = 0.034, label = "p = .05", hjust = 1, size = 3.6, colour = kol[["ciemny"]]) +
  scale_y_log10(breaks = c(0.001, 0.01, 0.05, 0.2, 1), labels = c(".001", ".01", ".05", ".2", "1")) +
  scale_colour_manual(values = c("choć raz p < .05" = kol[["cynober"]], "nigdy p < .05" = kol[["szary"]]), name = NULL) +
  scale_linewidth_manual(values = c("choć raz p < .05" = 0.9, "nigdy p < .05" = 0.4), name = NULL) +
  scale_x_continuous(breaks = tygodnie) +
  labs(x = "Dzień testu", y = "Wartość p (skala log)", title = "A. Ścieżki p w 40 testach A/A") + motyw
pB <- ggplot(kumul, aes(dzien, odsetek)) +
  geom_ribbon(aes(ymin = odsetek - 1.96 * se, ymax = odsetek + 1.96 * se), fill = kol[["cynober"]], alpha = 0.2) +
  geom_step(colour = kol[["cynober"]], linewidth = 1.1) +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = kol[["niebieski"]]) +
  annotate("text", x = 1, y = 0.065, label = "α = 5% (jedno spojrzenie)", hjust = 0, size = 3.6, colour = kol[["niebieski"]]) +
  scale_y_continuous(labels = scales::percent, limits = c(0, 0.3)) + scale_x_continuous(breaks = tygodnie) +
  labs(x = "Dzień testu", y = "Testy z fałszywym alarmem do tego dnia",
       title = "B. Codzienne zaglądanie: odsetek alarmów") + motyw
p1 <- pA + pB + plot_layout(guides = "collect") & theme(legend.position = "bottom")
p1   # zapis: ggsave("pulapki-testow-a-b-zagladanie.svg", p1, width = 10, height = 5.4)
Wynik w R
[1] 0.7972542
                                zasada falszywe_alarmy blad_mc
         jedno spojrzenie po 28 dniach             5.2     0.7
            co tydzień, zwykłe p < .05            12.4     1.0
 co tydzień, granice O’Briena–Fleminga             5.1     0.7
           co tydzień, granice Pococka             6.4     0.8
            codziennie, zwykłe p < .05            27.0     1.4
        [,1]  [,2]  [,3]  [,4]
OBF    4.333 2.963 2.359 2.014
Pocock 2.368 2.368 2.358 2.350
      testy_z_alarmem          mediana_dnia  w_pierwszym_tygodniu
                  270                     5                   177
istotne_tez_w_dniu_28
                   52
2. Wiele wersji i metryk: Rysunek 2
R
# Rysunek 2. Wiele wariantów i wiele metryk: odsetek testów A/A z fałszywym „zwycięzcą”
# Korzysta z palety kol i motywu motyw z przepisu 1.
library(ggplot2)

# Przy dziesiątkach tysięcy osób statystyki z mają rozkład normalny, więc losujemy je od razu (bez pojedynczych wizyt).
# Korelacje ustalone ręcznie: dwa porównania z tą samą kontrolą – .5 (przy równych grupach),
# metryki (rezerwacja, przychód, kliknięcie w ofertę, dodanie do ulubionych, czas na stronie) – .4 między sobą.
metryki <- c("rezerwacja", "przychód", "kliknięcie w ofertę", "ulubione", "czas na stronie")
kor_metryk <- matrix(0.4, 5, 5); diag(kor_metryk) <- 1
scenariusze <- data.frame(wersje_nowe = c(1, 1, 3, 3), liczba_metryk = c(1, 5, 1, 5))
scenariusze$porownania <- scenariusze$wersje_nowe * scenariusze$liczba_metryk

set.seed(612)                                   # to samo ziarno co w przepisie 1
n_testow <- 1000
wynik <- do.call(rbind, lapply(seq_len(nrow(scenariusze)), function(s) {
  k <- scenariusze$wersje_nowe[s]; m <- scenariusze$liczba_metryk[s]
  kor_wersji <- matrix(0.5, k, k); diag(kor_wersji) <- 1
  R <- kronecker(kor_wersji, kor_metryk[1:m, 1:m, drop = FALSE])   # korelacje wszystkich porównań
  Zs <- mvtnorm::rmvnorm(n_testow, sigma = R)                       # 1000 testów A/A (wszystkie H0 prawdziwe)
  P <- 2 * pnorm(-abs(Zs))
  bez <- apply(P < .05, 1, any)
  holm <- apply(P, 1, function(p) any(p.adjust(p, "holm") < .05))
  data.frame(scenariusze[s, ], niezalezne_wzor = 1 - 0.95^(k * m),
             bez_poprawki = mean(bez), z_holmem = mean(holm))
}))
wynik$blad_mc_bez <- sqrt(wynik$bez_poprawki * (1 - wynik$bez_poprawki) / n_testow)
print(transform(wynik, niezalezne_wzor = round(100 * niezalezne_wzor, 1), bez_poprawki = round(100 * bez_poprawki, 1),
                z_holmem = round(100 * z_holmem, 1), blad_mc_bez = round(100 * blad_mc_bez, 1)), row.names = FALSE)

wykres <- rbind(data.frame(wynik[, 1:3], zasada = "bez poprawki", odsetek = wynik$bez_poprawki),
                data.frame(wynik[, 1:3], zasada = "poprawka Holma", odsetek = wynik$z_holmem))
wykres$etykieta <- sprintf("%d %s × %d %s\n(%d porównań)", wykres$wersje_nowe,
                           ifelse(wykres$wersje_nowe == 1, "wersja", "wersje"), wykres$liczba_metryk,
                           ifelse(wykres$liczba_metryk == 1, "metryka", "metryk"), wykres$porownania)
wykres$etykieta <- factor(wykres$etykieta, unique(wykres$etykieta))
wykres$se <- sqrt(wykres$odsetek * (1 - wykres$odsetek) / n_testow)
wzor <- data.frame(etykieta = levels(wykres$etykieta), wzor = wynik$niezalezne_wzor)
p2 <- ggplot(wykres, aes(etykieta, odsetek, fill = zasada)) +
  geom_col(position = position_dodge(0.75), width = 0.7) +
  geom_errorbar(aes(ymin = odsetek - 1.96 * se, ymax = odsetek + 1.96 * se), position = position_dodge(0.75),
                width = 0.15, colour = "grey25") +
  geom_text(aes(label = sprintf("%.1f%%", 100 * odsetek), y = odsetek + 1.96 * se + 0.012),
            position = position_dodge(0.75), vjust = 0, size = 3.6, colour = "grey20") +
  geom_point(data = wzor, aes(etykieta, wzor), inherit.aes = FALSE, shape = 4, size = 3.5, stroke = 1.3,
             colour = kol[["ciemny"]]) +
  geom_hline(yintercept = 0.05, linetype = "dashed", colour = kol[["ciemny"]]) +
  scale_fill_manual(values = c("bez poprawki" = kol[["cynober"]], "poprawka Holma" = kol[["niebieski"]]), name = NULL) +
  scale_y_continuous(labels = scales::percent, limits = c(0, 0.6), expand = c(0, 0)) +
  labs(x = NULL, y = "Testy A/A z co najmniej jednym p < .05",
       title = "Im więcej porównań, tym częściej „wygrywa” wersja bez efektu",
       subtitle = "1000 testów A/A na scenariusz; × = wzór 1 − 0.95^m dla niezależnych porównań; wąsy – 95% przedział błędu MC") +
  motyw
p2   # zapis: ggsave("pulapki-testow-a-b-warianty-i-metryki.svg", p2, width = 10, height = 5.6)
Wynik w R
 wersje_nowe liczba_metryk porownania niezalezne_wzor bez_poprawki z_holmem
           1             1          1             5.0          5.7      5.7
           1             5          5            22.6         19.2      4.8
           3             1          3            14.3         10.4      3.5
           3             5         15            53.7         44.8      4.2
 blad_mc_bez
         0.7
         1.2
         1.0
         1.6
3. Efekt nowości: Rysunek 3 i plik CSV
R
# Rysunek 3. Efekt nowości: dzienna różnica odsetka rezerwacji B − A w 28-dniowym teście (dane symulowane)
# Korzysta z palety kol i motywu motyw z przepisu 1.
library(ggplot2)

# Prawdziwy efekt (ustalony ręcznie): trwałe +0.3 pp plus +1.0 pp nowości, która wygasa (połowa po ok. 3.5 dnia)
dni <- 28; odwiedzajacy <- 2500; p_a <- 0.040                       # osoby odwiedzające stronę danego dnia, na wersję
efekt <- function(d) 0.003 + 0.010 * exp(-(d - 1) / 5)
symuluj_test <- function() {
  data.frame(dzien = rep(1:dni, 2), wersja = rep(c("A", "B"), each = dni), odwiedzajacy = odwiedzajacy,
             rezerwacje = c(rbinom(dni, odwiedzajacy, p_a), rbinom(dni, odwiedzajacy, p_a + efekt(1:dni))))
}
set.seed(612)                                   # to samo ziarno co w przepisie 1
test <- symuluj_test()
write.csv(test, "pulapki-testow-a-b-dzienne-rezerwacje.csv", row.names = FALSE)

# Różnica odsetków w okresie: B − A z 95% CI (przybliżenie normalne)
roznica <- function(dane, od, do) {
  s <- aggregate(cbind(rezerwacje, odwiedzajacy) ~ wersja, subset(dane, dzien >= od & dzien <= do), sum)
  pa <- s$rezerwacje[1] / s$odwiedzajacy[1]; pb <- s$rezerwacje[2] / s$odwiedzajacy[2]
  se <- sqrt(pa * (1 - pa) / s$odwiedzajacy[1] + pb * (1 - pb) / s$odwiedzajacy[2])
  c(roznica_pp = 100 * (pb - pa), dolna = 100 * (pb - pa - 1.96 * se), gorna = 100 * (pb - pa + 1.96 * se),
    p = 2 * pnorm(-abs((pb - pa) / se)))
}
okresy <- rbind("tydzień 1 (dni 1–7)" = roznica(test, 1, 7), "cały test (dni 1–28)" = roznica(test, 1, 28),
                "tygodnie 3–4 (dni 15–28)" = roznica(test, 15, 28))
round(okresy, 4)
c(prawdziwy_efekt_dzien_1_pp = 100 * efekt(1), prawdziwy_trwaly_pp = 0.3,
  prawdziwa_srednia_28_dni_pp = round(100 * mean(efekt(1:dni)), 2))

# Czy efekt zmienia się w czasie? Regresja logistyczna z interakcją wersja × dzień (test ilorazu wiarygodności, 1 df)
m0 <- glm(cbind(rezerwacje, odwiedzajacy - rezerwacje) ~ wersja + dzien, binomial, data = test)
m1 <- glm(cbind(rezerwacje, odwiedzajacy - rezerwacje) ~ wersja * dzien, binomial, data = test)
anova(m0, m1, test = "LRT")

# 1000 powtórzeń tego samego testu: co dałby test zatrzymany po tygodniu, a co po czterech?
set.seed(612)
powt <- t(replicate(1000, { d <- symuluj_test(); c(roznica(d, 1, 7)[1], roznica(d, 1, 28)[1], roznica(d, 15, 28)[1]) }))
colnames(powt) <- c("tydzien_1", "caly_test", "tygodnie_3_4")
round(colMeans(powt), 3)                        # średnia oszacowana różnica (pp) w 1000 testach

# Rysunek: dzienna różnica z 95% CI, skumulowana różnica i prawdziwy efekt
dz <- reshape(test[, 1:4], idvar = "dzien", timevar = "wersja", direction = "wide")
dz$pa <- dz$rezerwacje.A / dz$odwiedzajacy.A; dz$pb <- dz$rezerwacje.B / dz$odwiedzajacy.B
dz$rozn <- 100 * (dz$pb - dz$pa)
dz$se <- 100 * sqrt(dz$pa * (1 - dz$pa) / odwiedzajacy + dz$pb * (1 - dz$pb) / odwiedzajacy)
dz$kumul <- sapply(dz$dzien, function(d) roznica(test, 1, d)[1])
linie <- rbind(data.frame(dzien = dz$dzien, y = dz$kumul, co = "różnica skumulowana od dnia 1"),
               data.frame(dzien = dz$dzien, y = 100 * efekt(dz$dzien), co = "prawdziwy efekt (znany w symulacji)"))
p3 <- ggplot(dz, aes(dzien, rozn)) +
  annotate("rect", xmin = 0.5, xmax = 7.5, ymin = -Inf, ymax = Inf, fill = kol[["pomarancz"]], alpha = 0.12) +
  annotate("text", x = 4, y = 3.1, label = "tydzień 1", size = 3.6, colour = "grey30") +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_errorbar(aes(ymin = rozn - 1.96 * se, ymax = rozn + 1.96 * se), width = 0, colour = kol[["szary"]]) +
  geom_point(colour = kol[["ciemny"]], size = 1.9) +
  geom_line(data = linie, aes(dzien, y, colour = co, linetype = co), linewidth = 1.1) +
  scale_colour_manual(values = c("różnica skumulowana od dnia 1" = kol[["cynober"]],
                                 "prawdziwy efekt (znany w symulacji)" = kol[["niebieski"]]), name = NULL) +
  scale_linetype_manual(values = c("różnica skumulowana od dnia 1" = "solid",
                                   "prawdziwy efekt (znany w symulacji)" = "dashed"), name = NULL) +
  scale_x_continuous(breaks = c(1, 7, 14, 21, 28)) +
  labs(x = "Dzień testu", y = "Różnica odsetka rezerwacji B − A (pp)",
       title = "Efekt nowości: przewaga wersji B topnieje",
       subtitle = sprintf("Punkty – różnica dzienna z 95%% CI (%d osób dziennie na wersję)", odwiedzajacy)) +
  motyw
p3   # zapis: ggsave("pulapki-testow-a-b-efekt-nowosci.svg", p3, width = 10, height = 5.6)
Wynik w R
                         roznica_pp   dolna  gorna      p
tydzień 1 (dni 1–7)          0.7486  0.3177 1.1794 0.0007
cały test (dni 1–28)         0.5086  0.2959 0.7212 0.0000
tygodnie 3–4 (dni 15–28)     0.2886 -0.0099 0.5871 0.0581
 prawdziwy_efekt_dzien_1_pp         prawdziwy_trwaly_pp
                        1.3                         0.3
prawdziwa_srednia_28_dni_pp
                        0.5
Analysis of Deviance Table

Model 1: cbind(rezerwacje, odwiedzajacy - rezerwacje) ~ wersja + dzien
Model 2: cbind(rezerwacje, odwiedzajacy - rezerwacje) ~ wersja * dzien
  Resid. Df Resid. Dev Df Deviance Pr(>Chi)
1        53     60.547
2        52     57.582  1   2.9647   0.0851 .
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
   tydzien_1    caly_test tygodnie_3_4
       0.897        0.501        0.325
4. Nierówny podział ruchu (SRM): Rysunek 4
R
# Rysunek 4. Nierówny podział ruchu (SRM): błąd zapisu wizyt w wersji B (dane symulowane)
# Korzysta z palety kol i motywu motyw z przepisu 1.
library(ggplot2)
library(patchwork)

# Scenariusz (ustalony ręcznie): losowanie 50/50 działa, ale w wersji B skrypt pomiarowy ładuje się później
# i nie zapisuje 25% osób, które wychodzą w pierwszych sekundach. Takie osoby (30% ruchu) nigdy nie rezerwują.
# Pozostali rezerwują z p = 4%/0.7 w A i o 2% rzadziej w B – wersja B jest więc naprawdę trochę GORSZA.
dziennie <- 1400; dni <- 28; udzial_szybkich <- 0.30; gubione <- 0.25
p_a <- 0.04 / (1 - udzial_szybkich); p_b <- 0.98 * p_a
symuluj_srm <- function(blad = TRUE) {
  n_a <- rbinom(1, 2 * dziennie * dni, 0.5)                   # losowanie 50/50 osób do wersji A i B
  n_b <- 2 * dziennie * dni - n_a
  szybcy_b <- rbinom(1, n_b, udzial_szybkich)
  zapisani_b <- n_b - if (blad) rbinom(1, szybcy_b, gubione) else 0
  x_a <- rbinom(1, n_a - rbinom(1, n_a, udzial_szybkich), p_a)  # rezerwują tylko osoby, które nie wyszły od razu
  x_b <- rbinom(1, n_b - szybcy_b, p_b)
  srm <- chisq.test(c(n_a, zapisani_b), p = c(0.5, 0.5))      # kontrola podziału: test chi-kwadrat zgodności
  pa <- x_a / n_a; pb <- x_b / zapisani_b
  se <- sqrt(pa * (1 - pa) / n_a + pb * (1 - pb) / zapisani_b)
  c(n_a = n_a, n_b = zapisani_b, chi2 = unname(srm$statistic), p_srm = srm$p.value,
    proc_a = 100 * pa, proc_b = 100 * pb, roznica_pp = 100 * (pb - pa), p_efekt = 2 * pnorm(-abs((pb - pa) / se)))
}
prawdziwa_roznica_pp <- 100 * (1 - udzial_szybkich) * (p_b - p_a)
round(c(prawdziwa_roznica_pp = prawdziwa_roznica_pp), 3)

set.seed(612)                                   # to samo ziarno co w przepisie 1
jeden <- symuluj_srm()
round(c(jeden, udzial_b = jeden[["n_b"]] / (jeden[["n_a"]] + jeden[["n_b"]])), 4)

# 1000 testów z błędem zapisu i 1000 bez błędu
set.seed(612)
S <- rbind(data.frame(t(replicate(1000, symuluj_srm(TRUE))), zapis = "z błędem zapisu w B"),
           data.frame(t(replicate(1000, symuluj_srm(FALSE))), zapis = "poprawny zapis"))
podsum <- aggregate(cbind(srm_p_ponizej_001 = p_srm < 0.001, srednia_roznica_pp = roznica_pp,
                          B_istotnie_lepsza = roznica_pp > 0 & p_efekt < 0.05,
                          B_istotnie_gorsza = roznica_pp < 0 & p_efekt < 0.05) ~ zapis, S, mean)
podsum[, c(2, 4, 5)] <- 100 * podsum[, c(2, 4, 5)]
print(transform(podsum, srednia_roznica_pp = round(srednia_roznica_pp, 3)), digits = 3, row.names = FALSE)

S$zapis <- factor(S$zapis, c("poprawny zapis", "z błędem zapisu w B"))
pA <- ggplot(S, aes(chi2, fill = zapis)) +
  geom_histogram(bins = 40, boundary = 0, colour = "white", linewidth = 0.2, position = "identity", alpha = 0.85) +
  geom_vline(xintercept = qchisq(0.999, 1), linetype = "dashed", colour = kol[["ciemny"]]) +
  annotate("text", x = qchisq(0.999, 1) + 2, y = Inf, vjust = 1.6, hjust = 0, size = 3.5, colour = kol[["ciemny"]],
           label = "próg p = .001") +
  scale_x_sqrt(breaks = c(1, 10, 50, 100, 200)) +
  scale_fill_manual(values = c("poprawny zapis" = kol[["niebieski"]], "z błędem zapisu w B" = kol[["cynober"]]),
                    name = NULL) +
  labs(x = "χ² zgodności z podziałem 50/50 (skala pierwiastkowa)", y = "Liczba testów",
       title = "A. Kontrola podziału (SRM)") + motyw
pB <- ggplot(S, aes(zapis, roznica_pp, colour = zapis, shape = zapis)) +
  geom_hline(yintercept = 0, colour = "grey40") +
  geom_hline(yintercept = prawdziwa_roznica_pp, linetype = "dashed", colour = kol[["ciemny"]]) +
  geom_jitter(data = S[S$zapis == "poprawny zapis", ][1:300, ], width = 0.25, height = 0, alpha = 0.45, size = 1.3) +
  geom_jitter(data = S[S$zapis != "poprawny zapis", ][1:300, ], width = 0.25, height = 0, alpha = 0.45, size = 1.3) +
  annotate("label", x = 0.45, y = prawdziwa_roznica_pp - 0.04, hjust = 0, vjust = 1, size = 3.5, colour = kol[["ciemny"]],
           fill = "white", linewidth = 0,
           label = sub("-", "−", sprintf("prawdziwa różnica %.2f pp", prawdziwa_roznica_pp))) +
  stat_summary(fun = mean, geom = "crossbar", width = 0.6, colour = "grey15", linewidth = 0.5) +
  scale_colour_manual(values = c("poprawny zapis" = kol[["niebieski"]], "z błędem zapisu w B" = kol[["cynober"]]),
                      guide = "none") +
  scale_shape_manual(values = c(16, 17), guide = "none") +
  labs(x = NULL, y = "Oszacowana różnica B − A (pp)", title = "B. Oszacowany efekt",
       subtitle = "300 testów na grupę; kreska – średnia z 1000") + motyw
p4 <- pA + pB + plot_layout(widths = c(1.15, 1)) & theme(legend.position = "bottom")
p4   # zapis: ggsave("pulapki-testow-a-b-srm.svg", p4, width = 10, height = 5.4)
Wynik w R
prawdziwa_roznica_pp
               -0.08
       n_a        n_b       chi2      p_srm     proc_a     proc_b roznica_pp
39310.0000 36177.0000   130.0315     0.0000     3.7344     4.0827     0.3483
   p_efekt   udzial_b
    0.0137     0.4792
               zapis srm_p_ponizej_001 srednia_roznica_pp B_istotnie_lepsza
      poprawny zapis               0.1             -0.083               1.3
 z błędem zapisu w B             100.0              0.241              39.0
 B_istotnie_gorsza
               8.3
               0.0
5. Lista kontrolna jako karta: Rysunek 5
R
# Rysunek 5. Lista kontrolna testu A/B jako karta (grafika z prostokątów i tekstu w ggplot2)
# Korzysta z palety kol i motywu motyw z przepisu 1 (tu tylko kolory).
library(ggplot2)

etapy <- data.frame(x = 1:3, etap = c("1. Przed startem", "2. W trakcie testu", "3. Po zakończeniu"),
                    kolor = c(kol[["niebieski"]], kol[["cynober"]], kol[["zielony"]]))
punkty <- data.frame(
  x = rep(1:3, each = 5), y = rep(5:1, 3),
  tekst = c("Jedna metryka główna\n(licznik i mianownik)",
            "Najmniejszy efekt wart\nwykrycia i liczebność",
            "Czas: pełne tygodnie,\nnp. 4 × 7 dni",
            "Reguła zatrzymania: jedno\nspojrzenie lub granice",
            "Lista wersji i metryk\noraz poprawka (Holm)",
            "Codzienna kontrola podziału\n(χ², próg p < .001)",
            "Szukaj awarii i błędów zapisu;\nnie decyduj na podstawie p",
            "Spojrzenia tylko w dniach\nz planu (np. co 7 dni)",
            "Nie dodawaj wersji ani\nmetryk w trakcie",
            "Notuj zmiany na stronie,\nkampanie i święta",
            "Różnica odsetków z 95% CI,\nnie tylko p",
            "Wykres dziennej różnicy:\nczy efekt maleje?",
            "Wszystkie wersje i metryki,\nteż te bez efektu",
            "Metryki ochronne:\nczy coś się nie popsuło?",
            "Decyzja i opis zgodne\nz planem sprzed startu"))
p5 <- ggplot() +
  geom_rect(data = etapy, aes(xmin = x - 0.47, xmax = x + 0.47, ymin = 0.45, ymax = 6.25), fill = "grey97",
            colour = "grey80", linewidth = 0.4) +
  geom_rect(data = etapy, aes(xmin = x - 0.47, xmax = x + 0.47, ymin = 5.6, ymax = 6.25, fill = kolor)) +
  geom_text(data = etapy, aes(x, 5.925, label = etap), colour = "white", fontface = "bold", size = 4.6) +
  geom_tile(data = punkty, aes(x - 0.37, y, width = 0.07, height = 0.3), fill = "white", colour = "grey35",
            linewidth = 0.5) +
  geom_text(data = punkty, aes(x - 0.29, y, label = tekst), hjust = 0, size = 3.7, lineheight = 0.95,
            colour = "grey15") +
  scale_fill_identity() +
  scale_x_continuous(limits = c(0.5, 3.5), expand = c(0, 0)) + scale_y_continuous(limits = c(0.4, 6.3)) +
  labs(title = "Lista kontrolna testu A/B",
       subtitle = "Odhacz przed startem, w trakcie i po zakończeniu; każdy punkt odpowiada jednej pułapce z tekstu") +
  theme_void(base_size = 13) +
  theme(plot.title = element_text(face = "bold", colour = "#0f1d3a"), plot.subtitle = element_text(colour = "grey30"),
        plot.background = element_rect(fill = "white", colour = NA), plot.margin = margin(10, 14, 10, 10))
p5   # zapis: ggsave("pulapki-testow-a-b-lista-kontrolna.svg", p5, width = 10, height = 6.4)
6. Sprawdzenie palety przy zaburzeniach widzenia barw
R
# Czy paleta przetrwa zaburzenia widzenia barw? Symulacja w pakiecie colorspace
library(colorspace)
pary <- list("cynober – szary (alarm / brak alarmu; rysunek 1)" = c("#D55E00", "#999999"),
             "cynober – niebieski (bez poprawki / Holm; skumulowana / prawdziwa; błąd / poprawny)" = c("#D55E00", "#0072B2"),
             "pomarańczowe tło – białe (tydzień 1 na rysunku 3)" = c("#FCF4E0", "#FFFFFF"),
             "nagłówki karty: niebieski – zielony" = c("#0072B2", "#009E73"),
             "nagłówki karty: cynober – zielony" = c("#D55E00", "#009E73"),
             "czerwony – zielony (do unikania)" = c("#E41A1C", "#4DAF4A"))
roznica <- function(k) {           # odległość barw w przestrzeni CIELAB (ΔE)
  lab <- coords(as(hex2RGB(k), "LAB")); sqrt(sum((lab[1, ] - lab[2, ])^2))
}
round(t(sapply(pary, function(k) c(widzenie_typowe = roznica(k), deuteranopia = roznica(deutan(k)),
                                   protanopia = roznica(protan(k))))), 1)
Wynik w R
                                                                                    widzenie_typowe
cynober – szary (alarm / brak alarmu; rysunek 1)                                               77.2
cynober – niebieski (bez poprawki / Holm; skumulowana / prawdziwa; błąd / poprawny)           114.6
pomarańczowe tło – białe (tydzień 1 na rysunku 3)                                              11.2
nagłówki karty: niebieski – zielony                                                            70.1
nagłówki karty: cynober – zielony                                                             102.4
czerwony – zielony (do unikania)                                                              121.7
                                                                                    deuteranopia
cynober – szary (alarm / brak alarmu; rysunek 1)                                            62.9
cynober – niebieski (bez poprawki / Holm; skumulowana / prawdziwa; błąd / poprawny)        108.3
pomarańczowe tło – białe (tydzień 1 na rysunku 3)                                           11.0
nagłówki karty: niebieski – zielony                                                         55.4
nagłówki karty: cynober – zielony                                                           53.5
czerwony – zielony (do unikania)                                                            21.1
                                                                                    protanopia
cynober – szary (alarm / brak alarmu; rysunek 1)                                          56.0
cynober – niebieski (bez poprawki / Holm; skumulowana / prawdziwa; błąd / poprawny)       91.9
pomarańczowe tło – białe (tydzień 1 na rysunku 3)                                         11.2
nagłówki karty: niebieski – zielony                                                       58.0
nagłówki karty: cynober – zielony                                                         37.3
czerwony – zielony (do unikania)                                                          31.6
Bibliografia oprogramowania
Liczby na tej stronie pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (losowanie, test dla dwóch proporcji, test chi-kwadrat zgodności, regresja logistyczna, poprawka Holma i power.prop.test() – pakiety base i stats). Granice sekwencyjne wyznaczono pakietem gsDesign, a skorelowane statystyki z wylosowano pakietem mvtnorm. Rysunki wykonano w ggplot2 i patchwork (osie procentowe – pakiet scales); pliki SVG zapisano pakietem svglite, a paletę sprawdzono w symulacji zaburzeń widzenia barw pakietem colorspace. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
- scales (wersja 1.4.0): Wickham, H., Pedersen, T. L., & Seidel, D. (2025). scales: Scale functions for visualization [R package]. https://doi.org/10.32614/CRAN.package.scales
- gsDesign (wersja 3.11.0): Anderson, K. (2026). gsDesign: Group sequential design [R package]. https://doi.org/10.32614/CRAN.package.gsDesign
- mvtnorm (wersja 1.3-6): Genz, A., & Bretz, F. (2009). Computation of multivariate normal and t probabilities. Springer. ISBN 978-3-642-01688-2
- colorspace (wersja 2.1.2): Zeileis, A., Fisher, J. C., Hornik, K., Ihaka, R., McWhite, C. D., Murrell, P., Stauffer, R., & Wilke, C. O. (2020). colorspace: A toolbox for manipulating and assessing colors and palettes. Journal of Statistical Software, 96(1). https://doi.org/10.18637/jss.v096.i01
- svglite (wersja 2.2.2): Wickham, H., Henry, L., Pedersen, T. L., Luciani, T. J., Decorde, M., & Lise, V. (2025). svglite: An 'SVG' graphics device [R package]. https://doi.org/10.32614/CRAN.package.svglite
Inne pułapki w skrócie
- Przedłużanie testu, „aż wyjdzie”. To to samo co zaglądanie, tylko od drugiej strony.
- Wynik nieistotny jako dowód braku różnicy. Przy mocy 79.7% mniej więcej co piąty prawdziwy wzrost z 4.0% do 4.4% zostanie przeoczony.
- Losowanie wizyt zamiast osób. Ta sama osoba widzi obie wersje, a obserwacje nie są niezależne.
- Kilka testów naraz na tych samych osobach bez sprawdzenia, czy zmiany na siebie nie wpływają.
- Selekcja segmentów po teście. „B wygrywa wśród kobiet z telefonem” po przejrzeniu 20 segmentów to pułapka 2 w innym przebraniu. Gdy chcesz wiedzieć, komu zmiana pomaga, zaplanuj to jak we wpisie o modelowaniu uplift.
Pomoc przy planie i analizie testu do pracy: analizy statystyczne dla studentów.
Najczęstsze pytania
Czy można sprawdzać wyniki testu A/B codziennie?
Oglądać dane wolno, np. żeby wyłapać awarię, ale nie wolno decydować o końcu testu na podstawie zwykłej wartości p. W 1000 symulowanych testach A/A codzienne sprawdzanie i zatrzymanie przy p < .05 dało 27.0% fałszywych alarmów. Jeśli chcesz kończyć wcześniej, zaplanuj z góry spojrzenia i granice sekwencyjne, np. typu O’Briena–Fleminga.
Co to jest test A/A i po co go robić?
Test A/A porównuje dwie identyczne wersje strony. Każdy wynik istotny jest wtedy fałszywym alarmem, więc test A/A sprawdza, czy losowanie, zapis wizyt i analiza dają około 5% alarmów przy α = .05. Symulacja wielu testów A/A pokazuje też, jak zasady zatrzymania i liczba metryk zmieniają to ryzyko.
Co to jest SRM w teście A/B?
SRM (sample ratio mismatch) to rozbieżność między planowanym a obserwowanym podziałem osób między wersje, np. 47.9% zamiast 50%. Sprawdzasz ją testem chi-kwadrat zgodności. Wyraźny SRM oznacza błąd w losowaniu lub zapisie danych; w przykładzie sprawił, że gorsza wersja wyglądała na lepszą, więc wyniku nie interpretuj.
Jak rozpoznać efekt nowości w teście A/B?
Narysuj dzienną różnicę między wersjami i porównaj efekt z pierwszego tygodnia z efektem z ostatnich tygodni. W przykładzie przewaga spadła z 0.75 do 0.29 punktu procentowego. Formalny test trendu ma małą moc (tu p = .085), więc brak istotności nie wyklucza efektu nowości.
Czy przy teście A/B/C/D trzeba stosować poprawkę?
Tak, jeśli wybierasz zwycięzcę spośród kilku porównań. Przy trzech nowych wersjach jedna metryka dała 10.4% testów A/A z fałszywym zwycięzcą, a pięć metryk – 44.8%. Poprawka Holma utrzymała ten odsetek poniżej 5%. Jedną metrykę główną testuj na poziomie α, a pozostałe opisz jako eksploracyjne albo również skoryguj.
Powiązane hasła
Przeczytaj też
Test A/B – plan i analiza
Metryka główna, liczebność z power.prop.test, losowanie i czas trwania, skutki podglądania wyników w symulacji oraz różnica odsetków z CI i względny wzrost.
Czytaj →PoradnikCUPED – krótszy test A/B
Wydatki sprzed testu jako kowariant: węższy przedział, symulacja 1000 testów, związek z ANCOVA i pułapka kowariantu po starcie – z kodem R.
Czytaj →PoradnikWskaźniki ilorazowe w testach A/B – CTR i średni koszyk
Losujesz użytkowników, a liczysz wyświetlenia i zamówienia: naiwny przedział, metoda delta, bootstrap po użytkownikach i 1000 testów A/A – z kodem R.
Czytaj →PoradnikDługoterminowy holdout personalizacji
Serwis z muzyką: efekt personalizacji tydzień po tygodniu, zanik nowości, retencja abonentów, pułapki i koszt holdoutu – kod R.
Czytaj →Analizujesz test A/B do pracy z marketingu?
Pomożemy zaplanować liczebność i regułę zatrzymania, sprawdzić podział ruchu, poprawnie porównać wersje i metryki oraz opisać wynik tak, żebyś umiał(a) go obronić.
Oferta dla studentówWyceń analizęBibliografia i dalsza literatura naukowa (APA 7)
- Armitage, P., McPherson, C. K., & Rowe, B. C. (1969). Repeated significance tests on accumulating data. Journal of the Royal Statistical Society. Series A (General), 132(2), 235–244. https://doi.org/10.2307/2343787
- Fabijan, A., Gupchup, J., Gupta, S., Omhover, J., Qin, W., Vermeer, L., & Dmitriev, P. (2019). Diagnosing sample ratio mismatch in online controlled experiments: A taxonomy and rules of thumb for practitioners. In Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining (pp. 2156–2164). ACM. https://doi.org/10.1145/3292500.3330722
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Johari, R., Koomen, P., Pekelis, L., & Walsh, D. (2022). Always valid inference: Continuous monitoring of A/B tests. Operations Research, 70(3), 1806–1821. https://doi.org/10.1287/opre.2021.2135
- Kohavi, R., Tang, D., & Xu, Y. (2020). Trustworthy online controlled experiments: A practical guide to A/B testing. Cambridge University Press. https://doi.org/10.1017/9781108653985
- Lan, K. K. G., & DeMets, D. L. (1983). Discrete sequential boundaries for clinical trials. Biometrika, 70(3), 659–663. https://doi.org/10.1093/biomet/70.3.659
- Sadeghi, S., Gupta, S., Gramatovici, S., Lu, J., Ai, H., & Zhang, R. (2022). Novelty and primacy: A long-term estimator for online experiments. Technometrics, 64(4), 524–534. https://doi.org/10.1080/00401706.2022.2124309 ● Otwarty dostęp: pełny tekst
Cytowania BibTeX
@article{armitage1969repeated, author={Armitage, P. and McPherson, C. K. and Rowe, B. C.}, title={{Repeated significance tests on accumulating data}}, journal={Journal of the Royal Statistical Society. Series A (General)}, year={1969}, volume={132}, number={2}, pages={235--244}, doi={10.2307/2343787}}@inproceedings{fabijan2019diagnosing, author={Fabijan, Aleksander and Gupchup, Jayant and Gupta, Somit and Omhover, Jeff and Qin, Wen and Vermeer, Lukas and Dmitriev, Pavel}, title={{Diagnosing sample ratio mismatch in online controlled experiments: A taxonomy and rules of thumb for practitioners}}, booktitle={Proceedings of the 25th ACM SIGKDD International Conference on Knowledge Discovery \& Data Mining}, year={2019}, pages={2156--2164}, publisher={ACM}, doi={10.1145/3292500.3330722}}@article{holm1979simple, author={Holm, Sture}, title={{A simple sequentially rejective multiple test procedure}}, journal={Scandinavian Journal of Statistics}, year={1979}, volume={6}, number={2}, pages={65--70}, url={https://www.jstor.org/stable/4615733}}@article{johari2022always, author={Johari, Ramesh and Koomen, Pete and Pekelis, Leonid and Walsh, David}, title={{Always valid inference: Continuous monitoring of A/B tests}}, journal={Operations Research}, year={2022}, volume={70}, number={3}, pages={1806--1821}, doi={10.1287/opre.2021.2135}}@book{kohavi2020trustworthy, author={Kohavi, Ron and Tang, Diane and Xu, Ya}, title={{Trustworthy online controlled experiments: A practical guide to A/B testing}}, year={2020}, publisher={Cambridge University Press}, doi={10.1017/9781108653985}}@article{lan1983discrete, author={Lan, K. K. Gordon and DeMets, David L.}, title={{Discrete sequential boundaries for clinical trials}}, journal={Biometrika}, year={1983}, volume={70}, number={3}, pages={659--663}, doi={10.1093/biomet/70.3.659}}@article{sadeghi2022novelty, author={Sadeghi, Soheil and Gupta, Somit and Gramatovici, Stefan and Lu, Jiannan and Ai, Hao and Zhang, Ruhan}, title={{Novelty and primacy: A long-term estimator for online experiments}}, journal={Technometrics}, year={2022}, volume={64}, number={4}, pages={524--534}, doi={10.1080/00401706.2022.2124309}}