Co to jest SPRT?
Sekwencyjny test ilorazu wiarygodności (ang. sequential probability ratio test, SPRT) to test, w którym po każdej obserwacji liczy się iloraz wiarygodności dwóch prostych hipotez, H₁ do H₀, i podejmuje jedną z trzech decyzji: odrzucić H₀, przyjąć H₀ albo zebrać kolejną obserwację. Liczebność próby nie jest ustalona z góry, lecz zależy od danych. Test opisał Wald (1945). Wald i Wolfowitz (1948) udowodnili, że spośród testów o nie większych prawdopodobieństwach obu błędów SPRT wymaga średnio najmniej obserwacji przy każdej z dwóch hipotez.
Granice Walda
Dla dopuszczalnych prawdopodobieństw błędów I i II rodzaju α i β (moc 1 − β) przyjmuje się przybliżone granice:
- A ≈ (1 − β) / α – gdy iloraz wiarygodności ją przekroczy, odrzuca się H₀;
- B ≈ β / (1 − α) – gdy spadnie poniżej niej, przyjmuje się H₀;
- pomiędzy granicami zbiera się kolejną obserwację.
W praktyce sumuje się logarytmy ilorazów dla kolejnych obserwacji, podobnie jak w teście ilorazu wiarygodności, ale sumę porównuje się z log A i log B po każdym kroku. Nie myl tego z ilorazem wiarygodności testu diagnostycznego (LR+, LR−).
Przykład
Sprawdzamy, czy odsetek sukcesów wynosi 0.5 (H₀), czy 0.7 (H₁), przy α = .05 i β = .20: A = 16, B = 0.211. W 10 000 symulowanych ciągów przy prawdziwej H₀ odrzucono ją w 4.7% przypadków, średnio po 18.3 obserwacji, a przy prawdziwej H₁ – w 84.2%, średnio po 26.3. Test o stałej liczebności z tymi samymi α i mocą wymaga 37 obserwacji.
Na rysunku
Ten sam test co w przykładzie (H₀: π = 0.5, H₁: π = 0.7, α = .05, β = .20). Panel A pokazuje, jak po każdej obserwacji zmienia się logarytm ilorazu wiarygodności, panel B – ile obserwacji test zużywa w 10 000 ciągów z przykładu.
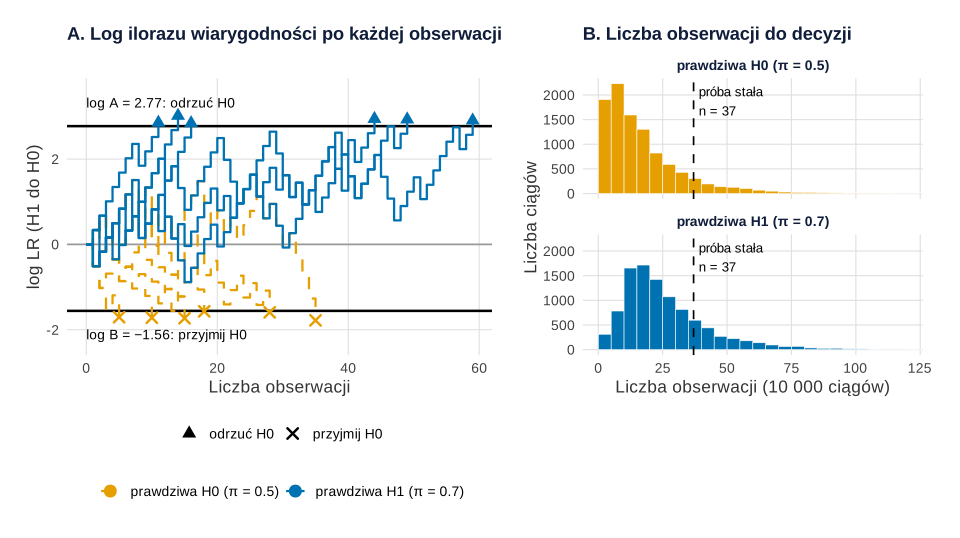
set.seed(594)).Co widać. Każdy sukces podnosi log LR o 0.336, każda porażka obniża go o 0.511, więc ścieżka idzie schodami, aż dotknie jednej z granic. Wszystkie 12 narysowanych ścieżek skończyło się poprawną decyzją, ale po bardzo różnej liczbie obserwacji – od 5 do 59. Panel B pokazuje to samo na 10 000 ciągów: średnia wynosi 18.3 przy H₀ i 26.3 przy H₁ (jak w przykładzie), mediana 14 i 21. Rozkład ma jednak długi ogon: więcej niż 37 obserwacji, czyli więcej niż test o stałej liczebności, potrzebowało 10.3% ciągów przy H₀ i 19.0% przy H₁ (błąd Monte Carlo 0.3 i 0.4 punktu procentowego), a najdłuższy ciąg miał 175 obserwacji.
Na co uważać. Oszczędność SPRT dotyczy średniej, a nie każdego badania – planując budżet, patrz na ogon rozkładu, a nie tylko na średnie n. Stąd w praktyce test obcięty z maksymalną liczebnością. Rysunek pokazuje tylko dwie wartości π; gdy prawdziwa wartość leży między nimi, ścieżki dłużej błądzą między granicami. Podobny obraz ścieżek, ale dla wartości p przy podglądaniu danych bez korekty, ma hasło opcjonalne zatrzymywanie.
Podpis do pracy:
Oba bloki losujące mają własne set.seed(594) – to samo ziarno co w przykładzie, ustalone raz. Część B powtarza symulację z przykładu, więc daje te same średnie. Liczbę 12 narysowanych ścieżek wybrano ręcznie. Rysunek na stronie różni się od wyniku kodu tylko motywem serwisu.
Kod R rysunku 1
# Rysunek 1. Ścieżki logarytmu ilorazu wiarygodności w SPRT z granicami Walda (A)
# i rozkład liczby obserwacji do decyzji w 10 000 ciągów przy H0 i przy H1 (B)
library(ggplot2)
library(patchwork)
motyw <- theme_minimal(base_size = 13) +
  theme(panel.grid.minor = element_blank(), legend.position = "bottom", plot.title = element_text(face = "bold"))
kol <- c("prawdziwa H0 (π = 0.5)" = "#E69F00", "prawdziwa H1 (π = 0.7)" = "#0072B2")

alfa <- 0.05; beta <- 0.20; p0 <- 0.5; p1 <- 0.7
logA <- log((1 - beta) / alfa); logB <- log(beta / (1 - alfa))   # granice Walda: 2.773 i -1.558
krok1 <- log(p1 / p0); krok0 <- log((1 - p1) / (1 - p0))         # zmiana log LR po sukcesie i po porażce
round(c(logA = logA, logB = logB, po_sukcesie = krok1, po_porazce = krok0), 3)

# A: po 6 ciągów przy każdej hipotezie, każdy do chwili decyzji
sprt_sciezka <- function(p, id) {
  llr <- 0; n <- 0; wart <- 0
  while (llr > logB && llr < logA) {
    n <- n + 1
    llr <- llr + ifelse(rbinom(1, 1, p) == 1, krok1, krok0)
    wart <- c(wart, llr)
  }
  data.frame(id = id, n = 0:n, llr = wart, prawda = names(kol)[1 + (p == p1)],
             decyzja = ifelse(llr >= logA, "odrzuć H0", "przyjmij H0"))
}
set.seed(594)
sc <- do.call(rbind, c(lapply(1:6, function(i) sprt_sciezka(p0, i)), lapply(7:12, function(i) sprt_sciezka(p1, i))))
konce <- do.call(rbind, lapply(split(sc, sc$id), function(d) d[nrow(d), ]))
print(table(konce$prawda, konce$decyzja))
range(konce$n)
pA <- ggplot(sc, aes(n, llr, group = id, colour = prawda, linetype = prawda)) +
  geom_hline(yintercept = c(logA, logB), linewidth = 0.9) +
  geom_hline(yintercept = 0, colour = "grey60") +
  annotate("text", x = 0, y = c(logA + 0.55, logB - 0.55), label = c("log A = 2.77: odrzuć H0", "log B = −1.56: przyjmij H0"),
           hjust = 0, size = 3.6) +
  geom_step(linewidth = 0.8, direction = "hv") +
  geom_point(data = konce, aes(shape = decyzja), size = 2.8, stroke = 1.3) +
  scale_colour_manual(values = kol, name = NULL) +
  scale_linetype_manual(values = c("dashed", "solid"), name = NULL) +
  scale_shape_manual(values = c("odrzuć H0" = 17, "przyjmij H0" = 4), name = NULL) +
  scale_y_continuous(limits = c(-2.3, 3.6)) +
  labs(title = "A. Log ilorazu wiarygodności po każdej obserwacji", x = "Liczba obserwacji", y = "log LR (H1 do H0)") +
  motyw

# B: ten sam test co w przykładzie hasła (10 000 ciągów przy H0 i przy H1, to samo ziarno)
A <- (1 - beta) / alfa; B <- beta / (1 - alfa)
sprt <- function(p, n_max = 1000) {
  llr <- 0
  for (n in 1:n_max) {
    x <- rbinom(1, 1, p)
    llr <- llr + x * log(p1 / p0) + (1 - x) * log((1 - p1) / (1 - p0))
    if (llr >= log(A)) return(c(n = n, odrzuc_H0 = 1))
    if (llr <= log(B)) return(c(n = n, odrzuc_H0 = 0))
  }
  c(n = n_max, odrzuc_H0 = NA)
}
set.seed(594)
wyn <- lapply(c(H0 = p0, H1 = p1), function(p) replicate(10000, sprt(p)))
n_stop <- data.frame(n = c(wyn$H0["n", ], wyn$H1["n", ]), prawda = factor(rep(names(kol), each = 10000), levels = names(kol)))
# średnia (jak w przykładzie hasła), mediana, 90. centyl i odsetek ciągów dłuższych niż próba stała 37 (z błędem MC)
podsum <- sapply(split(n_stop$n, n_stop$prawda), function(n)
  c(srednia = mean(n), mediana = median(n), centyl_90 = unname(quantile(n, 0.9)), max = max(n),
    proc_ponad_37 = 100 * mean(n > 37), blad_MC_pp = 100 * sqrt(mean(n > 37) * (1 - mean(n > 37)) / length(n))))
round(podsum, 1)
pB <- ggplot(n_stop, aes(n, fill = prawda)) +
  geom_histogram(binwidth = 5, boundary = 0, colour = "white", linewidth = 0.2) +
  geom_vline(xintercept = 37, linetype = "dashed") +
  annotate("text", x = 39, y = Inf, label = "próba stała\nn = 37", hjust = 0, vjust = 1.3, size = 3.5) +
  facet_wrap(~ prawda, ncol = 1) +
  scale_fill_manual(values = kol, guide = "none") +
  coord_cartesian(xlim = c(0, 120)) +
  labs(title = "B. Liczba obserwacji do decyzji", x = "Liczba obserwacji (10 000 ciągów)", y = "Liczba ciągów") +
  motyw
p1_rys <- pA + pB + plot_layout(widths = c(1.25, 1)) & theme(legend.box = "vertical")
p1_rys
Wynik w R
       logA        logB po_sukcesie  po_porazce
      2.773      -1.558       0.336      -0.511

                         odrzuć H0 przyjmij H0
  prawdziwa H0 (π = 0.5)         0           6
  prawdziwa H1 (π = 0.7)         6           0
[1]  5 59
              prawdziwa H0 (π = 0.5) prawdziwa H1 (π = 0.7)
srednia                         18.3                   26.3
mediana                         14.0                   21.0
centyl_90                       38.0                   49.0
max                            127.0                  175.0
proc_ponad_37                   10.3                   19.0
blad_MC_pp                       0.3                    0.4
Jak opisać w pracy
Na co uważać
- Hipotezy proste. Klasyczny SPRT porównuje dwie konkretne wartości parametru; gdy prawdziwa wartość leży między nimi, oczekiwana liczba obserwacji rośnie.
- Brak górnej granicy. Test może trwać długo, dlatego w praktyce dodaje się maksymalną liczebność (test obcięty).
- Dane w grupach. W badaniach klinicznych dane analizuje się zwykle partiami – wtedy stosuje się analizy pośrednie z funkcją wydatkowania alfa.
SPRT w R
Do SPRT nie potrzeba osobnego pakietu: kod w bazowym R liczy granice Walda, symuluje ciągi obserwacji 0/1 przy H₀ i przy H₁ i porównuje średnią liczbę obserwacji z testem o stałej liczebności.
SPRT dla odsetka sukcesów: 0.5 wobec 0.7
R
# SPRT Walda dla odsetka sukcesów: H0 (0.5) wobec H1 (0.7)
alfa <- 0.05; beta <- 0.20; p0 <- 0.5; p1 <- 0.7
A <- (1 - beta) / alfa; B <- beta / (1 - alfa)         # granice Walda dla ilorazu wiarygodności
round(c(A = A, B = B, logA = log(A), logB = log(B)), 3)
sprt <- function(p, n_max = 1000) {
  llr <- 0
  for (n in 1:n_max) {
    x <- rbinom(1, 1, p)                               # kolejna obserwacja 0/1
    llr <- llr + x * log(p1 / p0) + (1 - x) * log((1 - p1) / (1 - p0))
    if (llr >= log(A)) return(c(n = n, odrzuc_H0 = 1))
    if (llr <= log(B)) return(c(n = n, odrzuc_H0 = 0))
  }
  c(n = n_max, odrzuc_H0 = NA)
}
set.seed(594)
wyniki <- sapply(c(H0 = p0, H1 = p1), function(p) {
  r <- replicate(10000, sprt(p))
  c(odsetek_odrzucen_H0 = mean(r["odrzuc_H0", ]), srednie_n = mean(r["n", ]))
})
round(wyniki, 3)
# Porównanie: stała próba dla jednostronnego testu z alfa = 0.05 i mocą 80% (przybliżenie normalne)
ceiling(((qnorm(1 - alfa) * sqrt(p0 * (1 - p0)) + qnorm(1 - beta) * sqrt(p1 * (1 - p1))) / (p1 - p0))^2)
Wynik w R
     A      B   logA   logB
16.000  0.211  2.773 -1.558
                        H0     H1
odsetek_odrzucen_H0  0.047  0.842
srednie_n           18.268 26.291
[1] 37
Bibliografia oprogramowania
Wyniki pochodzą z uruchomienia pokazanego kodu w R 4.5.3 (funkcje pakietów base i stats). Rysunek 1 wykonano w pakietach ggplot2 i patchwork. W pracy podaj wersje faktycznie użytych pakietów (sessionInfo()).
- R: R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- ggplot2 (wersja 4.0.2): Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer. https://ggplot2.tidyverse.org
- patchwork (wersja 1.3.2): Pedersen, T. L. (2025). patchwork: The composer of plots [R package]. https://doi.org/10.32614/CRAN.package.patchwork
Najczęstsze pytania
Dlaczego SPRT wymaga mniej obserwacji niż test o stałej próbie?
Kończy się, gdy dane są już rozstrzygające, zamiast czekać na zaplanowaną liczebność. Wald i Wolfowitz (1948) wykazali, że przy tych samych prawdopodobieństwach błędów żaden test nie wymaga średnio mniej obserwacji.
Czy granice Walda dają dokładnie zakładane α i β?
Nie, to przybliżenia. Faktyczne prawdopodobieństwa błędów są zwykle zbliżone do zakładanych, a ich suma nie przekracza α + β; w przykładzie wyniosły 0.047 i 0.158.
Jak przeprowadzić SPRT w R?
Wystarczy bazowy R: po każdej obserwacji dodaj logarytm ilorazu wiarygodności i porównaj sumę z log A i log B. Kod na tej stronie robi to dla danych 0/1.
Powiązane hasła
Poradniki, w których użyjesz tego pojęcia
Analizy pośrednie w praktyce
Plan grupowo-sekwencyjny w R: granice Pococka i OBF, wzrost N, symulacja błędu I rodzaju, daremność i zawyżony efekt po wczesnym zatrzymaniu.
Czytaj →PoradnikSekwencyjny test A/B i granice zatrzymania
Gazeta cyfrowa testuje paywall z 4 analizami pośrednimi: granice O’Briena–Fleminga i Pococka, fałszywe alarmy, czas testu i zawyżony efekt – z kodem R.
Czytaj →Potrzebujesz wsparcia w analizie danych?
Wybierz ofertę dopasowaną do pracy dyplomowej albo profesjonalnego projektu naukowego.
Wyceń analizęOferta dla studentówBibliografia i dalsza literatura naukowa (APA 7)
- Wald, A. (1945). Sequential tests of statistical hypotheses. The Annals of Mathematical Statistics, 16(2), 117–186. https://doi.org/10.1214/aoms/1177731118 ● Otwarty dostęp
- Wald, A., & Wolfowitz, J. (1948). Optimum character of the sequential probability ratio test. The Annals of Mathematical Statistics, 19(3), 326–339. https://doi.org/10.1214/aoms/1177730197 ● Otwarty dostęp
Cytowania BibTeX
@article{wald1945sequential, author={Wald, Abraham}, title={{Sequential tests of statistical hypotheses}}, journal={The Annals of Mathematical Statistics}, year={1945}, volume={16}, number={2}, pages={117--186}, doi={10.1214/aoms/1177731118}}@article{wald1948optimum, author={Wald, Abraham and Wolfowitz, Jacob}, title={{Optimum character of the sequential probability ratio test}}, journal={The Annals of Mathematical Statistics}, year={1948}, volume={19}, number={3}, pages={326--339}, doi={10.1214/aoms/1177730197}}